

شيء بنيته بنفسك يعمل الآن في الإنتاج. مراقبتك إمّا معدومة تمامًا أو مجرد فحص توفّر بسيط، وفي الأسبوع الماضي عرفت بحدوث عطل من أحد المستخدمين. وكل إجابة تبحث عنها تشير إلى الاسم نفسه.
تدور هذه المراجعة لـ Prometheus حول الفجوة بين أمرين صحيحين معًا. فهو مجاني ومفتوح المصدر، بلا ترخيص وبلا فاتورة لكل مقياس مهما كان الحجم. وهو أيضًا يكلّفك أمسية كاملة، إضافة إلى لغة استعلام لا تعرفها بعد. إنه جامع مقاييس يعمل بأسلوب السحب مع تنبيهات مدمجة، وهو برنامج ممتاز. أما هل هو البرنامج المناسب للتجهيزة التي تديرها أنت الآن، فذلك سؤال آخر، وهو السؤال الذي يستحق إجابة.
النسخة المختصرة
- الحكم: 3.5 / 5 للاستضافة الذاتية للأفراد والفرق الصغيرة. يستحق Prometheus التشغيل إذا كانت مجموعة مضيفاتك وخدماتك مستقرة إلى حد معقول، وكنت مستعدًا لتخصيص الوقت لتعلّم PromQL، وأردت مقاييس تملكها ملكية كاملة بلا اشتراك وبلا فاتورة على مدة الاحتفاظ.
- تجاوزه إن كان السؤال الذي تحتاج إجابته هو «هل الموقع يعمل؟». فأداة فحص التوفّر توصلك إلى تلك الإجابة أسرع بكثير، واللجوء إلى Prometheus لهذه المهمة يعني دفع ثمن لغة استعلام للإجابة عن شيء كان يمكن حسمه في عشر دقائق.
- PromQL هي الكلفة التي تتكرر باستمرار. الإعداد كلفة تُدفع مرة واحدة. لكن ما إن تتجاوز أسئلتك اللوحات الجاهزة والمنشئ المرئي في Grafana، حتى تعود إلى PromQL.
- كلفة الصيانة تتبع حجم ما تديره من التجهيزة يدويًا. الأسطول الذي يحافظ على شكله رخيص المراقبة. أما الذي يكسب مضيفات ويفقدها ويعيد تسميتها، فهناك تتراكم الكلفة بهدوء.
- هذا الحكم محصور في الاستضافة الذاتية على نطاق صغير. على نطاق Kubernetes وفرق SRE في الإنتاج، يصبح Prometheus عرضًا مختلفًا تمامًا، وهذه المراجعة لا تحاول الإجابة عن ذلك السؤال.
كيف أُعدّت هذه المراجعة: Prometheus مجاني ومفتوح المصدر، فلا توجد هنا علاقة مع أي مورّد ولم يرسل لي أحد شيئًا. معلومات الإصدارات وسلوك التخزين مأخوذة من توثيق Prometheus نفسه. أما أرقام استهلاك الموارد وأزمنة الإعداد فمأخوذة من اختبارين عمليين نُشرا بشكل مستقل، ويُنسب كل منهما في الموضع الذي يُستخدم فيه. وحيث يختلف الاختباران، سترى الرقمين معًا بدلًا من متوسط بينهما.
ما الذي تغطيه هذه المراجعة
الحكم أعلاه له حدود، وهذه الحدود تهم هنا أكثر من المعتاد، لأن Prometheus يتصرف كأداة مختلفة عند كل نطاق.
- تقييم Prometheus للاستضافة الذاتية على خادم VPS واحد وللمشاريع الصغيرة: حفنة من المضيفات والخدمات، وشخص واحد يتولّى رعايتها.
- ليس Kubernetes. فـ Prometheus Operator وServiceMonitors وkube-prometheus-stack عالم تشغيلي منفصل، والحكم هنا لا يقول عنه شيئًا.
- ليست دليلًا لتوجيه Alertmanager. التنبيهات موجودة وتعمل؛ أما ضبط المسارات وفترات الإسكات والمستقبِلات فموضوع قائم بذاته.
- ليست دليل تثبيت خطوة بخطوة. السؤال هنا هو هل تشغّله من الأساس. وإن كنت قد حسمت ذلك بالفعل، فإن دليلنا لـ Grafana وPrometheus عبر Docker Compose يشرح الخطوات.
- ليست مسحًا لأدوات التصدير. لن تظهر أدوات التصدير إلا حيث تغيّر الإجابة.
ما الذي يُحسنه Prometheus
لا يكلّف Prometheus شيئًا. ليست «باقة مجانية مع ترقيات مدفوعة»، ولا «مجاني حتى تتجاوز حدًا للمقاييس». فـ المستودع مرخّص بموجب Apache 2.0 من أوله إلى آخره، ولا توجد نسخة مدفوعة من المشروع الأساسي، ولا توجد فوترة لكل مضيف أو لكل مقياس أو لكل وسم في أي موضع. الفاتورة الوحيدة التي يولّدها Prometheus هي الخادم الذي يعمل عليه.
حين تعتزم الاعتماد على شيء ما، يصبح سؤال «هل سيظل موجودًا بعد ثلاث سنوات؟» سؤالًا وجيهًا، والاحتمالات هنا جيدة بقدر ما يسمح به المصدر المفتوح. فـ Prometheus تخرّج من CNCF في أغسطس 2018، وهو ثاني مشروع يفعل ذلك على الإطلاق، بعد Kubernetes. والإصدارات تصدر بانتظام، إذ صدرت v3.13.2 في أواخر يوليو 2026، ولأن ذلك المسار من الإصدارات مسار دعم طويل الأمد، فإنه يحصل على إصلاحات للعلل والأمان والتوثيق لمدة عام، وبذلك لا يعني البقاء محدّثًا اللهاث خلف كل إصدار فرعي.
نموذج البيانات هو سبب العمق الكبير للمنظومة المحيطة به. يجمع Prometheus المقاييس عبر HTTP ويعرّف كل سلسلة باسم المقياس مع وسوم من نوع مفتاح/قيمة، ما يجعل كتابة أداة تصدير عملًا صغيرًا. لذلك توجد أدوات تصدير لكل ما قد تشغّله تقريبًا: مقاييس النظام، وPostgres، وNginx، وRedis، ومجسّات blackbox لما لا يمكن اختباره إلا من الخارج.
وأنت تملك ما يجمعه، وهو الجانب الذي يهم لاحقًا لا في اليوم الأول. فسجلّ تجهيزة صغيرة يشغل قدرًا لا يُذكر من القرص (الأرقام أدناه)، ولا يستطيع أحد إعادة تسعيره عليك الربع القادم، ولا يوجد بند في الفاتورة يكبر كلما أضاف أحدهم قياسًا إلى تطبيق. وإن سبق أن رأيت فاتورة مراقبة مُدارة ترتفع لأن مطوّرًا أضاف وسمًا واحدًا، فتلك هي الحجة كلها في جملة واحدة.
أين يكلّفك Prometheus أكثر مما يبدو
اختبار على dev.to شمل سبع أدوات مراقبة على خادم VPS صغير قاس 15 دقيقة لإعداد Prometheus وحده. اقرنه بـ Grafana كما فعل صاحب الاختبار، لأن متصفح التعابير المدمج ليس سوى مكان لتنفيذ الاستعلامات. والاختبار نفسه يضع Grafana + Prometheus عند 35 دقيقة حتى أول رسم بياني، مع إعداد YAML للجمع في المنتصف.
الدقائق هي الجزء الرخيص. أما الغالي فهو PromQL. يخزّن Prometheus كل شيء كسلاسل زمنية معرّفة بالاسم والوسوم، وتظل PromQL هي اللغة الكامنة تحت الأسئلة التي تطرحها عليه. صار لدى Grafana منشئ مرئي الآن، فلست مضطرًا لكتابة كل استعلام يدويًا. وكان حكم صاحب الاختبار نفسه صريحًا: PromQL رائعة لمن يعيش داخلها، وهو لم يكن كذلك. وإن لم تستخدم لغة استعلام من قبل، فخصّص لها أكثر من أمسية واحدة، وتوقّع العودة إليها كلما توقف المنشئ المرئي عن الكفاية. اللوحة التي نسختها من شخص آخر تجيب عن أسئلته هو. أما أسئلتك أنت فهي استعلام لم تكتبه بعد.
الكلفة الثالثة هي التي لا تظهر إلا لاحقًا. فهناك تقرير مشغّل عن ثلاثة أسابيع يصف بالضبط ما تطلّبه إضافة خادم واحد إلى تجهيزة من سبع عقد: إعادة الوسم، وإعادة فحص إعدادات الجمع، وتعديل متغيّرات اللوحات، وإعادة صياغة استعلامات القوالب حتى يظهر المضيف الجديد في القوائم المنسدلة. وقد تخلّى ذلك المشغّل عن المنظومة بعد ثلاثة أسابيع، بعدما خلص إلى أنه يقضي في ضبط اللوحات وقتًا أطول مما يقضيه في مراقبة بنيته التحتية.
لاحظ بماذا ترتبط هذه الكلفة في هذا النوع من التجهيزات: بالأهداف واللوحات التي تُدار يدويًا. أما تشغيل Prometheus عامين هادئين فلا يكلّفك شيئًا يُذكر فوق ذلك.
كم من الذاكرة والقرص يحتاج Prometheus فعليًا؟
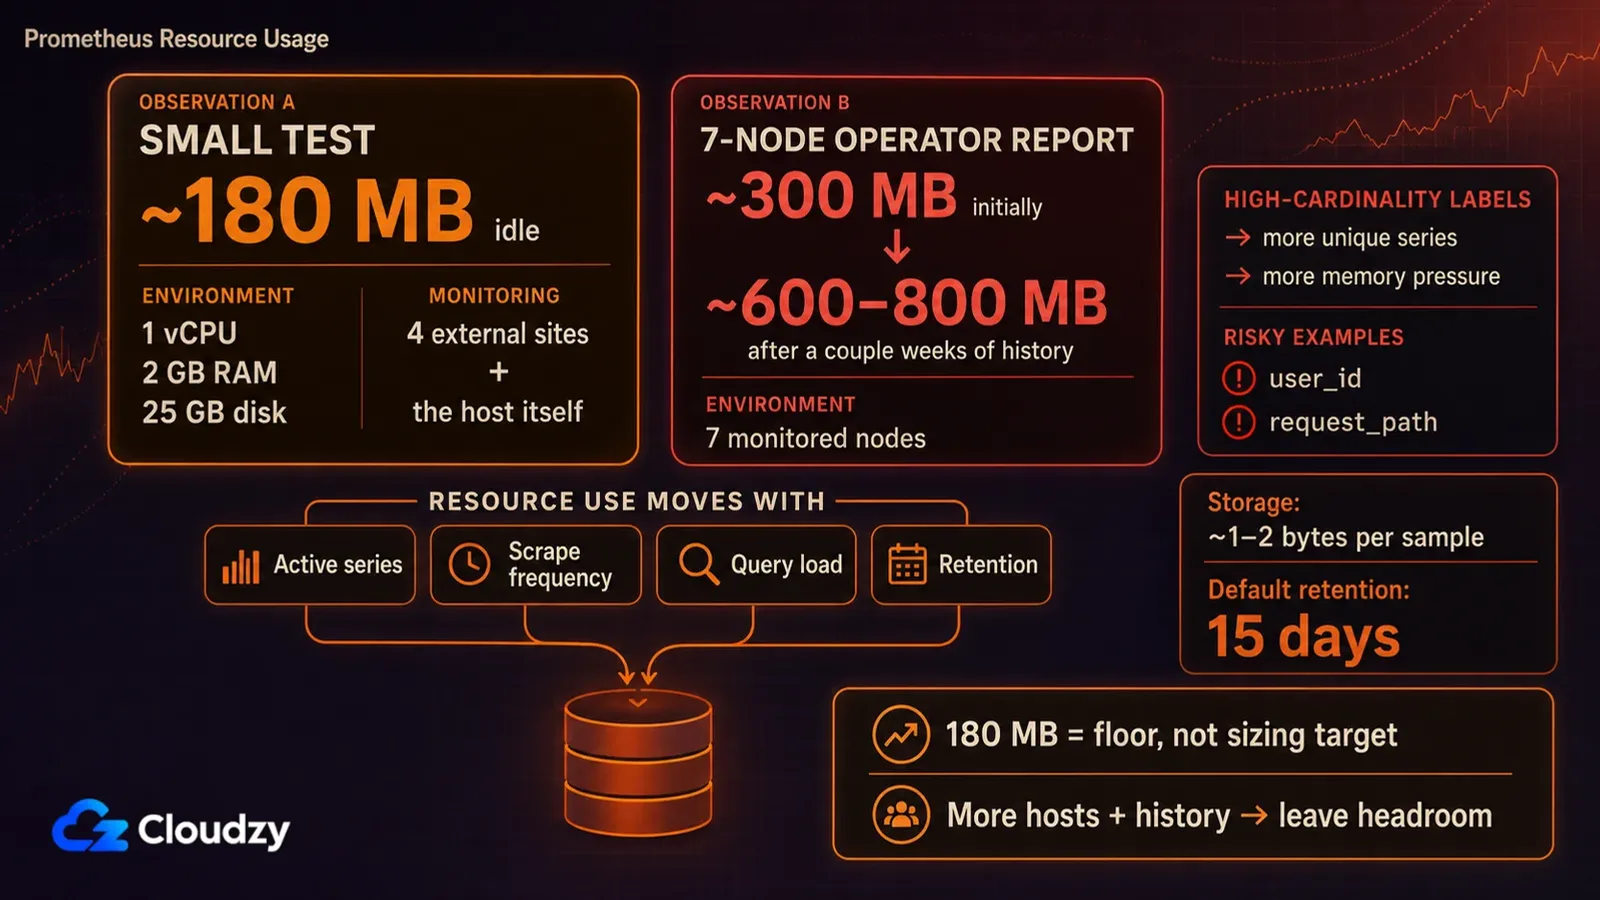
لا يوجد متطلب ثابت. فالسلاسل النشطة وتواتر الجمع وحمل الاستعلامات ومدة الاحتفاظ تهم أكثر من مجرد عدد الخوادم التي توجّهه إليها. اختباران عمليان منشوران على تجهيزات صغيرة يضعانه بين نحو 180 ميغابايت و800 ميغابايت، ويخص الرقم الأعلى سبع عقد مع أسبوعين من السجل.
يختلف الاختباران، وهذا الاختلاف هو الجزء المفيد. فالمقارنة نفسها التي شملت سبع أدوات على VPS شغّلت كل أداة على عتاد مطابق (1 vCPU و2 غيغابايت ذاكرة و25 غيغابايت قرص وUbuntu 24.04) وهي تراقب أربعة مواقع خارجية إضافة إلى المضيف نفسه، وقاست Prometheus عند نحو 180 ميغابايت في الخمول. أما المشغّل نفسه فأفاد بأن Prometheus وحده كان يستقر قرب 300 ميغابايت على المضيف المركزي، ويرتفع نحو 600 إلى 800 ميغابايت بعد تراكم أسبوعين من السجل.
ليسا القياس نفسه، ولهذا فإن أخذ متوسطهما يعني إهدار المعلومة. أحدهما قراءة شبه خاملة على جهاز لا يكاد يخزّن شيئًا. والآخر نشر عامل فعليًا، خلفه أسطول وسجل على القرص. قراءتي أنا: تعامل مع نتيجة 180 ميغابايت كأرضية لا كهدف للتحجيم. فما إن تجمع من عدة مضيفات وتحتفظ بسجل، اترك هامشًا بدل التخطيط على رقم الخمول ذاك.
القرص هو النصف السهل. توثيق التخزين في Prometheus يقدّره بمتوسط 1 إلى 2 بايت لكل عيّنة، فالاحتفاظ بسجل طويل لتجهيزة صغيرة رخيص. والمشكلة في القيمة الافتراضية: مدة الاحتفاظ الافتراضية 15 يومًا ما لم تحدّد مدة احتفاظ أو حجم احتفاظ. يفصلها عن عام كامل خيار واحد عند الإقلاع، وهي من نوع الإعدادات الافتراضية التي تفضّل معرفتها الآن، لا في أول مرة تبحث فيها عن أرقام الشهر الماضي فتجد أنها انقضت قبل ثلاثة أسابيع.
ما يرفع رقم الذاكرة هو التعدد: أي عدد السلاسل الزمنية المتمايزة، حيث يصير كل تركيب فريد من وسوم مقياس ما سلسلة قائمة بذاتها. ووسم واحد سيئ الاختيار على مقياس كثيف الحركة قد ينشئ سلاسل أكثر مما تنشئه خمسة خوادم إضافية، ويفعل ذلك بصمت، وبالوتيرة نفسها التي تسير بها حركتك. (معرّف المستخدم أو مسار الطلب يبدو وسمًا ممتازًا، إلى أن تعدّ كم عددها.)
أي رقم للذاكرة تجده منسوبًا إلى Prometheus لا يفيدك إلا إذا عرفت أيضًا كم سلسلة كانت خلفه.
ماذا يحدث حين يتعطّل خادم Prometheus لديك؟
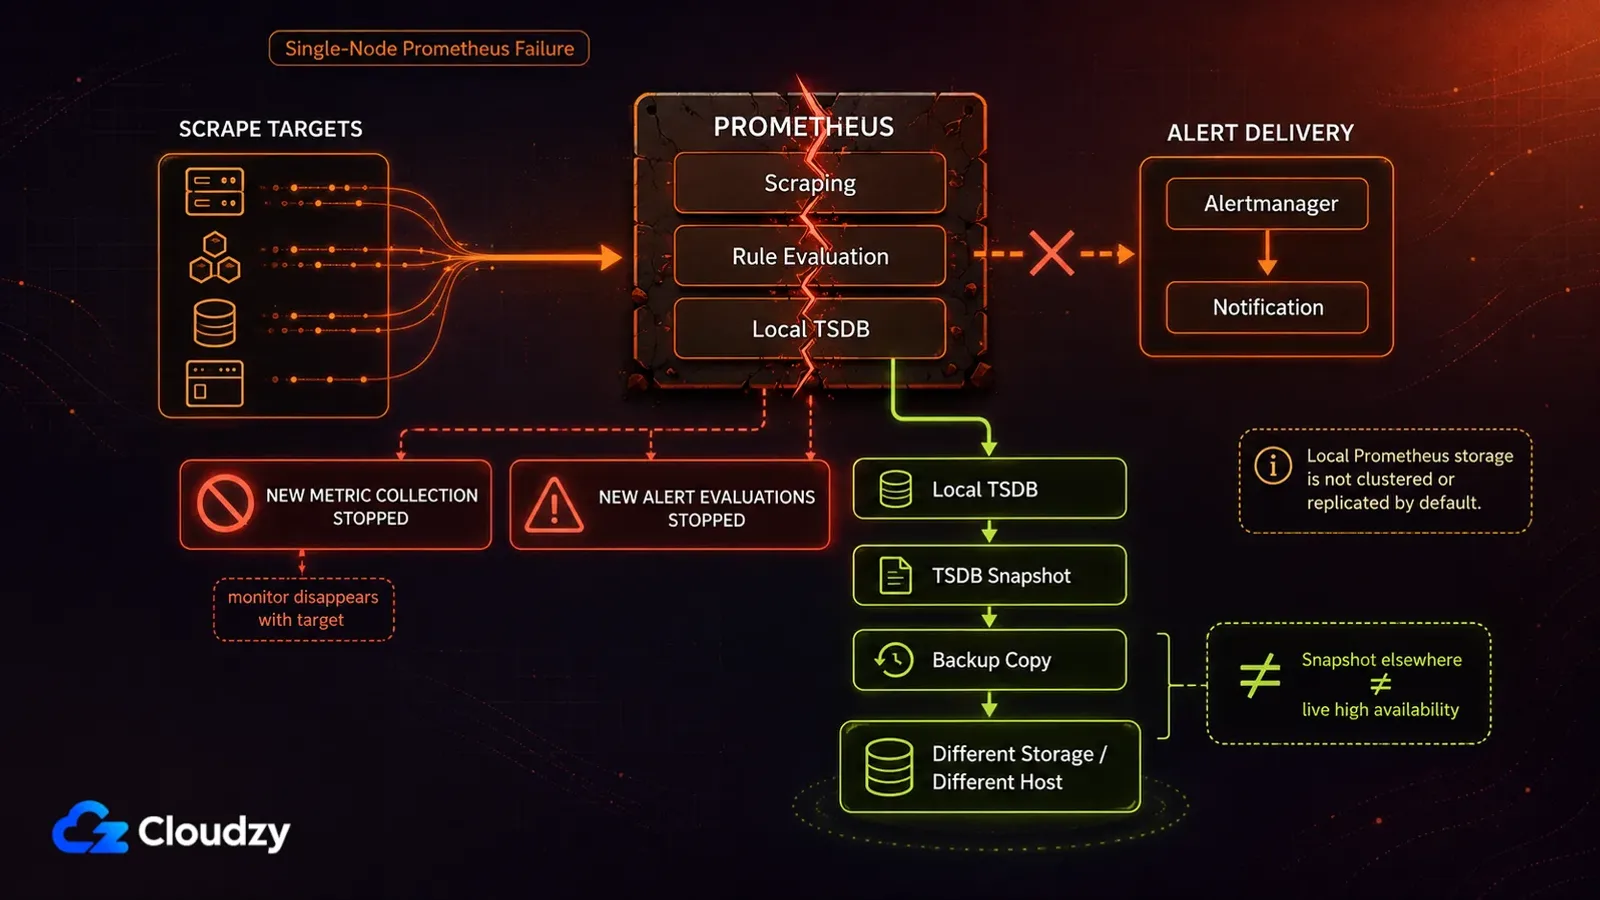
توثيق التخزين في Prometheus صريح بهذا الشأن: فالتخزين المحلي ليس عنقوديًا ولا مُنسوخًا، ولذلك فهو غير صامد أمام عطل قرص أو عقدة. وكل خادم قائم بذاته بحكم التصميم ولا يعتمد على تخزين شبكي ولا على خدمات بعيدة، وهو بالضبط ما يجعل تشغيله سهلًا، وبالضبط ما يتركه مكشوفًا.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
وهناك حد ثانٍ يعلنه المشروع عن نفسه، ويستحق التقدير لإعلانه: إن كنت تحتاج دقة 100%، كالفوترة لكل طلب مثلًا، يقول التوثيق إن Prometheus هو الخيار الخاطئ، لأن البيانات التي يجمعها لن تكون على الأرجح مفصّلة ولا كاملة بما يكفي. استخدم شيئًا آخر للأرقام التي تصدر بها فواتيرك، وأبقِ Prometheus للمراقبة. ولا يبادر المورّدون عادةً بقول مثل هذا عن أنفسهم.
وثمة إجابات راسخة عن هذا على نطاق أكبر، وهي خارج نطاق هذا النص للسبب نفسه الذي أخرج أدوات Kubernetes: فهي التزام تشغيلي مختلف عن الذي تغطيه هذه المراجعة. أما لخادم VPS واحد، فقراءتي أن هذا التعرّض مقبول إن احتفظت بلقطات TSDB في مكان آخر أو قبلت منذ البداية أنك ستفقد السجل، وأنه مشكلة حقيقية إن كان Prometheus هو الشيء الوحيد الذي يقف بينك وبين عطل صامت.
من الذي ينبغي أن يستضيف Prometheus ذاتيًا؟
أوضح إشارة إلى أن Prometheus سيردّ ما يكلّفه لا علاقة لها بعدد خوادمك. بل بما إذا كانت ستظل الخوادم نفسها بعد ستة أشهر. فمجموعة مستقرة من المضيفات المضبوطة يدويًا تعني أنك تكتب الإعداد مرة واحدة وتجمع السجل مجانًا؛ ومجموعة تتغير باستمرار تعني أنك تعود إلى ذلك الإعداد باستمرار.
في تجهيزة ثابتة، يكون إعداد Prometheus وGrafana لديك وصفًا صريحًا لبنيتك التحتية: أهداف الجمع، والوسوم المرتبطة بها، واللوحات المبنية فوق تلك الوسوم. ولهذا فإن السجل هو المكسب كله. فسنة من البيانات على مجموعة مستقرة من المضيفات تخبرك كيف يبدو الوضع الطبيعي، وهذا أوثق طريق لتمييز غير الطبيعي قبل أن يتحول إلى عطل.
ولذلك فإن أول نمط هو من يدير مجموعة صغيرة بطيئة التغير من الخوادم ويريد أكثر من مجرد «يعمل أو لا يعمل»: زمن استجابة الطلبات عبر الوقت، واتجاهات الذاكرة، وقرص يمتلئ ببطء يكفي لتراه قادمًا قبل أسابيع. فإن استطعت وصف بنيتك التحتية اليوم وتوقّعت أن يظل ذلك الوصف صحيحًا تقريبًا بعد عام، فإن الأمسية التي تنفقها في الإعداد هي آخر فاتورة كبيرة.
والثاني هو كل من يتعلّم هذه المنظومة عن قصد. فإن كنت تتوقع أن تدير بنية تحتية بعد بضع سنوات، لك أو لغيرك، فإن أمسية PromQL هي ما جئت من أجله، والمراقبة أثر جانبي. وهذا النمط يقلب الأول جزئيًا: فاختبار الاستقرار أقل أهمية هنا، لأن الوقت المنفق في إعادة الوسم هو أيضًا وقت منفق في تعلّم ما هي إعادة الوسم. ولهذا القارئ كنت سأرفع التقييم.
والنمط الثالث يتعلق بالملكية، وهو الذي يقلّل الناس من شأنه إلى أن يجدوا أنفسهم في الجانب الخطأ منه. فـ Prometheus لا يحاسبك لكل مضيف ولا لكل مقياس ولا لكل وسم، ولا توجد صفحة أسعار يمكن أن تتبدّل من تحتك الربع القادم. المقايضة أمام خدمة مُدارة مثل Datadog: تتنازل عن الصقل وعن عقد الدعم وعن مناوبة شخص آخر، وتحصل في المقابل على مقاييس تملكها أنت وفاتورة لا تتحرك حين يضيف مطوّر قياسًا جديدًا. أما هل هي مقايضة جيدة، فيتوقف ذلك على قيمة ساعاتك أنت، وهو رقم لا يضعه سواك (ونادرًا ما يكون صفرًا، حتى حين يبدو كذلك).
وشيء ينبغي معرفته قبل أن تلتزم: تجاوز حدود التخزين المحلي في Prometheus ليس طريقًا مسدودًا. فـ VictoriaMetrics يقبل عمليات الكتابة البعيدة من Prometheus، وإصداره MetricsQL متوافقة رجعيًا مع PromQL، ولذلك فإن معظم الاستعلامات ولوحات Grafana التي تبنيها الآن ينبغي أن تنجو من الانتقال. إنها هجرة لا إعادة كتابة.
يستحق الأمر مراجعة سنوية بدل قرار يُتخذ مرة واحدة: فالتجهيزة الرخيصة المراقبة اليوم تصبح مكلفة في الربع الذي تبدأ فيه إعادة بنائها.

ابنِ على خادم Linux VPS بوصول root وتخزين NVMe وقوة AMD EPYC.
عرض باقات Linuxمن الذي ينبغي أن يتجاوز Prometheus؟
إن كانت الجملة التي تصف بها حاجتك هي «أخبرني حين يسقط الموقع»، فأنت تصف أداة فحص توفّر، وPrometheus آلية ضخمة للوصول إلى تلك الإجابة. Uptime Kuma يؤدي هذه المهمة بالذات عبر واجهة ويب ولا يطالبك بتعلّم لغة استعلام للمراقبة. والفارق في الإمكانات بين الأداتين هائل، وغير ذي صلة إطلاقًا بالمهمة التي تريد إسنادها.
والقارئ الثاني هو من يريد رسومًا بيانية صالحة للاستخدام دون أن يتعلّم لغة استعلام أولًا. وNetdata مبني حول هذا بالضبط: مقاييس لكل مضيف يمكنك النظر إليها فورًا، بإعداد أقل بكثير وبلا شيء يقف بينك وبين الرسوم. فإن كان السؤال الذي تكرّره هو «لماذا هذا الجهاز بطيء الآن؟»، فذلك طريق أقصر بكثير إلى إجابة.
والثالث هو كل من تتغير بنيته التحتية شكلًا باستمرار ويدير الأهداف ومتغيّرات اللوحات يدويًا. مضيفات تُنشأ لأسبوع ثم تُهدم، وأهداف يُعاد تسميتها، ومشاريع يُعاد تسميتها في منتصف الطريق. وهذه هي الحالة التي تدفع فيها كلفة الإعداد مرة بعد مرة بينما تحصل على أقل فائدة مما تدفع ثمنه، أي على سجل متصل لنظام يظل قابلًا للتعرّف عليه.
لا شيء من هذا مأخذ على الأداة. فـ«تجاوزه» هنا تعني تجاوزه لهذه المهمة وعند هذا النطاق. أما على نطاق Kubernetes، حيث يتكفل اكتشاف الخدمات بمعظم ما كنت ستوصّله يدويًا، فإن عدة كلف مما سبق تتقلص أو تختفي تمامًا، وقراءتي لذلك النطاق أن التفوّق على Prometheus فيه صعب جدًا. لكن تلك مراجعة أخرى.

الأسئلة الشائعة
هل Prometheus مجاني؟
نعم، ولا يوجد تحتها فخ باقة مجانية. فـ Prometheus مرخّص بموجب Apache 2.0 ولا تقف خلفه نسخة تجارية، فلا حصة مقاييس تتجاوزها ولا دعوة للترقية تنتظرك على الجانب الآخر. أنت تدفع ثمن البنية التحتية ووقتك أنت، لا ثمن ترخيص لـ Prometheus.
هل يحتاج Prometheus إلى Grafana؟
لا، لكن خطّط لها. فمتصفح التعابير في Prometheus موجود لتنفيذ استعلام والنظر إلى الجواب، وهو ما يكفي لفحص شيء واحد مرة واحدة. أما كل ما تريد تركه مفتوحًا على شاشة ثانية فهو عمل Grafana، والاثنان يُشغَّلان معًا في الغالب الأعم.
هل Prometheus مبالغ فيه لخادم واحد؟
غالبًا نعم. فإن كان ما تحتاجه هو معرفة ما إذا كان الخادم وخدماته تعمل، فأداة فحص التوفّر تجيبك عن ذلك في جزء يسير من زمن الإعداد. ويستحق Prometheus مكانه حين تريد مقاييس تاريخية يمكنك استعلامها، وتكون مستعدًا لتعلّم PromQL للوصول إليها.
كم من الوقت يحتفظ Prometheus بالمقاييس افتراضيًا؟
15 يومًا، ولا ينبّهك قبل ذلك. يُسقط Prometheus العيّنات الأقدم من نافذة الاحتفاظ ما لم ترفعها بخيار مدة احتفاظ أو حجم احتفاظ عند الإقلاع. اضبطها يوم التثبيت نفسه، لأن توسيع النافذة لاحقًا لن يعيد بيانات انقضت مدتها من قبل.



النقاش
التعليقات
سجّل الدخول للمشاركة في النقاش.