

Noget, du selv har bygget, kører i produktion. Din overvågning er enten slet ingenting eller et uptime-ping, og i sidste uge hørte du om et nedbrud fra en bruger. Hvert svar, du leder efter, peger på det samme navn.
Denne Prometheus-anmeldelse handler om afstanden mellem to ting, der begge er sande. Det er gratis og open source, uden licens og uden regning per metrik, uanset skala. Det koster dig også en aften plus et forespørgselssprog, du endnu ikke kan. Det er en pull-baseret metrikindsamler med alarmering indbygget, og det er fremragende software. Om det er den rigtige software til den opsætning, du kører lige nu, er et andet spørgsmål, og det er det, der er værd at besvare.
Den korte version
- Dom: 3,5 / 5 til selvhosting for enkeltpersoner og små teams. Prometheus er værd at køre, hvis din samling af hosts og tjenester er nogenlunde stabil, du vil bruge tiden på at lære PromQL, og du vil have metrikker, der er dine helt og holdent, uden abonnement og uden regning for opbevaring.
- Spring det over, hvis det spørgsmål, du har brug for svar på, er “kører den?”. En uptime-checker bringer dig derhen langt hurtigere, og at trække Prometheus ind til den opgave betyder, at du betaler for et forespørgselssprog for at besvare noget, du kunne have klaret på ti minutter.
- PromQL er den udgift, der bliver ved med at vende tilbage. Opsætningen er en engangsudgift. Så snart dine spørgsmål vokser ud over færdige dashboards og Grafanas visuelle forespørgselsbygger, er du tilbage i PromQL.
- Vedligeholdelsesomkostningen følger, hvor stor en del af opsætningen du styrer i hånden. En flåde, der holder sin form, er billig at overvåge. En, der får, mister og omdøber hosts, er præcis der, hvor omkostningen stille og roligt hober sig op.
- Denne dom gælder udelukkende selvhosting i lille skala. På Kubernetes- og produktions-SRE-niveau er Prometheus et helt andet tilbud, og denne anmeldelse forsøger ikke at besvare det spørgsmål.
Sådan blev denne anmeldelse til: Prometheus er gratis og open source, så der er ingen leverandørrelation her, og ingen har sendt mig noget. Oplysningerne om versioner og lagringsadfærd kommer fra Prometheus' egen dokumentation. Ressourcetallene og opsætningstiderne kommer fra to uafhængigt udgivne praksistests, med kildeangivelse netop dér, hvor hver af dem bruges. Hvor de to er uenige, ser du begge tal i stedet for et gennemsnit.
Hvad denne anmeldelse dækker
Dommen ovenfor har grænser, og de grænser vejer tungere her end normalt, fordi Prometheus opfører sig som et andet værktøj i forskellige skalaer.
- Prometheus vurderet til selvhosting på én VPS og til små projekter: en håndfuld hosts og tjenester og én person, der holder øje med dem.
- Ikke Kubernetes. Prometheus Operator, ServiceMonitors og kube-prometheus-stack er en driftsverden for sig, og dommen her siger ingenting om den.
- Ikke en guide til Alertmanager-routing. Alarmering findes og virker; at konfigurere ruter, silences og receivers er et emne i sig selv.
- Ikke en installationsvejledning. Spørgsmålet her er, om du overhovedet skal køre det. Har du allerede besvaret det, beskriver vores guide til Grafana og Prometheus med Docker Compose trinnene.
- Ikke en gennemgang af exporters. Exporters dukker kun op dér, hvor de ændrer svaret.
Hvad Prometheus gør rigtigt
Prometheus koster ingenting. Ikke “gratis niveau med betalte opgraderinger”, ikke “gratis indtil du overskrider en metrikgrænse”. Repositoryet er licenseret under Apache 2.0 fra ende til anden, der findes ingen betalt udgave af kerneprojektet, og der afregnes intetsteds per host, per metrik eller per label. Den eneste regning, Prometheus nogensinde skaber, er den server, det kører på.
Til noget, du regner med at læne dig op ad, er “findes det her stadig om tre år” et rimeligt spørgsmål, og her er oddsene omtrent så gode, som det bliver i open source. Prometheus forlod CNCF som graduated projekt i august 2018, som det andet projekt nogensinde, efter Kubernetes. Udgivelserne kommer stabilt, med v3.13.2 der udkom i slutningen af juli 2026, og fordi den udgivelseslinje er en linje med langtidsunderstøttelse, får den fejlrettelser samt sikkerheds- og dokumentationsrettelser i et helt år, så at holde sig opdateret med patches betyder ikke, at du skal jagte hver eneste mindre version.
Datamodellen er grunden til, at økosystemet omkring det er så dybt. Prometheus henter metrikker over HTTP og identificerer hver serie med et metriknavn plus nøgle/værdi-labels, hvilket gør det til en lille opgave at skrive en exporter. Derfor findes der exporters til stort set alt, du realistisk kunne køre: node-metrikker, Postgres, Nginx, Redis, blackbox-probes til de ting, du kun kan pirke til udefra.
Og du ejer det, den indsamler, og det er den del, der som regel betyder noget senere frem for på dag ét. Historikken for en lille opsætning fylder en ubetydelig mængde diskplads (tal længere nede), ingen kan prissætte den om for dig næste kvartal, og der er ingen post på regningen, der vokser, hver gang nogen tilføjer instrumentering til en applikation. Har du nogensinde set en regning for administreret overvågning klatre, fordi en udvikler tilføjede ét label, så står hele argumentet i den ene sætning.
Hvor Prometheus koster dig mere, end det ser ud til
En dev.to-test af syv overvågningsværktøjer på én lille VPS målte 15 minutters opsætning for Prometheus alene. Kombinér det med Grafana, sådan som testeren gjorde, for den indbyggede expression browser er kun et sted at køre forespørgsler. Samme test sætter Grafana + Prometheus til 35 minutter frem til den første graf, med YAML-scrapekonfiguration undervejs.
Minutterne er den billige del. Den dyre er PromQL. Prometheus gemmer alt som tidsserier identificeret ved navn og labels, og PromQL er stadig sproget under de spørgsmål, du stiller. Grafana har efterhånden en visuel bygger, så du behøver ikke skrive hver forespørgsel i hånden. Testerens egen dom var kontant: PromQL er fantastisk, hvis man bor i det, og det gjorde han ikke. Har du aldrig brugt et forespørgselssprog, så afsæt mere end én aften til det, og regn med at vende tilbage til det, hver gang den visuelle bygger ikke længere slår til. Et dashboard, du har kopieret fra en anden, besvarer vedkommendes spørgsmål. Dine er en forespørgsel, du endnu ikke har skrevet.
Den tredje udgift er den, der først dukker op senere. Et tre uger langt referat fra en driftsansvarlig beskriver præcis, hvad det indebar at føje én enkelt server til en opsætning med syv noder: omlabeling, gennemgang af scrapekonfigurationer igen, redigering af dashboardvariabler og omskrivning af template-forespørgsler, så den nye host ville dukke op i rullelisterne. Den driftsansvarlige opgav stakken efter tre uger med den konklusion, at han brugte mere tid på at finjustere dashboards end på at holde øje med sin infrastruktur.
Læg mærke til, hvad den udgift hænger sammen med i den slags opsætning: targets og dashboards, der styres i hånden. At køre Prometheus i to rolige år koster dig næsten ingenting oveni.
Hvor meget RAM og diskplads har Prometheus egentlig brug for?
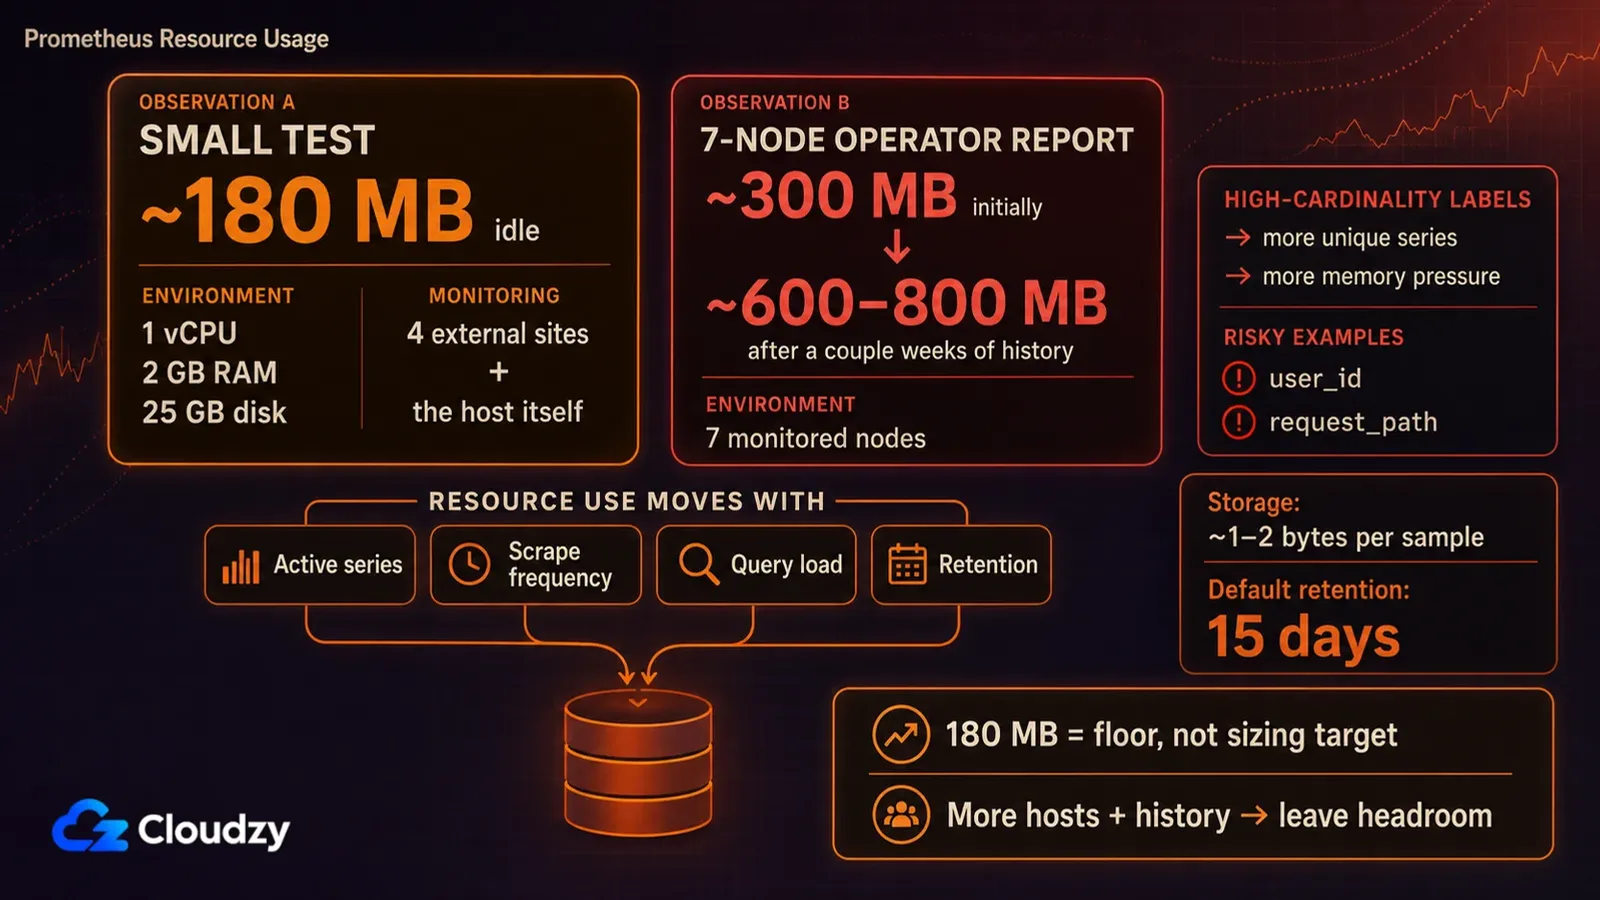
Der findes ikke noget fast krav. Aktive serier, scrapefrekvens, forespørgselsbelastning og opbevaringstid tæller mere end det rå antal servere, du peger den mod. To udgivne praksistests af små opsætninger placerer den mellem cirka 180 MB og 800 MB, hvor det højeste tal dækker syv noder med et par ugers historik.
De to tests er uenige, og netop uenigheden er den nyttige del. Den samme VPS-sammenligning af syv værktøjer kørte hvert af dem på identisk hardware (1 vCPU, 2 GB RAM, 25 GB disk, Ubuntu 24.04), mens den holdt øje med fire eksterne sites plus værten selv, og målte Prometheus til omkring 180 MB i tomgang. Den samme driftsansvarlige rapporterede, at Prometheus alene lå omkring 300 MB i tomgang på den centrale vært og klatrede mod 600 til 800 MB, når der havde hobet sig et par ugers historik op.
Det er ikke den samme måling, og derfor ville et gennemsnit smide informationen væk. Den ene er en næsten tomgangsaflæsning på en maskine med meget lidt at gemme. Den anden er en kørende installation med en flåde bagved og historik på disken. Min læsning: behandl resultatet på 180 MB som en bund, ikke som et dimensioneringsmål. Så snart du indsamler fra flere hosts og gemmer historik, så læg luft ind i stedet for at planlægge efter det tomgangstal.
Disken er den nemme halvdel. Prometheus' lagringsdokumentation sætter det til i gennemsnit 1 til 2 byte per sample, så det er billigt at gemme lang historik for en lille opsætning. Hagen ligger i standardværdien: opbevaringen står som standard til 15 dage medmindre du sætter en opbevaringstid eller en opbevaringsstørrelse. Der er ét opstartsflag mellem det og et helt år, og det er den slags standardindstilling, du hellere vil høre om nu end første gang, du leder efter sidste måneds tal og opdager, at de udløb for tre uger siden.
Det, der driver hukommelsestallet op, er kardinalitet: antallet af forskellige tidsserier, hvor hver unik kombination af labels på en metrik bliver sin egen serie. Ét dårligt valgt label på en metrik med meget trafik kan skabe flere serier, end fem ekstra servere nogensinde ville, og det gør det lydløst, i præcis det tempo din trafik nu engang kører. (Et bruger-id eller en request-sti ligner et fremragende label lige indtil det øjeblik, du tæller, hvor mange der er af dem.)
Ethvert RAM-tal, du finder citeret om Prometheus, er kun brugbart, hvis du også ved, hvor mange serier der lå bag det.
Hvad sker der, når din Prometheus-server går ned?
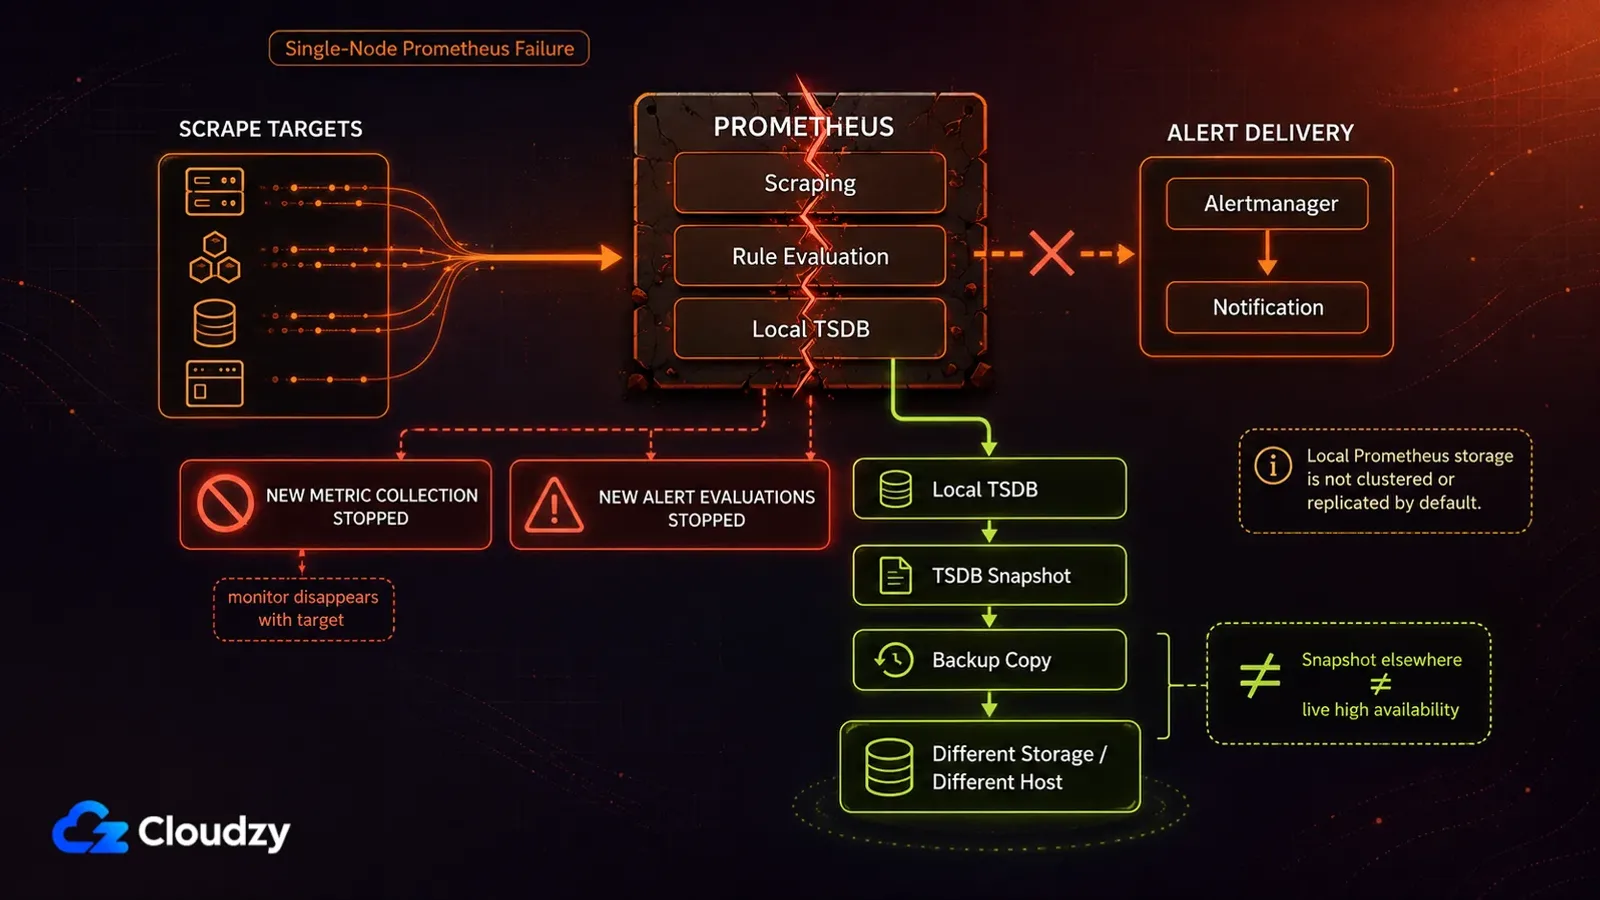
Prometheus' egen lagringsdokumentation er ligefrem om det: lokal lagring er hverken clustret eller replikeret, og den overlever derfor ikke et disk- eller nodenedbrud. Hver server står bevidst for sig selv og afhænger hverken af netværkslagring eller fjerntjenester, og det er præcis dét, der gør den nem at drive, og præcis dét, der lader den stå udsat.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Der er en anden grænse, som projektet selv melder ud om sig selv, og det fortjener anerkendelse for at sige det: hvis du har brug for 100 % nøjagtighed, for eksempel til fakturering per request, siger dokumentationen, at Prometheus er det forkerte valg, fordi de data, den indsamler, sandsynligvis ikke er detaljerede og komplette nok. Brug noget andet til de tal, du fakturerer på, og hold Prometheus til overvågning. Leverandører plejer ikke af sig selv at fortælle den slags om sig selv.
På større skala findes der etablerede svar på dette, og de ligger uden for rammerne her af samme grund som Kubernetes-værktøjet: de indebærer en anden driftsforpligtelse end den, denne anmeldelse dækker. For én enkelt VPS er min læsning, at eksponeringen er acceptabel, hvis du gemmer TSDB-snapshots et andet sted eller på forhånd accepterer, at du mister historikken, og at det er et reelt problem, hvis Prometheus er det eneste, der står mellem dig og et lydløst nedbrud.
Hvem bør hoste Prometheus selv?
Det klareste tegn på, at Prometheus tjener sin pris ind, har intet at gøre med, hvor mange servere du har. Det handler om, hvorvidt det er de samme servere om et halvt år. En stabil samling håndkonfigurerede hosts betyder, at du skriver konfigurationen én gang og får historikken gratis; en samling, der bliver ved med at ændre sig, betyder, at du bliver ved med at rode med den konfiguration.
I en statisk opsætning er din Prometheus- og Grafana-konfiguration en eksplicit beskrivelse af din infrastruktur: scrapetargets, de labels der hænger på dem, og de dashboards der er bygget oven på de labels. Derfor er historikken hele udbyttet. Et års data om en stabil samling hosts fortæller dig, hvordan normalt ser ud, og det er den mest pålidelige måde at genkende unormalt på, før det bliver til et nedbrud.
Den første profil er altså en, der driver en lille, langsomt foranderlig samling servere og vil have mere end oppe eller nede: request-latens over tid, hukommelsestendenser, en disk der fyldes langsomt nok til, at du kan se det komme uger i forvejen. Kan du beskrive din infrastruktur i dag og forvente, at den beskrivelse stadig passer nogenlunde om et år, så er den aften, du bruger på opsætningen, den sidste store regning.
Den anden er enhver, der bevidst lærer denne stak. Regner du med at drive infrastruktur om nogle år, din egen eller en andens, så er PromQL-aftenen netop dét, du kom efter, og overvågningen er en sidegevinst. Denne profil vender delvist den første på hovedet: stabilitetstesten vejer mindre her, fordi tid brugt på omlabeling også er tid brugt på at lære, hvad omlabeling er. For denne læser ville jeg sætte karakteren op.
Den tredje profil handler om ejerskab, og det er den, folk undervurderer, indtil de har stået på den forkerte side af den. Prometheus afregner hverken per host, per metrik eller per label, og ingen prisside kan skifte under fødderne på dig næste kvartal. Byttet over for en administreret tjeneste som Datadog: du giver afkald på finishen, supportaftalen og en andens vagt, og til gengæld får du metrikker, der er dine, på en regning der ikke rykker sig, når en udvikler tilføjer instrumentering. Om det er en god handel, kommer an på, hvad dine egne timer er værd, og det tal er der kun du, der kan sætte ind (og det er sjældent nul, selv når det føles sådan).
Én ting, du bør vide, før du binder dig: at vokse fra Prometheus' lokale lagring er ikke en blindgyde. VictoriaMetrics tager imod remote writes fra Prometheus, og den MetricsQL er bagudkompatibelt med PromQL, så de fleste af de forespørgsler og Grafana-dashboards, du bygger nu, burde overleve flytningen. Det er en migrering, ikke en omskrivning.
Værd at tage op igen én gang om året frem for at afgøre én gang for alle: den opsætning, der er billig at overvåge i dag, bliver dyr i det kvartal, hvor du begynder at bygge den om.

Byg på en Linux VPS med root-adgang, NVMe og AMD EPYC-kraft.
Se Linux-planerHvem bør springe Prometheus over?
Er den sætning, du ville bruge til at beskrive dit behov, “sig til, når siden går ned”, så beskriver du en uptime-checker, og Prometheus er meget maskineri for at nå frem til det svar. Uptime Kuma gør præcis det stykke arbejde med en webgrænseflade og beder dig ikke om at lære et forespørgselssprog til overvågning. Forskellen i kunnen mellem de to værktøjer er enorm og fuldstændig irrelevant for den opgave, du hyrer dem til.
Den anden læser er den, der vil have brugbare grafer uden først at lære et forespørgselssprog. Netdata er bygget præcis omkring dét: metrikker per host, som du kan kigge på med det samme, med langt mindre konfiguration og ingenting mellem dig og graferne. Er det spørgsmål, du bliver ved med at stille, “hvorfor er den her kasse langsom lige nu”, så er det en langt kortere vej til et svar.
Den tredje er enhver, hvis infrastruktur ofte skifter form, og som styrer targets og dashboardvariabler i hånden. Hosts der rejses for en uge og destrueres igen, targets der omdøbes, projekter der får nyt navn halvvejs. Det er tilfældet, hvor du betaler konfigurationsomkostningen igen og igen, mens du får mindst muligt ud af dét, du betaler for: sammenhængende historik om et system, der forbliver genkendeligt.
Intet af dette er en kritik af værktøjet. “Springe over” betyder her: springe over til denne opgave, i denne skala. På Kubernetes-skala, hvor service discovery klarer det meste af det, du ellers ville trække i hånden, skrumper flere af omkostningerne ovenfor eller forsvinder helt, og min læsning af den skala er, at Prometheus er meget svær at slå dér. Det er en anden anmeldelse.

Ofte stillede spørgsmål
Er Prometheus gratis?
Ja, og der ligger ikke nogen gratis-niveau-fælde under. Prometheus er licenseret under Apache 2.0 uden en kommerciel udgave bagved, så der er ingen metrikkvote at overskride og ingen opgraderingsprompt, der venter på den anden side. Du betaler for infrastrukturen og din egen tid, ikke for en Prometheus-licens.
Kræver Prometheus Grafana?
Nej, men regn med det. Prometheus' egen expression browser findes for at køre en forespørgsel og se på svaret, og det dækker at tjekke én ting én gang. Alt, hvad du vil lade stå åbent på en skærm nummer to, er Grafanas opgave, og de to køres næsten altid sammen.
Er Prometheus overkill til én enkelt server?
Ofte ja. Har du bare brug for at vide, om serveren og dens tjenester kører, så besvarer en uptime-checker det på en brøkdel af opsætningstiden. Prometheus gør sig fortjent til sin plads, når du vil have historiske metrikker, du kan forespørge på, og du er villig til at lære PromQL for at komme til dem.
Hvor længe gemmer Prometheus metrikker som standard?
15 dage, og den advarer dig ikke først. Prometheus smider samples væk, der er ældre end opbevaringsvinduet, medmindre du hæver det med et flag for opbevaringstid eller opbevaringsstørrelse ved opstart. Sæt det den dag, du installerer, for at udvide vinduet senere henter ikke data tilbage, der allerede er udløbet.



Diskussion
Kommentarer
Log ind for at deltage i diskussionen.