
Um usuário do r/linuxquestions fez a comparação sobre a qual todo mundo continua discutindo. Ele instalou o CachyOS, rodou benchmarks de vários jogos em um Ryzen 7 7800X3D com uma Radeon RX 7900 XTX e não mediu diferença alguma em relação às outras distribuições que já estavam na máquina. As respostas seguiram o roteiro de sempre. Um comentarista colocou o teto baixo o bastante para ser invisível no uso normal. Outro explicou o escalonador. Um terceiro disse que benchmarks não conseguem mostrar o que o escalonador faz. Ninguém apresentou a medição que encerraria a discussão.
A pergunta volta sempre com as mesmas palavras: o CachyOS é mesmo mais rápido? A resposta curta é sim, em cargas de trabalho específicas. Pacotes recompilados podem ajudar o código que o compilador consegue vetorizar, as comparações de jogos citadas aqui mostram pouca separação nos FPS médios, e um sistema que parece mais rápido depois da troca é mais difícil de atribuir, porque trocar de distribuição muda muito mais do que uma única variável.
Ela continua em aberto porque «mais rápido» carrega três afirmações separadas com três respostas diferentes, cada uma exigindo seu próprio instrumento. Pacotes recompilados terminam uma tarefa em menos tempo de relógio ou não terminam. Um escalonador muda como o desktop se comporta sob disputa ou não muda. E uma máquina mais ágil se explica pelo CachyOS ou por algo que chegou junto com ele.
A versão curta
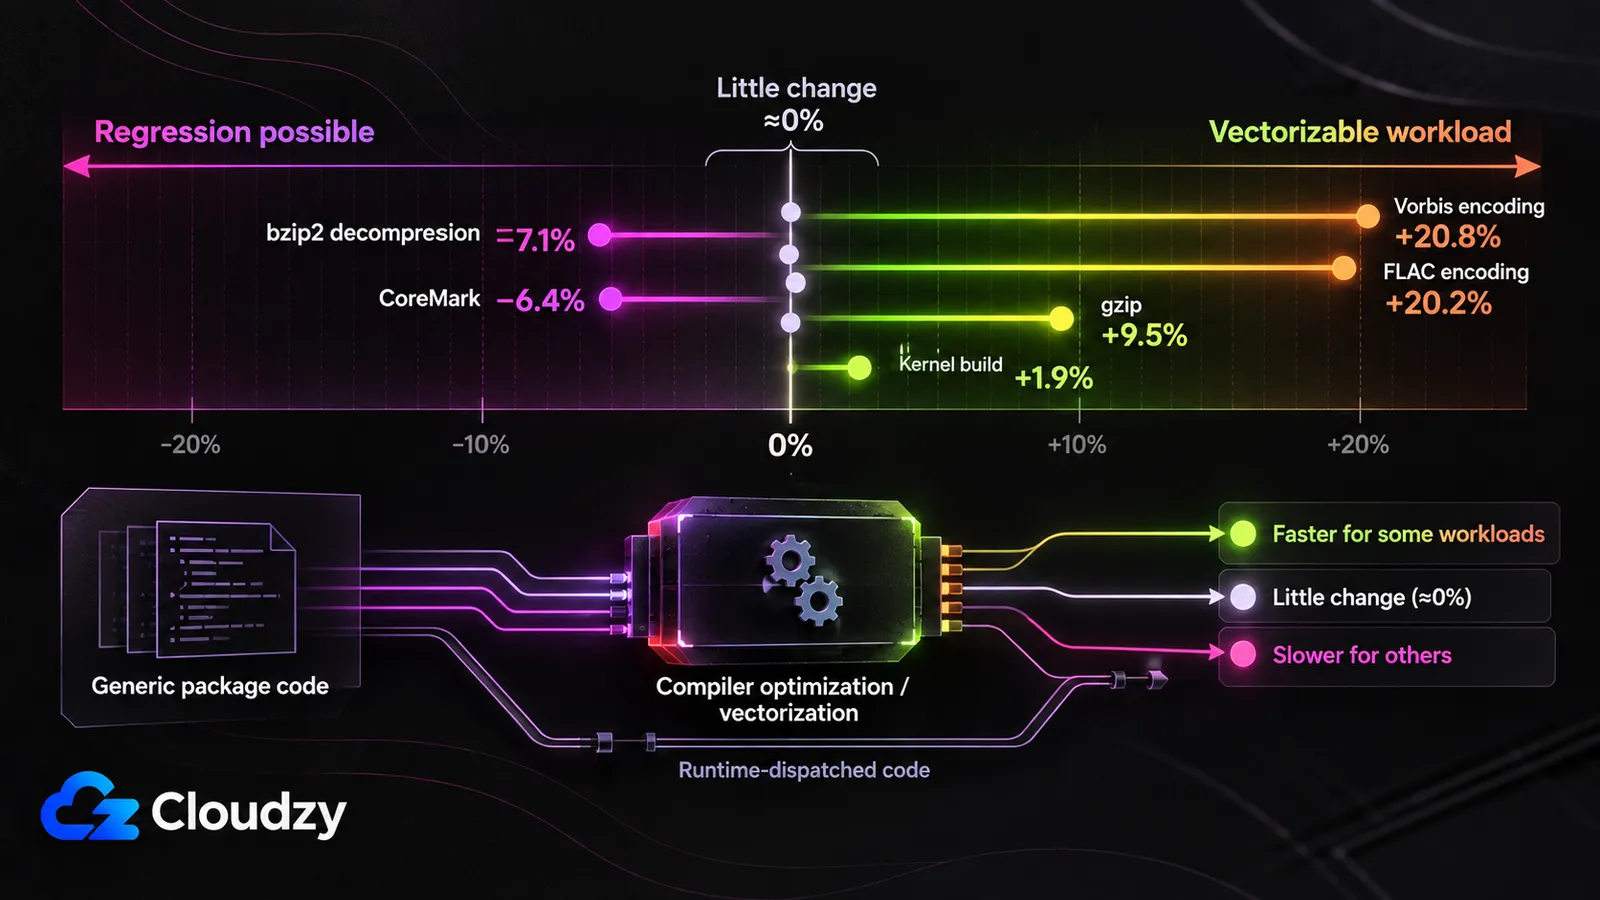
- Pacotes recompilados: mensuravelmente mais rápidos, em uma minoria do que você executa. Os ganhos se concentram no código que o compilador consegue vetorizar, vários pacotes saem mais lentos e a maioria não muda. Uma comparação em arch-chroot de janeiro de 2023 em sunnyflunk.github.io, em um Intel NUC8i5BEK, encontrou a codificação flac 20,2% mais rápida e a descompressão bzip2 7,1% mais lenta na mesma rodada.
- A história do escalonador se divide em duas. O kernel padrão atual do CachyOS usa EEVDF, enquanto o BORE está disponível separadamente. Comparações entre distribuições de maio de 2026 encontraram pouca separação nos FPS médios e também mediram os 1% lows e o frame pacing, mas não isolaram o BORE nem adicionaram uma carga de CPU concorrente controlada. O desempenho em jogos logo após a instalação foi medido; o benefício do BORE sob disputa não foi isolado.
- A sensação de uma máquina mais rápida: experiência genuína, atribuição pouco confiável. Uma instalação limpa e a correção casual de um bug sem relação produzem, ambas, um sistema mais ágil que não deve nada aos níveis de conjunto de instruções. A exceção que vale conhecer é a comparação out-of-the-box da Phoronix em um Intel Core Ultra 9 285K, em que o CachyOS ficou à frente do Arch padrão em uma CPU que não consegue usar as otimizações AVX-512 de forma alguma.
O que o CachyOS realmente muda no seu sistema
O CachyOS é o Arch Linux com três modificações separadas empilhadas em cima: um kernel com patches que oferece escalonadores alternativos, repositórios cujos pacotes são recompilados para níveis mais novos de conjunto de instruções da CPU, e otimizações extras de compilador em um subconjunto de pacotes essenciais. Cada uma é um mecanismo distinto com um efeito distinto, e elas quase nunca são medidas separadamente.
O lado do kernel é a maior superfície. A lista de recursos do kernel do CachyOS cobre Clang ThinLTO, perfilamento AutoFDO, modos de preempção selecionáveis em tempo de execução e várias opções de escalonador. O pacote atual linux-cachyos usa um EEVDF ajustado pelo CachyOS como escalonador padrão. BORE e BMQ estão disponíveis em variantes separadas do kernel, enquanto o linux-cachyos-eevdf aplica um ajuste adicional de responsividade ao EEVDF e o linux-cachyos-server usa o EEVDF original. O sched-ext continua disponível nas variantes que o suportam.
Do lado dos pacotes, os repositórios x86-64-v3 do CachyOS são o mecanismo em questão. A página de repositórios otimizados do CachyOS descreve a recompilação dos pacotes do Arch para três alvos acima da base genérica: x86-64-v3, x86-64-v4 e um alvo dedicado Zen 4/5 que acrescenta mais extensões AVX-512, além de algumas instruções fora do AVX-512, por cima do v4. Um subconjunto de pacotes sensíveis a desempenho também recebe otimização guiada por perfil e BOLT.
Esses nomes de nível vêm da especificação de níveis de microarquitetura do psABI x86-64, e são portões, não botões de ajuste. O x86-64-v3 exige as instruções da era AVX e AVX2 que chegaram com o Haswell da Intel em 2013 e com os núcleos Excavator da AMD; o x86-64-v4 exige AVX-512, o que na prática significa chips Intel da classe Skylake-X e qualquer AMD Zen 4 ou mais recente. Uma CPU passa da barra ou não passa.
As três afirmações escondidas na palavra «mais rápido»
Quando duas pessoas discordam sobre se o CachyOS é mais rápido, geralmente as duas estão certas sobre coisas diferentes. Vazão, consistência de quadros e responsividade percebida são propriedades separadas, e nenhuma métrica única resolve as três. Uma tarefa cronometrada mede a vazão; medições de frame time e latência cobrem a fluidez em jogos; para o efeito mais amplo no nível do sistema é preciso uma comparação controlada com instalação limpa.
| A afirmação | O que está sendo afirmado | Como você mediria | O que as evidências mostram | Confiança |
|---|---|---|---|---|
| Vazão medida | Pacotes recompilados terminam a mesma tarefa em menos tempo | Cronometrar uma tarefa em hardware fixo e kernel fixo, mudando apenas o repositório de origem dos pacotes | Ganhos sólidos em trabalho vetorizável, pequenas regressões em vários pacotes, nenhuma mudança na maioria | Alta. A Canonical, o CentOS ISA SIG e dois benchmarkers independentes concordam no formato |
| Latência de entrada e consistência de quadros | O desktop continua responsivo enquanto outra coisa satura a CPU | Percentis de frame time e latência de entrada sob carga concorrente, não a taxa média de quadros | Os testes publicados agora incluem 1% lows e frame pacing, mas não isolam o escalonador nem introduzem uma carga de CPU concorrente controlada | Baixa. O mecanismo está documentado, a medição está faltando |
| Responsividade percebida | A máquina parece mais ágil depois da troca | Comparar com uma instalação limpa da distribuição anterior, não com a desgastada | Normalmente explicado por efeitos da instalação limpa ou por uma correção incidental; uma comparação out-of-the-box encontrou uma vantagem no nível da distribuição | Média. Experiência sólida, atribuição pouco confiável |
Uma suíte de benchmarks que responde à primeira linha não consegue responder à segunda, e nenhuma delas toca na terceira. Rodar uma das três e apresentar o resultado como veredito sobre as três é o que mantém a discussão viva.
Pacotes recompilados realmente rodam mais rápido?
Sim, em uma minoria do que um desktop executa, e o tamanho é definido pela carga de trabalho, não pela distribuição. Trabalho vetorizável tem ganhos de dois dígitos, um punhado de pacotes sai mais lento e a maioria não mostra nada. A página de repositórios otimizados do CachyOS coloca o ganho do x86-64-v3 entre 5% e 20% sobre o x86-64 genérico; as medições publicadas ficam em sua maioria na ponta de baixo.
A comparação de desempenho CachyOS vs Arch mais limpa isola a variável dos pacotes e nada mais: um teste em arch-chroot de janeiro de 2023 em sunnyflunk.github.io. O host rodava Arch padrão em um Intel NUC8i5BEK, os dois conjuntos de pacotes foram testados dentro de um arch-chroot para que kernel e ambiente permanecessem idênticos, e os benchmarks rodaram em RAM para eliminar a latência de disco. Contra os pacotes do Arch padrão, as builds do CachyOS foram 20,2% mais rápidas codificando flac em -8, 20,8% mais rápidas codificando vorbis e 9,5% mais rápidas no gzip -3. Na mesma rodada, foram 7,1% mais lentas descomprimindo bzip2, 1,6% a 2,9% mais lentas comprimindo com lz4, 3% mais lentas no pybench e sem alteração no benchmark de R. Duas ressalvas vêm do próprio autor: o CachyOS compilava com -march=x86-64-v3 -mpclmul -O3 contra o -march=x86-64 -O2do Arch, e seus testes de acompanhamento sugeriram que -O3 e não o nível de conjunto de instruções explicava parte dos ganhos maiores. O post é anterior ao repositório Zen 4 do CachyOS, que chegou com o lançamento de julho de 2024, mas não ao trabalho com BOLT: o autor interpreta o pacote Python do CachyOS por trás da regressão do pybench como já carregando BOLT sobre o x86-64-v3.
Os benchmarks do CachyOS em hardware mais novo repetem o padrão. Uma comparação de julho de 2024 em mvermeulen.org rodou um subconjunto da Phoronix Test Suite em um Ryzen 7940HS Zen 4, CachyOS com o repositório Zen 4 contra o Ubuntu 22.04. A maioria dos resultados ficou dentro de alguns pontos percentuais para um lado ou para o outro: coremark 6,4% mais lento, os subtestes do OpenSSL de cerca de 1% mais lentos a 4% mais rápidos, tempo de compilação do kernel 1,9% mais rápido, phpbench como ponto fora da curva com pouco mais que o dobro da pontuação. O autor aponta uma diferença de versão do GCC, 14.1 contra a 11.4 do Ubuntu, como provável fator de confusão. Sua rodada separada de NAMD em março de 2024 encontrou melhorias de 6,5% e 5,8% em duas cargas de dinâmica molecular.
Testes institucionais encontraram o mesmo quadro misto nas duas pontas. O próprio benchmarking x86-64-v3 da Canonical, publicado em março de 2024 com uma imagem experimental do Ubuntu 23.10 no Azure, relatou ganhos reproduzíveis de até 60% no benchmark Log2 da glibc enquanto outros benchmarks regrediram de forma significativa, em um caso porque ativar o v3 em código SSE já otimizado fez o compilador expandi-lo em 17 vezes mais instruções. A reconstrução do CentOS Stream 9 pelo CentOS ISA SIG de v2 para v3, em máquinas Intel da classe Ice Lake em agosto de 2023, chamou os resultados de «bastante mistos», com acelerações de 2,2x concentradas no Mocassin e no md5crypt do John the Ripper, ambos fortemente vetorizáveis, embora a equipe tenha creditado o ganho do Mocassin principalmente à autovetorização do GCC 12, e não ao nível de ISA.
Muitas bibliotecas matemáticas e criptográficas críticas para desempenho trazem várias versões de suas funções quentes e escolhem uma em tempo de execução por detecção de recursos da CPU, uma técnica chamada multiversionamento de funções e implementada na glibc por meio dos resolvedores IFUNC. Isso significa que alguns caminhos quentes já podem usar AVX2 em uma instalação padrão do Arch sem recompilar o pacote inteiro. O post do sunnyflunk viu isso diretamente, observando que o código-fonte do flac já inclui funções AVX2 de tempo de execução que não precisam de -march para serem ativadas. A descoberta do CentOS é a imagem espelhada: a equipe encontrou funções matemáticas da glibc sem versões IFUNC, que é exatamente onde uma reconstrução estática tem espaço para ajudar. O que uma reconstrução v3 alcança é o código restante que o autovetorizador do compilador consegue melhorar sozinho, o que é uma fatia de um desktop, e pequena.
O formato da carga de trabalho, não a etiqueta na CPU, decide se uma mudança no nível da máquina aparece. O veredito sobre vazão é sim, mas com limites: mudanças de um dígito são comuns nas medições acima, ganhos maiores se agrupam em cargas vetorizáveis como codificação e compressão, e alguns pacotes regridem. É uma descrição melhor do que tratar o x86-64-v3 como um multiplicador de velocidade para o sistema inteiro.
O que o escalonador muda, e por que os FPS médios não captam isso
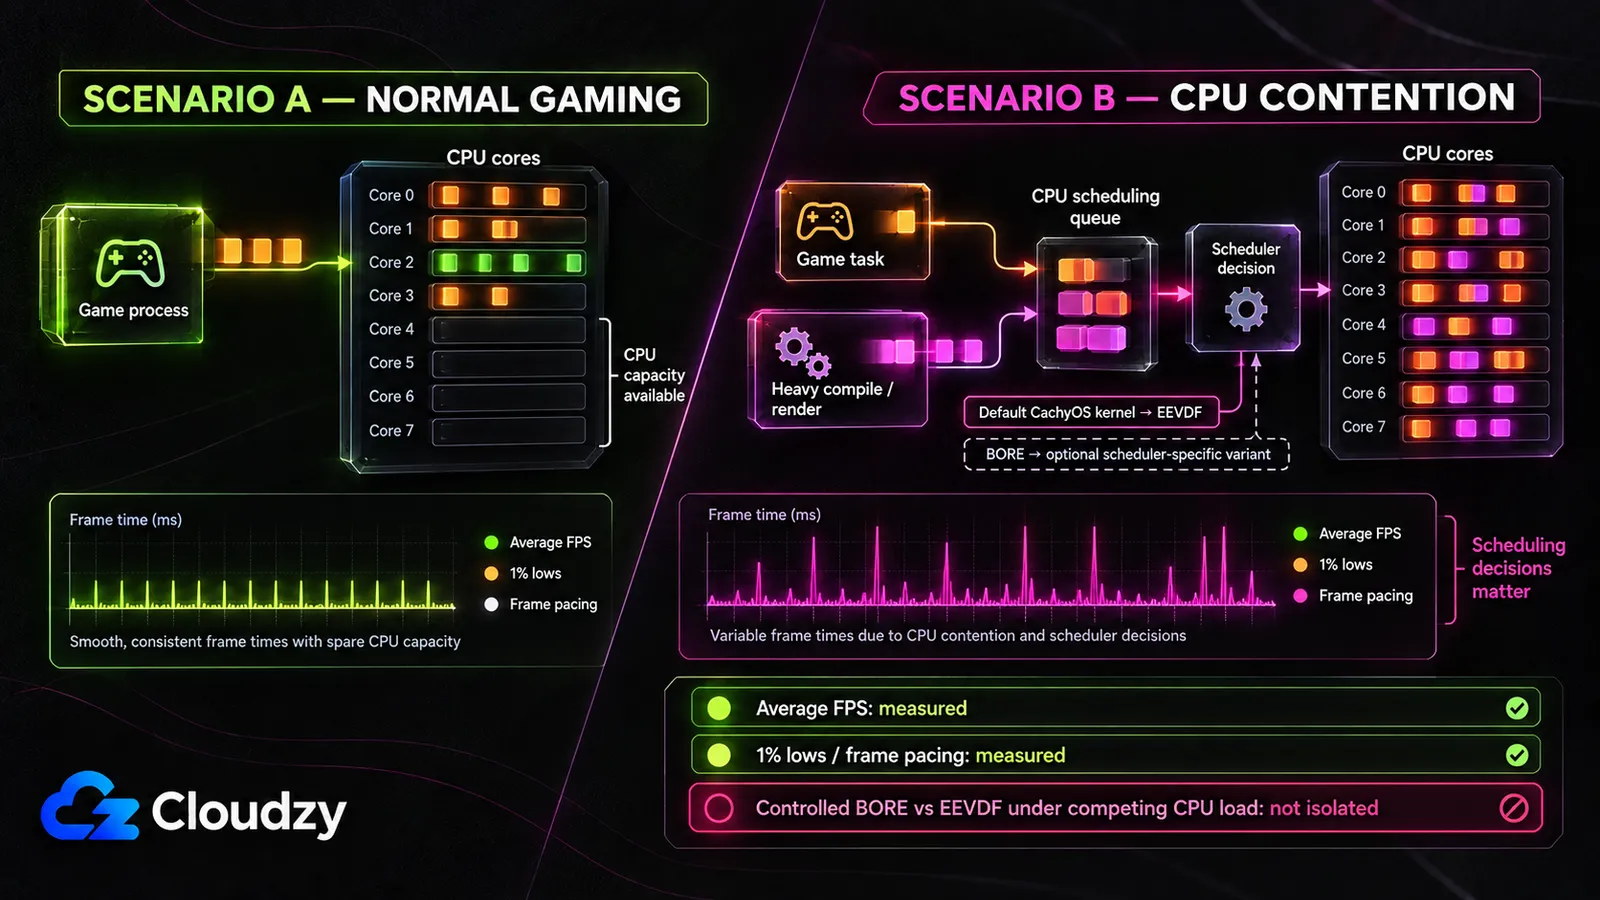
O kernel padrão atual do CachyOS, linux-cachyos , usa EEVDF, enquanto o BORE está disponível em variantes específicas de escalonador, como linux-cachyos-bore. Essa distinção importa porque as comparações de jogos abaixo são testes no nível da distribuição, não testes controlados de BORE contra EEVDF. O BORE continua relevante para a afirmação mais ampla de desempenho porque seu design mira explicitamente a responsividade sob cargas mistas, mas essa afirmação precisa ser avaliada separadamente do desempenho em jogos do CachyOS logo após a instalação.
O README do BORE declara a intenção sem rodeios:
Para isso, o BORE introduz uma dimensão de flexibilidade chamada «burstiness» para cada tarefa individual, afastando-se parcialmente do princípio de «justiça completa» inerente ao CFS.
firelzrd/bore-scheduler, README do projeto
Burstiness é o tempo de CPU que uma tarefa acumulou desde a última vez em que abriu mão da CPU dormindo, esperando E/S ou cedendo a vez. O BORE converte isso em uma pontuação e a usa para ajustar o peso de cada tarefa e a agressividade da sua preempção ao acordar, de modo que tarefas que cedem a vez com frequência são tratadas como interativas e favorecidas frente às tarefas que monopolizam sua fatia. O README nomeia a troca por conta própria: o BORE se acomoda em um «equilíbrio entre tarefas gulosas e fracas (geralmente tarefas em lote presas à CPU) e tarefas modestas e fortes (geralmente tarefas interativas presas à E/S)». Dar mais peso ao trabalho interativo é a mesma operação que dar menos peso ao trabalho de vazão em lote.
Isso diz qual instrumento detectaria a afirmação específica do BORE: introduzir uma carga de CPU concorrente e medir percentis de frame time ou latência de entrada mudando apenas o escalonador. Um escalonador tem muito menos o que arbitrar quando o jogo roda com capacidade de CPU ociosa.
Um benchmark com cinco jogos publicado em 16 de maio de 2026 usou instalações limpas de CachyOS e Omarchy no mesmo SSD e no mesmo hardware, uma RTX 5060 Ti e um Ryzen 9, com a mesma build do Proton-GE e configurações em 1440p. Os FPS médios diferiram em apenas um ou dois quadros. Dois dias depois, o mesmo testador publicou uma segunda comparação com registro completo de quadros pelo MangoHUD, acrescentando 5% lows, 1% lows e variância de frame pacing. Esse segundo teste usou hardware diferente, um Intel i7-13700 e uma Radeon RX 9060 XT, então é evidência adicional sobre consistência de quadros, e não uma extensão do primeiro teste no mesmo hardware. Nenhuma das comparações isola o escalonador da CPU nem acrescenta uma carga de CPU concorrente deliberada.
O projeto também não exagera. Em uma thread do r/cachyos sobre desempenho em jogos, Peter Jung, um dos desenvolvedores fundadores do CachyOS, respondeu diretamente a um usuário: «In gaming not all too much. The newer feature can make a difference tough :)» (em jogos, não tanto assim; o recurso mais novo pode fazer diferença, porém).
Isso deixa duas conclusões separadas. Para jogos no CachyOS logo após a instalação, os testes publicados mostram pouca separação nos FPS médios e agora incluem medições de 1% lows e frame pacing. Para o BORE especificamente sob disputa deliberada de CPU, não consegui encontrar um teste publicado controlado que mude apenas o escalonador e meça a responsividade sob essa carga.
Por que uma troca parece mais rápida mesmo quando nada mede mais rápido
Dois mecanismos produzem uma máquina mais ágil depois de uma troca de distribuição sem que nenhuma das otimizações do CachyOS esteja envolvida: a própria instalação limpa e a correção casual de um problema sem relação que o sistema anterior tinha. Os dois são específicos o bastante para serem reconhecidos no seu próprio caso, e é isso que os separa de uma acusação genérica de placebo.
Comece pela instalação limpa. Em uma thread do r/linuxquestions sobre a questão, um usuário do CachyOS que disse não ter notado diferença ele mesmo sugeriu que quem relata grandes ganhos talvez esteja comparando com uma instalação bem usada em vez de uma limpa. Anos de entradas de inicialização automática acumuladas, serviços órfãos, configuração à deriva e um disco cheio são uma carga de trabalho, e uma partição limpa remove tudo isso de uma vez. Uma troca de distribuição move o kernel, o ambiente de desktop, cada versão de pacote e cada padrão ao mesmo tempo, e uma comparação completa entre Manjaro e Ubuntu se estende por uma dúzia de eixos distintos. Atribuir uma melhoria a um deles depois é chute.
A correção casual é o caso mais nítido. Na mesma thread, um comentarista descreveu usar o Fedora no dia a dia com um problema de gerenciamento de VRAM que degradava seriamente o desempenho, trocar para o CachyOS e ver o problema desaparecer. Depois ele passou para o Arch puro e relatou basicamente o mesmo desempenho do CachyOS, concluindo que já não sabia o que tinha sido diferente. A melhoria era real; os alvos de compilação do CachyOS não tinham nada a ver com isso.
Nada disso autoriza um desmentido limpo, e a evidência mais forte contra um desmentido é um teste controlado. A comparação de distribuições no Arrow Lake da Phoronix colocou Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux e CachyOS no mesmo Intel Core Ultra 9 285K em seus estados padrão, e o CachyOS passou à frente de todos, inclusive do Clear Linux, que normalmente lidera em silício Intel. O Arrow Lake não tem suporte a AVX-512, então essa vantagem não pode vir do x86-64-v4; ela reflete alguma combinação das escolhas de kernel e de build do CachyOS, das otimizações de pacotes e da configuração padrão.
A experiência pode ser genuína enquanto a atribuição permanece incerta. A comparação do Arrow Lake da Phoronix é um contraexemplo útil: uma instalação do CachyOS em estado padrão pode superar o Arch padrão mesmo quando o x86-64-v4 não está disponível.
Como verificar se algo disso se aplica à sua máquina
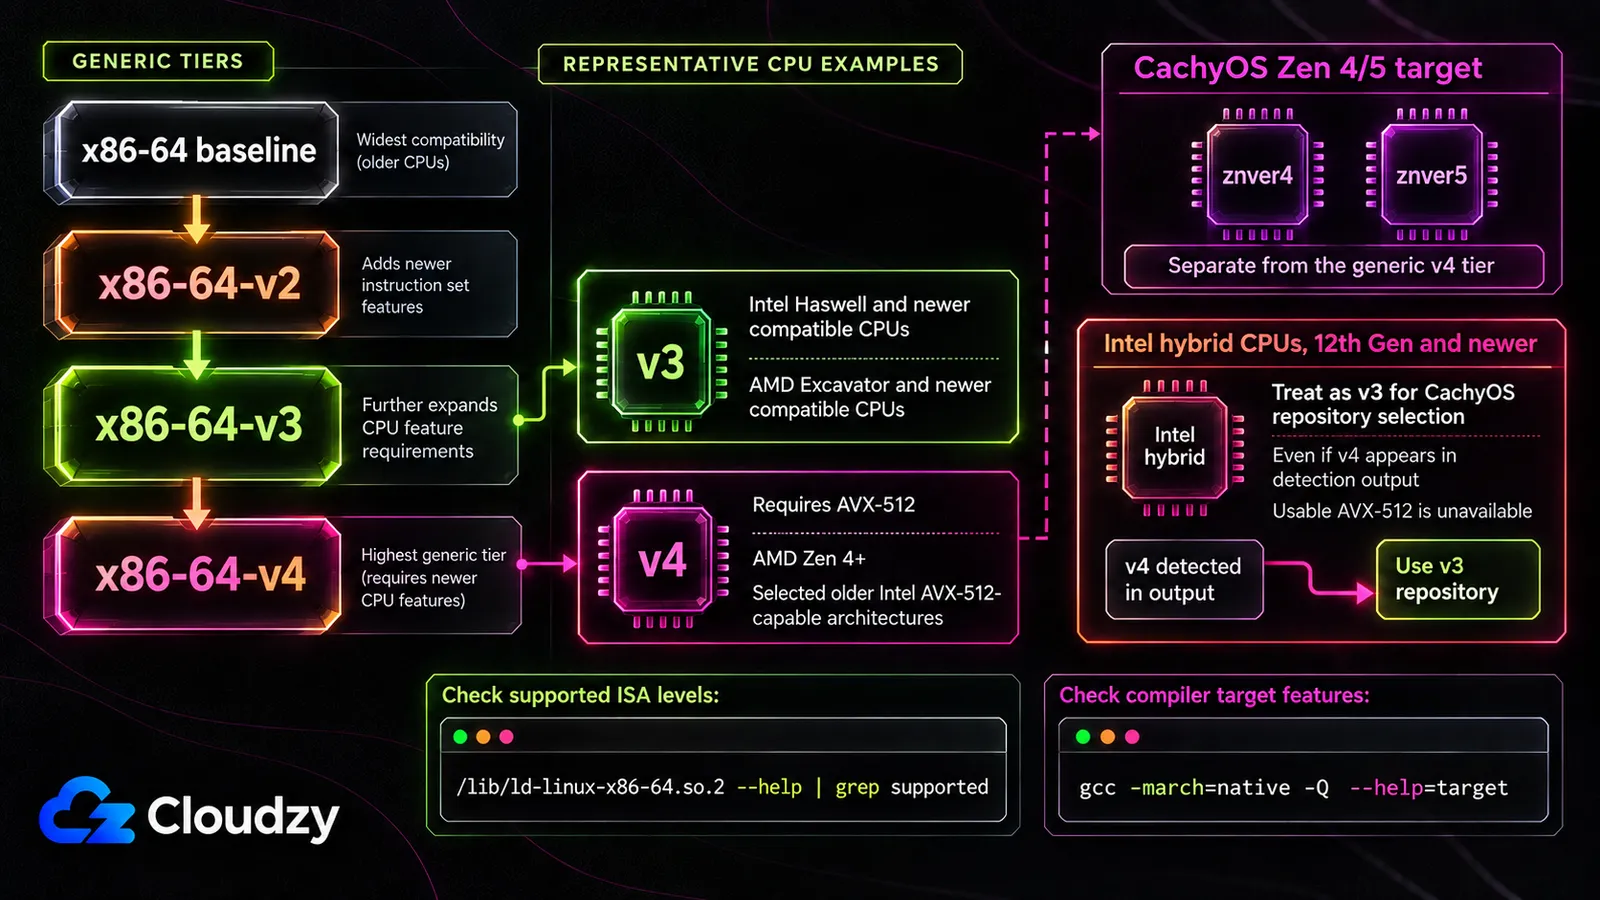
Qual nível padronizado de microarquitetura x86-64 sua CPU suporta é quase todo respondido com um comando. O vinculador dinâmico informa os níveis glibc-hwcaps que consegue usar, então a entrada x86-64-vN mais alta suportada normalmente diz se a CPU se qualifica para o nível de repositório genérico v2, v3 ou v4. Uma exceção importante são as CPUs híbridas da Intel de 12ª geração em diante: o CachyOS orienta tratá-las como v3 mesmo que v4 apareça na saída, porque o AVX-512 não é utilizável nelas. O alvo separado Zen 4/5 do CachyOS também precisa da sua própria verificação de arquitetura.
/lib/ld-linux-x86-64.so.2 --help | grep supportedPara AMD Zen 4/5, o CachyOS também documenta:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"O primeiro comando imprime algo assim:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Essa é uma CPU com v3 e v2, mas sem AVX-512. Três resultados, três decisões:
- Nada acima de x86-64-v2. A vantagem das reconstruções v3/v4/específicas de Zen não se aplica a esta CPU. O CachyOS ainda pode rodar, e otimizações de compilador específicas de pacote, além de mudanças de kernel e configuração padrão, ainda podem fazer diferença.
- x86-64-v3 suportado, x86-64-v4 indisponível. Isso inclui CPUs híbridas modernas da Intel, como o Arrow Lake, para fins práticos de escolha de repositório. Nas comparações citadas acima, muitas mudanças foram pequenas, algumas cargas de codificação e compressão ganharam bem mais, e alguns pacotes regrediram.
- x86-64-v4 suportado. O AVX-512 cria mais margem teórica para cargas vetorizáveis, mas não garante um grande ganho em todo o sistema.
Se sua CPU se qualifica e a metade dos pacotes é o que você quer, não precisa reinstalar para obtê-la. Os repositórios do CachyOS podem ser adicionados a um sistema Arch existente, e o ALHP publica reconstruções dos repositórios oficiais do Arch em cada nível x86-64-vN, documentadas na Arch Wiki com suas próprias ressalvas: pacotes DKMS são necessários no lugar de módulos de kernel vinculados diretamente, e definir -march para a compilação do kernel «não traria nenhum resultado significativo». Qualquer um dos caminhos entrega os pacotes recompilados e nada do conjunto de patches do kernel ou das variantes de escalonador.
Rode o comando primeiro. Ele converte uma discussão sobre distribuições em um fato sobre a sua própria máquina, que é a única versão desta pergunta que você consegue resolver sozinho hoje à noite.

Construa num VPS Linux com acesso root, NVMe e o poder do AMD EPYC.
Ver planos LinuxPerguntas frequentes
O CachyOS realmente melhora o desempenho em jogos?
Na taxa média de quadros, quase nada. Uma comparação com cinco jogos de maio de 2026 encontrou apenas uma diferença de um a dois quadros, e um acompanhamento dois dias depois também mediu 1% lows e frame pacing. Nenhum dos testes introduziu uma carga de CPU concorrente deliberada, então a questão em aberto é a responsividade do escalonador sob disputa, não se o frame pacing foi medido.
Minha CPU suporta x86-64-v3 ou v4?
No CachyOS ou no Arch, rode /lib/ld-linux-x86-64.so.2 --help | grep supported para ver os níveis glibc-hwcaps padronizados detectados para sua CPU. O x86-64-v3 exige o conjunto de recursos da era AVX/AVX2, enquanto o v4 acrescenta AVX-512. Para CPUs híbridas da Intel de 12ª geração em diante, o CachyOS recomenda tratar o sistema como v3 mesmo que v4 apareça na saída; usuários de Zen 4/5 também devem verificar o alvo separado znver4/znver5.
Por que os pacotes recompilados não fazem uma diferença maior?
Porque parte do código altamente otimizado já é despachada em tempo de execução para implementações específicas de CPU. Bibliotecas matemáticas e criptográficas costumam usar multiversionamento de funções ou IFUNC nas funções quentes, então recompilar pacotes ajuda principalmente o código que o compilador ainda consegue otimizar ou vetorizar globalmente.
Posso obter os pacotes otimizados do CachyOS sem trocar de distribuição?
Sim. Os repositórios do CachyOS podem ser adicionados a uma instalação existente do Arch Linux, e o projeto ALHP publica reconstruções dos repositórios oficiais do Arch para x86-64-v2, v3 e v4, documentadas na Arch Wiki. Os dois entregam apenas os pacotes recompilados, não o conjunto de patches do kernel do CachyOS, os escalonadores alternativos ou os padrões do instalador.
Discussão
Comentários
Inicie sessão para participar na discussão.