
En bruger på r/linuxquestions lavede den sammenligning, alle bliver ved med at skændes om. Han installerede CachyOS, benchmarkede flere spil på en Ryzen 7 7800X3D med et Radeon RX 7900 XTX og målte ingen forskel i forhold til de andre distributioner, der allerede lå på maskinen. Svarene gik, som de altid går. Én kommentator satte loftet så lavt, at det er usynligt i normal brug. En anden forklarede scheduleren. En tredje sagde, at benchmarks ikke kan vise, hvad scheduleren gør. Ingen leverede den måling, der ville afgøre sagen.
Spørgsmålet vender tilbage med de samme ord: er CachyOS virkelig hurtigere? Det korte svar er ja, i bestemte arbejdsbyrder. Rekompilerede pakker kan hjælpe kode, som compileren kan vektorisere, de spilsammenligninger, der citeres her, viser lille forskel i gennemsnitlig FPS, og et system, der føles hurtigere efter skiftet, er sværere at tilskrive noget bestemt, fordi et distroskift ændrer langt mere end én variabel.
Det forbliver uafklaret, fordi „hurtigere“ rummer tre separate påstande med tre forskellige svar, som hver kræver sit eget måleinstrument. Rekompilerede pakker fuldfører enten en opgave på kortere vægurstid, eller også gør de ikke. En scheduler ændrer enten, hvordan skrivebordet opfører sig under belastning, eller også gør den ikke. Og en kvikkere maskine kan enten spores tilbage til CachyOS eller til noget, der kom med samtidig.
Den korte version
- Rekompilerede pakker: målbart hurtigere, for et mindretal af det, du kører. Gevinsterne koncentrerer sig i kode, som compileren kan vektorisere, flere pakker bliver langsommere, og de fleste ændrer sig ikke. En arch-chroot-sammenligning fra januar 2023 på sunnyflunk.github.io, på en Intel NUC8i5BEK, fandt flac-kodning 20,2 % hurtigere og bzip2-dekomprimering 7,1 % langsommere i samme kørsel.
- Scheduler-historien deler sig i to. CachyOS' nuværende standardkerne bruger EEVDF, mens BORE er tilgængelig separat. Distributionssammenligninger fra maj 2026 fandt lille forskel i gennemsnitlig FPS og målte også 1 %-lows og frame pacing, men de isolerede ikke BORE eller tilføjede en kontrolleret konkurrerende CPU-belastning. Spil ud af boksen er blevet målt; BOREs fordel under belastning er ikke blevet isoleret.
- Følelsen af en hurtigere maskine: ægte oplevelse, upålidelig tilskrivning. En frisk installation og en tilfældig rettelse af en urelateret fejl giver begge et kvikkere system, som ikke skylder instruktionssæt-niveauer noget. Undtagelsen, der er værd at kende, er Phoronix' ud-af-boksen-sammenligning på en Intel Core Ultra 9 285K, hvor CachyOS kom foran standard-Arch på en CPU, der slet ikke kan bruge AVX-512-optimeringerne.
Hvad CachyOS faktisk ændrer ved dit system
CachyOS er Arch Linux med tre separate ændringer stablet ovenpå: en patchet kerne med alternative schedulere, repositories hvis pakker er rekompileret til nyere CPU-instruktionssæt-niveauer, og ekstra compiler-optimeringer på en delmængde af kernepakkerne. Hver er en særskilt mekanisme med en særskilt effekt, og de måles næsten aldrig hver for sig.
Kernesiden er den største flade. CachyOS' liste over kernefunktioner dækker Clang ThinLTO, AutoFDO-profilering, preemption-tilstande der kan vælges under kørsel, og flere scheduler-muligheder. Den nuværende linux-cachyos -pakke bruger CachyOS-tunet EEVDF som standardscheduler. BORE og BMQ er tilgængelige via separate kernevarianter, mens linux-cachyos-eevdf tilføjer ekstra EEVDF-tuning for responsivitet, og linux-cachyos-server bruger standard-EEVDF. sched-ext er fortsat tilgængelig på de varianter, der understøtter den.
På pakkesiden er CachyOS' x86-64-v3-repositories den mekanisme, det handler om. CachyOS' side om optimerede repositories beskriver genopbygning af Arch-pakker til tre mål over den generiske basis: x86-64-v3, x86-64-v4 og et dedikeret Zen 4/5-mål, der oven på v4 tilføjer yderligere AVX-512-udvidelser samt nogle instruktioner uden for AVX-512. En delmængde af ydelsesfølsomme pakker får også profilstyret optimering og BOLT.
Niveaunavnene kommer fra x86-64 psABI-specifikationen for mikroarkitekturniveauer, og de er tærskler, ikke drejeknapper. x86-64-v3 kræver instruktionerne fra AVX- og AVX2-æraen, som kom med Intels Haswell i 2013 og AMD's Excavator-kerner; x86-64-v4 kræver AVX-512, hvilket i praksis betyder Intel-chips i Skylake-X-klassen og alle AMD Zen 4 eller nyere. En CPU kommer enten over barren eller gør det ikke.
De tre påstande, der gemmer sig i ordet „hurtigere“
Når to personer er uenige om, hvorvidt CachyOS er hurtigere, har de som regel begge ret om forskellige ting. Gennemløb, frame-konsistens og oplevet responsivitet er separate egenskaber, og ingen enkelt metrik afgør alle tre. En tidtaget opgave måler gennemløb; frametime- og latensmålinger dækker jævnheden i spil; en kontrolleret sammenligning med frisk installation er nødvendig for den bredere effekt på systemniveau.
| Påstanden | Hvad der hævdes | Hvordan du ville måle det | Hvad evidensen viser | Sikkerhed |
|---|---|---|---|---|
| Målt gennemløb | Rekompilerede pakker fuldfører samme opgave på kortere tid | Tag tid på én opgave på fast hardware og en fast kerne, og skift kun hvilket repository pakkerne kom fra | Solide gevinster på vektoriserbart arbejde, små regressioner på flere pakker, ingen ændring på de fleste | Høj. Canonical, CentOS ISA SIG og to uafhængige benchmarkere er enige om mønstret |
| Inputlatens og frame-konsistens | Skrivebordet forbliver responsivt, mens noget andet mætter CPU'en | Frametime-percentiler og inputlatens under en konkurrerende belastning, ikke gennemsnitlig billedhastighed | Offentliggjorte tests inkluderer nu 1 %-lows og frame pacing, men de isolerer ikke scheduleren eller indfører en kontrolleret konkurrerende CPU-belastning | Lav. Mekanismen er dokumenteret, målingen mangler |
| Oplevet responsivitet | Maskinen føles kvikkere efter skiftet | Sammenlign med en frisk installation af den tidligere distribution, ikke den slidte | Normalt forklaret ved frisk-installations-effekter eller en tilfældig rettelse; én ud-af-boksen-sammenligning fandt et forspring på distributionsniveau | Middel. Reel oplevelse, upålidelig tilskrivning |
En benchmark-suite, der besvarer første række, kan ikke besvare den anden, og ingen af dem rører den tredje. At køre én af de tre og rapportere resultatet som en dom over alle tre er det, der holder tråden i gang.
Kører rekompilerede pakker virkelig hurtigere?
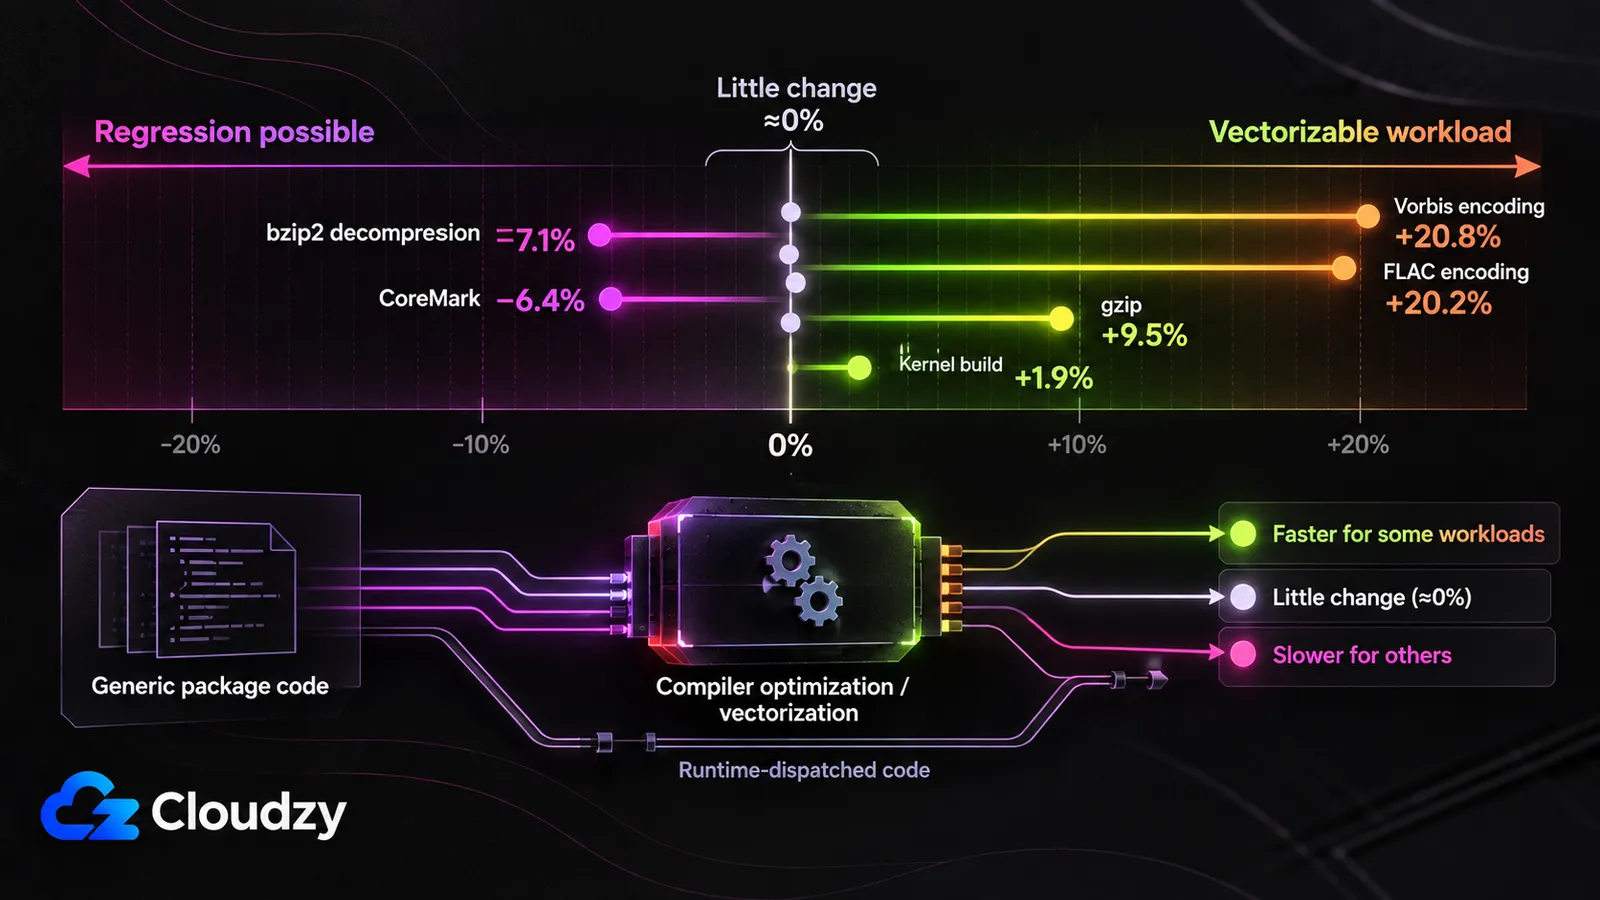
Ja, for et mindretal af det, et skrivebord kører, og størrelsen bestemmes af arbejdsbyrden, ikke distributionen. Vektoriserbart arbejde får tocifrede gevinster, en håndfuld pakker bliver langsommere, og de fleste viser ingenting. CachyOS' side om optimerede repositories sætter x86-64-v3-gevinsten til 5 % til 20 % over generisk x86-64; offentliggjorte målinger ligger mest i den lave ende.
Den reneste CachyOS vs Arch-ydelsessammenligning isolerer pakkevariablen og intet andet: en arch-chroot-test fra januar 2023 på sunnyflunk.github.io. Værten kørte standard-Arch på en Intel NUC8i5BEK, begge pakkesæt blev testet inde i en arch-chroot, så kernen og miljøet forblev identiske, og benchmarkene kørte i RAM for at fjerne disklatens. Mod standard-Arch-pakkerne var CachyOS-byggene 20,2 % hurtigere til at kode flac med -8, 20,8 % hurtigere til at kode vorbis og 9,5 % hurtigere på gzip -3. I samme kørsel var de 7,1 % langsommere til at dekomprimere bzip2, 1,6 % til 2,9 % langsommere til at komprimere med lz4, 3 % langsommere på pybench og uændret på R-benchmarken. To forbehold kommer fra forfatteren selv: CachyOS byggede med -march=x86-64-v3 -mpclmul -O3 mod Archs -march=x86-64 -O2, og hans opfølgende tests antydede, at -O3 snarere end instruktionssæt-niveauet stod for nogle af de større gevinster. Indlægget ligger før CachyOS' Zen 4-repository, som kom med udgivelsen i juli 2024, men ikke før BOLT-arbejdet: forfatteren læser CachyOS' Python-pakke bag pybench-regressionen som allerede udstyret med BOLT oven på x86-64-v3.
CachyOS-benchmarkene på nyere hardware gentager mønstret. En sammenligning fra juli 2024 på mvermeulen.org kørte en delmængde af Phoronix Test Suite på en Zen 4 Ryzen 7940HS, CachyOS med Zen 4-repositoryet mod Ubuntu 22.04. De fleste resultater landede inden for få procent i begge retninger: coremark 6,4 % langsommere, OpenSSL-deltestene fra omkring 1 % langsommere til 4 % hurtigere, kernebyggetid 1,9 % hurtigere, phpbench som en outlier med lidt over dobbelt score. Forfatteren fremhæver en GCC-versionsforskel, 14.1 mod Ubuntus 11.4, som en sandsynlig fejlkilde. Hans separate NAMD-kørsel i marts 2024 fandt forbedringer på 6,5 % og 5,8 % på to molekylærdynamik-arbejdsbyrder.
Institutionel testning fandt det samme blandede billede i begge ender. Canonicals egen x86-64-v3-benchmarking, offentliggjort i marts 2024 med et eksperimentelt Ubuntu 23.10-image på Azure, rapporterede reproducerbare gevinster på op til 60 % på glibc Log2-benchmarken, mens andre benchmarks gik markant tilbage, i ét tilfælde fordi aktivering af v3 på allerede optimeret SSE-kode fik compileren til at udvide den til 17 gange flere instruktioner. CentOS ISA SIG's genopbygning af CentOS Stream 9 fra v2 til v3, på Intel-maskiner i Ice Lake-klassen i august 2023, kaldte resultaterne „temmelig blandede“, med 2,2x hastighedsforøgelser koncentreret i Mocassin og John the Rippers md5crypt, begge vektoriseringstunge, selvom holdet tilskrev Mocassins gevinst hovedsageligt GCC 12's autovektorisering snarere end ISA-niveauet.
Mange ydelseskritiske matematik- og kryptografibiblioteker leverer flere versioner af deres hot functions og vælger én under kørsel via CPU-funktionsdetektion, en teknik kaldet function multiversioning, implementeret i glibc via IFUNC-resolvere. Det betyder, at nogle hot paths allerede kan bruge AVX2 på en standard-Arch-installation uden at genopbygge hele pakken. Sunnyflunk-indlægget så det direkte og bemærkede, at flacs kildekode allerede indeholder AVX2-runtime-funktioner, der ikke behøver -march for at blive aktiveret. CentOS-fundet er spejlbilledet: holdet opdagede glibc-matematikfunktioner uden IFUNC-versioner, hvilket er præcis dér, en statisk genopbygning har plads til at hjælpe. Det, en v3-genopbygning når, er den resterende kode, som compilerens autovektorisator kan forbedre på egen hånd, og det er en skive af et skrivebord, og en lille en.
Arbejdsbyrdens form, ikke mærkatet på CPU'en, afgør, om en ændring på maskinniveau overhovedet viser sig. Dommen over gennemløb er ja, men afgrænset: encifrede ændringer er almindelige i målingerne ovenfor, større gevinster klumper sig om vektoriserbare arbejdsbyrder som kodning og komprimering, og nogle pakker går tilbage. Det er en bedre beskrivelse end at behandle x86-64-v3 som en systemdækkende hastighedsmultiplikator.
Hvad scheduleren ændrer, og hvorfor gennemsnitlig FPS overser det
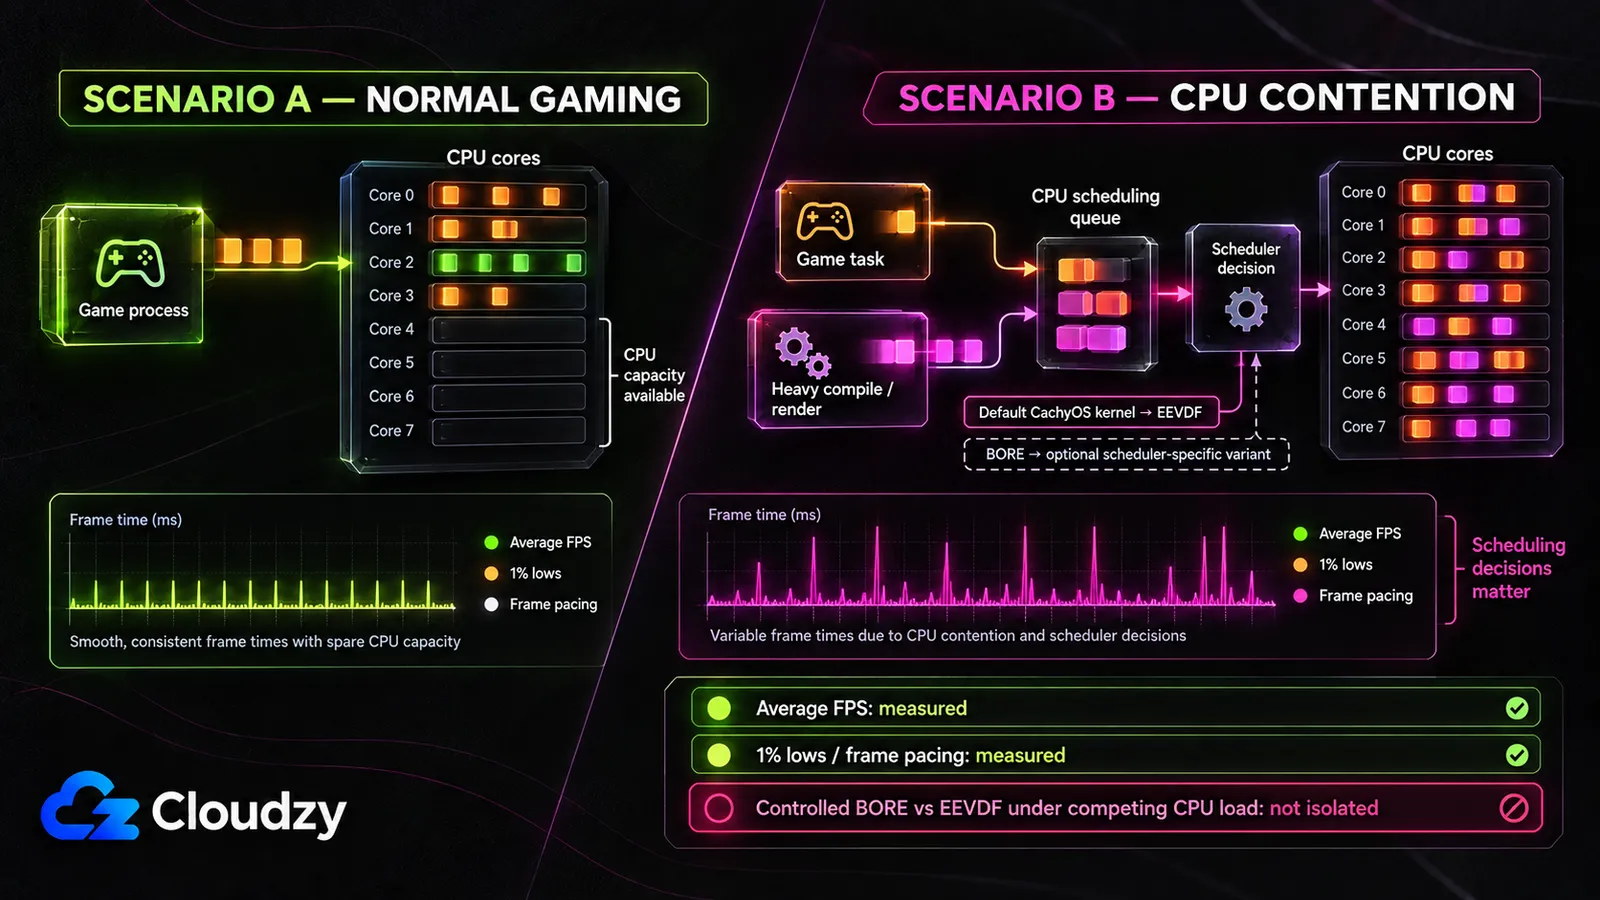
CachyOS' nuværende standardkerne, linux-cachyos , bruger EEVDF, mens BORE er tilgængelig via scheduler-specifikke varianter som linux-cachyos-bore. Den skelnen er vigtig, fordi spilsammenligningerne nedenfor er tests på distributionsniveau, ikke kontrollerede BORE-mod-EEVDF-tests. BORE er stadig relevant for den bredere ydelsespåstand, fordi dens design udtrykkeligt sigter mod responsivitet under blandede arbejdsbyrder, men den påstand skal vurderes adskilt fra CachyOS' spilydelse ud af boksen.
BOREs egen README siger hensigten ligeud:
For at opnå dette introducerer BORE en dimension af fleksibilitet kendt som „burstiness“ for hver enkelt opgave og afviger delvist fra CFS' iboende princip om „fuldstændig fairness“.
firelzrd/bore-scheduler, projektets README
Burstiness er den CPU-tid, en opgave har akkumuleret, siden den sidst afgav CPU'en ved at sove, vente på I/O eller give afkald. BORE omregner det til en score og bruger den til at justere hver opgaves vægt og aggressiviteten af dens wakeup-preemption, så opgaver, der bliver ved med at give afkald, behandles som interaktive og favoriseres over for opgaver, der bruger hele deres tidsskive. README'en nævner selv afvejningen: BORE lander i en „ligevægt mellem modsatrettede grådige og svage opgaver (typisk CPU-bundne batchopgaver) og beskedne og stærke opgaver (typisk I/O-bundne interaktive opgaver)“. At vægte interaktivt arbejde op er den samme operation som at vægte batch-gennemløbsarbejde ned.
Det fortæller dig, hvilket instrument der ville påvise BOREs specifikke påstand: indfør en konkurrerende CPU-belastning og mål frametime-percentiler eller inputlatens, mens du kun ændrer scheduleren. En scheduler har langt mindre at fordele, når spillet kører med ledig CPU-kapacitet.
En fem-spils-benchmark offentliggjort den 16. maj 2026 brugte rene CachyOS- og Omarchy-installationer på samme SSD og hardware, et RTX 5060 Ti og en Ryzen 9, med samme Proton-GE-build og 1440p-indstillinger. Gennemsnitlig FPS afveg kun med et eller to billeder. To dage senere offentliggjorde samme tester en anden sammenligning med fuld MangoHUD-frame-logning, som tilføjede 5 %-lows, 1 %-lows og frame-pacing-varians. Den anden test brugte anden hardware, en Intel i7-13700 og et Radeon RX 9060 XT, så den er yderligere evidens om frame-konsistens snarere end en udvidelse af den første test på samme hardware. Ingen af sammenligningerne isolerer CPU-scheduleren eller tilføjer en bevidst konkurrerende CPU-arbejdsbyrde.
Projektet oversælger det heller ikke. I en r/cachyos-tråd om spilydelse, Peter Jung, en af CachyOS' grundlæggende udviklere, svarede en bruger direkte: „In gaming not all too much. The newer feature can make a difference tough :)“ (i spil ikke så meget; den nyere funktion kan dog gøre en forskel).
Det efterlader to separate konklusioner. For CachyOS-spil ud af boksen viser offentliggjorte tests lille forskel i gennemsnitlig FPS og inkluderer nu målinger af 1 %-lows og frame pacing. For BORE specifikt under bevidst CPU-belastning kunne jeg ikke finde en kontrolleret offentliggjort test, der kun ændrer scheduleren og måler responsivitet under den belastning.
Hvorfor et skift føles hurtigere, selv når intet måler hurtigere
To mekanismer giver en kvikkere maskine efter et distroskift, uden at nogen af CachyOS' optimeringer er involveret: den friske installation i sig selv og en tilfældig rettelse af et urelateret problem, som det tidligere system havde. Begge er specifikke nok til at genkende i ens eget tilfælde, og det er det, der adskiller dem fra en generel anklage om placebo.
Start med den friske installation. I en r/linuxquestions-tråd om spørgsmåletforeslog en CachyOS-bruger, der sagde, at han ikke selv havde bemærket en forskel, at folk, der rapporterer store gevinster, måske sammenligner med en velbrugt installation snarere end en frisk. Årevis af ophobede autostart-poster, forældreløse tjenester, drevet konfiguration og en fuld disk er en arbejdsbyrde, og en ren partition fjerner det hele på én gang. Et distroskift flytter kernen, skrivebordsmiljøet, hver pakkeversion og hver standardindstilling samtidig, og en fuld Manjaro-mod-Ubuntu-sammenligning strækker sig over et dusin separate akser. At tilskrive en forbedring til én af dem bagefter er gætværk.
Den tilfældige rettelse er det skarpere tilfælde. I samme tråd beskrev en kommentator at bruge Fedora dagligt med et VRAM-håndteringsproblem, der forringede ydelsen alvorligt, skifte til CachyOS og se problemet forsvinde. Han gik derefter til rent Arch og rapporterede stort set samme ydelse som CachyOS og konkluderede, at han ikke længere vidste, hvad der havde været anderledes. Forbedringen var reel; CachyOS' kompileringsmål havde intet med det at gøre.
Ingen af delene berettiger en ren afvisning, og det stærkeste bevis mod en sådan er en kontrolleret test. Phoronix' Arrow Lake-distributionssammenligning satte Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux og CachyOS på den samme Intel Core Ultra 9 285K i deres standardtilstand, og CachyOS sneg sig forbi dem alle, inklusive Clear Linux, som normalt fører på Intel-silicium. Arrow Lake har ingen AVX-512-understøttelse, så det forspring kan ikke komme fra x86-64-v4; det afspejler en kombination af CachyOS' kerne- og byggevalg, pakkeoptimeringer og standardkonfiguration.
Oplevelsen kan være ægte, mens tilskrivningen forbliver usikker. Phoronix' Arrow Lake-sammenligning er et nyttigt modeksempel: en CachyOS-installation i standardtilstand kan overgå standard-Arch, selv når x86-64-v4 ikke er tilgængelig.
Sådan tjekker du, om noget af dette gælder din maskine
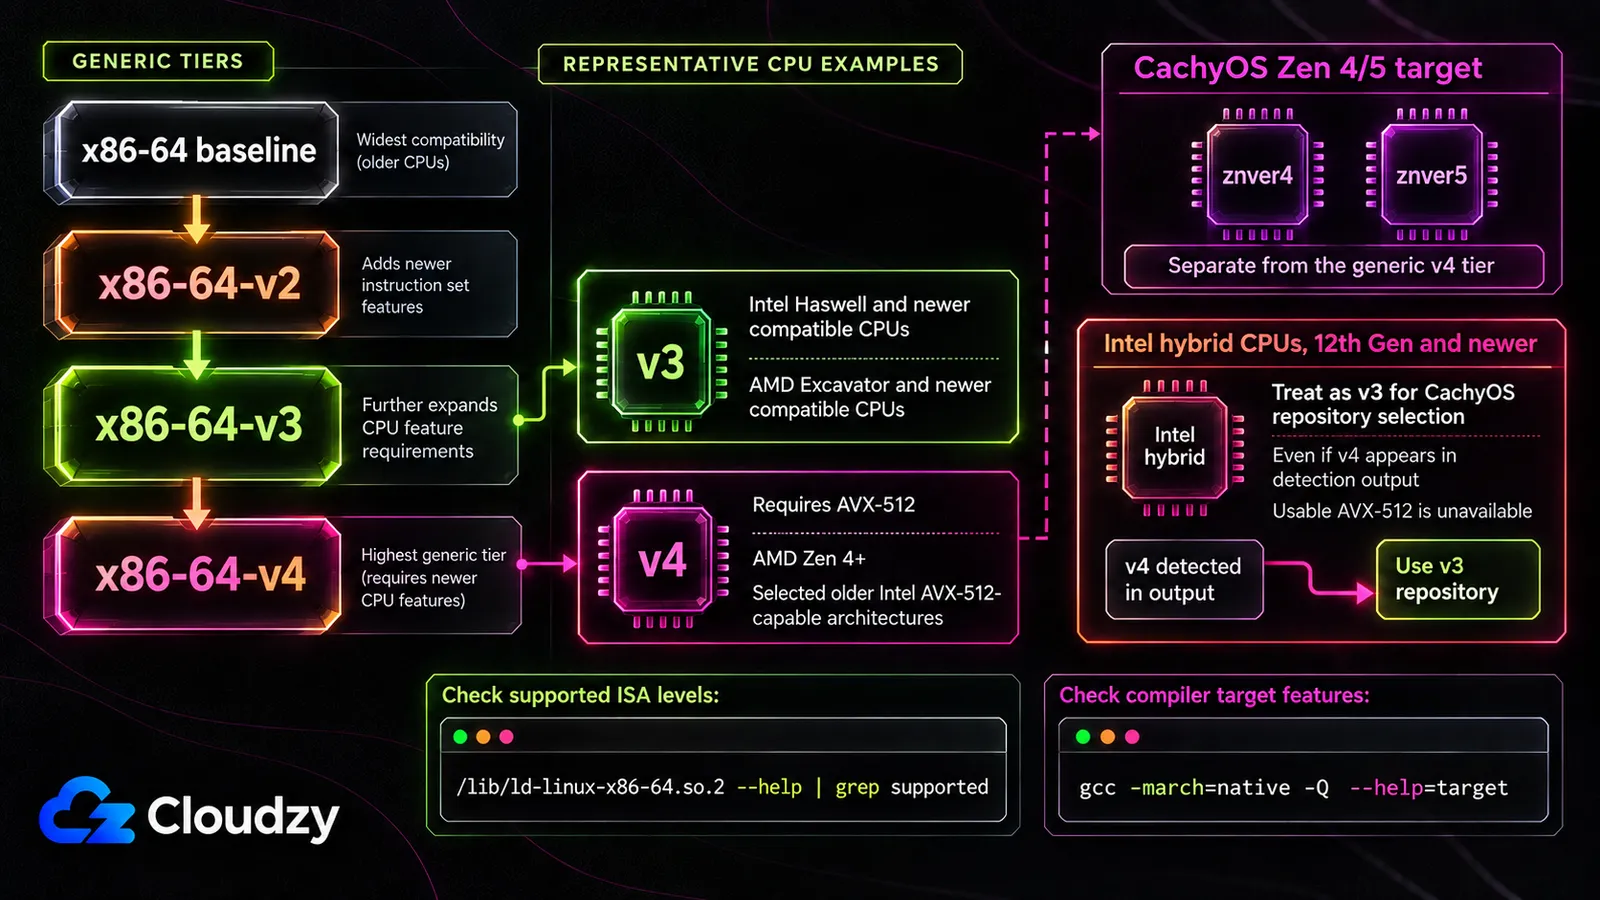
Hvilket standardiseret x86-64-mikroarkitekturniveau din CPU understøtter, kan for det meste besvares med én kommando. Den dynamiske linker rapporterer de glibc-hwcaps-niveauer, den kan bruge, så den højeste understøttede x86-64-vN-post fortæller normalt, om CPU'en kvalificerer sig til det generiske v2-, v3- eller v4-repository-niveau. Én vigtig undtagelse er Intels hybrid-CPU'er fra 12. generation og nyere: CachyOS siger, at de skal behandles som v3, selv hvis v4 optræder i outputtet, fordi AVX-512 ikke kan bruges der. CachyOS' separate Zen 4/5-mål kræver også sit eget arkitekturtjek.
/lib/ld-linux-x86-64.so.2 --help | grep supportedFor AMD Zen 4/5 dokumenterer CachyOS også:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Den første kommando udskriver noget i denne stil:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Det er en CPU med v3 og v2, men uden AVX-512. Tre udfald, tre beslutninger:
- Intet over x86-64-v2. Fordelen ved v3/v4/Zen-specifik genopbygning gælder ikke denne CPU. CachyOS kan stadig køre, og pakkespecifikke compiler-optimeringer samt kerne- og standardkonfigurationsændringer kan stadig have betydning.
- x86-64-v3 understøttet, x86-64-v4 ikke tilgængelig. Dette omfatter moderne Intel hybrid-CPU'er som Arrow Lake i forhold til praktisk repository-valg. I de sammenligninger, der citeres ovenfor, var mange ændringer små, nogle kodnings- og komprimeringsarbejdsbyrder vandt langt mere, og nogle pakker gik tilbage.
- x86-64-v4 understøttet. AVX-512 skaber mere teoretisk råderum for vektoriserbare arbejdsbyrder, men det garanterer ikke en stor systemdækkende gevinst.
Hvis din CPU kvalificerer sig, og pakkehalvdelen er det, du vil have, behøver du ikke geninstallere for at få den. CachyOS' repositories kan tilføjes til et eksisterende Arch-system, og ALHP udgiver genopbygninger af de officielle Arch-repositories på hvert x86-64-vN-niveau, dokumenteret på Arch Wiki med sine egne forbehold: DKMS-pakker kræves i stedet for direkte linkede kernemoduler, og at sætte -march for kernekompilering „ville ikke give nogen nævneværdige resultater“. Begge veje giver dig de rekompilerede pakker og intet af kerne-patchsættet eller scheduler-varianterne.
Kør kommandoen først. Den forvandler et skænderi om distributioner til et faktum om din egen maskine, og det er den eneste version af dette spørgsmål, du selv kan afgøre i aften.

Byg på en Linux VPS med root-adgang, NVMe og AMD EPYC-kraft.
Se Linux-planerOfte stillede spørgsmål
Forbedrer CachyOS virkelig spilydelsen?
For gennemsnitlig billedhastighed knap nok. En fem-spils-sammenligning fra maj 2026 fandt kun en forskel på et til to billeder, og en opfølgning to dage senere målte også 1 %-lows og frame pacing. Ingen af testene indførte en bevidst konkurrerende CPU-arbejdsbyrde, så det uafklarede spørgsmål er schedulerens responsivitet under belastning, ikke om frame pacing overhovedet er blevet målt.
Understøtter min CPU x86-64-v3 eller v4?
På CachyOS eller Arch skal du køre /lib/ld-linux-x86-64.so.2 --help | grep supported for at se de standardiserede glibc-hwcaps-niveauer, der er detekteret for din CPU. x86-64-v3 kræver funktionssættet fra AVX/AVX2-æraen, mens v4 tilføjer AVX-512. For Intel hybrid-CPU'er fra 12. generation og nyere anbefaler CachyOS at behandle systemet som v3, selv hvis v4 optræder i outputtet; Zen 4/5-brugere bør også tjekke det separate znver4/znver5-mål.
Hvorfor gør rekompilerede pakker ikke en større forskel?
Fordi noget stærkt optimeret kode allerede bliver dirigeret til CPU-specifikke implementeringer under kørsel. Matematik- og kryptografibiblioteker bruger ofte function multiversioning eller IFUNC til hot functions, så genopbygning af pakker hjælper primært kode, som compileren yderligere kan optimere eller vektorisere globalt.
Kan jeg få CachyOS' optimerede pakker uden at skifte distro?
Ja. CachyOS' repositories kan tilføjes til en eksisterende Arch Linux-installation, og ALHP-projektet udgiver genopbygninger af de officielle Arch-repositories rettet mod x86-64-v2, v3 og v4, dokumenteret på Arch Wiki. Begge giver dig kun de rekompilerede pakker, ikke CachyOS' kerne-patchsæt, de alternative schedulere eller installationsprogrammets standardindstillinger.
Diskussion
Kommentarer
Log ind for at deltage i diskussionen.