
Due database possono occupare lo stesso spazio e richiedere VPS diversi. Uno rilegge poche righe, l'altro sostiene scritture, costruisce grandi indici o deve riprendersi rapidamente da un guasto. La scelta del miglior VPS per database parte da queste differenze, prima del confronto tra fornitori.
Un VPS non gestito comporta la responsabilità operativa del database. PostgreSQL, MySQL e MariaDB richiedono budget RAM diversi; anche la capacità di ripristino va progettata insieme al primario. La configurazione iniziale deve lasciare margine per backup e manutenzione e superare una prova rappresentativa.
Dimensionare il carico prima di scegliere il piano
Misura dati e indici attivi, query simultanee al picco, crescita e requisiti di ripristino prima di scegliere CPU, RAM e disco. Aggiungi risorse secondo il vincolo misurato. Includi spazio di manutenzione e picchi applicativi se l'host è condiviso: il budget deve coprire periodi intensi e normali.
Il working set comprende dati e indici usati abbastanza spesso da beneficiare della RAM; il volume archiviato include dati freddi. Anche connessioni aperte e query attive differiscono: client inattivi e ordinamenti simultanei hanno esigenze CPU/RAM diverse. Registra entrambi, forma delle query e rapporto letture/scritture.
Ricava i requisiti d'acquisto da un periodo intenso rappresentativo:
- Misura il picco RAM applicativo se condividerà il VPS.
- Registra dimensioni di dati e indici, working set stimato, operazioni simultanee e crescita nell'orizzonte previsto.
- Misura la produzione di log e individua la maggiore creazione d'indice, riscrittura di tabella o manutenzione prevista.
- Definisci latenza p95, perdita di dati accettabile e tempo di ripristino obiettivo.
- Decidi dove eseguire l'applicazione e prova il percorso verso il database.
La documentazione di monitoraggio PostgreSQL raccomanda statistiche del database insieme agli strumenti del sistema operativo. Raccogli CPU, pressione RAM e attività disco con tempi di query e commit. Un aumento di latenza durante il backup va indagato anche se il controllo a riposo sembra corretto.
Le vCPU dedicate offrono accesso continuativo alle risorse assegnate. Non equivalgono a un intero server fisico né garantiscono IOPS. Valuta CPU, RAM e comportamento del disco separatamente. Se i requisiti misurati superano i VPS disponibili, considera hardware dedicato senza estrapolare dal nome di un piano maggiore.
Associare carichi SQL a una configurazione iniziale
Usa PostgreSQL 16, MySQL 8.4 con InnoDB o MariaDB 11.4 con InnoDB come ambienti alternativi secondo compatibilità. Non sono motori intercambiabili né indicazioni dell'ultima versione. Registra la patch installata prima del test; gli esempi non specificano la versione dell'immagine del fornitore.
Ospitare insieme una piccola app e il database
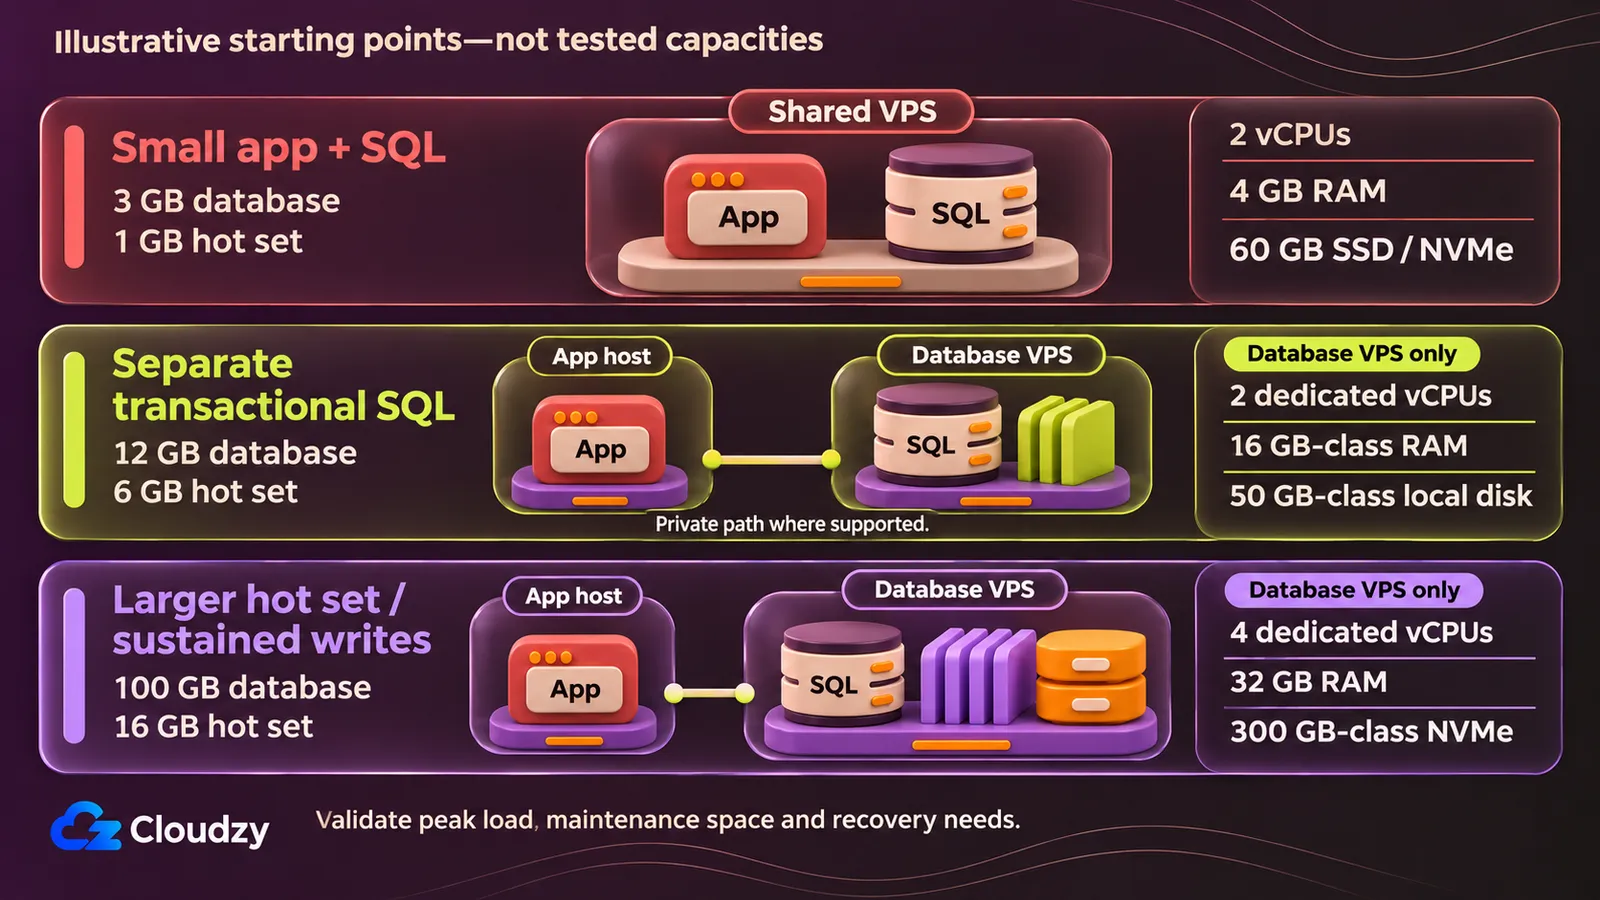
Per ipotesi di 3 GB di database, 1 GB di dati frequenti e cinque query semplici indicizzate attive, prova 2 vCPU, 4 GB RAM e 60 GB nominali SSD o NVMe. La connessione resta locale, ma app e database devono rientrare insieme nel picco RAM.
Ipotizza letture/scritture 90/10, crescita mensile di 1 GB e niente report lunghi durante i backup. La CPU condivisa può bastare per staging tollerante. Scegli risorse dedicate se la contesa continua peggiora troppo le risposte; il confronto di produzione successivo usa solo vCPU dedicate.
Budget RAM proposto, con tutte le cifre in GB:
| Utilizzo | RAM ipotizzata |
|---|---|
| Sistema operativo e agenti di monitoraggio | 0.75 |
| Applicazione al picco | 1 |
| Cache del database | 1 |
| Cache del file system | 0.75 |
| Riserva per query, connessioni e manutenzione | 0.5 |
| Totale | 4 |
Adatta il pool InnoDB di MySQL o MariaDB a questo budget. Applicare all'intero host una percentuale da server database dedicato sottrarrebbe RAM all'app. Per PostgreSQL conta separatamente buffer condivisi e memoria operativa nell'allocazione e riserva del database. Misura il picco combinato prima di approvare entrambe le alternative.
Esempio disco: 5 GB SO/log, 3 GB dati/indici, 4 GB log motore, 3 GB temporanei e 6 GB crescita, totale 21 GB. Il resto nominale assorbe overhead del file system e lavoro transitorio; non giustifica conservare i backup sul primario.
Connetti con socket locale o localhost. Prova commit durevoli con app e backup attivi, inclusa sincronizzazione (fsync), che chiede al SO di scrivere su memoria persistente. Se il responsabile accetta RPO di 24 ore, la perdita ammissibile, e RTO di quattro ore, il tempo di recupero obiettivo, proponi backup nativo notturno fuori nodo e dimostra la durata in esercitazione. Se RAM, latenza o recupero sforano, separa, ridimensiona o rivedi il recupero dopo diagnosi di query e indici.
Separare un database SQL transazionale
Con app altrove, un database SQL illustrativo da 12 GB e working set caldo da 6 GB può iniziare i test con 2 vCPU dedicate, RAM classe 16 GB e disco locale classe 50 GB. Si ipotizzano 20 query indicizzate attive, scritture brevi e calcolo continuativo ridotto; operazioni maggiori possono invalidare il budget.
Ipotizza letture/scritture 90/10 e crescita di 1 GB mensile per tre mesi. È il riferimento della tabella fornitori. Le unità differiscono: confronta RAM realmente disponibile e byte utilizzabili prima delle allocazioni.
Per PostgreSQL su VPS, le indicazioni sui buffer condivisi di PostgreSQL 16 partono dal 25% della memoria di sistema su server database dedicato con almeno 1 GB RAM. Si usa anche la cache SO. Budget proposto da 16 GB: 4 GB condivisi, 2 GB SO/agenti, 2 GB riserva query/connessioni/manutenzione e 8 GB cache file/margine.
La riserva non è un'impostazione work_mem. La documentazione sulla memoria delle operazioni di query PostgreSQL spiega che ordinamenti e hash separati allocano memoria con sessioni concorrenti. Gli hash usano anche hash_mem_multiplier. Imposta limiti secondo la concorrenza consentita; valori elevati per operazione possono superare il budget anche con buffer condivisi adeguati.
Per MySQL VPS, le indicazioni sul buffer pool MySQL 8.4 Oracle raccomandano in genere il 50–75% della RAM considerando SO e altre allocazioni. Prova un pool InnoDB da 8 GB, lasciando il resto per altri consumi e picchi.
MariaDB richiede un calcolo diverso. Le indicazioni di allocazione RAM partono dal 60–70% della RAM disponibile dopo SO/servizi per sistemi prevalentemente InnoDB. Con 13 GB disponibili sono 7,8–9,1 GB; 8 GB iniziali sono coerenti. MyISAM o Aria richiedono cache separata. Sono budget alternativi: non sommarli.
Disco: 12 GB dati/indici + 3 GB crescita + 5 GB SO + 4 GB log + 8 GB temporanei/manutenzione = 32 GB. Un disco classe 50 GB lascia circa 18 GB nominali prima dell'overhead. Richiedi almeno 15 GB liberi misurati; più log o riscritture invalidano l'esempio.
Avvicina app e database con percorso privato verificato dove supportato, autenticazione, controlli d'accesso e cifratura. Controlla latenza query/commit durevoli durante checkpoint, flush e backup. Prevedi backup indipendenti; il caso seguente ne sviluppa il progetto. Ridimensiona se risorse, spazio o recupero non bastano dopo diagnosi di query/indici.
Prevedere working set grandi o scritture sostenute
Per 100 GB ipotizzati e 16 GB di dati frequenti, prova 4 vCPU dedicate, 32 GB RAM e NVMe classe 300 GB, con app separata. L'esempio ammette 30 query miste attive e letture/scritture 60/40; misura esecuzione e pressione del disco prima di aumentare risorse.
Ipotizza crescita di 10 GB mensile per tre mesi. PostgreSQL: 8 GB condivisi, 4 GB riserva SO/query/manutenzione e 20 GB cache file/margine. Un pool InnoDB di circa 16 GB è l'alternativa iniziale MySQL/MariaDB dopo le altre riserve. Le impostazioni PostgreSQL non si trasferiscono agli altri motori.
Il disco include lavori in corso: 100 GB dati/indici + 30 GB crescita + 30 GB log conservati/in coda + 60 GB per la maggiore manutenzione/operazione temporanea + 10 GB SO = 230 GB. Restano circa 70 GB nominali. Una riscrittura maggiore richiede nuovi conti anche con crescita giornaliera modesta.
La documentazione di vacuum ordinario PostgreSQL distingue VACUUM, che rende riutilizzabile lo spazio delle righe morte, da VACUUM FULL, che crea una nuova copia e richiede spazio temporaneo aggiuntivo. Un disco appena più grande dei dati può impedire la manutenzione necessaria a recuperare spazio.
Misura CPU, pressione cache e I/O fisico separati dalla latenza di scrittura. Includi scritture temporanee, checkpoint e flush. NVMe e CPU dedicate descrivono il sistema, non garantiscono IOPS. Prova trasferimenti continuativi di backup e replica, con connessione privata vicina e storage di recupero indipendente. Log più rapidi modificano conservazione e rete. Aumenta core, RAM o disco per il vincolo osservato, non perché il piano successivo aumenta tutto.
Aggiungere capacità di recupero in produzione
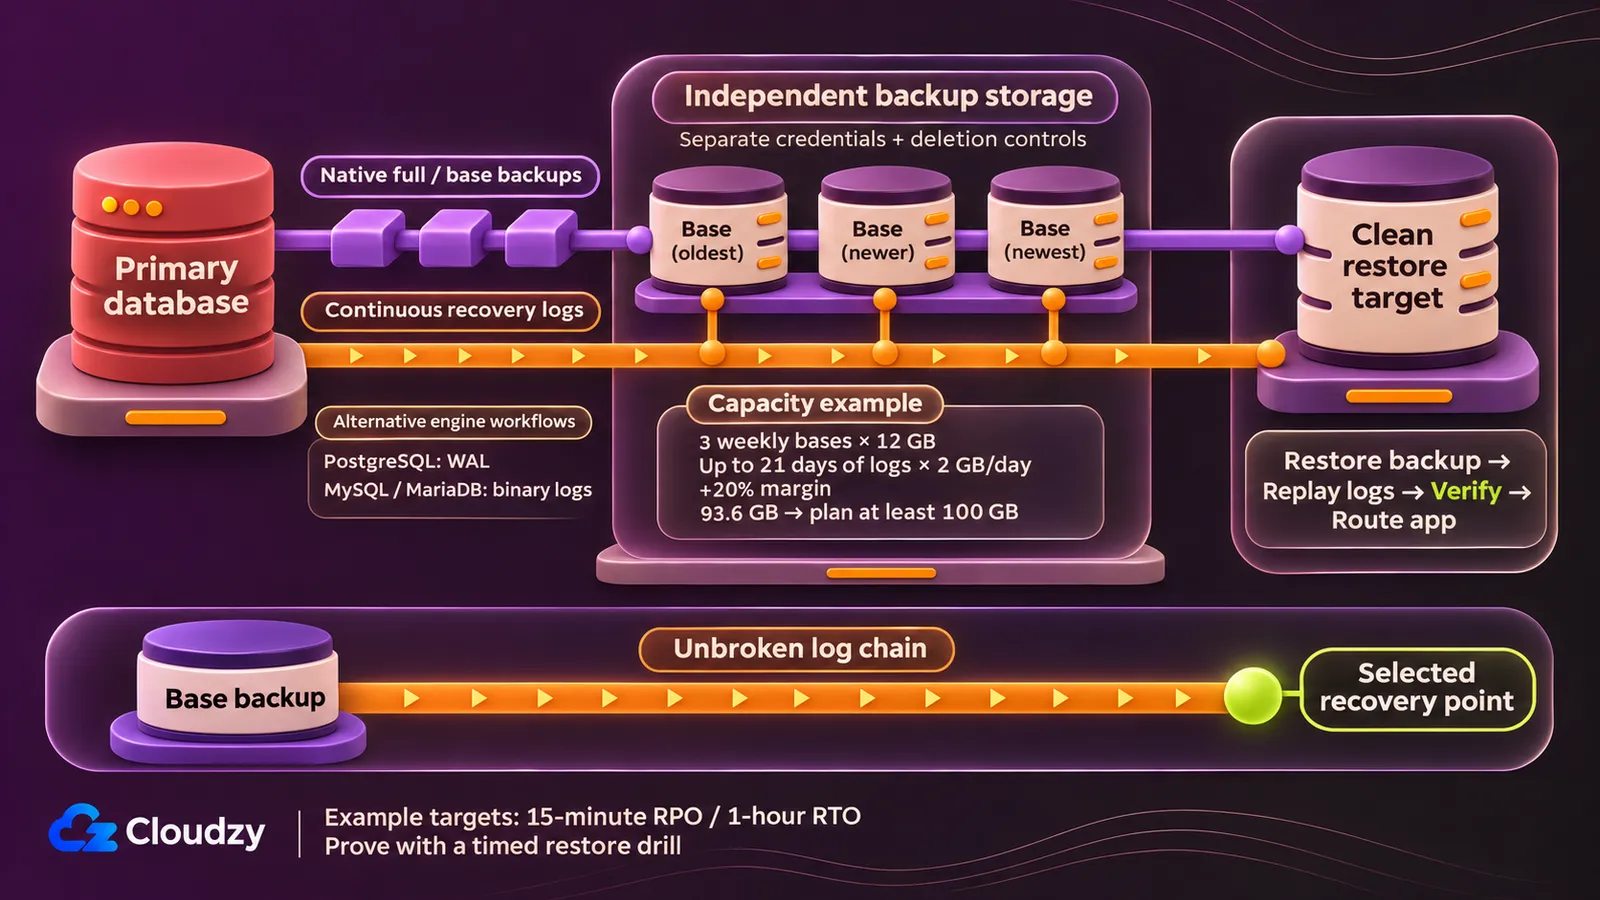
Perdita accettata di 15 minuti e ripristino entro un'ora richiedono più del budget primario. Mantieni le ipotesi SQL separate e aggiungi backup nativi, log conservati, storage indipendente ed esercitazione cronometrata. Sono obiettivi di progetto, dimostrabili solo dal test.
La documentazione di archiviazione continua PostgreSQL descrive backup base e archivio WAL ininterrotto per recupero puntuale. La documentazione di recupero MySQL Oracle usa backup completo e log binari successivi. La procedura PITR MariaDB ripristina dati completi/incrementali prima dei log binari. Il logging binario deve essere abilitato per questi flussi MySQL/MariaDB.
Esempio: ogni backup completo/base non compresso misura 12 GB. Conserva tre basi settimanali e log continui dall'inizio della più vecchia. Prevedi fino a 21 giorni a 2 GB al giorno con margine del 20%:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
Prevedi almeno 100 GB indipendenti senza contare sulla compressione. Lega eliminazione log a scadenza backup e sostituzione riuscita. Verifica la catena completa di basi e log per tutti i punti di ripristino promessi.
Usa backup su destinazione indipendente, con credenziali e controlli di cancellazione separati dal primario. Uno snapshot del fornitore non dimostra la catena nativa. L'esercitazione deve creare una destinazione pulita, trasferire e ripristinare, riprodurre log, verificare consistenza database/app e instradare l'app. Cronometra anche provisioning e trasferimento.
Un'interruzione più breve può richiedere una replica indipendente per l'intero carico. Calcola CPU, RAM e disco separati; definisci promozione, isolamento del vecchio primario e routing client. Esercitati. La replica non sostituisce i backup e un VPS non offre alta disponibilità. Rivedi se il ripristino supera un'ora, il ritardo archivio supera RPO, lo standby non regge o i backup sfiorano il limite.
Quando scegliere un VPS gestito
Se nessuno risponde agli allarmi o ripristina durante un incidente, acquista copertura operativa esplicita. Un VPS gestito può trasferire manutenzione, ma il contratto deve nominare le attività database. Un pannello non garantisce copertura; VPS gestito e database gestito sono distinti.
La differenza tra responsabilità VPS gestite e non gestite è utile per singola attività. È una lista d'acquisto, non una promessa di servizi identici. L'infrastruttura fisica resta del fornitore; software ospite e operazioni database necessitano di responsabilità esplicite.
| Attività | VPS non gestito | Copertura da definire prima dell'acquisto |
|---|---|---|
| Patch e aggiornamenti SO ospite e database | Li pianifichi e li esegui tu | Versioni supportate, ambito patch, prove di aggiornamento e finestre di manutenzione |
| Ottimizzazione di query, schema e indici | Diagnostichi e modifichi tu | Se inclusa, limitata alla configurazione del servizio o fatturata a parte |
| Monitoraggio e incidenti | Configuri gli allarmi e rispondi tu | Orari di monitoraggio, responsabilità di intervento/escalation e chi agisce dopo l'allarme |
| Backup e ripristini | La procedura di recupero è tua responsabilità | Conservazione, storage indipendente, assistenza e prove di ripristino |
Domanda contrattuale utile: «Se il disco si esaurisce durante un backup, chi diagnostica, ripristina il servizio e controlla il backup seguente?». Distingue accesso al supporto e responsabilità sul risultato. Chiedilo anche per aggiornamenti falliti e cancellazioni accidentali.
I database gestiti hanno accordi propri su ciclo del motore, backup e failover. Possono convenire se vuoi delegare recupero e aggiornamenti. Non dedurre ottimizzazione applicativa dall'etichetta: query e comportamento dell'app restano da assegnare salvo accordi diversi.
Assegna ogni attività una volta, con escalation e verifica d'accettazione. Confronta il costo con tempo e disponibilità. Non esiste valore orario universale dell'autogestione; un conto di calcolo basso non risolve incidenti senza responsabile.
Scegliere un VPS per carichi non SQL
Gli esempi distinguono memoria, documenti e indici di ricerca. Avvicina l'app e testa percorsi e trasferimenti verso backup e repliche quando usati.
| Carico e ipotesi | Configurazione iniziale da provare | Storage, recupero e motivi di modifica |
|---|---|---|
| Redis cache/chiave-valore; dati misurati 2 GB | 2 vCPU dedicate, 8 GB RAM; imposta maxmemory sotto la memoria host con riserva per overhead |
Una cache ricostruibile può perdere dati. Un primario persistente richiede RDB/AOF ragionati, spazio di riscrittura e backup indipendenti. Misura RAM/RSS, frammentazione, espulsioni, picchi di persistenza e latenze di coda. |
| MongoDB; documenti/indici 20 GB e piccolo insieme caldo misurato | 2–4 vCPU dedicate, 16 GB RAM, disco locale classe 100 GB | Prevedi journal/oplog, crescita e temporanei. Prova ripristino; osserva espulsioni cache, I/O e ritardo replica. Calcola CPU, RAM e disco di ogni replica secondo ruolo. |
| Elasticsearch; piccolo indice da 30 GB | 4 vCPU dedicate, 16 GB RAM, circa 150 GB locali per nodo dati interessato | Prevedi repliche, merge dei segmenti, conservazione e snapshot indipendenti. Controlla heap/GC, latenze ricerca/indicizzazione, I/O merge e disco. La resilienza richiede anche voto e routing adeguati. |
La guida amministrativa Redis avverte che salvataggi RDB o riscritture AOF con molte scritture possono usare fino al doppio della RAM normale secondo le pagine cambiate. I 2 GB non possono occupare tutta la RAM. La documentazione di persistenza distingue snapshot periodici RDB e log AOF. Scegli secondo perdita accettabile e misura i picchi RAM/disco in esecuzione.
La documentazione della cache WiredTiger MongoDB descrive cache interna e file system. Il valore predefinito è il maggiore tra 50% × (RAM − 1 GB) e 0,256 GB. La guida ai replica set consiglia tre membri con dati. Un arbitro vota senza dati. Prevedi backup indipendenti e configura autenticazione MongoDB prima di collegare l'app.
La documentazione delle impostazioni JVM Elastic raccomanda heap automatico. In manuale, usa minimo/massimo uguali e non oltre il 50% della RAM disponibile. La guida di resilienza dei piccoli cluster descrive due nodi dati eleggibili master e uno spareggio solo votante. Configura repliche e client verso i nodi dati; lo spareggio aggiunge voto, non copia. Se merge o conservazione esauriscono la riserva, rivedi il disco prima di altri documenti.
Confrontare i piani non gestiti per la configurazione richiesta
Per SQL transazionale separato, filtra almeno 2 vCPU dedicate, RAM classe 16 GB e storage locale classe 50 GB. Superare il minimo rende candidati al test. Pacchetti CPU/disco, unità e impegni diversi impediscono equivalenza hardware o classifiche prestazionali.
Riferimento: Linux autogestito in Germania o vicina Europa centrale, pochi dati e più RAM. Vicinanza non implica latenza uguale. Percorso privato dove disponibile, preventivi con IPv4 pubblica standard. Trasferimento ipotizzato sotto tutte le quote.
| Fornitore e piano non gestito | vCPU dedicate / RAM / disco locale | Posizione e traffico incluso | Costo, fatturazione e IPv4 |
|---|---|---|---|
| Cloudzy: il nostro Regular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | Località in varie regioni mondiali; 10 TB | 49,98 $/mese; IPv4 e IPv6 incluse |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1; almeno 20 TB nell'UE | Massimo 86,49 €/mese, inclusi 0,50 € IPv4 primaria, IVA esclusa |
| DigitalOcean Memory-Optimized Droplet in pacchetto, CPU Regular, SSD 1× | 2 / 16 GiB / 50 GiB NVMe | Famiglia disponibile FRA1; 4.000 GiB | Massimo 84 $/mese; 0,125 $/ora; IPv4 pubblica inclusa |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2 core/16 GB/100 GB | 2 / 16.384 MB / 100 GB NVMe | Francoforte (fra); 6.144 GB |
80 $/mese; 0,11 $/ora; IPv4 predefinita; conferma costi separati o sconto senza IPv4 prima del budget |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16.384 MB / SSD 327.680 MB (classe 320 GB) | Francoforte (de-fra-2) indicata disponibile; 6.000 GB |
173 $/mese; 0,2595 $/ora; IPv4 pubblica standard senza supplemento |
La guida DigitalOcean include Memory-Optimized per SQL/NoSQL e cache. Consiglio questa famiglia in pacchetto per poco disco e molta RAM. Un VPS ottimizzato RAM non è esclusivo SQL. Se la misura indica capacità o richiesta disco continuativa come vincolo, valuta Storage-Optimized separatamente.
Tutti e cinque superano la soglia con riserve CPU/disco differenti. Possono sostenere crescita ma non dimostrano vantaggi di velocità senza prove. Il catalogo Hetzner non garantisce disponibilità d'ordine. Akamai documenta SSD per G7 Dedicated. Optimized Memory Vultr è distinta da High Frequency Compute condivisa.
La nostra allocazione dedicata è adatta alla configurazione autogestita al prezzo indicato. Confronta risorse, valuta, impegno di fatturazione e IPv4 prima del valore complessivo.
Costo totale: calcolo + indirizzo + storage/richieste/traffico backup indipendenti + capacità di test ripristino + standby opzionale. Costi sconosciuti non sono zero. Ottieni prezzi aggiornati del recupero e verifica piano, località e upgrade prima d'impegnarti. Non dedurre la fattura annua moltiplicando un equivalente mensile arrotondato.
Scelto il motore SQL compatibile, le nostre app in un clic abbreviano l'installazione. PostgreSQL, MySQL e MariaDB sono selezioni distinte; sceglierne una non installa tutte. Restano autogestiti patch, ottimizzazione e recupero.
Domande frequenti
Il tasso di cache hit PostgreSQL indica se il disco è lento?
No. La documentazione delle statistiche I/O PostgreSQL spiega che la cache SO può servire una lettura senza disco. Combina hit rate con I/O SO e tempi query. Il solo rapporto non distingue ritardo fisico e letture dalla memoria kernel.
Un dump logico PostgreSQL serve per recupero puntuale basato su WAL?
No. I requisiti di archiviazione continua PostgreSQL dicono che il dump logico non contiene informazioni per riprodurre WAL. Ripristina lo stato catturato; il recupero WAL richiede backup base adatto e archivio WAL continuo. Scegli formato secondo metodo di recupero.
La cache MongoDB deve usare la RAM host in un container?
Usa la RAM disponibile al container. La guida alla memoria dei container MongoDB avverte che WiredTiger può ignorare limiti inferiori in alcuni casi. Imposta cache sotto tale limite lasciando spazio agli altri processi; la RAM host può sovrastimare quella utilizzabile.
Discussione
Commenti
Accedi per partecipare alla discussione.