

Qualcosa che hai costruito è in produzione. Il tuo monitoraggio o non esiste, oppure è un ping di disponibilità, e la settimana scorsa di un disservizio te l'ha detto un utente. Ogni risposta che vai a cercare punta allo stesso nome.
Questa recensione di Prometheus parla della distanza tra due cose che sono vere entrambe. È gratuito e open source, senza licenza e senza fattura per metrica, a qualunque scala. Ti costa anche una serata, più un linguaggio di query che ancora non conosci. È un raccoglitore di metriche basato su pull con l'alerting incluso, ed è un software eccellente. Se sia il software giusto per l'ambiente che stai facendo girare adesso è un'altra domanda, ed è quella che vale la pena di affrontare.
La versione breve
- Verdetto: 3,5 / 5 per chi lo ospita da solo o in un piccolo team. Prometheus vale la pena di essere avviato se il tuo insieme di host e servizi è ragionevolmente stabile, se sei disposto a metterci il tempo per imparare PromQL e se vuoi metriche interamente tue, senza abbonamento e senza fattura per la conservazione.
- Lascia perdere se la domanda a cui ti serve rispondere è «è su?». Un controllo di disponibilità ti porta a quella risposta molto più in fretta, e tirare in ballo Prometheus per quel compito significa pagare un linguaggio di query per rispondere a qualcosa che avresti risolto in dieci minuti.
- PromQL è il costo che continua a ripresentarsi. L'installazione è un costo una tantum. Ma nel momento in cui le tue domande superano le dashboard preconfezionate e il generatore visuale di query di Grafana, sei di nuovo dentro PromQL.
- Il costo di manutenzione segue quanta parte dell'ambiente gestisci a mano. Una flotta che mantiene la sua forma costa poco da monitorare. Una che acquisisce, perde e rinomina host è esattamente il punto in cui il costo si accumula in silenzio.
- Questo verdetto vale soltanto per il self-hosting su piccola scala. Alla scala di Kubernetes e dell'SRE in produzione, Prometheus è una proposta completamente diversa, e questa recensione non prova a rispondere a quella domanda.
Come è stata costruita questa recensione: Prometheus è gratuito e open source, quindi qui non c'è alcun rapporto con un fornitore e nessuno mi ha mandato nulla. I dati su versioni e comportamento dello storage vengono dalla documentazione ufficiale di Prometheus. I numeri sulle risorse e i tempi di installazione vengono da due test pratici pubblicati in modo indipendente, citati nel punto esatto in cui vengono usati. Dove i due divergono, vedrai entrambe le cifre invece di una media.
Che cosa copre questa recensione
Il verdetto qui sopra ha dei confini, e qui quei confini pesano più del solito, perché a scale diverse Prometheus si comporta come uno strumento diverso.
- Prometheus valutato per il self-hosting su un singolo VPS e per progetti piccoli: una manciata di host e servizi, e una sola persona che se ne occupa.
- Non Kubernetes. Prometheus Operator, i ServiceMonitors e il kube-prometheus-stack sono un mondo operativo a parte, e il verdetto di qui non dice nulla su quello.
- Non è una guida al routing di Alertmanager. L'alerting esiste e funziona; configurare route, silence e receiver è un argomento a sé.
- Non è una guida all'installazione. La domanda qui è se convenga farlo girare, punto. Se a quella hai già risposto, la nostra guida a Grafana e Prometheus con Docker Compose spiega i passaggi.
- Non è una rassegna di exporter. Gli exporter compaiono solo dove cambiano la risposta.
Che cosa fa bene Prometheus
Prometheus non costa nulla. Non è un «piano gratuito con upgrade a pagamento», né un «gratis finché non superi un limite di metriche». Il repository è rilasciato sotto licenza Apache 2.0 da cima a fondo, non esiste un'edizione a pagamento del progetto principale e da nessuna parte si fattura per host, per metrica o per etichetta. L'unica fattura che Prometheus genera è il server su cui gira.
Per qualcosa su cui hai intenzione di appoggiarti, «ci sarà ancora tra tre anni?» è una domanda legittima, e qui le probabilità sono buone quanto può esserlo l'open source. Prometheus si è diplomato nella CNCF ad agosto 2018, secondo progetto in assoluto a riuscirci, dopo Kubernetes. Le release escono con regolarità, con la v3.13.2 uscita a fine luglio 2026, e poiché quella linea di release è una linea a supporto a lungo termine, riceve correzioni di bug, di sicurezza e di documentazione per un anno, quindi restare aggiornati con le patch non significa rincorrere ogni versione minore.
Il modello dati è il motivo per cui l'ecosistema attorno è così profondo. Prometheus raccoglie le metriche via HTTP e identifica ogni serie con un nome di metrica più etichette chiave/valore, il che rende scrivere un exporter un lavoretto piccolo. Per questo esistono exporter per praticamente qualunque cosa tu possa far girare: metriche di sistema, Postgres, Nginx, Redis, sonde blackbox per le cose che puoi stuzzicare solo dall'esterno.
E quello che raccoglie è tuo, ed è la parte che di solito conta più avanti che il primo giorno. Lo storico di un'installazione piccola occupa una quantità di disco trascurabile (i numeri sono più sotto), nessuno può riprezzartelo il prossimo trimestre, e non c'è una voce in fattura che cresce ogni volta che qualcuno aggiunge strumentazione a un'applicazione. Se hai mai visto la fattura di un monitoraggio gestito salire perché uno sviluppatore ha aggiunto un'etichetta, l'intero ragionamento sta in quella frase.
Dove Prometheus ti costa più di quanto sembri
Un test su dev.to di sette strumenti di monitoraggio su un unico VPS piccolo ha misurato 15 minuti per installare il solo Prometheus. Abbinalo a Grafana, come ha fatto chi ha condotto il test, perché il browser di espressioni integrato è soltanto un posto in cui eseguire query. Lo stesso test colloca Grafana + Prometheus a 35 minuti prima del primo grafico, con la configurazione YAML dello scrape nel mezzo.
I minuti sono la parte a buon mercato. Quella cara è PromQL. Prometheus conserva tutto come serie temporali identificate da nome ed etichette, e PromQL resta il linguaggio sotto le domande che gli poni. Grafana ormai ha un generatore visuale, quindi non devi scrivere a mano ogni query. Il verdetto di chi ha condotto il test è stato netto: PromQL è meraviglioso per chi ci vive dentro, e lui non ci viveva. Se non hai mai usato un linguaggio di query, mettine in conto più di una serata, e aspettati di tornarci ogni volta che il generatore visuale non basterà più. Una dashboard copiata da qualcun altro risponde alle domande di quella persona. Le tue sono una query che non hai ancora scritto.
Il terzo costo è quello che non salta fuori se non più avanti. Un resoconto di tre settimane di un operatore descrive esattamente che cosa ha comportato aggiungere un singolo server a un'installazione da sette nodi: rietichettare, ricontrollare le configurazioni di scrape, modificare le variabili delle dashboard e rifare le query dei template perché il nuovo host comparisse nei menu a tendina. Quell'operatore ha abbandonato lo stack dopo tre settimane, avendo concluso che passava più tempo a mettere a punto le dashboard che a guardare la propria infrastruttura.
Nota a che cosa è legato quel costo in un'installazione del genere: a target e dashboard gestiti a mano. Far girare Prometheus per due anni tranquilli non ti costa quasi nulla in più.
Quanta RAM e quanto disco servono davvero a Prometheus?
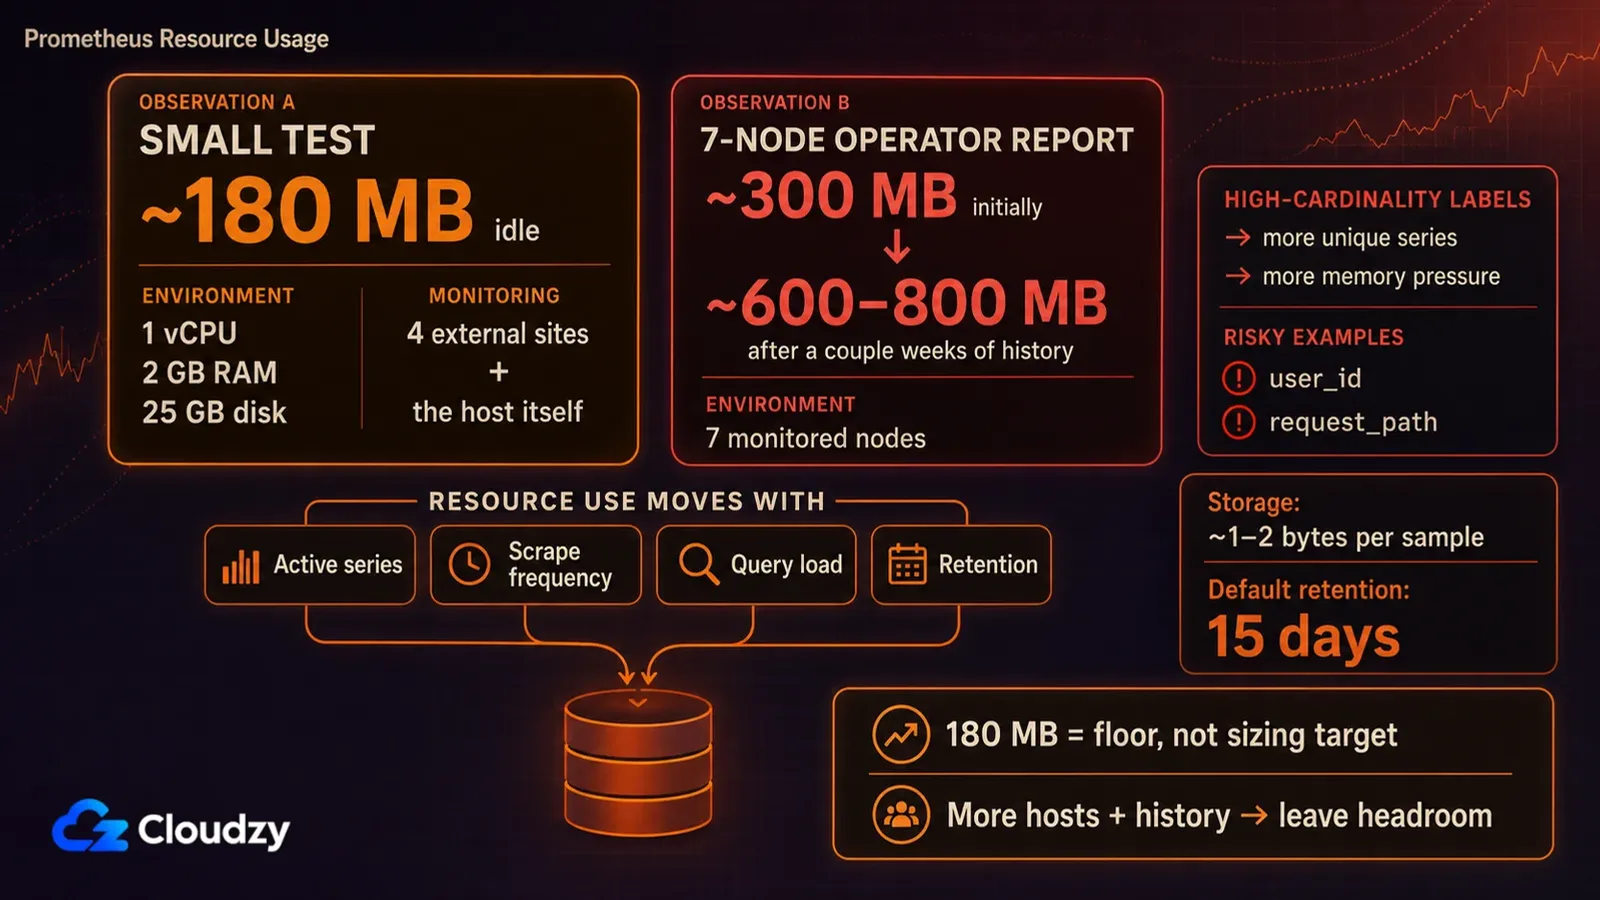
Non esiste un requisito fisso. Serie attive, frequenza di scrape, carico di query e periodo di conservazione contano più del semplice numero di server su cui lo punti. Due test pratici pubblicati su installazioni piccole lo collocano fra circa 180 MB e 800 MB, dove la cifra più alta copre sette nodi con un paio di settimane di storico.
I due test non concordano, e la parte utile è proprio il disaccordo. Lo stesso confronto su VPS fra sette strumenti ha fatto girare ognuno su hardware identico (1 vCPU, 2 GB di RAM, 25 GB di disco, Ubuntu 24.04) sorvegliando quattro siti esterni più l'host stesso, e ha misurato Prometheus a circa 180 MB a riposo. Lo stesso operatore ha riferito che il solo Prometheus stava intorno ai 300 MB a riposo sull'host centrale, salendo verso 600-800 MB una volta accumulate un paio di settimane di storico.
Non sono la stessa misurazione, ed è per questo che farne la media butterebbe via l'informazione. Una è una lettura quasi a riposo su una macchina che ha pochissimo da archiviare. L'altra è un'installazione in funzione, con una flotta dietro e lo storico su disco. La mia lettura: tratta il risultato di 180 MB come un pavimento, non come un obiettivo di dimensionamento. Non appena raccogli da più host e conservi lo storico, lascia margine invece di pianificare su quel numero a riposo.
Il disco è la metà facile. La documentazione sullo storage di Prometheus lo colloca a una media di 1-2 byte per campione, quindi conservare uno storico lungo per un'installazione piccola costa poco. La fregatura sta nel valore predefinito: la conservazione è impostata su 15 giorni per impostazione predefinita a meno che tu non imposti un tempo o una dimensione di conservazione. C'è un solo flag di avvio fra quello e un anno intero, ed è il tipo di impostazione predefinita che preferisci scoprire adesso, e non la prima volta che vai a cercare i numeri del mese scorso e ti accorgi che sono scaduti tre settimane fa.
Ciò che spinge in alto il numero della memoria è la cardinalità: il conteggio delle serie temporali distinte, dove ogni combinazione unica di etichette su una metrica diventa una serie a sé. Una sola etichetta scelta male su una metrica ad alto traffico può creare più serie di quante ne creerebbero cinque server in più, e lo fa in silenzio, alla velocità a cui sta viaggiando il tuo traffico. (Un ID utente o un percorso di richiesta sembrano un'etichetta ottima esattamente fino al momento in cui conti quanti ce ne sono.)
Qualunque numero sulla RAM tu trovi citato per Prometheus è utilizzabile solo se sai anche quante serie ci stavano dietro.
Che cosa succede quando il tuo server Prometheus va giù?
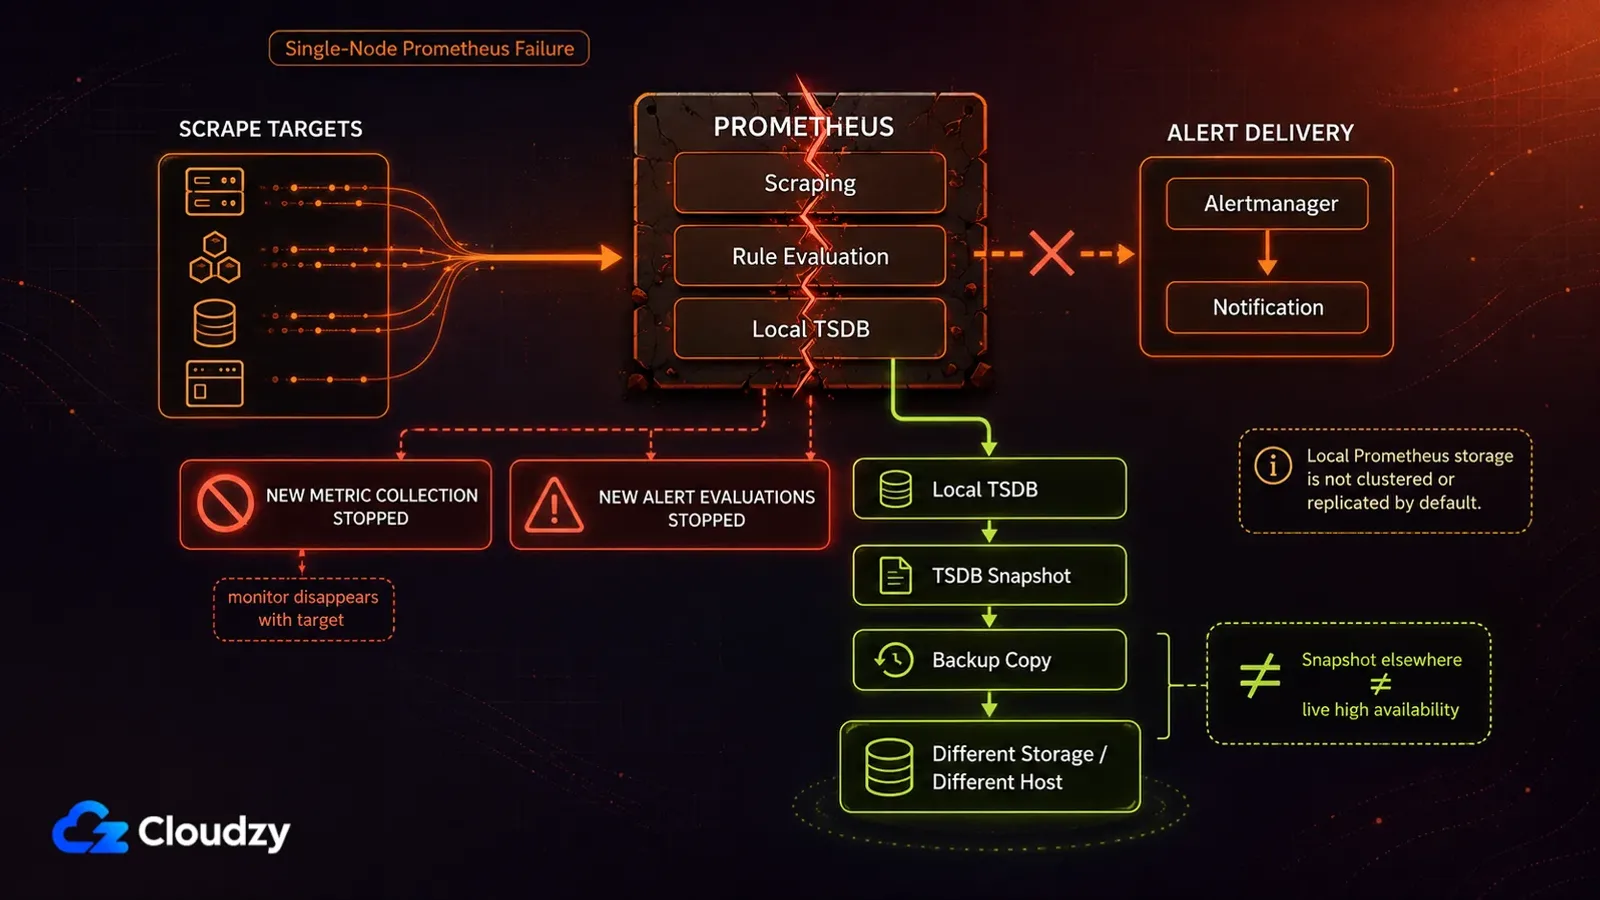
La documentazione sullo storage di Prometheus è diretta su questo punto: lo storage locale non è in cluster né replicato, quindi non sopravvive al guasto di un disco o di un nodo. Ogni server è autonomo per progetto e non dipende né da storage di rete né da servizi remoti, il che è esattamente ciò che lo rende facile da gestire ed esattamente ciò che lo lascia esposto.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
C'è un secondo confine che il progetto dichiara su se stesso, e va riconosciuto il merito di dichiararlo: se ti serve un'accuratezza del 100%, per esempio per la fatturazione a richiesta, la documentazione dice che Prometheus è la scelta sbagliata, perché i dati che raccoglie con ogni probabilità non saranno abbastanza dettagliati e completi. Per i numeri su cui fatturi usa qualcos'altro e tieni Prometheus per il monitoraggio. Di solito i fornitori non dicono spontaneamente questo genere di cose su se stessi.
Su scale maggiori esistono risposte consolidate a tutto questo, e restano fuori portata qui per la stessa ragione degli strumenti Kubernetes: comportano un impegno operativo diverso da quello di cui parla questa recensione. Per un singolo VPS la mia lettura è che l'esposizione sia accettabile se conservi altrove gli snapshot del TSDB o accetti in partenza di perdere lo storico, e che sia un problema vero se Prometheus è l'unica cosa fra te e un disservizio silenzioso.
Chi dovrebbe ospitare Prometheus da sé?
Il segnale più chiaro che Prometheus ripagherà quel che costa non ha nulla a che vedere con quanti server hai. Riguarda se fra sei mesi saranno gli stessi server. Un insieme stabile di host configurati a mano significa che la configurazione la scrivi una volta e lo storico te lo prendi gratis; un insieme che continua a cambiare significa che quella configurazione continui a metterci mano.
In un'installazione statica, la tua configurazione di Prometheus e Grafana è una descrizione esplicita della tua infrastruttura: i target di scrape, le etichette attaccate a essi e le dashboard costruite sopra quelle etichette. Ecco perché tutto il guadagno sta nello storico. Un anno di dati su un insieme stabile di host ti dice che aspetto ha il normale, ed è il modo più affidabile di riconoscere l'anormale prima che diventi un disservizio.
Il primo profilo, quindi, è chi gestisce un piccolo insieme di server che cambia lentamente e vuole più del semplice su o giù: latenza delle richieste nel tempo, andamento della memoria, un disco che si riempie abbastanza gradualmente da vederlo arrivare con settimane di anticipo. Se sai descrivere la tua infrastruttura oggi e ti aspetti che quella descrizione sia ancora grosso modo vera fra un anno, la serata che spendi sull'installazione è l'ultima fattura pesante.
Il secondo è chiunque stia imparando questo stack di proposito. Se prevedi di gestire infrastruttura fra qualche anno, tua o di qualcun altro, la serata su PromQL è esattamente ciò per cui sei venuto e il monitoraggio è un effetto collaterale. Questo profilo ribalta in parte il primo: qui la prova di stabilità pesa meno, perché il tempo speso a rietichettare è anche tempo speso a capire che cos'è la rietichettatura. Per questo lettore alzerei il voto.
Il terzo profilo riguarda la proprietà, ed è quello che si tende a sottovalutare finché non ci si ritrova dalla parte sbagliata. Prometheus non fattura per host, per metrica o per etichetta, e nessuna pagina dei prezzi può cambiarti sotto i piedi il prossimo trimestre. Lo scambio rispetto a un servizio gestito come Datadog: rinunci alla rifinitura, al contratto di supporto e alla reperibilità di qualcun altro, e in cambio ottieni metriche che sono tue, su una fattura che non si muove quando uno sviluppatore aggiunge strumentazione. Se sia un buon scambio dipende da quanto valgono le tue ore, un numero che puoi inserire solo tu (e raramente è zero, anche quando sembra esserlo).
Una cosa da sapere prima di impegnarti: superare lo storage locale di Prometheus non è un vicolo cieco. VictoriaMetrics accetta le remote write di Prometheus, e la MetricsQL è retrocompatibile con PromQL, quindi la maggior parte delle query e delle dashboard Grafana che costruisci ora dovrebbe sopravvivere al passaggio. È una migrazione, non una riscrittura.
Vale la pena riconsiderarlo una volta l'anno anziché deciderlo una volta per tutte: l'installazione che oggi costa poco da monitorare diventa cara nel trimestre in cui inizi a ricostruirla.

Costruisci su un VPS Linux con accesso root, NVMe e la potenza di AMD EPYC.
Vedi piani LinuxChi dovrebbe lasciar perdere Prometheus?
Se la frase con cui descriveresti ciò che ti serve è «avvisami quando il sito va giù», stai descrivendo un controllo di disponibilità, e Prometheus è un bel po' di macchinario per arrivare a quella risposta. Uptime Kuma fa esattamente quel lavoro con un'interfaccia web e non ti chiede di imparare un linguaggio di query per il monitoraggio. Il divario di funzionalità fra i due strumenti è enorme e del tutto irrilevante per il lavoro per cui li stai assumendo.
Il secondo lettore è chi vuole grafici utilizzabili senza prima imparare un linguaggio di query. Netdata è costruito esattamente attorno a questo: metriche per host che puoi guardare subito, con molta meno configurazione e senza nulla fra te e i grafici. Se la domanda che ti fai di continuo è «perché questa macchina è lenta adesso», quella è una strada molto più corta verso una risposta.
Il terzo è chiunque abbia un'infrastruttura che cambia forma spesso e che gestisca a mano target e variabili delle dashboard. Host tirati su per una settimana e distrutti, target rinominati, progetti che cambiano nome a metà strada. È il caso in cui paghi il costo della configurazione ancora e ancora ottenendo il minimo da ciò per cui stai pagando, cioè lo storico continuo di un sistema che resta riconoscibile.
Niente di tutto questo è una critica allo strumento. «Lasciar perdere» qui significa lasciar perdere per questo lavoro, a questa scala. Alla scala di Kubernetes, dove il service discovery si occupa della maggior parte di ciò che altrimenti cableresti a mano, diversi dei costi qui sopra si riducono o spariscono del tutto, e la mia lettura di quella scala è che lì Prometheus sia difficilissimo da battere. Ma quella è un'altra recensione.

Domande frequenti
Prometheus è gratuito?
Sì, e sotto non c'è nessuna trappola da piano gratuito. Prometheus è rilasciato sotto licenza Apache 2.0 senza alcuna edizione commerciale alle spalle, quindi non c'è nessuna quota di metriche da superare né alcun invito all'upgrade ad aspettarti dall'altra parte. Paghi l'infrastruttura e il tuo tempo, non una licenza Prometheus.
Prometheus ha bisogno di Grafana?
No, ma mettilo in conto. Il browser di espressioni di Prometheus esiste per lanciare una query e guardare la risposta, il che copre il controllare una cosa una volta. Tutto ciò che vuoi lasciare aperto su un secondo monitor è lavoro per Grafana, e i due vengono quasi sempre eseguiti insieme.
Prometheus è eccessivo per un singolo server?
Spesso sì. Se ti serve solo sapere se il server e i suoi servizi sono attivi, un controllo di disponibilità risponde in una frazione del tempo di installazione. Prometheus si guadagna il suo posto quando vuoi metriche storiche interrogabili e sei disposto a imparare PromQL per arrivarci.
Per quanto tempo Prometheus conserva le metriche per impostazione predefinita?
15 giorni, e non ti avvisa prima. Prometheus scarta i campioni più vecchi della finestra di conservazione, a meno che tu non la alzi con un flag di tempo o di dimensione di conservazione all'avvio. Impostala il giorno stesso in cui installi, perché allargare la finestra in seguito non riporta indietro i dati già scaduti.



Discussione
Commenti
Accedi per partecipare alla discussione.