

PRTG fattura per sensore, cioè una metrica monitorata su un dispositivo, non il dispositivo in sé. I livelli pubblicati da Paessler fissano il rapporto pratico a circa dieci a uno: 500 sensori coprono circa 50 dispositivi, 10.000 ne coprono circa 1.000. Aggiungi uno stack di switch e inizia a osservare il throughput per porta, e il conteggio cresce più in fretta del parco macchine. SolarWinds conta in modo diverso e arriva allo stesso punto.
Per una rete prevalentemente Windows, metterei in lista due alternative self-hosted a PRTG e SolarWinds: Zabbix, oppure uno stack basato su Prometheus se il tuo team ne gestisce già uno. La scelta tra i due dipende da cosa ciascuno riesce a vedere su un host Windows e da cosa gli serve per vederlo.
Una precisazione prima di tutto il resto. Se nessuno nel team ha ore libere, PRTG e SolarWinds restano la risposta giusta. La loro facilità d'uso è un prodotto che compri di proposito, e vale i soldi che costa. Il passaggio descritto qui spende ore invece di canoni di licenza, ed è uno scambio, non un upgrade.
TL;DR
- La scelta predefinita è Zabbix. Zabbix mette il polling SNMP, gli agent Windows, i template e gli alert dentro un'unica piattaforma di monitoraggio. Devi comunque gestire il server Zabbix, il database e il frontend web, ma non assembli componenti di monitoraggio separati solo per partire.
- L'eccezione è un team che già usa Grafana e Prometheus per le metriche di applicazioni e host. Estendere ciò che già mantieni costa meno che mettere in piedi un secondo sistema di monitoraggio.
- Prometheus non interroga i dispositivi di rete da solo.
snmp_exportercolma quella lacuna; la sua configurazione predefinita copre molti switch e router comuni, mentre oggetti specifici del produttore o polling personalizzato possono richiedere il generatore e ulteriore lavoro sulle MIB. - La raccolta senza agent vede solo ciò che un host o un dispositivo sceglie di pubblicare. In Zabbix, i registri eventi di Windows, lo stato dei servizi e i contatori di prestazioni granulari sono item key dell'agent.
- Dimensiona il server per metriche, non per dispositivi. Zabbix conta una metrica come un item più un trigger più un grafico, e colloca circa 1.000 metriche su 2 core CPU e 8 GiB di memoria, circa 10.000 su 4 core e 16 GiB.
Cosa fanno pagare PRTG e SolarWinds
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
SolarWinds conta un'unità diversa, e la regola è facile da trascurare finché non arriva il preventivo di rinnovo. Il modello di licenza NPM di SolarWinds stabilisce che NPM «è concesso in licenza in base al numero più alto tra i seguenti tipi di elementi di rete monitorati: nodi, interfacce, volumi». Non la somma. Il più alto dei tre. Una rete con 80 nodi e 900 porte di switch monitorate viene licenziata sui 900, non sugli 80, e i livelli vanno da SL100 a SLX. Un singolo motore di polling ha un tetto di 12.000 elementi (la somma di nodi, interfacce e volumi, non il più alto tra loro) a prescindere dal livello, oltre il quale aggiungi un altro motore di polling con licenza.
L'effetto pratico dei due modelli è lo stesso. Il livello di licenza decide cosa viene monitorato. Non la rete. Interfacce che vorresti tenere d'occhio restano senza monitoraggio perché farlo supererebbe una soglia, e quel costo non compare mai in fattura.
Le due strade self-hosted che vale la pena percorrere
Zabbix è un'unica piattaforma di monitoraggio costruita attorno a un server centrale, un database e un frontend web. Il server interroga i dispositivi SNMP, riceve i dati dagli agent Windows e applica template, trigger e alert nello stesso prodotto. Rispetto ad assemblare uno stack di monitoraggio di rete basato su Prometheus, ci sono meno componenti separati da integrare per conto tuo. Lo installi, lo punti agli host e colleghi i template, cioè pacchetti riutilizzabili di item, trigger e grafici che coprono una classe di dispositivi.
Parti dalla licenza. La pagina della licenza di Zabbix afferma che ogni versione dalla 7.0 in poi è rilasciata sotto la GNU Affero General Public License versione 3, e che tutto fino alla 6.4 era in GPLv2. Non c'è alcun canone di licenza per il software, a qualsiasi scala. Zabbix vende il supporto tecnico come abbonamento opzionale separato e chiede agli utenti commerciali di acquistarne un livello, ma niente nel prodotto è bloccato dietro quell'acquisto.
La seconda strada è Grafana, Prometheus e VictoriaMetrics. È la scelta giusta in esattamente una situazione: usi già questo stack per le metriche di applicazioni e host, e qualcuno lo mantiene già. Se è il tuo caso, la configurazione completa su un singolo VPS è un problema già risolto e stai estendendo qualcosa di familiare. Nessuno deve imparare un nuovo modello di dati.

Il punto debole di quella strada sono i dispositivi di rete. Prometheus raccoglie da endpoint HTTP; non parla SNMP direttamente. Gli apparati di rete si gestiscono di norma tramite snmp_exporter, che interroga il dispositivo ed espone i risultati perché Prometheus li raccolga. La sua configurazione predefinita include moduli come if_mib, quindi il monitoraggio standard delle interfacce su molti switch e router non richiede di generare una configurazione personalizzata. Il generatore diventa lavoro extra quando ti servono oggetti specifici del produttore, walk personalizzati o MIB non incluse di default. La strada Prometheus ha quindi più pezzi da mantenere rispetto a Zabbix, ma il generatore non è obbligatorio per ogni dispositivo.
LibreNMS è il terzo nome in questo ambito, costruito attorno alla scoperta automatica: percorre una rete tramite SNMP, CDP, LLDP, OSPF, BGP e ARP per trovare cosa c'è. È un'opzione ragionevole quando la scoperta è la priorità. Non cambia la questione della raccolta su Windows, che è dove si decide questa scelta.
Come ogni strada vede un host Windows
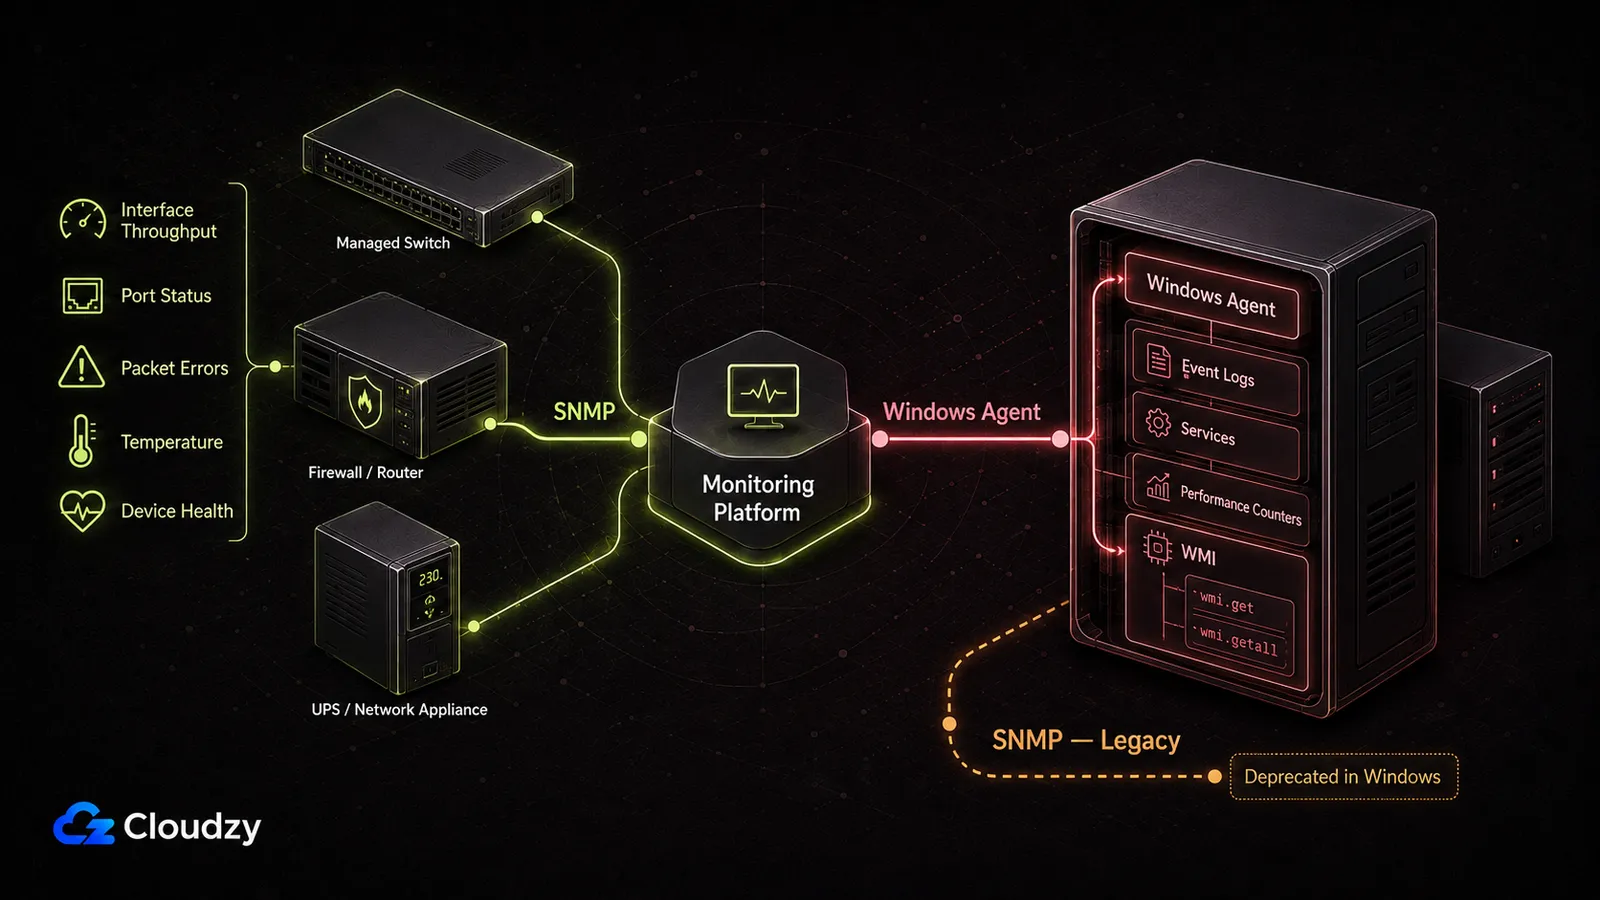
Il monitoraggio di Windows può passare per SNMP, WMI remoto o un agent installato. Quale strada si applica dipende dal prodotto di monitoraggio e dalla metrica raccolta. In Zabbix nello specifico, i controlli WMI integrati passano dall'agent Windows.
SNMP
Un polling SNMP chiede a un dispositivo il valore corrente di un oggetto numerato, indirizzato da un OID, cioè una posizione nella MIB del dispositivo. Quello che torna è ciò che il dispositivo pubblica e nient'altro. Su uno switch gestito, un firewall o un UPS di solito basta: contatori delle interfacce, stato delle porte, tassi di errore, temperatura, salute dello chassis.
Su Windows il quadro è più povero. L' avviso di deprecazione di Microsoft per SNMP e WMI SNMP Provider conferma che entrambe le funzionalità sono deprecate, quindi tratterei l'SNMP di Windows come percorso di compatibilità legacy e non come impostazione predefinita per una nuova installazione. Zabbix fornisce ancora un template Windows by SNMP, ma l'agent nativo ti dà molta più visibilità sul sistema operativo.
WMI
WMI può essere interrogato da remoto senza installare un agent di monitoraggio sul target, ed è per questo che prodotti come PRTG possono usarlo come metodo di raccolta Windows senza agent. Zabbix funziona in modo diverso. I suoi controlli WMI integrati, wmi.get e i piani wmi.getall, sono item key dell'agent Windows, quindi è l'agent Zabbix o l'agent 2 a eseguire quelle query sulla macchina monitorata.
Il WMI remoto porta anche i propri requisiti di rete quando un prodotto di monitoraggio lo usa direttamente. Sui sistemi Windows attuali, RPC parte sulla porta TCP 135 e di norma negozia le connessioni attraverso l'intervallo dinamico di porte TCP alte, tipicamente da 49152 a 65535. Il firewall e i permessi WMI sul target devono consentire la connessione.
Per questo confronto, la distinzione conta più del protocollo in sé: PRTG può usare il WMI remoto senza un agent di monitoraggio installato, mentre Zabbix ottiene la sua visibilità WMI specifica per Windows tramite il proprio agent.
L'agent nativo
L'agent è dove risiede la profondità specifica per Windows. La documentazione di Zabbix elenca le chiavi specifiche per Windows: eventlog per il monitoraggio del registro eventi di Windows, perf_counter per qualsiasi contatore di prestazioni di Windows, service.discovery e i piani service.info per lo stato dei servizi. Sono tutte item key dell'agent.
Il costo è il rollout. Un agent su ogni Windows Server e ogni workstation che ti interessa è un pacchetto da distribuire, una versione da tenere aggiornata e una regola firewall da mantenere. È un impegno operativo permanente, ed è il contrappeso del risparmio sulla licenza.
La raccolta senza agent è limitata a ciò che l'host o il dispositivo sceglie di pubblicare, e in Zabbix i registri eventi e i contatori di prestazioni granulari stanno dietro item key dell'agent.
A confronto
Il confronto ruota attorno a quattro cose: se lo strumento interroga i dispositivi di rete via SNMP, se ha un agent Windows, quanto a fondo riesce a vedere dentro un host Windows e quanto assemblaggio c'è tra te e un sistema funzionante. La licenza sta accanto a questi perché è il motivo per cui la valutazione è iniziata.
| Strumento | Polling SNMP dei dispositivi | Monitoraggio Windows | Sforzo di configurazione | Licenza |
|---|---|---|---|---|
| Zabbix | Integrato | Agent: registri eventi, stato dei servizi, contatori di prestazioni e WMI; stato di massima via SNMP | Moderato: un server, poi i template | AGPLv3, nessun canone di licenza; supporto venduto a parte |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | Non integrato; richiede snmp_exporter come componente separato | Nessun agent Windows nativo; le metriche host arrivano da exporter separati; i registri eventi non sono nativi | Alto: più componenti; l'SNMP personalizzato può richiedere lavoro sul generatore | Componenti open source, nessun canone di licenza |
| Monitor di uptime e stato | Nessuno | Solo raggiungibilità dei servizi e tempo di risposta | Basso: minuti | Varia in base allo strumento |
Se il requisito è «avvisami entro un minuto quando un servizio smette di rispondere», un monitor di uptime è lo strumento della misura giusta e gli altri due sono sovradimensionati per questo. Quello che non farà è interrogare uno switch per il throughput di un'interfaccia o leggere un contatore di prestazioni di Windows, quindi non sostituisce PRTG o SolarWinds. È un lavoro diverso che a volte viene scambiato per lo stesso.

Quale scegliere
Scegli Zabbix. Per una rete prevalentemente Windows senza un investimento Prometheus esistente, è di gran lunga la strada più breve. Hai comunque un server, un database e un frontend web da gestire, ma il modello di monitoraggio, i template e gli alert vivono in un unico prodotto invece di essere assemblati da più componenti di monitoraggio.
Per un'installazione di monitoraggio di lunga durata, usa il ramo LTS corrente di Zabbix invece di una release standard a breve termine. Il ciclo di vita LTS di Zabbix dà a ogni release tre anni di supporto completo seguiti da due anni di supporto limitato, il che qui conta più che inseguire l'ultima release con nuove funzionalità.
L'eccezione è stretta e precisa. Se il tuo team usa già Grafana e Prometheus in produzione per le metriche di applicazioni e host, e qualcuno è già responsabile di quello stack, allora snmp_exporter è un'aggiunta a qualcosa di mantenuto anziché un secondo sistema da mantenere. Quella condizione è congiunta: entrambe le metà devono valere. Un'istanza Grafana abbandonata che qualcuno ha messo su l'anno scorso non conta.
E se nessuno ha le ore, rinnova. Non è una scappatoia. È una situazione diversa con una risposta corretta diversa. Il passaggio converte un costo di licenza in un costo operativo: rollout degli agent, lavoro sui template, aggiornamenti e qualcuno che capisca il sistema abbastanza bene da ripararlo alle 2 di notte. Un team già al limite farà quel lavoro male o non lo farà affatto, e un monitoraggio non mantenuto è peggio di un monitoraggio costoso, perché fallisce in silenzio.
L'ibrido esiste davvero: tieni il prodotto attuale su un nucleo sempre più piccolo di sistemi critici, sposta tutto il resto su Zabbix e lascia che il livello di licenza scenda nel tempo. Funziona. Significa però anche gestire due sistemi di monitoraggio e riconciliare i loro alert, quindi trattalo come uno stato di transizione con una data di fine.
Cosa non sopravvive alla migrazione
La guida alla migrazione di Zabbix stessa ha una sezione intitolata «Cosa NON viene migrato», e l'elenco è più lungo di quanto la parola «migrazione» lasci intendere. I dati storici e le letture dei sensori non passano. Le notifiche e le dipendenze personalizzate di PRTG nemmeno. Le mappe e le dashboard nemmeno, perché i due prodotti le modellano in modo così diverso che ricostruire batte tradurre. I sensori stessi nemmeno, dato che Zabbix lavora con un concetto del tutto diverso.
Nomi dei dispositivi, indirizzi IP e tipi di interfaccia possono essere trasferiti. Anche questo passa da script personalizzati di esportazione e importazione contro entrambe le API. La guida dice chiaramente che non esiste alcuno strumento ufficiale per migrare direttamente tra le due piattaforme.
Un team ha documentato quanto costa in pratica: circa 500 VM e server fisici, circa sette anni su PRTG, ricostruiti da zero in sei mesi di progetto a bassa priorità. I loro 2.500 sensori PRTG sono diventati 43.000 item Zabbix, un'illustrazione chiara di quanto diversamente contino i due sistemi.
«Ricomincia da zero. Non esiste un'opzione «premi questo pulsante e migra» da PRTG a Zabbix, e anche se esistesse, un'operazione del genere è una buona occasione per non ripetere gli errori di progettazione precedenti.»
È l'esperienza di una sola organizzazione, non un riferimento. Un parco più piccolo non produrrà quei numeri. Ciò che si trasferisce è l'ipotesi di pianificazione: metti in budget tempo di ricostruzione, non tempo di migrazione.
Ordina la ricostruzione in base a ciò di cui non puoi fare a meno. Se la tua preoccupazione è la continuità degli alert, ricostruisci prima le regole di notifica e lascia indietro le dashboard. Se è lo storico dei report, esporta ciò che ti serve prima che scada la vecchia licenza. Non verrà con te.
Dimensionare il server
I requisiti hardware di Zabbix collocano un'installazione piccola di circa 1.000 metriche monitorate su 2 core CPU e 8 GiB di memoria, e un'installazione media di circa 10.000 metriche su 4 core e 16 GiB. Sono questi i numeri su cui basare la richiesta.
L'unità è il punto in cui il dimensionamento sbaglia. Zabbix definisce una metrica monitorata come un item più un trigger più un grafico. Una metrica non è un dispositivo e non è un host. Un singolo Windows Server contribuisce con tante metriche quanti item configuri: CPU, memoria, ogni filesystem, ogni servizio, ogni contatore che campioni. Il numero di dispositivi è una guida scadente per la macchina che ti serve. Un parco che sembra piccolo può finire nella fascia media senza che nessuno faccia nulla di insolito.
Due cose spingono il numero verso l'alto più in fretta del numero di host. La prima è la frequenza di polling: dimezzare un intervallo di aggiornamento raddoppia il tasso di scrittura per ogni item su quell'intervallo. La seconda è la conservazione dello storico, dato che il database cresce con il tempo per cui tieni i valori grezzi. Il numero di dispositivi conta soprattutto attraverso il numero di item monitorati che ogni dispositivo aggiunge.
Se il tuo parco resta vicino all'esempio delle 1.000 metriche con intervalli di aggiornamento ordinari e conservazione modesta, la fascia piccola è un punto di partenza ragionevole. Se campioni i contatori di prestazioni ogni trenta secondi e conservi un anno di storico grezzo, non lo è. Zabbix è esplicito nel dire che i numeri pubblicati sono «esempi di dimensione e configurazione hardware da cui partire», e raccomanda di fare benchmark in un ambiente di staging prima di impegnare hardware di produzione. È l'avvertenza del produttore stesso. Prendila alla lettera.
Zabbix supporta il componente server solo su Linux e UNIX; su Windows è supportato solo l'agent.
Le metriche non sono dispositivi, e il moltiplicatore tra i due è ciò che determina la dimensione della macchina.

Costruisci su un VPS Linux con accesso root, NVMe e la potenza di AMD EPYC.
Vedi piani LinuxDove mettere il server di monitoraggio
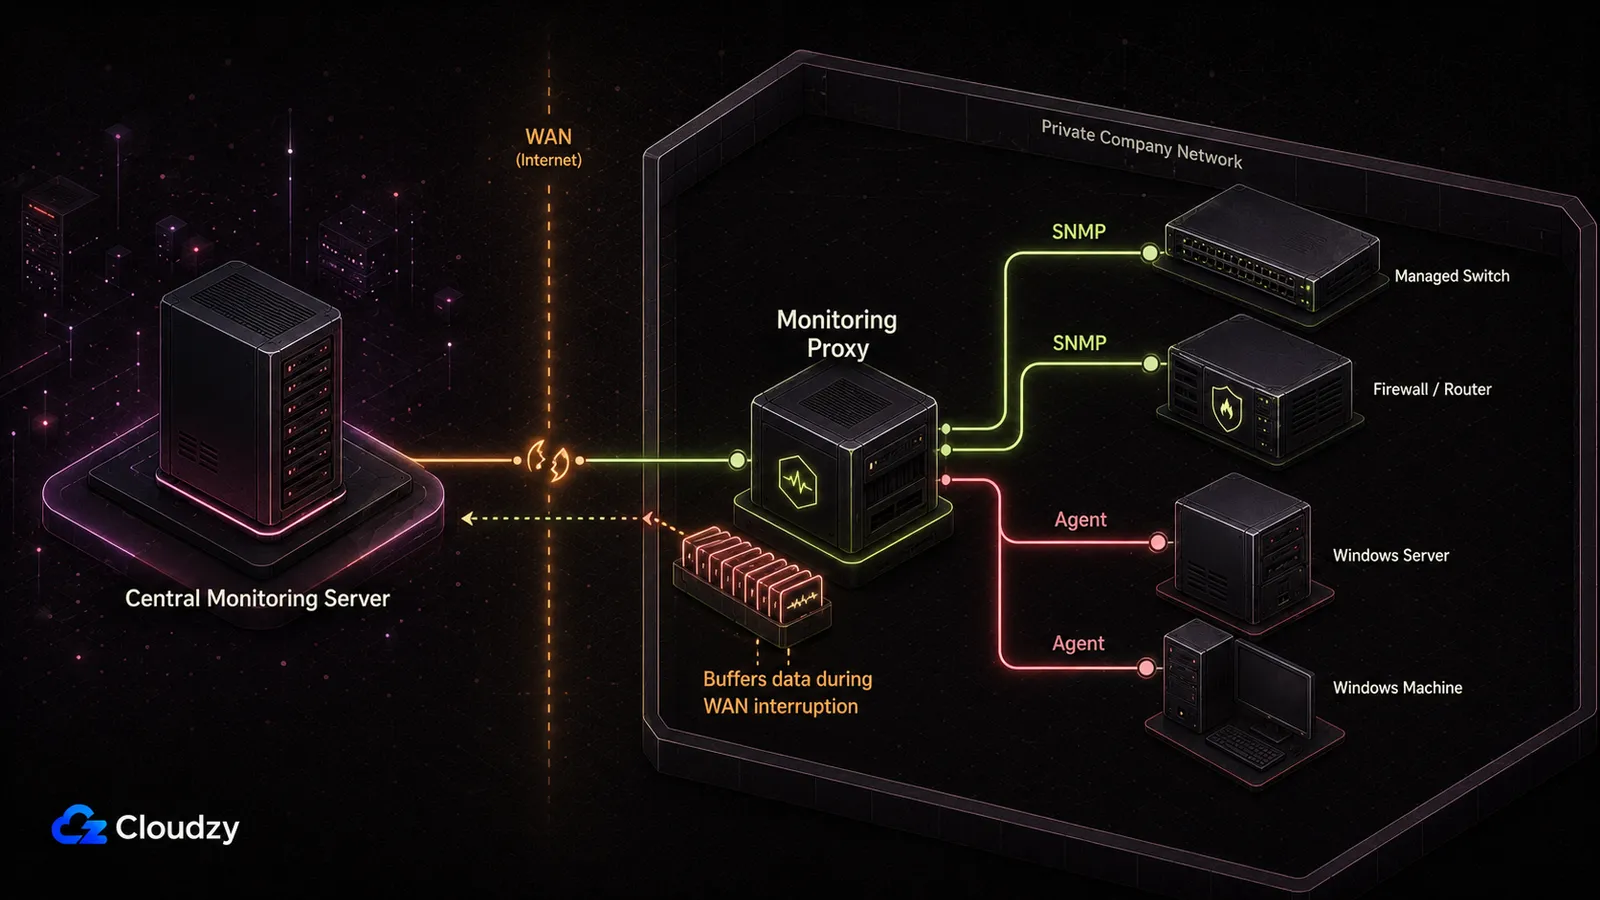
Se hai bisogno che il monitoraggio sopravviva a un'interruzione dell'intera sede, tieni il server Zabbix centrale fuori dal dominio di guasto della sede. Perdere l'uplink della sede può allora mettere offline la rete monitorata senza portarsi dietro il server di monitoraggio.
Per una rete privata, un proxy Zabbix può stare dentro la sede e raccogliere dai sistemi che lo circondano. Il proxy può gestire localmente i controlli SNMP e agent, rimandare i dati raccolti al server centrale e mettere in buffer i dati di monitoraggio finché la connettività tra i due non è disponibile. Questo permette al server centrale di restare fuori dalla sede senza richiedere che ogni switch, firewall e host Windows privato sia raggiungibile direttamente da Internet.
Un VPS è un posto pratico dove far girare quel server centrale. Cloudzy offre Server Zabbix come installazione con un clic su Ubuntu Server 24.04 LTS, se vuoi saltare l'installazione iniziale e passare direttamente alla configurazione di host e template.
Domande frequenti
Zabbix è davvero gratuito?
Sì. Zabbix è rilasciato sotto la GNU Affero General Public License versione 3 dalla versione 7.0 in poi, e non c'è alcun canone di licenza per il software, a prescindere da quanti dispositivi o metriche monitori. Zabbix vende il supporto tecnico come abbonamento opzionale separato, ma nessuna funzionalità del prodotto è bloccata dietro di esso. Il costo di far girare Zabbix è il server su cui gira e le ore che spendi per gestirlo.
Devo installare un agent su ogni Windows Server?
Non su ogni macchina Windows, ma se vuoi la profondità di monitoraggio Windows nativa di Zabbix, pianifica di installare l'agent sui server che ti interessano di più. L'SNMP può fornire dati di massima senza agent, anche se la funzionalità SNMP di Windows è deprecata da Microsoft. Anche i controlli WMI integrati di Zabbix passano dal suo agent Windows, quindi WMI non è un percorso di raccolta senza agent diretto in Zabbix. Usa l'agent per registri eventi, scoperta dei servizi, query WMI e contatori di prestazioni granulari; tieni l'SNMP senza agent soprattutto per l'hardware di rete e i casi Windows legacy.
Posso far girare il server di monitoraggio su Windows?
Non con Zabbix. La documentazione dei requisiti di Zabbix elenca il componente server come supportato solo su Linux e altre piattaforme UNIX, e afferma che «UNIX è l'unico sistema operativo in grado di garantire in modo costante le prestazioni, la tolleranza ai guasti e la resilienza necessarie». Il supporto per Windows copre l'agent Zabbix e l'agent 2, cioè ciò che installi sulle macchine monitorate. Il server di monitoraggio sta su un host Linux; il parco Windows è ciò che osserva.
Prometheus fa monitoraggio SNMP?
Non da solo. Prometheus raccoglie da endpoint HTTP e usa snmp_exporter per raccogliere dai dispositivi SNMP. La sua configurazione predefinita copre molti switch e router comuni, mentre oggetti specifici del produttore o polling personalizzato possono richiedere configurazione MIB aggiuntiva e il generatore.



Discussione
Commenti
Accedi per partecipare alla discussione.