

Algo que você construiu está em produção. Seu monitoramento é ou nada, ou um ping de disponibilidade, e na semana passada você soube de uma queda por um usuário. Toda resposta que você vai procurar aponta para o mesmo nome.
Esta análise do Prometheus trata da distância entre duas coisas que são verdadeiras ao mesmo tempo. Ele é gratuito e de código aberto, sem licença e sem cobrança por métrica em nenhuma escala. Ele também custa uma noite sua, mais uma linguagem de consulta que você ainda não conhece. É um coletor de métricas baseado em pull com alertas acoplados, e é um software excelente. Se é o software certo para o ambiente que você roda agora é outra pergunta, e é essa que vale a pena responder.
A versão curta
- Veredicto: 3,5 / 5 para quem hospeda sozinho ou em equipe pequena. O Prometheus vale a pena se o seu conjunto de hosts e serviços for razoavelmente estável, você estiver disposto a investir tempo aprendendo PromQL e quiser métricas que sejam inteiramente suas, sem assinatura e sem conta de retenção.
- Pule se a pergunta que você precisa responder for “está no ar?”. Um verificador de disponibilidade te leva até essa resposta muito mais rápido, e recorrer ao Prometheus para essa tarefa significa pagar por uma linguagem de consulta para responder algo que você resolveria em dez minutos.
- O PromQL é o custo que não para de voltar. Configurar é um custo único. Assim que suas perguntas ultrapassam os dashboards prontos e o construtor visual do Grafana, você está de volta ao PromQL.
- O custo de manutenção acompanha o quanto do ambiente você administra na mão. Uma frota que mantém a forma é barata de monitorar. Uma que ganha, perde e renomeia hosts é exatamente onde o custo se acumula em silêncio.
- Este veredicto se restringe a self-hosting de pequena escala. Na escala do Kubernetes e do SRE em produção, o Prometheus é uma proposta completamente diferente, e esta análise não tenta responder a essa pergunta.
Como esta análise foi feita: O Prometheus é gratuito e de código aberto, então não há aqui nenhuma relação com fornecedor e ninguém me enviou nada. As informações sobre versões e comportamento do armazenamento vêm da documentação oficial do Prometheus. Os números de consumo de recursos e os tempos de instalação vêm de dois testes práticos publicados de forma independente, creditados no ponto em que cada um é usado. Onde os dois divergem, você verá os dois números em vez de uma média.
O que esta análise cobre
O veredicto acima tem limites, e esses limites pesam mais do que o normal aqui, porque o Prometheus se comporta como uma ferramenta diferente em cada escala.
- Prometheus avaliado para self-hosting em um único VPS e para projetos pequenos: um punhado de hosts e serviços, com uma única pessoa cuidando deles.
- Não é Kubernetes. Prometheus Operator, ServiceMonitors e o kube-prometheus-stack formam um mundo operacional à parte, e o veredicto aqui não diz nada sobre aquele.
- Não é um guia de roteamento do Alertmanager. O alerta existe e funciona; configurar rotas, silences e receivers é um assunto por si só.
- Não é um passo a passo de instalação. A pergunta aqui é se vale rodar isso, ponto. Se essa você já respondeu, nosso guia de Grafana e Prometheus com Docker Compose cobre as etapas.
- Não é um panorama de exporters. Os exporters aparecem apenas onde mudam a resposta.
O que o Prometheus acerta
O Prometheus não custa nada. Não é “plano gratuito com upgrades pagos”, nem “gratuito até você cruzar um limite de métricas”. O repositório é licenciado sob Apache 2.0 de ponta a ponta, não existe edição paga do projeto principal e não há cobrança por host, por métrica ou por rótulo em lugar nenhum. A única conta que o Prometheus gera é o servidor em que ele roda.
Para algo em que você pretende se apoiar, “isso ainda vai existir daqui a três anos” é uma pergunta justa, e aqui as chances são das melhores que o código aberto costuma oferecer. O Prometheus se formou na CNCF em agosto de 2018, como o segundo projeto da história a conseguir isso, depois do Kubernetes. As versões saem com regularidade, com a v3.13.2 lançada no fim de julho de 2026, e como essa linha de versões é uma linha de suporte de longo prazo, ela recebe correções de bugs, de segurança e de documentação por um ano, então manter tudo atualizado não significa correr atrás de cada versão menor.
O modelo de dados é o motivo de o ecossistema ao redor dele ser tão profundo. O Prometheus coleta métricas por HTTP e identifica cada série por um nome de métrica mais rótulos de chave/valor, o que torna escrever um exporter um trabalho pequeno. Por isso existem exporters para praticamente tudo o que você poderia rodar: métricas de nó, Postgres, Nginx, Redis, sondas blackbox para as coisas que só dá para cutucar de fora.
E você é dono do que ele coleta, que é a parte que costuma importar mais tarde do que no primeiro dia. O histórico de um ambiente pequeno ocupa uma quantidade irrisória de disco (os números estão logo abaixo), ninguém pode reprecificá-lo no próximo trimestre, e não existe linha na fatura que cresça toda vez que alguém adiciona instrumentação a uma aplicação. Se você já viu a conta de um monitoramento gerenciado subir porque um desenvolvedor acrescentou um rótulo, o argumento inteiro cabe nessa frase.
Onde o Prometheus custa mais do que parece
Um teste no dev.to com sete ferramentas de monitoramento em um único VPS pequeno mediu 15 minutos para instalar só o Prometheus. Combine com o Grafana, como fez o autor do teste, porque o navegador de expressões embutido é apenas um lugar para rodar consultas. O mesmo teste coloca Grafana + Prometheus em 35 minutos até o primeiro gráfico, com configuração de scrape em YAML no meio do caminho.
Os minutos são a parte barata. A cara é o PromQL. O Prometheus guarda tudo como séries temporais identificadas por nome e rótulos, e o PromQL continua sendo a linguagem por baixo das perguntas que você faz a ele. O Grafana já tem um construtor visual, então você não precisa escrever cada consulta na mão. O veredicto do próprio autor do teste foi direto: o PromQL é maravilhoso para quem vive dentro dele, e ele não vivia. Se você nunca usou uma linguagem de consulta, reserve mais de uma noite para isso e conte com voltar a ela sempre que o construtor visual deixar de bastar. Um dashboard copiado de outra pessoa responde às perguntas dela. As suas são uma consulta que você ainda não escreveu.
O terceiro custo é aquele que só aparece mais tarde. Um relato de três semanas de um operador descreve exatamente o que envolveu acrescentar um único servidor a um ambiente de sete nós: rerrotular, revisar de novo as configurações de scrape, editar variáveis de dashboard e refazer as consultas de template para que o novo host aparecesse nos menus suspensos. Esse operador abandonou a stack depois de três semanas, tendo concluído que gastava mais tempo ajustando dashboards do que observando a própria infraestrutura.
Repare a que esse custo está preso nesse tipo de ambiente: a targets e dashboards administrados na mão. Rodar o Prometheus por dois anos tranquilos não custa quase nada além disso.
De quanta RAM e de quanto disco o Prometheus realmente precisa?
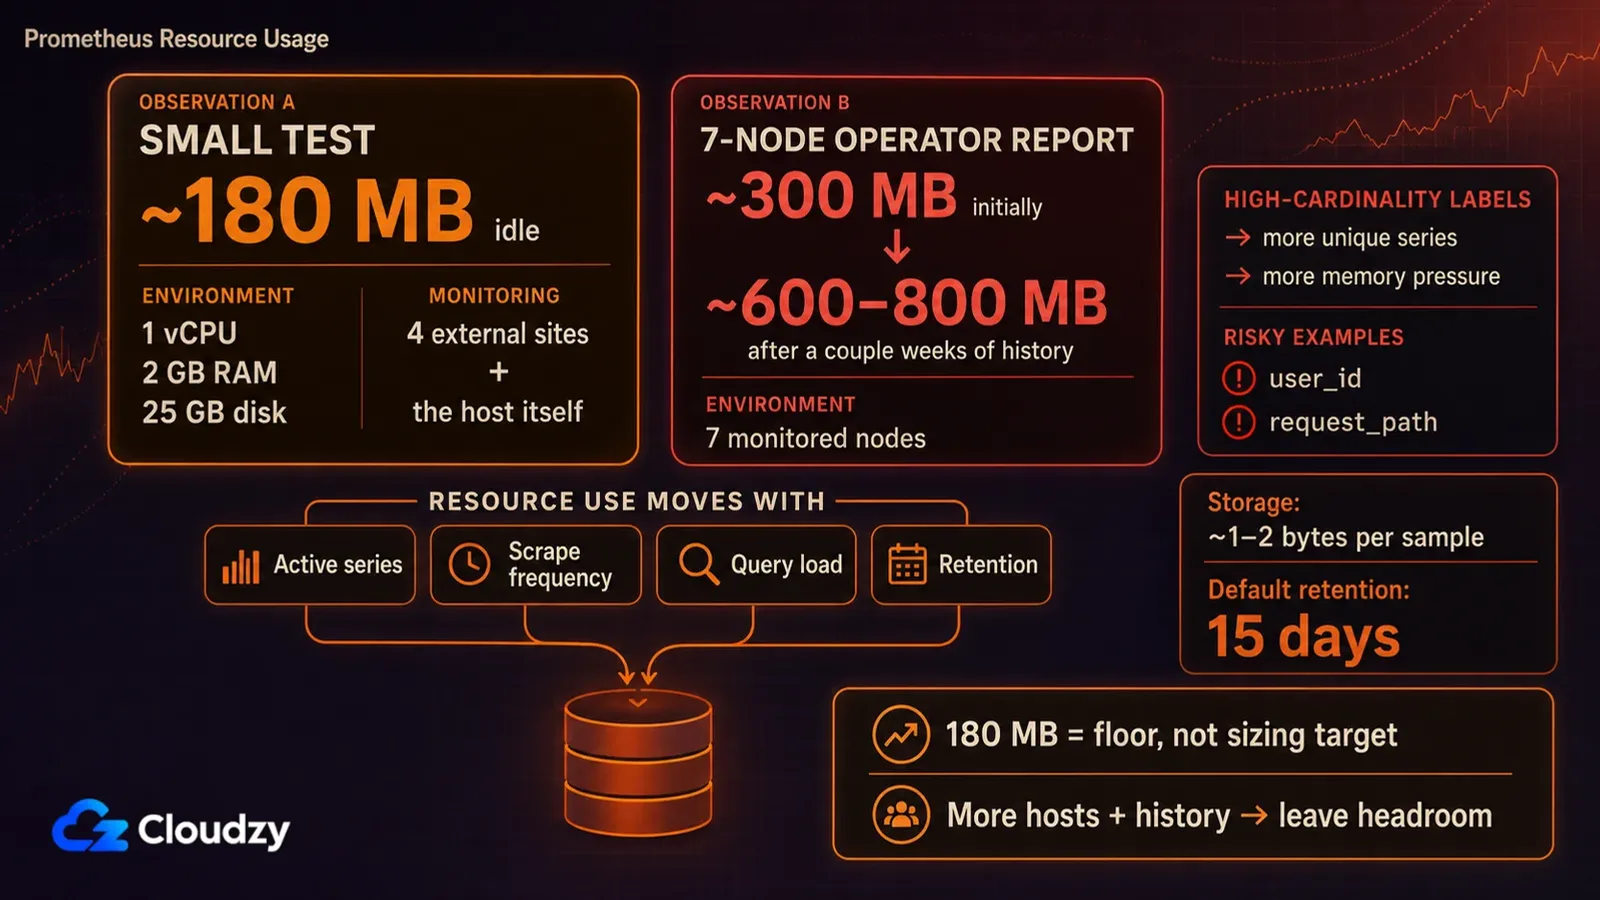
Não existe requisito fixo. Séries ativas, frequência de coleta, carga de consultas e tempo de retenção contam mais do que o número bruto de servidores para os quais você o aponta. Dois testes práticos publicados sobre ambientes pequenos o colocam entre mais ou menos 180 MB e 800 MB, com o número mais alto cobrindo sete nós e algumas semanas de histórico.
Os dois testes discordam, e a discordância é justamente a parte útil. A mesma comparação de sete ferramentas em VPS rodou cada uma em hardware idêntico (1 vCPU, 2 GB de RAM, 25 GB de disco, Ubuntu 24.04) observando quatro sites externos mais o próprio host, e mediu o Prometheus em cerca de 180 MB em repouso. O mesmo operador relatou que só o Prometheus ficava em torno de 300 MB em repouso no host central, subindo para 600 a 800 MB depois que algumas semanas de histórico se acumularam.
Não são a mesma medição, e é por isso que tirar a média jogaria a informação fora. Uma é uma leitura quase em repouso em uma máquina com muito pouco a armazenar. A outra é uma implantação em funcionamento, com uma frota atrás e histórico em disco. Minha leitura: trate o resultado de 180 MB como piso, não como meta de dimensionamento. A partir do momento em que você coleta de vários hosts e guarda histórico, deixe folga em vez de planejar por aquele número em repouso.
O disco é a metade fácil. A documentação de armazenamento do Prometheus coloca a média em 1 a 2 bytes por amostra, então guardar um histórico longo para um ambiente pequeno sai barato. A pegadinha está no valor padrão: a retenção vem definida em 15 dias por padrão a menos que você defina um tempo ou um tamanho de retenção. Um único parâmetro de inicialização separa isso de um ano inteiro, e é o tipo de padrão que você prefere descobrir agora, e não na primeira vez que for atrás dos números do mês passado e vir que expiraram três semanas atrás.
O que empurra o número de memória para cima é a cardinalidade: a quantidade de séries temporais distintas, em que cada combinação única de rótulos em uma métrica vira uma série própria. Um único rótulo mal escolhido numa métrica de tráfego alto pode criar mais séries do que cinco servidores extras criariam, e faz isso em silêncio, no ritmo em que o seu tráfego estiver correndo. (Um ID de usuário ou um caminho de requisição parece um ótimo rótulo até o momento em que você conta quantos existem.)
Qualquer número de RAM que você encontre citado para o Prometheus só é aproveitável se você souber também quantas séries estavam por trás dele.
O que acontece quando o seu servidor Prometheus cai?
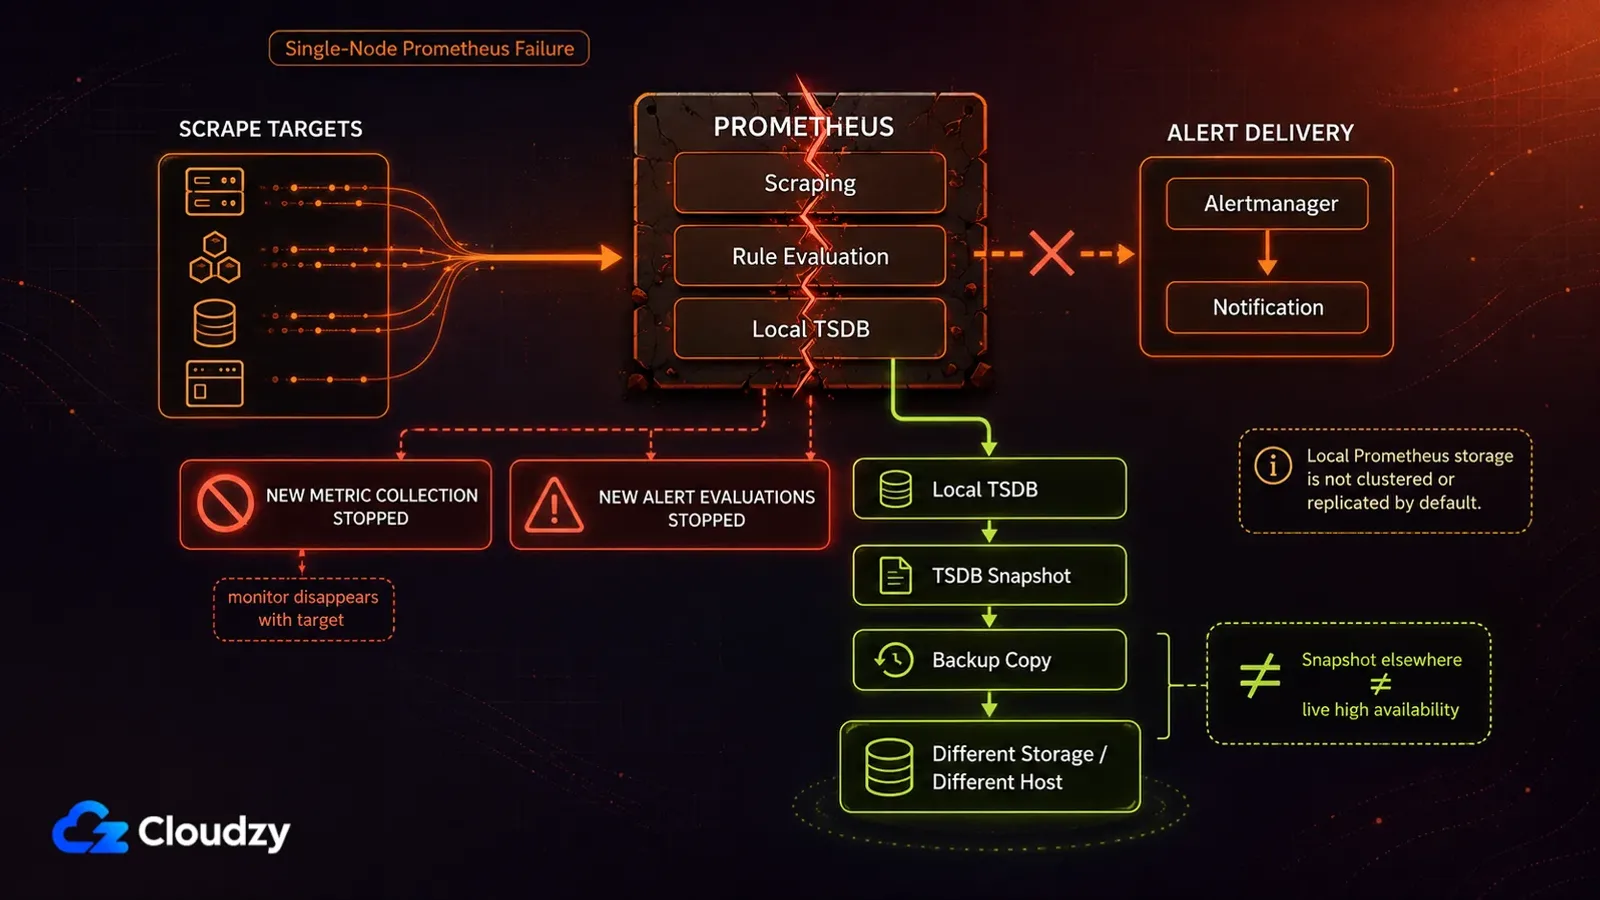
A própria documentação de armazenamento do Prometheus é direta quanto a isso: o armazenamento local não é clusterizado nem replicado, então ele não sobrevive a uma falha de disco ou de nó. Cada servidor é autônomo por projeto e não depende de armazenamento em rede nem de serviços remotos, que é exatamente o que o torna fácil de operar e exatamente o que o deixa exposto.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Há um segundo limite que o próprio projeto declara sobre si mesmo, e ele merece crédito por declarar: se você precisa de 100% de exatidão, por exemplo para cobrança por requisição, a documentação diz que o Prometheus é a escolha errada, porque os dados que ele coleta provavelmente não serão detalhados e completos o bastante. Use outra coisa para os números que você fatura e deixe o Prometheus para monitoramento. Fornecedores costumam não dizer esse tipo de coisa sobre si próprios.
Em escalas maiores existem respostas consolidadas para isso, e elas ficam fora do escopo aqui pelo mesmo motivo que o ferramental do Kubernetes: representam um compromisso operacional diferente do que esta análise cobre. Para um único VPS, minha leitura é que a exposição é aceitável se você guardar snapshots do TSDB em outro lugar ou aceitar de antemão que vai perder o histórico, e que é um problema de verdade se o Prometheus for a única coisa entre você e uma queda silenciosa.
Quem deveria hospedar o Prometheus por conta própria?
O sinal mais claro de que o Prometheus vai devolver o que custa não tem nada a ver com quantos servidores você tem. Tem a ver com serem ou não os mesmos servidores daqui a seis meses. Um conjunto estável de hosts configurados na mão significa que você escreve a configuração uma vez e coleta histórico de graça; um que muda o tempo todo significa que você mexe nessa configuração o tempo todo.
Num ambiente estático, a sua configuração de Prometheus e Grafana é uma descrição explícita da sua infraestrutura: os targets de coleta, os rótulos presos a eles e os dashboards construídos sobre esses rótulos. É por isso que o histórico é toda a recompensa. Um ano de dados sobre um conjunto estável de hosts te diz como é o normal, e essa é a forma mais confiável de reconhecer o anormal antes que ele vire uma queda.
Então o primeiro perfil é alguém que administra um conjunto pequeno de servidores que muda devagar e que quer mais do que no ar ou fora do ar: latência de requisição ao longo do tempo, tendências de memória, um disco enchendo devagar o suficiente para você ver a coisa chegando semanas antes. Se você consegue descrever a sua infraestrutura hoje e espera que essa descrição continue mais ou menos verdadeira daqui a um ano, a noite que você gasta na instalação é a última conta grande.
O segundo é qualquer pessoa aprendendo esta stack de propósito. Se você espera estar cuidando de infraestrutura daqui a alguns anos, sua ou de outra pessoa, a noite de PromQL é justamente o que você veio buscar e o monitoramento é um efeito colateral. Este perfil inverte em parte o primeiro: o teste de estabilidade pesa menos aqui, porque tempo gasto rerrotulando também é tempo gasto aprendendo o que é rerrotular. Para esse leitor eu subiria a nota.
O terceiro perfil é sobre propriedade, e é o que as pessoas subestimam até já terem estado do lado errado dele. O Prometheus não cobra por host, por métrica nem por rótulo, e nenhuma página de preços pode mudar debaixo dos seus pés no próximo trimestre. A troca em relação a um serviço gerenciado como o Datadog: você abre mão do acabamento, do contrato de suporte e do plantão de outra pessoa, e em troca recebe métricas que são suas, numa conta que não se mexe quando um desenvolvedor adiciona instrumentação. Se é uma boa troca depende de quanto valem as suas próprias horas, um número que só você pode preencher (e raramente é zero, mesmo quando parece).
Uma coisa a saber antes de se comprometer: passar do tamanho do armazenamento local do Prometheus não é um beco sem saída. O VictoriaMetrics aceita remote writes do Prometheus, e a MetricsQL é retrocompatível com o PromQL, então a maior parte das consultas e dos dashboards do Grafana que você construir agora deve sobreviver à mudança. É uma migração, não uma reescrita.
Vale rever uma vez por ano em vez de decidir de uma vez por todas: o ambiente que hoje é barato de monitorar fica caro no trimestre em que você começa a reconstruí-lo.

Construa num VPS Linux com acesso root, NVMe e o poder do AMD EPYC.
Ver planos LinuxQuem deveria pular o Prometheus?
Se a frase que você usaria para descrever o que precisa é “me avise quando o site cair”, você está descrevendo um verificador de disponibilidade, e o Prometheus é muita maquinaria para chegar a essa resposta. Uptime Kuma faz exatamente esse trabalho com uma interface web e não pede que você aprenda uma linguagem de consulta de monitoramento. A diferença de capacidade entre as duas ferramentas é enorme e completamente irrelevante para o trabalho que você quer contratar.
O segundo leitor é quem quer gráficos utilizáveis sem antes aprender uma linguagem de consulta. O Netdata é construído exatamente em torno disso: métricas por host que você olha na hora, com muito menos configuração e nada entre você e os gráficos. Se a pergunta que você repete é “por que esta máquina está lenta agora”, esse é um caminho bem mais curto até uma resposta.
O terceiro é qualquer um cuja infraestrutura muda de forma com frequência e que administra targets e variáveis de dashboard na mão. Hosts criados por uma semana e destruídos, targets renomeados, projetos renomeados no meio do caminho. É o caso em que você paga o custo de configuração vez após vez enquanto tira o menor proveito daquilo que está pagando, que é o histórico contínuo de um sistema que continua reconhecível.
Nada disso é uma crítica à ferramenta. “Pular” aqui significa pular para este trabalho, nesta escala. Na escala do Kubernetes, onde o service discovery cuida da maior parte do que você teria de conectar na mão, vários dos custos acima encolhem ou desaparecem de vez, e minha leitura dessa escala é que o Prometheus é muito difícil de bater nela. Essa é outra análise.

Perguntas frequentes
O Prometheus é gratuito?
Sim, e não há pegadinha de plano gratuito por baixo. O Prometheus é licenciado sob Apache 2.0 sem nenhuma edição comercial por trás, então não existe cota de métricas a ultrapassar nem convite a fazer upgrade esperando do outro lado. Você paga pela infraestrutura e pelo seu próprio tempo, não por uma licença do Prometheus.
O Prometheus precisa do Grafana?
Não, mas já conte com ele. O navegador de expressões do Prometheus existe para rodar uma consulta e olhar a resposta, o que cobre conferir uma coisa uma vez. Qualquer coisa que você queira deixar aberta num segundo monitor é trabalho do Grafana, e os dois quase sempre são executados juntos.
O Prometheus é exagero para um único servidor?
Muitas vezes, sim. Se tudo o que você precisa é saber se o servidor e seus serviços estão no ar, um verificador de disponibilidade responde isso numa fração do tempo de instalação. O Prometheus ganha o lugar dele quando você quer métricas históricas consultáveis e está disposto a aprender PromQL para chegar até elas.
Por quanto tempo o Prometheus guarda métricas por padrão?
15 dias, e ele não avisa antes. O Prometheus descarta amostras mais antigas que a janela de retenção, a menos que você a aumente com um parâmetro de tempo ou de tamanho de retenção na inicialização. Ajuste no mesmo dia em que instalar, porque ampliar a janela depois não traz de volta dados que já expiraram.



Discussão
Comentários
Inicie sessão para participar na discussão.