

O PRTG cobra por sensor, ou seja, uma métrica monitorizada num dispositivo, não o dispositivo em si. Os próprios escalões da Paessler fixam a proporção prática em cerca de dez para um: 500 sensores cobrem cerca de 50 dispositivos, 10.000 cobrem cerca de 1.000. Junte uma pilha de switches e comece a acompanhar o débito por porta, e a contagem cresce mais depressa do que o parque. O SolarWinds conta de outra forma e chega ao mesmo sítio.
Para uma rede maioritariamente Windows, eu pré-selecionaria duas alternativas self-hosted ao PRTG e ao SolarWinds: o Zabbix, ou uma stack baseada em Prometheus se a sua equipa já opera uma. A escolha entre as duas depende do que cada uma consegue ver num host Windows e do que precisa para o ver.
Uma ressalva antes de tudo. Se ninguém na equipa tem horas livres, o PRTG e o SolarWinds continuam a ser a resposta certa. A facilidade de utilização deles é um produto que compra de propósito, e vale o dinheiro. A mudança descrita aqui gasta horas em vez de licenças, e isso é uma troca, não uma melhoria.
TL;DR
- A escolha por defeito é o Zabbix. O Zabbix junta o polling SNMP, os agentes Windows, os templates e os alertas numa única plataforma de monitorização. Continua a operar o servidor Zabbix, a base de dados e o frontend web, mas não anda a montar componentes de monitorização separados só para começar.
- A exceção é uma equipa que já corre Grafana e Prometheus para métricas de aplicações e hosts. Estender o que já mantém fica mais barato do que montar um segundo sistema de monitorização.
- O Prometheus não faz polling de dispositivos de rede por si só.
snmp_exporterpreenche essa lacuna; a configuração por defeito cobre muitos switches e routers comuns, enquanto objetos específicos do fabricante ou polling personalizado podem exigir o gerador e trabalho adicional com MIB. - A recolha sem agente só vê o que um host ou dispositivo decide publicar. No Zabbix, os registos de eventos do Windows, o estado dos serviços e os contadores de desempenho detalhados são chaves de item do agente.
- Dimensione o servidor por métricas, não por dispositivos. O Zabbix conta uma métrica como um item mais um trigger mais um gráfico, e coloca cerca de 1.000 métricas em 2 núcleos de CPU e 8 GiB de memória, cerca de 10.000 em 4 núcleos e 16 GiB.
O que o PRTG e o SolarWinds cobram
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
O SolarWinds conta uma unidade diferente, e a regra é fácil de deixar passar até chegar o orçamento de renovação. O modelo de licenciamento do NPM da SolarWinds afirma que o NPM «é licenciado de acordo com o maior número dos seguintes tipos de elementos de rede monitorizados: nós, interfaces, volumes». Não a soma. O maior dos três. Uma rede com 80 nós e 900 portas de switch monitorizadas é licenciada pelas 900, não pelos 80, e os escalões vão de SL100 a SLX. Um único motor de polling tem um limite de 12.000 elementos (a soma de nós, interfaces e volumes, não o maior deles) independentemente do escalão, a partir do qual acrescenta outro motor de polling licenciado.
O efeito prático dos dois modelos é o mesmo. O escalão da licença decide o que é monitorizado. A rede não. Interfaces que gostaria de acompanhar ficam sem monitorização porque acompanhá-las ultrapassa um limite, e esse custo nunca aparece na fatura.
Os dois caminhos self-hosted que valem a pena
O Zabbix é uma única plataforma de monitorização construída à volta de um servidor central, uma base de dados e um frontend web. O servidor faz polling de dispositivos SNMP, recebe dados dos agentes Windows e aplica templates, triggers e alertas dentro do mesmo produto. Comparado com montar uma stack de monitorização de rede baseada em Prometheus, há menos componentes separados para integrar por conta própria. Instala-o, aponta-o aos hosts e associa templates, que são pacotes reutilizáveis de itens, triggers e gráficos que cobrem uma classe de dispositivos.
Comece pelo licenciamento. A página de licença do Zabbix afirma que todas as versões a partir da 7.0 são lançadas sob a GNU Affero General Public License versão 3, e que tudo até à 6.4 era GPLv2. Não há qualquer custo de licença pelo software, seja qual for a escala. O Zabbix vende suporte técnico como uma subscrição opcional à parte, e pede aos utilizadores comerciais que comprem algum nível, mas nada no produto fica bloqueado atrás dessa compra.
O segundo caminho é Grafana, Prometheus e VictoriaMetrics. É a escolha certa em exatamente uma situação: já corre esta stack para métricas de aplicações e hosts, e alguém já a mantém. Se for o seu caso, a montagem completa num único VPS é um problema resolvido e está a estender algo familiar. Ninguém tem de aprender um novo modelo de dados.

A lacuna nesse caminho são os dispositivos de rede. O Prometheus recolhe de endpoints HTTP; não fala SNMP diretamente. O equipamento de rede é normalmente tratado através do snmp_exporter, que faz polling do dispositivo e expõe os resultados para o Prometheus recolher. A sua configuração por defeito inclui módulos como if_mib, pelo que a monitorização padrão de interfaces em muitos switches e routers não exige gerar uma configuração personalizada. O gerador passa a ser trabalho extra quando precisa de objetos específicos do fabricante, walks personalizados ou MIB que não vêm incluídas por defeito. O caminho Prometheus tem por isso mais peças para manter do que o Zabbix, mas o gerador não é obrigatório para todos os dispositivos.
O LibreNMS é o terceiro nome neste espaço, construído à volta da descoberta automática: percorre uma rede por SNMP, CDP, LLDP, OSPF, BGP e ARP para encontrar o que lá está. É uma opção razoável quando a descoberta é a prioridade. Não altera a questão da recolha em Windows, que é onde esta decisão se resolve.
Como cada caminho vê um host Windows
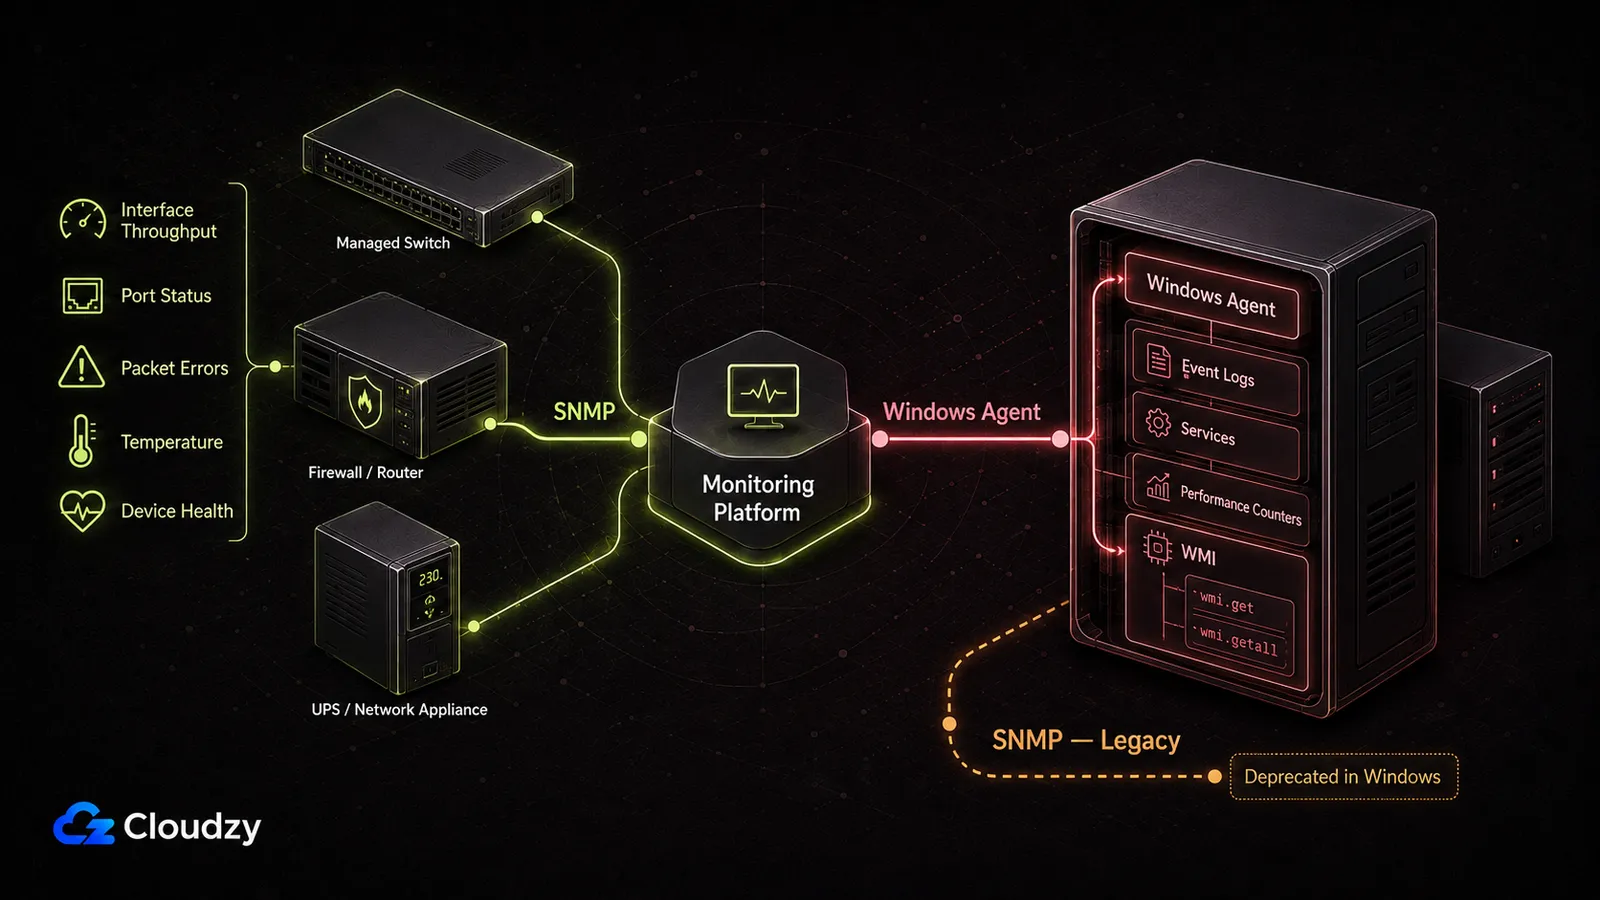
A monitorização de Windows pode envolver SNMP, WMI remoto ou um agente instalado. O caminho aplicável depende do produto de monitorização e da métrica recolhida. No Zabbix em concreto, as verificações WMI integradas passam pelo agente Windows.
SNMP
Um polling SNMP pede a um dispositivo o valor atual de um objeto numerado, endereçado por um OID, que é uma posição na MIB do dispositivo. O que volta é o que o dispositivo publica e nada mais. Num switch gerido, numa firewall ou numa UPS, isso costuma chegar: contadores de interface, estado das portas, taxas de erro, temperatura, saúde do chassis.
No Windows o quadro é mais pobre. O aviso de descontinuação da Microsoft para o SNMP e o fornecedor WMI SNMP confirma que ambas as funcionalidades estão descontinuadas, por isso trataria o SNMP do Windows como um caminho de compatibilidade legado e não como a escolha por defeito para uma nova implementação. O Zabbix ainda fornece um template Windows by SNMP, mas o agente nativo dá-lhe bastante mais visibilidade sobre o sistema operativo.
WMI
O WMI pode ser consultado remotamente sem instalar um agente de monitorização no alvo, e é por isso que produtos como o PRTG o podem usar como método de recolha Windows sem agente. O Zabbix funciona de outra forma. As suas verificações WMI integradas, wmi.get e wmi.getall, são chaves de item do agente Windows, pelo que é o agente Zabbix ou o agente 2 que executa essas consultas na máquina monitorizada.
O WMI remoto também traz os seus próprios requisitos de rede quando um produto de monitorização o usa diretamente. Nos sistemas Windows atuais, o RPC começa na porta TCP 135 e normalmente negoceia as ligações através do intervalo dinâmico de portas TCP altas, tipicamente de 49152 a 65535. A firewall e as permissões WMI no alvo têm de permitir a ligação.
Para esta comparação, a distinção importa mais do que o protocolo em si: o PRTG pode usar WMI remoto sem um agente de monitorização instalado, enquanto o Zabbix obtém a sua visibilidade WMI específica do Windows através do seu agente.
O agente nativo
O agente é onde vive a profundidade específica do Windows. A documentação do Zabbix lista as chaves específicas do Windows: eventlog para monitorizar o registo de eventos do Windows, perf_counter para qualquer contador de desempenho do Windows, service.discovery e service.info para o estado dos serviços. Todas são chaves de item do agente.
O custo é a implementação. Um agente em cada Windows Server e em cada estação de trabalho que lhe interessa é um pacote para distribuir, uma versão para manter atualizada e uma regra de firewall para manter. É um compromisso operacional permanente, e é o contrapeso da poupança na licença.
A recolha sem agente está limitada ao que o host ou dispositivo decide publicar, e no Zabbix os registos de eventos e os contadores de desempenho detalhados estão atrás de chaves de item do agente.
Lado a lado
A comparação assenta em quatro coisas: se a ferramenta faz polling de dispositivos de rede por SNMP, se tem um agente Windows, até onde consegue ver dentro de um host Windows e quanta montagem há entre si e um sistema a funcionar. O licenciamento fica ao lado porque é a razão pela qual a avaliação começou.
| Ferramenta | Polling SNMP de dispositivos | Monitorização de Windows | Esforço de configuração | Licenciamento |
|---|---|---|---|---|
| Zabbix | Integrado | Agente: registos de eventos, estado dos serviços, contadores de desempenho e WMI; estado grosseiro por SNMP | Moderado: um servidor, depois templates | AGPLv3, sem custo de licença; suporte vendido à parte |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | Não integrado; precisa do snmp_exporter como componente separado | Sem agente Windows nativo; as métricas de host vêm de exporters separados; os registos de eventos não são nativos | Elevado: vários componentes; SNMP personalizado pode exigir trabalho no gerador | Componentes open source, sem custo de licença |
| Monitores de uptime e estado | Nenhuma | Apenas alcançabilidade dos serviços e tempo de resposta | Baixo: minutos | Varia consoante a ferramenta |
Se o requisito é «avisa-me no espaço de um minuto quando um serviço deixar de responder», um monitor de uptime é a ferramenta do tamanho certo e as outras duas são exageradas para isso. O que ele não faz é fazer polling a um switch para obter o débito de uma interface ou ler um contador de desempenho do Windows, por isso não substitui o PRTG nem o SolarWinds. É um trabalho diferente que às vezes se confunde com o mesmo.

Qual escolher
Escolha o Zabbix. Para uma rede maioritariamente Windows sem investimento prévio em Prometheus, é de longe o caminho mais curto. Continua a ter um servidor, uma base de dados e um frontend web para operar, mas o modelo de monitorização, os templates e os alertas vivem num único produto em vez de serem montados a partir de vários componentes de monitorização.
Para uma implementação de monitorização de longa duração, use o ramo LTS atual do Zabbix em vez de uma versão standard de curta duração. O ciclo de vida LTS do Zabbix dá a cada versão três anos de suporte completo seguidos de dois anos de suporte limitado, o que aqui importa mais do que correr atrás da versão mais recente com novas funcionalidades.
A exceção é estreita e específica. Se a sua equipa já corre Grafana e Prometheus em produção para métricas de aplicações e hosts, e alguém já é dono dessa stack, então o snmp_exporter é um acréscimo a algo que já é mantido, em vez de um segundo sistema para manter. Essa condição é conjunta: as duas metades têm de se verificar. Uma instância Grafana abandonada que alguém montou no ano passado não conta.
E se ninguém tem as horas, renove. Não é uma evasiva. É uma situação diferente com uma resposta certa diferente. A mudança converte uma fatura de licenciamento numa fatura operacional: distribuição de agentes, trabalho nos templates, atualizações e alguém que perceba o sistema suficientemente bem para o reparar às 2 da manhã. Uma equipa já no limite fará esse trabalho mal ou não o fará, e uma monitorização sem manutenção é pior do que uma monitorização cara, porque falha em silêncio.
O híbrido é real: mantenha a ferramenta atual num núcleo cada vez menor de sistemas críticos, passe tudo o resto para o Zabbix e deixe o escalão da licença descer com o tempo. Funciona. Também significa correr dois sistemas de monitorização e reconciliar os seus alertas, por isso trate-o como um estado de transição com data de fim.
O que não sobrevive à migração
O próprio guia de migração do Zabbix tem uma secção intitulada «O que NÃO é migrado», e a lista é mais longa do que a palavra «migração» sugere. Os dados históricos e as leituras dos sensores não passam. As notificações e dependências personalizadas do PRTG também não. Os mapas e dashboards também não, porque os dois produtos os modelam de forma tão diferente que reconstruir vale mais do que traduzir. Os próprios sensores também não, já que o Zabbix trabalha com um conceito completamente diferente.
Os nomes dos dispositivos, os endereços IP e os tipos de interface podem ser transferidos. Mesmo isso passa por scripts personalizados de exportação e importação contra as duas API. O guia diz claramente que não existe nenhuma ferramenta oficial para migrar diretamente entre as duas plataformas.
Uma equipa documentou o que isso custa na prática: cerca de 500 VM e servidores físicos, cerca de sete anos em PRTG, reconstruídos do zero ao longo de seis meses de projeto de baixa prioridade. Os seus 2.500 sensores PRTG passaram a 43.000 itens Zabbix, uma ilustração clara de quão diferente os dois sistemas contam.
«Comece do zero. Não existe a opção «carregue neste botão e migre» do PRTG para o Zabbix, e mesmo que existisse, algo assim é uma boa oportunidade para não repetir os erros de conceção anteriores.»
É a experiência de uma organização, não uma referência. Um parque mais pequeno não produzirá esses números. O que se transfere é a premissa de planeamento: orçamente tempo de reconstrução, não tempo de migração.
Sequencie a reconstrução por aquilo de que não pode prescindir. Se a sua preocupação é a continuidade dos alertas, reconstrua primeiro as regras de notificação e deixe os dashboards para depois. Se é o histórico de relatórios, exporte o que precisa antes de a licença antiga expirar. Ele não vai consigo.
Dimensionar o servidor
Os requisitos de hardware do Zabbix colocam uma instalação pequena de cerca de 1.000 métricas monitorizadas em 2 núcleos de CPU e 8 GiB de memória, e uma instalação média de cerca de 10.000 métricas em 4 núcleos e 16 GiB. São esses os números para fazer o pedido.
A unidade é onde o dimensionamento falha. O Zabbix define uma métrica monitorizada como um item mais um trigger mais um gráfico. Uma métrica não é um dispositivo e não é um host. Um único Windows Server contribui com tantas métricas quantos itens configurar: CPU, memória, cada sistema de ficheiros, cada serviço, cada contador que amostrar. A contagem de dispositivos é um mau guia para a máquina de que precisa. Um parque que parece pequeno pode cair no escalão médio sem que ninguém faça nada de invulgar.
Duas coisas fazem o número subir mais depressa do que a contagem de hosts. A frequência de polling é a primeira: reduzir a metade um intervalo de atualização duplica a taxa de escrita de cada item nesse intervalo. A retenção do histórico é a segunda, já que a base de dados cresce com o tempo durante o qual guarda valores em bruto. A contagem de dispositivos importa sobretudo pelo número de itens monitorizados que cada dispositivo acrescenta.
Se o seu parque se mantiver perto do exemplo das 1.000 métricas com intervalos de atualização normais e retenção modesta, o escalão pequeno é um ponto de partida razoável. Se estiver a amostrar contadores de desempenho a cada trinta segundos e a guardar um ano de histórico em bruto, não é. O Zabbix é explícito em que os números publicados são «exemplos de dimensão e configuração de hardware para começar», e recomenda fazer benchmarks num ambiente de staging antes de comprometer hardware de produção. É a ressalva do próprio fornecedor. Leve-a à letra.
O Zabbix só suporta o componente servidor em Linux e UNIX; no Windows, apenas o agente é suportado.
As métricas não são dispositivos, e o multiplicador entre ambos é o que determina o tamanho da máquina.

Construa num VPS Linux com acesso root, NVMe e o poder do AMD EPYC.
Ver planos LinuxOnde colocar o servidor de monitorização
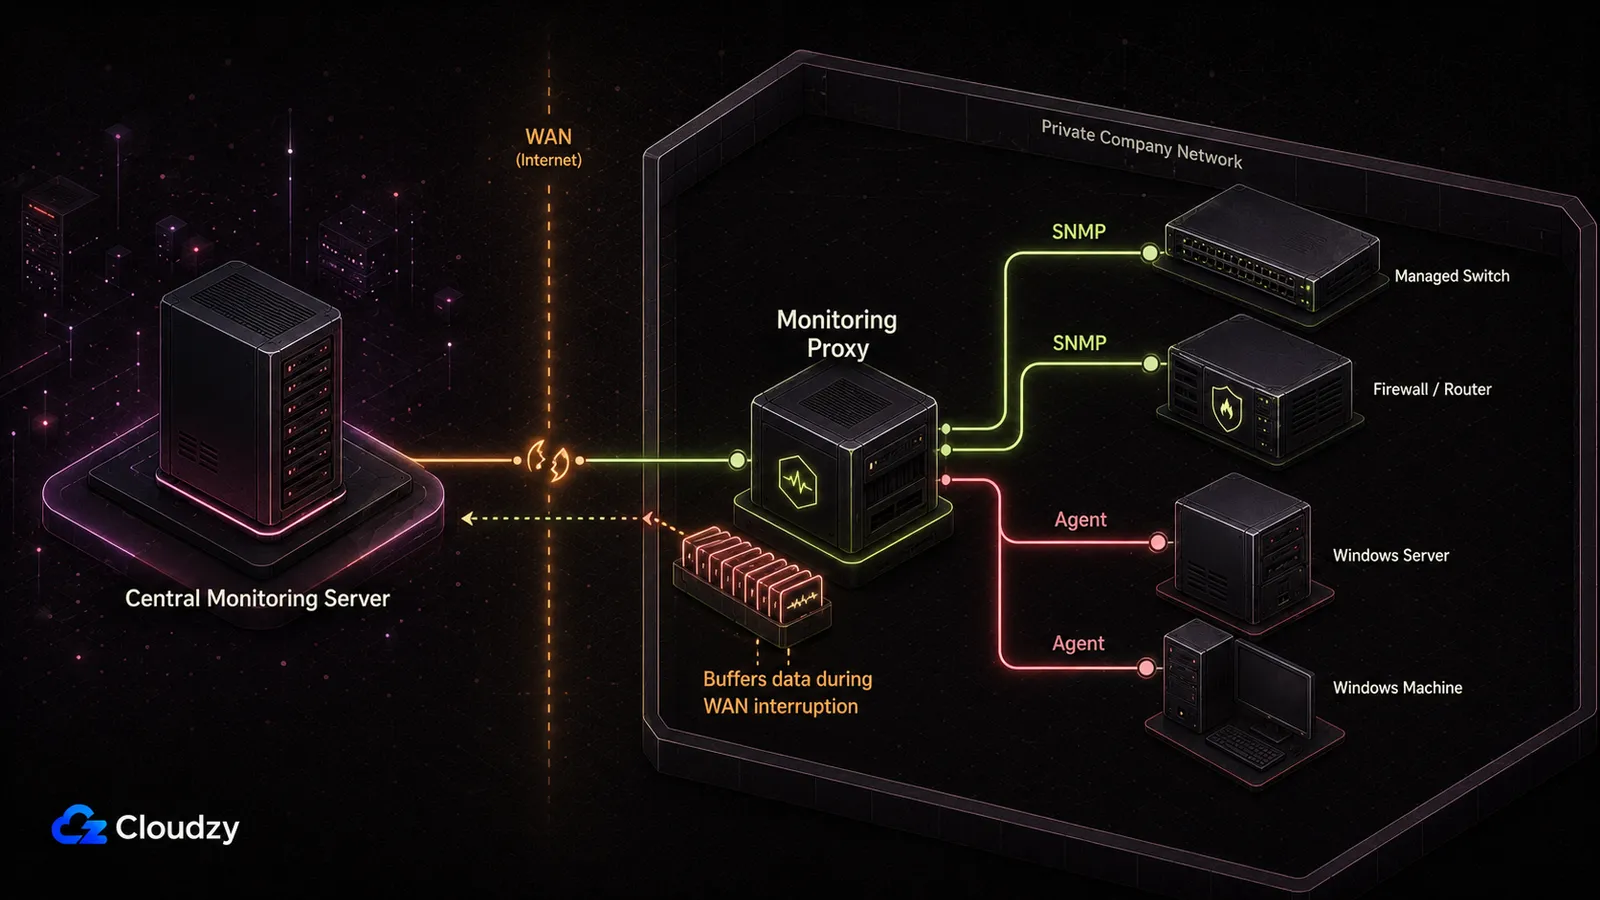
Se precisa que a monitorização sobreviva a uma falha de toda a instalação, mantenha o servidor Zabbix central fora do domínio de falha dessa instalação. Perder o uplink da instalação pode então deixar a rede monitorizada offline sem derrubar também o servidor de monitorização.
Para uma rede privada, um proxy Zabbix pode ficar dentro da instalação e recolher dos sistemas à sua volta. O proxy pode tratar localmente as verificações SNMP e de agente, enviar os dados recolhidos de volta ao servidor central e guardar os dados de monitorização em buffer enquanto a conectividade entre os dois estiver indisponível. Isso permite que o servidor central fique fora da instalação sem exigir que cada switch, firewall e host Windows privado seja acessível diretamente a partir da Internet.
Um VPS é um sítio prático para correr esse servidor central. A Cloudzy oferece o Servidor Zabbix como implementação com um clique em Ubuntu Server 24.04 LTS, se quiser saltar a instalação inicial e passar diretamente à configuração de hosts e templates.
Perguntas frequentes
O Zabbix é mesmo gratuito?
Sim. O Zabbix é lançado sob a GNU Affero General Public License versão 3 a partir da versão 7.0, e não há qualquer custo de licença pelo software, independentemente de quantos dispositivos ou métricas monitorizar. O Zabbix vende suporte técnico como uma subscrição opcional à parte, mas nenhuma funcionalidade do produto fica bloqueada atrás dela. O custo de correr o Zabbix é o servidor onde corre e as horas que gasta a operá-lo.
Preciso de instalar um agente em cada Windows Server?
Não em todas as máquinas Windows, mas se quiser a profundidade de monitorização Windows nativa do Zabbix, conte instalar o agente nos servidores que mais lhe importam. O SNMP pode fornecer dados grosseiros sem agente, embora a funcionalidade SNMP do Windows esteja descontinuada pela Microsoft. As verificações WMI integradas do Zabbix também passam pelo seu agente Windows, pelo que o WMI não é um caminho de recolha sem agente direto no Zabbix. Use o agente para registos de eventos, descoberta de serviços, consultas WMI e contadores de desempenho detalhados; reserve o SNMP sem agente sobretudo para hardware de rede e casos Windows legados.
Posso correr o servidor de monitorização em Windows?
Com o Zabbix, não. A documentação de requisitos do Zabbix lista o componente servidor como suportado apenas em Linux e outras plataformas UNIX, e afirma que «o UNIX é o único sistema operativo capaz de fornecer de forma consistente o desempenho, a tolerância a falhas e a resiliência necessários». O suporte para Windows cobre o agente Zabbix e o agente 2, que é o que instala nas máquinas monitorizadas. O servidor de monitorização fica num host Linux; o parque Windows é o que ele observa.
O Prometheus faz monitorização SNMP?
Por si só, não. O Prometheus recolhe de endpoints HTTP e usa o snmp_exporter para recolher de dispositivos SNMP. A configuração por defeito cobre muitos switches e routers comuns, enquanto objetos específicos do fabricante ou polling personalizado podem exigir configuração MIB adicional e o gerador.



Discussão
Comentários
Inicie sessão para participar na discussão.