
Un utente di r/linuxquestions ha fatto il confronto su cui tutti continuano a discutere. Ha installato CachyOS, ha eseguito benchmark di diversi giochi su un Ryzen 7 7800X3D con una Radeon RX 7900 XTX e non ha misurato alcuna differenza rispetto alle altre distribuzioni già presenti sulla macchina. Le risposte sono andate come vanno sempre. Un commentatore ha messo il tetto abbastanza in basso da renderlo invisibile nell'uso normale. Un altro ha spiegato lo scheduler. Un terzo ha detto che i benchmark non possono mostrare ciò che fa lo scheduler. Nessuno ha prodotto la misurazione che avrebbe chiuso la questione.
La domanda torna sempre con le stesse parole: CachyOS è davvero più veloce? La risposta breve è sì, in carichi di lavoro specifici. I pacchetti ricompilati possono aiutare il codice che il compilatore sa vettorizzare, i confronti nei giochi citati qui mostrano poca differenza negli FPS medi, e un sistema che sembra più veloce dopo il passaggio è più difficile da attribuire, perché cambiare distribuzione modifica molto più di una sola variabile.
Resta irrisolta perché «più veloce» contiene tre affermazioni distinte con tre risposte diverse, ognuna con bisogno del proprio strumento. I pacchetti ricompilati completano un'attività in meno tempo reale oppure no. Uno scheduler cambia il comportamento del desktop sotto contesa oppure no. E una macchina più reattiva si spiega con CachyOS oppure con qualcosa arrivato insieme a esso.
La versione breve
- Pacchetti ricompilati: misurabilmente più veloci, su una minoranza di ciò che esegui. I guadagni si concentrano nel codice che il compilatore può vettorizzare, diversi pacchetti risultano più lenti e la maggior parte non cambia. Un confronto in arch-chroot del gennaio 2023 su sunnyflunk.github.io, su un Intel NUC8i5BEK, ha trovato la codifica flac più veloce del 20,2 % e la decompressione bzip2 più lenta del 7,1 % nella stessa sessione.
- La storia dello scheduler si divide in due. L'attuale kernel predefinito di CachyOS usa EEVDF, mentre BORE è disponibile separatamente. I confronti tra distribuzioni del maggio 2026 hanno trovato poca differenza negli FPS medi e hanno misurato anche gli 1% low e il frame pacing, ma non hanno isolato BORE né aggiunto un carico CPU concorrente controllato. Il gaming out-of-the-box è stato misurato; il beneficio di BORE sotto contesa non è stato isolato.
- La sensazione di una macchina più veloce: esperienza reale, attribuzione inaffidabile. Un'installazione pulita e la correzione casuale di un bug non correlato producono entrambe un sistema più scattante che non deve nulla ai livelli di set di istruzioni. L'eccezione da conoscere è il confronto out-of-the-box di Phoronix su un Intel Core Ultra 9 285K, dove CachyOS ha superato Arch standard su una CPU che non può affatto usare le ottimizzazioni AVX-512.
Cosa cambia davvero CachyOS nel tuo sistema
CachyOS è Arch Linux con tre modifiche separate impilate sopra: un kernel con patch che offre scheduler alternativi, repository i cui pacchetti sono ricompilati per livelli di set di istruzioni CPU più recenti, e ottimizzazioni aggiuntive del compilatore su un sottoinsieme di pacchetti di base. Ognuna è un meccanismo distinto con un effetto distinto, e quasi mai vengono misurate separatamente.
Il lato kernel è la superficie più ampia. L'elenco delle funzionalità del kernel di CachyOS copre Clang ThinLTO, profilazione AutoFDO, modalità di preemption selezionabili a runtime e diverse opzioni di scheduler. L'attuale pacchetto linux-cachyos usa un EEVDF messo a punto da CachyOS come scheduler predefinito. BORE e BMQ sono disponibili tramite varianti separate del kernel, mentre linux-cachyos-eevdf applica un'ulteriore messa a punto della reattività di EEVDF e linux-cachyos-server usa l'EEVDF di serie. sched-ext resta disponibile sulle varianti che lo supportano.
Sul lato pacchetti, i repository x86-64-v3 di CachyOS sono il meccanismo in questione. La pagina dei repository ottimizzati di CachyOS descrive la ricompilazione dei pacchetti Arch per tre target sopra la base generica: x86-64-v3, x86-64-v4 e un target dedicato Zen 4/5 che aggiunge ulteriori estensioni AVX-512, più alcune istruzioni fuori da AVX-512, sopra v4. Un sottoinsieme di pacchetti sensibili alle prestazioni riceve anche ottimizzazione guidata dal profilo e BOLT.
Quei nomi di livello vengono dalla specifica dei livelli di microarchitettura dello psABI x86-64, e sono soglie, non manopole. x86-64-v3 richiede le istruzioni dell'era AVX e AVX2 arrivate con Haswell di Intel nel 2013 e con i core Excavator di AMD; x86-64-v4 richiede AVX-512, che in pratica significa chip Intel di classe Skylake-X e qualsiasi AMD Zen 4 o successivo. Una CPU supera l'asticella oppure no.
Le tre affermazioni nascoste nella parola «più veloce»
Quando due persone non sono d'accordo sul fatto che CachyOS sia più veloce, di solito hanno entrambe ragione su cose diverse. Throughput, costanza dei frame e reattività percepita sono proprietà separate, e nessuna singola metrica le risolve tutte e tre. Un'attività cronometrata misura il throughput; le misure di frame time e latenza coprono la fluidità nei giochi; per l'effetto più ampio a livello di sistema serve un confronto controllato con installazione pulita.
| L'affermazione | Cosa si sostiene | Come la misureresti | Cosa mostrano le prove | Affidabilità |
|---|---|---|---|---|
| Throughput misurato | I pacchetti ricompilati completano la stessa attività in meno tempo | Cronometrare un'attività su hardware fisso e kernel fisso, cambiando solo il repository di provenienza dei pacchetti | Guadagni solidi sul lavoro vettorizzabile, piccole regressioni su diversi pacchetti, nessun cambiamento sulla maggior parte | Alta. Canonical, il CentOS ISA SIG e due benchmarker indipendenti concordano sulla forma |
| Latenza di input e costanza dei frame | Il desktop resta reattivo mentre qualcos'altro satura la CPU | Percentili di frame time e latenza di input sotto un carico concorrente, non il frame rate medio | I test pubblicati ora includono 1% low e frame pacing, ma non isolano lo scheduler né introducono un carico CPU concorrente controllato | Bassa. Il meccanismo è documentato, la misurazione manca |
| Reattività percepita | La macchina sembra più scattante dopo il passaggio | Confrontare con un'installazione pulita della distribuzione precedente, non con quella consumata | Di solito spiegato dagli effetti dell'installazione pulita o da una correzione casuale; un confronto out-of-the-box ha trovato un vantaggio a livello di distribuzione | Media. Esperienza fondata, attribuzione inaffidabile |
Una suite di benchmark che risponde alla prima riga non può rispondere alla seconda, e nessuna delle due tocca la terza. Eseguirne una delle tre e presentare il risultato come verdetto su tutte e tre è ciò che tiene in vita il thread.
I pacchetti ricompilati girano davvero più veloci?
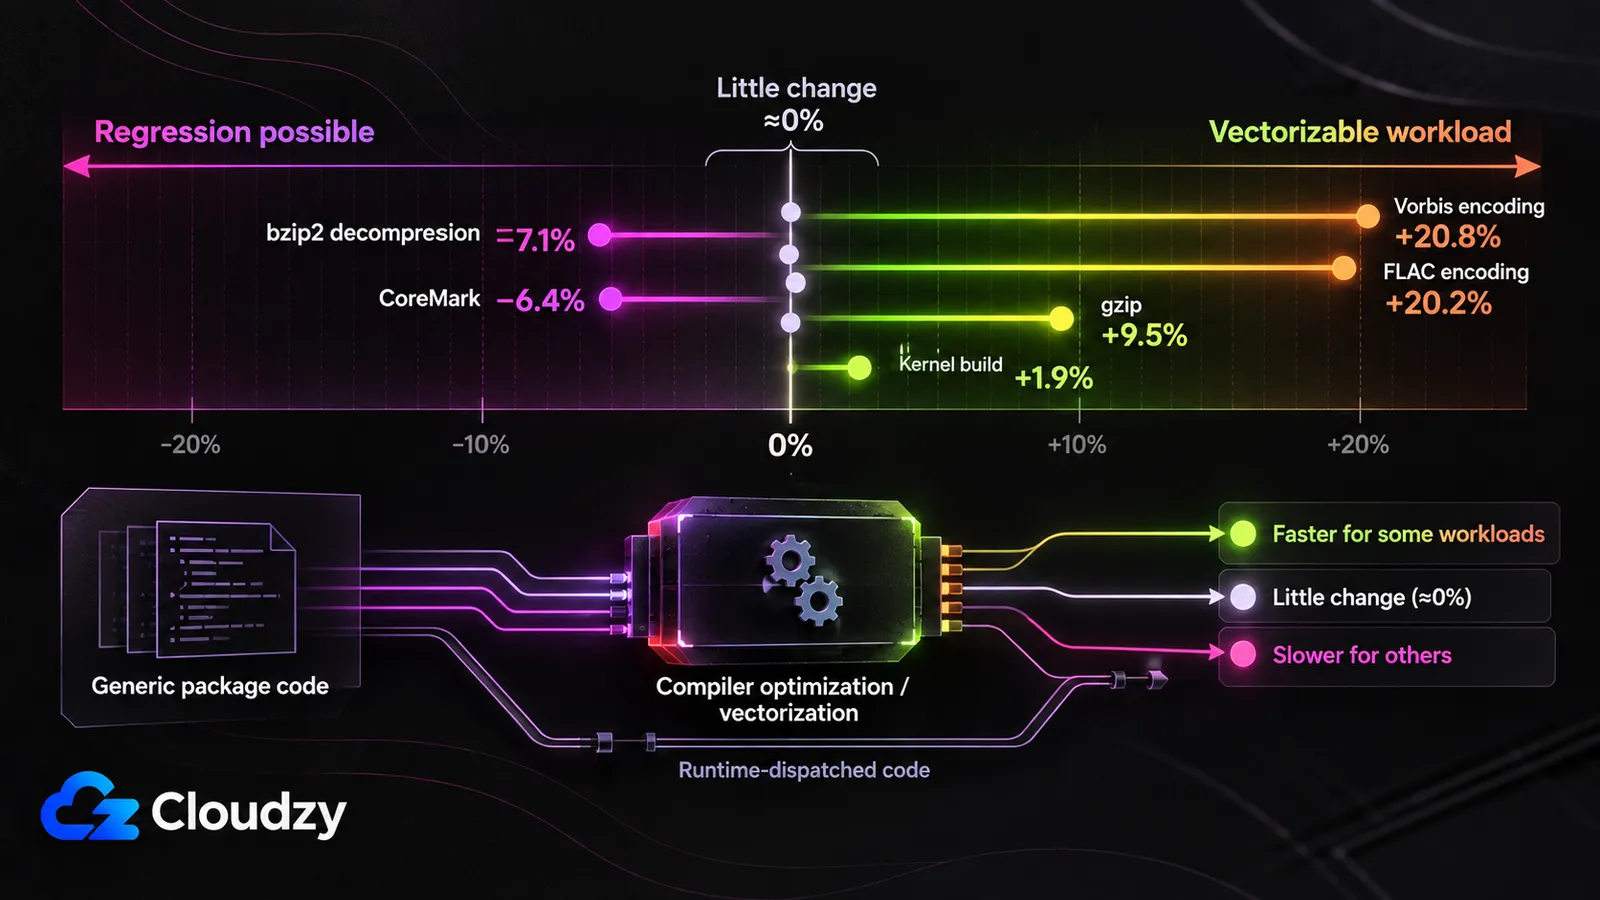
Sì, su una minoranza di ciò che un desktop esegue, e la dimensione la decide il carico di lavoro, non la distribuzione. Il lavoro vettorizzabile vede guadagni a due cifre, una manciata di pacchetti risulta più lenta e la maggior parte non mostra nulla. La pagina dei repository ottimizzati di CachyOS colloca il guadagno di x86-64-v3 tra il 5 % e il 20 % rispetto a x86-64 generico; le misurazioni pubblicate si collocano per lo più nella fascia bassa.
Il confronto di prestazioni CachyOS vs Arch più pulito isola la variabile dei pacchetti e nient'altro: un test in arch-chroot del gennaio 2023 su sunnyflunk.github.io. L'host eseguiva Arch standard su un Intel NUC8i5BEK, entrambi i set di pacchetti sono stati testati dentro un arch-chroot in modo che kernel e ambiente restassero identici, e i benchmark sono stati eseguiti in RAM per eliminare la latenza del disco. Rispetto ai pacchetti Arch standard, le build CachyOS erano il 20,2 % più veloci nella codifica flac a -8, il 20,8 % più veloci nella codifica vorbis e il 9,5 % più veloci su gzip -3. Nella stessa sessione erano il 7,1 % più lente nella decompressione bzip2, dall'1,6 % al 2,9 % più lente nella compressione con lz4, il 3 % più lente su pybench e invariate sul benchmark R. Due avvertenze arrivano dall'autore stesso: CachyOS compilava con -march=x86-64-v3 -mpclmul -O3 contro -march=x86-64 -O2di Arch, e i suoi test successivi suggerivano che -O3 e non il livello del set di istruzioni spiegasse parte dei guadagni maggiori. Il post precede il repository Zen 4 di CachyOS, arrivato con la release di luglio 2024, ma non il suo lavoro su BOLT: l'autore legge il pacchetto Python di CachyOS dietro la regressione di pybench come già dotato di BOLT sopra x86-64-v3.
I benchmark di CachyOS su hardware più recente ripetono lo schema. Un confronto del luglio 2024 su mvermeulen.org ha eseguito un sottoinsieme della Phoronix Test Suite su un Ryzen 7940HS Zen 4, CachyOS con il repository Zen 4 contro Ubuntu 22.04. La maggior parte dei risultati è rimasta entro pochi punti percentuali in un senso o nell'altro: coremark il 6,4 % più lento, i sottotest OpenSSL da circa l'1 % più lenti al 4 % più veloci, tempo di compilazione del kernel l'1,9 % più veloce, phpbench come valore anomalo con un punteggio poco più che doppio. L'autore segnala una discrepanza di versione di GCC, 14.1 contro la 11.4 di Ubuntu, come probabile fattore di confusione. La sua prova separata di NAMD del marzo 2024 ha trovato miglioramenti del 6,5 % e del 5,8 % su due carichi di dinamica molecolare.
I test istituzionali hanno trovato lo stesso quadro misto, a entrambi gli estremi. Il benchmarking x86-64-v3 di Canonical, pubblicato nel marzo 2024 con un'immagine sperimentale di Ubuntu 23.10 su Azure, ha riportato guadagni riproducibili fino al 60 % sul benchmark Log2 di glibc mentre altri benchmark regredivano in modo significativo, in un caso perché abilitare v3 su codice SSE già ottimizzato ha portato il compilatore a espanderlo in 17 volte più istruzioni. La ricostruzione di CentOS Stream 9 da parte del CentOS ISA SIG da v2 a v3, su macchine Intel di classe Ice Lake nell'agosto 2023, ha definito i risultati «piuttosto misti», con accelerazioni di 2,2x concentrate in Mocassin e nel md5crypt di John the Ripper, entrambi fortemente vettorizzabili, anche se il team ha attribuito il guadagno di Mocassin soprattutto all'autovettorizzazione di GCC 12 e non al livello ISA.
Molte librerie matematiche e crittografiche critiche per le prestazioni includono più versioni delle funzioni calde e ne selezionano una a runtime tramite il rilevamento delle funzionalità della CPU, una tecnica chiamata function multiversioning e implementata in glibc tramite i resolver IFUNC. Questo significa che alcuni percorsi caldi possono già usare AVX2 su un'installazione Arch standard senza ricompilare l'intero pacchetto. Il post di sunnyflunk lo ha visto direttamente, notando che il sorgente di flac include già funzioni AVX2 a runtime che non hanno bisogno di -march per essere abilitate. La scoperta di CentOS è l'immagine speculare: il team ha individuato funzioni matematiche di glibc prive di versioni IFUNC, che è esattamente dove una ricostruzione statica ha margine per aiutare. Ciò che raggiunge una ricostruzione v3 è il codice residuo che l'autovettorizzatore del compilatore può migliorare da solo, ovvero una fetta di un desktop, e piccola.
È la forma del carico di lavoro, non l'etichetta sulla CPU, a decidere se un cambiamento a livello macchina si vede. Il verdetto sul throughput è sì, ma delimitato: i cambiamenti a una cifra sono comuni nelle misurazioni sopra, i guadagni maggiori si raggruppano attorno a carichi vettorizzabili come codifica e compressione, e alcuni pacchetti regrediscono. È una descrizione migliore che trattare x86-64-v3 come un moltiplicatore di velocità per tutto il sistema.
Cosa cambia lo scheduler, e perché gli FPS medi non lo colgono
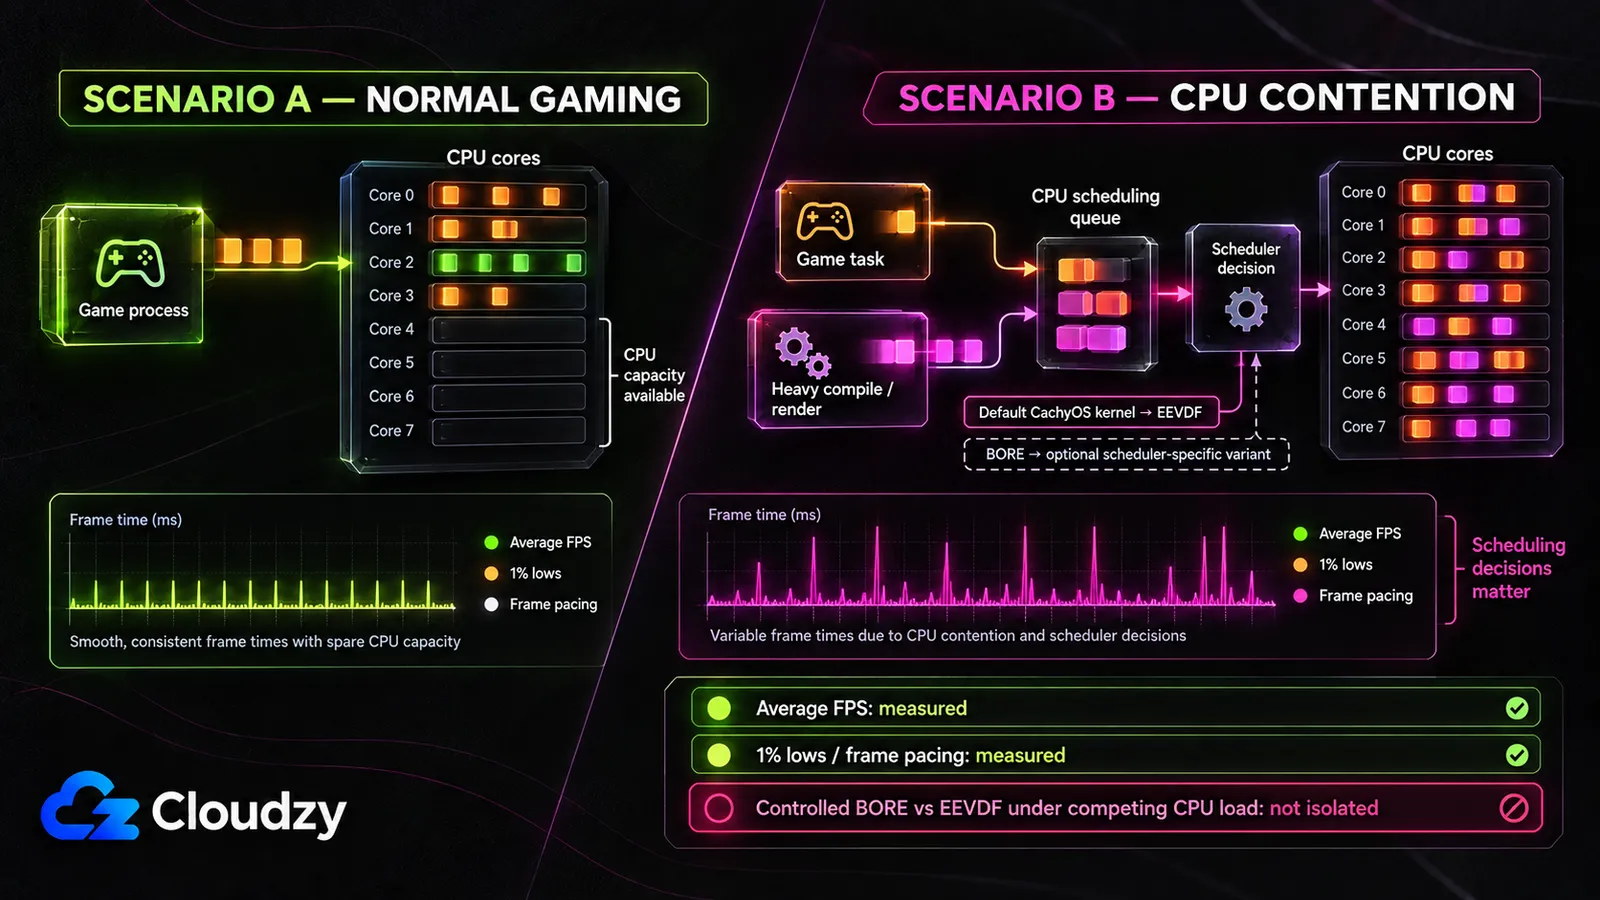
L'attuale kernel predefinito di CachyOS, linux-cachyos , usa EEVDF, mentre BORE è disponibile tramite varianti specifiche per scheduler come linux-cachyos-bore. Questa distinzione conta perché i confronti nei giochi qui sotto sono test a livello di distribuzione, non test controllati BORE contro EEVDF. BORE resta rilevante per l'affermazione più ampia sulle prestazioni perché il suo design punta esplicitamente alla reattività sotto carichi misti, ma quell'affermazione va valutata separatamente dalle prestazioni di gioco di CachyOS out-of-the-box.
Il README di BORE dichiara chiaramente l'intento:
Per ottenere questo, BORE introduce una dimensione di flessibilità chiamata «burstiness» per ogni singolo task, discostandosi in parte dal principio di «completa equità» intrinseco a CFS.
firelzrd/bore-scheduler, README del progetto
La burstiness è il tempo CPU che un task ha accumulato dall'ultima volta in cui ha ceduto la CPU dormendo, aspettando I/O o cedendo il turno. BORE lo converte in un punteggio e lo usa per regolare il peso di ogni task e l'aggressività della sua preemption al risveglio, così i task che cedono spesso il turno vengono trattati come interattivi e favoriti rispetto ai task che monopolizzano la loro fetta. Il README nomina da sé il compromesso: BORE si assesta in un «equilibrio tra task avidi e deboli (di solito task batch legati alla CPU) e task modesti e forti (di solito task interattivi legati all'I/O)». Dare più peso al lavoro interattivo è la stessa operazione di dare meno peso al lavoro batch di throughput.
Questo ti dice quale strumento rileverebbe l'affermazione specifica di BORE: introdurre un carico CPU concorrente e misurare i percentili di frame time o la latenza di input cambiando solo lo scheduler. Uno scheduler ha molto meno da arbitrare quando il gioco gira con capacità CPU inutilizzata.
Un benchmark su cinque giochi pubblicato il 16 maggio 2026 ha usato installazioni pulite di CachyOS e Omarchy sullo stesso SSD e sullo stesso hardware, una RTX 5060 Ti e un Ryzen 9, con la stessa build di Proton-GE e impostazioni a 1440p. Gli FPS medi differivano solo di uno o due frame. Due giorni dopo, lo stesso tester ha pubblicato un secondo confronto con logging completo dei frame tramite MangoHUD, aggiungendo 5% low, 1% low e varianza del frame pacing. Quel secondo test usava hardware diverso, un Intel i7-13700 e una Radeon RX 9060 XT, quindi è una prova aggiuntiva sulla costanza dei frame e non un'estensione del primo test sullo stesso hardware. Nessuno dei due confronti isola lo scheduler della CPU o aggiunge un carico CPU concorrente deliberato.
Nemmeno il progetto esagera. In un thread di r/cachyos sulle prestazioni nei giochi, Peter Jung, uno degli sviluppatori fondatori di CachyOS, ha risposto direttamente a un utente: «In gaming not all too much. The newer feature can make a difference tough :)» (nei giochi non poi tanto; la funzionalità più recente può però fare la differenza).
Restano due conclusioni separate. Per il gaming su CachyOS out-of-the-box, i test pubblicati mostrano poca differenza negli FPS medi e ora includono misurazioni di 1% low e frame pacing. Per BORE nello specifico sotto contesa CPU deliberata, non sono riuscito a trovare un test pubblicato controllato che cambi solo lo scheduler e misuri la reattività sotto quel carico.
Perché un passaggio sembra più veloce anche quando nulla si misura più veloce
Due meccanismi producono una macchina più scattante dopo un cambio di distribuzione senza che nessuna delle ottimizzazioni di CachyOS sia coinvolta: l'installazione pulita in sé, e la correzione casuale di un problema non correlato che il sistema precedente aveva. Entrambi sono abbastanza specifici da riconoscere nel proprio caso, ed è questo che li distingue da un'accusa generica di placebo.
Partiamo dall'installazione pulita. In un thread di r/linuxquestions sulla questione, un utente di CachyOS che diceva di non aver notato alcuna differenza ha suggerito che chi riporta grandi guadagni potrebbe confrontare con un'installazione molto usata invece che con una pulita. Anni di voci di avvio automatico accumulate, servizi orfani, configurazione alla deriva e un disco pieno sono un carico di lavoro, e una partizione pulita elimina tutto in una volta. Un cambio di distribuzione sposta contemporaneamente il kernel, l'ambiente desktop, ogni versione di pacchetto e ogni impostazione predefinita, e un confronto completo Manjaro contro Ubuntu si estende su una dozzina di assi distinti. Attribuire in seguito un miglioramento a uno di essi è tirare a indovinare.
La correzione casuale è il caso più netto. Nello stesso thread, un commentatore ha descritto l'uso quotidiano di Fedora con un problema di gestione della VRAM che degradava gravemente le prestazioni, il passaggio a CachyOS e la scomparsa del problema. Poi è passato ad Arch puro e ha riportato praticamente le stesse prestazioni di CachyOS, concludendo che non sapeva più cosa fosse stato diverso. Il miglioramento era reale; i target di compilazione di CachyOS non c'entravano nulla.
Nessuna di queste cose autorizza uno smontaggio netto, e la prova più forte contro uno smontaggio del genere è un test controllato. Il confronto tra distribuzioni su Arrow Lake di Phoronix ha messo Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux e CachyOS sullo stesso Intel Core Ultra 9 285K nel loro stato predefinito, e CachyOS li ha superati tutti di poco, compreso Clear Linux, che di norma guida su silicio Intel. Arrow Lake non supporta AVX-512, quindi quel vantaggio non può venire da x86-64-v4; riflette una combinazione delle scelte di kernel e di build di CachyOS, delle ottimizzazioni dei pacchetti e della configurazione predefinita.
L'esperienza può essere reale mentre l'attribuzione resta incerta. Il confronto Arrow Lake di Phoronix è un controesempio utile: un'installazione CachyOS in stato predefinito può superare Arch standard anche quando x86-64-v4 non è disponibile.
Come verificare se qualcosa di tutto questo vale per la tua macchina
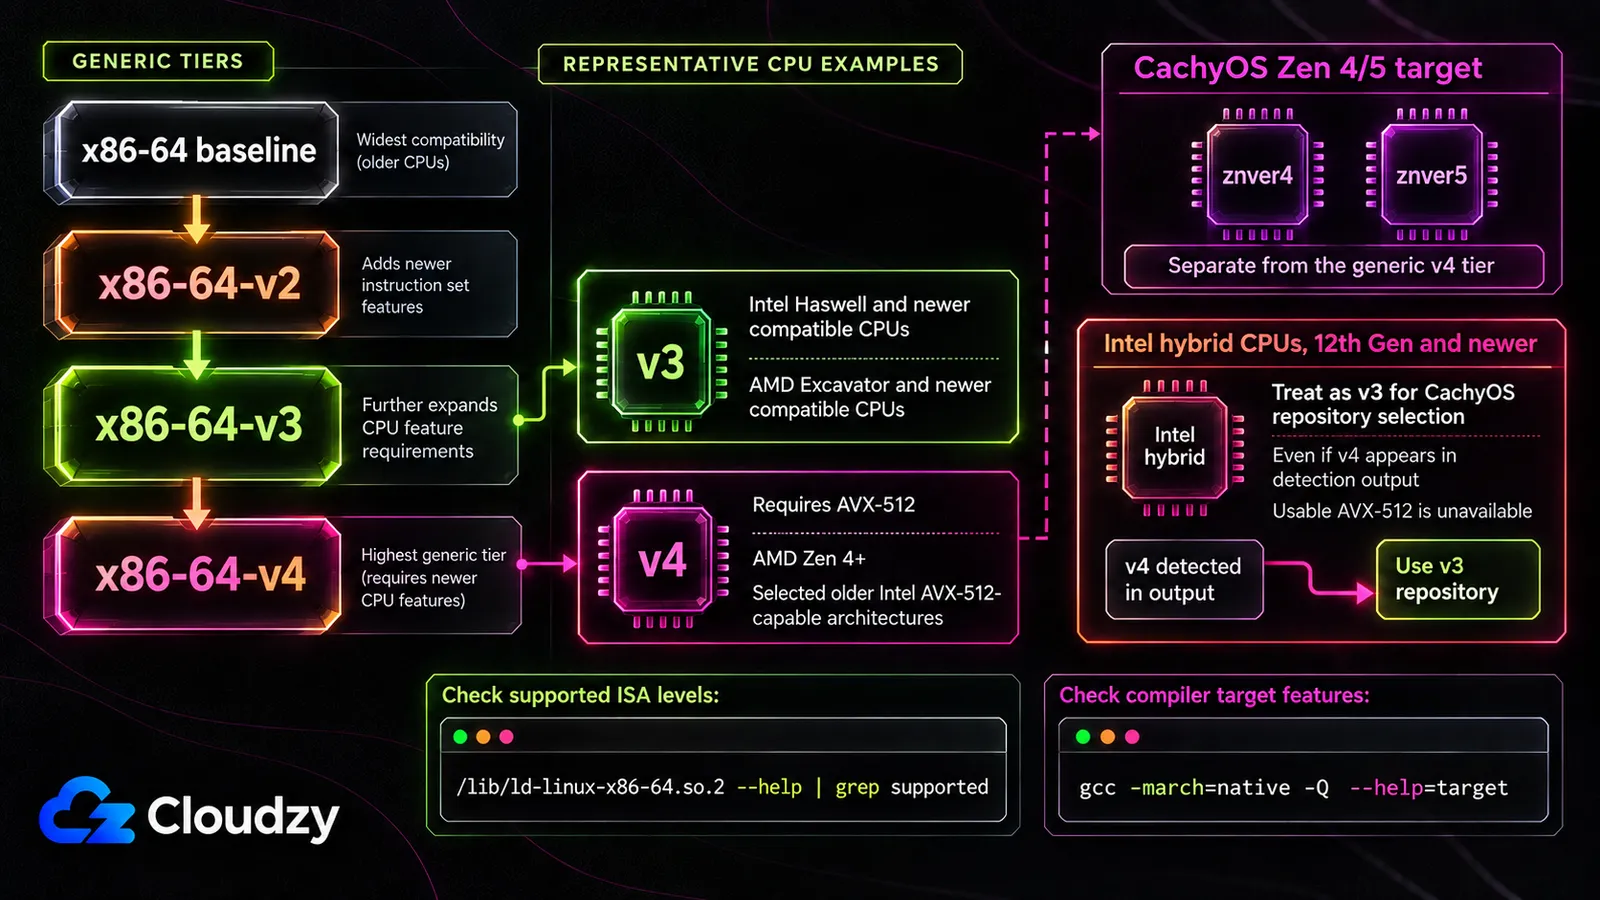
Quale livello standardizzato di microarchitettura x86-64 supporta la tua CPU si risolve quasi del tutto con un comando. Il linker dinamico riporta i livelli glibc-hwcaps che può usare, quindi la voce x86-64-vN più alta supportata di norma ti dice se la CPU si qualifica per il livello di repository generico v2, v3 o v4. Un'eccezione importante sono le CPU ibride Intel di 12ª generazione e successive: CachyOS dice di trattarle come v3 anche se v4 compare nell'output, perché AVX-512 lì non è utilizzabile. Anche il target separato Zen 4/5 di CachyOS richiede una propria verifica di architettura.
/lib/ld-linux-x86-64.so.2 --help | grep supportedPer AMD Zen 4/5, CachyOS documenta anche:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Il primo comando stampa qualcosa del genere:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Quella è una CPU con v3 e v2 ma senza AVX-512. Tre esiti, tre decisioni:
- Nulla sopra x86-64-v2. Il vantaggio delle ricostruzioni v3/v4/specifiche per Zen non si applica a questa CPU. CachyOS può comunque funzionare, e le ottimizzazioni del compilatore specifiche per pacchetto più le modifiche a kernel e configurazione predefinita possono ancora contare.
- x86-64-v3 supportato, x86-64-v4 non disponibile. Questo include le CPU ibride Intel moderne come Arrow Lake ai fini pratici della scelta del repository. Nei confronti citati sopra, molti cambiamenti erano piccoli, alcuni carichi di codifica e compressione hanno guadagnato molto di più, e alcuni pacchetti sono regrediti.
- x86-64-v4 supportato. AVX-512 crea più margine teorico per i carichi vettorizzabili, ma non garantisce un grande guadagno a livello di sistema.
Se la tua CPU si qualifica e la metà dei pacchetti è ciò che vuoi, non devi reinstallare per ottenerla. I repository di CachyOS possono essere aggiunti a un sistema Arch esistente, e ALHP pubblica ricostruzioni dei repository ufficiali di Arch a ogni livello x86-64-vN, documentate sull'Arch Wiki con le proprie avvertenze: servono pacchetti DKMS al posto dei moduli kernel collegati direttamente, e impostare -march per la compilazione del kernel «non produrrebbe alcun risultato significativo». Entrambe le strade ti danno i pacchetti ricompilati e nulla del patchset del kernel o delle varianti di scheduler.
Esegui prima il comando. Trasforma una discussione sulle distribuzioni in un fatto sulla tua macchina, che è l'unica versione di questa domanda che puoi chiudere da solo stasera.

Costruisci su un VPS Linux con accesso root, NVMe e la potenza di AMD EPYC.
Vedi piani LinuxDomande frequenti
CachyOS migliora davvero le prestazioni nei giochi?
Per il frame rate medio, a malapena. Un confronto su cinque giochi del maggio 2026 ha trovato solo una differenza di uno o due frame, e un seguito due giorni dopo ha misurato anche 1% low e frame pacing. Nessuno dei due test ha introdotto un carico CPU concorrente deliberato, quindi la questione irrisolta è la reattività dello scheduler sotto contesa, non se il frame pacing sia stato misurato.
La mia CPU supporta x86-64-v3 o v4?
Su CachyOS o Arch, esegui /lib/ld-linux-x86-64.so.2 --help | grep supported per vedere i livelli glibc-hwcaps standardizzati rilevati per la tua CPU. x86-64-v3 richiede il set di funzionalità dell'era AVX/AVX2, mentre v4 aggiunge AVX-512. Per le CPU ibride Intel di 12ª generazione e successive, CachyOS consiglia di trattare il sistema come v3 anche se v4 compare nell'output; gli utenti Zen 4/5 dovrebbero controllare anche il target separato znver4/znver5.
Perché i pacchetti ricompilati non fanno una differenza maggiore?
Perché parte del codice fortemente ottimizzato viene già smistata a runtime verso implementazioni specifiche per CPU. Le librerie matematiche e crittografiche usano spesso function multiversioning o IFUNC per le funzioni calde, quindi ricompilare i pacchetti aiuta soprattutto il codice che il compilatore può ancora ottimizzare o vettorizzare globalmente.
Posso ottenere i pacchetti ottimizzati di CachyOS senza cambiare distribuzione?
Sì. I repository di CachyOS possono essere aggiunti a un'installazione Arch Linux esistente, e il progetto ALHP pubblica ricostruzioni dei repository ufficiali di Arch per x86-64-v2, v3 e v4, documentate sull'Arch Wiki. Entrambi ti danno solo i pacchetti ricompilati, non il patchset del kernel di CachyOS, gli scheduler alternativi o le impostazioni predefinite dell'installer.
Discussione
Commenti
Accedi per partecipare alla discussione.