
두 데이터베이스가 같은 디스크를 사용해도 필요한 VPS는 다를 수 있습니다. 하나는 적은 행을 반복해서 읽고, 다른 하나는 계속 쓰거나 큰 인덱스를 만들고 장애 후 신속한 복구를 요구합니다. 최적의 VPS 선택은 제공업체 비교보다 먼저 이런 차이에서 출발합니다.
비관리형 VPS를 구매하면 데이터베이스 운영도 책임져야 합니다. PostgreSQL, MySQL, MariaDB의 메모리 예산은 다르며 복구 역량도 주 서버와 함께 설계해야 합니다. 초기 구성은 백업과 유지보수 여유를 남기고 대표 부하 테스트를 통과해야 합니다.
요금제 선택 전에 데이터베이스 부하 측정하기
CPU, RAM, 디스크 선택 전에 활성 데이터·인덱스, 최대 동시 쿼리, 증가량과 복구 요구를 측정하세요. 측정된 제약에 따라 자원을 추가합니다. 공유 호스트라면 유지보수 공간과 앱의 최대 소비를 포함해 평소와 혼잡 시간을 모두 감당해야 합니다.
작업 집합은 메모리에 둘 가치가 있을 만큼 자주 쓰는 데이터와 인덱스입니다. 저장량에는 콜드 데이터도 포함됩니다. 열린 연결도 활성 쿼리와 다릅니다. 유휴 클라이언트와 동시 정렬은 CPU·RAM 요구가 다르므로 둘 다 쿼리 형태와 읽기/쓰기 비율과 함께 기록하세요.
대표적인 혼잡 기간을 기준으로 구매 요건을 정하세요:
- 앱이 VPS를 공유한다면 최대 메모리를 측정합니다.
- 데이터·인덱스 크기, 예상 작업 집합, 동시 작업 및 계획 기간의 증가량을 기록합니다.
- 로그 생성량과 예상 최대 인덱스 구축, 테이블 재작성 또는 유지보수 작업을 측정합니다.
- 앱의 p95 지연 목표, 허용 데이터 손실 구간과 복원 시간 목표를 정합니다.
- 앱 실행 위치를 정하고 데이터베이스까지 경로를 테스트합니다.
PostgreSQL 모니터링 문서는 데이터베이스 통계와 OS 도구를 함께 쓰라고 권합니다. CPU, 메모리 압박, 디스크 활동을 쿼리·커밋 시간과 측정하세요. 유휴 상태가 정상이더라도 백업 중 지연 증가는 조사해야 합니다.
전용 vCPU는 할당 CPU에 지속 접근할 수 있지만 물리 서버 전체나 IOPS 보장은 아닙니다. CPU 할당, RAM, 저장장치 동작을 따로 평가하세요. 실측 요구가 VPS 선택지를 넘으면 큰 상품 이름으로 추정하지 말고 전용 하드웨어를 검토합니다.
SQL 부하에 초기 구성 맞추기
앱 호환성에 따라 PostgreSQL 16, InnoDB의 MySQL 8.4 또는 MariaDB 11.4를 대안 예시 환경으로 쓰세요. 엔진은 상호 교환되지 않으며 최신 버전이라는 주장도 아닙니다. 테스트 전에 설치된 패치 버전을 기록하세요. 예시는 공급자 이미지 배포 버전을 지정하지 않습니다.
작은 앱과 데이터베이스 함께 배치하기
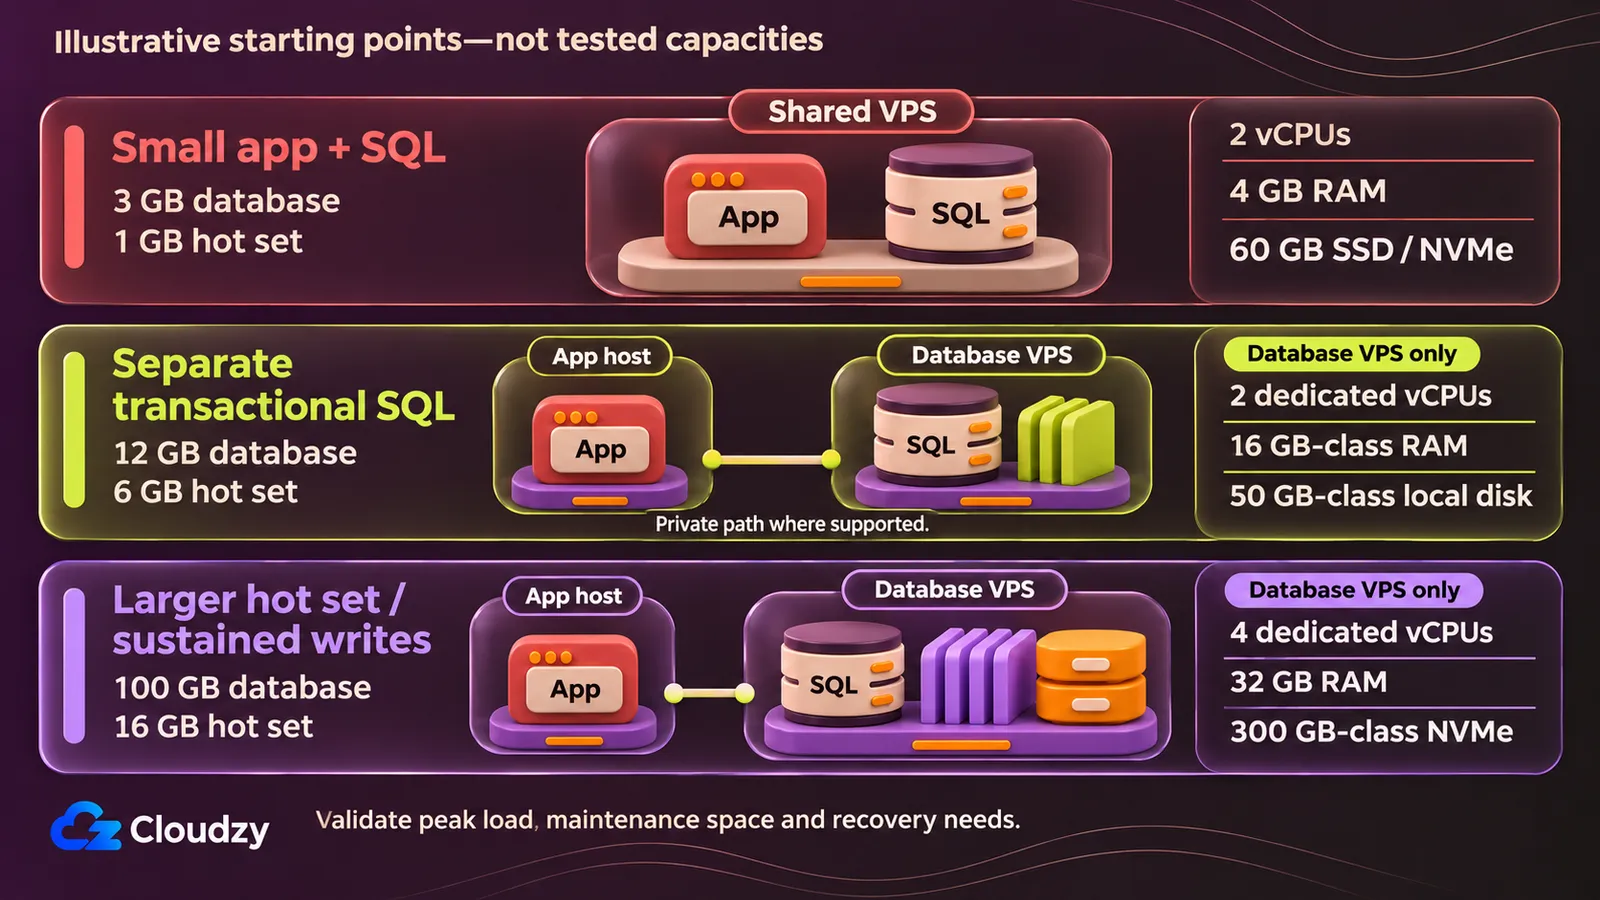
데이터 3 GB, 핫 집합 1 GB, 활성 단순 인덱스 쿼리 5개를 가정하면 2 vCPU, 4 GB RAM, 공칭 60 GB SSD/NVMe를 시험합니다. 연결은 로컬이지만 두 구성 요소의 최대 메모리가 같은 예산에 들어야 합니다.
읽기/쓰기 90/10, 월 1 GB 증가, 백업 중 장시간 보고서 없음을 가정합니다. 변동을 허용하는 스테이징에는 공유 CPU가 맞을 수 있습니다. 지속 경쟁으로 응답이 나빠지면 전용을 고르세요. 뒤의 운영 상품 비교는 모두 전용 vCPU입니다.
제안 RAM 배분이며 모든 숫자 단위는 GB입니다:
| 소비 항목 | 가정 RAM |
|---|---|
| OS 및 모니터링 에이전트 | 0.75 |
| 앱 최대 부하 | 1 |
| 데이터베이스 캐시 | 1 |
| 파일 시스템 캐시 | 0.75 |
| 쿼리·연결·유지보수 예비 | 0.5 |
| 합계 | 4 |
MySQL/MariaDB InnoDB 풀을 이 범위에 맞추세요. 전용 데이터베이스용 비율을 전체 호스트에 적용하면 앱의 RAM을 소모합니다. PostgreSQL은 데이터베이스 할당과 예비 안에서 공유 버퍼와 작업 메모리를 따로 계산하고, 어느 구성이든 합산 최대치를 측정한 후 채택합니다.
디스크 예시는 OS/로그 5 GB, 데이터/인덱스 3 GB, 엔진 로그 4 GB, 임시 3 GB, 성장 6 GB로 총 21 GB입니다. 공칭 나머지는 파일 시스템 오버헤드와 임시 작업을 위한 것이지 주 서버에 백업을 보관할 이유가 아닙니다.
로컬 소켓이나 localhost로 연결합니다. 앱·백업 가동 중 영속 커밋과, OS에 영속 저장장치로 쓰도록 요청하는 동기화(fsync)를 테스트하세요. 담당자가 24시간 RPO(허용 손실 구간)와 4시간 RTO(복구 시간 목표)를 수용하면 야간 엔진 기본 백업을 노드 밖에 저장하고 훈련으로 복원 시간을 입증합니다. RAM·지연·복구 예산 실패 시 쿼리/인덱스 진단 후 분리, 증설 또는 재설계합니다.
트랜잭션 SQL 데이터베이스 분리하기
앱이 다른 곳에 있으면 12 GB SQL, 6 GB 핫 집합 예시는 전용 2 vCPU, 16 GB급 RAM, 50 GB급 로컬 저장장치로 시험을 시작할 수 있습니다. 활성 인덱스 쿼리 20개, 짧은 쓰기, 낮은 지속 연산을 가정하며 큰 작업은 예산을 무효로 합니다.
읽기/쓰기 90/10, 3개월간 매월 1 GB 성장을 가정합니다. 제공업체 표의 기준 부하입니다. 단위가 다르므로 할당 전에 실제 가용 RAM과 파일 시스템 사용 가능 바이트를 비교하세요.
PostgreSQL VPS에서 PostgreSQL 16 공유 버퍼 지침은 RAM 1 GB 이상인 전용 데이터베이스 서버의 시스템 메모리 25%부터 시작합니다. OS 캐시도 씁니다. 16 GB 제안은 공유 버퍼 4 GB, OS/에이전트 2 GB, 쿼리/연결/유지보수 2 GB, 파일 캐시와 여유 8 GB입니다.
예비량은 work_mem 설정이 아닙니다. PostgreSQL 쿼리 작업 메모리 문서에 따르면 여러 세션의 각 정렬·해시가 별도로 메모리를 할당할 수 있습니다. 해시는 hash_mem_multiplier도 씁니다. 허용 동시 작업으로 한도를 정하세요. 작업당 값이 크면 공유 버퍼가 충분해도 호스트 예산을 넘습니다.
MySQL VPS에서 Oracle MySQL 8.4 버퍼 풀 지침은 OS와 다른 할당을 고려해 보통 RAM 50–75%를 권합니다. 여기서는 InnoDB 8 GB를 시험하고 나머지는 다른 소비와 최대 부하에 남깁니다.
MariaDB는 계산이 다릅니다. 메모리 할당 지침은 주로 InnoDB일 때 OS/서비스를 뺀 RAM 60–70%부터 시작합니다. 가용 13 GB라면 7.8–9.1 GB여서 초기 8 GB가 맞습니다. MyISAM이나 Aria 캐시는 별도입니다. 엔진 예산은 대안이므로 합산하지 마세요.
디스크는 데이터/인덱스 12 GB + 성장 3 GB + OS 5 GB + 로그 4 GB + 임시/보수 8 GB = 32 GB입니다. 50 GB급은 오버헤드 전 공칭 약 18 GB가 남습니다. 실측 여유 최소 15 GB를 요구하세요. 로그 보관이나 재작성이 늘면 예시는 성립하지 않습니다.
앱과 데이터베이스를 가깝게 두고 지원 시 시험된 사설 경로, 인증, 접근 제어, 암호화를 사용합니다. 체크포인트, 플러시, 백업 시 쿼리와 영속 커밋 지연을 확인하세요. 독립 백업 공간은 아래 복구 예시에서 설명합니다. 진단 후에도 자원 포화, 여유 부족, 복구 미달이면 증설합니다.
큰 작업 집합과 지속 쓰기에 대비하기
100 GB 데이터, 16 GB 핫 집합을 가정해 전용 4 vCPU, 32 GB RAM, 300 GB급 NVMe와 별도 앱을 시험합니다. 활성 혼합 쿼리 30개, 읽기/쓰기 60/40이며, 자원 증설 전 실행과 저장장치 압박을 측정하세요.
3개월간 매월 10 GB 증가를 가정합니다. PostgreSQL은 공유 버퍼 8 GB, OS/쿼리/보수 4 GB, 파일 캐시와 여유 20 GB입니다. MySQL/MariaDB에서는 다른 소비를 확보한 후 약 16 GB InnoDB가 대안 초기값입니다. PostgreSQL 설정을 그대로 옮기지 마세요.
디스크에는 진행 중 작업도 포함됩니다. 데이터/인덱스 100 GB + 성장 30 GB + 보관/대기 로그 30 GB + 최대 임시/보수 60 GB + OS 10 GB = 230 GB로 공칭 약 70 GB가 남습니다. 일상 증가가 작아도 큰 테이블 재작성은 재계산해야 합니다.
PostgreSQL 정기 vacuum 문서는 죽은 행 공간을 재사용하게 하는 VACUUM과 새 테이블 사본을 써 임시 추가 공간이 필요한 VACUUM FULL을 구분합니다. 데이터보다 조금 큰 디스크는 공간 회수에 필요한 보수를 막을 수 있습니다.
CPU 실행, 캐시 압박, 물리 I/O를 쓰기 지연과 따로 측정합니다. 임시 쓰기와 체크포인트/플러시도 포함하세요. NVMe·전용 CPU는 구성이지 IOPS 보장이 아닙니다. 가까운 사설 앱 연결과 독립 복구 공간으로 지속 백업/복제 전송도 시험합니다. 빠른 로그는 보관 용량과 네트워크 요구를 바꿉니다. 상위 상품이 모두 늘려서가 아니라 관측 병목에 따라 코어, RAM, 디스크를 늘리세요.
운영 환경에 복구 능력 추가하기
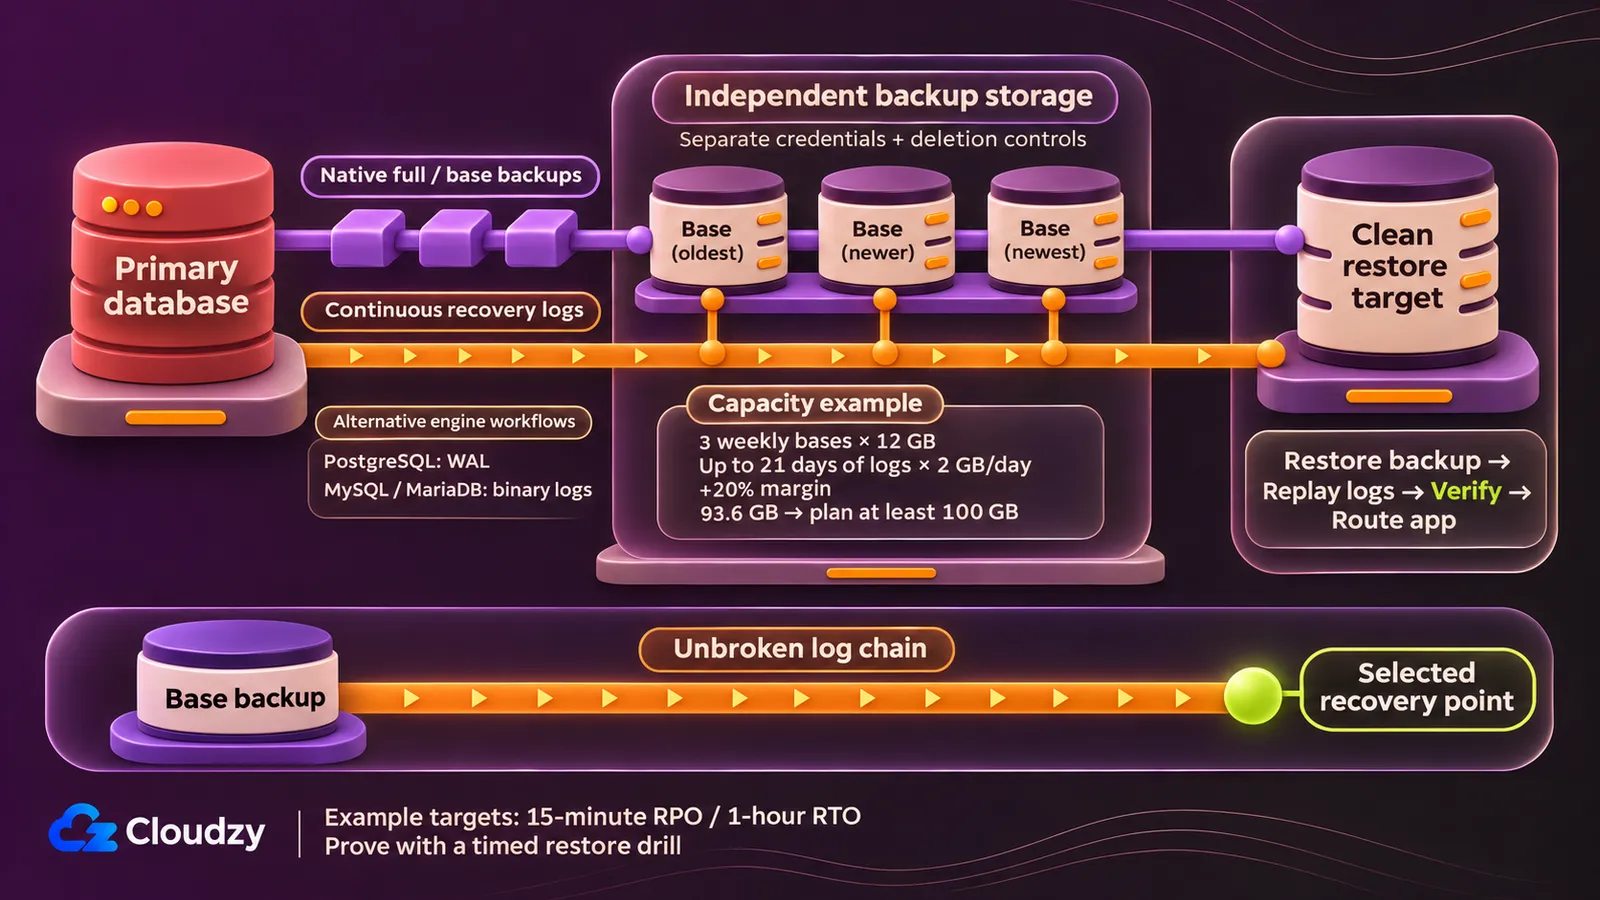
15분 손실 허용과 1시간 복원 목표에는 주 서버 예산 이상이 필요합니다. 분리 SQL 가정을 유지하며 엔진 자체 백업, 보관 로그, 독립 저장장치, 시간 측정 훈련을 더합니다. 계획 목표일 뿐 달성 여부는 훈련이 입증합니다.
PostgreSQL 연속 아카이빙 문서는 기본 백업과 끊김 없는 WAL로 시점 복구를 설명합니다. Oracle MySQL 복구 문서는 전체 백업 후 바이너리 로그를 적용합니다. MariaDB PITR 절차는 전체/증분 데이터를 복원한 다음 바이너리 로그를 재생합니다. 이 MySQL/MariaDB 경로는 바이너리 로깅을 켜야 합니다.
용량 예시로 비압축 전체/기본 백업 각각 12 GB를 가정합니다. 주간 기본 3개와 가장 오래된 시작부터 연속 로그를 유지합니다. 최대 21일, 하루 2 GB에 20% 여유로 계산합니다:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
압축을 가정하지 말고 독립 백업 최소 100 GB를 계획하세요. 로그 삭제는 백업 만료와 성공적 대체에 연동합니다. 약속한 모든 복구점까지 기본 백업과 로그 사슬이 완전한지 확인하세요.
자격 정보와 삭제 통제도 주 서버와 분리한 독립 대상 백업을 사용합니다. 공급자 스냅샷만으로 이 기본 복구 사슬을 입증할 수 없습니다. 훈련은 깨끗한 대상 생성, 전송/복원, 로그 재생, 데이터베이스/앱 일관성 확인, 앱 라우팅까지 해야 합니다. 프로비저닝과 전송 시간도 측정하세요.
더 짧은 중단 목표에는 전체 부하를 처리하는 독립 복제본이 필요할 수 있습니다. CPU, RAM, 디스크를 따로 계산하고 승격, 이전 주 서버 격리, 클라이언트 경로를 정해 훈련하세요. 복제는 백업 대체가 아니며 VPS 한 대는 고가용성이 아닙니다. 복원 1시간 초과, 아카이브 지연이 RPO 초과, 대기 서버 용량 부족, 백업 공간 한계 접근 시 재설계합니다.
관리형 VPS가 필요한 경우
경고 대응이나 장애 복원을 할 사람이 없다면 명시된 운영 범위를 구매하세요. 관리형 VPS는 일부 보수를 넘길 수 있지만 계약에 데이터베이스 작업을 명시해야 합니다. 제어판은 범위 증거가 아니며 관리형 VPS와 관리형 데이터베이스는 다릅니다.
관리형·비관리형 VPS의 책임 차이는 작업별로 유용합니다. 다음은 구매 점검표이며 모든 서비스의 같은 범위를 약속하지 않습니다. 물리 인프라는 공급자 영역이지만 게스트 소프트웨어와 데이터베이스 운영은 담당자를 명확히 해야 합니다.
| 작업 | 관리되지 않는 VPS | 관리 서비스 구매 전 정할 범위 |
|---|---|---|
| 게스트 OS·데이터베이스 패치/업그레이드 | 직접 계획하고 수행 | 지원 버전, 패치 범위, 업그레이드 시험과 보수 시간 |
| 쿼리·스키마·인덱스 튜닝 | 직접 진단하고 변경 | 포함 여부, 서비스 설정만인지 별도 요금인지 |
| 모니터링과 사고 | 직접 경고를 설정하고 대응 | 감시 시간, 대응/에스컬레이션 책임, 경고 후 실행자 |
| 백업과 복원 | 복구 절차는 직접 책임 | 보관, 독립 공간, 복원 지원 및 시험 증거 |
계약에 유용한 질문은 ‘백업 중 디스크가 가득 차면 누가 진단하고 서비스를 복구하며 다음 백업 성공을 확인하는가?’입니다. 지원 접근과 결과 책임을 구분합니다. 엔진 업그레이드 실패나 실수로 삭제한 경우도 물어보세요.
관리형 데이터베이스는 엔진 수명주기, 백업, 장애조치 약정이 따로 있습니다. 복구와 업그레이드를 넘기려면 더 맞을 수 있습니다. 이름으로 앱 튜닝까지 추정하지 마세요. 별도 약정 없이는 쿼리 설계와 앱 동작에 여전히 담당자가 필요합니다.
각 작업을 한 번만 배정하고 에스컬레이션과 인수 확인을 정하세요. 서비스 가격을 본인 시간·대응 가능성과 비교합니다. 자가 관리의 보편적 시급은 없고, 싼 서버는 주인 없는 사고를 해결하지 못합니다.
SQL 외 부하에 VPS 선택하기
메모리, 문서, 검색 인덱싱 부하를 나눈 예시입니다. 앱을 가깝게 두고 연결과 사용 중인 백업/복제본 전송도 시험하세요.
| 부하와 가정 | 시험할 초기 구성 | 저장장치·복구·변경 조건 |
|---|---|---|
| Redis 캐시/키값: 실측 2 GB 데이터 | 전용 2 vCPU, 8 GB RAM: maxmemory를 호스트 RAM 아래로 두고 오버헤드 확보 |
재구축 캐시는 손실을 허용할 수 있습니다. 영속 주 서버는 명확한 RDB/AOF, 재작성 공간, 독립 백업이 필요합니다. RAM/RSS, 단편화, 퇴출, 영속성 최대치, 꼬리 지연을 측정하세요. |
| MongoDB: 20 GB 문서/인덱스와 작은 실측 핫 집합 | 전용 2–4 vCPU, 16 GB RAM, 100 GB급 로컬 디스크 | journal/oplog, 성장, 임시 공간을 계산합니다. 복원 시간과 캐시 퇴출, I/O, 복제 지연을 확인하고 복제본별 CPU/RAM/디스크를 역할에 맞게 계산합니다. |
| Elasticsearch: 작은 30 GB 인덱스 | 관련 데이터 노드당 전용 4 vCPU, 16 GB RAM, 150 GB급 로컬 디스크 | 복제본, 세그먼트 병합, 보관, 독립 스냅샷을 계산합니다. heap/GC, 검색/색인 지연, 병합 I/O, 디스크를 확인하세요. 복원력에는 적절한 투표 토폴로지와 클라이언트 경로도 필요합니다. |
Redis 관리 지침은 쓰기 집중 RDB 저장/AOF 재작성 때 바뀐 페이지에 따라 평소 두 배 RAM을 쓸 수 있다고 경고합니다. 2 GB 데이터로 RAM을 다 쓰면 안 됩니다. 영속성 문서는 주기 RDB 스냅샷과 AOF 쓰기 로그를 구분합니다. 허용 손실에 따라 선택하고 실행 중 RAM/디스크 최대치를 측정하세요.
MongoDB WiredTiger 캐시 문서는 내부·파일 시스템 캐시를 설명합니다. 기본 내부 값은 50% × (RAM − 1 GB)와 0.256 GB 중 큰 값입니다. 복제 세트 지침은 데이터를 가진 세 멤버를 권합니다. 중재자는 투표만 하고 데이터가 없습니다. 독립 백업을 확보하고 앱 연결 전 MongoDB 인증을 설정하세요.
Elastic JVM 설정 문서는 자동 heap을 권합니다. 수동이면 최솟값·최댓값을 같게 하고 가용 RAM 50% 이하로 합니다. 소규모 클러스터 복원력 지침은 데이터 보유·master 자격 노드 둘과 투표 전용 결정 노드를 설명합니다. 복제본을 구성하고 클라이언트를 데이터 노드로 연결하세요. 결정 노드는 표만 더하고 데이터 사본은 늘리지 않습니다. 병합/보관이 디스크 여유를 소모하면 새 문서 전에 예산을 수정합니다.
필요 구성에 맞는 비관리형 상품 비교하기
분리 트랜잭션 SQL은 최소 전용 2 vCPU, 16 GB급 RAM, 50 GB급 로컬로 선별합니다. 통과는 시험 후보일 뿐입니다. CPU/디스크 묶음, 단위, 요금 약정이 달라 같은 하드웨어나 성능 순위로 볼 수 없습니다.
기준은 독일 또는 가까운 중부 유럽의 자가 관리 Linux로, 데이터는 적고 RAM 예산은 큽니다. 가깝다고 앱 지연이 같지 않습니다. 지원 시 사설 연결을 사용하며 견적은 표준 공용 IPv4를 유지합니다. 전송은 모든 한도 아래로 가정합니다.
| 공급자와 비관리형 상품 | 전용 vCPU / RAM / 로컬 디스크 | 위치와 전송 한도 | 비용·청구·IPv4 |
|---|---|---|---|
| Cloudzy: 당사의 Regular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | 세계 여러 지역의 위치: 10 TB | 월 49.98달러: IPv4·IPv6 포함 |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1: EU에서 최소 20 TB | 월 상한 86.49유로, 기본 IPv4 0.50유로 포함, VAT 제외 |
| DigitalOcean Memory-Optimized 묶음 Droplet, Regular CPU, 1× SSD | 2 / 16 GiB / 50 GiB NVMe | FRA1에서 해당 계열 사용 가능: 4,000 GiB | 월 상한 84달러: 시간당 0.125달러: 공용 IPv4 포함 |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2코어/16 GB/100 GB | 2 / 16,384 MB / 100 GB NVMe | 프랑크푸르트(fra): 6,144 GB |
월 80달러: 시간당 0.11달러: 기본 IPv4. 별도 요금이나 IPv4 미사용 할인은 예산 전 확인 |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16,384 MB / SSD 327,680 MB(320 GB급 상품) | 프랑크푸르트(de-fra-2) 사용 가능으로 표시: 6,000 GB |
월 173달러: 시간당 0.2595달러: 표준 공용 IPv4 추가 비용 없음 |
DigitalOcean 선택 문서는 SQL/NoSQL·캐시에 Memory-Optimized를 제시합니다. 작은 디스크·큰 RAM 사례에는 위 묶음을 추천합니다. 메모리 최적화 VPS가 SQL 전용이라는 뜻은 아닙니다. 실측 제약이 용량이나 지속 저장장치 요구라면 Storage-Optimized를 따로 평가하세요.
다섯 상품 모두 최소치를 만족하며 추가 CPU/디스크가 다릅니다. 여유는 성장을 도울 수 있지만 시험 없이 DB 속도 우위를 증명하지 않습니다. Hetzner 목록은 주문 재고 보장이 아닙니다. Akamai는 G7 Dedicated를 SSD로 명시합니다. Vultr Optimized Memory는 공유 High Frequency Compute와 별도입니다.
당사의 전용 할당은 표시 가격에서 자가 관리 구성에 맞습니다. 총 가치를 판단하기 전에 자원, 통화, 요금 약정, IPv4 비용을 비교하세요.
총비용은 컴퓨팅 + 주소 + 독립 백업 저장/요청/전송 + 복원 시험 용량 + 선택 대기 서버입니다. 모르는 요금은 0이 아닙니다. 현재 복구 서비스 가격을 받고 약정 전에 정확한 상품·위치·업그레이드 경로를 확인하세요. 반올림 월 환산액을 곱해 연 청구액을 추정하지 마세요.
호환 SQL 엔진을 고른 뒤 원클릭 앱으로 설치를 줄일 수 있습니다. PostgreSQL, MySQL, MariaDB는 개별 선택이며 하나를 고른다고 셋 다 설치되지 않습니다. 패치, 튜닝, 복구는 계속 본인 책임입니다.
자주 묻는 질문
PostgreSQL 캐시 적중률로 느린 저장장치를 알 수 있나요?
아니요. PostgreSQL I/O 통계 문서는 OS 캐시가 디스크 접근 없이 읽기를 처리할 수 있다고 설명합니다. 적중률을 OS I/O·쿼리 시간과 함께 보세요. 비율만으로 물리 지연과 커널 메모리 읽기를 구분할 수 없습니다.
논리 PostgreSQL 덤프로 WAL 시점 복구를 할 수 있나요?
아니요. PostgreSQL 연속 아카이빙 요건은 논리 덤프에 WAL 재생 정보가 없다고 명시합니다. 덤프는 캡처한 상태를 복원하고, WAL 시점 복구는 적합한 기본 백업과 연속 WAL 아카이브가 필요합니다. 복구 방식에 맞는 형식을 선택하세요.
컨테이너 MongoDB 캐시는 호스트 전체 RAM을 써야 하나요?
컨테이너에 가용한 RAM을 쓰세요. MongoDB 컨테이너 메모리 지침은 WiredTiger가 더 낮은 제한을 인식하지 못할 수 있다고 경고합니다. 다른 프로세스 공간을 남겨 캐시를 제한 아래로 두세요. 호스트 총 RAM은 실제 DB 가용량을 과대평가할 수 있습니다.
토론
댓글
토론에 참여하려면 로그인하세요.