
Dois bancos podem ocupar o mesmo disco e exigir VPS diferentes. Um relê poucas linhas; outro mantém gravações, cria índices grandes ou precisa se recuperar rapidamente de falhas. A escolha começa nessas diferenças, antes de comparar provedores.
Comprar um VPS não gerenciado inclui operar o banco. PostgreSQL, MySQL e MariaDB precisam de orçamentos de memória diferentes; a capacidade de recuperação integra o projeto do primário. A configuração inicial deve reservar espaço para backups e manutenção e passar num teste representativo.
Dimensione a carga antes de escolher o plano
Meça dados e índices ativos, consultas simultâneas no pico, crescimento e recuperação antes de escolher CPU, RAM ou disco. Acrescente recursos conforme a restrição medida. Inclua manutenção e consumo máximo do aplicativo se compartilhar host; o orçamento deve cobrir picos e rotina.
O conjunto de trabalho reúne dados e índices acessados com frequência suficiente para se beneficiarem da memória. O volume armazenado inclui dados frios. Conexões abertas também diferem de consultas ativas: clientes ociosos e ordenações simultâneas exigem RAM e CPU distintas. Registre ambos, formato das consultas e proporção leitura/gravação.
Defina os requisitos de compra a partir de um período intenso representativo:
- Meça o pico de memória do aplicativo se compartilhar o VPS.
- Registre tamanho de dados e índices, conjunto de trabalho estimado, operações simultâneas e crescimento no horizonte previsto.
- Meça geração de logs e identifique a maior criação de índice, reescrita de tabela ou manutenção prevista.
- Defina latência p95, janela aceitável de perda e tempo-alvo de restauração.
- Escolha onde executar o aplicativo e teste o caminho até o banco.
A documentação de monitoramento do PostgreSQL recomenda estatísticas do banco com utilitários do sistema. Meça CPU, pressão de memória e disco junto dos tempos de consulta e commit. Investigue aumento de latência durante backup mesmo se o servidor ocioso parecer adequado.
vCPUs dedicadas dão acesso sustentado à CPU alocada, não um servidor físico inteiro nem IOPS garantidas. Avalie CPU, RAM e armazenamento separadamente. Se as necessidades medidas excederem os VPS disponíveis, avalie hardware dedicado em vez de extrapolar pelo nome de um plano maior.
Associe cargas SQL a uma configuração inicial
Use PostgreSQL 16, MySQL 8.4 com InnoDB ou MariaDB 11.4 com InnoDB como ambientes alternativos conforme compatibilidade. Não são intercambiáveis nem afirmações de versão mais recente. Registre o patch instalado antes do teste; os exemplos não especificam a versão da imagem do provedor.
Hospede aplicativo pequeno e banco juntos
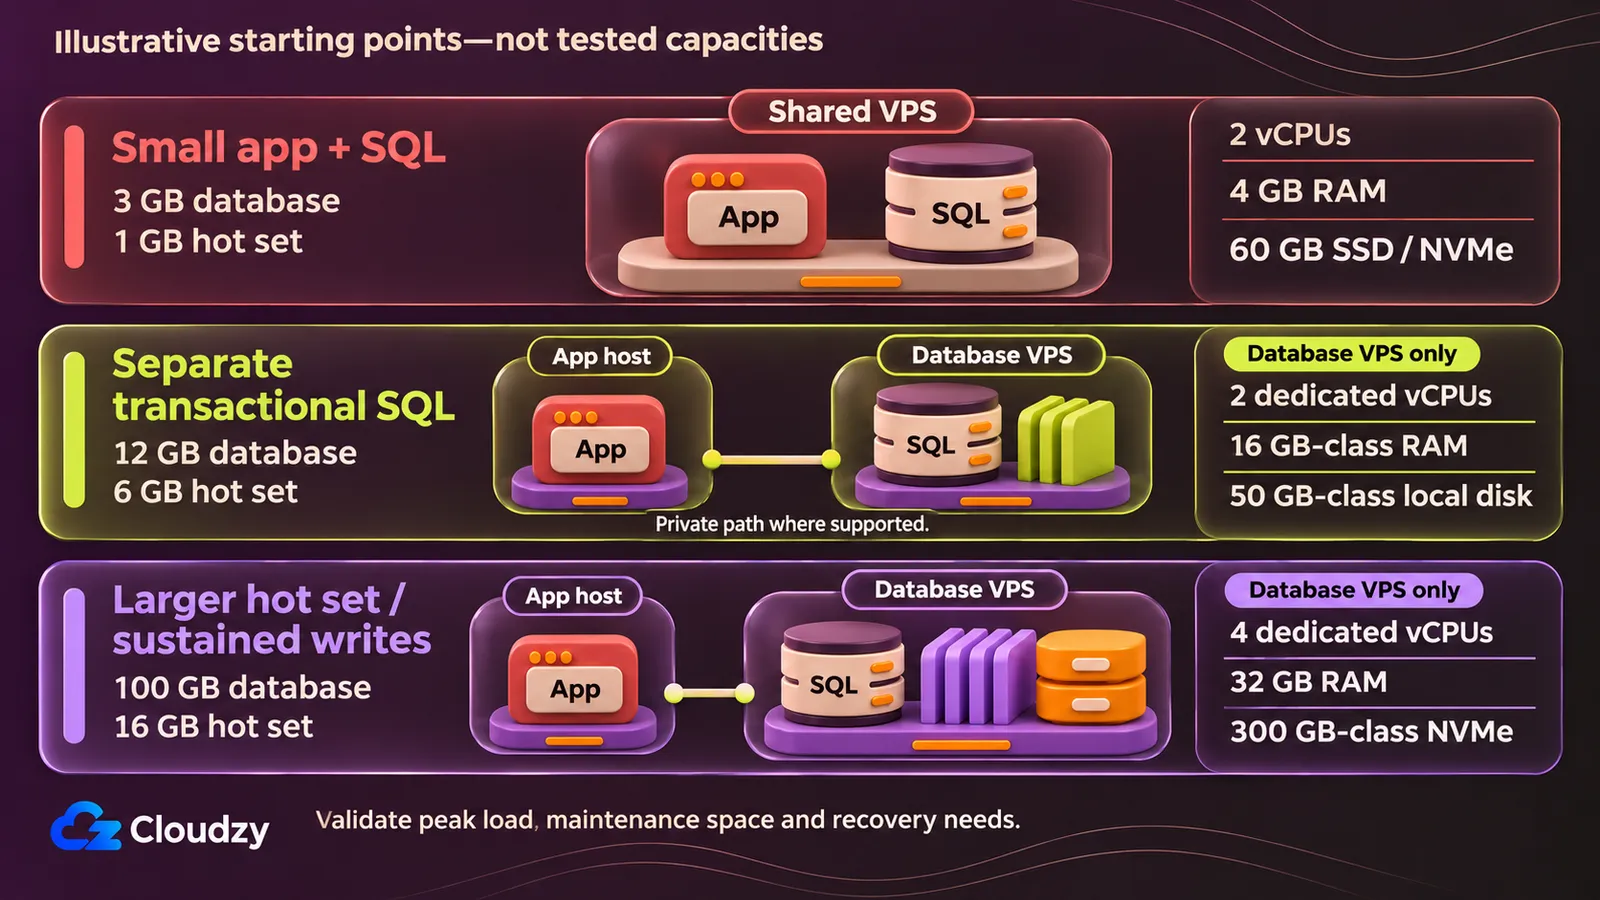
Para hipótese de banco de 3 GB, conjunto quente de 1 GB e cinco consultas simples indexadas ativas, teste 2 vCPUs, 4 GB RAM e 60 GB nominais SSD ou NVMe. A conexão é local, mas aplicativo e banco precisam caber juntos no pico de memória.
Suponha leitura/gravação 90/10, crescimento mensal de 1 GB e nenhum relatório longo durante backups. CPU compartilhada pode atender staging tolerante. Escolha dedicada se a disputa sustentada prejudicar respostas; a comparação de produção abaixo usa apenas vCPUs dedicadas.
Envelope de RAM proposto, todos os valores em GB:
| Consumidor | RAM presumida |
|---|---|
| SO e agentes de monitoramento | 0.75 |
| Aplicativo no pico | 1 |
| Cache do banco | 1 |
| Cache do sistema de arquivos | 0.75 |
| Reserva para consultas, conexões e manutenção | 0.5 |
| Total | 4 |
Encaixe o pool InnoDB de MySQL/MariaDB nesse envelope. Aplicar ao host inteiro uma porcentagem de servidor de banco dedicado consumiria memória do aplicativo. Para PostgreSQL, conte buffers compartilhados e memória das operações separadamente na alocação e reserva do banco. Meça o pico combinado antes de aceitar qualquer alternativa.
Exemplo de disco: 5 GB SO/logs, 3 GB dados/índices, 4 GB logs do motor, 3 GB temporários e 6 GB crescimento, total 21 GB. O restante nominal absorve sobrecarga do sistema de arquivos e trabalho temporário, não justifica reter backups no primário.
Conecte via socket local ou localhost. Teste commits duráveis com aplicativo e backup ativos, incluindo sincronização (fsync), que pede ao SO gravar em armazenamento durável. Se o responsável aceita RPO de 24 horas, a perda admissível, e RTO de quatro horas, o tempo-alvo, proponha backup nativo noturno fora do nó e comprove a restauração em exercício. Se memória, latência ou recuperação falhar, separe, redimensione ou reveja a recuperação após diagnosticar consultas/índices.
Separe um banco SQL transacional
Com aplicativo em outro host, um banco SQL ilustrativo de 12 GB e conjunto quente de 6 GB pode iniciar testes com 2 vCPUs dedicadas, RAM classe 16 GB e disco local classe 50 GB. Supõe 20 consultas indexadas ativas, gravações curtas e pouca computação sustentada; operações maiores invalidam o orçamento.
Suponha leitura/gravação 90/10 e crescimento mensal de 1 GB por três meses. É a carga de referência da tabela. Como unidades variam, compare memória realmente disponível e bytes utilizáveis antes das alocações.
Para PostgreSQL em VPS, a orientação de buffers compartilhados do PostgreSQL 16 parte de 25% da RAM do sistema em servidor dedicado ao banco com pelo menos 1 GB. PostgreSQL também usa cache do SO. Proposta de 16 GB: 4 GB compartilhados, 2 GB SO/agentes, 2 GB reserva de consultas/conexões/manutenção e 8 GB cache de arquivos/folga.
A reserva não é um valor de work_mem. A documentação de memória de operações de consulta PostgreSQL explica que ordenações e hashes separados alocam memória enquanto várias sessões trabalham. Hashes também usam hash_mem_multiplier. Defina limites pela concorrência permitida; valores altos por operação podem exceder o host mesmo com buffers compartilhados suficientes.
Para MySQL VPS, a orientação do buffer pool MySQL 8.4 da Oracle geralmente recomenda 50–75% da RAM, considerando SO e demais alocações. Teste InnoDB com 8 GB, reservando o restante para outros consumidores e picos.
MariaDB exige cálculo distinto. Sua orientação de alocação de memória começa em 60–70% da RAM disponível após SO/serviços para sistemas majoritariamente InnoDB. Com 13 GB disponíveis, são 7,8–9,1 GB; 8 GB iniciais cabem. MyISAM ou Aria exigem cache separado. São alternativas: não some esses orçamentos.
Disco: 12 GB dados/índices + 3 GB crescimento + 5 GB SO + 4 GB logs + 8 GB temporários/manutenção = 32 GB. Um disco classe 50 GB deixa cerca de 18 GB nominais antes da sobrecarga. Exija ao menos 15 GB livres medidos; mais logs ou reescritas invalidam o exemplo.
Aproxime aplicativo e banco com caminho privado testado onde suportado, autenticação, controles de acesso e criptografia. Meça latência de consulta/commit durável em checkpoints, flushes e backups. Aloque backup independente; o caso abaixo detalha. Redimensione se houver saturação, pouco espaço ou recuperação insuficiente após diagnóstico de consultas/índices.
Planeje conjuntos maiores ou gravações sustentadas
Para hipótese de 100 GB com conjunto quente de 16 GB, teste 4 vCPUs dedicadas, 32 GB RAM e NVMe classe 300 GB. Separe o aplicativo. O exemplo permite 30 consultas mistas ativas e leitura/gravação 60/40; meça execução e pressão de disco antes de ampliar.
Suponha crescimento mensal de 10 GB por três meses. PostgreSQL: 8 GB compartilhados, 4 GB reserva SO/consultas/manutenção e 20 GB cache/folga. Para MySQL/MariaDB, pool InnoDB de cerca de 16 GB é alternativa inicial após reservar os demais consumidores. Não transplante parâmetros PostgreSQL.
Armazenamento inclui trabalho em andamento: 100 GB dados/índices + 30 GB crescimento + 30 GB logs retidos/em fila + 60 GB maior operação temporária/manutenção + 10 GB SO = 230 GB. Sobram cerca de 70 GB nominais. Reescritas maiores exigem recalcular mesmo com crescimento diário modesto.
A documentação de vacuum rotineiro PostgreSQL distingue VACUUM, que torna reutilizável o espaço de linhas mortas, de VACUUM FULL, que grava nova cópia e precisa de espaço adicional temporário. Disco pouco maior que os dados pode impedir a manutenção necessária para liberar espaço.
Meça CPU, pressão de cache e E/S física separadas da latência de gravação. Inclua gravações temporárias, checkpoints e flushes. NVMe e CPU dedicada descrevem a configuração, sem garantir IOPS. Teste transferências sustentadas de backup e replicação com rede privada próxima e recuperação independente. Logs mais rápidos alteram retenção e rede. Amplie núcleos, RAM ou disco pelo gargalo observado, não porque o próximo plano aumenta tudo.
Adicione capacidade de recuperação à produção
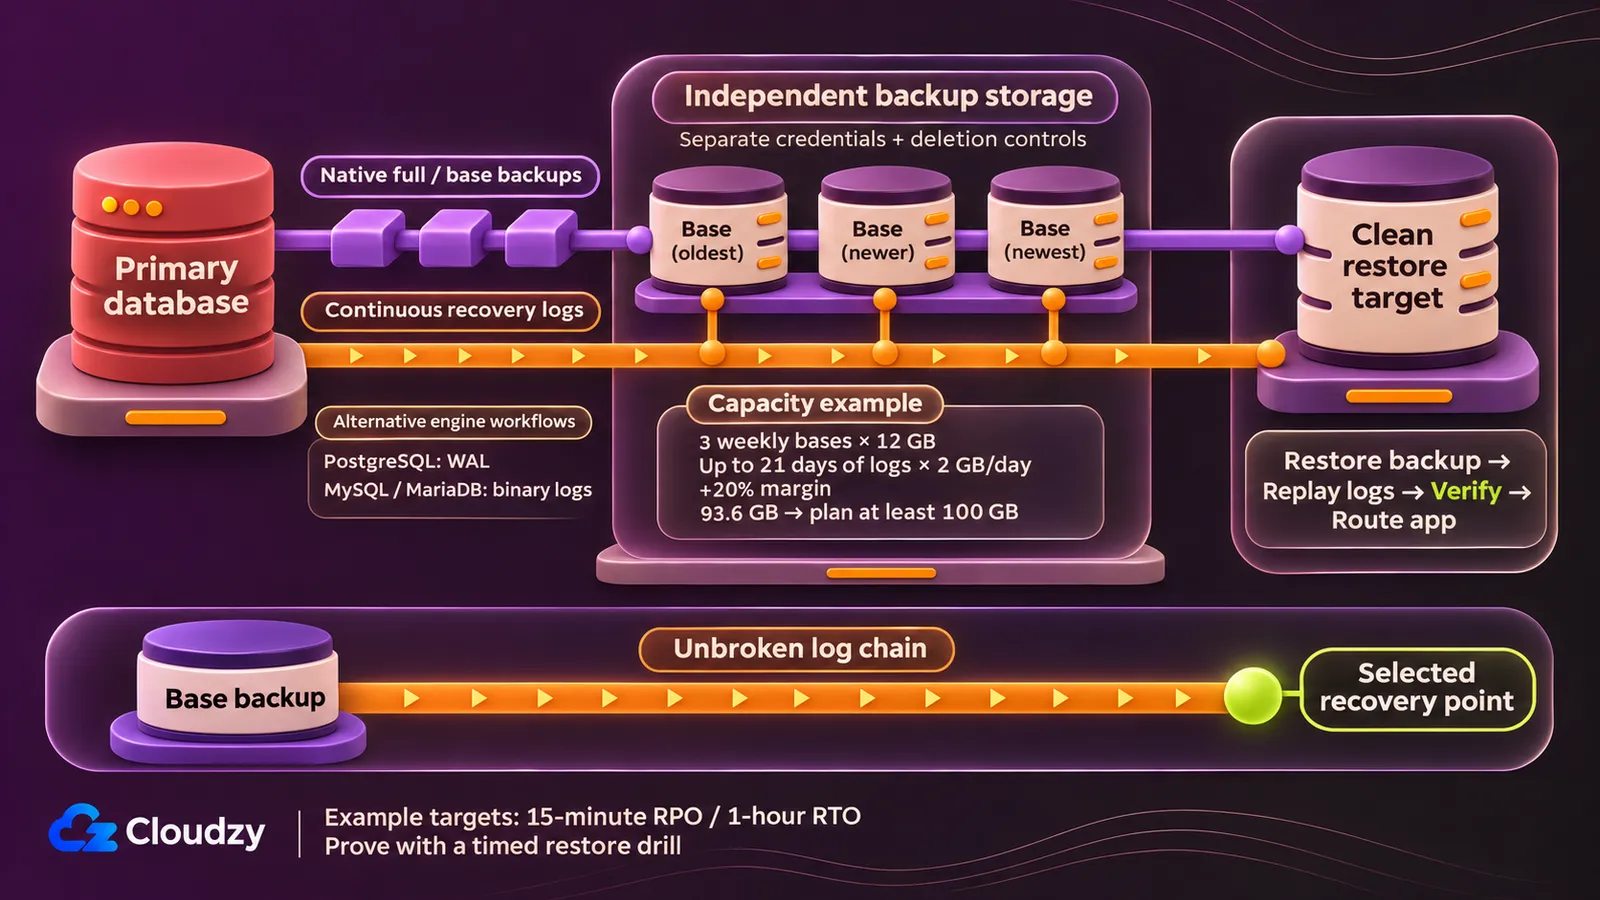
Aceitar perda de 15 minutos e restaurar em uma hora exige mais que o primário. Mantenha as hipóteses SQL separadas e adicione backups nativos, logs retidos, armazenamento independente e exercício cronometrado. São metas de planejamento: apenas o exercício comprova o atendimento.
A documentação de arquivamento contínuo PostgreSQL descreve backup base e WAL ininterrupto para recuperação pontual. A documentação de recuperação MySQL Oracle usa backup completo e logs binários. O procedimento PITR MariaDB restaura dados completos/incrementais antes de reaplicar logs binários. Ative logging binário para esses fluxos MySQL/MariaDB.
Exemplo: cada backup completo/base sem compressão ocupa 12 GB. Retenha três bases semanais e logs contínuos desde o começo da mais antiga. Planeje até 21 dias a 2 GB diários com margem de 20%:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
Planeje ao menos 100 GB independentes sem presumir compressão. Vincule exclusão de logs à expiração e substituição bem-sucedida dos backups. Verifique cadeia completa para cada ponto de recuperação prometido.
Use backups em destino independente com credenciais e controles de exclusão separados do primário. Snapshot do provedor não prova a cadeia nativa. O exercício deve provisionar destino limpo, transferir/restaurar, reaplicar logs, conferir consistência banco/aplicativo e redirecionar o aplicativo. Cronometre provisionamento e transferência também.
Interrupção menor pode exigir réplica independente para a carga inteira. Calcule CPU, RAM e disco separados e defina promoção, isolamento do primário antigo e roteamento. Ensaie. Replicação não substitui backup; um VPS não é alta disponibilidade. Reveja se restauração passa de uma hora, atraso do arquivo supera RPO, standby não suporta carga ou backups chegam ao limite.
Quando escolher um VPS gerenciado
Se ninguém responde a alertas ou restaura durante incidentes, compre cobertura operacional definida. VPS gerenciado pode transferir manutenção, mas o contrato deve nomear as tarefas do banco. Painel não comprova cobertura; VPS gerenciado difere de banco gerenciado.
A diferença entre responsabilidades de VPS gerenciado e não gerenciado ajuda por tarefa. Use como lista de compra, não promessa de serviços iguais. Infraestrutura física continua com o provedor; software convidado e operação do banco precisam de responsável explícito.
| Trabalho | VPS não gerenciado | Cobertura a definir antes de contratar gestão |
|---|---|---|
| Patches e upgrades do SO convidado e banco | Você agenda e executa | Versões suportadas, escopo dos patches, testes de upgrade e janelas de manutenção |
| Ajuste de consultas, esquema e índices | Você diagnostica e altera | Se incluído, limitado à configuração do serviço ou cobrado à parte |
| Monitoramento e incidentes | Você configura alertas e responde | Horários, responsáveis por resposta/escalonamento e quem age após alerta |
| Backups e restaurações | Você responde pelo procedimento de recuperação | Retenção, armazenamento independente, assistência e provas de testes |
Pergunta contratual útil: ‘Se faltar disco durante um backup, quem diagnostica, restaura o serviço e verifica o próximo backup?’ Distingue acesso ao suporte de responsabilidade pelo resultado. Pergunte também sobre upgrade malsucedido e exclusão acidental.
Bancos gerenciados têm acordos próprios de ciclo do motor, backups e failover. Podem ser melhores se você quer transferir recuperação e upgrades. Não infira ajuste de aplicativo do nome; consultas e comportamento ainda precisam de responsável salvo disposição contrária.
Atribua cada tarefa uma vez, com escalonamento e teste de aceitação. Compare preço com seu tempo e disponibilidade. Não há valor horário universal da autogestão, e computação barata não resolve incidente sem dono.
Escolha VPS para cargas não SQL
Os exemplos separam memória, documentos e indexação de busca. Aproxime o aplicativo e teste conexões e transferências para backups e réplicas quando usados.
| Carga e hipóteses | Configuração inicial para testar | Armazenamento, recuperação e motivos de mudança |
|---|---|---|
| Redis cache/chave-valor; conjunto medido de 2 GB | 2 vCPUs dedicadas, 8 GB RAM; ajuste maxmemory abaixo da RAM do host com reserva para sobrecarga |
Cache reconstruível aceita perda. Primário persistente exige RDB/AOF deliberados, espaço de reescrita e backups independentes. Meça RAM/RSS, fragmentação, expulsões, picos de persistência e latência de cauda. |
| MongoDB; documentos/índices de 20 GB e pequeno conjunto quente medido | 2–4 vCPUs dedicadas, 16 GB RAM, disco local classe 100 GB | Preveja journal/oplog, crescimento e temporários. Teste restauração; observe expulsões, E/S e atraso de replicação. Calcule cada réplica conforme seu papel. |
| Elasticsearch; índice pequeno de 30 GB | 4 vCPUs dedicadas, 16 GB RAM, disco local classe 150 GB por nó de dados relevante | Preveja réplicas, fusões de segmentos, retenção e snapshots independentes. Verifique heap/GC, latência de busca/indexação, E/S de fusão e disco. Resiliência exige topologia de votação e roteamento adequados. |
A orientação administrativa Redis avisa que salvar RDB ou reescrever AOF sob muita gravação pode usar o dobro da RAM normal conforme páginas alteradas. Os 2 GB não podem consumir toda a memória. A documentação de persistência distingue snapshots RDB periódicos de log AOF. Escolha pela perda aceita e meça picos RAM/disco durante execução.
A documentação do cache WiredTiger MongoDB descreve caches interno e de arquivos. O padrão é o maior entre 50% × (RAM − 1 GB) e 0,256 GB. A orientação de replica sets recomenda três membros com dados. Árbitro vota, mas não guarda dados. Reserve backups independentes e implemente autenticação MongoDB antes de conectar o aplicativo.
A documentação de ajustes JVM Elastic recomenda heap automático. Manualmente, iguale mínimo/máximo e não ultrapasse 50% da RAM disponível. A orientação de resiliência de clusters pequenos descreve dois nós de dados elegíveis a mestre e desempate somente votante. Configure réplicas e clientes nos nós de dados; desempate acrescenta voto, não cópia. Se fusões/retenção esgotam reserva, reveja disco antes de inserir documentos.
Compare planos não gerenciados para sua configuração
Para SQL transacional separado, filtre mínimo de 2 vCPUs dedicadas, RAM classe 16 GB e disco local classe 50 GB. Passar só torna candidato a testes. Pacotes, unidades e compromissos diferentes impedem equivalência de hardware ou ranking de desempenho.
Referência: Linux autogerenciado na Alemanha ou Europa central próxima, poucos dados e mais RAM. Proximidade não garante mesma latência. Caminho privado quando suportado; preços mantêm IPv4 pública padrão. Suponha transferência abaixo de todas as franquias.
| Provedor e plano não gerenciado | vCPUs dedicadas / RAM / disco local | Local e franquia de transferência | Preço, cobrança e IPv4 |
|---|---|---|---|
| Cloudzy: nosso Regular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | Locais em várias regiões do mundo; 10 TB | US$ 49,98/mês; IPv4 e IPv6 incluídos |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1; ao menos 20 TB na UE | Teto € 86,49/mês, incluindo € 0,50 de IPv4 primário, sem IVA |
| DigitalOcean Memory-Optimized Droplet em pacote, CPU Regular, SSD 1× | 2 / 16 GiB / 50 GiB NVMe | Família disponível em FRA1; 4.000 GiB | Teto US$ 84/mês; US$ 0,125/hora; IPv4 público incluído |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2 núcleos/16 GB/100 GB | 2 / 16.384 MB / 100 GB NVMe | Frankfurt (fra); 6.144 GB |
US$ 80/mês; US$ 0,11/hora; IPv4 padrão; confirme taxa separada ou desconto sem IPv4 antes do orçamento |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16.384 MB / SSD 327.680 MB (classe 320 GB) | Frankfurt (de-fra-2) listado disponível; 6.000 GB |
US$ 173/mês; US$ 0,2595/hora; IPv4 público padrão sem acréscimo |
A seleção de planos DigitalOcean inclui Memory-Optimized para SQL/NoSQL e caches. Recomendo esse pacote para pouco disco e muita RAM. VPS otimizado para memória não é exclusivo SQL. Se medições apontarem capacidade ou demanda sustentada de disco como limite, avalie Storage-Optimized separadamente.
Os cinco atendem ao mínimo com reservas diferentes de CPU/disco. Podem permitir crescimento, mas não provam vantagem de velocidade sem testes. Catálogo Hetzner não garante estoque. Akamai documenta SSD para G7 Dedicated. Optimized Memory Vultr difere de High Frequency Compute compartilhado.
Nossa alocação dedicada atende à configuração autogerenciada no preço mostrado. Compare recursos, moedas, compromisso de cobrança e IPv4 antes de julgar o valor total.
Custo total: computação + endereço + armazenamento/solicitações/transferência de backups independentes + capacidade de teste + standby opcional. Taxas desconhecidas não são zero. Obtenha preços atuais de recuperação e confira plano, local e upgrades antes do compromisso. Não deduza fatura anual multiplicando equivalente mensal arredondado.
Escolhido o motor SQL compatível, nossos aplicativos de um clique encurtam a instalação. PostgreSQL, MySQL e MariaDB são escolhas separadas; uma não instala as três. Patches, ajustes e recuperação continuam sob sua gestão.
Perguntas Frequentes
A taxa de acerto do cache PostgreSQL revela armazenamento lento?
Não. A documentação de estatísticas de E/S PostgreSQL explica que o cache SO pode atender leitura sem chegar ao disco. Combine acertos com E/S do SO e tempos de consulta. A taxa sozinha não distingue atraso físico de leituras na memória do kernel.
Dump lógico PostgreSQL serve para recuperação pontual baseada em WAL?
Não. Os requisitos de arquivamento contínuo PostgreSQL dizem que dumps lógicos não contêm informações para reaplicar WAL. Restauram o estado capturado; recuperação WAL requer base adequada e WAL contínuo arquivado. Escolha o formato segundo o método de recuperação.
O cache MongoDB deve usar RAM do host em um contêiner?
Use a memória disponível ao contêiner. A orientação de memória em contêineres MongoDB alerta que WiredTiger pode ignorar um limite menor em certos casos. Mantenha cache abaixo dele com espaço para outros processos; a RAM total do host pode superestimar o disponível.
Discussão
Comentários
Inicie sessão para participar na discussão.