

Ce que vous avez construit tourne en production. Votre supervision se résume à rien du tout ou à un simple ping de disponibilité, et la semaine dernière c'est un utilisateur qui vous a appris qu'il y avait une panne. Toutes les réponses que vous cherchez pointent vers le même nom.
Ce test de Prometheus porte sur l'écart entre deux choses également vraies. C'est gratuit et open source, sans licence ni facture à la métrique, quelle que soit l'échelle. Cela vous coûte aussi une soirée, plus un langage de requête que vous ne connaissez pas encore. C'est un collecteur de métriques en mode pull avec de l'alerting intégré, et c'est un excellent logiciel. Savoir si c'est le bon logiciel pour l'installation que vous faites tourner en ce moment est une autre question, et c'est celle qui mérite une réponse.
La version courte
- Verdict : 3,5 / 5 pour l'auto-hébergement en solo ou en petite équipe. Prometheus vaut la peine d'être déployé si votre ensemble d'hôtes et de services est raisonnablement stable, si vous prendrez le temps d'apprendre PromQL, et si vous voulez des métriques qui vous appartiennent vraiment, sans abonnement ni facture de rétention.
- Passez votre chemin si la seule question qui vous intéresse est « est-ce que c'est en ligne ? ». Un moniteur de disponibilité vous y amène bien plus vite, et mobiliser Prometheus pour ce travail revient à payer un langage de requête pour répondre à une question que vous auriez pu régler en dix minutes.
- PromQL est le coût qui revient sans cesse. L'installation est un coût unique. Dès que vos questions dépassent les tableaux de bord tout faits et le constructeur visuel de Grafana, vous revenez à PromQL.
- Le coût de maintenance suit la part de l'installation que vous gérez à la main. Un parc qui garde sa forme coûte peu à superviser. Un parc qui gagne, perd et renomme des hôtes, c'est là que le coût s'accumule discrètement.
- Ce verdict ne vaut que pour l'auto-hébergement à petite échelle. À l'échelle de Kubernetes et du SRE en production, Prometheus est une tout autre proposition, et ce test n'essaie pas de répondre à cette question-là.
Comment ce test a été mené : Prometheus est gratuit et open source : il n'y a donc aucune relation commerciale ici et personne ne m'a rien envoyé. Les informations sur les versions et le comportement du stockage viennent de la documentation officielle de Prometheus. Les chiffres de consommation et les temps d'installation viennent de deux tests pratiques publiés indépendamment, crédités à l'endroit où chacun est utilisé. Là où ces deux tests divergent, vous verrez les deux chiffres plutôt qu'une moyenne.
Ce que couvre ce test
Le verdict ci-dessus a des limites, et ces limites comptent plus que d'habitude ici, parce que Prometheus se comporte comme un outil différent selon l'échelle.
- Prometheus évalué pour l'auto-hébergement sur un seul VPS et pour de petits projets : une poignée d'hôtes et de services, une seule personne pour s'en occuper.
- Pas Kubernetes. Prometheus Operator, les ServiceMonitors et le kube-prometheus-stack forment un monde opérationnel à part, et le verdict rendu ici ne dit rien de celui-là.
- Pas un guide de routage Alertmanager. L'alerting existe et fonctionne ; configurer les routes, les silences et les récepteurs est un sujet à part entière.
- Pas un tutoriel d'installation. La question ici est de savoir s'il faut le faire tourner, tout court. Si vous avez déjà tranché celle-là, notre guide Grafana et Prometheus avec Docker Compose détaille les étapes.
- Pas un panorama des exporters. Les exporters n'apparaissent que là où ils changent la réponse.
Ce que Prometheus réussit
Prometheus ne coûte rien. Pas « offre gratuite avec options payantes », pas « gratuit jusqu'à une limite de métriques ». Le dépôt est sous licence Apache 2.0 de bout en bout, il n'y a pas d'édition payante du projet principal, et il n'y a aucune facturation par hôte, par métrique ou par label nulle part. La seule facture que Prometheus génère, c'est le serveur sur lequel il tourne.
Pour quelque chose dont vous comptez dépendre, « est-ce que ce sera encore là dans trois ans ? » est une question légitime, et ici les chances sont à peu près aussi bonnes que l'open source le permet. Prometheus est devenu projet diplômé de la CNCF en août 2018, le deuxième projet à y parvenir, après Kubernetes. Les versions sortent régulièrement, avec la v3.13.2 publiée fin juillet 2026, et comme cette branche est une branche à support long terme, elle reçoit des correctifs de bugs, de sécurité et de documentation pendant un an : rester à jour ne veut donc pas dire courir après chaque version mineure.
Le modèle de données explique pourquoi l'écosystème qui l'entoure est aussi profond. Prometheus collecte les métriques via HTTP et identifie chaque série par un nom de métrique plus des labels clé/valeur, ce qui fait qu'écrire un exporter est un petit travail. Il existe donc des exporters pour à peu près tout ce que vous pourriez faire tourner : métriques système, Postgres, Nginx, Redis, sondes blackbox pour les choses que vous ne pouvez tester que de l'extérieur.
Et vous êtes propriétaire de ce qu'il collecte, ce qui est la partie qui compte plus tard plutôt qu'au premier jour. L'historique d'une petite installation prend une quantité de disque insignifiante (les chiffres sont plus bas), personne ne peut en changer le tarif au trimestre prochain, et il n'y a pas de ligne de facture qui grossit chaque fois que quelqu'un ajoute de l'instrumentation à une application. Si vous avez déjà vu une facture de supervision managée grimper parce qu'un développeur a ajouté un label, tout l'argument tient dans cette phrase.
Là où Prometheus vous coûte plus qu'il n'y paraît
Un test dev.to portant sur sept outils de supervision sur un petit VPS a mesuré 15 minutes d'installation pour Prometheus seul. Associez-le à Grafana, comme l'a fait ce testeur, parce que le navigateur d'expressions intégré n'est qu'un endroit où exécuter des requêtes. Le même test place Grafana + Prometheus à 35 minutes avant le premier graphique, avec de la configuration YAML de collecte au milieu.
Les minutes sont la partie bon marché. PromQL est la partie chère. Prometheus stocke tout sous forme de séries temporelles identifiées par un nom et des labels, et PromQL reste le langage sous-jacent aux questions que vous lui posez. Grafana dispose maintenant d'un constructeur visuel, vous n'avez donc pas à écrire chaque requête à la main. Le verdict du testeur était direct : PromQL est formidable quand on vit dedans, et ce n'était pas son cas. Si vous n'avez jamais utilisé de langage de requête, prévoyez plus d'une soirée, et attendez-vous à y revenir dès que le constructeur visuel ne suffira plus. Un tableau de bord copié chez quelqu'un d'autre répond à ses questions. Les vôtres sont une requête que vous n'avez pas encore écrite.
Le troisième coût est celui qui n'apparaît que plus tard. Le compte rendu de trois semaines d'un opérateur décrit exactement ce qu'a impliqué l'ajout d'un seul serveur à une installation de sept nœuds : réétiqueter, revérifier les configurations de collecte, modifier les variables des tableaux de bord et retravailler les requêtes des modèles pour que le nouvel hôte apparaisse dans les menus déroulants. Cet opérateur a abandonné la stack au bout de trois semaines, ayant conclu qu'il passait plus de temps à régler ses tableaux de bord qu'à surveiller son infrastructure.
Remarquez à quoi ce coût est lié dans ce genre d'installation : des cibles et des tableaux de bord gérés à la main. Faire tourner Prometheus pendant deux années calmes ne vous coûte presque rien de plus.
De combien de RAM et de disque Prometheus a-t-il vraiment besoin ?
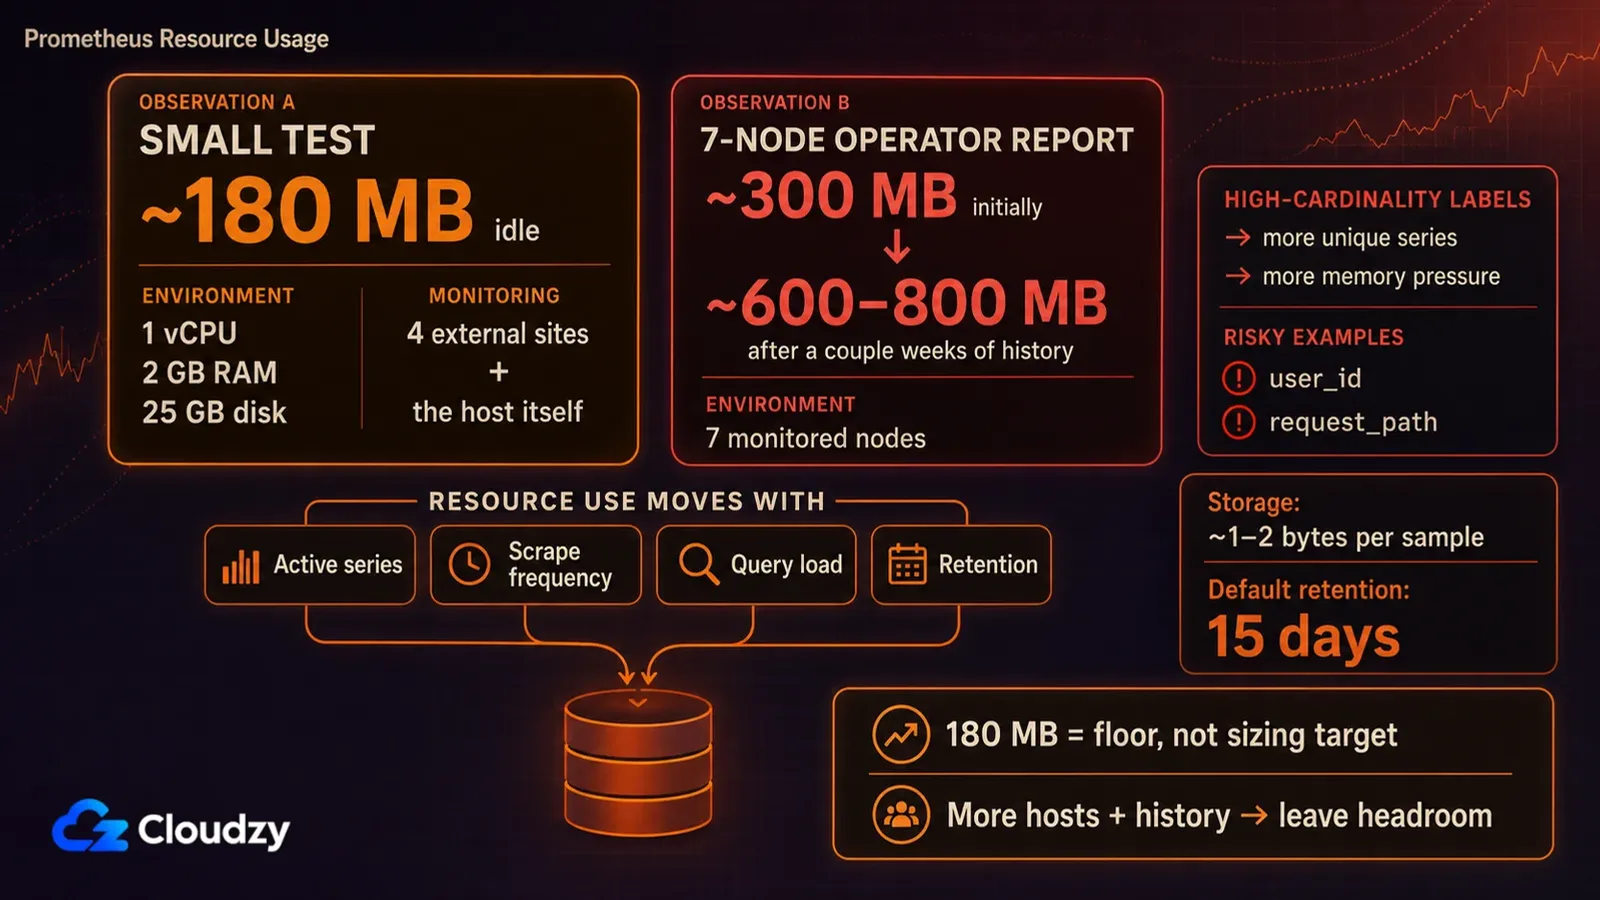
Il n'y a pas de prérequis fixe. Les séries actives, la fréquence de collecte, la charge de requêtes et la rétention comptent davantage que le nombre brut de serveurs que vous lui faites surveiller. Deux tests pratiques publiés sur de petites installations le situent entre 180 Mo et 800 Mo environ, le chiffre le plus élevé couvrant sept nœuds avec quelques semaines d'historique.
Les deux tests divergent, et c'est justement ce désaccord qui est utile. La même comparaison de sept outils sur VPS a fait tourner chaque outil sur un matériel identique (1 vCPU, 2 Go de RAM, 25 Go de disque, Ubuntu 24.04) en surveillant quatre sites externes plus l'hôte lui-même, et a mesuré Prometheus à environ 180 Mo au repos. Le même opérateur a rapporté que Prometheus seul tournait autour de 300 Mo au repos sur l'hôte central, montant vers 600 à 800 Mo une fois quelques semaines d'historique accumulées.
Ce ne sont pas les mêmes mesures, et c'est pourquoi en faire la moyenne reviendrait à jeter l'information. L'une est un relevé quasi au repos sur une machine qui a très peu à stocker. L'autre est un déploiement en fonctionnement, avec un parc derrière et de l'historique sur disque. Ma lecture : traitez le résultat de 180 Mo comme un plancher, pas comme une cible de dimensionnement. Dès que vous collectez depuis plusieurs hôtes et que vous conservez de l'historique, prévoyez de la marge au lieu de dimensionner sur ce chiffre au repos.
Le disque est la moitié facile. La documentation de stockage de Prometheus l'établit à une moyenne de 1 à 2 octets par échantillon : conserver un long historique pour une petite installation coûte donc peu. Le piège est la valeur par défaut : la rétention est fixée à 15 jours par défaut sauf si vous définissez une durée ou une taille de rétention. Un seul drapeau de démarrage sépare cela d'une année entière, et c'est le genre de valeur par défaut que vous préférez découvrir maintenant plutôt que la première fois où vous cherchez les chiffres du mois dernier et constatez qu'ils ont expiré il y a trois semaines.
Ce qui fait grimper le chiffre de la mémoire, c'est la cardinalité : le nombre de séries temporelles distinctes, où chaque combinaison unique de labels sur une métrique devient sa propre série. Un seul label mal choisi sur une métrique à fort trafic peut créer plus de séries que cinq serveurs supplémentaires, et il le fait silencieusement, au rythme de votre trafic. (Un identifiant d'utilisateur ou un chemin de requête a l'air d'un excellent label, jusqu'au moment où vous comptez combien il y en a.)
Tout chiffre de RAM cité pour Prometheus n'est exploitable que si vous savez aussi combien de séries se trouvaient derrière.
Que se passe-t-il quand votre serveur Prometheus tombe ?
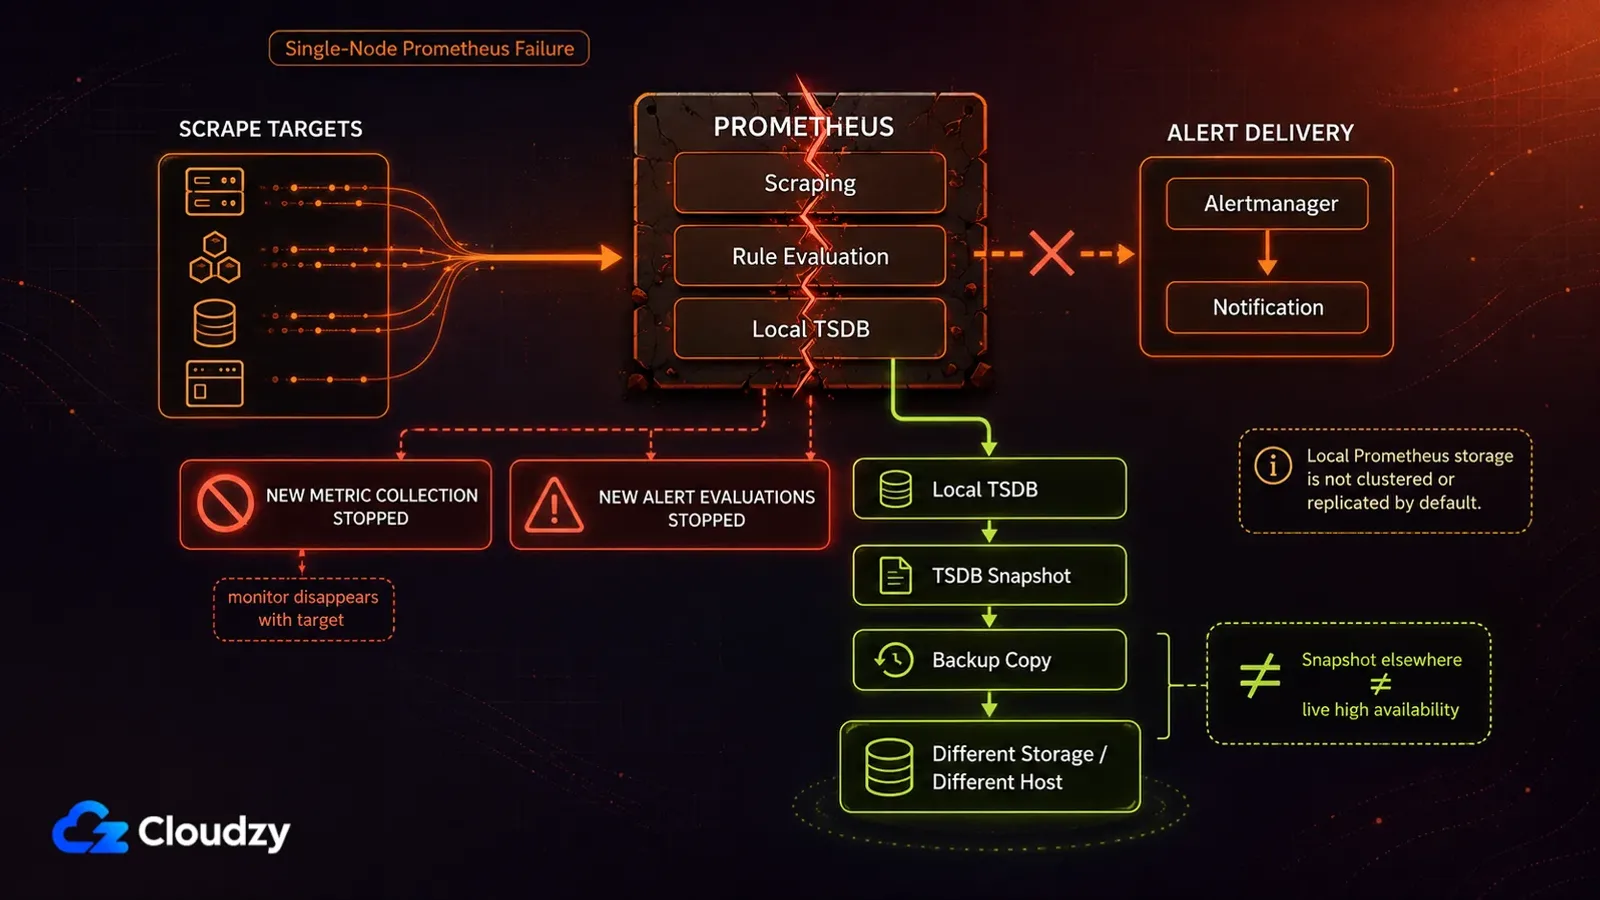
La documentation de stockage de Prometheus est directe sur ce point : le stockage local n'est ni en cluster ni répliqué, il n'est donc pas durable face à une panne de disque ou de nœud. Chaque serveur est autonome par conception et ne dépend d'aucun stockage réseau ni d'aucun service distant, ce qui est précisément ce qui le rend facile à exploiter et précisément ce qui le laisse exposé.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Il y a une seconde limite que le projet énonce à son propre sujet, et il mérite d'être salué pour cela : si vous avez besoin d'une exactitude à 100 %, par exemple pour une facturation à la requête, la documentation dit que Prometheus est le mauvais choix, parce que les données qu'il collecte ne seront probablement pas assez détaillées ni assez complètes. Utilisez autre chose pour les chiffres que vous facturez et gardez Prometheus pour la supervision. Les éditeurs ne disent pas souvent ce genre de chose sur eux-mêmes.
Il existe des réponses établies à cela à plus grande échelle, et elles sortent du cadre ici pour la même raison que l'outillage Kubernetes : un engagement opérationnel différent de celui que couvre ce test. Pour un VPS unique, ma lecture est que le risque est acceptable si vous gardez des instantanés TSDB ailleurs ou si vous acceptez d'emblée de perdre l'historique, et que c'est un vrai problème si Prometheus est la seule chose qui vous sépare d'une panne silencieuse.
Qui devrait auto-héberger Prometheus ?
Le signal le plus clair que Prometheus remboursera ce qu'il coûte n'a rien à voir avec le nombre de serveurs que vous avez. C'est de savoir si ce seront les mêmes serveurs dans six mois. Un ensemble stable d'hôtes configurés à la main signifie que vous écrivez la configuration une fois et que vous collectez de l'historique gratuitement ; un ensemble qui change sans arrêt signifie que vous retouchez cette configuration sans arrêt.
Dans une installation statique, votre configuration Prometheus et Grafana est une description explicite de votre infrastructure : les cibles de collecte, les labels qui leur sont attachés, et les tableaux de bord construits sur ces labels. C'est pour cela que l'historique est tout le bénéfice. Une année de données sur un ensemble stable d'hôtes vous dit à quoi ressemble le normal, ce qui est la manière la plus fiable de reconnaître l'anormal avant qu'il ne devienne une panne.
Le premier profil est donc quelqu'un qui gère un petit ensemble de serveurs qui évolue lentement et qui veut plus qu'un simple « en ligne ou pas » : la latence des requêtes dans le temps, les tendances mémoire, un disque qui se remplit assez progressivement pour que vous le voyiez venir des semaines à l'avance. Si vous pouvez décrire votre infrastructure aujourd'hui et vous attendre à ce que cette description soit encore à peu près vraie dans un an, la soirée passée à l'installation est la dernière grosse facture.
Le deuxième, c'est toute personne qui apprend cette stack délibérément. Si vous comptez gérer de l'infrastructure dans quelques années, la vôtre ou celle de quelqu'un d'autre, la soirée PromQL est ce pour quoi vous êtes venu et la supervision est un effet secondaire. Ce profil inverse en partie le premier : le test de stabilité compte moins ici, parce que le temps passé à réétiqueter est aussi du temps passé à apprendre ce qu'est le réétiquetage. Pour ce lecteur, je remonterais la note.
Le troisième profil concerne la propriété, et c'est celui que l'on sous-estime tant qu'on ne s'est pas retrouvé du mauvais côté. Prometheus ne facture ni par hôte, ni par métrique, ni par label, et aucune page de tarifs ne peut changer sous vos pieds au trimestre prochain. L'échange face à un service managé comme Datadog : vous renoncez au vernis, au contrat de support et à l'astreinte de quelqu'un d'autre, et en échange vous obtenez des métriques qui vous appartiennent, sur une facture qui ne bouge pas quand un développeur ajoute de l'instrumentation. Savoir si c'est un bon échange dépend de ce que valent vos propres heures, un chiffre que vous seul pouvez fournir (et il est rarement nul, même quand on a l'impression du contraire).
Une chose à savoir avant de vous engager : dépasser le stockage local de Prometheus n'est pas une impasse. VictoriaMetrics accepte les écritures distantes de Prometheus, et sa MetricsQL est rétrocompatible avec PromQL, donc la plupart des requêtes et des tableaux de bord Grafana que vous construisez aujourd'hui devraient survivre au changement. C'est une migration, pas une réécriture.
À réévaluer une fois par an plutôt qu'à trancher une fois pour toutes : l'installation qui coûte peu à superviser aujourd'hui devient chère le trimestre où vous commencez à la reconstruire.

Développez sur un VPS Linux avec accès root, NVMe et la puissance AMD EPYC.
Voir les plans LinuxQui devrait éviter Prometheus ?
Si la phrase que vous utiliseriez pour décrire votre besoin est « préviens-moi quand le site tombe », vous décrivez un moniteur de disponibilité, et Prometheus représente beaucoup de machinerie pour arriver à cette réponse. Uptime Kuma fait exactement ce travail avec une interface web et ne vous demande pas d'apprendre un langage de requête de supervision. L'écart de capacités entre les deux outils est énorme et totalement hors sujet pour la tâche que vous cherchez à confier.
Le deuxième lecteur est celui qui veut des graphiques utilisables sans apprendre d'abord un langage de requête. Netdata est bâti exactement pour cela : des métriques par hôte que vous pouvez consulter immédiatement, avec beaucoup moins de configuration et rien entre vous et les graphiques. Si la question que vous posez sans cesse est « pourquoi cette machine est-elle lente en ce moment ? », c'est un chemin bien plus court vers une réponse.
Le troisième est toute personne dont l'infrastructure change souvent de forme et qui gère à la main les cibles et les variables de tableau de bord. Des hôtes créés pour une semaine puis détruits, des cibles renommées, des projets renommés en cours de route. C'est le cas où vous payez le coût de configuration encore et encore tout en tirant le moins de bénéfice de ce que vous payez, c'est-à-dire un historique continu d'un système qui reste reconnaissable.
Rien de tout cela n'est un reproche fait à l'outil. « Éviter » signifie ici l'éviter pour ce travail, à cette échelle. À l'échelle de Kubernetes, où la découverte de services prend en charge l'essentiel de ce que vous câbleriez sinon à la main, plusieurs des coûts ci-dessus diminuent ou disparaissent complètement, et ma lecture de cette échelle est que Prometheus y est très difficile à battre. C'est un autre test.

Foire aux questions
Prometheus est-il gratuit ?
Oui, et il n'y a pas de piège d'offre gratuite en dessous. Prometheus est sous licence Apache 2.0 sans édition commerciale derrière : il n'y a donc pas de quota de métriques à franchir ni d'invitation à passer à la version supérieure qui vous attend de l'autre côté. Vous payez l'infrastructure et votre propre temps, pas une licence Prometheus.
Prometheus a-t-il besoin de Grafana ?
Non, mais prévoyez-le. Le navigateur d'expressions de Prometheus existe pour lancer une requête et regarder la réponse, ce qui couvre le fait de vérifier une chose une fois. Tout ce que vous voulez laisser ouvert sur un deuxième écran, c'est le travail de Grafana, et les deux sont presque toujours déployés ensemble.
Prometheus est-il excessif pour un seul serveur ?
Souvent, oui. Si ce dont vous avez besoin est de savoir si le serveur et ses services sont en ligne, un moniteur de disponibilité y répond en une fraction du temps d'installation. Prometheus mérite sa place quand vous voulez des métriques historiques interrogeables, et que vous êtes prêt à apprendre PromQL pour y accéder.
Combien de temps Prometheus conserve-t-il les métriques par défaut ?
15 jours, et il ne vous prévient pas. Prometheus supprime les échantillons plus anciens que la fenêtre de rétention, sauf si vous l'augmentez avec un drapeau de durée ou de taille de rétention au démarrage. Réglez-le le jour de l'installation, car élargir la fenêtre plus tard ne ramènera pas les données déjà expirées.



Discussion
Commentaires
Connectez-vous pour participer à la discussion.