
Immagina due righe in un file crontab: un’esportazione parte alle 01:00 e un caricamento nel data warehouse alle 02:00. L’ora di intervallo è l’unico accorgimento per far partire il caricamento dopo l’esportazione. Se una notte l’esportazione si prolunga o fallisce a metà, il caricamento parte comunque alle 02:00, legge il file del giorno prima e termina senza errori. Se nessuno legge l’e-mail di errore dell’esportazione, nessuno si accorge del problema: per cron entrambi i job sono partiti in orario.
L’automazione dei carichi di lavoro consente al caricamento di attendere il completamento dell’esportazione. Il termine compare soprattutto nei siti dei fornitori e nell’IT aziendale, associato a prodotti come Control-M e AutoSys. Parte del vocabolario è in comune con l’automazione dei flussi di lavoro e con l’automazione robotica dei processi. Per distinguerle, basta guardare cosa esegue ciascuno strumento e come avvia l’esecuzione.
La versione breve
- L’automazione dei carichi di lavoro (WLA) esegue da un punto centrale job IT con dipendenze su più server, come caricamenti di dati, trasferimenti di file e batch ERP. Offre nuovi tentativi, cronologia delle esecuzioni e avvisi di errore.
- Cron avvia un comando al minuto previsto su una sola macchina e ne invia l’output per e-mail. L’ordine dei job, il coordinamento tra host e la cronologia delle esecuzioni sono a carico dell’operatore.
- L’automazione dei flussi di lavoro collega applicazioni in risposta a eventi, con strumenti come n8n o Zapier, oppure inoltra richieste di approvazione. L’automazione robotica dei processi (RPA) usa l’interfaccia di un’applicazione come farebbe una persona. La WLA esegue job sui server che fanno funzionare queste applicazioni.
- Se due esecuzioni cron si sovrappongono, usa un blocco come
flocko modifica il job. La sovrapposizione, da sola, non giustifica l’acquisto di un prodotto WLA.
Che cos’è l’automazione dei carichi di lavoro?
L’automazione dei carichi di lavoro (WLA) usa software per eseguire job IT, come caricamenti notturni di dati, trasferimenti di file e batch ERP, nell’ordine corretto su più macchine e da un punto centrale. Avvia i job secondo un orario o in risposta a un evento, attende che i prerequisiti siano completati con successo, ritenta i job falliti, conserva una cronologia e segnala errori o sforamenti dei tempi.
Per chi pianifica i job, una dipendenza è una condizione sul risultato: avvia il caricamento solo se l’esportazione è riuscita e avvisa chi è di turno in caso di errore. Un intervallo di tempo è solo una stima della durata del primo job. Attorno a questa funzione di base, i prodotti WLA offrono spesso funzionalità simili:
- Dipendenze tra job, con rami da seguire in caso di errore
- Avvio a un orario, secondo un calendario lavorativo (solo giorni lavorativi, festività escluse) o in risposta a un evento, come l’arrivo di un file
- Esecuzione remota tramite agenti installati, connessioni senza agenti o integrazioni con servizi, a seconda del prodotto e della destinazione
- Nuovi tentativi, timeout e arresto dei job bloccati
- Cronologia con job eseguiti, luogo, orario, durata e stato di uscita
- Avvisi in caso di errore, di superamento della durata configurata o di rischio di non rispettare la scadenza prevista da uno SLA
- Recupero delle esecuzioni saltate, per avviare un job previsto mentre l’host era inattivo non appena torna disponibile
IBM descrive IBM Workload Automation come una piattaforma per coordinare job non presidiati e job attivati da eventi in ambienti ibridi. In pratica, un solo sistema avvia i job, senza intervento umano, a un orario o in risposta a un evento, su mainframe, macchine locali e macchine nel cloud. La descrizione rispecchia le funzioni del prodotto, ma il linguaggio rende difficile confrontarle con i job cron che usi già. Anche Control-M di BMC, AutoSys, Redwood RunMyJobs, ActiveBatch, Tidal e JAMS usano questo termine.
Automazione dei carichi di lavoro, cron, automazione dei flussi di lavoro e RPA a confronto
I quattro approcci differiscono per ciò che li avvia, il lavoro che svolgono e dove avviene l’esecuzione. Cron esegue un comando a un dato orario su una macchina. L’automazione dei carichi di lavoro esegue job su più server, in base a orari, eventi o risultati di altri job. L’automazione dei flussi chiama le API delle applicazioni o attende l’intervento di una persona. La RPA combina azioni nell’interfaccia e chiamate API.
| Aspetto | Cron | Automazione dei carichi di lavoro | Automazione dei flussi di lavoro | RPA |
|---|---|---|---|---|
| Cosa avvia l’esecuzione | Un orario | Orari, calendari, eventi e risultati di altri job | Eventi delle applicazioni, invio di moduli e pianificazioni | Una pianificazione, un evento o una persona |
| Unità di lavoro | Un comando | Un job su un host: script, batch, trasferimento o job ERP | Un passaggio che chiama l’API di un’applicazione | Una sequenza registrata di azioni nell’interfaccia e chiamate API |
| Dove viene eseguito | Una macchina | Più host e servizi sotto controllo centralizzato, tramite agenti, connessioni senza agenti o integrazioni | La piattaforma di automazione, che chiama le API dei servizi SaaS | Un ambiente di esecuzione dei bot in una sessione desktop o server |
| Dipendenze ed errori | Nessuna gestione integrata; l’output viene inviato per e-mail | Grafo delle dipendenze, nuovi tentativi, avvisi e cronologia delle esecuzioni | Rami di errore e nuovi tentativi per flusso di lavoro | Gestione delle eccezioni per singolo bot |
| Esempi di strumenti | cron | Control-M, AutoSys, IBM Workload Automation; per job simili: Rundeck, Dagu e Kestra | n8n e Zapier; suite BPM per le approvazioni | UiPath, Automation Anywhere |
Cron è uno strumento di automazione dei carichi di lavoro?
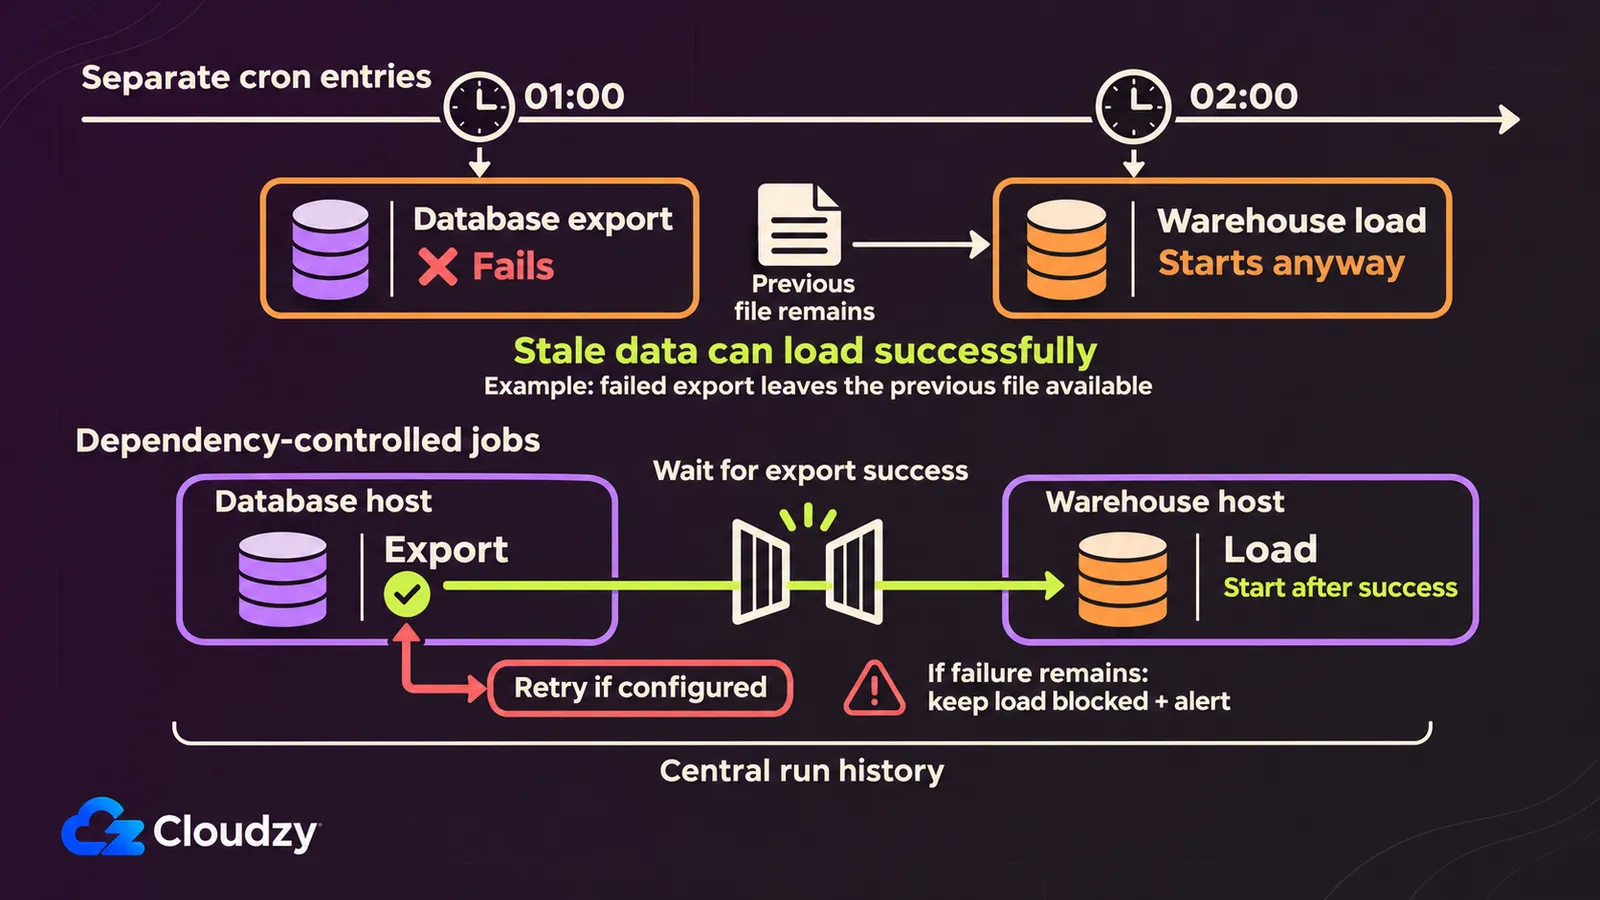
No. Cron pianifica job in base all’orario su una sola macchina. Secondo la pagina di manuale di cron(8), ogni minuto cron verifica quali job deve avviare e ne invia l’output per e-mail al proprietario del crontab. L’operatore deve gestire l’ordine dei job, il coordinamento tra host, la cronologia e gli avvisi.
La pagina di crontab(5) aggiunge che MAILTO="" disattiva l’invio delle e-mail anche quando un job fallisce. Ecco un’esportazione alle 01:00 e un caricamento alle 02:00, seguiti dal consueto espediente:
# BEFORE: illustration only; do not install these commented entries.
# 0 1 * * * /opt/jobs/export-orders.sh
# 0 2 * * * /opt/jobs/load-warehouse.sh

# AFTER: replace both old entries with this single entry.
# The load runs only if the export exits successfully.
0 1 * * * /opt/jobs/export-orders.sh && /opt/jobs/load-warehouse.sh
La riga con && sembra una dipendenza, ma riguarda un solo host e un codice di uscita. Restano cinque limiti. Fuori da quella riga manca una regola che esegua un job dopo il successo di X o avvii Y se X fallisce. Non c’è coordinamento tra host, perciò il caricamento sul server del data warehouse non può aspettare l’esportazione sul server del database. La cronologia si limita ai log di ogni script. L’unico avviso è l’output inviato per e-mail, che può rimanere non letto. Inoltre cron(8) non recupera una voce se il minuto previsto è passato mentre l’host era spento. Il manuale spiega che i job di sistema giornalieri, settimanali e mensili che un tempo erano in /etc/crontab ora vengono eseguiti per impostazione predefinita da anacron, uno strumento separato. File di segnalazione, script wrapper e catene con && aggirano questi limiti.
BMC presenta la distinzione dal punto di vista del fornitore nel suo approfondimento sulla pianificazione dei job e sulla WLA. La pianificazione esegue job batch su una piattaforma, mentre l’automazione dei carichi di lavoro coordina job dipendenti su più server e ambienti da un punto centrale. BMC cita l’Utilità di pianificazione di Windows come esempio degli strumenti inclusi nei principali sistemi operativi. Cron svolge un ruolo analogo in Linux e Unix. La differenza è l’ambito: una sola piattaforma o più piattaforme collegate da dipendenze.
Funzionalità della WLA già disponibili senza uno strumento dedicato
Tre strumenti comuni coprono parte delle funzioni della WLA. Un timer di calendario di systemd (OnCalendar=) con Persistent=true recupera un’esecuzione saltata a macchina spenta. Un CronJob di Kubernetes con concurrencyPolicy: Forbid salta un’esecuzione se la precedente è ancora in corso. flock impedisce la sovrapposizione di due istanze dello stesso job cron. In nessun caso serve un prodotto WLA.
Il manuale di systemd.timer dice che Persistent=true registra su disco l’orario dell’ultima attivazione. L’unità di servizio parte subito se avrebbe dovuto attivarsi almeno una volta mentre il timer era inattivo. Su quell’host ottieni un’unica attivazione di recupero per le esecuzioni di calendario saltate, al costo di due file di unità al posto di una riga di crontab. Un confronto tra cron e i timer di systemd mostra a cosa serve la configurazione aggiuntiva.
La documentazione dei CronJob di Kubernetes indica che Allow è il valore predefinito di concurrencyPolicy e permette l’esecuzione di entrambe le istanze. Forbid salta la nuova esecuzione, mentre Replace sostituisce il job in corso con quello nuovo. Fuori da Kubernetes, flock(1) gestisce i blocchi negli script di shell e mantiene il blocco finché il comando è in esecuzione. Con -n la seconda istanza fallisce invece di aspettare, quindi */5 * * * * flock -n /tmp/sync.lock /opt/jobs/sync.sh impedisce a due sincronizzazioni di sovrapporsi.
Per evitare sovrapposizioni e accumuli, usa un blocco o intervieni sul job. Cambiare sistema di pianificazione non risolve il problema. Se un job che parte ogni cinque minuti a volte ne impiega dieci, gli serve il doppio del tempo previsto. Il blocco evita l’accumulo. Per il resto, accelera il job, assegnagli più risorse o eseguilo meno spesso. Un prodotto WLA cambia il punto in cui viene segnalato lo sforamento, ma non lo elimina. In una discussione su r/sysadmin sui job cron che si sovrappongono, la risposta più votata suggerisce di controllare il blocco, flock viene citato più volte e una risposta riassume il compito di cron: «Cron esegue comandi. Lo fa molto bene».
Nessuno dei tre strumenti offre un grafo di dipendenze tra host o una cronologia centralizzata delle esecuzioni. Queste due funzioni possono giustificare il costo di uno strumento WLA.
Come si distingue l’automazione dei carichi di lavoro dall’automazione dei flussi di lavoro
La differenza sta in cosa viene eseguito e dove, a prescindere dalla partecipazione umana. La prima esegue script, caricamenti di dati e trasferimenti di file sui server. La seconda concatena le API delle applicazioni, ad esempio con un flusso n8n o Zapier che crea un record CRM a partire da un modulo, o inoltra approvazioni tramite uno strumento di gestione dei processi aziendali (BPM).
La parola ricorre in tre contesti. Il primo è la stessa automazione dei carichi di lavoro. Il secondo è l’automazione basata sulle integrazioni. La documentazione di n8n descrive n8n come uno strumento per automatizzare i flussi di lavoro, con licenza fair-code, che combina funzioni di IA e automazione dei processi aziendali. n8n e le altre alternative a Zapier con self-hosting collegano un evento in un’applicazione alle chiamate ad altre applicazioni. Il terzo contesto è il BPM, dove moduli e catene di approvazione trattengono ogni passaggio fino all’intervento di qualcuno.
Stonebranch, un fornitore di soluzioni WLA, distingue in base alla partecipazione delle persone. In un confronto del 2022 afferma che i passaggi dei flussi automatizzati in genere coinvolgono più persone, ad esempio in un’approvazione, mentre i job WLA di solito non richiedono queste interazioni. Il criterio funziona per il BPM. Anche un flusso n8n che copia ordini in un foglio di calcolo funziona senza intervento umano. Con lo stesso criterio rientrerebbe nella categoria di un batch su mainframe. Per questo la distinzione qui dipende dal lavoro: job sull’infrastruttura, chiamate tra applicazioni o passaggi che attendono l’intervento di una persona.
L’espressione «flusso di lavoro» non basta a distinguere le soluzioni. BMC presenta Control-M come mezzo per «orchestrare flussi di lavoro essenziali per l’attività aziendale» su mainframe e in ambienti cloud, distribuiti e SaaS. La documentazione di Apache Airflow descrive Airflow come piattaforma per sviluppare, pianificare e monitorare flussi di lavoro.
Gli strumenti condividono alcuni meccanismi di avvio. I flussi n8n possono partire a orari prestabiliti: un sistema di pubblicazione sui social con self-hosting usa uno Schedule Trigger alcune volte al giorno. I sistemi di pianificazione dei carichi di lavoro possono anche avviare job in risposta a eventi come l’arrivo di un file.
Come si distingue l’automazione dei carichi di lavoro dalla RPA
L’automazione dei carichi di lavoro esegue job sui server, dietro l’interfaccia delle applicazioni. L’automazione robotica dei processi (RPA) agisce nell’interfaccia: i bot fanno clic, digitano e copiano valori come una persona. La RPA può anche chiamare API. A caratterizzarla è la capacità di usare l’interfaccia utente.
La spiegazione della RPA di IBM considera entrambe le funzioni: la RPA unisce API e interazioni con le interfacce utente per integrare applicazioni aziendali e di produttività ed eseguire attività ripetitive. UiPath, che vende soluzioni RPA, pone l’accento sullo schermo e descrive bot che interagiscono con schermi e sistemi «imitando le azioni umane». Stonebranch traccia la distinzione dal punto di vista della WLA: la WLA gestisce processi di back-end e flussi di dati, mentre la RPA automatizza in genere attività umane svolte nell’interfaccia. Se un’applicazione offre una API o un’interfaccia batch, un job pianificato può chiamarla direttamente. La RPA diventa utile se lo schermo è l’unico modo per operare sul sistema.
A cosa servono Airflow, Rundeck, Kestra e Dagu
Diversi strumenti open source svolgono funzioni di WLA senza usare questo termine. Eseguono job pianificati e con dipendenze, con nuovi tentativi e cronologia. Si presentano come orchestratori, strumenti di automazione dei runbook o motori di flussi di lavoro. Apache Airflow si concentra sulle pipeline di dati. Rundeck, Kestra e Dagu coprono job operativi e pianificazione generale.
Come si descrive ciascun progetto:
- Airflow: «I flussi di lavoro di Airflow sono definiti interamente in Python», per attività come pipeline di dati batch, apprendimento automatico e addestramento di modelli (Apache-2.0).
- Rundeck: servizio open source di automazione dei runbook che esegue attività su un insieme di nodi, con console web, strumenti da riga di comando e API web (Apache-2.0).
- Kestra: piattaforma di orchestrazione e pianificazione basata su eventi (Apache-2.0).
- Dagu: trasforma script e runbook esistenti in flussi di produzione con pianificazione, nuovi tentativi, attività umane e cronologia. I job sono definiti in YAML (GPL-3.0).
Nelle sue domande frequenti sulla WLA, Stonebranch sostiene che gli strumenti della categoria di Airflow sono pensati per i flussi di ingegneria dei dati e che una piattaforma WLA può avviare e gestire job Airflow in un ambiente più ampio. È la prospettiva di un fornitore, ma coincide con l’attenzione ai dati dichiarata da Airflow. Per un team operativo conta come sono definiti i job e chi può mantenerli. In una discussione su r/sysadmin alla ricerca di un’alternativa gratuita a Control-M, l’autore escludeva i DAG Python di Airflow e sollevava la stessa preoccupazione per Kestra. È l’esperienza di un solo team. Ora Kestra offre un editor no-code per creare flussi tramite moduli senza scrivere YAML. Verifica che l’interfaccia attuale sia adatta a chi manterrà i job.
Che cosa è successo al Magic Quadrant per l’automazione dei carichi di lavoro?
Gartner ora inquadra il mercato nelle piattaforme di orchestrazione e automazione dei servizi (SOAP). Secondo l’annuncio di BMC, il primo Magic Quadrant per SOAP è stato pubblicato a settembre 2024. BMC riassume la definizione di Gartner come una combinazione di orchestrazione dei flussi, automazione dei carichi di lavoro e provisioning delle risorse. L’automazione dei carichi di lavoro resta al centro dell’esecuzione dei job in una SOAP.
In precedenza Gartner aveva pubblicato un Magic Quadrant per l’automazione dei carichi di lavoro. SOS GmbH, l’azienda dietro JobScheduler, ha annunciato la sua inclusione in quel rapporto, pubblicato da Gartner nel febbraio 2012.
Una suite come Control-M compare ora in un quadrante SOAP e si propone come strumento di orchestrazione dei flussi. Secondo l’autore, la categoria di analisi si è ampliata attorno allo stesso nucleo di esecuzione. Se un fornitore mette in risalto la sigla SOAP, è ragionevole aspettarsi che al centro della sua offerta ci sia uno strumento di pianificazione dei carichi di lavoro.
Come scegliere uno strumento adatto ai tuoi job
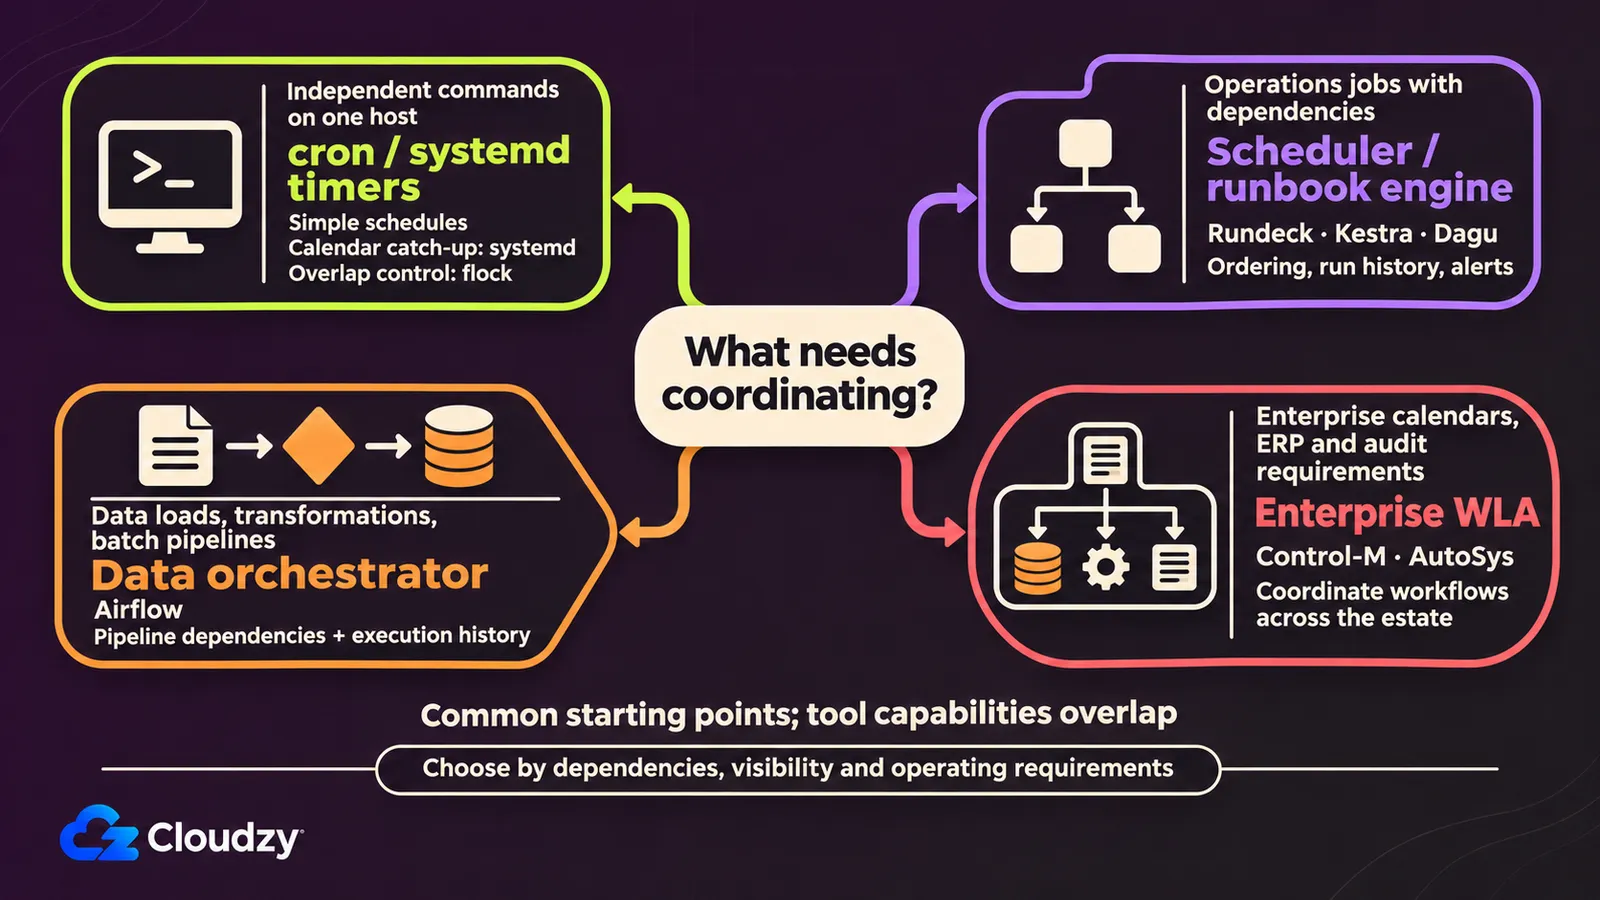
Il tipo di job determina la categoria di strumento. Per job indipendenti su un host bastano cron o un timer di systemd. Per job dipendenti su pochi host, che richiedono cronologia e avvisi, va bene uno strumento di pianificazione o un orchestratore open source. Gli ambienti estesi a tutta l’organizzazione con calendari aziendali, batch ERP e requisiti di audit sono il campo delle suite WLA aziendali.
Al primo livello, usa flock per i job che possono sforare e imposta Persistent=true nei timer OnCalendar= che devono recuperare esecuzioni dopo un’interruzione. Al livello intermedio, Rundeck, Kestra e Dagu vanno bene per un gruppo di job cron che devono soltanto essere eseguiti in ordine. Per le pipeline di dati, usa un orchestratore come Airflow. Il livello più alto include calendari di fine mese, job mainframe e ERP e registrazioni di ogni esecuzione per i revisori. Control-M, AutoSys e le altre suite aziendali WLA e SOAP si rivolgono a questi ambienti.
Il numero di job dice poco su quando cambiare strumento. Segnali più chiari sono un job che deve aspettare l’esito di un altro su una macchina diversa, oppure una mattina in cui nessuno sa cosa è successo la notte senza collegarsi a ogni server. Concatenare i job con intervalli orari costa poco fino alla prima esecuzione fuori ordine. A quel punto devi ripetere il caricamento, individuare i report che hanno usato dati obsoleti e spiegare le cifre. Inizia elencando i job pianificati, indicando quali dipendono dall’esito di altri e stimando quanto tempo serve per sapere cosa è stato eseguito su ogni host. Se la colonna delle dipendenze resta vuota e basta un minuto, cron è già lo strumento giusto.
Domande frequenti
Apache Airflow è uno strumento di automazione dei carichi di lavoro?
Apache Airflow esegue pipeline di dati scritte in Python, come caricamenti batch, apprendimento automatico e addestramento di modelli, sotto forma di job pianificati e con dipendenze. Conserva una cronologia delle esecuzioni. È un impiego tipico della WLA per i team dati, anche se la documentazione lo descrive come piattaforma di flussi di lavoro e non usa l’espressione «automazione dei carichi di lavoro».
Quali sono alcuni esempi di automazione dei carichi di lavoro?
Un’esportazione notturna del database seguita da un caricamento su un altro server, un trasferimento di file a un partner a fine giornata, i batch ERP di fine mese e una catena di backup che verifica ogni copia prima del passaggio successivo. Uno strumento WLA può pianificare ogni job e trattenere i passaggi dipendenti fino al completamento del prerequisito.
Che cosa significa SOAP nell’automazione dei carichi di lavoro?
Qui SOAP significa Service Orchestration and Automation Platform, ovvero piattaforma di orchestrazione e automazione dei servizi, il nome attuale della categoria Gartner. Nel riepilogo di BMC, la categoria aggiunge all’automazione dei carichi di lavoro l’orchestrazione dei flussi e il provisioning delle risorse. Non ha relazione con SOAP, lo standard di messaggistica XML per servizi web pubblicato dal W3C.
Automazione dei carichi di lavoro e pianificazione dei job sono la stessa cosa?
Sono concetti simili. BMC osserva che i principali sistemi operativi includono uno strumento per pianificare i job sulla stessa macchina, come l’Utilità di pianificazione di Windows. Su Linux questo ruolo spetta a cron. L’automazione dei carichi di lavoro entra in gioco quando i job su server diversi dipendono uno dall’altro. Secondo BMC, la distinzione è tra una piattaforma e più piattaforme.
Discussione
Commenti
Accedi per partecipare alla discussione.