

직접 만든 무언가가 운영 환경에서 돌아가고 있습니다. 모니터링은 아예 없거나 가동 여부를 확인하는 핑 하나뿐이고, 지난주에는 장애를 사용자에게서 전해 들었습니다. 답을 찾아 나서면 늘 같은 이름이 나옵니다.
이 Prometheus 리뷰는 둘 다 사실인 두 가지 사이의 간극을 다룹니다. 무료이고 오픈소스이며, 규모가 어떻든 라이선스도 메트릭당 청구서도 없습니다. 동시에 저녁 시간 하나와 아직 모르는 쿼리 언어 하나를 대가로 요구합니다. 알림 기능이 붙은 풀 방식 메트릭 수집기이고, 아주 훌륭한 소프트웨어입니다. 다만 지금 당신이 굴리고 있는 환경에 맞는 소프트웨어인지는 다른 질문이고, 답할 가치가 있는 쪽은 그 질문입니다.
요약
- 결론: 1인 및 소규모 팀 셀프 호스팅 기준 3.5 / 5. 호스트와 서비스 구성이 어느 정도 안정적이고, PromQL을 배우는 데 시간을 들일 생각이 있으며, 구독료도 보존 비용도 없이 온전히 내 것인 메트릭을 원한다면 Prometheus는 운영할 만합니다.
- 필요한 답이 “살아 있느냐”뿐이라면 넘기세요. 가동 확인 도구가 그 답에는 훨씬 빨리 도달하고, 그 일에 Prometheus를 꺼내 드는 것은 10분이면 끝났을 질문에 답하려고 쿼리 언어 값을 치르는 셈입니다.
- 계속 되돌아오는 비용은 PromQL입니다. 설치는 한 번으로 끝나는 비용입니다. 질문이 기성 대시보드와 Grafana의 시각적 빌더를 넘어서는 순간 다시 PromQL로 돌아오게 됩니다.
- 유지 비용은 구성 가운데 얼마를 손으로 관리하느냐를 따라갑니다. 형태를 유지하는 서버 묶음은 모니터링 비용이 쌉니다. 호스트가 늘고 줄고 이름이 바뀌는 쪽이 비용이 조용히 쌓이는 지점입니다.
- 이 결론은 소규모 셀프 호스팅에 한정됩니다. Kubernetes와 프로덕션 SRE 규모에서 Prometheus는 전혀 다른 제안이며, 이 리뷰는 그 질문에 답하려 하지 않습니다.
이 리뷰를 만든 방법: Prometheus는 무료이고 오픈소스라 여기에는 벤더와의 관계가 없고 누구도 제게 무언가를 보내지 않았습니다. 버전 정보와 저장소 동작은 Prometheus 공식 문서에서 가져왔습니다. 리소스 수치와 설치 시간은 독립적으로 공개된 두 건의 실측 테스트에서 가져왔고, 각각이 쓰인 지점에 출처를 밝혔습니다. 두 결과가 어긋나는 지점에서는 평균을 내는 대신 두 수치를 모두 보여 드립니다.
이 리뷰가 다루는 범위
위의 결론에는 경계가 있고, 여기서는 그 경계가 평소보다 더 중요합니다. Prometheus는 규모가 달라지면 사실상 다른 도구처럼 움직이기 때문입니다.
- VPS 한 대와 소규모 프로젝트의 셀프 호스팅을 기준으로 한 Prometheus 평가입니다. 호스트와 서비스가 몇 개, 그리고 그것을 돌보는 사람은 한 명인 상황입니다.
- Kubernetes는 아닙니다. Prometheus Operator, ServiceMonitors, kube-prometheus-stack은 별개의 운영 세계이고, 여기의 결론은 그쪽에 대해 아무 말도 하지 않습니다.
- Alertmanager 라우팅 가이드도 아닙니다. 알림 기능은 있고 잘 동작합니다. 다만 라우트와 사일런스, 리시버를 설정하는 일은 그 자체로 하나의 주제입니다.
- 설치 안내서도 아닙니다. 여기서의 질문은 애초에 이걸 돌릴지 말지입니다. 그 답을 이미 냈다면 Grafana와 Prometheus Docker Compose 가이드에서 단계를 확인할 수 있습니다.
- 익스포터 총람도 아닙니다. 익스포터는 답이 달라지는 지점에서만 등장합니다.
Prometheus가 잘하는 것
Prometheus는 아무 비용도 들지 않습니다. “유료 업그레이드가 딸린 무료 요금제”도 아니고 “메트릭 한도를 넘기 전까지 무료”도 아닙니다. 저장소는 처음부터 끝까지 Apache 2.0 라이선스 아래 있으며, 핵심 프로젝트에 유료 에디션은 없고, 어디에도 호스트당·메트릭당·레이블당 과금이 없습니다. Prometheus가 만들어 내는 유일한 청구서는 그것이 돌아가는 서버뿐입니다.
의존할 작정인 대상이라면 “3년 뒤에도 여기 있을까”는 정당한 질문이고, 이 경우 가능성은 오픈소스에서 기대할 수 있는 만큼 좋습니다. Prometheus는 2018년 8월에 CNCF를 졸업했고, Kubernetes에 이어 역대 두 번째였습니다. 릴리스도 꾸준해서 v3.13.2가 2026년 7월 말에 나왔습니다. 이 릴리스 라인은 장기 지원 라인이라 1년 동안 버그, 보안, 문서 수정을 받습니다. 그래서 패치를 유지한다는 것이 모든 마이너 버전을 쫓아다닌다는 뜻은 아닙니다.
주변 생태계가 그토록 두터운 이유는 데이터 모델에 있습니다. Prometheus는 HTTP로 메트릭을 수집하고 모든 시계열을 메트릭 이름과 키/값 레이블로 식별하기 때문에 익스포터를 작성하는 일이 작은 작업이 됩니다. 그래서 현실적으로 돌릴 만한 거의 모든 것에 익스포터가 존재합니다. 노드 메트릭, Postgres, Nginx, Redis, 밖에서만 찔러 볼 수 있는 대상을 위한 blackbox 프로브까지 말이죠.
그리고 수집한 것은 당신 소유입니다. 이 점은 첫날보다 나중에 가서 의미가 커지는 부분입니다. 작은 구성의 이력은 대수롭지 않은 용량만 차지하고(수치는 아래에 있습니다), 다음 분기에 누군가 가격을 다시 매길 수도 없으며, 누군가 애플리케이션에 계측을 추가할 때마다 커지는 청구 항목도 없습니다. 개발자가 레이블 하나를 추가했다는 이유로 관리형 모니터링 청구서가 올라가는 것을 본 적이 있다면, 논거 전체가 그 한 문장에 들어 있습니다.
Prometheus가 보이는 것보다 더 비싸지는 지점
소형 VPS 한 대에서 모니터링 도구 7종을 시험한 dev.to 테스트에서는 Prometheus 단독 설치 시간이 15분으로 측정됐습니다. 그 테스터가 그랬듯 Grafana와 함께 쓰세요. 내장된 표현식 브라우저는 쿼리를 실행해 보는 자리일 뿐이기 때문입니다. 같은 테스트에서 Grafana + Prometheus는 첫 차트까지 35분이 걸렸고, 중간에 YAML 스크레이프 설정이 끼어 있었습니다.
분 단위 시간은 싼 쪽입니다. 비싼 쪽은 PromQL입니다. Prometheus는 모든 것을 이름과 레이블로 식별되는 시계열로 저장하고, 당신이 던지는 질문 밑에 깔린 언어는 여전히 PromQL입니다. 이제 Grafana에 시각적 빌더가 있으니 모든 쿼리를 손으로 쓸 필요는 없습니다. 테스터 본인의 평가는 단호했습니다. PromQL은 그 안에서 사는 사람에게는 훌륭하지만, 그는 그렇지 않았다는 것입니다. 쿼리 언어를 써 본 적이 없다면 저녁 한 번 이상을 잡아 두고, 시각적 빌더로 부족해질 때마다 다시 돌아오게 되리라 예상하세요. 남에게서 복사해 온 대시보드는 그 사람의 질문에 답합니다. 당신의 질문은 아직 쓰지 않은 쿼리입니다.
세 번째 비용은 한참 뒤에야 드러납니다. 어느 운영자의 3주 기록은 7노드 구성에 서버 한 대를 추가하는 일이 정확히 무엇을 뜻했는지 보여 줍니다. 레이블을 다시 붙이고, 스크레이프 설정을 다시 확인하고, 대시보드 변수를 고치고, 새 호스트가 드롭다운에 뜨도록 템플릿 쿼리를 손보는 일이었습니다. 그 운영자는 인프라를 지켜보는 시간보다 대시보드를 다듬는 시간이 더 많다는 결론을 내리고 3주 만에 이 스택을 접었습니다.
이런 구성에서 그 비용이 무엇에 묶여 있는지 보세요. 손으로 관리하는 타깃과 대시보드입니다. 조용한 2년 동안 Prometheus를 굴리는 데는 그 외의 비용이 거의 들지 않습니다.
Prometheus에는 실제로 RAM과 디스크가 얼마나 필요할까?
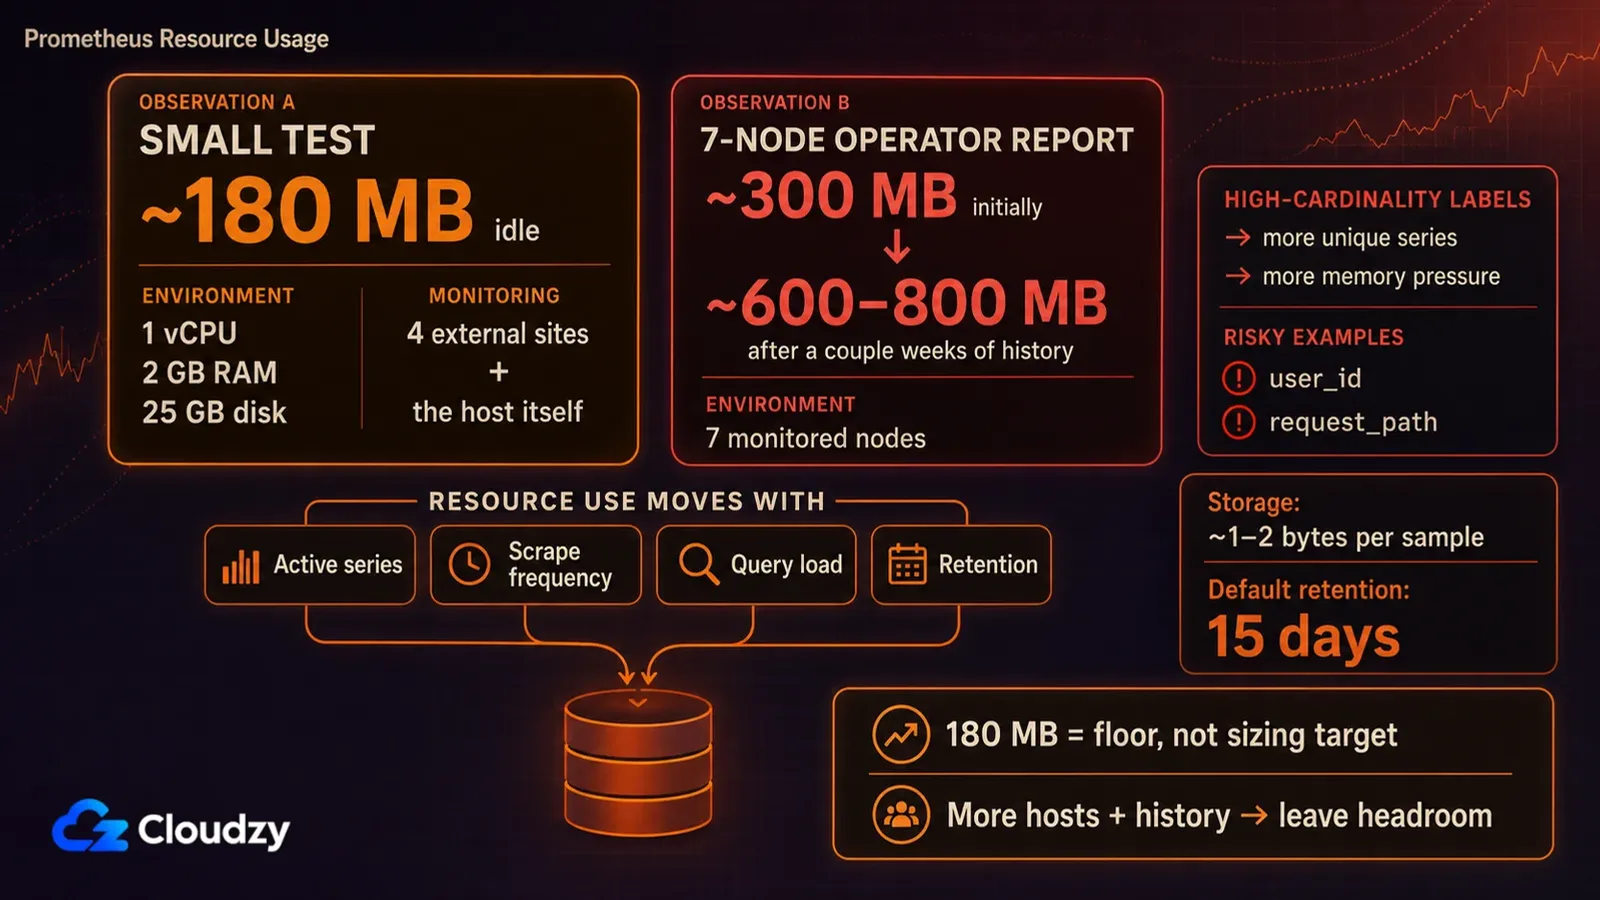
고정된 요구 사항은 없습니다. 활성 시계열, 스크레이프 주기, 쿼리 부하, 보존 기간이 겨냥한 서버 대수 자체보다 더 중요합니다. 소규모 구성을 다룬 공개 실측 테스트 두 건은 대략 180 MB에서 800 MB 사이로 잡는데, 높은 쪽 수치는 이력이 2주쯤 쌓인 7노드 환경입니다.
두 테스트는 서로 어긋나고, 쓸모 있는 부분은 바로 그 어긋남입니다. 같은 7종 VPS 비교는 모든 도구를 동일한 하드웨어(1 vCPU, 2 GB RAM, 25 GB 디스크, Ubuntu 24.04)에서 돌리며 외부 사이트 네 곳과 호스트 자신을 감시했고, Prometheus를 유휴 상태에서 약 180 MB로 측정했습니다. 같은 운영자는 중앙 호스트에서 Prometheus 단독으로 유휴 시 300 MB 안팎이었고, 이력이 2주쯤 쌓이자 600~800 MB 쪽으로 올라갔다고 보고했습니다.
둘은 같은 측정이 아니며, 그래서 평균을 내면 정보를 버리는 셈이 됩니다. 하나는 저장할 것이 거의 없는 장비에서 잰 사실상 유휴 수치입니다. 다른 하나는 뒤에 서버 묶음이 있고 디스크에 이력이 쌓인, 실제로 돌아가는 배포입니다. 제 해석은 이렇습니다. 180 MB라는 결과는 사이징 목표가 아니라 바닥으로 보세요. 여러 호스트에서 수집하고 이력을 보관하기 시작하면 그 유휴 수치에 맞춰 계획하는 대신 여유를 남겨 두어야 합니다.
디스크는 쉬운 쪽 절반입니다. Prometheus의 저장소 문서는 샘플당 평균 1~2바이트로 잡고 있어서, 작은 구성에서 긴 이력을 보관하는 비용은 쌉니다. 함정은 기본값에 있습니다. 보존 기간의 기본값은 15일입니다 보존 시간이나 보존 용량을 따로 지정하지 않는 한 그렇습니다. 1년으로 만드는 데 필요한 것은 시작 플래그 하나뿐이고, 이건 지난달 수치를 찾다가 3주 전에 만료됐다는 걸 처음 알게 되는 순간이 아니라 지금 알아 두는 편이 나은 종류의 기본값입니다.
메모리 수치를 밀어 올리는 것은 카디널리티, 즉 서로 다른 시계열의 개수입니다. 하나의 메트릭에서 레이블의 고유한 조합 하나하나가 각각의 시계열이 됩니다. 트래픽이 많은 메트릭에 잘못 고른 레이블 하나는 서버 다섯 대를 더 붙이는 것보다 많은 시계열을 만들어 낼 수 있고, 그 일을 트래픽이 흐르는 속도 그대로 조용히 해냅니다. (사용자 ID나 요청 경로는 그 개수를 세어 보기 전까지는 훌륭한 레이블처럼 보입니다.)
Prometheus를 두고 인용되는 어떤 RAM 수치든, 그 뒤에 시계열이 몇 개 있었는지까지 알아야 쓸모가 있습니다.
Prometheus 서버가 죽으면 어떻게 되나?
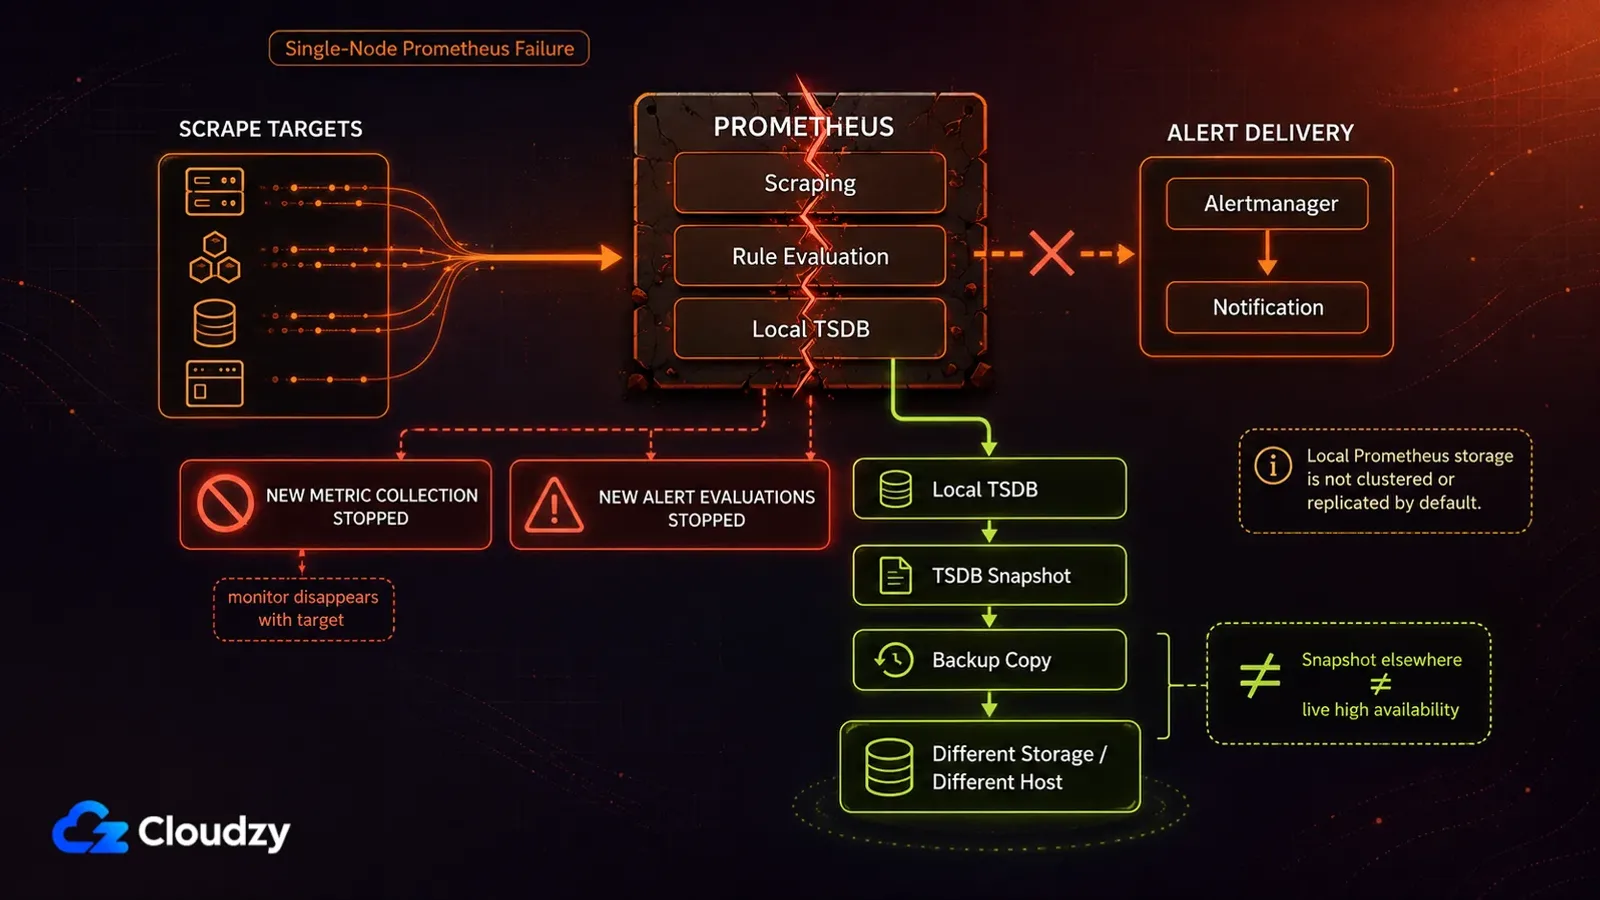
Prometheus 자체 저장소 문서는 이 점을 분명히 말합니다. 로컬 저장소는 클러스터링되지도 복제되지도 않습니다. 따라서 드라이브나 노드 장애를 견디지 못합니다. 각 서버는 설계상 독립적이고 네트워크 스토리지에도 원격 서비스에도 의존하지 않는데, 바로 그 점이 운영을 쉽게 만들면서 동시에 그대로 노출시킵니다.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
프로젝트가 스스로에 대해 밝히는 두 번째 한계가 있고, 그것을 밝혔다는 점은 인정받을 만합니다. 100% 정확도가 필요하다면, 예컨대 요청 단위 과금 같은 경우, 문서는 Prometheus가 잘못된 선택이라고 말합니다. 수집하는 데이터가 충분히 상세하고 완전하지 않을 가능성이 크기 때문입니다. 청구서를 끊는 숫자에는 다른 것을 쓰고, Prometheus는 모니터링용으로 남겨 두세요. 벤더가 자기 자신에 대해 이런 이야기를 먼저 꺼내는 일은 드뭅니다.
더 큰 규모에서는 이에 대한 정착된 답들이 있지만, Kubernetes 도구와 같은 이유로 여기서는 범위 밖입니다. 이 리뷰가 다루는 것과는 다른 수준의 운영 부담이기 때문입니다. VPS 한 대라면 제 해석은 이렇습니다. TSDB 스냅샷을 다른 곳에 보관하거나 이력을 잃는다는 것을 미리 받아들인다면 이 노출은 감수할 만하고, Prometheus가 당신과 조용한 장애 사이에 놓인 유일한 존재라면 진짜 문제입니다.
누가 Prometheus를 직접 호스팅해야 하나?
Prometheus가 치른 값을 되갚아 줄지 가장 분명하게 알려 주는 신호는 서버가 몇 대인지와 무관합니다. 여섯 달 뒤에도 같은 서버들일지가 관건입니다. 손으로 설정한 호스트 구성이 안정적이라면 설정은 한 번 쓰고 이력은 공짜로 쌓입니다. 계속 바뀌는 구성이라면 그 설정을 계속 건드리게 됩니다.
고정된 구성에서 Prometheus와 Grafana 설정은 인프라를 명시적으로 서술한 문서가 됩니다. 스크레이프 타깃, 거기 붙은 레이블, 그 레이블 위에 올린 대시보드가 그것입니다. 이력이 곧 전부인 이유가 여기 있습니다. 안정적인 호스트 구성에서 쌓인 1년치 데이터는 정상이 어떤 모습인지 알려 주고, 그것이 장애로 번지기 전에 비정상을 알아채는 가장 믿을 만한 방법입니다.
그래서 첫 번째 유형은 작고 천천히 변하는 서버 묶음을 굴리면서 살았는지 죽었는지 이상을 원하는 사람입니다. 시간에 따른 요청 지연, 메모리 추세, 몇 주 전부터 다가오는 게 보일 만큼 천천히 차오르는 디스크 같은 것들 말입니다. 오늘 자기 인프라를 서술할 수 있고 그 서술이 1년 뒤에도 대체로 맞으리라 기대한다면, 설치에 들이는 그 저녁이 마지막 큰 비용입니다.
두 번째는 이 스택을 작정하고 배우는 사람입니다. 몇 년 뒤에도 자기 것이든 남의 것이든 인프라를 다루고 있을 거라 본다면, PromQL에 쓰는 저녁이야말로 애초에 원한 것이고 모니터링은 부수적인 결과입니다. 이 유형은 첫 번째를 어느 정도 뒤집습니다. 여기서는 안정성 조건이 덜 중요한데, 레이블을 다시 붙이는 데 쓴 시간이 곧 레이블 재지정이 무엇인지 배우는 시간이기도 하기 때문입니다. 이런 독자라면 점수를 더 올리겠습니다.
세 번째 유형은 소유권에 관한 것이고, 반대편에 서 보기 전까지는 사람들이 과소평가하는 쪽입니다. Prometheus는 호스트당, 메트릭당, 레이블당 과금하지 않고, 어떤 가격 페이지도 다음 분기에 발밑에서 바뀔 수 없습니다. Datadog 같은 관리형 서비스와의 맞바꿈은 이렇습니다. 매끄러움과 지원 계약, 남이 서는 온콜을 포기하는 대신, 개발자가 계측을 추가해도 움직이지 않는 청구서와 온전히 내 것인 메트릭을 얻습니다. 그것이 좋은 거래인지는 당신의 시간이 얼마짜리인지에 달렸고, 그 숫자는 오직 당신만 넣을 수 있습니다(그리고 그렇게 느껴질 때조차 0인 경우는 드뭅니다).
결정하기 전에 알아 둘 것이 하나 있습니다. Prometheus의 로컬 저장소를 넘어서는 일은 막다른 길이 아닙니다. VictoriaMetrics는 Prometheus의 remote write를 받아들이고, 그리고 MetricsQL은 PromQL과 하위 호환됩니다. 그래서 지금 만드는 쿼리와 Grafana 대시보드 대부분은 옮긴 뒤에도 그대로 쓸 수 있습니다. 재작성이 아니라 이전입니다.
한 번 정하고 끝낼 일이 아니라 1년에 한 번씩 다시 볼 일입니다. 오늘 모니터링하기 싼 구성은 그것을 다시 짓기 시작하는 분기에 비싸집니다.

루트 액세스, NVMe, AMD EPYC 성능을 갖춘 Linux VPS에서 개발하세요.
Linux 요금제 보기누가 Prometheus를 건너뛰어야 하나?
필요한 것을 설명할 때 쓸 문장이 “사이트가 죽으면 알려 줘”라면, 당신이 말하는 것은 가동 확인 도구이고, 그 답에 이르기에 Prometheus는 지나치게 많은 장치입니다. Uptime Kuma 같은 도구는 바로 그 일을 웹 UI로 해내고 모니터링 쿼리 언어를 배우라고 요구하지 않습니다. 두 도구의 기능 격차는 엄청나지만, 당신이 맡기려는 일과는 전혀 상관이 없습니다.
두 번째 독자는 쿼리 언어를 먼저 배우지 않고도 쓸 만한 그래프를 원하는 사람입니다. Netdata가 바로 그것을 중심으로 만들어졌습니다. 훨씬 적은 설정으로, 당신과 차트 사이에 아무것도 두지 않고 곧바로 볼 수 있는 호스트별 메트릭입니다. 계속 던지는 질문이 “이 장비 지금 왜 느리지”라면, 답에 이르는 훨씬 짧은 길입니다.
세 번째는 인프라의 형태가 자주 바뀌는데 타깃과 대시보드 변수를 손으로 관리하는 모든 사람입니다. 일주일 쓰려고 띄웠다 없애는 호스트, 이름이 바뀌는 타깃, 중간에 이름이 바뀌는 프로젝트 같은 경우죠. 설정 비용은 몇 번이고 다시 치르면서, 정작 돈을 내고 사는 것, 즉 알아볼 수 있는 상태로 남아 있는 시스템의 연속된 이력에서는 가장 적게 얻는 경우입니다.
이 가운데 무엇도 이 도구를 깎아내리는 말은 아닙니다. 여기서 “건너뛰라”는 것은 이 일에서, 이 규모에서 건너뛰라는 뜻입니다. 서비스 디스커버리가 손으로 엮을 일 대부분을 처리하는 Kubernetes 규모에서는 위의 비용 가운데 여럿이 줄거나 아예 사라지고, 그 규모에 대한 제 해석은 거기서 Prometheus를 이기기가 대단히 어렵다는 것입니다. 그건 다른 리뷰의 몫입니다.

자주 묻는 질문
Prometheus는 무료인가요?
네, 그리고 그 아래 숨은 무료 요금제식 함정도 없습니다. Prometheus는 Apache 2.0 라이선스이고 뒤에 상용 에디션이 없어서, 넘어야 할 메트릭 할당량도, 그 너머에서 기다리는 업그레이드 안내도 없습니다. 당신이 지불하는 것은 인프라와 자기 시간이지 Prometheus 라이선스가 아닙니다.
Prometheus에 Grafana가 필요한가요?
아니요, 다만 쓰게 될 것을 염두에 두세요. Prometheus의 표현식 브라우저는 쿼리를 한 번 돌리고 답을 보기 위한 것이라, 한 가지를 한 번 확인하는 데까지는 충분합니다. 두 번째 모니터에 계속 띄워 두고 싶은 것은 모두 Grafana의 몫입니다. 둘은 거의 언제나 함께 운영됩니다.
서버 한 대에 Prometheus는 과한가요?
대체로 그렇습니다. 서버와 그 서비스가 살아 있는지만 알면 된다면, 가동 확인 도구가 설치 시간의 일부만으로 답을 줍니다. Prometheus는 질의할 수 있는 과거 메트릭을 원하고 거기 닿기 위해 PromQL을 배울 마음이 있을 때 제 몫을 합니다.
Prometheus는 기본적으로 메트릭을 얼마나 오래 보관하나요?
15일이고, 미리 경고해 주지도 않습니다. 시작 시 보존 시간이나 보존 용량 플래그로 늘리지 않는 한 Prometheus는 보존 기간보다 오래된 샘플을 버립니다. 설치하는 날 바로 설정하세요. 나중에 기간을 늘려도 이미 만료된 데이터는 돌아오지 않습니다.



토론
댓글
토론에 참여하려면 로그인하세요.