

Něco, co jste postavili, běží v produkci. Váš monitoring je buď úplně žádný, nebo jen ping na dostupnost, a minulý týden jste se o výpadku dozvěděli od uživatele. Každá odpověď, kterou hledáte, ukazuje na stejné jméno.
Tato recenze Prometheus je o mezeře mezi dvěma věcmi, které platí obě zároveň. Je zdarma a otevřený, bez licence a bez účtu za metriku, v jakémkoli měřítku. Zároveň vás stojí jeden večer plus dotazovací jazyk, který zatím neumíte. Je to sběrač metrik založený na pull s připojeným alertingem a je to výborný software. Jestli je to ten správný software pro sestavu, kterou provozujete právě teď, je ale jiná otázka, a právě ta stojí za odpověď.
Zkrácená verze
- Verdikt: 3,5 / 5 pro samostatné vývojáře a malé týmy provozující si vše sami. Prometheus se vyplatí provozovat, pokud je vaše sada hostů a služeb rozumně stabilní, pokud si najdete čas naučit se PromQL a pokud chcete metriky, které vám patří celé, bez předplatného a bez účtu za uchovávání dat.
- Vynechte ho, pokud otázka, na kterou potřebujete odpověď, zní „běží to?“. Kontrola dostupnosti vás k té odpovědi dovede mnohem rychleji a sáhnout kvůli téhle práci po Prometheus znamená zaplatit dotazovací jazyk za něco, co jste mohli vyřešit za deset minut.
- PromQL je náklad, který se vrací pořád dokola. Nastavení je jednorázový náklad. Jakmile vaše otázky přerostou hotové dashboardy a vizuální stavitel dotazů v Grafaně, jste zase zpátky v PromQL.
- Náklady na údržbu se odvíjejí od toho, kolik ze sestavy spravujete ručně. Flotila, která si drží tvar, se monitoruje levně. Ta, která hosty přibírá, ztrácí a přejmenovává, je přesně místo, kde náklady tiše narůstají.
- Tento verdikt platí výhradně pro provoz vlastními silami v malém měřítku. V měřítku Kubernetes a produkčního SRE je Prometheus úplně jiná nabídka a tato recenze se tuhle otázku zodpovědět nesnaží.
Jak tato recenze vznikla: Prometheus je zdarma a otevřený, takže tu není žádný vztah s dodavatelem a nikdo mi nic neposlal. Údaje o verzích a chování úložiště pocházejí z vlastní dokumentace Prometheus. Čísla o spotřebě zdrojů a doby nasazení pocházejí ze dvou nezávisle publikovaných praktických testů, přičemž každý je uveden na místě, kde se používá. Tam, kde se ty dva rozcházejí, uvidíte obě čísla místo průměru.
Co tato recenze pokrývá
Verdikt výše má hranice a tyhle hranice tu hrají větší roli než obvykle, protože Prometheus se v různých měřítkách chová jako jiný nástroj.
- Prometheus hodnocený pro provoz na jediném VPS a pro malé projekty: hrstka hostů a služeb a jeden člověk, který se o ně stará.
- Ne Kubernetes. Prometheus Operator, ServiceMonitors a kube-prometheus-stack jsou samostatný provozní svět a zdejší verdikt o něm neříká vůbec nic.
- Ne návod na směrování v Alertmanageru. Alerting existuje a funguje; nastavovat routy, silence a receivery je téma samo o sobě.
- Ne návod na instalaci. Otázka tady zní, jestli ho vůbec provozovat. Pokud tuhle otázku už máte zodpovězenou, kroky popisuje náš průvodce Grafanou a Prometheus přes Docker Compose do detailu.
- Ne přehled exportérů. Exportéry se objevují jen tam, kde mění odpověď.
V čem je Prometheus dobrý
Prometheus nestojí nic. Ne „bezplatná úroveň s placenými vylepšeními“, ne „zdarma, dokud nepřekročíte limit metrik“. Repozitář je licencovaný pod Apache 2.0 od začátku do konce, placená edice hlavního projektu neexistuje a nikde se neúčtuje za hosta, za metriku ani za label. Jediný účet, který Prometheus kdy vytvoří, je server, na kterém běží.
U něčeho, na čem hodláte stavět, je otázka „bude to tu za tři roky ještě?“ na místě a šance jsou tady zhruba tak dobré, jak to u otevřeného softwaru bývá. Prometheus absolvoval CNCF v srpnu 2018, jako vůbec druhý projekt v historii, hned po Kubernetes. Vydání vycházejí pravidelně, například v3.13.2 vyšla na konci července 2026, a protože je tahle řada vydání řadou s dlouhodobou podporou, dostává opravy chyb, bezpečnosti a dokumentace po dobu jednoho roku, takže držet záplaty neznamená honit se za každou menší verzí.
Datový model je důvod, proč je ekosystém kolem něj tak hluboký. Prometheus sbírá metriky přes HTTP a každou řadu identifikuje názvem metriky plus labely typu klíč/hodnota, takže napsat exportér je malá práce. Existují proto exportéry skoro na všechno, co byste reálně provozovali: metriky uzlu, Postgres, Nginx, Redis, blackbox sondy pro věci, do kterých se dá šťouchnout jen zvenčí.
A to, co posbírá, patří vám, což je ta část, která obvykle začne být důležitá až později, ne první den. Historie malé sestavy zabere nezajímavé množství místa na disku (čísla jsou níž), nikdo vám ji příští čtvrtletí nepřecení a není tu žádná položka na faktuře, která roste pokaždé, když někdo přidá do aplikace další měření. Pokud jste někdy sledovali, jak účet za spravovaný monitoring šplhá nahoru, protože vývojář přidal jeden label, celý argument se vejde do téhle věty.
Kde vás Prometheus stojí víc, než to vypadá
Test na dev.to se sedmi monitorovacími nástroji na jednom malém VPS naměřil samotnému Prometheus 15 minut nasazení. Spárujte si ho s Grafanou, jak to udělal i autor testu, protože vestavěný prohlížeč výrazů je jen místo, kde spustíte dotaz. Tentýž test dává dvojici Grafana + Prometheus 35 minut k prvnímu grafu, se scrape konfigurací v YAML někde uprostřed.
Minuty jsou ta levná část. Ta drahá je PromQL. Prometheus ukládá všechno jako časové řady identifikované názvem a labely a PromQL je pořád jazyk pod otázkami, které mu kladete. Grafana už má vizuálního stavitele dotazů, takže nemusíte psát každý dotaz ručně. Verdikt autora testu byl přímočarý: PromQL je skvělý, pokud v něm žijete, a on v něm nežil. Pokud jste nikdy dotazovací jazyk nepoužívali, počítejte s víc než jedním večerem a s tím, že se k němu budete vracet vždycky, když vizuální stavitel přestane stačit. Dashboard, který jste od někoho zkopírovali, odpovídá na jeho otázky. Ty vaše jsou dotaz, který jste ještě nenapsali.
Třetí náklad je ten, který se ukáže až později. Jeden třítýdenní zápis jednoho provozovatele přesně popisuje, co obnášelo přidání jediného serveru do sestavy o sedmi uzlech: přeznačkovat, znovu projít scrape konfigurace, upravit proměnné dashboardů a přepracovat šablonové dotazy, aby se nový host objevil v rozbalovacích seznamech. Ten provozovatel to po třech týdnech vzdal se závěrem, že tráví víc času laděním dashboardů než sledováním vlastní infrastruktury.
Všimněte si, na čem ten náklad v takové sestavě visí: na cílech a dashboardech spravovaných ručně. Provozovat Prometheus dva klidné roky vás navíc nestojí skoro nic.
Kolik RAM a místa na disku Prometheus doopravdy potřebuje?
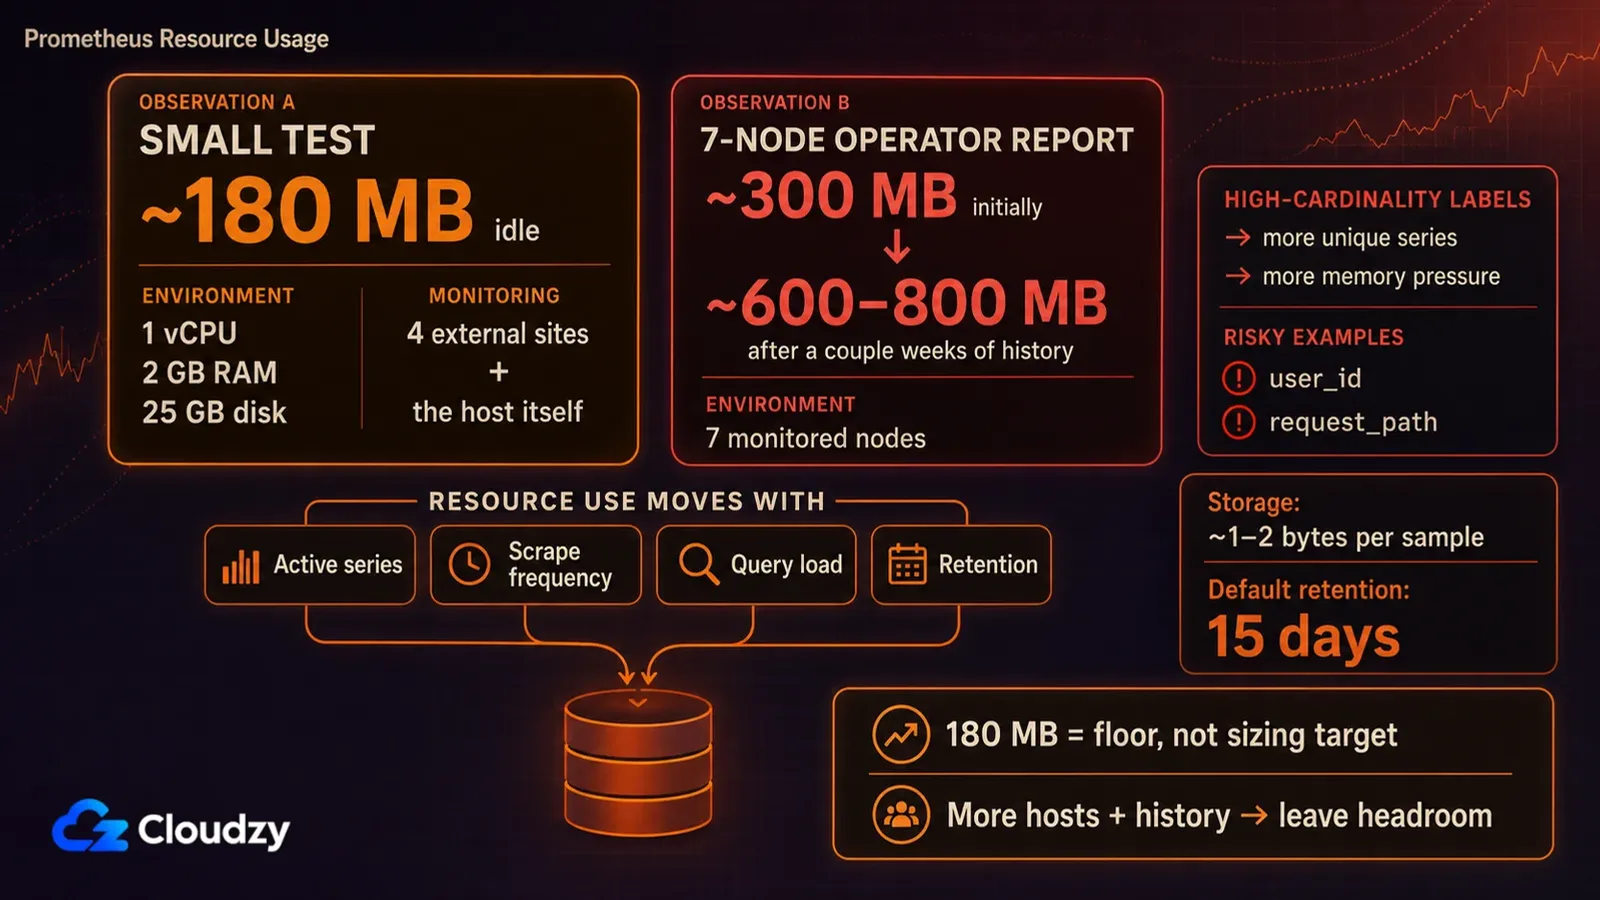
Žádný pevný požadavek neexistuje. Aktivní řady, frekvence sběru, zátěž dotazy a doba uchovávání rozhodují víc než holý počet serverů, na které ho namíříte. Dva publikované praktické testy malých sestav ho kladou zhruba mezi 180 MB a 800 MB, přičemž vyšší číslo pokrývá sedm uzlů s pár týdny historie.
Ty dva testy se rozcházejí a právě ten rozpor je užitečný. Totéž VPS srovnání sedmi nástrojů pouštělo každý z nich na identickém hardwaru (1 vCPU, 2 GB RAM, 25 GB disku, Ubuntu 24.04) při sledování čtyř externích webů plus samotného hosta a Prometheus naměřilo na zhruba 180 MB v klidu. Tentýž provozovatel uvedl, že samotný Prometheus se na centrálním hostu držel v klidu kolem 300 MB a šplhal k 600 až 800 MB, jakmile se nasbíralo pár týdnů historie.
Nejsou to stejná měření, a proto by jejich zprůměrování informaci zahodilo. Jedno je téměř klidový odečet na stroji, který má velmi málo co ukládat. Druhé je běžící nasazení s flotilou za zády a historií na disku. Já to čtu takto: berte výsledek 180 MB jako podlahu, ne jako cíl dimenzování. Jakmile sbíráte z více hostů a držíte historii, nechte si rezervu, místo abyste plánovali podle toho klidového čísla.
Disk je ta snadná polovina. Dokumentace úložiště Prometheus ho počítá v průměru na 1 až 2 bajty na vzorek, takže držet dlouhou historii u malé sestavy je levné. Háček je ve výchozím nastavení: doba uchovávání je ve výchozím stavu 15 dní pokud nenastavíte dobu ani velikost uchovávání. Od celého roku vás dělí jediný parametr při startu a je to přesně ten druh výchozího nastavení, o kterém se raději dozvíte teď, než až poprvé půjdete hledat čísla z minulého měsíce a zjistíte, že vypršela před třemi týdny.
Co žene číslo paměti nahoru, je kardinalita: počet odlišných časových řad, kde se každá jedinečná kombinace labelů na metrice stává vlastní řadou. Jediný špatně zvolený label na metrice s vysokým provozem umí vytvořit víc řad, než by kdy vytvořilo pět serverů navíc, a dělá to tiše, tempem, jakým zrovna běží váš provoz. (ID uživatele nebo cesta požadavku vypadají jako skvělý label přesně do chvíle, než spočítáte, kolik jich je.)
Jakékoli číslo o RAM, které u Prometheus najdete citované, je použitelné jen tehdy, když víte i to, kolik řad za ním stálo.
Co se stane, když vám server s Prometheus spadne?
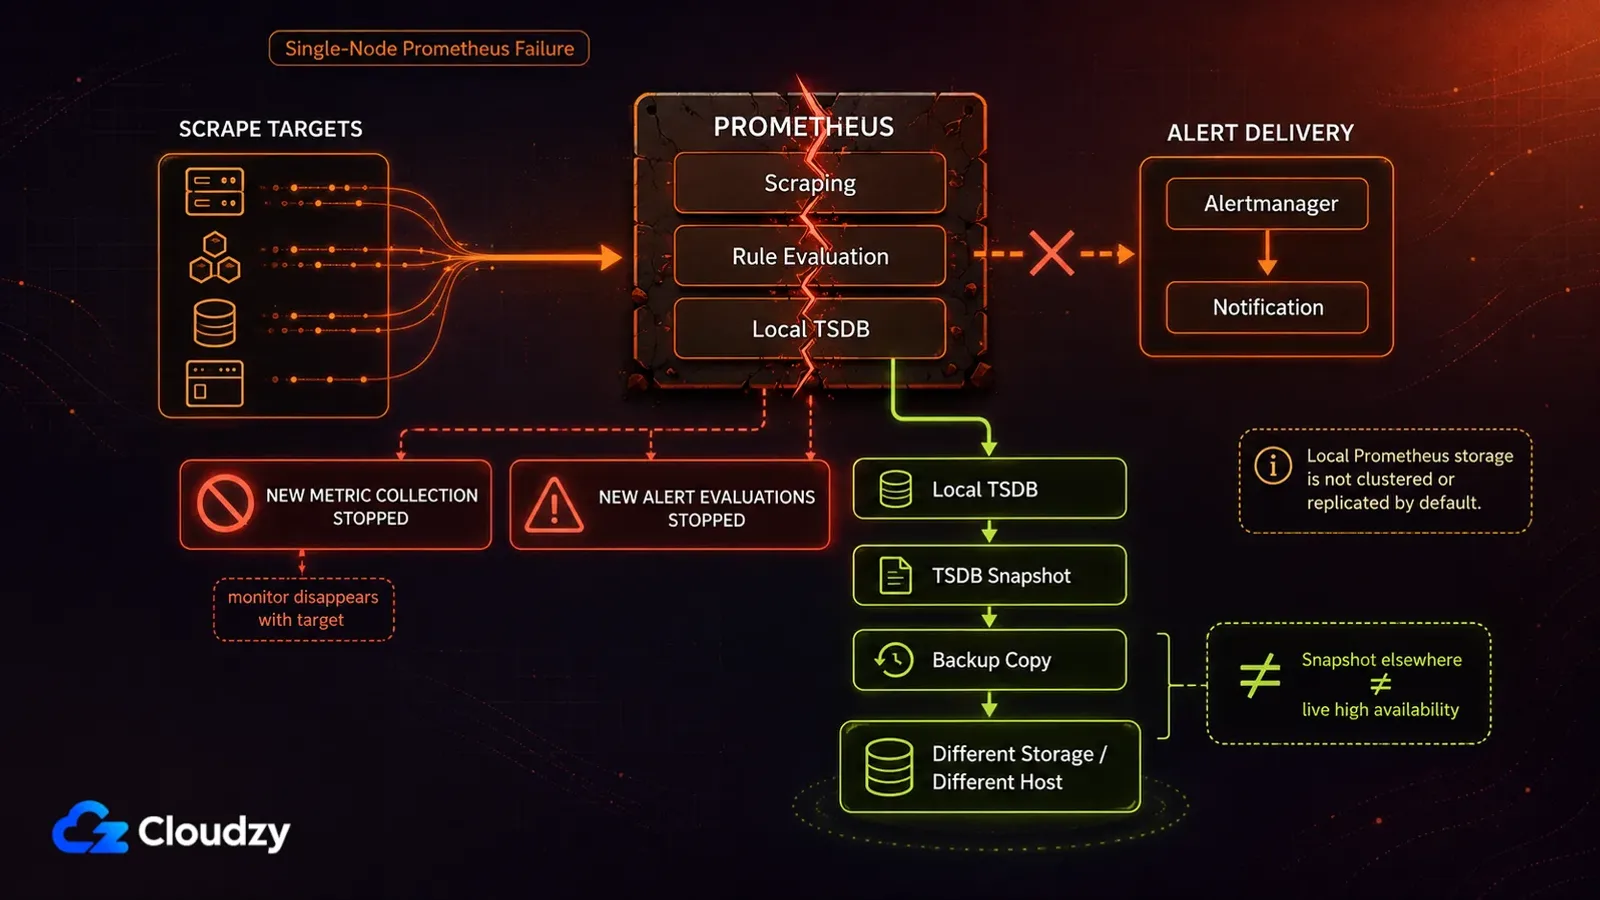
Vlastní dokumentace úložiště Prometheus to říká napřímo: lokální úložiště není clusterované ani replikované, takže nepřežije selhání disku ani uzlu. Každý server je záměrně samostatný a nezávisí na síťovém úložišti ani na vzdálených službách, což je přesně to, co ho dělá snadno provozovatelným, a přesně to, co ho nechává nechráněný.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Je tu ještě druhá hranice, kterou projekt sám o sobě uvádí, a zaslouží si za to uznání: pokud potřebujete 100% přesnost, například pro fakturaci za jednotlivé požadavky, dokumentace říká, že Prometheus je špatná volba, protože data, která sbírá, nebudou nejspíš dost podrobná a úplná. Na čísla, podle kterých fakturujete, použijte něco jiného a Prometheus si nechte na monitoring. Dodavatelé obvykle takové věci o sobě sami od sebe neříkají.
Ve větším měřítku na tohle existují zavedené odpovědi a jsou tady mimo záběr ze stejného důvodu jako nástroje kolem Kubernetes: znamenají jiný provozní závazek než ten, kterým se tahle recenze zabývá. Pro jediný VPS to čtu tak, že riziko je přijatelné, pokud držíte snapshoty TSDB jinde nebo předem přijmete, že o historii přijdete, a že je to skutečný problém, pokud je Prometheus jediné, co stojí mezi vámi a tichým výpadkem.
Kdo by si měl Prometheus provozovat sám?
Nejjasnější signál, že se vám Prometheus vrátí, nemá nic společného s tím, kolik máte serverů. Jde o to, jestli to za půl roku budou tytéž servery. Stabilní sada ručně nakonfigurovaných hostů znamená, že konfiguraci napíšete jednou a historii sbíráte zadarmo; sada, která se pořád mění, znamená, že se do té konfigurace pořád nimráte.
Ve statické sestavě je vaše konfigurace Prometheus a Grafany explicitním popisem vaší infrastruktury: cíle sběru, labely na ně navěšené a dashboardy postavené nad těmi labely. Proto je historie celý ten výnos. Rok dat nad stabilní sadou hostů vám řekne, jak vypadá normál, což je nejspolehlivější způsob, jak rozpoznat abnormál dřív, než se z něj stane výpadek.
První profil je tedy někdo, kdo provozuje malou, pomalu se měnící sadu serverů a chce víc než jen běží/neběží: latenci požadavků v čase, trendy paměti, disk, který se plní dost pozvolna na to, aby to bylo vidět týdny dopředu. Pokud dokážete svou infrastrukturu popsat dnes a čekáte, že ten popis bude zhruba platit i za rok, pak je večer strávený nasazením poslední velká položka.
Druhý je každý, kdo se tenhle stack učí záměrně. Pokud počítáte s tím, že za pár let budete provozovat infrastrukturu, svoji nebo cizí, je večer s PromQL přesně to, pro co jste přišli, a monitoring je vedlejší produkt. Tenhle profil první částečně obrací: test stability tu váží míň, protože čas strávený přeznačkováním je zároveň časem stráveným učením se, co přeznačkování vlastně je. Pro tohohle čtenáře bych hodnocení posunul nahoru.
Třetí profil je o vlastnictví a je to ten, který lidé podceňují, dokud se sami neocitnou na špatné straně. Prometheus neúčtuje za hosta, za metriku ani za label a žádná ceníková stránka se vám příští čtvrtletí nezmění pod nohama. Výměna oproti spravované službě typu Datadog: vzdáte se uhlazenosti, smlouvy o podpoře a cizí pohotovosti a výměnou dostanete metriky, které jsou vaše, na účtu, který se nepohne, když vývojář přidá další měření. Jestli je to dobrý obchod, záleží na tom, kolik stojí vaše vlastní hodiny, a to číslo umíte doplnit jen vy (a málokdy je nulové, i když to tak působí).
Jednu věc je dobré vědět, než se rozhodnete: přerůst lokální úložiště Prometheus není slepá ulička. VictoriaMetrics přijímá remote write z Prometheus, a MetricsQL je zpětně kompatibilní s PromQL, takže většina dotazů a dashboardů v Grafaně, které dnes postavíte, by měla přechod přežít. Je to migrace, ne přepis.
Stojí za to jednou ročně přehodnotit, spíš než rozhodnout jednou provždy: sestava, která se dnes monitoruje levně, zdraží ve čtvrtletí, kdy ji začnete přestavovat.

Stavte na Linux VPS s root přístupem, NVMe a výkonem AMD EPYC.
Zobrazit Linux plányKdo by měl Prometheus vynechat?
Pokud věta, kterou byste popsali svoji potřebu, zní „dej mi vědět, až web spadne“, popisujete kontrolu dostupnosti a Prometheus je na tuhle odpověď hodně stroje. Uptime Kuma dělá přesně tuhle práci ve webovém rozhraní a nechce po vás, abyste se učili monitorovací dotazovací jazyk. Rozdíl ve schopnostech mezi těmi dvěma nástroji je obrovský a pro práci, na kterou je najímáte, naprosto nepodstatný.
Druhý čtenář je ten, kdo chce použitelné grafy, aniž by se napřed učil dotazovací jazyk. Netdata je postavená přesně kolem toho: metriky po hostech, na které se můžete okamžitě podívat, s mnohem menší konfigurací a s ničím mezi vámi a grafy. Pokud si pořád kladete otázku „proč je tenhle stroj zrovna teď pomalý“, tohle je mnohem kratší cesta k odpovědi.
Třetí je každý, komu infrastruktura často mění tvar a kdo si cíle a proměnné dashboardů spravuje ručně. Hosti nastartovaní na týden a zase zrušení, přejmenované cíle, projekty přejmenované v půlce cesty. To je případ, kdy platíte konfigurační náklad znovu a znovu a přitom máte nejmenší užitek z toho, co si platíte, tedy ze souvislé historie systému, který zůstává rozpoznatelný.
Nic z toho není výtka vůči nástroji. „Vynechat“ tu znamená vynechat pro tuhle práci a v tomhle měřítku. V měřítku Kubernetes, kde service discovery obstará většinu toho, co byste jinak drátovali ručně, se několik nákladů výše zmenší nebo úplně zmizí, a tohle měřítko čtu tak, že Prometheus je v něm hodně těžké porazit. To je ale jiná recenze.

Časté dotazy
Je Prometheus zdarma?
Ano a není pod tím žádný háček s bezplatnou úrovní. Prometheus je licencovaný pod Apache 2.0 a žádná komerční edice za ním nestojí, takže není žádná kvóta metrik, kterou byste překročili, ani výzva k upgradu čekající na druhé straně. Platíte za infrastrukturu a za svůj vlastní čas, ne za licenci Prometheus.
Potřebuje Prometheus Grafanu?
Ne, ale počítejte s ní. Prohlížeč výrazů v Prometheus existuje proto, abyste spustili dotaz a podívali se na odpověď, což pokryje jednorázovou kontrolu jedné věci. Cokoli, co chcete nechat otevřené na druhém monitoru, je práce pro Grafanu, a obojí se skoro vždycky provozuje společně.
Není Prometheus na jediný server zbytečně velký?
Často ano. Pokud potřebujete jen vědět, jestli server a jeho služby běží, kontrola dostupnosti vám na to odpoví ve zlomku doby nasazení. Prometheus si své místo zaslouží tehdy, když chcete historické metriky, na které se dá dotazovat, a jste ochotní se kvůli nim naučit PromQL.
Jak dlouho Prometheus uchovává metriky ve výchozím nastavení?
15 dní a předem vás nevaruje. Prometheus zahazuje vzorky starší, než je okno uchovávání, pokud ho při startu nezvýšíte parametrem doby nebo velikosti uchovávání. Nastavte si to hned v den instalace, protože rozšíření okna později už vypršelá data nevrátí.



Diskuse
Komentáře
Přihlaste se a zapojte se do diskuse.