
Deux bases de données peuvent occuper le même espace disque et nécessiter des VPS différents. L'une relit un petit ensemble de lignes ; l'autre soutient des écritures, construit de gros index ou doit redémarrer rapidement après une panne. Choisir le meilleur VPS pour héberger une base commence par ces différences, avant de comparer les fournisseurs.
Avec un VPS non infogéré, vous assumez aussi l'exploitation de la base. PostgreSQL, MySQL et MariaDB ont des besoins mémoire différents, et la capacité de reprise doit être prévue avec le serveur principal. La configuration initiale doit garder de la marge pour les sauvegardes et la maintenance, puis réussir un test représentatif de la charge.
Dimensionner la charge de la base avant de choisir une offre
Mesurez données et index actifs, requêtes simultanées au pic, croissance et besoins de reprise avant de choisir CPU, RAM et disque. Ajoutez des ressources selon la contrainte mesurée. Prévoyez l'espace de maintenance et le pic de consommation de l'application si elle partage l'hôte ; le budget doit couvrir les périodes chargées comme le fonctionnement habituel.
L'ensemble de travail regroupe les données et index consultés assez souvent pour bénéficier d'un maintien en mémoire. La taille stockée inclut aussi les données froides. De même, connexions ouvertes et requêtes actives diffèrent : clients inactifs et tris simultanés n'exigent pas la même mémoire ni le même CPU. Relevez les deux, la forme des requêtes et le rapport lectures/écritures.
Établissez vos critères d'achat à partir d'une période chargée représentative :
- Mesurez le pic mémoire de l'application si elle partage le VPS.
- Relevez la taille des données et index, l'ensemble de travail estimé, les opérations simultanées et la croissance sur l'horizon de capacité prévu.
- Mesurez la production de journaux et identifiez la plus grosse construction d'index, réécriture de table ou autre opération de maintenance attendue.
- Fixez la latence p95 cible de l'application, la fenêtre de perte de données acceptable et le délai de restauration cible.
- Décidez où l'application sera exécutée et testez le chemin vers la base.
La documentation de supervision de PostgreSQL recommande de combiner statistiques de la base et outils du système. Mesurez CPU, pression mémoire et activité disque avec les durées des requêtes et validations. Une hausse de latence pendant une sauvegarde doit être étudiée, même si un contrôle du serveur au repos semble satisfaisant.
Les vCPU dédiés donnent un accès soutenu aux ressources CPU allouées. Ils ne fournissent ni serveur physique entier ni niveau d'IOPS garanti. Évaluez séparément allocation CPU, mémoire et comportement du stockage. Si les besoins mesurés dépassent les VPS disponibles, étudiez du matériel dédié plutôt que d'extrapoler à partir du nom d'une offre supérieure.
Associer les charges SQL à une configuration initiale
Selon la compatibilité de l'application, prenez PostgreSQL 16, MySQL 8.4 avec InnoDB ou MariaDB 11.4 avec InnoDB comme environnements d'exemple alternatifs. Ces moteurs ne sont pas interchangeables et ne sont pas présentés comme les dernières versions. Notez la version corrective installée avant le test ; les exemples ne précisent pas celle de l'image du fournisseur.
Héberger une petite application et sa base ensemble
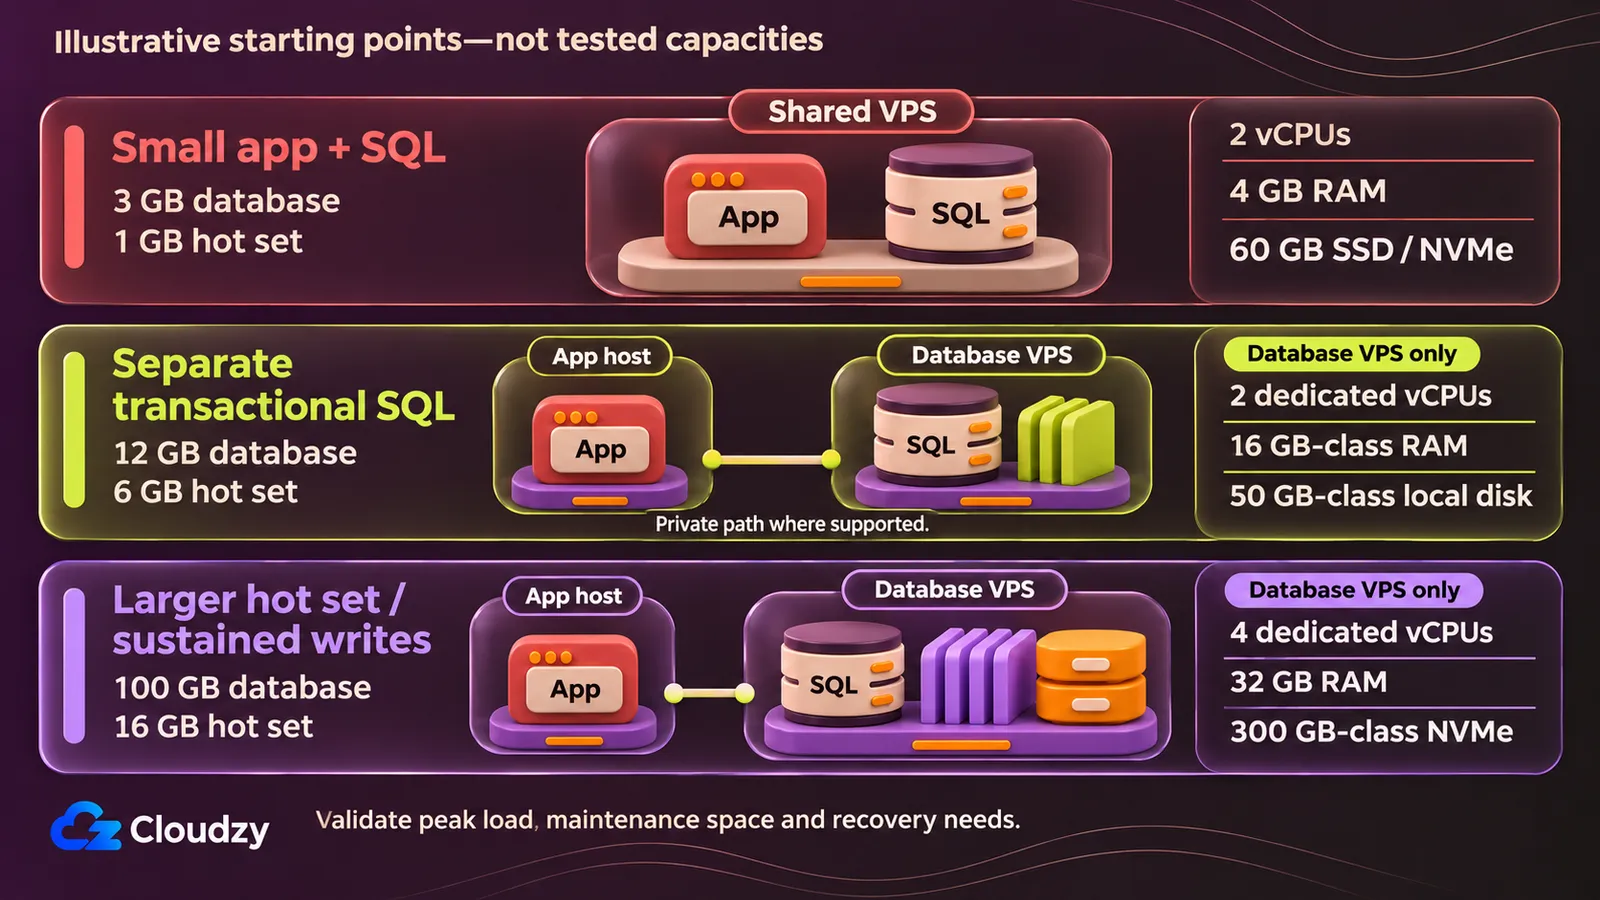
Pour une base supposée de 3 Go, dont 1 Go de données chaudes, et cinq requêtes indexées simples actives, testez un VPS à 2 vCPU, 4 Go de RAM et 60 Go de SSD ou NVMe nominaux. La connexion reste locale, mais application et base doivent tenir dans le même budget mémoire au pic.
Supposez 90/10 en lectures/écritures, 1 Go de croissance mensuelle et aucun long rapport pendant les sauvegardes. Un CPU partagé peut convenir à une préproduction tolérante. Choisissez des ressources dédiées si la contention prolongée dégrade trop les temps de réponse ; la comparaison des offres de production ci-dessous utilise uniquement des vCPU dédiés.
Voici une enveloppe RAM proposée, tous les chiffres étant en Go :
| Consommateur | RAM supposée |
|---|---|
| OS et agents de supervision | 0.75 |
| Application au pic | 1 |
| Cache de la base | 1 |
| Cache du système de fichiers | 0.75 |
| Réserve pour requêtes, connexions et maintenance | 0.5 |
| Total | 4 |
Pour MySQL ou MariaDB, faites tenir le pool InnoDB dans cette enveloppe. Appliquer à tout l'hôte un pourcentage prévu pour un serveur de base dédié consommerait la mémoire de l'application. Avec PostgreSQL, comptez séparément les tampons partagés et la mémoire des opérations dans l'allocation et la réserve de la base. Mesurez le pic cumulé avant d'accepter l'une ou l'autre configuration.
Exemple d'enveloppe disque : 5 Go pour OS/journaux, 3 Go pour données/index, 4 Go pour journaux du moteur, 3 Go temporaires et 6 Go de croissance, soit 21 Go. La capacité nominale restante couvre les surcoûts du système de fichiers et les travaux transitoires ; elle ne justifie pas de conserver les sauvegardes sur le serveur principal.
Connectez-vous par socket local ou localhost. Testez les validations durables avec application et sauvegarde actives, notamment la synchronisation du stockage (fsync), qui demande à l'OS d'écrire les données sur un stockage durable. Si le responsable accepte un RPO de 24 heures, la perte de données acceptable, et un RTO de quatre heures, le délai de reprise cible, proposez une sauvegarde native nocturne hors du nœud et prouvez le temps de restauration lors d'un exercice. Si mémoire, latence ou reprise dépassent le budget, séparez, redimensionnez ou revoyez la reprise après diagnostic des requêtes et index.
Séparer une base SQL transactionnelle
Pour une application hébergée ailleurs, une base SQL illustrative de 12 Go, dont 6 Go chauds, peut commencer les tests sur 2 vCPU dédiés, environ 16 Go de RAM et 50 Go de stockage local. Cela suppose 20 requêtes indexées actives, des écritures courtes et peu de calcul soutenu ; des opérations plus lourdes peuvent invalider ce budget.
Supposez 90/10 en lectures/écritures et 1 Go de croissance mensuelle sur trois mois. C'est la charge de référence du tableau des fournisseurs. Les unités diffèrent selon les offres : comparez mémoire réellement disponible et octets utilisables avant d'appliquer les allocations.
Pour un VPS PostgreSQL, les recommandations sur les tampons partagés de PostgreSQL 16 partent de 25 % de la mémoire système sur un serveur dédié à la base disposant d'au moins 1 Go de RAM. PostgreSQL utilise aussi le cache de l'OS. Budget proposé sur 16 Go : 4 Go de tampons partagés, 2 Go OS/agents, 2 Go de réserve requêtes/connexions/maintenance et 8 Go de cache de fichiers/marge.
La réserve n'est pas une valeur de work_mem. La documentation mémoire des opérations de requête de PostgreSQL explique que chaque tri et hachage peut allouer de la mémoire pendant que plusieurs sessions travaillent. Les hachages utilisent aussi hash_mem_multiplier. Fixez les limites selon la simultanéité autorisée ; une valeur élevée par opération peut dépasser le budget malgré des tampons partagés suffisants.
Pour MySQL sur VPS, les recommandations du pool de tampons MySQL 8.4 d'Oracle indiquent généralement 50–75 % de la mémoire système, en tenant compte de l'OS et des autres allocations. Testez ici un pool InnoDB de 8 Go, en gardant le reste pour ces consommateurs et les pics.
Un VPS MariaDB demande un calcul un peu différent. Les recommandations d'allocation mémoire de MariaDB proposent 60–70 % de la RAM disponible après OS/services pour un système essentiellement InnoDB. Sur 13 Go disponibles, cela donne 7,8–9,1 Go ; un pool initial de 8 Go convient à cet exemple. MyISAM ou Aria demandent un budget de cache séparé. Ces budgets sont des alternatives : ne les additionnez pas.
Budget disque : 12 Go données/index + 3 Go croissance + 5 Go OS + 4 Go journaux + 8 Go temporaires/maintenance = 32 Go. Un disque d'environ 50 Go laisse environ 18 Go nominaux avant les surcoûts du système de fichiers. Exigez au moins 15 Go libres mesurés dans cet exemple ; davantage de journaux conservés ou de réécritures l'invalident.
Rapprochez application et base, sur un chemin privé testé si disponible, avec authentification, contrôles d'accès et chiffrement. Vérifiez latence des requêtes et validations durables pendant checkpoints, vidages et sauvegardes. Prévoyez un stockage de sauvegarde indépendant ; le cas de reprise ci-dessous le détaille. Redimensionnez après diagnostic des requêtes/index si une ressource sature, si l'espace libre manque ou si les objectifs de reprise échouent.
Prévoir des ensembles de travail plus grands ou des écritures soutenues
Pour une base supposée de 100 Go dont 16 Go chauds, testez 4 vCPU dédiés, 32 Go de RAM et environ 300 Go NVMe. Séparez l'application. Cet exemple autorise 30 requêtes mixtes actives et un rapport 60/40 lectures/écritures ; mesurez exécution et pression du stockage avant de choisir la ressource à augmenter.
Supposez 10 Go de croissance mensuelle sur trois mois. Enveloppe PostgreSQL : 8 Go de tampons partagés, 4 Go de réserve OS/requêtes/maintenance et 20 Go de cache de fichiers/marge. Pour MySQL ou MariaDB, un pool InnoDB d'environ 16 Go constitue une alternative initiale après réserve des autres consommateurs. Les paramètres PostgreSQL ne se transposent pas à ces moteurs.
Le stockage doit couvrir les travaux en cours. Budget : 100 Go données/index + 30 Go croissance + 30 Go journaux conservés ou en attente + 60 Go pour la plus grosse opération temporaire/de maintenance prévue + 10 Go OS = 230 Go. Il reste environ 70 Go nominaux. Une réécriture de table plus importante impose un nouveau calcul, même si la croissance quotidienne reste faible.
La documentation du vacuum courant de PostgreSQL distingue VACUUM, qui rend réutilisable l'espace des lignes mortes, de VACUUM FULL, qui crée une nouvelle copie de la table et nécessite temporairement du disque supplémentaire. Acheter à peine plus de disque que le volume des données peut empêcher la maintenance nécessaire pour récupérer de l'espace.
Mesurez séparément exécution CPU, pression du cache, E/S physiques et latence d'écriture. Incluez écritures temporaires et périodes de checkpoint/vidage dans le test. NVMe et CPU dédiés décrivent la configuration, sans garantir d'IOPS. Testez aussi les transferts soutenus de sauvegarde et réplication, avec connexion privée proche pour l'application et stockage de reprise indépendant. Une production de journaux plus rapide modifie rétention et demande réseau. Augmentez cœurs, RAM ou disque selon la contrainte observée, pas parce que l'offre suivante augmente les trois.
Ajouter une capacité de reprise en production
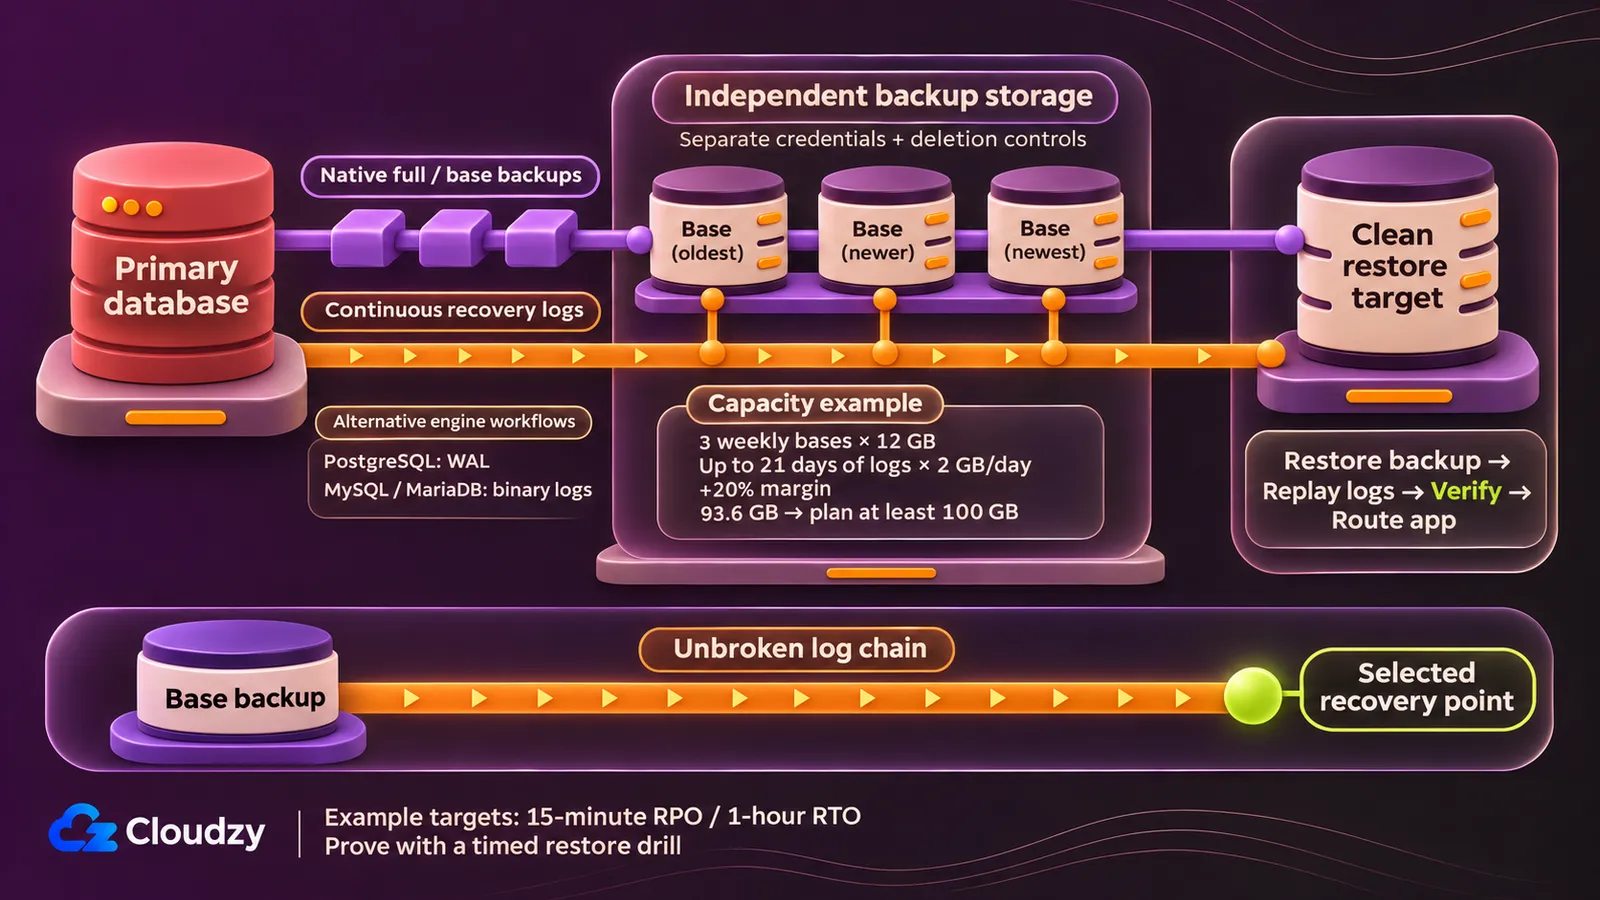
Une perte acceptable de 15 minutes et un délai de restauration cible d'une heure nécessitent plus que le budget du serveur principal. Gardez les hypothèses de la base transactionnelle séparée, puis ajoutez sauvegardes natives, journaux de reprise conservés, stockage indépendant et exercice chronométré. Ces durées sont des objectifs de planification ; seul l'exercice confirme leur respect.
La documentation d'archivage continu de PostgreSQL décrit une sauvegarde de base et une archive ininterrompue des journaux WAL pour la restauration à un instant donné. La documentation de reprise MySQL d'Oracle utilise une sauvegarde complète puis des journaux binaires. La procédure PITR de MariaDB restaure les sauvegardes complètes/incrémentales avant de rejouer les journaux binaires. Ces flux MySQL/MariaDB nécessitent leur activation.
Exemple de capacité : chaque sauvegarde complète/de base non compressée fait 12 Go. Gardez trois bases hebdomadaires et tous les journaux nécessaires depuis le début de la plus ancienne. Prévoyez jusqu'à 21 jours de journaux à 2 Go par jour avec 20 % de marge :
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
Prévoyez au moins 100 Go de stockage indépendant sans compter sur la compression. Liez la suppression des journaux à l'expiration des sauvegardes et à leur remplacement réussi. Vérifiez que bases et journaux forment une chaîne complète pour chaque point de reprise promis.
Utilisez des sauvegardes sur une cible indépendante, avec identifiants et contrôles de suppression séparés du serveur principal. Un instantané fournisseur ne suffit pas à établir cette chaîne native. L'exercice doit créer une cible vierge, transférer et restaurer la sauvegarde, rejouer les journaux, vérifier la cohérence base/application et rediriger l'application. Chronométrez aussi provisionnement et transfert.
Un objectif d'interruption plus court peut nécessiter un réplica indépendant capable de porter toute la charge. Budgétez séparément CPU, RAM et disque ; définissez promotion, mise à l'écart de l'ancien primaire et routage client. Répétez la séquence. La réplication ne remplace pas les sauvegardes et un seul VPS n'assure pas la haute disponibilité. Revoyez la conception si la restauration dépasse une heure, si le retard d'archivage dépasse le RPO, si le secours ne supporte pas la charge ou si le stockage de sauvegarde approche sa limite.
Quand choisir un VPS infogéré plutôt que non infogéré
Si personne ne peut répondre aux alertes ou restaurer la base en incident, achetez une couverture opérationnelle explicite. Un VPS infogéré peut transférer certaines tâches, mais le contrat doit nommer celles qui concernent la base. Un panneau de contrôle ne suffit pas, et un VPS infogéré diffère d'une base de données gérée.
La différence entre les responsabilités des VPS infogérés et non infogérés devient utile tâche par tâche. Utilisez cette liste pour l'achat, sans supposer que chaque service couvre les mêmes travaux. L'infrastructure physique reste du ressort du fournisseur ; logiciels invités et exploitation de la base exigent un responsable explicite.
| Tâche | VPS non géré | Couverture à définir avant d'acheter l'infogérance |
|---|---|---|
| Correctifs et mises à niveau de l'OS invité et de la base | Vous les planifiez et les réalisez | Versions OS/moteur prises en charge, périmètre des correctifs, tests de mise à niveau et fenêtres de maintenance |
| Optimisation des requêtes, schémas et index | Vous diagnostiquez et modifiez | Optimisation incluse, limitée à la configuration du service ou facturée séparément |
| Supervision et incidents | Vous configurez les alertes et intervenez | Horaires de supervision, responsabilité d'intervention/escalade et personne agissant après une alerte |
| Sauvegardes et restaurations | Vous êtes responsable de la procédure de reprise | Rétention, stockage indépendant, aide à la restauration et preuves de tests |
Question utile au contrat : « Si le disque de la base se remplit pendant une sauvegarde, qui diagnostique, rétablit le service et vérifie la sauvegarde suivante ? » La réponse distingue accès au support et responsabilité du résultat. Posez aussi la question pour une mise à niveau du moteur ratée ou une suppression accidentelle.
Les bases gérées ont leurs propres engagements de cycle de vie du moteur, sauvegarde et basculement. Elles peuvent convenir davantage si vous voulez déléguer reprise et mises à niveau. N'en déduisez pas une optimisation de l'application ; conception des requêtes et comportement applicatif restent à attribuer sauf disposition contraire.
Attribuez chaque tâche une seule fois, avec escalade et contrôle d'acceptation. Comparez le prix à votre temps et disponibilité. Il n'existe pas de valeur horaire universelle de l'autogestion, et une facture de calcul faible ne règle pas un incident sans responsable.
Choisir un VPS pour les charges non SQL
Ces exemples distinguent mémoire, documents et indexation de recherche. Placez l'application près de la base et testez la connexion, ainsi que les transferts vers sauvegardes et réplicas éventuels.
| Charge et hypothèses | Configuration initiale à tester | Stockage, reprise et critères de changement |
|---|---|---|
| Redis cache/clé-valeur ; jeu de données mesuré de 2 Go | 2 vCPU dédiés, 8 Go de RAM ; réglez maxmemory sous la mémoire de l'hôte avec une réserve pour les surcoûts |
Un cache reconstructible peut accepter la perte. Un primaire persistant exige des réglages RDB/AOF réfléchis, de l'espace de réécriture et des sauvegardes indépendantes. Mesurez mémoire/RSS, fragmentation, évictions, pics de persistance et latence de queue. |
| MongoDB ; 20 Go de documents/index et petit ensemble chaud mesuré | 2–4 vCPU dédiés, 16 Go de RAM, environ 100 Go de disque local | Prévoyez journal/oplog, croissance et temporaire. Testez la restauration ; surveillez évictions du cache, E/S disque et retard de réplication. Budgétez CPU, RAM et disque de chaque réplica selon son rôle. |
| Elasticsearch ; petit volume d'index de 30 Go | 4 vCPU dédiés, 16 Go de RAM, environ 150 Go locaux par nœud de données concerné | Prévoyez réplicas, fusions de segments, rétention et instantanés indépendants. Contrôlez tas/GC, latences de recherche et indexation, E/S des fusions et disque. La résilience exige aussi une topologie de vote et un routage clients adaptés. |
Les conseils d'administration de Redis préviennent que sauvegardes RDB et réécritures AOF sous fortes écritures peuvent utiliser jusqu'au double de la mémoire normale selon les pages modifiées. Les 2 Go de données ne peuvent donc pas occuper toute la RAM. Sa documentation de persistance distingue instantanés RDB périodiques et journal AOF. Choisissez selon la perte acceptable, puis mesurez pics mémoire et disque pendant l'exécution.
La documentation du cache WiredTiger de MongoDB décrit les caches interne et de fichiers. Le cache interne par défaut est le plus grand de 50 % × (RAM − 1 Go) et 0,256 Go. Ses conseils sur les ensembles de réplicas recommandent trois membres stockant les données. Un arbitre vote mais ne stocke aucune donnée. Prévoyez aussi des sauvegardes indépendantes et mettez en place l'authentification MongoDB avant de connecter l'application.
La documentation des paramètres JVM d'Elastic recommande le dimensionnement automatique du tas. En manuel, utilisez les mêmes minima/maxima et au plus 50 % de la mémoire disponible. Ses conseils de résilience des petits clusters décrivent deux nœuds pouvant stocker les données et devenir maîtres, plus un arbitre votant uniquement. Configurez réplicas et routage vers les nœuds de données ; l'arbitre ajoute un vote, pas une copie. Si fusions ou rétention épuisent la réserve disque, revoyez le budget avant d'ajouter des documents.
Comparer les offres non infogérées pour votre configuration
Pour l'exemple SQL transactionnel séparé, filtrez les offres sur au moins 2 vCPU dédiés, environ 16 Go de RAM et 50 Go de stockage local. Une offre qui passe ce seuil est candidate aux tests. Différences CPU/disque, unités et engagements empêchent de traiter ces lignes comme du matériel équivalent ou un classement de performances.
Référence : Linux autogéré en Allemagne ou en Europe centrale proche, peu de données stockées mais davantage de mémoire. Proximité ne signifie pas même latence applicative. La connexion envisagée est privée si disponible ; les devis gardent l'IPv4 publique standard proposée. Supposez le transfert sous toutes les limites indiquées.
| Fournisseur et offre non infogérée | vCPU dédiés / RAM / disque local | Emplacement et transfert inclus | Prix, facturation et IPv4 |
|---|---|---|---|
| Cloudzy : notre Regular Dedicated CPU | 8 / 16 Go / 350 Go NVMe | Emplacements dans plusieurs régions du monde ; 10 To | 49,98 $/mois ; IPv4 et IPv6 incluses |
| Hetzner CCX23 | 4 / 16 Go / 160 Go NVMe | EU-central NBG1/HEL1 ; au moins 20 To dans l'UE | Plafond de 86,49 €/mois, dont 0,50 € pour l'IPv4 principale, hors TVA |
| DigitalOcean Memory-Optimized Droplet groupé, CPU Regular, SSD 1× | 2 / 16 Gio / 50 Gio NVMe | Famille disponible en FRA1 ; 4 000 Gio | Plafond de 84 $/mois ; 0,125 $/heure ; IPv4 publique incluse |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2 cœurs/16 Go/100 Go | 2 / 16 384 Mo / 100 Go NVMe | Francfort (fra) ; 6 144 Go |
80 $/mois ; 0,11 $/heure ; IPv4 attribuée par défaut ; confirmez les frais séparés ou la réduction sans IPv4 avant de budgéter |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16 384 Mo / 327 680 Mo SSD (offre de classe 320 Go) | Francfort (de-fra-2) indiqué disponible ; 6 000 Go |
173 $/mois ; 0,2595 $/heure ; IPv4 publique standard sans supplément |
La documentation de choix des offres DigitalOcean cite les Memory-Optimized pour bases SQL/NoSQL et caches. Je recommande cette famille groupée pour ce cas à petit disque et gros besoin mémoire. Un VPS optimisé mémoire n'est pas réservé au SQL. Si les mesures désignent plutôt capacité ou sollicitation soutenue du stockage comme contrainte, évaluez séparément la famille groupée Storage-Optimized.
Les cinq offres respectent le seuil de référence avec des surplus CPU/disque différents. Ils peuvent absorber la croissance, sans prouver une meilleure vitesse de base sans test. Le catalogue Hetzner ne garantit pas le stock commandable. Akamai indique du SSD pour G7 Dedicated. Optimized Memory chez Vultr est distinct de High Frequency Compute partagé.
Nos ressources dédiées conviennent à cette configuration autogérée au prix indiqué. Comparez ressources, devises, engagements et frais IPv4 de chaque fournisseur avant de juger la valeur globale.
Calculez le coût total : calcul + adresse + stockage/requêtes/transfert des sauvegardes indépendantes + capacité pour les tests de restauration + secours éventuel. Un coût inconnu n'est pas nul. Obtenez les tarifs de reprise actuels avant de comparer et vérifiez offre, emplacement et mise à niveau avant engagement. Ne déduisez pas une facture annuelle d'un équivalent mensuel arrondi.
Après le choix d'un moteur SQL compatible, nos applications en un clic raccourcissent l'installation. PostgreSQL, MySQL et MariaDB sont des choix distincts ; un choix n'installe pas les trois. Le déploiement reste autogéré : correctifs, réglages et reprise restent à votre charge.
Questions fréquemment posées
Le taux de réussite du cache PostgreSQL indique-t-il si le stockage est lent ?
Non. La documentation des statistiques d'E/S de PostgreSQL explique qu'une lecture peut être servie par le cache de l'OS sans accéder au disque. Combinez taux de cache, E/S système et durées des requêtes. Ce taux seul ne distingue pas retard physique du stockage et lectures servies depuis la mémoire du noyau.
Un export logique PostgreSQL permet-il une restauration ponctuelle fondée sur WAL ?
Non. Les exigences d'archivage continu de PostgreSQL indiquent que les exports logiques n'ont pas les informations nécessaires au rejeu WAL. Un export restaure l'état capturé ; la restauration ponctuelle WAL exige une sauvegarde de base adaptée et un archivage WAL continu. Choisissez le format selon la méthode de reprise prévue.
Le cache MongoDB doit-il utiliser la RAM de l'hôte dans un conteneur ?
Utilisez la mémoire disponible pour le conteneur. Les conseils sur la mémoire des conteneurs de MongoDB signalent que WiredTiger peut ignorer une limite de conteneur inférieure dans certains cas. Réglez le cache sous cette limite en gardant de la place aux autres processus ; la RAM totale de l'hôte peut surestimer celle accessible à la base.
Discussion
Commentaires
Connectez-vous pour participer à la discussion.