Recensione di AllTube Download: vale ancora la pena usarlo nel 2026?
AllTube Download è stato archiviato nel 2023 e non è più affidabile. Ecco una recensione onesta della sua situazione attuale e delle alternative ancora attive che oggi meritano il…
Seleziona un paese per vedere Cloudzy nella tua lingua.
Il blog di Cloudzy
AllTube Download è stato archiviato nel 2023 e non è più affidabile. Ecco una recensione onesta della sua situazione attuale e delle alternative ancora attive che oggi meritano il…
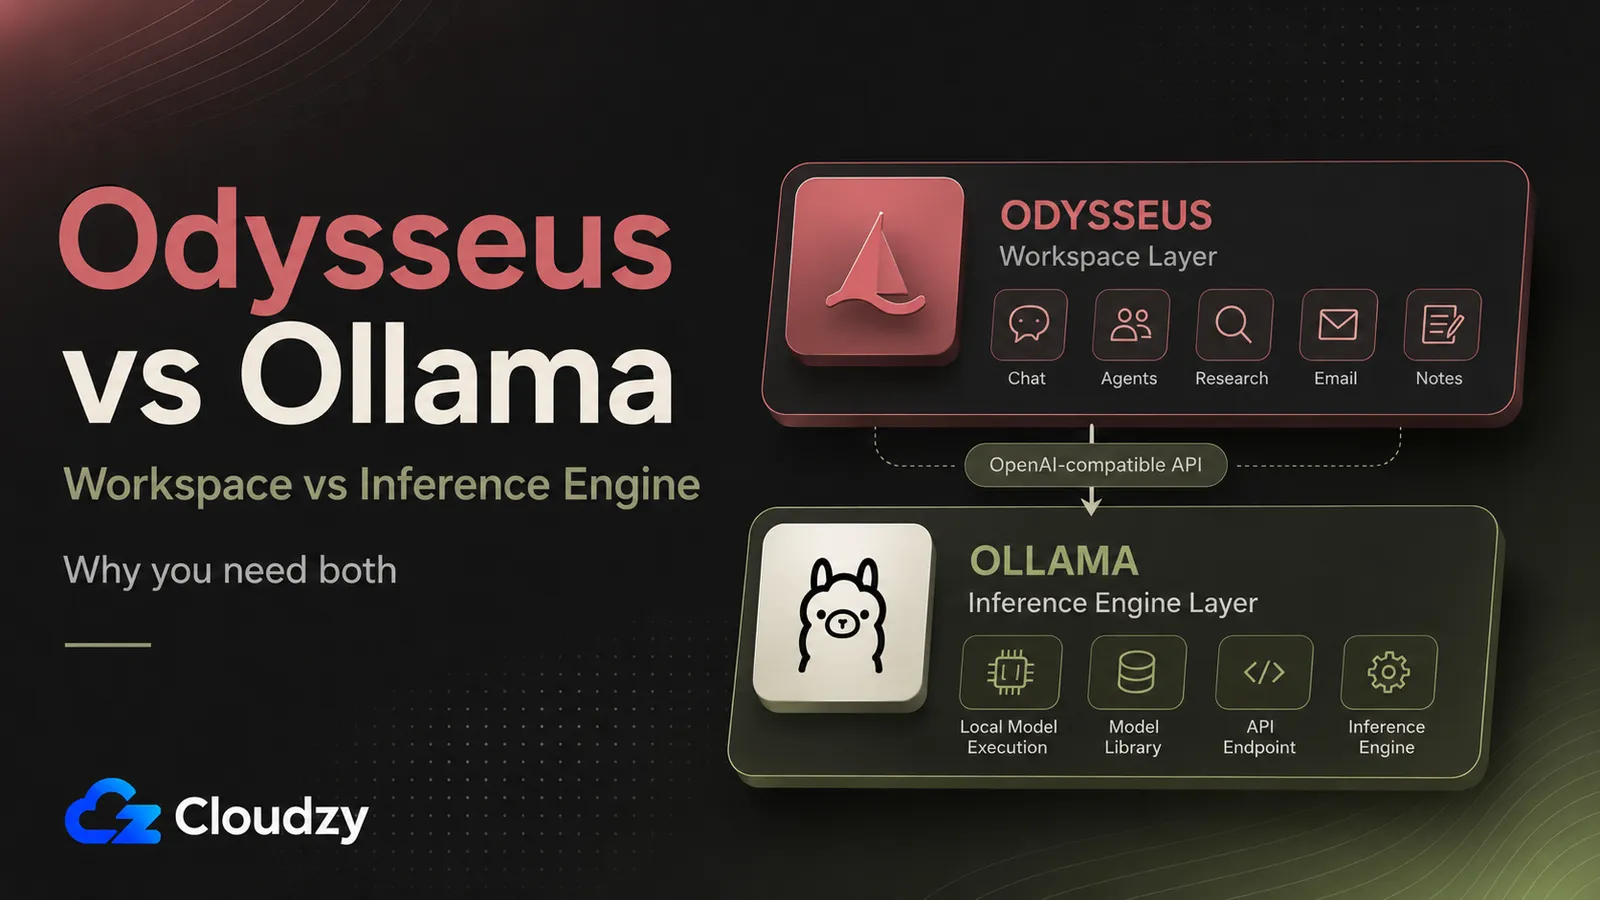
Odysseus e Ollama non sono concorrenti, uno è il tuo spazio di lavoro AI, l'altro esegue il modello. Ecco come si combinano e come ospitarli entrambi da solo.
Fare self-hosting di un LLM open-weight su un GPU VPS batte un'API solo sopra un pareggio che la maggior parte dei builder solitari non raggiunge mai. La matematica dei costi del…
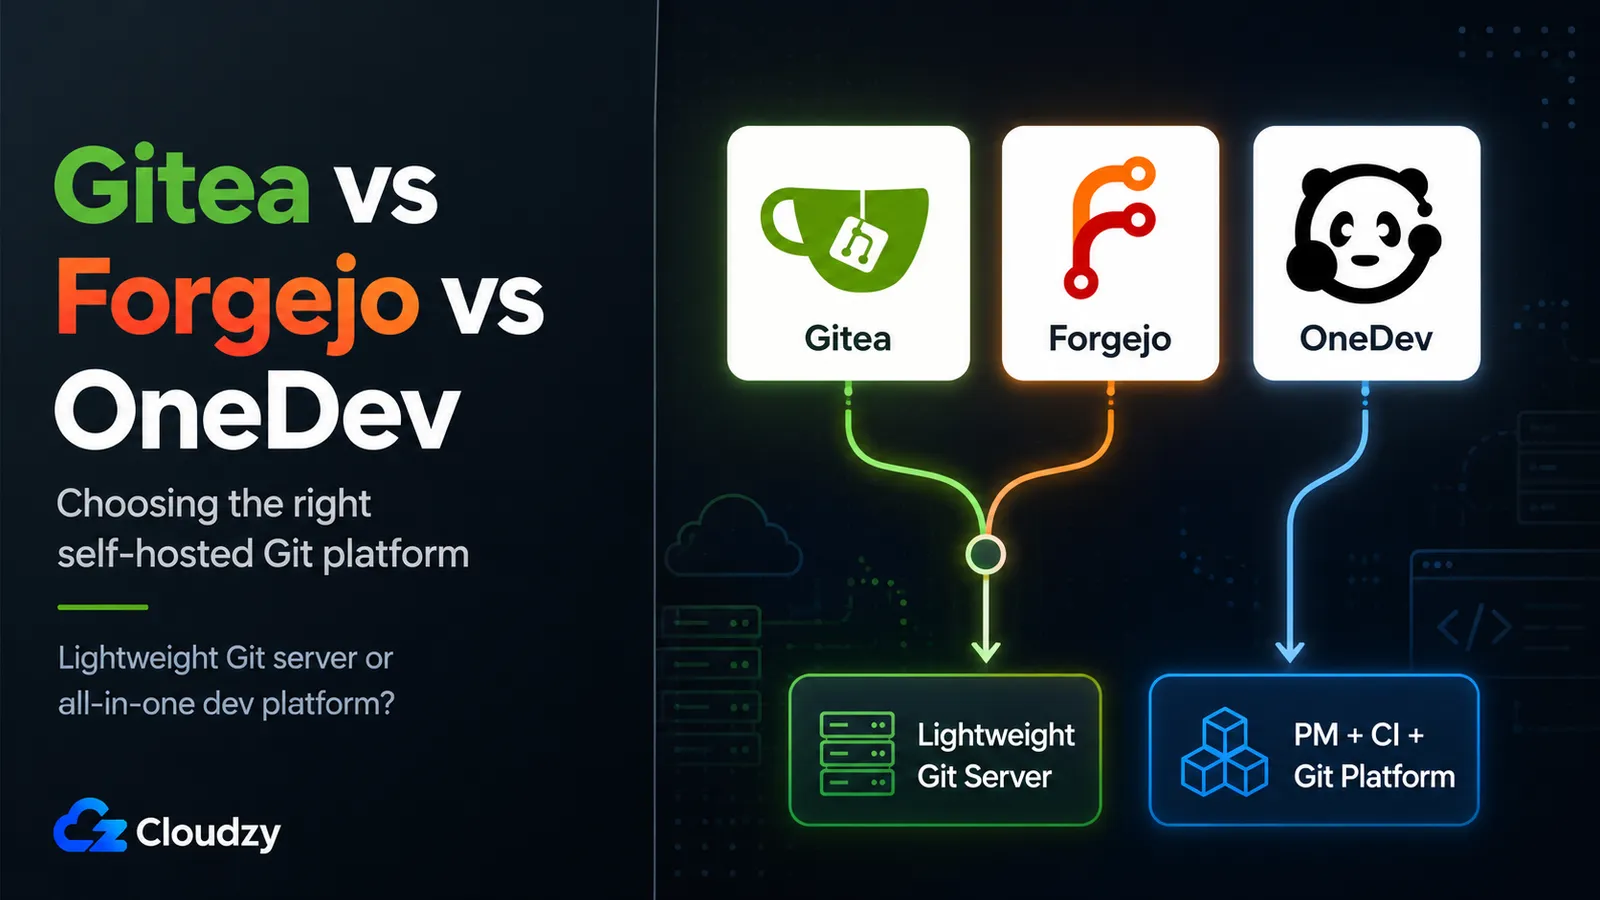
Gitea, Forgejo e OneDev a confronto per il self-hosting: governance, CI/CD, costo di RAM e quale si adatta al tuo team. Una guida diretta alla decisione, senza fronzoli.
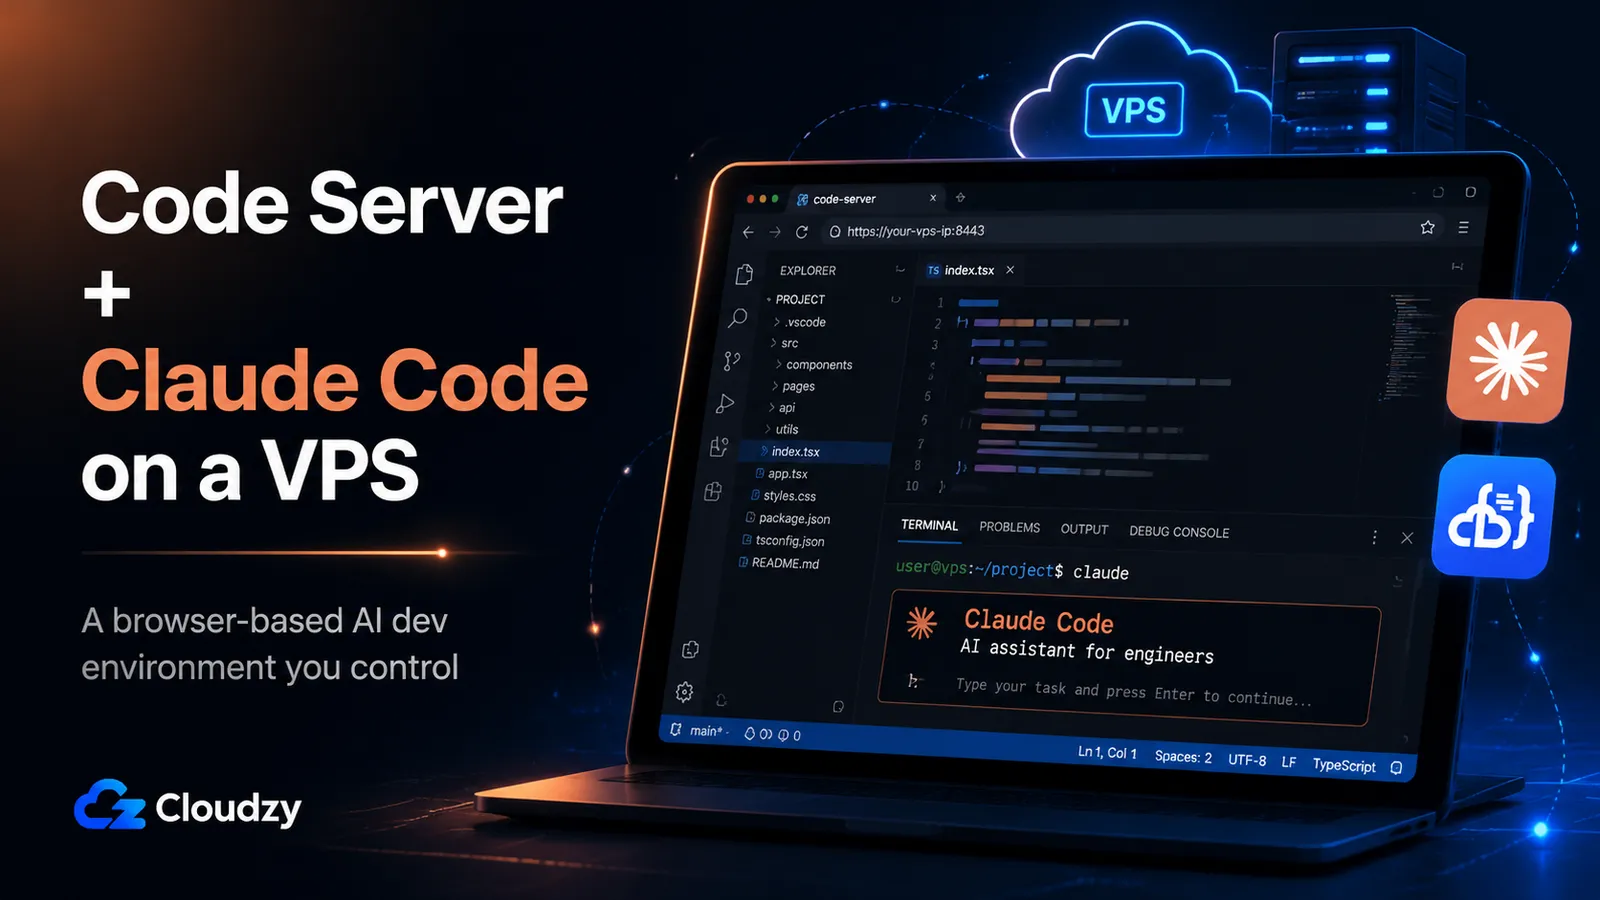
Configura Code Server e Claude Code su un singolo VPS Linux per un ambiente di sviluppo assistito dall'IA e basato su browser. Dimensionamento, installazione, autenticazione…
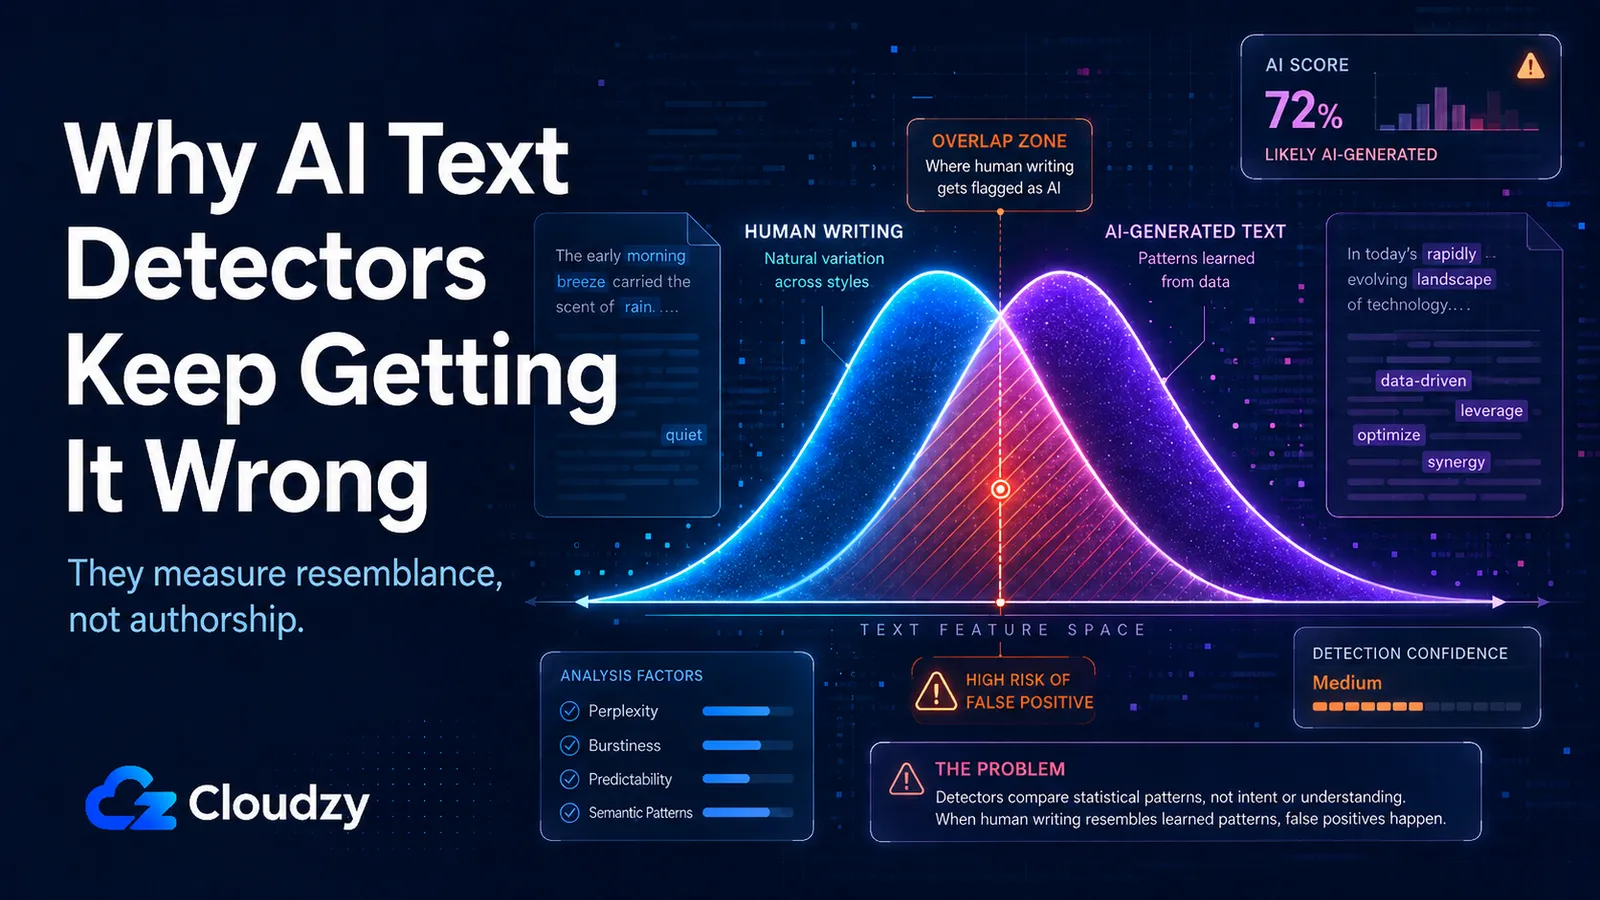
I rilevatori di IA non dimostrano la paternità. Misurano la somiglianza statistica. Ecco perché avvengono i falsi positivi e cosa funziona meglio.
Gli aggiornamenti diretti da Gitea a Forgejo si fermano a Gitea 1.22. Per Gitea 1.23+, confronta downgrade SQL, strumenti di migrazione, importazioni API, backup e cosa si rompe.
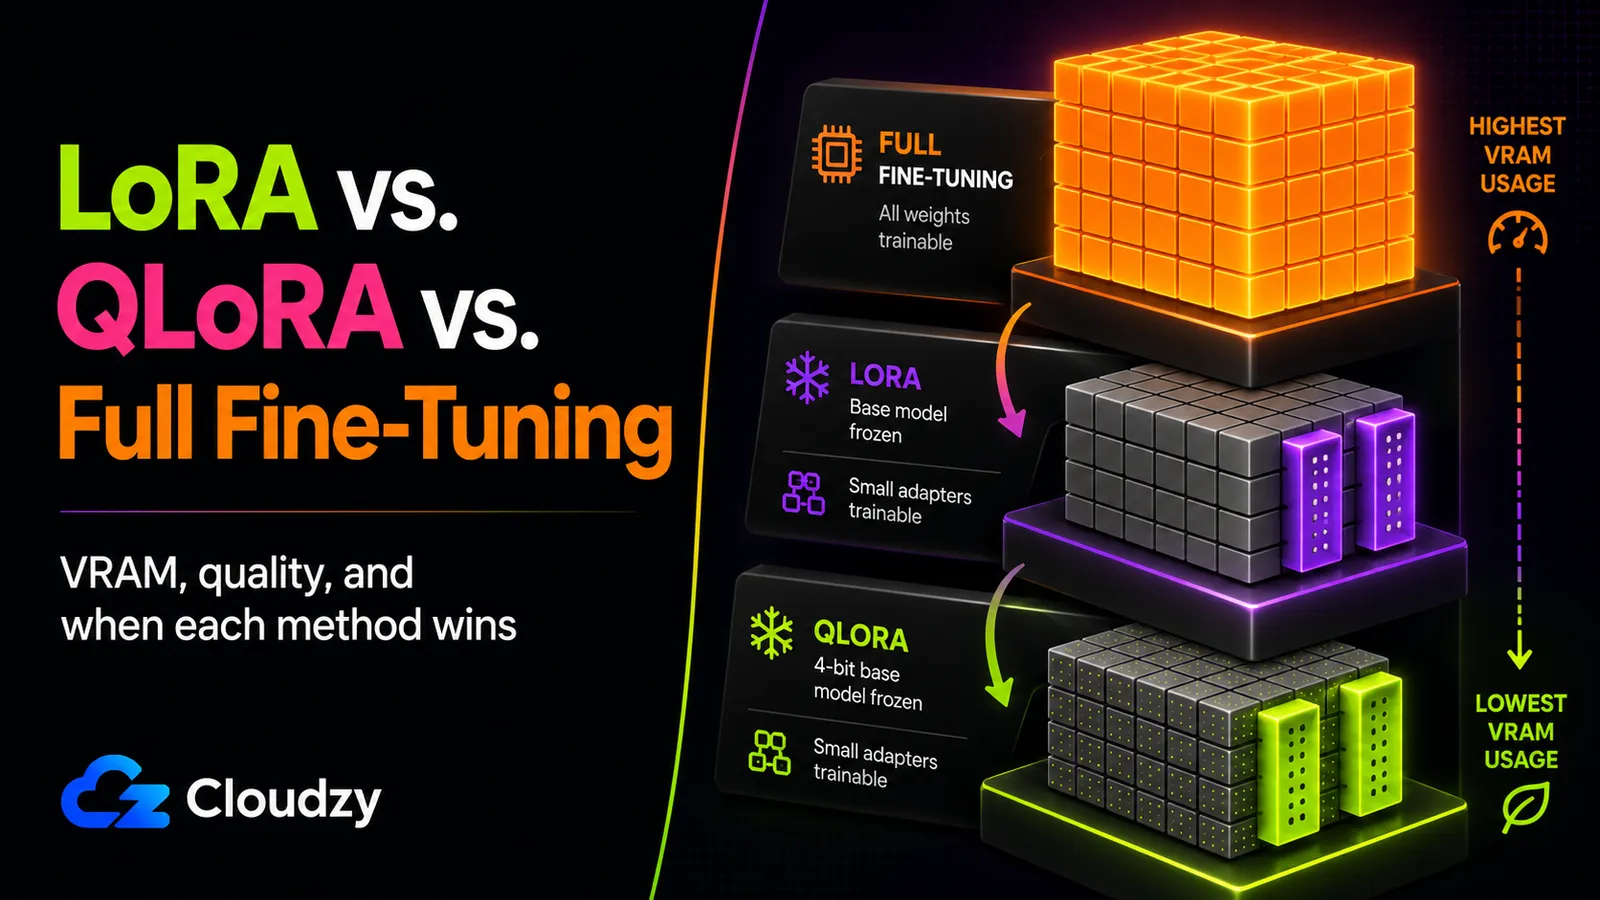
Confronta LoRA, QLoRA e full fine-tuning per VRAM, qualità e caso d'uso. Scopri quale metodo di fine-tuning per LLM si adatta al tuo budget GPU.
Quanto devi pagare per un computer ad alte prestazioni con le specifiche di cui hai bisogno? Le bollette internet ti impediscono di usare la connessione più veloce e stabile? Hai…
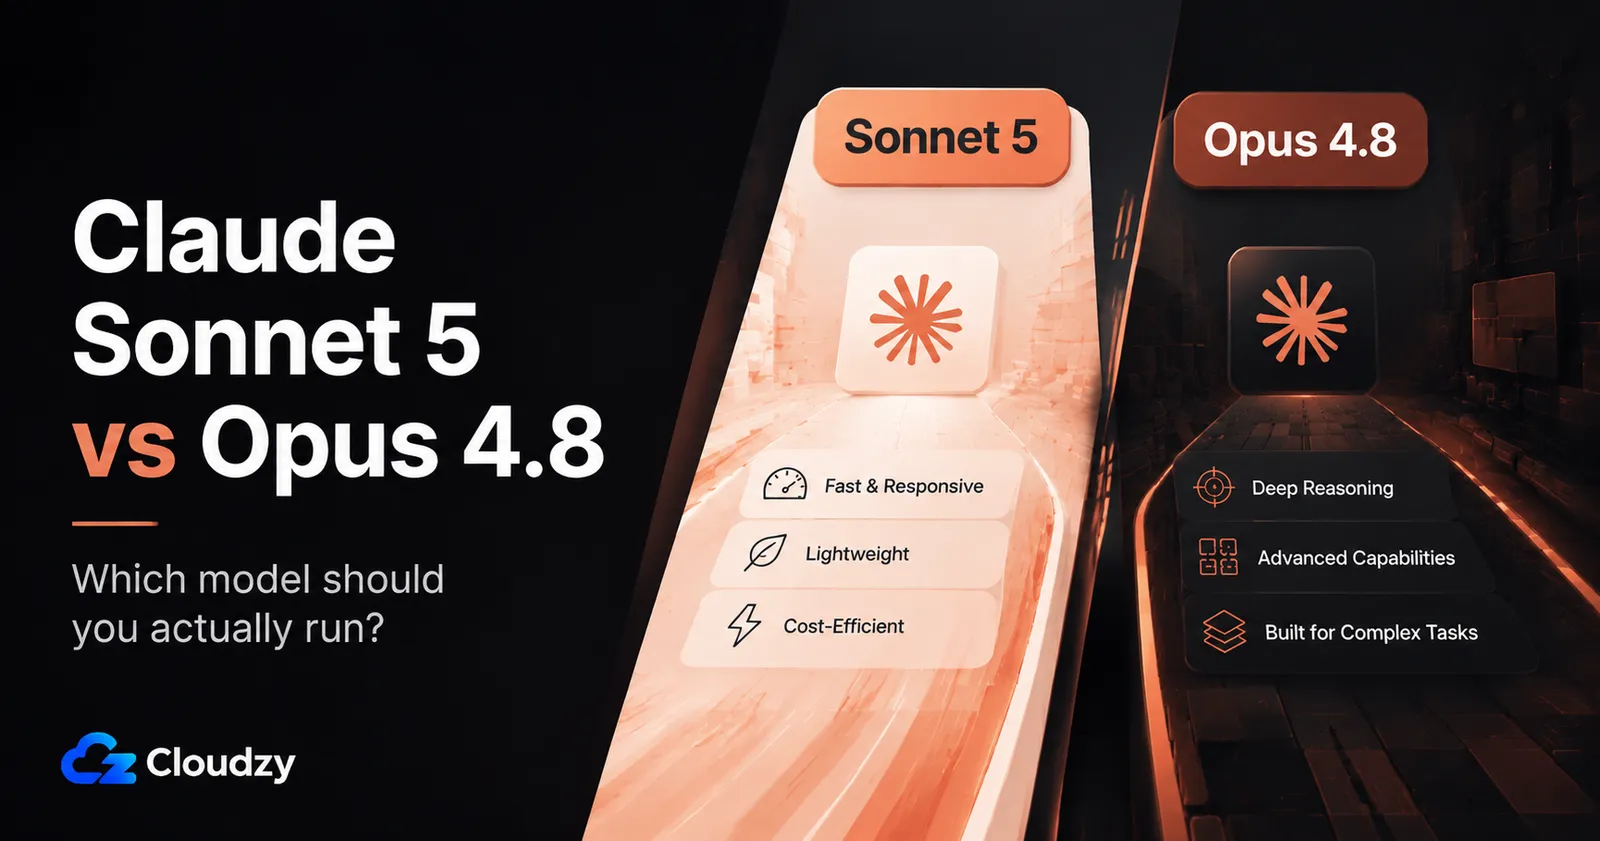
Sonnet 5 batte Opus 4.8 sul prezzo, ma il tokenizer è cambiato e le esecuzioni ad alto sforzo ribaltano il calcolo. Ecco quale modello usare e quando Opus vince ancora.
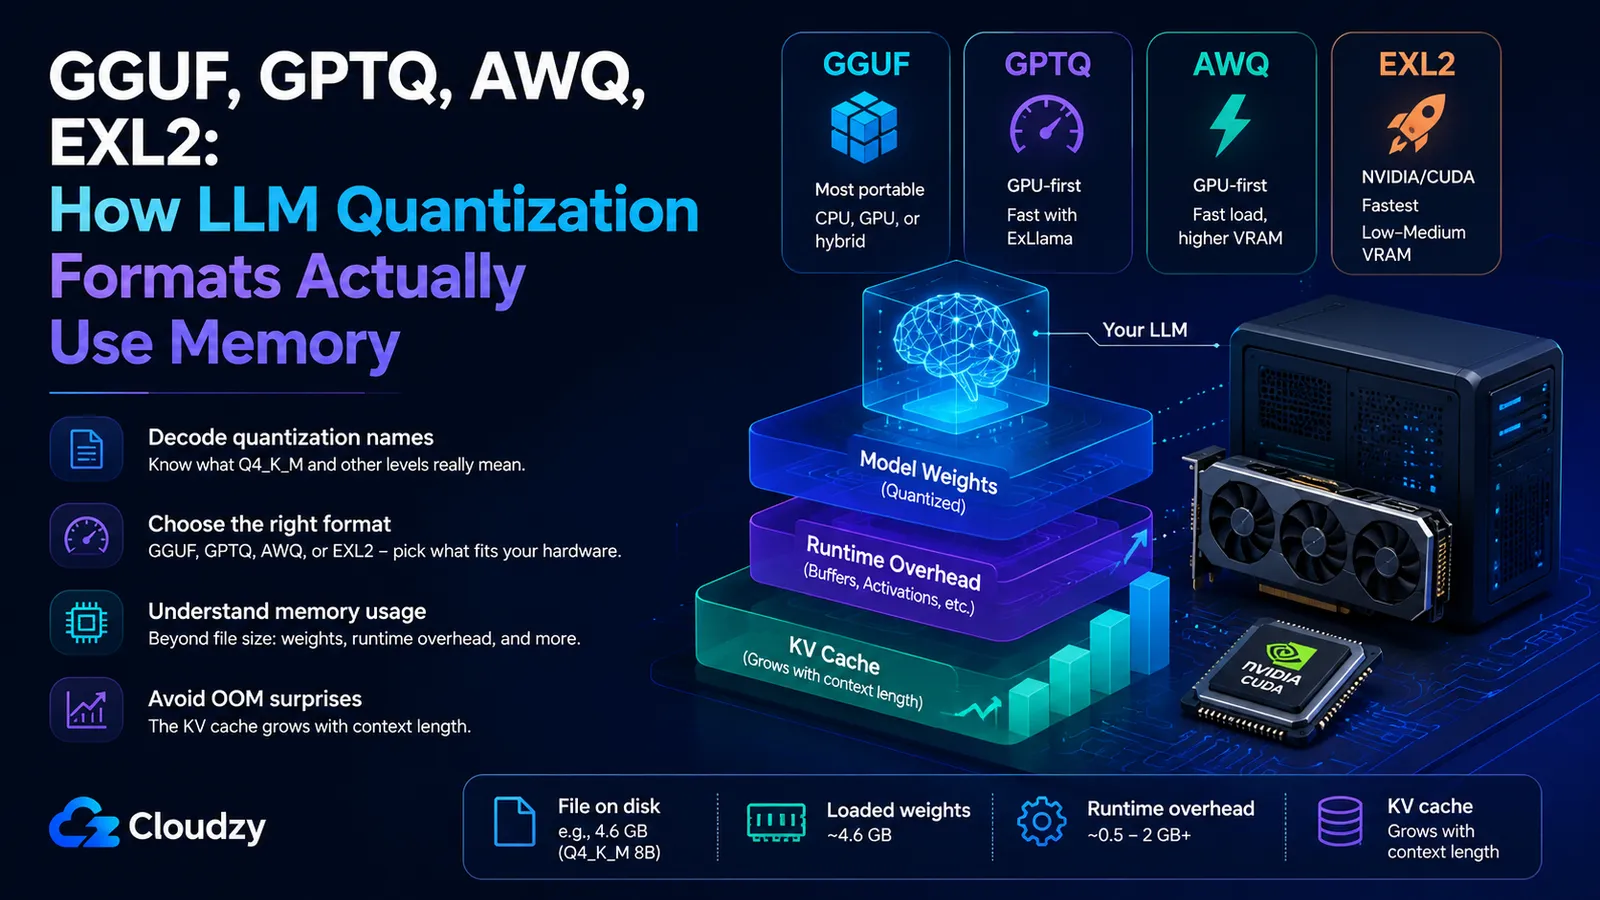
Confronta l'uso di memoria di GGUF, GPTQ, AWQ ed EXL2, dalla dimensione del file Q4_K_M alla crescita della cache KV e all'overhead di runtime.
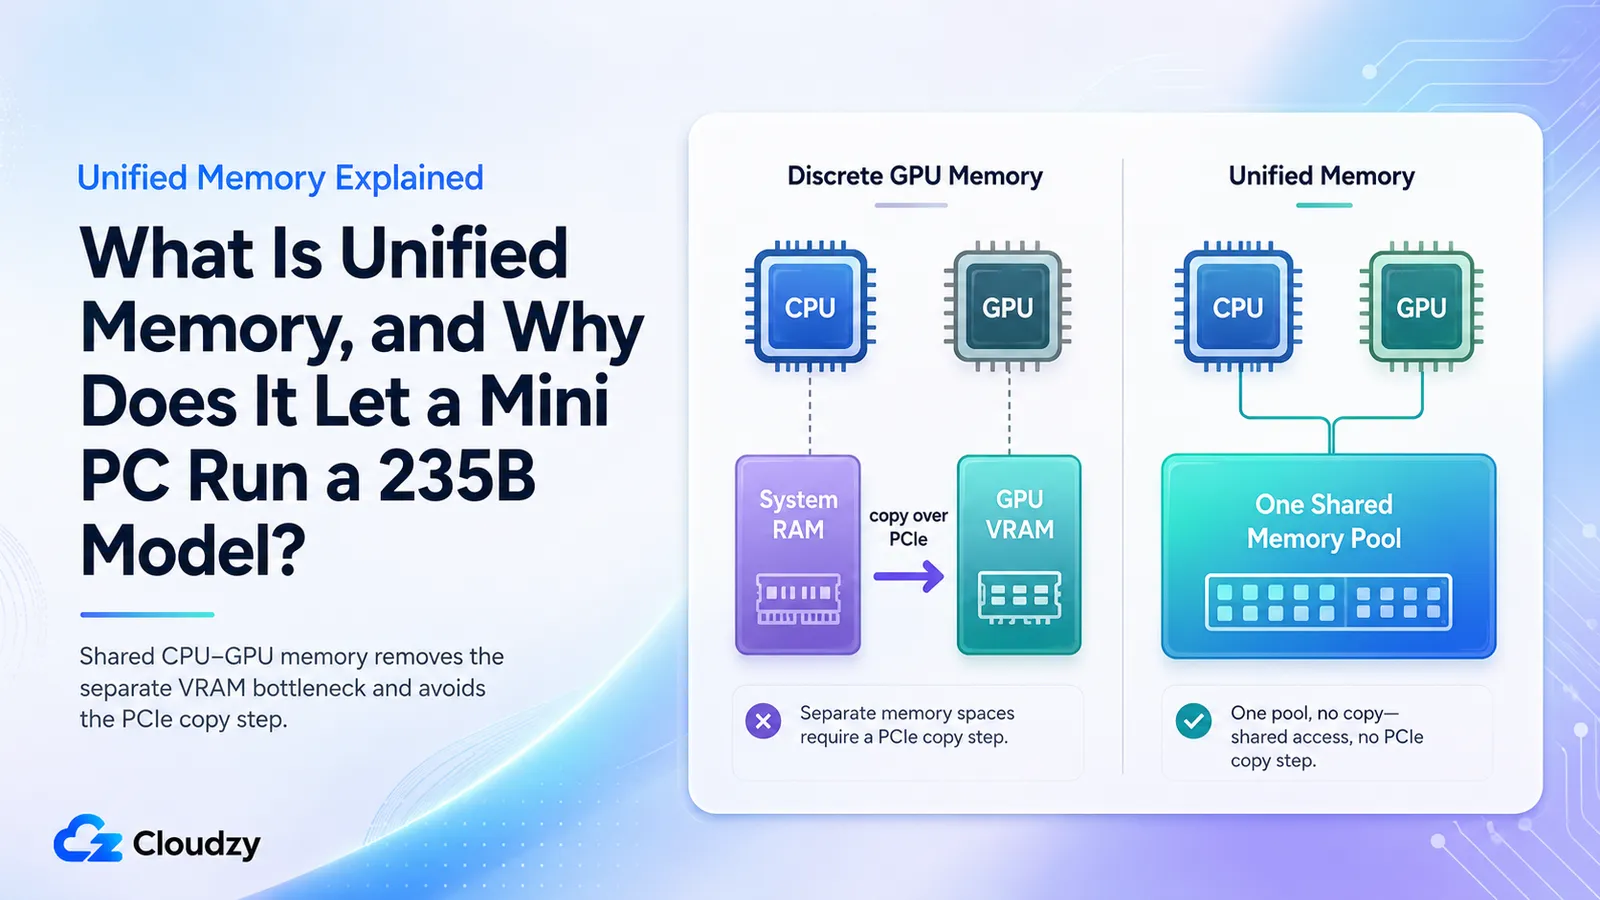
La memoria unificata permette a un PC AI compatto di caricare modelli di classe 235B che nessuna singola GPU da 24-32GB può contenere. Cos'è, perché funziona e perché più grande…