
r/linuxquestions의 한 사용자가 모두가 계속 논쟁하는 그 비교를 직접 해봤습니다. CachyOS를 설치하고 Ryzen 7 7800X3D와 Radeon RX 7900 XTX에서 여러 게임을 벤치마크했지만, 이미 그 머신에 있던 다른 배포판과 아무 차이도 측정되지 않았습니다. 답글은 늘 그렇듯 흘러갔습니다. 한 사람은 상한을 일상 사용에서는 보이지 않을 만큼 낮게 잡았습니다. 다른 사람은 스케줄러를 설명했습니다. 세 번째 사람은 벤치마크로는 스케줄러가 하는 일을 보여줄 수 없다고 했습니다. 아무도 논쟁을 끝낼 측정치를 내놓지 않았습니다.
질문은 늘 같은 말로 돌아옵니다. CachyOS는 정말 더 빠를까? 짧은 답은 '특정 워크로드에서는 그렇다'입니다. 재컴파일된 패키지는 컴파일러가 벡터화할 수 있는 코드에 도움이 되고, 여기서 인용한 게임 비교는 평균 FPS 차이가 거의 없으며, 전환 후 더 빠르게 느껴지는 시스템은 배포판 전환이 변수 하나보다 훨씬 많은 것을 바꾸기 때문에 원인을 특정하기가 더 어렵습니다.
이 문제가 결론 나지 않는 이유는 "더 빠르다"는 말에 서로 다른 답을 가진 세 가지 별개의 주장이 담겨 있고, 각각 자기만의 측정 도구가 필요하기 때문입니다. 재컴파일된 패키지는 작업을 더 짧은 실제 시간에 끝내거나, 그렇지 않거나 둘 중 하나입니다. 스케줄러는 경합 상황에서 데스크톱의 동작을 바꾸거나, 바꾸지 않거나입니다. 그리고 더 쾌적해진 머신의 원인은 CachyOS이거나, 함께 딸려온 다른 무언가입니다.
요약
- 재컴파일된 패키지: 측정 가능하게 더 빠르지만, 실행하는 것 중 소수에서만. 이득은 컴파일러가 벡터화할 수 있는 코드에 집중되고, 몇몇 패키지는 오히려 느려지며, 대부분은 변화가 없습니다. sunnyflunk.github.io의 2023년 1월 arch-chroot 비교는 Intel NUC8i5BEK에서 같은 실행 안에 flac 인코딩이 20.2% 빨라지고 bzip2 압축 해제가 7.1% 느려진 것을 확인했습니다.
- 스케줄러 이야기는 둘로 갈립니다. CachyOS의 현재 기본 커널은 EEVDF를 사용하고, BORE는 별도로 제공됩니다. 2026년 5월의 배포판 비교는 평균 FPS 차이가 거의 없음을 확인했고 1% low와 프레임 페이싱도 측정했지만, BORE를 분리하거나 통제된 경쟁 CPU 부하를 추가하지는 않았습니다. 기본 상태의 게이밍은 측정되었지만, 경합 상황에서 BORE의 이점은 분리 검증되지 않았습니다.
- 더 빠른 머신이라는 느낌: 경험은 진짜, 원인 귀속은 신뢰 불가. 새 설치와 무관한 버그의 우연한 해결은 둘 다 명령어 집합 수준과 아무 관계 없이 더 쾌적한 시스템을 만듭니다. 알아둘 만한 예외는 Intel Core Ultra 9 285K에서 진행된 Phoronix의 기본 상태 비교로, AVX-512 최적화를 전혀 쓸 수 없는 CPU에서 CachyOS가 순정 Arch를 앞섰습니다.
CachyOS가 시스템에서 실제로 바꾸는 것
CachyOS는 Arch Linux 위에 세 가지 별개의 수정을 쌓은 것입니다. 대안 스케줄러를 제공하는 패치된 커널, 더 새로운 CPU 명령어 집합 수준으로 패키지를 재컴파일한 저장소, 그리고 핵심 패키지 일부에 대한 추가 컴파일러 최적화입니다. 각각은 별개의 효과를 내는 별개의 메커니즘이며, 따로 측정되는 일은 거의 없습니다.
커널 쪽이 가장 큰 영역입니다. CachyOS 커널 기능 목록 은 Clang ThinLTO, AutoFDO 프로파일링, 런타임에 선택 가능한 선점 모드, 여러 스케줄러 옵션을 다룹니다. 현재 linux-cachyos 패키지는 CachyOS가 튜닝한 EEVDF를 기본 스케줄러로 사용합니다. BORE와 BMQ는 별도 커널 변형으로 제공되고, linux-cachyos-eevdf 는 EEVDF 응답성 튜닝을 추가로 적용하며 linux-cachyos-server 는 순정 EEVDF를 사용합니다. sched-ext는 이를 지원하는 변형에서 계속 사용할 수 있습니다.
패키지 쪽에서는 CachyOS x86-64-v3 저장소가 쟁점이 되는 메커니즘입니다. CachyOS의 최적화 저장소 페이지 는 일반 기준선 위의 세 가지 대상으로 Arch 패키지를 다시 빌드한다고 설명합니다. x86-64-v3, x86-64-v4, 그리고 v4 위에 추가 AVX-512 확장과 AVX-512 외의 일부 명령어를 더한 전용 Zen 4/5 대상입니다. 성능에 민감한 패키지 일부는 프로파일 기반 최적화와 BOLT도 적용받습니다.
이 수준 이름들은 x86-64 psABI 마이크로아키텍처 수준 명세에서 온 것이며, 다이얼이 아니라 관문입니다. x86-64-v3는 2013년 Intel Haswell과 AMD Excavator 코어와 함께 등장한 AVX 및 AVX2 세대 명령어를 요구하고, x86-64-v4는 AVX-512를 요구하는데 이는 실질적으로 Skylake-X급 Intel 제품과 모든 AMD Zen 4 이상을 뜻합니다. CPU는 기준을 넘거나 넘지 못하거나 둘 중 하나입니다.
"더 빠르다"는 말 안에 숨은 세 가지 주장
두 사람이 CachyOS가 더 빠른지를 두고 다툴 때, 보통 둘 다 서로 다른 것에 대해 옳습니다. 처리량, 프레임 일관성, 체감 응답성은 별개의 속성이며, 어떤 단일 지표도 셋을 한꺼번에 판정하지 못합니다. 시간을 잰 작업은 처리량을 측정하고, 프레임 타임과 지연 측정은 게임의 부드러움을 다루며, 더 넓은 시스템 수준 효과에는 통제된 새 설치 비교가 필요합니다.
| 주장 | 무엇을 주장하는가 | 어떻게 측정하는가 | 증거가 보여주는 것 | 신뢰도 |
|---|---|---|---|---|
| 측정된 처리량 | 재컴파일된 패키지가 같은 작업을 더 짧은 시간에 끝낸다 | 고정된 하드웨어와 고정된 커널에서 작업 하나의 시간을 재되, 패키지를 가져온 저장소만 바꾼다 | 벡터화 가능한 작업에서 확실한 이득, 여러 패키지에서 소폭 퇴행, 대부분은 변화 없음 | 높음. Canonical, CentOS ISA SIG, 독립 벤치마커 두 명이 전체 양상에 동의 |
| 입력 지연과 프레임 일관성 | 다른 무언가가 CPU를 포화시키는 동안에도 데스크톱이 반응한다 | 평균 프레임 레이트가 아니라, 경쟁 부하 아래에서의 프레임 타임 백분위와 입력 지연 | 공개된 테스트에 이제 1% low와 프레임 페이싱이 포함되지만, 스케줄러를 분리하거나 통제된 경쟁 CPU 부하를 도입하지는 않음 | 낮음. 메커니즘은 문서화되어 있지만 측정이 빠져 있음 |
| 체감 응답성 | 전환 후 머신이 더 쾌적하게 느껴진다 | 낡은 설치가 아니라 이전 배포판의 새 설치와 비교한다 | 대개 새 설치 효과나 우연한 해결로 설명됨. 한 기본 상태 비교에서는 배포판 수준의 우위가 확인됨 | 중간. 경험은 타당하나 원인 귀속은 신뢰 불가 |
첫 번째 행에 답하는 벤치마크 스위트는 두 번째 행에 답할 수 없고, 둘 다 세 번째 행은 건드리지 못합니다. 셋 중 하나를 실행하고 그 결과를 셋 모두에 대한 판정처럼 보고하는 것이 이 논쟁을 계속 굴러가게 합니다.
재컴파일된 패키지는 정말 더 빠르게 실행될까?
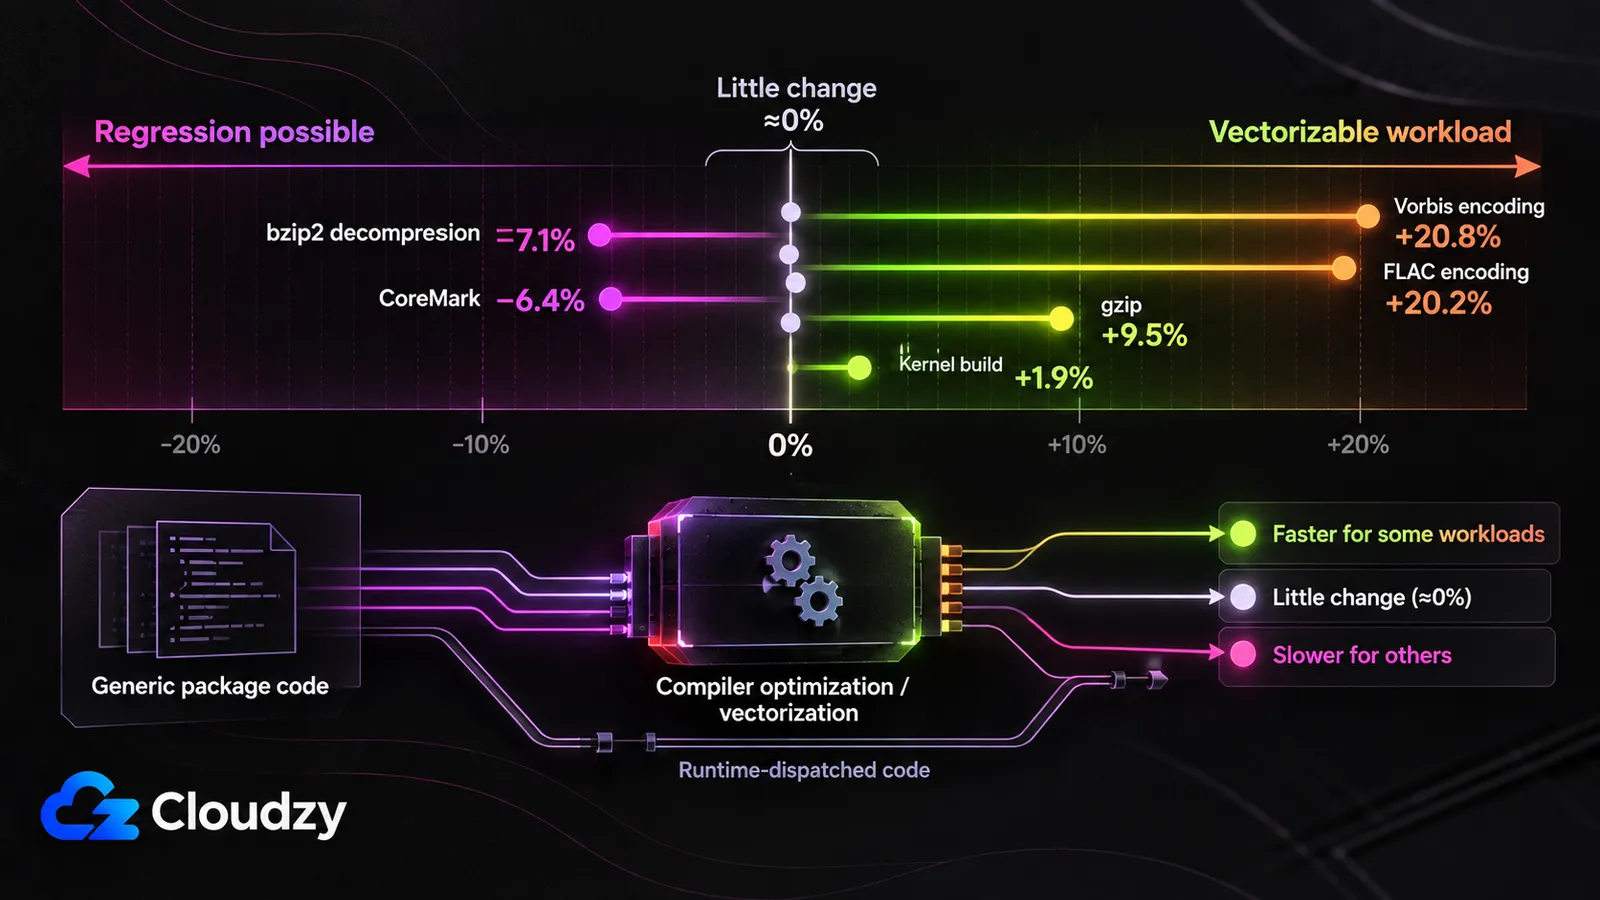
그렇습니다. 다만 데스크톱이 실행하는 것 중 소수에서만 그렇고, 그 크기는 배포판이 아니라 워크로드가 정합니다. 벡터화 가능한 작업은 두 자릿수 이득을 보고, 소수의 패키지는 느려지며, 대부분은 아무 변화도 보이지 않습니다. CachyOS의 최적화 저장소 페이지는 x86-64-v3의 향상폭을 일반 x86-64 대비 5%에서 20%로 제시하는데, 공개된 측정치는 대부분 그 하단에 있습니다.
가장 깔끔한 CachyOS 대 Arch 성능 비교는 패키지 변수만 분리하고 다른 것은 아무것도 바꾸지 않습니다. 2023년 1월의 arch-chroot 테스트 가 sunnyflunk.github.io에 있습니다. 호스트는 Intel NUC8i5BEK에서 순정 Arch를 실행했고, 두 패키지 세트는 커널과 환경이 동일하게 유지되도록 arch-chroot 안에서 테스트되었으며, 벤치마크는 디스크 지연을 제거하기 위해 RAM에서 실행되었습니다. 순정 Arch 패키지 대비 CachyOS 빌드는 -8옵션의 flac 인코딩에서 20.2%, vorbis 인코딩에서 20.8%, gzip -3에서 9.5% 더 빨랐습니다. 같은 실행에서 bzip2 압축 해제는 7.1%, lz4 압축은 1.6%에서 2.9%, pybench는 3% 더 느렸고, R 벤치마크는 변화가 없었습니다. 두 가지 단서는 저자 본인이 달았습니다. CachyOS는 Arch의 -march=x86-64-v3 -mpclmul -O3 에 맞서 -march=x86-64 -O2로 빌드하고 있었고, 그의 후속 테스트는 더 큰 이득 중 일부가 명령어 집합 수준이 아니라 -O3 때문임을 시사했습니다. 이 글은 2024년 7월 릴리스와 함께 나온 CachyOS의 Zen 4 저장소보다 앞서지만 BOLT 작업보다 앞서지는 않습니다. 저자는 pybench 퇴행의 원인이 된 CachyOS Python 패키지가 이미 x86-64-v3 위에 BOLT를 적용한 것으로 읽습니다.
더 새로운 하드웨어에서의 CachyOS 벤치마크도 같은 패턴을 반복합니다. mvermeulen.org의 2024년 7월 비교 는 Zen 4 Ryzen 7940HS에서 Phoronix Test Suite의 일부를 실행해, Zen 4 저장소를 쓰는 CachyOS를 Ubuntu 22.04와 비교했습니다. 대부분의 결과는 어느 쪽이든 몇 퍼센트 안에 들어왔습니다. coremark는 6.4% 느렸고, OpenSSL 하위 테스트는 약 1% 느린 것부터 4% 빠른 것까지였으며, 커널 빌드 시간은 1.9% 빨랐고, phpbench는 점수가 두 배를 조금 넘는 이상치였습니다. 저자는 Ubuntu의 11.4에 대한 14.1이라는 GCC 버전 불일치를 유력한 교란 요인으로 지적합니다. 그의 2024년 3월 별도 NAMD 실행 은 두 분자 동역학 워크로드에서 6.5%와 5.8%의 개선을 확인했습니다.
기관 차원의 테스트도 양쪽 끝에서 같은 혼합된 그림을 확인했습니다. Canonical 자체의 x86-64-v3 벤치마킹은 2024년 3월 Azure의 실험용 Ubuntu 23.10 이미지로 발표되었으며, glibc Log2 벤치마크에서 최대 60%의 재현 가능한 이득을 보고한 반면 다른 벤치마크는 크게 퇴행했는데, 한 사례에서는 이미 최적화된 SSE 코드에 v3를 켜자 컴파일러가 이를 17배 많은 명령어로 확장했기 때문이었습니다. CentOS ISA SIG의 CentOS Stream 9 재빌드 는 2023년 8월 Ice Lake급 Intel 머신에서 v2를 v3로 올린 것으로, 결과를 "상당히 혼합적"이라고 평했습니다. 2.2배의 속도 향상은 둘 다 벡터화 비중이 큰 Mocassin과 John the Ripper의 md5crypt에 집중되었지만, 팀은 Mocassin의 이득을 ISA 수준이 아니라 주로 GCC 12의 자동 벡터화 덕으로 돌렸습니다.
성능이 중요한 많은 수학 및 암호화 라이브러리는 핫 함수의 여러 버전을 함께 제공하고 런타임에 CPU 기능 감지를 통해 하나를 선택합니다. 이 기법은 함수 다중 버전화라 불리며 glibc에서는 IFUNC 리졸버로 구현됩니다. 즉 일부 핫 패스는 패키지 전체를 다시 빌드하지 않아도 순정 Arch 설치에서 이미 AVX2를 쓸 수 있습니다. sunnyflunk의 글은 이를 직접 확인하며, flac의 소스가 활성화에 -march 가 필요 없는 AVX2 런타임 함수를 이미 포함하고 있다고 지적했습니다. CentOS의 발견은 그 거울상입니다. 팀은 IFUNC 버전이 없는 glibc 수학 함수를 발견했는데, 바로 그곳이 정적 재빌드가 도움을 줄 여지가 있는 지점입니다. v3 재빌드가 닿는 것은 컴파일러의 자동 벡터화기가 스스로 개선할 수 있는 나머지 코드이며, 그것은 데스크톱의 한 조각, 그것도 작은 조각입니다.
머신 수준의 변화가 드러나느냐를 정하는 것은 CPU에 붙은 라벨이 아니라 워크로드의 형태입니다. 처리량에 대한 판정은 '그렇다'이되 범위가 있습니다. 위 측정치에서는 한 자릿수 변화가 흔하고, 더 큰 이득은 인코딩과 압축 같은 벡터화 가능한 워크로드 주변에 몰리며, 일부 패키지는 퇴행합니다. 이것이 x86-64-v3를 시스템 전체의 속도 배율로 취급하는 것보다 나은 설명입니다.
스케줄러가 바꾸는 것, 그리고 평균 FPS가 그것을 놓치는 이유
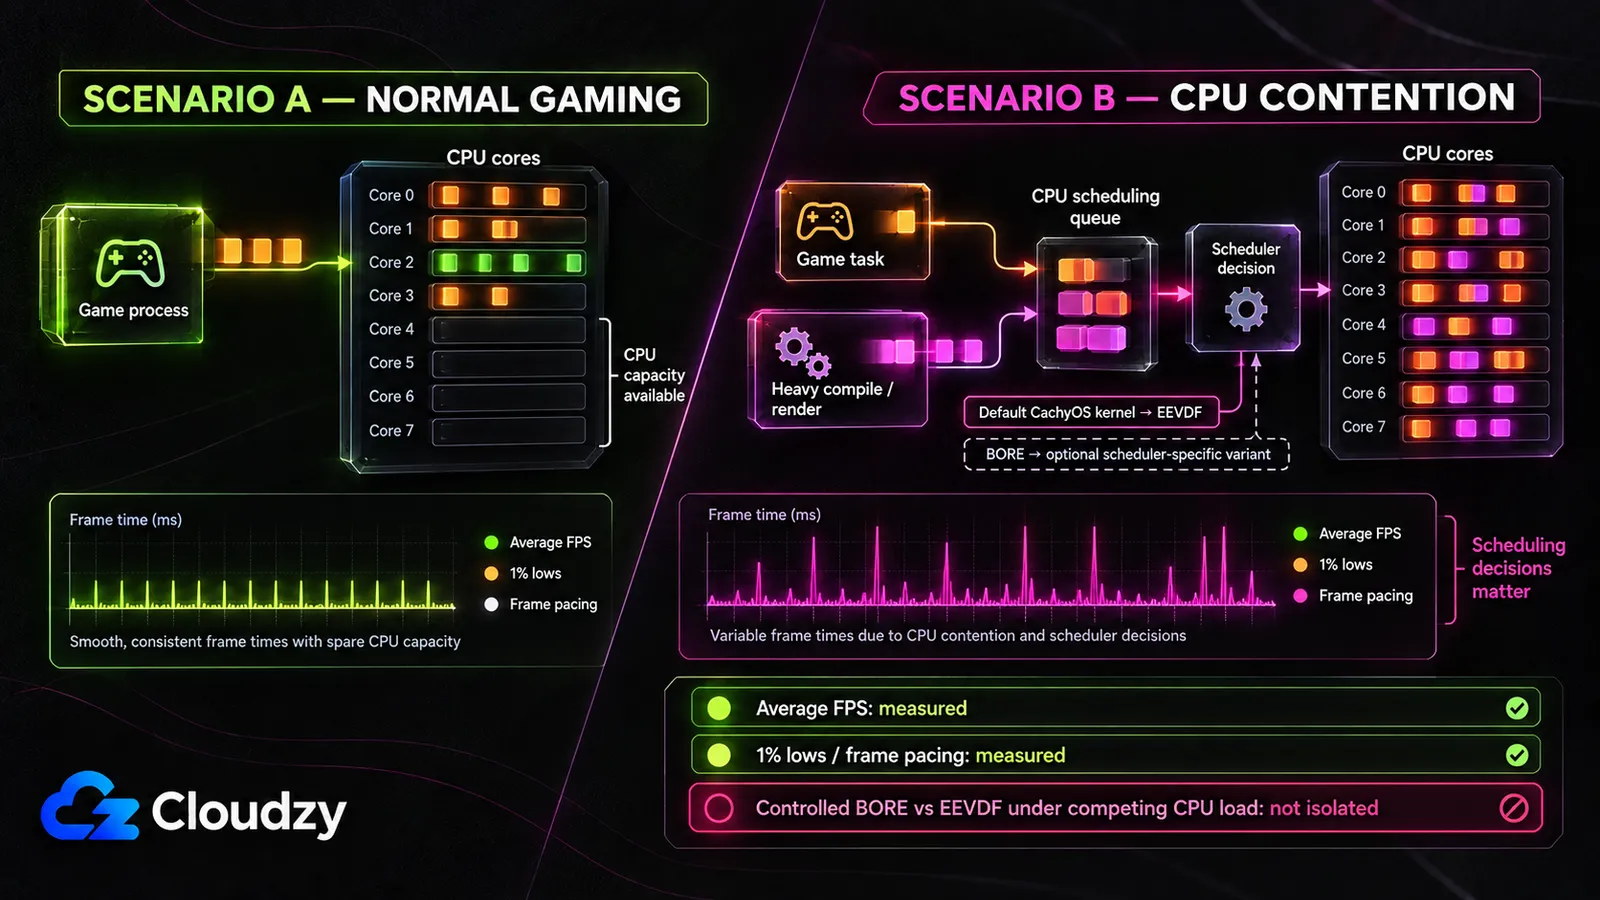
CachyOS의 현재 기본 linux-cachyos 커널은 EEVDF를 사용하고, BORE는 linux-cachyos-bore같은 스케줄러별 변형을 통해 제공됩니다. 이 구분이 중요한 이유는 아래의 게임 비교가 통제된 BORE 대 EEVDF 테스트가 아니라 배포판 수준의 테스트이기 때문입니다. BORE는 설계 자체가 혼합 워크로드 아래의 응답성을 명시적으로 겨냥하기 때문에 더 넓은 성능 주장과 여전히 관련이 있지만, 그 주장은 CachyOS의 기본 상태 게임 성능과는 별도로 평가해야 합니다.
BORE의 README 는 의도를 분명히 밝힙니다.
이를 위해 BORE는 각 개별 태스크에 "버스티니스"라는 유연성의 차원을 도입하여, CFS 고유의 "완전한 공정성" 원칙에서 부분적으로 벗어난다.
firelzrd/bore-scheduler, 프로젝트 README
버스티니스는 태스크가 잠들거나, I/O를 기다리거나, 양보하여 CPU를 마지막으로 내놓은 이후 누적한 CPU 시간입니다. BORE는 이를 점수로 바꿔 각 태스크의 가중치와 깨어날 때의 선점 공격성을 조정하는 데 쓰므로, 계속 양보하는 태스크는 대화형으로 취급되어 자기 슬라이스를 독차지하는 태스크보다 우대받습니다. README는 그 트레이드오프를 스스로 이름 짓습니다. BORE는 "서로 대립하는 탐욕적이고 약한 태스크(대개 CPU 바운드 배치 태스크)와 겸손하고 강한 태스크(대개 I/O 바운드 대화형 태스크) 사이의 균형"에 자리 잡습니다. 대화형 작업의 가중치를 올리는 것은 배치 처리량 작업의 가중치를 내리는 것과 같은 연산입니다.
이는 BORE의 특정 주장을 검출할 도구가 무엇인지 알려줍니다. 경쟁 CPU 부하를 도입하고, 스케줄러만 바꾼 채 프레임 타임 백분위나 입력 지연을 측정하는 것입니다. 게임이 유휴 CPU 용량을 두고 실행될 때 스케줄러가 중재할 일은 훨씬 적습니다.
다섯 게임 벤치마크 는 2026년 5월 16일에 공개되었으며, 같은 SSD와 하드웨어(RTX 5060 Ti와 Ryzen 9)에 CachyOS와 Omarchy를 깨끗하게 설치하고 같은 Proton-GE 빌드와 1440p 설정을 사용했습니다. 평균 FPS는 한두 프레임밖에 차이 나지 않았습니다. 이틀 뒤 같은 테스터가 MangoHUD 전체 프레임 로깅을 곁들인 두 번째 비교를 공개해 5% low, 1% low, 프레임 페이싱 분산을 추가했습니다. 이 두 번째 테스트는 Intel i7-13700과 Radeon RX 9060 XT라는 다른 하드웨어를 사용했으므로, 같은 하드웨어에서 첫 테스트를 확장한 것이 아니라 프레임 일관성에 대한 추가 증거입니다. 두 비교 모두 CPU 스케줄러를 분리하거나 의도적인 경쟁 CPU 워크로드를 추가하지 않았습니다.
프로젝트 측도 과장하지 않습니다. 게임 성능에 관한 r/cachyos 스레드에서 Peter Jung, CachyOS의 창립 개발자 중 한 명은 한 사용자에게 직접 이렇게 답했습니다. "In gaming not all too much. The newer feature can make a difference tough :)" (게임에서는 그리 크지 않지만, 더 새로운 기능은 차이를 낼 수 있다는 뜻)
여기서 두 가지 별개의 결론이 남습니다. 기본 상태 CachyOS 게이밍에 대해 공개된 테스트는 평균 FPS 차이가 거의 없음을 보여주며, 이제 1% low와 프레임 페이싱 측정도 포함합니다. 의도적인 CPU 경합 아래의 BORE에 대해서는, 스케줄러만 바꾸고 그 부하 아래의 응답성을 측정한 통제된 공개 테스트를 찾을 수 없었습니다.
측정상 더 빨라진 게 없어도 전환이 더 빠르게 느껴지는 이유
두 가지 메커니즘이 CachyOS의 최적화와 전혀 무관하게 배포판 전환 후 더 쾌적한 머신을 만듭니다. 새 설치 그 자체, 그리고 이전 시스템에 있던 무관한 문제의 우연한 해결입니다. 둘 다 자기 사례에서 알아볼 수 있을 만큼 구체적이며, 그것이 뭉뚱그린 플라세보 비난과 구별되는 점입니다.
새 설치부터 시작합시다. 이 질문에 관한 r/linuxquestions 스레드에서, 본인은 차이를 느끼지 못했다고 밝힌 한 CachyOS 사용자는 큰 이득을 보고하는 사람들이 새 설치가 아니라 오래 쓴 설치와 비교하고 있을 수 있다고 지적했습니다. 수년간 쌓인 자동 시작 항목, 고아 서비스, 어긋난 설정, 꽉 찬 디스크는 그 자체로 워크로드이며, 깨끗한 파티션은 이를 한 번에 없앱니다. 배포판 전환은 커널, 데스크톱 환경, 모든 패키지 버전, 모든 기본값을 동시에 바꾸며, Manjaro 대 Ubuntu 전체 비교 는 열두 개의 별개 축에 걸쳐 있습니다. 나중에 그중 하나에 개선을 귀속시키는 것은 추측입니다.
우연한 해결은 더 날카로운 사례입니다. 같은 스레드에서 한 댓글 작성자는 성능을 심각하게 떨어뜨리는 VRAM 관리 문제를 안고 Fedora를 매일 쓰다가 CachyOS로 옮기자 문제가 사라지는 것을 봤다고 했습니다. 이후 순정 Arch로 옮겼더니 CachyOS와 기본적으로 같은 성능이 나왔고, 무엇이 달랐던 건지 더는 모르겠다고 결론지었습니다. 개선은 진짜였지만, CachyOS의 컴파일 대상과는 아무 관계가 없었습니다.
이 중 어느 것도 깔끔한 반박을 정당화하지 않으며, 그런 반박에 맞서는 가장 강력한 증거는 통제된 테스트입니다. Phoronix의 Arrow Lake 배포판 비교 는 Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux, CachyOS를 같은 Intel Core Ultra 9 285K에 기본 상태로 올렸고, CachyOS는 Intel 실리콘에서 보통 선두인 Clear Linux를 포함해 모두를 근소하게 앞섰습니다. Arrow Lake는 AVX-512를 지원하지 않으므로 그 우위는 x86-64-v4에서 올 수 없으며, CachyOS의 커널 및 빌드 선택, 패키지 최적화, 기본 설정이 어떤 식으로든 결합된 결과입니다.
경험은 진짜일 수 있고 원인 귀속은 불확실한 채로 남을 수 있습니다. Phoronix의 Arrow Lake 비교는 유용한 반례입니다. 기본 상태의 CachyOS 설치는 x86-64-v4를 쓸 수 없을 때도 순정 Arch를 능가할 수 있습니다.
이 중 어떤 것이 내 머신에 해당하는지 확인하는 방법
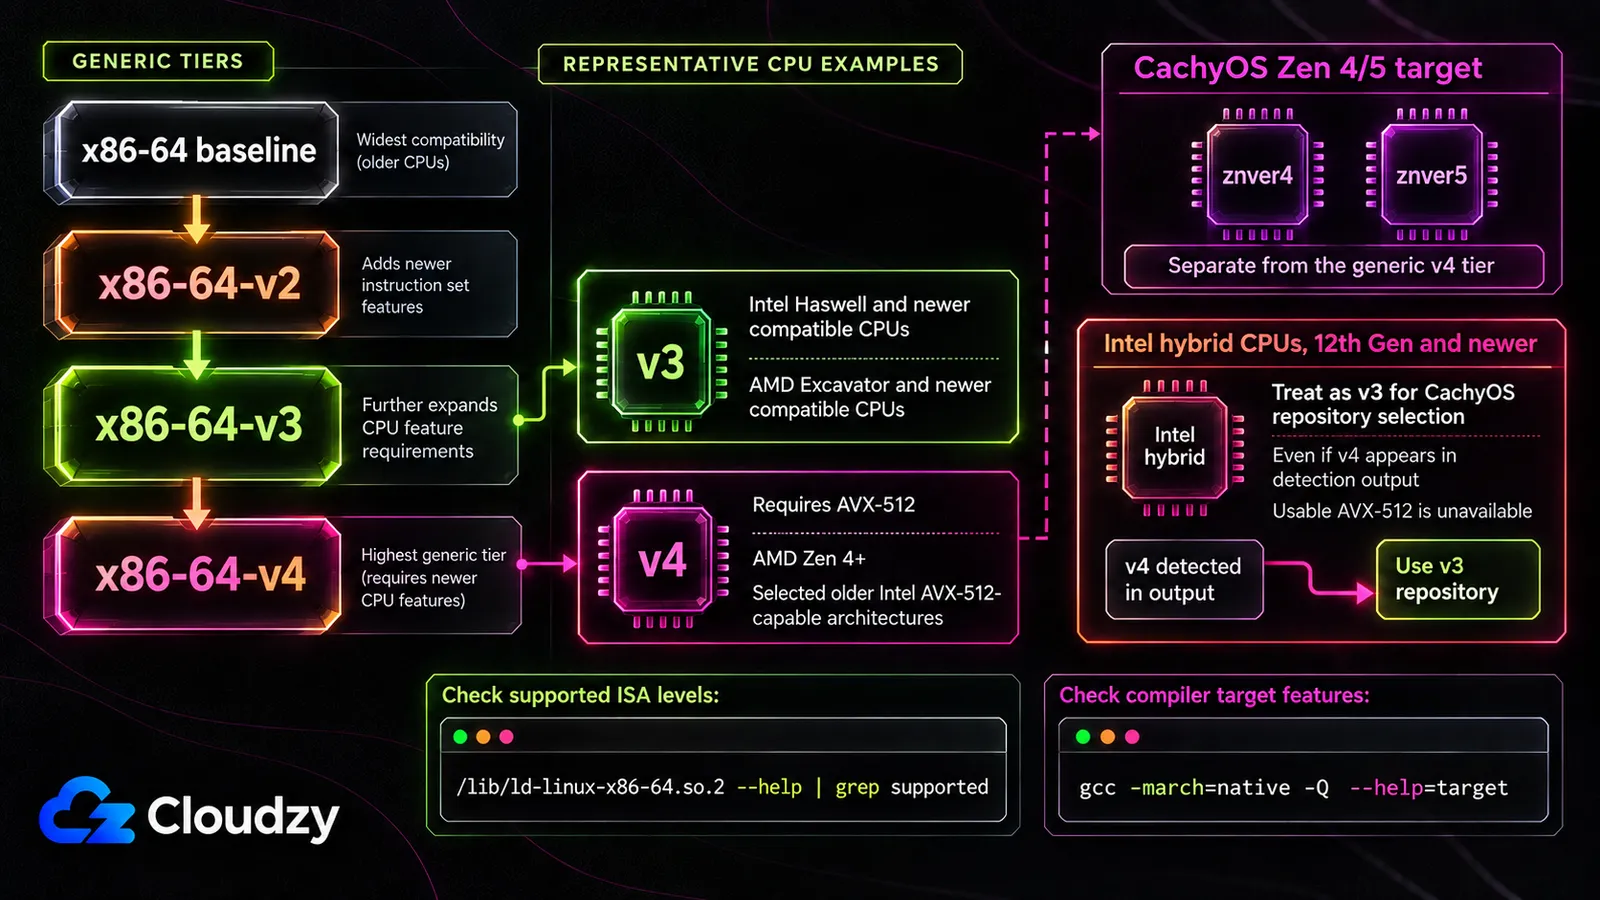
내 CPU가 어떤 표준 x86-64 마이크로아키텍처 수준을 지원하는지는 대부분 명령 하나로 답이 나옵니다. 동적 링커는 자신이 사용할 수 있는 glibc-hwcaps 수준을 보고하므로, 지원되는 가장 높은 x86-64-vN 항목이 보통 CPU가 일반 v2, v3, v4 저장소 계층에 해당하는지를 알려줍니다. 중요한 예외 하나는 Intel 12세대 이후의 하이브리드 CPU입니다. AVX-512를 쓸 수 없기 때문에, 출력에 v4가 나타나더라도 v3로 취급하라고 CachyOS는 안내합니다. CachyOS의 별도 Zen 4/5 대상도 자체 아키텍처 확인이 필요합니다.
/lib/ld-linux-x86-64.so.2 --help | grep supportedAMD Zen 4/5의 경우 CachyOS는 다음도 문서화하고 있습니다.
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"첫 번째 명령은 다음과 비슷한 출력을 냅니다.
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
이는 v3와 v2는 있지만 AVX-512는 없는 CPU입니다. 세 가지 결과, 세 가지 결정입니다.
- x86-64-v2 위로는 아무것도 없음. v3/v4/Zen 전용 재빌드의 이점은 이 CPU에 해당하지 않습니다. CachyOS는 여전히 실행할 수 있고, 패키지별 컴파일러 최적화와 커널 및 기본 설정 변경은 여전히 의미가 있을 수 있습니다.
- x86-64-v3 지원, x86-64-v4 사용 불가. 실질적인 저장소 선택 관점에서 Arrow Lake 같은 최신 Intel 하이브리드 CPU가 여기에 포함됩니다. 위에서 인용한 비교에서 많은 변화는 작았고, 일부 인코딩 및 압축 워크로드는 훨씬 큰 이득을 얻었으며, 일부 패키지는 퇴행했습니다.
- x86-64-v4 지원. AVX-512는 벡터화 가능한 워크로드에 더 많은 이론적 여유를 만들지만, 시스템 전반의 큰 이득을 보장하지는 않습니다.
CPU가 조건을 충족하고 원하는 것이 패키지 쪽 절반이라면, 그것을 얻기 위해 재설치할 필요는 없습니다. CachyOS의 저장소는 기존 Arch 시스템에 추가할 수 있고, ALHP는 각 x86-64-vN 수준으로 공식 Arch 저장소를 다시 빌드한 것을 공개하며, Arch Wiki에 문서화되어 있고 나름의 주의 사항이 있습니다. 직접 링크된 커널 모듈 대신 DKMS 패키지가 필요하고, 커널 컴파일에 -march 를 설정하는 것은 "의미 있는 결과를 내지 못합니다." 어느 경로든 재컴파일된 패키지만 얻을 뿐, 커널 패치셋이나 스케줄러 변형은 전혀 얻지 못합니다.
먼저 명령을 실행하세요. 그것은 배포판에 대한 논쟁을 자기 머신에 대한 사실로 바꿔주며, 이 질문 중 오늘 밤 혼자 힘으로 결론 낼 수 있는 유일한 버전입니다.

루트 액세스, NVMe, AMD EPYC 성능을 갖춘 Linux VPS에서 개발하세요.
Linux 요금제 보기자주 묻는 질문
CachyOS는 정말 게임 성능을 높여줄까?
평균 프레임 레이트로는 거의 그렇지 않습니다. 2026년 5월의 다섯 게임 비교는 한두 프레임 차이만 확인했고, 이틀 뒤의 후속 테스트는 1% low와 프레임 페이싱도 측정했습니다. 두 테스트 모두 의도적인 경쟁 CPU 워크로드를 도입하지 않았으므로, 해결되지 않은 질문은 프레임 페이싱이 측정되었는지가 아니라 경합 상황에서의 스케줄러 응답성입니다.
내 CPU는 x86-64-v3 또는 v4를 지원할까?
CachyOS나 Arch에서 /lib/ld-linux-x86-64.so.2 --help | grep supported 를 실행하면 CPU에 대해 감지된 표준 glibc-hwcaps 수준을 볼 수 있습니다. x86-64-v3는 AVX/AVX2 세대 기능 집합을 요구하고, v4는 AVX-512를 추가합니다. Intel 12세대 이후 하이브리드 CPU의 경우 CachyOS는 출력에 v4가 나타나더라도 시스템을 v3로 취급하라고 권장하며, Zen 4/5 사용자는 별도의 znver4/znver5 대상도 확인해야 합니다.
재컴파일된 패키지는 왜 더 큰 차이를 내지 못할까?
고도로 최적화된 코드 일부는 이미 런타임에 CPU별 구현으로 분기되기 때문입니다. 수학 및 암호화 라이브러리는 핫 함수에 함수 다중 버전화나 IFUNC를 자주 사용하므로, 패키지 재빌드는 주로 컴파일러가 전역적으로 더 최적화하거나 벡터화할 수 있는 코드에 도움이 됩니다.
배포판을 바꾸지 않고 CachyOS의 최적화 패키지를 쓸 수 있을까?
그렇습니다. CachyOS의 저장소는 기존 Arch Linux 설치에 추가할 수 있고, ALHP 프로젝트는 x86-64-v2, v3, v4를 대상으로 공식 Arch 저장소를 다시 빌드한 것을 Arch Wiki에 문서화하여 공개합니다. 둘 다 재컴파일된 패키지만 제공할 뿐, CachyOS 커널 패치셋, 대안 스케줄러, 설치 프로그램 기본값은 제공하지 않습니다.
토론
댓글
토론에 참여하려면 로그인하세요.