

То, что вы построили, работает в продакшене. Мониторинга у вас либо нет вовсе, либо это простой пинг доступности, и на прошлой неделе о сбое вам сообщил пользователь. Все ответы, которые вы ищете, указывают на одно и то же имя.
Этот обзор Prometheus — о разрыве между двумя утверждениями, которые оба верны. Он бесплатный и с открытым исходным кодом, без лицензий и счетов за метрики на любом масштабе. И он же стоит вам одного вечера плюс языка запросов, которого вы пока не знаете. Это pull-based сборщик метрик со встроенным алертингом, и это отличная программа. А вот подходящая ли это программа для той установки, которую вы держите прямо сейчас, — вопрос другой, и именно на него стоит ответить.
Кратко
- Вердикт: 3,5 / 5 для self-hosted-установок одиночки и небольшой команды. Prometheus стоит разворачивать, если ваш набор хостов и сервисов достаточно стабилен, если вы готовы потратить время на изучение PromQL и если вам нужны метрики, которые полностью принадлежат вам, без подписки и без счёта за хранение.
- Откажитесь, если вопрос, на который вам нужен ответ, — «работает ли оно». Чекер доступности приведёт вас к этому ответу гораздо быстрее, а браться за Prometheus ради такой задачи — значит платить языком запросов за то, что можно было выяснить за десять минут.
- PromQL — это расход, который возвращается снова и снова. Настройка — разовая трата. Но как только ваши вопросы перерастают готовые дашборды и визуальный конструктор Grafana, вы снова оказываетесь в PromQL.
- Стоимость обслуживания зависит от того, какую долю установки вы ведёте вручную. Парк, который сохраняет форму, обходится в мониторинге дёшево. А тот, который прибавляет, теряет и переименовывает хосты, — это как раз то место, где расходы тихо накапливаются.
- Этот вердикт ограничен self-hosted-установками небольшого масштаба. На масштабе Kubernetes и продакшен-SRE Prometheus — совсем другое предложение, и на тот вопрос этот обзор отвечать не берётся.
Как готовился этот обзор: Prometheus бесплатен и открыт, так что никаких отношений с вендором здесь нет и никто мне ничего не присылал. Факты о версиях и поведении хранилища взяты из собственной документации Prometheus. Цифры по ресурсам и времени настройки взяты из двух независимо опубликованных практических тестов, со ссылкой в том месте, где используется каждый из них. Там, где эти два теста расходятся, вы увидите обе цифры, а не среднее.
Что охватывает этот обзор
Вердикт выше имеет границы, и здесь эти границы важны больше обычного, потому что на разных масштабах Prometheus ведёт себя как разный инструмент.
- Prometheus оценивается для self-hosted-установок на одном VPS и небольших проектов: горстка хостов и сервисов, один человек, который за ними следит.
- Не Kubernetes. Prometheus Operator, ServiceMonitors и kube-prometheus-stack — это отдельный операционный мир, и вердикт здесь ничего о нём не говорит.
- Не руководство по маршрутизации Alertmanager. Алертинг есть и работает; настройка маршрутов, сайленсов и получателей — тема сама по себе.
- Не пошаговая установка. Вопрос здесь в том, стоит ли вообще его запускать. Если на него вы уже ответили, наше руководство по Grafana и Prometheus в Docker Compose описывает шаги.
- Не обзор экспортеров. Экспортеры упоминаются только там, где они меняют ответ.
В чём Prometheus хорош
Prometheus не стоит ничего. Не «бесплатный тариф с платными улучшениями» и не «бесплатно, пока не превысите лимит метрик». Репозиторий лицензирован под Apache 2.0 от начала и до конца, платной редакции основного проекта нет, и нигде нет тарификации за хост, за метрику или за лейбл. Единственный счёт, который порождает Prometheus, — это сервер, на котором он работает.
Для того, на что вы собираетесь опираться, вопрос «будет ли это здесь через три года» вполне уместен, и здесь шансы примерно настолько хороши, насколько это вообще бывает в открытом коде. Prometheus выпустился из CNCF в августе 2018 года — вторым проектом в истории, после Kubernetes. Релизы выходят ровно, а v3.13.2 вышла в конце июля 2026 года; поскольку эта ветка релизов относится к линии долгосрочной поддержки, она получает исправления ошибок, безопасности и документации в течение года, так что оставаться на актуальных патчах не значит гоняться за каждой минорной версией.
Модель данных объясняет, почему экосистема вокруг него настолько глубока. Prometheus собирает метрики по HTTP и идентифицирует каждый ряд именем метрики плюс лейблами ключ/значение, из-за чего написать экспортер — небольшая работа. Поэтому экспортеры есть почти для всего, что вы вообще можете запускать: системные метрики, Postgres, Nginx, Redis, blackbox-пробы для того, что можно проверить только снаружи.
И вы владеете тем, что он собирает, — а это та часть, которая обычно важна не в первый день, а позже. История небольшой установки занимает незначительный объём диска (цифры ниже), никто не переоценит её в следующем квартале, и нет строки в счёте, которая растёт каждый раз, когда кто-то добавляет инструментирование в приложение. Если вы хоть раз видели, как счёт за управляемый мониторинг ползёт вверх из-за того, что разработчик добавил один лейбл, — весь аргумент умещается в это предложение.
Где Prometheus обходится дороже, чем кажется
Тест на dev.to, где семь инструментов мониторинга проверяли на одном небольшом VPS показал 15 минут на настройку одного только Prometheus. Соедините его с Grafana, как сделал автор теста, потому что встроенный браузер выражений — это лишь место, где выполняют запросы. Тот же тест даёт Grafana + Prometheus 35 минут до первого графика, с YAML-конфигурацией сбора где-то посередине.
Минуты — дешёвая часть. Дорогая — PromQL. Prometheus хранит всё как временные ряды, определяемые именем и лейблами, и PromQL по-прежнему остаётся языком под теми вопросами, которые вы ему задаёте. У Grafana теперь есть визуальный конструктор, так что писать каждый запрос вручную не придётся. Собственный вердикт автора теста был прямым: PromQL прекрасен, если вы в нём живёте, а он не жил. Если вы никогда не работали с языком запросов, закладывайте на это больше одного вечера и рассчитывайте возвращаться к нему всякий раз, когда визуального конструктора перестанет хватать. Дашборд, скопированный у кого-то другого, отвечает на его вопросы. Ваши — это запрос, который вы ещё не написали.
Третья статья расходов проявляется не сразу. Один трёхнедельный отчёт оператора описывает ровно то, во что обошлось добавление одного сервера к установке из семи узлов: переразметка лейблов, перепроверка конфигураций сбора, правка переменных дашбордов и переделка шаблонных запросов, чтобы новый хост появился в выпадающих списках. Этот оператор отказался от стека через три недели, придя к выводу, что тратит больше времени на подкрутку дашбордов, чем на наблюдение за инфраструктурой.
Обратите внимание, к чему привязан этот расход в такой установке: к целям и дашбордам, которыми управляют вручную. Два спокойных года работы Prometheus не стоят вам почти ничего сверх того.
Сколько RAM и диска на самом деле нужно Prometheus?
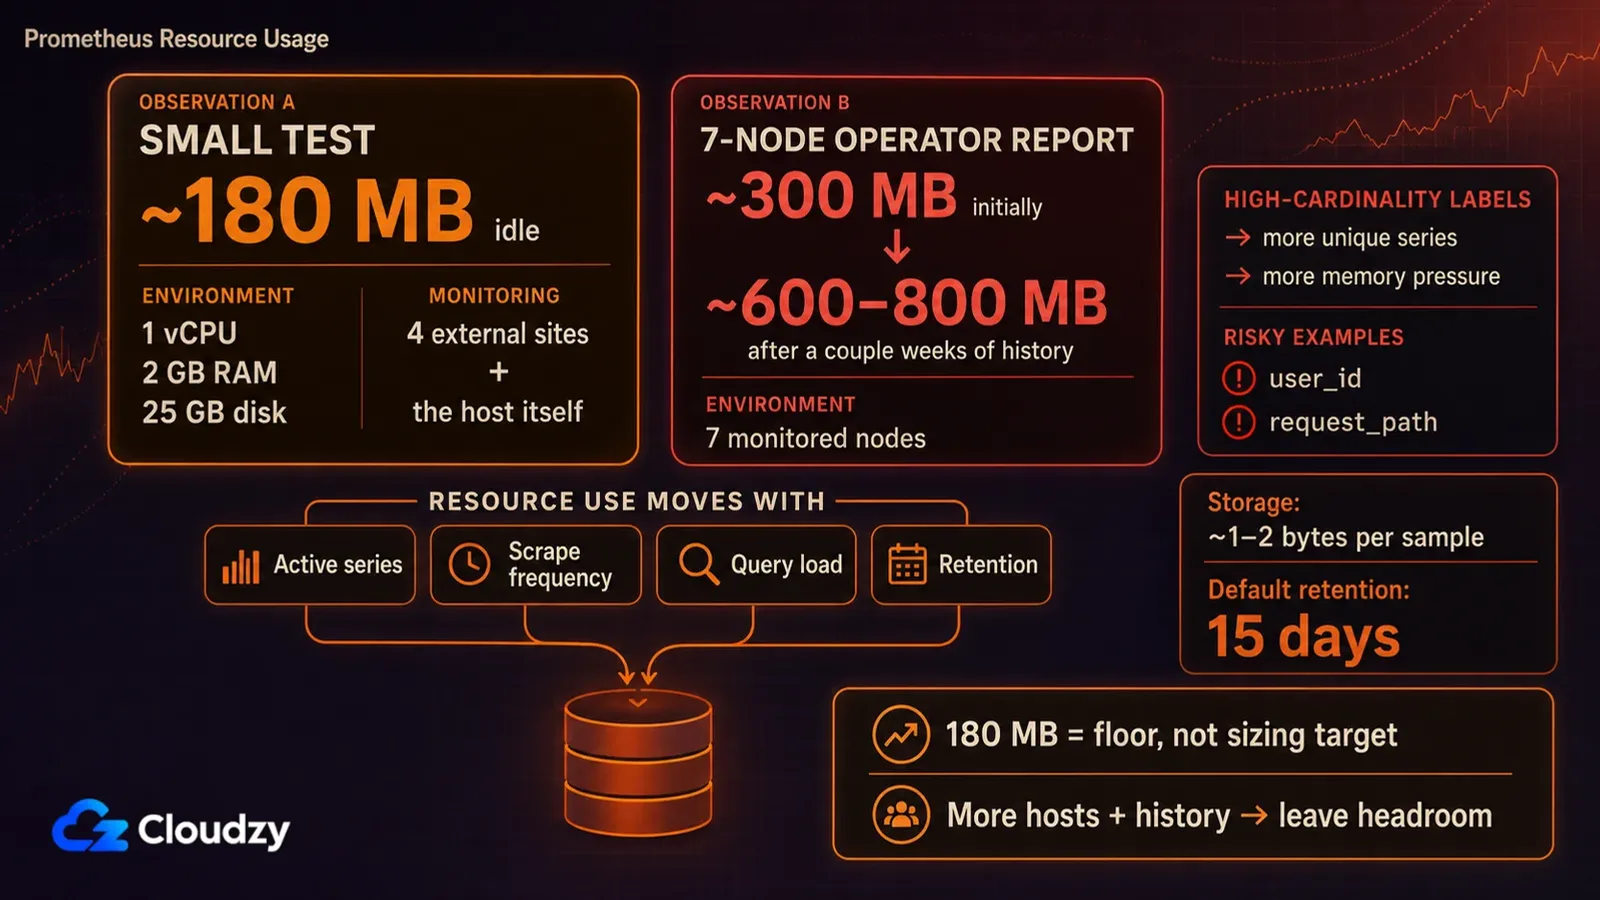
Фиксированного требования нет. Активные ряды, частота сбора, нагрузка запросами и срок хранения значат больше, чем просто число серверов, на которые вы его нацелили. Два опубликованных практических теста небольших установок дают диапазон примерно от 180 МБ до 800 МБ, причём большая цифра относится к семи узлам с парой недель истории.
Два теста расходятся, и полезна как раз эта нестыковка. То же сравнение семи инструментов на VPS гоняло каждый из них на одинаковом железе (1 vCPU, 2 ГБ RAM, 25 ГБ диска, Ubuntu 24.04), наблюдая за четырьмя внешними сайтами и самим хостом, и намерило у Prometheus около 180 МБ в простое. Тот же оператор сообщал, что один Prometheus в простое держался около 300 МБ на центральном хосте и поднимался к 600–800 МБ, когда накопилась пара недель истории.
Это не одно и то же измерение, и именно поэтому усреднять их — значит выбросить информацию. Одно — почти холостой замер на машине, которой почти нечего хранить. Другое — работающее развёртывание с парком за спиной и историей на диске. Моё прочтение: считайте результат в 180 МБ полом, а не целевым размером. Как только вы собираете с нескольких хостов и храните историю, закладывайте запас вместо того, чтобы планировать по этой цифре простоя.
Диск — простая половина. Документация Prometheus по хранилищу оценивает его в среднем в 1–2 байта на сэмпл, так что держать длинную историю для небольшой установки дёшево. Подвох — в значении по умолчанию: срок хранения по умолчанию равен 15 дням если вы не задали время или размер хранения. От года это отделяет один флаг запуска, и это ровно тот вид умолчания, о котором лучше узнать сейчас, а не в тот момент, когда вы полезете за цифрами прошлого месяца и обнаружите, что они истекли три недели назад.
Цифру памяти вверх тянет кардинальность: количество различных временных рядов, где каждая уникальная комбинация лейблов на метрике становится отдельным рядом. Один неудачно выбранный лейбл на метрике с большим трафиком способен породить больше рядов, чем пять дополнительных серверов, и делает он это молча, ровно с той скоростью, с какой идёт ваш трафик. (Идентификатор пользователя или путь запроса выглядят отличным лейблом ровно до того момента, когда вы посчитаете, сколько их.)
Любая цифра RAM, которую вы найдёте применительно к Prometheus, пригодна только вместе со знанием того, сколько рядов за ней стояло.
Что произойдёт, когда ваш сервер Prometheus упадёт?
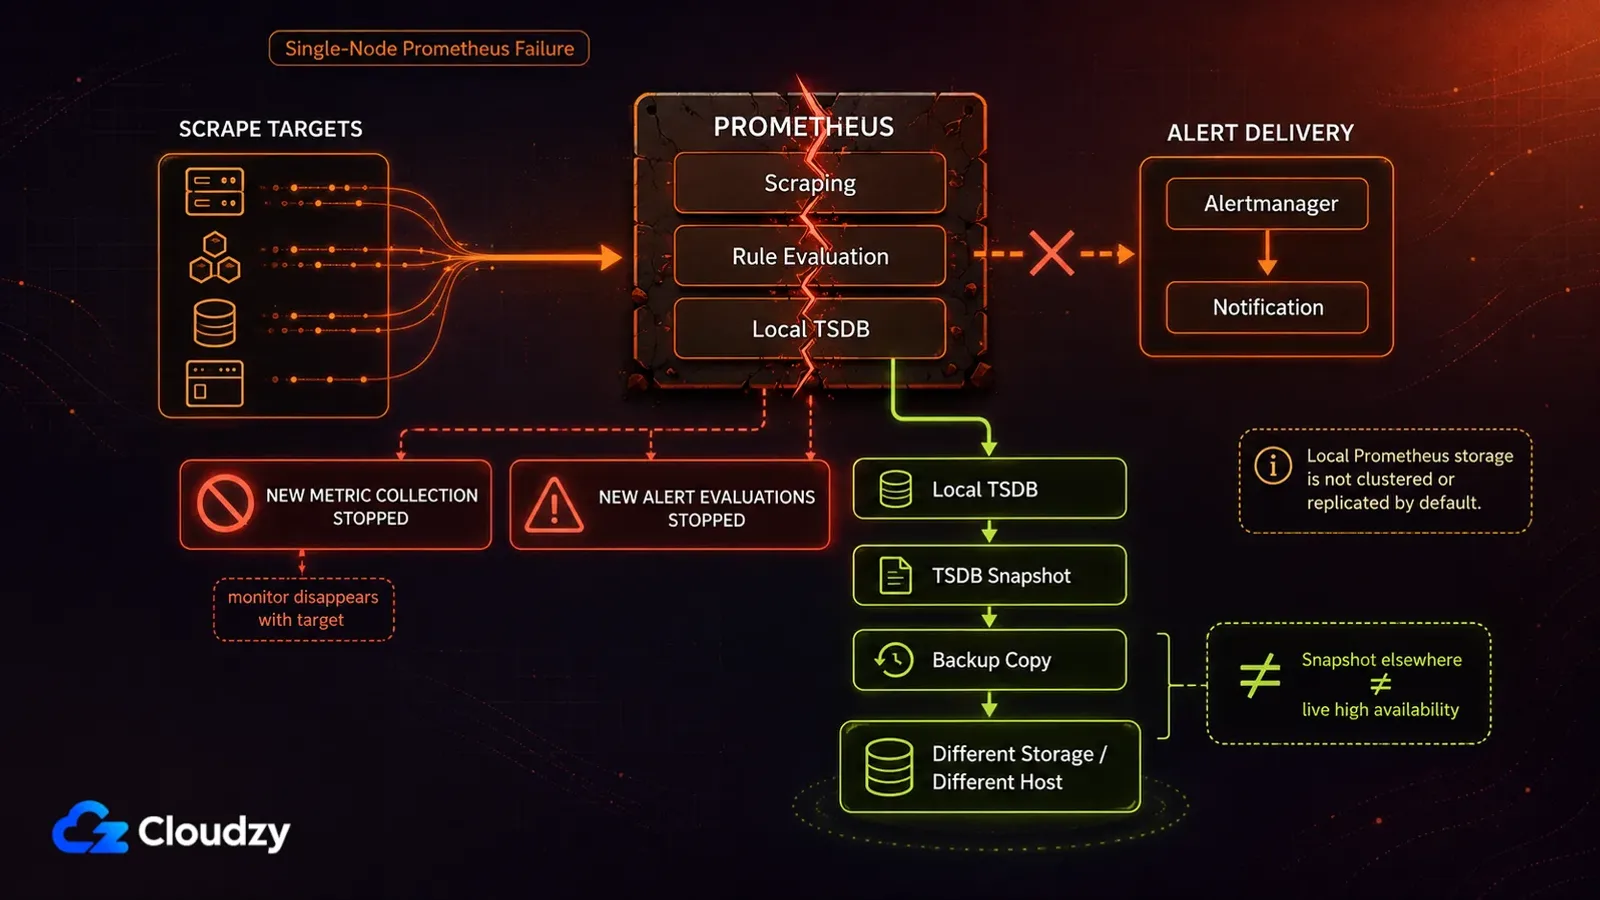
Собственная документация Prometheus по хранилищу говорит об этом прямо: локальное хранилище не кластеризовано и не реплицировано, поэтому оно не переживёт отказ диска или узла. Каждый сервер по замыслу автономен и не зависит ни от сетевого хранилища, ни от удалённых сервисов, — именно это делает его простым в эксплуатации и именно это оставляет его уязвимым.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Есть и вторая граница, которую проект заявляет о самом себе, и за это его стоит похвалить: если вам нужна 100 % точность, например для потарифного выставления счетов, документация говорит, что Prometheus — неверный выбор, потому что собираемые им данные, скорее всего, окажутся недостаточно подробными и полными. Для цифр, по которым вы выставляете счета, используйте что-то другое, а Prometheus оставьте для мониторинга. Вендоры обычно не сообщают о себе подобное добровольно.
На большем масштабе на это есть устоявшиеся ответы, и они за рамками этого текста по той же причине, что и инструментарий Kubernetes: это другой уровень операционных обязательств, чем тот, который покрывает обзор. Для одного VPS моё прочтение такое: риск приемлем, если вы храните снапшоты TSDB в другом месте или заранее соглашаетесь потерять историю, и это настоящая проблема, если Prometheus — единственное, что стоит между вами и тихим сбоем.
Кому стоит разворачивать Prometheus у себя?
Самый ясный признак того, что Prometheus окупит свою цену, никак не связан с тем, сколько у вас серверов. Он связан с тем, будут ли это те же самые серверы через полгода. Стабильный набор хостов, настроенных вручную, означает, что конфигурацию вы пишете один раз, а историю получаете бесплатно; набор, который постоянно меняется, означает, что вы постоянно правите эту конфигурацию.
В статичной установке ваша конфигурация Prometheus и Grafana — это явное описание вашей инфраструктуры: цели сбора, привязанные к ним лейблы и дашборды, построенные поверх этих лейблов. Именно поэтому вся отдача — в истории. Год данных по стабильному набору хостов показывает вам, как выглядит норма, а это самый надёжный способ распознать аномалию до того, как она превратится в сбой.
Итак, первый профиль — тот, кто держит небольшой, медленно меняющийся набор серверов и хочет большего, чем «работает или нет»: задержку запросов во времени, тренды памяти, диск, который наполняется достаточно плавно, чтобы это было видно за недели. Если вы можете описать свою инфраструктуру сегодня и ожидаете, что через год описание останется примерно верным, тот вечер, потраченный на настройку, — последний крупный счёт.
Второй — любой, кто осознанно изучает этот стек. Если вы рассчитываете через несколько лет заниматься инфраструктурой, своей или чужой, вечер с PromQL — это ровно то, за чем вы пришли, а мониторинг — побочный эффект. Этот профиль отчасти переворачивает первый: проверка на стабильность здесь значит меньше, потому что время, потраченное на переразметку лейблов, — это и время, потраченное на понимание того, что такое переразметка. Для такого читателя я бы поднял оценку.
Третий профиль — про владение, и его недооценивают ровно до тех пор, пока не окажутся не на той стороне. Prometheus не берёт денег ни за хост, ни за метрику, ни за лейбл, и никакая страница с ценами не поменяется у вас под ногами в следующем квартале. Размен по сравнению с управляемым сервисом вроде Datadog: вы отказываетесь от лоска, контракта на поддержку и чужого дежурства, а взамен получаете метрики, которые принадлежат вам, и счёт, который не двигается, когда разработчик добавляет инструментирование. Хороший ли это размен, зависит от того, сколько стоят ваши собственные часы, — число, которое можете подставить только вы (и оно редко равно нулю, даже когда так кажется).
Что стоит знать до того, как вы на это подпишетесь: перерасти локальное хранилище Prometheus — не тупик. VictoriaMetrics принимает remote write от Prometheus, а его MetricsQL обратно совместим с PromQL, так что большинство запросов и дашбордов Grafana, которые вы строите сейчас, должны пережить переезд. Это миграция, а не переписывание.
Это стоит пересматривать раз в год, а не решать однажды и навсегда: установка, которую сегодня дёшево мониторить, дорожает в тот квартал, когда вы начинаете её перестраивать.

Разрабатывайте на Linux VPS с root-доступом, NVMe и мощью AMD EPYC.
Посмотреть тарифы LinuxКому Prometheus не нужен?
Если фраза, которой вы описали бы свою потребность, звучит как «сообщи мне, когда сайт упадёт», то вы описываете чекер доступности, а Prometheus — слишком много механики ради такого ответа. Uptime Kuma делает ровно эту работу, имеет веб-интерфейс и не требует учить язык запросов для мониторинга. Разрыв в возможностях между двумя инструментами огромен и совершенно нерелевантен той задаче, ради которой вы их нанимаете.
Второй читатель — тот, кому нужны пригодные графики без предварительного изучения языка запросов. Netdata построен ровно вокруг этого: метрики по хосту, на которые можно посмотреть сразу, с куда меньшей настройкой и без чего-либо между вами и графиками. Если вопрос, который вы задаёте снова и снова, — «почему эта машина сейчас тормозит», то это гораздо более короткий путь к ответу.
Третий — любой, чья инфраструктура часто меняет форму и кто ведёт цели и переменные дашбордов вручную. Хосты, поднятые на неделю и снесённые, переименованные цели, проекты, переименованные на полпути. Это как раз тот случай, когда вы платите за конфигурацию снова и снова, получая при этом меньше всего от того, за что платите, — от непрерывной истории системы, которая остаётся узнаваемой.
Ничто из этого не упрёк инструменту. «Не брать» здесь означает не брать для этой задачи и на этом масштабе. На масштабе Kubernetes, где service discovery берёт на себя большую часть того, что иначе пришлось бы связывать руками, некоторые из перечисленных расходов уменьшаются или исчезают совсем, и моё прочтение того масштаба таково, что Prometheus там очень трудно обойти. Но это уже другой обзор.

Часто задаваемые вопросы
Prometheus бесплатный?
Да, и никакого подвоха с бесплатным тарифом под этим нет. Prometheus лицензирован под Apache 2.0, коммерческой редакции за ним не стоит, так что нет ни квоты на метрики, которую можно превысить, ни предложения перейти на платную версию по ту сторону. Вы платите за инфраструктуру и за собственное время, а не за лицензию Prometheus.
Нужна ли Prometheus Grafana?
Нет, но рассчитывайте на неё. Собственный браузер выражений Prometheus существует, чтобы выполнить запрос и посмотреть на ответ, — этого хватает, чтобы проверить одну вещь один раз. Всё, что вы хотите оставить открытым на втором мониторе, — это работа Grafana, и эти два инструмента почти всегда запускают вместе.
Не избыточен ли Prometheus для одного сервера?
Часто да. Если вам нужно знать, работают ли сервер и его сервисы, чекер доступности ответит на это за долю того времени, что уйдёт на настройку. Prometheus оправдывает своё место тогда, когда вам нужны исторические метрики, которые можно запрашивать, и вы готовы выучить PromQL, чтобы до них добраться.
Сколько времени Prometheus хранит метрики по умолчанию?
15 дней, и заранее он не предупреждает. Prometheus отбрасывает сэмплы старше окна хранения, если вы не увеличили его флагом времени или размера хранения при запуске. Задайте его в тот же день, когда ставите, потому что расширение окна позже не вернёт данные, срок которых уже истёк.



Обсуждение
Комментарии
Войдите, чтобы присоединиться к обсуждению.