
Một người dùng trên r/linuxquestions đã làm phép so sánh mà mọi người vẫn tranh cãi mãi. Anh cài CachyOS, chạy benchmark vài trò chơi trên Ryzen 7 7800X3D với Radeon RX 7900 XTX, và không đo được khác biệt nào so với các bản phân phối khác đã có sẵn trên máy. Các bình luận diễn ra như thường lệ. Một người đặt mức trần thấp đến mức không thể nhận ra khi dùng bình thường. Một người khác giải thích về bộ lập lịch. Người thứ ba nói benchmark không thể cho thấy bộ lập lịch làm gì. Không ai đưa ra phép đo có thể khép lại tranh luận.
Câu hỏi cứ quay lại với cùng những từ ấy: CachyOS có thực sự nhanh hơn? Câu trả lời ngắn gọn là có, ở những khối lượng công việc cụ thể. Các gói biên dịch lại có thể giúp mã mà trình biên dịch vector hóa được, các so sánh chơi game được trích dẫn ở đây cho thấy chênh lệch FPS trung bình rất nhỏ, và một hệ thống cảm giác nhanh hơn sau khi chuyển đổi thì khó quy cho một nguyên nhân hơn, vì đổi bản phân phối thay đổi nhiều hơn hẳn một biến số.
Nó vẫn chưa ngã ngũ vì "nhanh hơn" chứa ba khẳng định riêng biệt với ba câu trả lời khác nhau, mỗi cái cần công cụ đo riêng. Gói biên dịch lại hoặc hoàn thành một tác vụ trong thời gian thực ngắn hơn, hoặc không. Bộ lập lịch hoặc thay đổi cách desktop hành xử khi bị tranh chấp tài nguyên, hoặc không. Và một chiếc máy nhạy hơn hoặc bắt nguồn từ CachyOS, hoặc từ thứ gì đó đến cùng nó.
Phiên bản ngắn gọn
- Gói biên dịch lại: nhanh hơn có thể đo được, trên một phần nhỏ những gì bạn chạy. Mức tăng tập trung vào mã mà trình biên dịch có thể vector hóa, vài gói lại chậm đi, và phần lớn không đổi. Một so sánh trong arch-chroot vào tháng 1/2023 trên sunnyflunk.github.io, trên Intel NUC8i5BEK, thấy mã hóa flac nhanh hơn 20,2% và giải nén bzip2 chậm hơn 7,1% trong cùng một lượt chạy.
- Câu chuyện về bộ lập lịch tách làm hai. Kernel mặc định hiện tại của CachyOS dùng EEVDF, còn BORE có sẵn riêng. Các so sánh bản phân phối tháng 5/2026 thấy chênh lệch FPS trung bình nhỏ và cũng đo 1% low cùng độ đều khung hình, nhưng không tách riêng BORE hay thêm tải CPU cạnh tranh có kiểm soát. Chơi game ở cấu hình mặc định đã được đo; lợi ích của BORE khi tranh chấp CPU thì chưa được tách riêng.
- Cảm giác máy nhanh hơn: trải nghiệm thật, quy nguyên nhân không đáng tin. Một bản cài mới và một lỗi không liên quan tình cờ được sửa đều tạo ra hệ thống nhanh nhẹn hơn mà chẳng nhờ gì vào các cấp tập lệnh. Ngoại lệ đáng biết là so sánh cấu hình mặc định của Phoronix trên Intel Core Ultra 9 285K, nơi CachyOS vượt Arch tiêu chuẩn trên một CPU hoàn toàn không dùng được các tối ưu hóa AVX-512.
CachyOS thực sự thay đổi gì trên hệ thống của bạn
CachyOS là Arch Linux với ba thay đổi riêng biệt xếp chồng lên: một kernel được vá cung cấp các bộ lập lịch thay thế, các kho lưu trữ có gói được biên dịch lại cho các cấp tập lệnh CPU mới hơn, và các tối ưu hóa trình biên dịch bổ sung trên một phần các gói lõi. Mỗi thứ là một cơ chế riêng với tác động riêng, và hầu như không bao giờ được đo tách biệt.
Phía kernel là bề mặt lớn nhất. Danh sách tính năng kernel của CachyOS bao gồm Clang ThinLTO, profiling AutoFDO, các chế độ preemption chọn được lúc chạy, và vài tùy chọn bộ lập lịch. Gói linux-cachyos hiện tại dùng EEVDF do CachyOS tinh chỉnh làm bộ lập lịch mặc định. BORE và BMQ có sẵn qua các biến thể kernel riêng, trong khi linux-cachyos-eevdf áp dụng thêm tinh chỉnh độ phản hồi cho EEVDF và linux-cachyos-server dùng EEVDF nguyên bản. sched-ext vẫn có sẵn trên các biến thể hỗ trợ nó.
Về phía gói, các kho x86-64-v3 của CachyOS là cơ chế đang được bàn. Trang kho lưu trữ tối ưu hóa của CachyOS mô tả việc xây dựng lại các gói Arch cho ba mục tiêu trên nền chung: x86-64-v3, x86-64-v4, và một mục tiêu Zen 4/5 riêng bổ sung thêm các phần mở rộng AVX-512, cộng một số lệnh ngoài AVX-512, trên nền v4. Một phần các gói nhạy cảm về hiệu năng còn nhận tối ưu hóa theo hồ sơ và BOLT.
Những tên cấp đó đến từ đặc tả cấp vi kiến trúc x86-64 psABI, và chúng là ngưỡng, không phải núm vặn. x86-64-v3 yêu cầu các lệnh thời AVX và AVX2 xuất hiện cùng Haswell của Intel năm 2013 và các nhân Excavator của AMD; x86-64-v4 yêu cầu AVX-512, trong thực tế nghĩa là các chip Intel dòng Skylake-X và mọi AMD Zen 4 trở lên. Một CPU hoặc vượt ngưỡng, hoặc không.
Ba khẳng định ẩn trong từ "nhanh hơn"
Khi hai người bất đồng về việc CachyOS có nhanh hơn không, thường cả hai đều đúng về những điều khác nhau. Thông lượng, độ ổn định khung hình và độ phản hồi cảm nhận là các thuộc tính riêng, và không một chỉ số nào giải quyết cả ba. Một tác vụ đo thời gian đo thông lượng; đo thời gian khung hình và độ trễ bao quát độ mượt khi chơi game; một so sánh bản cài mới có kiểm soát là cần thiết cho hiệu ứng rộng hơn ở cấp hệ thống.
| Khẳng định | Điều được khẳng định | Bạn đo nó thế nào | Bằng chứng cho thấy gì | Độ tin cậy |
|---|---|---|---|---|
| Thông lượng đo được | Gói biên dịch lại hoàn thành cùng tác vụ trong thời gian ngắn hơn | Đo thời gian một tác vụ trên phần cứng cố định và kernel cố định, chỉ thay đổi kho mà gói được lấy từ đó | Tăng đáng kể trên công việc vector hóa được, thoái lui nhỏ ở vài gói, không đổi ở phần lớn | Cao. Canonical, CentOS ISA SIG và hai người benchmark độc lập đồng thuận về hình dạng kết quả |
| Độ trễ đầu vào và độ ổn định khung hình | Desktop vẫn phản hồi trong khi thứ khác chiếm hết CPU | Phân vị thời gian khung hình và độ trễ đầu vào dưới tải cạnh tranh, không phải tốc độ khung hình trung bình | Các thử nghiệm đã công bố nay bao gồm 1% low và độ đều khung hình, nhưng không tách riêng bộ lập lịch hay đưa vào tải CPU cạnh tranh có kiểm soát | Thấp. Cơ chế được ghi nhận, phép đo còn thiếu |
| Độ phản hồi cảm nhận | Máy cảm giác nhanh nhẹn hơn sau khi chuyển | So với bản cài mới của bản phân phối trước, không phải bản đã cũ mòn | Thường được giải thích bằng hiệu ứng cài mới hoặc một sửa lỗi tình cờ; một so sánh cấu hình mặc định thấy lợi thế ở cấp bản phân phối | Trung bình. Trải nghiệm có cơ sở, quy nguyên nhân không đáng tin |
Một bộ benchmark trả lời hàng đầu tiên không thể trả lời hàng thứ hai, và cả hai đều không chạm tới hàng thứ ba. Chạy một trong ba rồi báo kết quả như phán quyết cho cả ba là điều khiến cuộc tranh luận không dứt.
Gói biên dịch lại có thực sự chạy nhanh hơn?
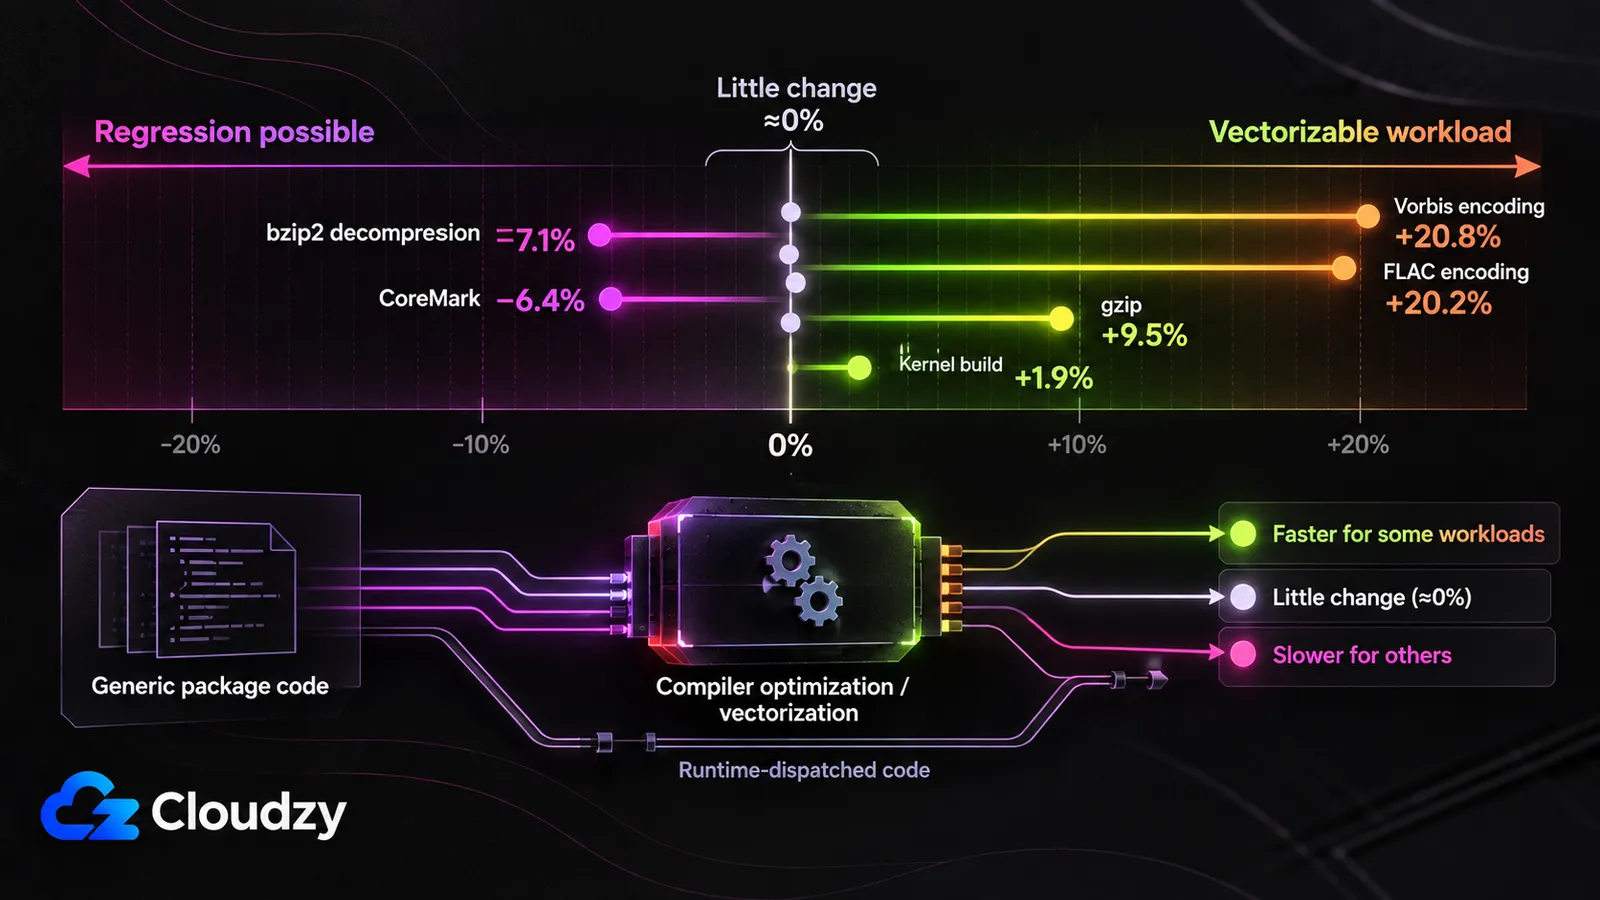
Có, trên một phần nhỏ những gì desktop chạy, và mức độ do khối lượng công việc quyết định, không phải bản phân phối. Công việc vector hóa được tăng hai chữ số, một nhúm gói chậm đi, và phần lớn không cho thấy gì. Trang kho tối ưu hóa của CachyOS đặt mức tăng x86-64-v3 ở 5% đến 20% so với x86-64 chung; các phép đo đã công bố phần lớn nằm ở đầu thấp.
So sánh hiệu năng CachyOS và Arch sạch nhất tách riêng biến số gói và không gì khác: một thử nghiệm arch-chroot tháng 1/2023 trên sunnyflunk.github.io. Máy chủ chạy Arch tiêu chuẩn trên Intel NUC8i5BEK, cả hai bộ gói được thử trong arch-chroot để kernel và môi trường giữ nguyên, và các benchmark chạy trong RAM để loại bỏ độ trễ đĩa. So với gói Arch tiêu chuẩn, các bản dựng CachyOS nhanh hơn 20,2% khi mã hóa flac với -8, nhanh hơn 20,8% khi mã hóa vorbis và nhanh hơn 9,5% trên gzip -3. Trong cùng lượt chạy, chúng chậm hơn 7,1% khi giải nén bzip2, chậm hơn 1,6% đến 2,9% khi nén với lz4, chậm hơn 3% trên pybench và không đổi trên benchmark R. Hai lưu ý đến từ chính tác giả: CachyOS dựng với -march=x86-64-v3 -mpclmul -O3 so với -march=x86-64 -O2của Arch, và các thử nghiệm tiếp theo của anh cho thấy -O3 chứ không phải cấp tập lệnh mới giải thích một phần các mức tăng lớn hơn. Bài viết có trước kho Zen 4 của CachyOS, ra đời cùng bản phát hành tháng 7/2024, nhưng không trước công việc BOLT: tác giả đọc gói Python của CachyOS đứng sau thoái lui pybench là đã mang BOLT trên nền x86-64-v3.
Các benchmark CachyOS trên phần cứng mới hơn lặp lại mô hình đó. Một so sánh tháng 7/2024 trên mvermeulen.org chạy một phần Phoronix Test Suite trên Ryzen 7940HS Zen 4, CachyOS với kho Zen 4 so với Ubuntu 22.04. Phần lớn kết quả nằm trong vài phần trăm theo cả hai chiều: coremark chậm hơn 6,4%, các bài con OpenSSL từ chậm hơn khoảng 1% đến nhanh hơn 4%, thời gian dựng kernel nhanh hơn 1,9%, phpbench là ngoại lệ với điểm hơn gấp đôi một chút. Tác giả đánh dấu lệch phiên bản GCC, 14.1 so với 11.4 của Ubuntu, là yếu tố gây nhiễu có thể. Lượt chạy NAMD riêng của anh vào tháng 3/2024 thấy cải thiện 6,5% và 5,8% trên hai khối lượng công việc động lực học phân tử.
Thử nghiệm cấp tổ chức thấy cùng bức tranh lẫn lộn ở cả hai đầu. Benchmark x86-64-v3 của chính Canonical, công bố tháng 3/2024 với image Ubuntu 23.10 thử nghiệm trên Azure, báo cáo mức tăng có thể tái lập lên tới 60% trên benchmark glibc Log2 trong khi các benchmark khác thoái lui đáng kể, trong một trường hợp vì bật v3 trên mã SSE đã tối ưu khiến trình biên dịch mở rộng nó thành gấp 17 lần số lệnh. Việc CentOS ISA SIG xây dựng lại CentOS Stream 9 từ v2 lên v3, trên các máy Intel dòng Ice Lake vào tháng 8/2023, gọi kết quả là "khá lẫn lộn", với mức tăng tốc 2,2 lần tập trung ở Mocassin và md5crypt của John the Ripper, cả hai đều nặng về vector hóa, dù nhóm quy mức tăng của Mocassin chủ yếu cho tự động vector hóa của GCC 12 chứ không phải cấp ISA.
Nhiều thư viện toán học và mật mã quan trọng về hiệu năng đi kèm nhiều phiên bản của các hàm nóng và chọn một phiên bản lúc chạy qua phát hiện tính năng CPU, kỹ thuật gọi là function multiversioning và được triển khai trong glibc qua các resolver IFUNC. Nghĩa là một số đường nóng đã có thể dùng AVX2 trên bản cài Arch tiêu chuẩn mà không cần dựng lại cả gói. Bài của sunnyflunk thấy điều này trực tiếp, ghi nhận rằng mã nguồn flac đã có sẵn các hàm AVX2 lúc chạy không cần -march để bật. Phát hiện của CentOS là hình ảnh phản chiếu: nhóm tìm thấy các hàm toán glibc thiếu phiên bản IFUNC, chính là nơi một bản dựng lại tĩnh có chỗ để giúp. Thứ mà bản dựng lại v3 chạm tới là phần mã còn lại mà bộ tự động vector hóa của trình biên dịch có thể tự cải thiện, tức một lát của desktop, và là lát nhỏ.
Hình dạng khối lượng công việc, chứ không phải nhãn trên CPU, quyết định liệu một thay đổi cấp máy có hiện ra hay không. Phán quyết về thông lượng là có, nhưng có giới hạn: thay đổi một chữ số phổ biến trong các phép đo trên, mức tăng lớn hơn tụ quanh các khối lượng công việc vector hóa được như mã hóa và nén, và một số gói thoái lui. Đó là mô tả tốt hơn việc coi x86-64-v3 như hệ số nhân tốc độ toàn hệ thống.
Bộ lập lịch thay đổi gì, và vì sao FPS trung bình bỏ lỡ điều đó
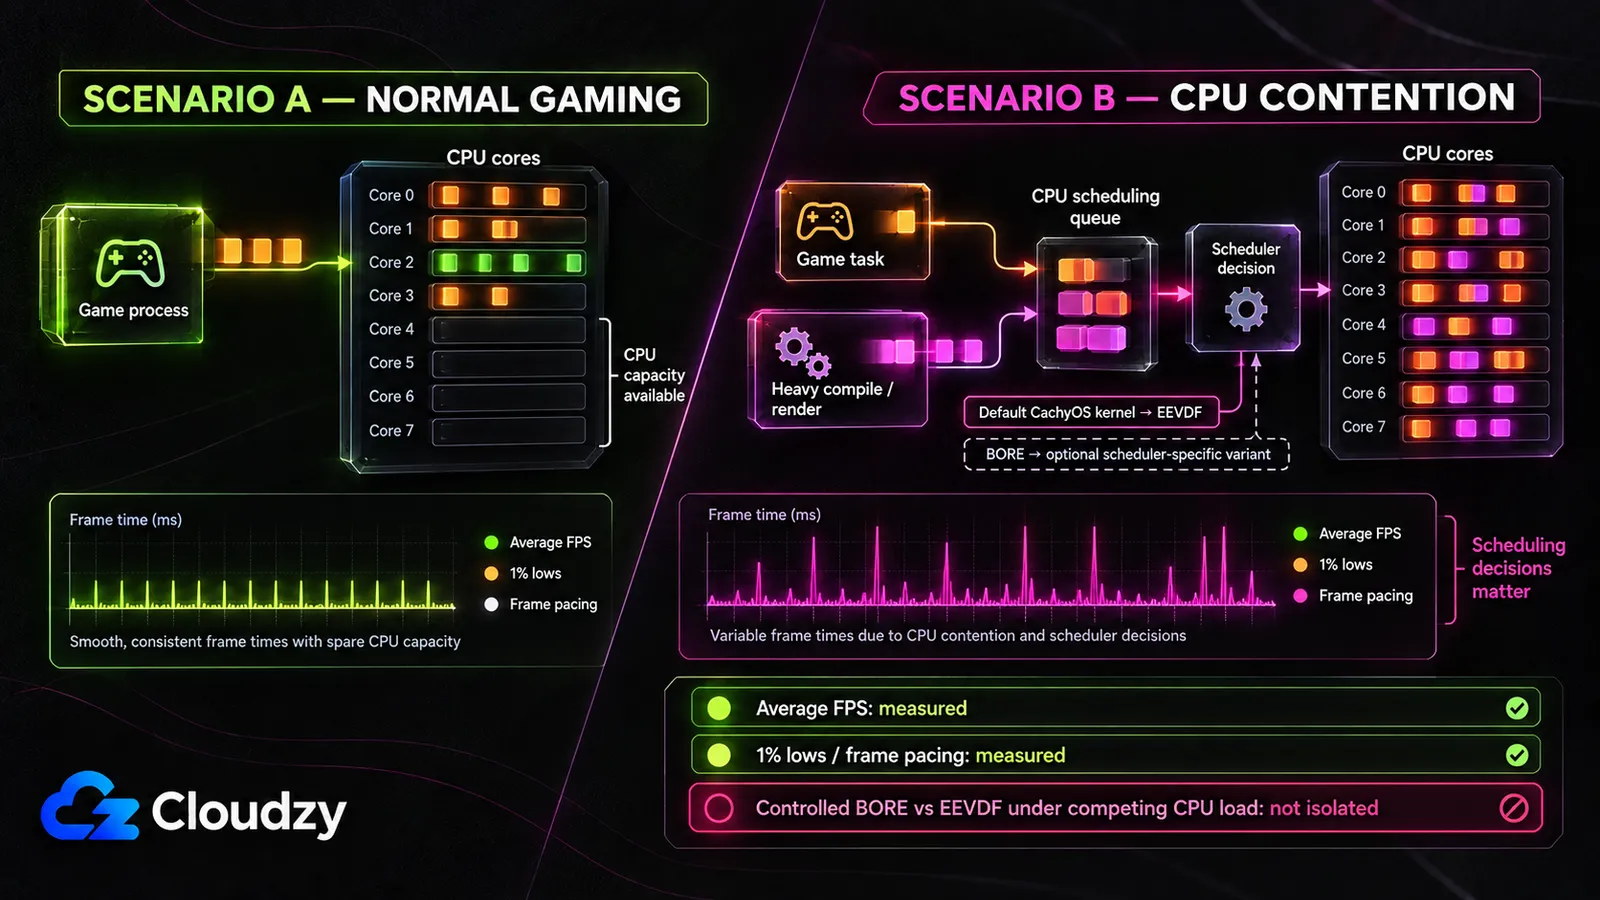
Kernel mặc định hiện tại của CachyOS, linux-cachyos , dùng EEVDF, còn BORE có sẵn qua các biến thể theo bộ lập lịch như linux-cachyos-bore. Sự phân biệt đó quan trọng vì các so sánh chơi game bên dưới là thử nghiệm cấp bản phân phối, không phải thử nghiệm có kiểm soát BORE so với EEVDF. BORE vẫn liên quan đến khẳng định hiệu năng rộng hơn vì thiết kế của nó nhắm rõ vào độ phản hồi dưới khối lượng công việc hỗn hợp, nhưng khẳng định đó phải được đánh giá tách biệt với hiệu năng chơi game mặc định của CachyOS.
README của chính BORE nêu rõ ý định:
Để đạt được điều này, BORE đưa vào một chiều linh hoạt gọi là "burstiness" cho từng tác vụ riêng lẻ, tách một phần khỏi nguyên tắc "công bằng hoàn toàn" vốn có của CFS.
firelzrd/bore-scheduler, README của dự án
Burstiness là thời gian CPU mà một tác vụ tích lũy kể từ lần cuối nó nhường CPU bằng cách ngủ, chờ I/O hoặc nhường lượt. BORE chuyển nó thành điểm số và dùng để điều chỉnh trọng số mỗi tác vụ cùng mức độ ưu tiên chiếm quyền khi thức dậy, nên các tác vụ liên tục nhường lượt được coi là tương tác và được ưu ái so với các tác vụ chiếm trọn phần thời gian của mình. README tự nêu tên sự đánh đổi: BORE ổn định ở "trạng thái cân bằng giữa các tác vụ tham lam và yếu (thường là tác vụ theo lô bị giới hạn bởi CPU) và các tác vụ khiêm tốn và mạnh (thường là tác vụ tương tác bị giới hạn bởi I/O)". Tăng trọng số công việc tương tác cũng chính là giảm trọng số công việc thông lượng theo lô.
Điều đó cho bạn biết công cụ nào sẽ phát hiện khẳng định riêng của BORE: đưa vào tải CPU cạnh tranh và đo phân vị thời gian khung hình hoặc độ trễ đầu vào trong khi chỉ thay đổi bộ lập lịch. Bộ lập lịch có ít việc để phân xử hơn hẳn khi game chạy với dung lượng CPU còn rảnh.
Một benchmark năm trò chơi công bố ngày 16/5/2026 dùng các bản cài sạch CachyOS và Omarchy trên cùng SSD và phần cứng, RTX 5060 Ti và Ryzen 9, với cùng bản dựng Proton-GE và thiết lập 1440p. FPS trung bình chỉ chênh một hai khung hình. Hai ngày sau, cùng người thử nghiệm đã công bố một so sánh thứ hai với ghi log khung hình đầy đủ bằng MangoHUD, bổ sung 5% low, 1% low và phương sai độ đều khung hình. Thử nghiệm thứ hai đó dùng phần cứng khác, Intel i7-13700 và Radeon RX 9060 XT, nên nó là bằng chứng bổ sung về độ ổn định khung hình chứ không phải phần mở rộng của thử nghiệm đầu trên cùng phần cứng. Không so sánh nào tách riêng bộ lập lịch CPU hay thêm khối lượng công việc CPU cạnh tranh có chủ đích.
Dự án cũng không thổi phồng. Trong một chủ đề trên r/cachyos về hiệu năng chơi game, Peter Jung, một trong những nhà phát triển sáng lập CachyOS, đã trả lời thẳng một người dùng: "In gaming not all too much. The newer feature can make a difference tough :)" (khi chơi game thì không nhiều lắm; tính năng mới hơn vẫn có thể tạo khác biệt).
Điều đó để lại hai kết luận riêng. Với chơi game trên CachyOS mặc định, các thử nghiệm đã công bố cho thấy chênh lệch FPS trung bình nhỏ và nay có cả phép đo 1% low và độ đều khung hình. Với BORE nói riêng dưới tranh chấp CPU có chủ đích, tôi không tìm được thử nghiệm có kiểm soát nào đã công bố chỉ thay đổi bộ lập lịch và đo độ phản hồi dưới tải đó.
Vì sao chuyển đổi cho cảm giác nhanh hơn ngay cả khi không đo được gì nhanh hơn
Hai cơ chế tạo ra chiếc máy nhanh nhẹn hơn sau khi đổi bản phân phối mà không cần bất kỳ tối ưu hóa nào của CachyOS: bản thân việc cài mới, và một vấn đề không liên quan của hệ thống cũ tình cờ được sửa. Cả hai đủ cụ thể để nhận ra trong trường hợp của chính bạn, đó là điều tách chúng khỏi cáo buộc chung chung về hiệu ứng giả dược.
Bắt đầu với bản cài mới. Trong một chủ đề trên r/linuxquestions về câu hỏi này, một người dùng CachyOS nói bản thân không nhận thấy khác biệt đã gợi ý rằng những người báo cáo mức tăng lớn có thể đang so với một bản cài đã dùng lâu thay vì bản mới. Nhiều năm tích tụ các mục tự khởi động, dịch vụ mồ côi, cấu hình trôi dạt và ổ đĩa đầy là một khối lượng công việc, và một phân vùng sạch xóa sạch tất cả cùng lúc. Đổi bản phân phối thay đổi đồng thời kernel, môi trường desktop, mọi phiên bản gói và mọi mặc định, và một so sánh đầy đủ Manjaro với Ubuntu trải dài trên cả chục trục riêng biệt. Quy cải thiện cho một trục trong số đó sau này chỉ là đoán mò.
Sửa lỗi tình cờ là trường hợp rõ hơn. Trong cùng chủ đề, một người bình luận kể việc dùng Fedora hằng ngày với một vấn đề quản lý VRAM làm giảm hiệu năng nghiêm trọng, chuyển sang CachyOS và thấy vấn đề biến mất. Sau đó anh chuyển sang Arch thuần và báo cáo hiệu năng về cơ bản giống CachyOS, kết luận rằng anh không còn biết điều gì đã khác. Cải thiện là thật; các mục tiêu biên dịch của CachyOS không liên quan gì.
Không điều nào trong đó cho phép bác bỏ gọn gàng, và bằng chứng mạnh nhất chống lại bác bỏ đó là một thử nghiệm có kiểm soát. So sánh bản phân phối trên Arrow Lake của Phoronix đặt Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux và CachyOS trên cùng Intel Core Ultra 9 285K ở trạng thái mặc định, và CachyOS nhỉnh hơn tất cả, kể cả Clear Linux vốn thường dẫn đầu trên silicon Intel. Arrow Lake không hỗ trợ AVX-512, nên lợi thế đó không thể đến từ x86-64-v4; nó phản ánh sự kết hợp nào đó của các lựa chọn kernel và bản dựng của CachyOS, tối ưu hóa gói và cấu hình mặc định.
Trải nghiệm có thể là thật trong khi việc quy nguyên nhân vẫn không chắc chắn. So sánh Arrow Lake của Phoronix là phản ví dụ hữu ích: một bản cài CachyOS ở trạng thái mặc định có thể vượt Arch tiêu chuẩn ngay cả khi x86-64-v4 không khả dụng.
Cách kiểm tra xem điều nào trong đây áp dụng cho máy của bạn
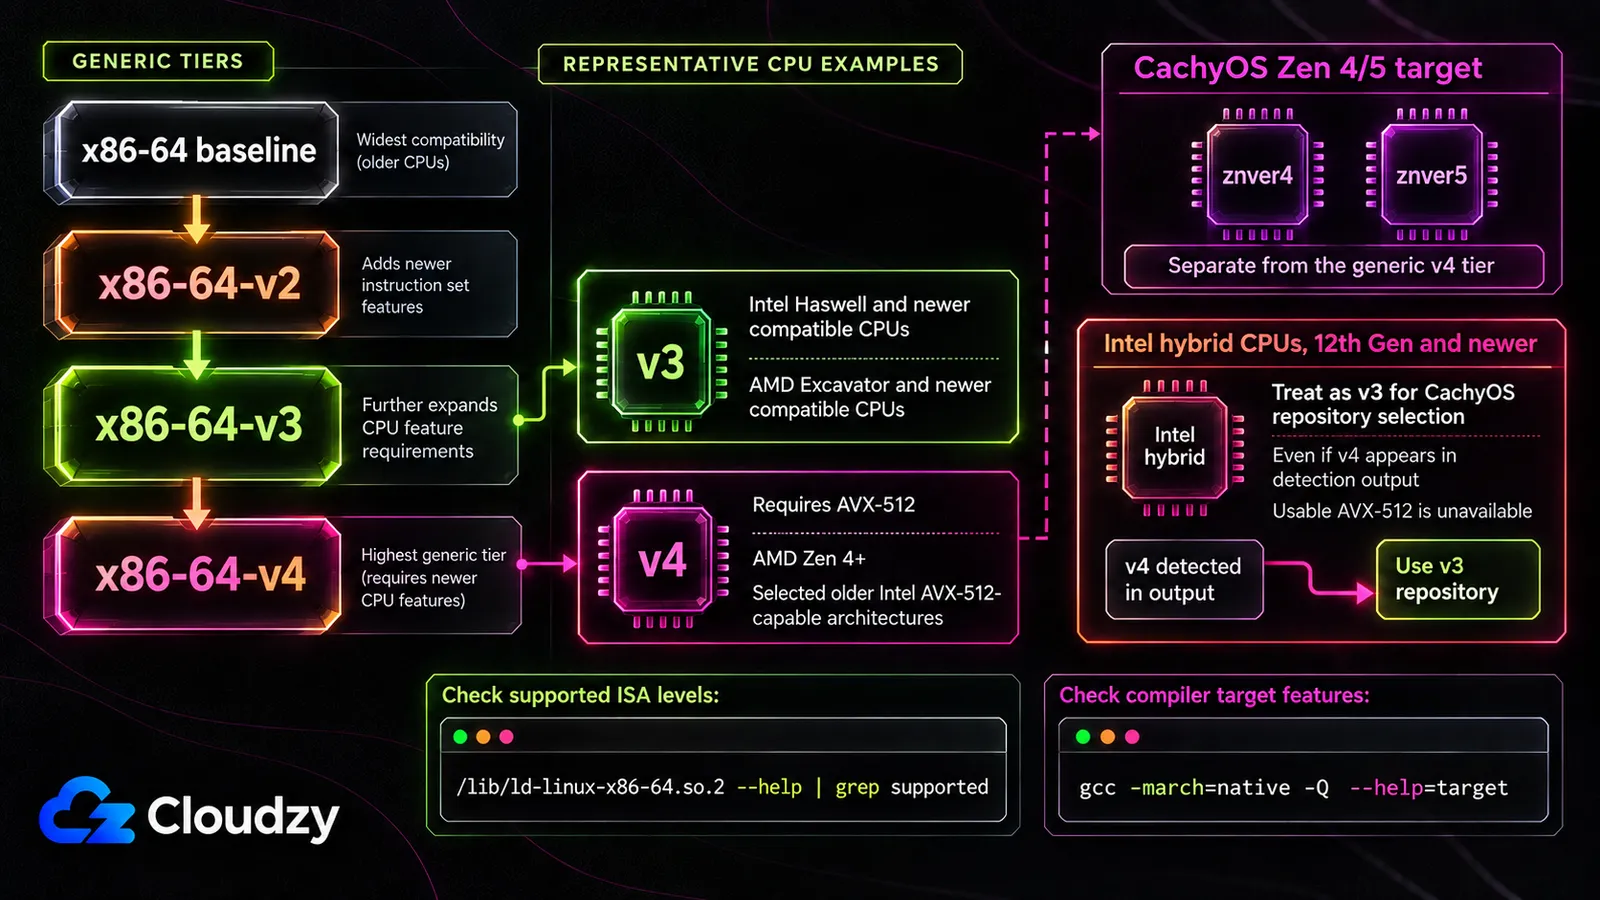
CPU của bạn hỗ trợ cấp vi kiến trúc x86-64 chuẩn hóa nào phần lớn trả lời được bằng một lệnh. Trình liên kết động báo các cấp glibc-hwcaps nó dùng được, nên mục x86-64-vN cao nhất được hỗ trợ thường cho biết CPU có đủ điều kiện cho tầng kho chung v2, v3 hay v4. Một ngoại lệ quan trọng là CPU lai Intel thế hệ 12 trở lên: CachyOS nói hãy coi chúng là v3 dù v4 xuất hiện trong kết quả, vì AVX-512 không dùng được ở đó. Mục tiêu Zen 4/5 riêng của CachyOS cũng cần kiểm tra kiến trúc riêng.
/lib/ld-linux-x86-64.so.2 --help | grep supportedVới AMD Zen 4/5, CachyOS còn ghi nhận:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Lệnh đầu tiên in ra thứ gì đó như sau:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Đó là một CPU có v3 và v2 nhưng không có AVX-512. Ba kết quả, ba quyết định:
- Không có gì trên x86-64-v2. Lợi thế dựng lại riêng cho v3/v4/Zen không áp dụng cho CPU này. CachyOS vẫn chạy được, và các tối ưu hóa trình biên dịch theo từng gói cùng thay đổi kernel và cấu hình mặc định vẫn có thể đáng kể.
- x86-64-v3 được hỗ trợ, x86-64-v4 không khả dụng. Điều này bao gồm các CPU lai Intel hiện đại như Arrow Lake khi chọn kho thực tế. Trong các so sánh trích dẫn ở trên, nhiều thay đổi nhỏ, một số khối lượng công việc mã hóa và nén tăng nhiều hơn hẳn, và một số gói thoái lui.
- x86-64-v4 được hỗ trợ. AVX-512 tạo thêm dư địa lý thuyết cho các khối lượng công việc vector hóa được, nhưng không bảo đảm mức tăng lớn toàn hệ thống.
Nếu CPU của bạn đủ điều kiện và phần gói là thứ bạn muốn, bạn không cần cài lại để có nó. Các kho của CachyOS có thể thêm vào hệ thống Arch hiện có, và ALHP phát hành các bản dựng lại kho chính thức của Arch ở từng cấp x86-64-vN, được ghi nhận trên Arch Wiki với các lưu ý riêng: cần gói DKMS thay cho các module kernel liên kết trực tiếp, và đặt -march cho việc biên dịch kernel "sẽ không mang lại kết quả đáng kể nào". Cả hai đường đều cho bạn các gói biên dịch lại và không có gì từ bộ vá kernel hay các biến thể bộ lập lịch.
Chạy lệnh trước đã. Nó biến một tranh luận về bản phân phối thành một sự thật về chính máy của bạn, phiên bản duy nhất của câu hỏi này mà bạn có thể tự giải quyết ngay tối nay.

Xây dựng trên VPS Linux với quyền root, NVMe và sức mạnh AMD EPYC.
Xem các gói LinuxCâu hỏi thường gặp
CachyOS có thực sự cải thiện hiệu năng chơi game?
Về tốc độ khung hình trung bình, gần như không. Một so sánh năm trò chơi tháng 5/2026 chỉ thấy chênh một đến hai khung hình, và bài tiếp theo hai ngày sau cũng đo 1% low và độ đều khung hình. Không thử nghiệm nào đưa vào khối lượng công việc CPU cạnh tranh có chủ đích, nên câu hỏi chưa giải quyết là độ phản hồi của bộ lập lịch khi tranh chấp, không phải liệu độ đều khung hình đã được đo hay chưa.
CPU của tôi có hỗ trợ x86-64-v3 hay v4?
Trên CachyOS hoặc Arch, chạy /lib/ld-linux-x86-64.so.2 --help | grep supported để xem các cấp glibc-hwcaps chuẩn hóa được phát hiện cho CPU của bạn. x86-64-v3 yêu cầu bộ tính năng thời AVX/AVX2, còn v4 thêm AVX-512. Với CPU lai Intel thế hệ 12 trở lên, CachyOS khuyến nghị coi hệ thống là v3 dù v4 xuất hiện trong kết quả; người dùng Zen 4/5 cũng nên kiểm tra mục tiêu znver4/znver5 riêng.
Vì sao các gói biên dịch lại không tạo khác biệt lớn hơn?
Vì một phần mã được tối ưu mạnh đã được điều phối lúc chạy tới các triển khai riêng cho từng CPU. Các thư viện toán học và mật mã thường dùng function multiversioning hoặc IFUNC cho các hàm nóng, nên dựng lại gói chủ yếu giúp phần mã mà trình biên dịch còn có thể tối ưu hoặc vector hóa thêm trên toàn cục.
Tôi có thể lấy các gói tối ưu hóa của CachyOS mà không đổi bản phân phối không?
Có. Các kho của CachyOS có thể thêm vào bản cài Arch Linux hiện có, và dự án ALHP phát hành các bản dựng lại kho chính thức của Arch nhắm tới x86-64-v2, v3 và v4, được ghi nhận trên Arch Wiki. Cả hai chỉ cho bạn các gói biên dịch lại, không phải bộ vá kernel của CachyOS, các bộ lập lịch thay thế hay các mặc định của trình cài đặt.
Thảo luận
Bình luận
Đăng nhập để tham gia thảo luận.