
Uživatel na r/linuxquestions provedl srovnání, o kterém se všichni pořád hádají. Nainstaloval CachyOS, otestoval několik her na Ryzenu 7 7800X3D s Radeonem RX 7900 XTX a nenaměřil žádný rozdíl oproti ostatním distribucím, které už na stroji měl. Odpovědi šly obvyklou cestou. Jeden komentující nastavil strop tak nízko, že je v běžném používání neviditelný. Druhý vysvětlil plánovač. Třetí řekl, že benchmarky nedokážou ukázat, co plánovač dělá. Nikdo nepředložil měření, které by věc rozhodlo.
Otázka se vrací pořád stejnými slovy: je CachyOS opravdu rychlejší? Krátká odpověď zní ano, u konkrétních zátěží. Překompilované balíčky mohou pomoci kódu, který kompilátor umí vektorizovat, zde citovaná herní srovnání ukazují malý rozdíl v průměrných FPS a systém, který po přechodu působí rychleji, se hůř přisuzuje jedné příčině, protože změna distribuce mění mnohem víc než jednu proměnnou.
Zůstává nerozhodnutá, protože „rychlejší“ v sobě nese tři samostatná tvrzení se třemi různými odpověďmi a každé potřebuje vlastní nástroj. Překompilované balíčky buď dokončí úlohu za kratší reálný čas, nebo ne. Plánovač buď změní chování desktopu při souběžné zátěži, nebo ne. A svižnější stroj má původ buď v CachyOS, nebo v něčem, co přišlo spolu s ním.
Zkrácená verze
- Překompilované balíčky: měřitelně rychlejší, u menšiny toho, co spouštíte. Zisky se soustředí v kódu, který kompilátor umí vektorizovat, několik balíčků vychází pomaleji a většina se nemění. Srovnání v arch-chroot z ledna 2023 na sunnyflunk.github.io, na Intelu NUC8i5BEK, naměřilo kódování flac o 20,2 % rychlejší a dekompresi bzip2 o 7,1 % pomalejší v témže běhu.
- Příběh plánovače se dělí na dvě části. Aktuální výchozí jádro CachyOS používá EEVDF, zatímco BORE je k dispozici zvlášť. Srovnání distribucí z května 2026 našla malý rozdíl v průměrných FPS a změřila i 1% minima a rozestupy snímků, ale neizolovala BORE ani nepřidala řízenou souběžnou zátěž CPU. Hraní „z krabice“ změřeno bylo; přínos BORE při souběžné zátěži izolován nebyl.
- Pocit rychlejšího stroje: skutečná zkušenost, nespolehlivé přisouzení. Čistá instalace i náhodná oprava nesouvisející chyby dávají svižnější systém, který za nic nevděčí úrovním instrukční sady. Výjimkou, o které stojí za to vědět, je srovnání Phoronixu v továrním stavu na Intelu Core Ultra 9 285K, kde CachyOS předstihl standardní Arch na procesoru, který optimalizace AVX-512 vůbec nemůže využít.
Co CachyOS na vašem systému skutečně mění
CachyOS je Arch Linux se třemi samostatnými úpravami navrch: záplatovaným jádrem nabízejícím alternativní plánovače, repozitáři, jejichž balíčky jsou překompilované pro novější úrovně instrukční sady CPU, a dalšími optimalizacemi kompilátoru na podmnožině základních balíčků. Každá je samostatný mechanismus se samostatným účinkem a téměř nikdy se neměří odděleně.
Strana jádra je největší plocha. Seznam funkcí jádra CachyOS zahrnuje Clang ThinLTO, profilování AutoFDO, za běhu volitelné režimy preempce a několik možností plánovače. Aktuální balíček linux-cachyos používá jako výchozí plánovač EEVDF vyladěný CachyOS. BORE a BMQ jsou k dispozici v samostatných variantách jádra, přičemž linux-cachyos-eevdf aplikuje další ladění odezvy EEVDF a linux-cachyos-server používá standardní EEVDF. sched-ext zůstává k dispozici na variantách, které ho podporují.
Na straně balíčků jsou dotčeným mechanismem repozitáře CachyOS x86-64-v3. Stránka optimalizovaných repozitářů CachyOS popisuje přestavbu balíčků Archu pro tři cíle nad obecným základem: x86-64-v3, x86-64-v4 a vyhrazený cíl Zen 4/5, který na v4 přidává další rozšíření AVX-512 plus některé instrukce mimo AVX-512. Podmnožina výkonově citlivých balíčků dostává také optimalizaci řízenou profilem a BOLT.
Tyto názvy úrovní pocházejí ze specifikace úrovní mikroarchitektury x86-64 psABIa jsou to prahy, ne otočné knoflíky. x86-64-v3 vyžaduje instrukce éry AVX a AVX2, které přišly s Intel Haswellem v roce 2013 a jádry AMD Excavator; x86-64-v4 vyžaduje AVX-512, což v praxi znamená čipy Intel třídy Skylake-X a každé AMD Zen 4 nebo novější. Procesor laťku buď zdolá, nebo ne.
Tři tvrzení schovaná ve slově „rychlejší“
Když se dva lidé neshodnou, zda je CachyOS rychlejší, obvykle mají oba pravdu, jen o různých věcech. Propustnost, konzistence snímků a vnímaná odezva jsou samostatné vlastnosti a žádná jediná metrika nerozhodne všechny tři. Časovaná úloha měří propustnost; měření časů snímků a latence pokrývají plynulost her; pro širší efekt na úrovni systému je potřeba řízené srovnání s čistou instalací.
| Tvrzení | Co se tvrdí | Jak to změřit | Co ukazují důkazy | Jistota |
|---|---|---|---|---|
| Naměřená propustnost | Překompilované balíčky dokončí stejnou úlohu za kratší čas | Změřit jednu úlohu na pevném hardwaru a pevném jádře, měnit jen repozitář, ze kterého balíčky pocházejí | Solidní zisky u vektorizovatelné práce, malé regrese u několika balíčků, žádná změna u většiny | Vysoká. Canonical, CentOS ISA SIG a dva nezávislí testeři se shodují na tvaru výsledků |
| Vstupní latence a konzistence snímků | Desktop zůstává responzivní, zatímco něco jiného saturuje CPU | Percentily časů snímků a vstupní latence při souběžné zátěži, ne průměrná snímková frekvence | Publikované testy už zahrnují 1% minima a rozestupy snímků, ale neizolují plánovač ani nezavádějí řízenou souběžnou zátěž CPU | Nízká. Mechanismus je zdokumentovaný, měření chybí |
| Vnímaná odezva | Stroj po přechodu působí svižněji | Srovnávat s čistou instalací předchozí distribuce, ne s tou opotřebovanou | Obvykle vysvětleno efekty čisté instalace nebo náhodnou opravou; jedno srovnání v továrním stavu našlo náskok na úrovni distribuce | Střední. Oprávněná zkušenost, nespolehlivé přisouzení |
Sada benchmarků, která odpovídá na první řádek, nemůže odpovědět na druhý, a ani jedna se nedotýká třetího. Spustit jeden ze tří a vydávat výsledek za verdikt nad všemi třemi je to, co drží tu debatu při životě.
Běží překompilované balíčky opravdu rychleji?
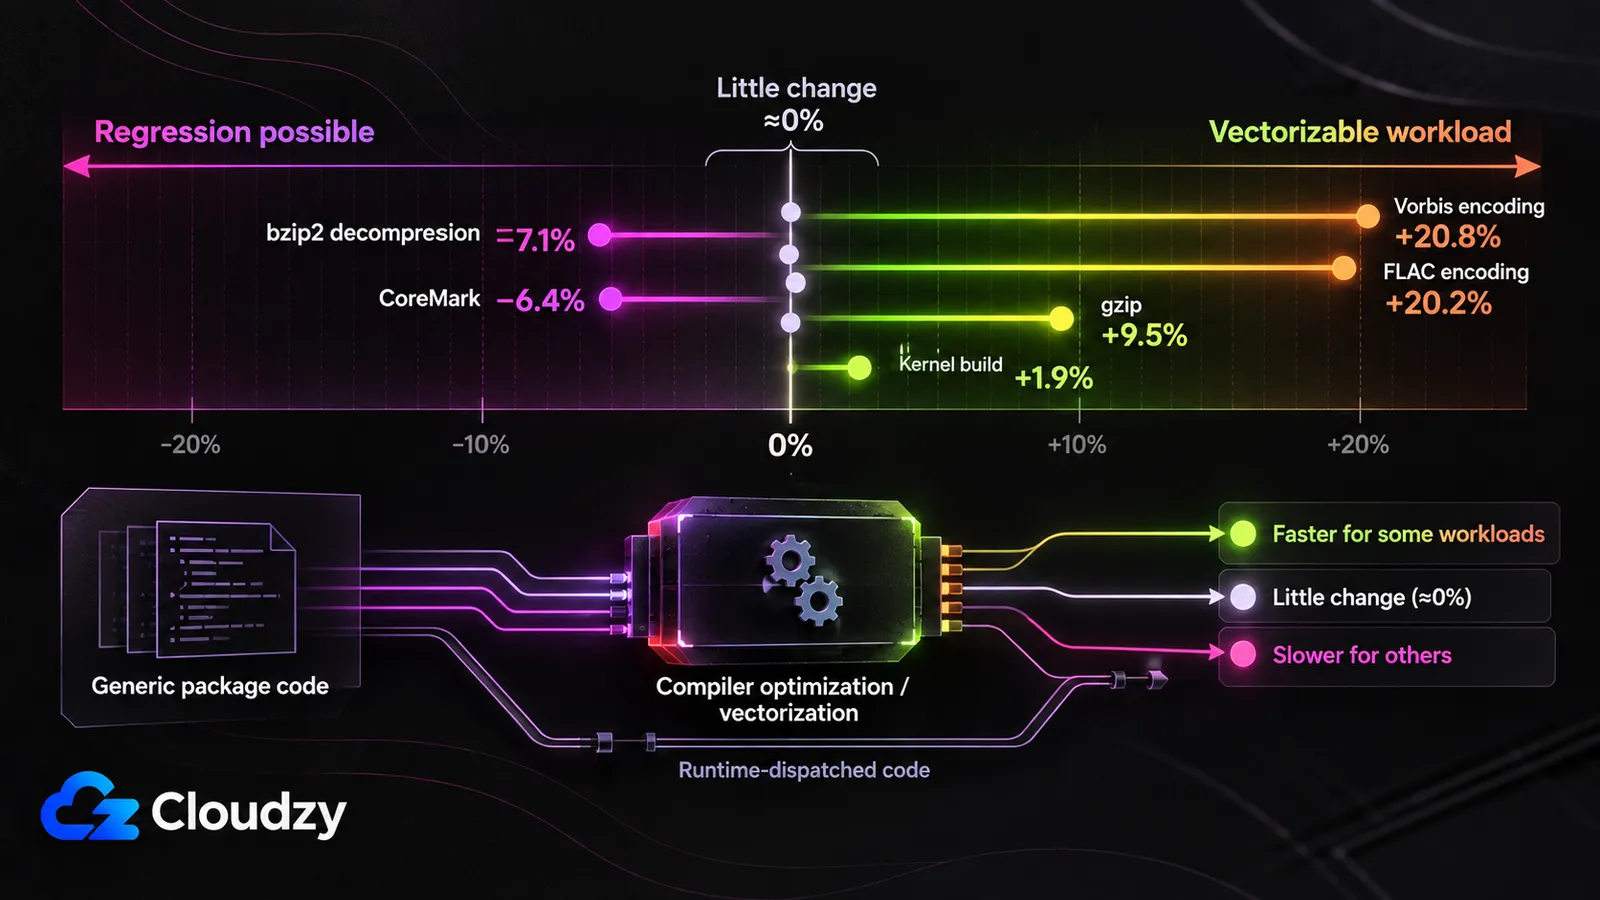
Ano, u menšiny toho, co desktop spouští, a velikost určuje zátěž, ne distribuce. Vektorizovatelná práce vidí dvouciferné zisky, hrstka balíčků vychází pomaleji a většina neukazuje nic. Stránka optimalizovaných repozitářů CachyOS udává nárůst x86-64-v3 na 5 % až 20 % oproti obecnému x86-64; publikovaná měření se většinou drží u spodní hranice.
Nejčistší srovnání výkonu CachyOS vs Arch izoluje proměnnou balíčků a nic jiného: test v arch-chroot z ledna 2023 na sunnyflunk.github.io. Hostitel běžel na standardním Archu na Intelu NUC8i5BEK, obě sady balíčků se testovaly uvnitř arch-chroot, aby jádro i prostředí zůstaly totožné, a benchmarky běžely v RAM, aby se odstranila latence disku. Oproti standardním balíčkům Archu byly sestavení CachyOS o 20,2 % rychlejší při kódování flac s -8, o 20,8 % rychlejší při kódování vorbis a o 9,5 % rychlejší na gzip -3. V témže běhu byla o 7,1 % pomalejší při dekompresi bzip2, o 1,6 % až 2,9 % pomalejší při kompresi lz4, o 3 % pomalejší na pybench a beze změny na benchmarku R. Dvě výhrady pocházejí od samotného autora: CachyOS sestavoval s -march=x86-64-v3 -mpclmul -O3 oproti -march=x86-64 -O2Archu a jeho následné testy naznačovaly, že -O3 a ne úroveň instrukční sady stálo za částí větších zisků. Příspěvek vznikl před repozitářem Zen 4 CachyOS, který přišel s vydáním z července 2024, ale ne před jeho prací s BOLT: autor čte balíček Pythonu CachyOS stojící za regresí pybench tak, že už nesl BOLT navrch x86-64-v3.
Benchmarky CachyOS na novějším hardwaru opakují stejný vzorec. Srovnání z července 2024 na mvermeulen.org spustilo podmnožinu Phoronix Test Suite na Ryzenu 7940HS Zen 4, CachyOS s repozitářem Zen 4 proti Ubuntu 22.04. Většina výsledků skončila v rozmezí několika procent na obě strany: coremark o 6,4 % pomalejší, dílčí testy OpenSSL od zhruba 1 % pomalejší po 4 % rychlejší, doba sestavení jádra o 1,9 % rychlejší, phpbench jako odlehlá hodnota s lehce více než dvojnásobným skóre. Autor upozorňuje na nesoulad verzí GCC, 14.1 oproti 11.4 v Ubuntu, jako pravděpodobný matoucí faktor. Jeho samostatný běh NAMD z března 2024 našel zlepšení o 6,5 % a 5,8 % u dvou zátěží molekulární dynamiky.
Institucionální testování našlo tentýž smíšený obraz na obou koncích. Vlastní benchmarking x86-64-v3 od Canonicalu, publikovaný v březnu 2024 s experimentálním obrazem Ubuntu 23.10 na Azure, hlásil reprodukovatelné zisky až 60 % v benchmarku glibc Log2, zatímco jiné benchmarky výrazně regredovaly, v jednom případě proto, že zapnutí v3 na už optimalizovaném SSE kódu přimělo kompilátor rozvinout ho do 17krát více instrukcí. Přestavba CentOS Stream 9 skupinou CentOS ISA SIG z v2 na v3, na strojích Intel třídy Ice Lake v srpnu 2023, označila výsledky za „dosti smíšené“, se zrychlením 2,2x soustředěným v Mocassinu a md5crypt z John the Ripper, oba silně vektorizovatelné, i když zisk Mocassinu tým připsal hlavně autovektorizaci GCC 12, a ne úrovni ISA.
Mnoho výkonově kritických matematických a kryptografických knihoven dodává několik verzí horkých funkcí a jednu vybírá za běhu podle detekce vlastností CPU, což je technika zvaná multiverzování funkcí, implementovaná v glibc přes resolvery IFUNC. To znamená, že některé horké cesty už mohou používat AVX2 na standardní instalaci Archu bez přestavby celého balíčku. Příspěvek sunnyflunk to viděl přímo, když si všiml, že zdrojový kód flac už obsahuje AVX2 funkce pro běh, které nepotřebují -march , aby se zapnuly. Zjištění CentOS je zrcadlový obraz: tým objevil matematické funkce glibc bez verzí IFUNC, což je přesně místo, kde má statická přestavba prostor pomoci. To, na co přestavba v3 dosáhne, je zbývající kód, který autovektorizátor kompilátoru dokáže vylepšit sám, a to je výsek desktopu, a malý.
O tom, zda se změna na úrovni stroje vůbec projeví, rozhoduje tvar zátěže, ne nálepka na procesoru. Verdikt ohledně propustnosti zní ano, ale s hranicemi: jednociferné změny jsou ve výše uvedených měřeních běžné, větší zisky se shlukují kolem vektorizovatelných zátěží jako kódování a komprese a některé balíčky regredují. To je lepší popis než brát x86-64-v3 jako celosystémový násobič rychlosti.
Co mění plánovač a proč to průměrným FPS uniká
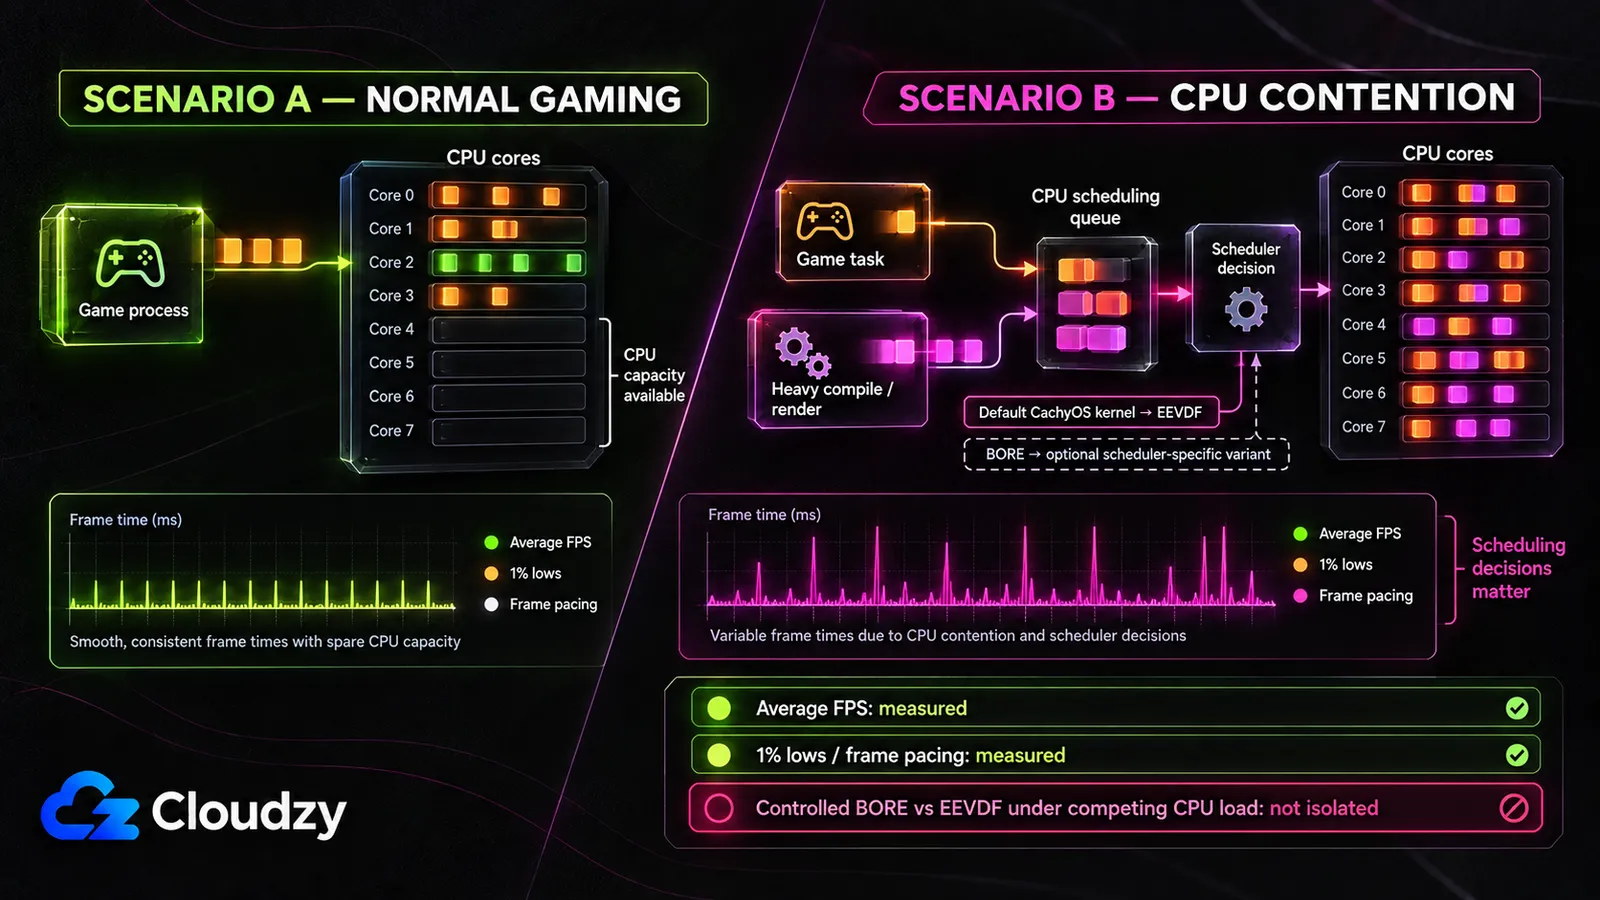
Aktuální výchozí jádro CachyOS, linux-cachyos , používá EEVDF, zatímco BORE je k dispozici ve variantách pro konkrétní plánovač, jako je linux-cachyos-bore. Ten rozdíl je důležitý, protože herní srovnání níže jsou testy na úrovni distribuce, ne řízené testy BORE proti EEVDF. BORE zůstává relevantní pro širší tvrzení o výkonu, protože jeho návrh výslovně míří na odezvu při smíšených zátěžích, ale to tvrzení se musí hodnotit odděleně od herního výkonu CachyOS „z krabice“.
README samotného BORE vyjadřuje záměr jasně:
Aby toho dosáhl, zavádí BORE pro každou jednotlivou úlohu rozměr flexibility zvaný „burstiness“ a částečně se odklání od principu „úplné spravedlnosti“ vlastního CFS.
firelzrd/bore-scheduler, README projektu
Burstiness je čas CPU, který úloha nasbírala od chvíle, kdy naposledy odevzdala CPU uspáním, čekáním na I/O nebo uvolněním. BORE ho převádí na skóre a používá ho k úpravě váhy každé úlohy a agresivity její preempce při probuzení, takže úlohy, které se stále vzdávají CPU, jsou brány jako interaktivní a upřednostněny před úlohami, které svůj příděl vyčerpávají. README pojmenovává kompromis samo: BORE se usadí v „rovnováze mezi protichůdnými hltavými a slabými úlohami (obvykle dávkovými úlohami vázanými na CPU) a skromnými a silnými úlohami (obvykle interaktivními úlohami vázanými na I/O)“. Zvýšit váhu interaktivní práce je táž operace jako snížit váhu dávkové práce na propustnost.
To vám říká, který nástroj by konkrétní tvrzení BORE odhalil: zavést souběžnou zátěž CPU a měřit percentily časů snímků nebo vstupní latenci, přičemž se mění jen plánovač. Plánovač má mnohem méně co rozhodovat, když hra běží s nevyužitou kapacitou CPU.
Benchmark pěti her zveřejněný 16. května 2026 použil čisté instalace CachyOS a Omarchy na stejném SSD a hardwaru, RTX 5060 Ti a Ryzen 9, se stejným sestavením Proton-GE a nastavením 1440p. Průměrné FPS se lišily jen o jeden nebo dva snímky. O dva dny později tentýž tester zveřejnil druhé srovnání s úplným logováním snímků přes MangoHUD, které přidalo 5% minima, 1% minima a rozptyl rozestupů snímků. Tento druhý test použil jiný hardware, Intel i7-13700 a Radeon RX 9060 XT, takže je to další důkaz o konzistenci snímků, ne rozšíření prvního testu na stejném hardwaru. Ani jedno srovnání neizoluje plánovač CPU ani nepřidává záměrnou souběžnou zátěž CPU.
Ani projekt sám to nepřeceňuje. Ve vlákně na r/cachyos o herním výkonu, Peter Jung, jeden ze zakládajících vývojářů CachyOS, odpověděl uživateli přímo: „In gaming not all too much. The newer feature can make a difference tough :)“ (ve hrách ne zas tak moc, novější funkce ale rozdíl udělat může).
Zbývají dva samostatné závěry. Pro hraní na CachyOS „z krabice“ ukazují publikované testy malý rozdíl v průměrných FPS a nyní zahrnují i měření 1% minim a rozestupů snímků. Pro BORE konkrétně při záměrném souběhu o CPU jsem nenašel řízený publikovaný test, který mění jen plánovač a měří odezvu při takové zátěži.
Proč přechod působí rychleji, i když nic rychleji neměří
Dva mechanismy dávají po změně distribuce svižnější stroj, aniž by se na tom podílela kterákoli z optimalizací CachyOS: samotná čistá instalace a náhodná oprava nesouvisejícího problému, který měl předchozí systém. Oba jsou dost konkrétní na to, aby se daly ve vlastním případě rozpoznat, což je odlišuje od paušálního obvinění z placeba.
Začněme čistou instalací. Ve vlákně na r/linuxquestions k této otázceuživatel CachyOS, který podle svých slov sám žádný rozdíl nezaznamenal, nadhodil, že lidé hlásící velké zisky možná srovnávají s opotřebovanou instalací místo s čistou. Roky nahromaděných položek automatického spouštění, osiřelé služby, rozjetá konfigurace a plný disk jsou zátěž a čistý oddíl to všechno odstraní najednou. Změna distribuce posune naráz jádro, desktopové prostředí, každou verzi balíčku a každé výchozí nastavení a úplné srovnání Manjara s Ubuntu se táhne přes tucet samostatných os. Přisoudit zlepšení dodatečně jedné z nich je hádání.
Náhodná oprava je ostřejší případ. V témže vlákně komentující popsal každodenní používání Fedory s problémem správy VRAM, který vážně zhoršoval výkon, přechod na CachyOS a zmizení problému. Poté přešel na holý Arch a hlásil v podstatě stejný výkon jako CachyOS s tím, že už neví, co bylo jinak. Zlepšení bylo skutečné; cíle kompilace CachyOS s tím neměly nic společného.
Nic z toho neopravňuje k čistému vyvrácení a nejsilnějším důkazem proti takovému vyvrácení je řízený test. Srovnání distribucí na Arrow Lake od Phoronixu postavilo Ubuntu 24.10, Fedoru Workstation 41, Arch Linux, Clear Linux a CachyOS na stejný Intel Core Ultra 9 285K ve výchozím stavu a CachyOS všechny těsně předstihl, včetně Clear Linuxu, který na křemíku Intelu obvykle vede. Arrow Lake nemá podporu AVX-512, takže ten náskok nemůže pocházet z x86-64-v4; odráží nějakou kombinaci voleb CachyOS ohledně jádra a sestavení, optimalizací balíčků a výchozí konfigurace.
Zkušenost může být skutečná, zatímco přisouzení zůstává nejisté. Srovnání Phoronixu na Arrow Lake je užitečný protipříklad: instalace CachyOS ve výchozím stavu může předstihnout standardní Arch, i když x86-64-v4 není k dispozici.
Jak zjistit, zda se něco z toho týká vašeho stroje
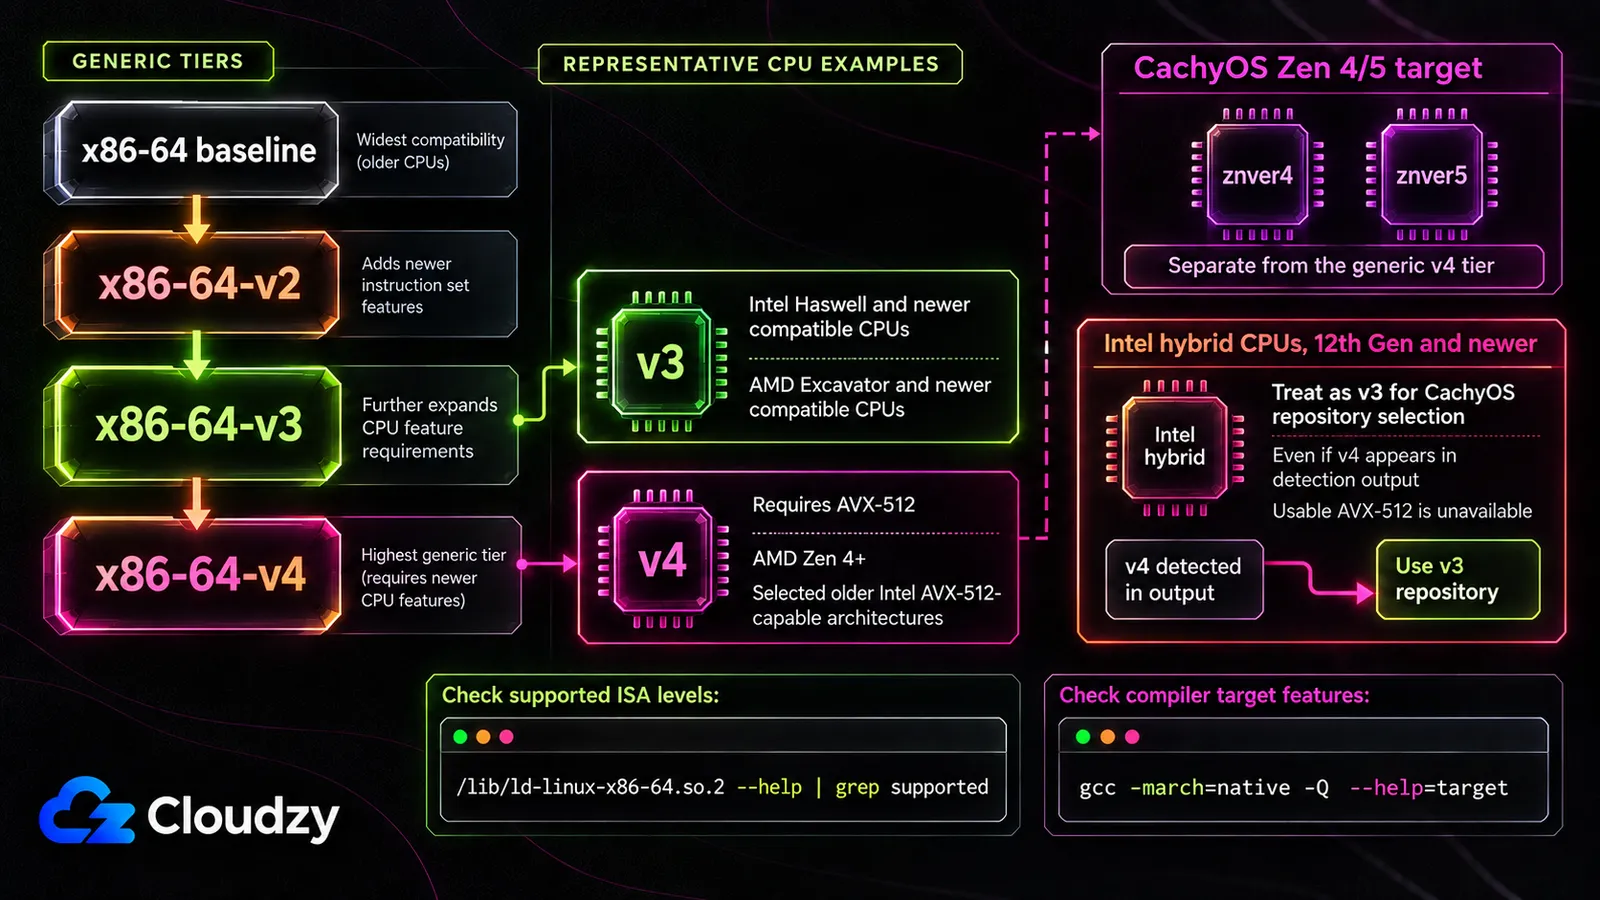
Kterou standardizovanou úroveň mikroarchitektury x86-64 váš procesor podporuje, se dá z větší části zjistit jedním příkazem. Dynamický linker hlásí úrovně glibc-hwcaps, které umí použít, takže nejvyšší podporovaná položka x86-64-vN obvykle říká, zda se CPU kvalifikuje pro obecnou úroveň repozitáře v2, v3 nebo v4. Jednou důležitou výjimkou jsou hybridní procesory Intel 12. generace a novější: CachyOS říká brát je jako v3, i když se ve výstupu objeví v4, protože AVX-512 tam není použitelné. Samostatný cíl CachyOS Zen 4/5 také potřebuje vlastní kontrolu architektury.
/lib/ld-linux-x86-64.so.2 --help | grep supportedPro AMD Zen 4/5 CachyOS také dokumentuje:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"První příkaz vypíše něco takového:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
To je procesor s v3 a v2, ale bez AVX-512. Tři výsledky, tři rozhodnutí:
- Nic nad x86-64-v2. Výhoda přestaveb pro v3/v4/Zen se na tento procesor nevztahuje. CachyOS může přesto běžet a optimalizace kompilátoru pro konkrétní balíčky spolu se změnami jádra a výchozí konfigurace mohou stále hrát roli.
- x86-64-v3 podporováno, x86-64-v4 nedostupné. Pro praktický výběr repozitáře to zahrnuje moderní hybridní procesory Intel, jako je Arrow Lake. Ve výše citovaných srovnáních byla mnohá změna malá, některé zátěže kódování a komprese získaly mnohem víc a některé balíčky regredovaly.
- x86-64-v4 podporováno. AVX-512 vytváří větší teoretický prostor pro vektorizovatelné zátěže, ale nezaručuje velký celosystémový zisk.
Pokud se váš procesor kvalifikuje a chcete jen balíčkovou polovinu, nemusíte kvůli tomu přeinstalovávat. Repozitáře CachyOS lze přidat do existujícího systému Arch a ALHP publikuje přestavby oficiálních repozitářů Archu na každé úrovni x86-64-vN, zdokumentované na Arch Wiki s vlastními výhradami: místo přímo linkovaných modulů jádra jsou vyžadovány balíčky DKMS a nastavení -march pro kompilaci jádra „by nepřineslo žádné významné výsledky“. Obě cesty vám dají překompilované balíčky a nic ze sady záplat jádra ani z variant plánovače.
Nejdřív spusťte ten příkaz. Promění hádku o distribucích ve fakt o vašem vlastním stroji, a to je jediná verze této otázky, kterou dnes večer dokážete rozhodnout sami.

Stavte na Linux VPS s root přístupem, NVMe a výkonem AMD EPYC.
Zobrazit Linux plányČasté dotazy
Zlepšuje CachyOS opravdu herní výkon?
V průměrné snímkové frekvenci sotva. Srovnání pěti her z května 2026 našlo jen rozdíl jednoho až dvou snímků a navazující test o dva dny později změřil i 1% minima a rozestupy snímků. Ani jeden test nezavedl záměrnou souběžnou zátěž CPU, takže nevyřešenou otázkou je odezva plánovače při souběhu, ne to, zda se rozestupy snímků vůbec měřily.
Podporuje můj procesor x86-64-v3 nebo v4?
Na CachyOS nebo Archu spusťte /lib/ld-linux-x86-64.so.2 --help | grep supported , abyste viděli standardizované úrovně glibc-hwcaps detekované pro váš procesor. x86-64-v3 vyžaduje sadu funkcí éry AVX/AVX2, zatímco v4 přidává AVX-512. U hybridních procesorů Intel 12. generace a novějších CachyOS doporučuje brát systém jako v3, i když se ve výstupu objeví v4; uživatelé Zen 4/5 by měli zkontrolovat i samostatný cíl znver4/znver5.
Proč překompilované balíčky nedělají větší rozdíl?
Protože část silně optimalizovaného kódu už je za běhu směrována na implementace specifické pro CPU. Matematické a kryptografické knihovny často používají multiverzování funkcí nebo IFUNC pro horké funkce, takže překompilace balíčků pomáhá hlavně kódu, který kompilátor může ještě globálně dál optimalizovat nebo vektorizovat.
Můžu získat optimalizované balíčky CachyOS bez změny distribuce?
Ano. Repozitáře CachyOS lze přidat do existující instalace Arch Linuxu a projekt ALHP publikuje přestavby oficiálních repozitářů Archu pro x86-64-v2, v3 a v4, zdokumentované na Arch Wiki. Obojí vám dá jen překompilované balíčky, ne sadu záplat jádra CachyOS, alternativní plánovače ani výchozí nastavení instalátoru.
Diskuse
Komentáře
Přihlaste se a zapojte se do diskuse.