

PRTG cobra por sensor, es decir, una métrica monitorizada en un dispositivo, no el dispositivo en sí. Los propios niveles de Paessler fijan la proporción práctica en unos diez a uno: 500 sensores cubren unos 50 dispositivos, 10 000 cubren unos 1000. Añade una pila de switches y empieza a vigilar el caudal por puerto, y el contador crece más rápido que el parque. SolarWinds cuenta de otra forma y llega al mismo sitio.
Para una red mayoritariamente Windows, yo preseleccionaría dos alternativas autoalojadas a PRTG y SolarWinds: Zabbix, o una pila basada en Prometheus si tu equipo ya opera una. La elección entre ambas depende de lo que cada una puede ver en un host Windows y de lo que necesita para verlo.
Una salvedad antes de nada. Si nadie en el equipo tiene horas libres, PRTG y SolarWinds siguen siendo la respuesta correcta. Su facilidad de uso es un producto que compras a propósito, y vale dinero. El cambio que se describe aquí gasta horas en lugar de licencias, y eso es un intercambio, no una mejora.
TL;DR
- La opción por defecto es Zabbix. Zabbix reúne el sondeo SNMP, los agentes Windows, las plantillas y las alertas en una sola plataforma de monitorización. Sigues operando el servidor Zabbix, la base de datos y el frontend web, pero no ensamblas componentes de monitorización separados solo para empezar.
- La excepción es un equipo que ya ejecuta Grafana y Prometheus para métricas de aplicaciones y hosts. Ampliar lo que ya mantienes sale más barato que levantar un segundo sistema de monitorización.
- Prometheus no sondea dispositivos de red por sí solo.
snmp_exportercubre ese hueco; su configuración por defecto cubre muchos switches y routers comunes, mientras que los objetos específicos de fabricante o el sondeo personalizado pueden requerir el generador y trabajo adicional con MIB. - La recopilación sin agente solo ve lo que un host o dispositivo decide publicar. En Zabbix, los registros de eventos de Windows, el estado de los servicios y los contadores de rendimiento detallados son claves de elemento del agente.
- Dimensiona el servidor por métricas, no por dispositivos. Zabbix cuenta una métrica como un elemento más un disparador más un gráfico, y sitúa unas 1000 métricas en 2 núcleos de CPU y 8 GiB de memoria, y unas 10 000 en 4 núcleos y 16 GiB.
Qué cobran PRTG y SolarWinds
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
SolarWinds cuenta una unidad distinta, y la regla es fácil de pasar por alto hasta que llega el presupuesto de renovación. El modelo de licencia de NPM de SolarWinds afirma que NPM «se licencia según el mayor número de los siguientes tipos de elementos de red monitorizados: nodos, interfaces, volúmenes». No la suma. El mayor de los tres. Una red con 80 nodos y 900 puertos de switch monitorizados se licencia por los 900, no por los 80, y los niveles van de SL100 a SLX. Un solo motor de sondeo tiene un tope de 12 000 elementos (la suma de nodos, interfaces y volúmenes, no el mayor de ellos) sea cual sea el nivel, y a partir de ahí añades otro motor de sondeo con licencia.
El efecto práctico de ambos modelos es el mismo. El nivel de licencia decide qué se monitoriza. La red no. Interfaces que te gustaría vigilar se quedan sin vigilar porque vigilarlas cruza un límite, y ese coste nunca aparece en la factura.
Las dos vías autoalojadas que merecen la pena
Zabbix es una única plataforma de monitorización construida alrededor de un servidor central, una base de datos y un frontend web. El servidor sondea dispositivos SNMP, recibe datos de los agentes Windows y aplica plantillas, disparadores y alertas dentro del mismo producto. Comparado con ensamblar una pila de monitorización de red basada en Prometheus, hay menos componentes separados que integrar por tu cuenta. Lo instalas, lo apuntas a los hosts y adjuntas plantillas, que son paquetes reutilizables de elementos, disparadores y gráficos que cubren una clase de dispositivo.
Empieza por la licencia. La página de licencia de Zabbix afirma que toda versión a partir de la 7.0 se publica bajo la GNU Affero General Public License versión 3, y que todo lo anterior hasta la 6.4 era GPLv2. No hay ninguna cuota de licencia por el software a ninguna escala. Zabbix vende el soporte técnico como una suscripción opcional aparte, y pide a los usuarios comerciales que compren algún nivel, pero nada del producto está bloqueado tras esa compra.
La segunda vía es Grafana, Prometheus y VictoriaMetrics. Es la elección correcta en exactamente una situación: ya ejecutas esta pila para métricas de aplicaciones y hosts, y alguien ya la mantiene. Si ese es tu caso, el montaje completo en un solo VPS es un problema resuelto y estás ampliando algo conocido. Nadie tiene que aprender un modelo de datos nuevo.

El punto débil de esa vía son los dispositivos de red. Prometheus recopila endpoints HTTP; no habla SNMP directamente. El equipamiento de red suele gestionarse mediante snmp_exporter, que sondea el dispositivo y expone los resultados para que Prometheus los recopile. Su configuración por defecto incluye módulos como if_mib, así que la monitorización estándar de interfaces en muchos switches y routers no exige generar una configuración personalizada. El generador se convierte en trabajo extra cuando necesitas objetos específicos de fabricante, recorridos personalizados o MIB que no vienen incluidas por defecto. La vía Prometheus tiene por tanto más piezas que mantener que Zabbix, pero el generador no es obligatorio para cada dispositivo.
LibreNMS es el tercer nombre en este espacio, construido alrededor del descubrimiento automático: recorre una red mediante SNMP, CDP, LLDP, OSPF, BGP y ARP para encontrar lo que hay. Es una opción razonable cuando el descubrimiento es la prioridad. No cambia la cuestión de la recopilación en Windows, que es donde se decide esta elección.
Cómo ve cada vía un host Windows
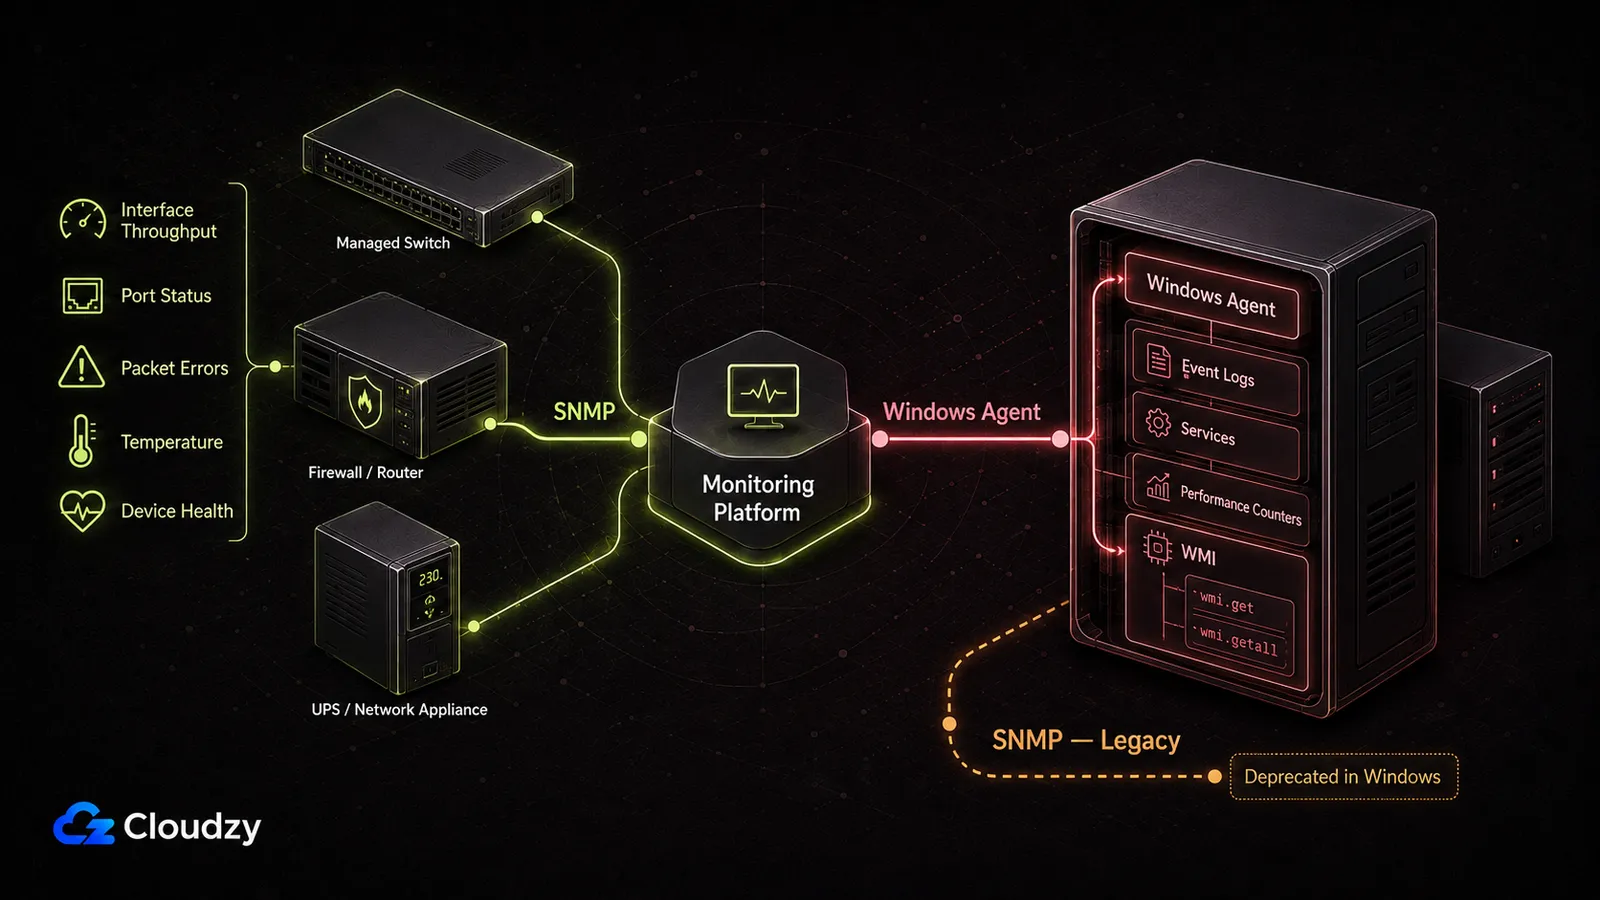
La monitorización de Windows puede implicar SNMP, WMI remoto o un agente instalado. Qué vía aplica depende del producto de monitorización y de la métrica que se recopila. En Zabbix en concreto, las comprobaciones WMI integradas pasan por el agente Windows.
SNMP
Un sondeo SNMP pide a un dispositivo el valor actual de un objeto numerado, direccionado por un OID, que es una posición en la MIB del dispositivo. Lo que vuelve es lo que el dispositivo publica y nada más. En un switch gestionado, un cortafuegos o un SAI, eso suele bastar: contadores de interfaz, estado de puertos, tasas de error, temperatura, salud del chasis.
En Windows el panorama es más pobre. El aviso de obsolescencia de Microsoft para SNMP y el proveedor WMI SNMP confirma que ambas funciones están obsoletas, así que yo trataría el SNMP de Windows como una vía de compatibilidad heredada y no como la opción por defecto para un despliegue nuevo. Zabbix sigue ofreciendo una plantilla Windows by SNMP, pero el agente nativo te da bastante más visibilidad del sistema operativo.
WMI
WMI puede consultarse de forma remota sin instalar un agente de monitorización en el destino, y por eso productos como PRTG pueden usarlo como método de recopilación Windows sin agente. Zabbix funciona de otra manera. Sus comprobaciones WMI integradas, wmi.get y wmi.getall, son claves de elemento del agente Windows, así que es el agente Zabbix o el agente 2 quien ejecuta esas consultas en la máquina monitorizada.
El WMI remoto también trae sus propios requisitos de red cuando un producto de monitorización lo usa directamente. En los sistemas Windows actuales, RPC arranca en el puerto TCP 135 y normalmente negocia las conexiones a través del rango dinámico de puertos TCP altos, típicamente del 49152 al 65535. El cortafuegos y los permisos WMI del destino deben permitir la conexión.
Para esta comparación, la distinción importa más que el protocolo en sí: PRTG puede usar WMI remoto sin un agente de monitorización instalado, mientras que Zabbix obtiene su visibilidad WMI específica de Windows a través de su agente.
El agente nativo
El agente es donde vive la profundidad específica de Windows. La documentación de Zabbix enumera las claves específicas de Windows: eventlog para monitorizar el registro de eventos de Windows, perf_counter para cualquier contador de rendimiento de Windows, service.discovery y service.info para el estado de los servicios. Todas son claves de elemento del agente.
El coste es el despliegue. Un agente en cada Windows Server y cada estación de trabajo que te importe es un paquete que distribuir, una versión que mantener al día y una regla de cortafuegos que mantener. Es un compromiso operativo permanente, y es el contrapeso del ahorro en licencias.
La recopilación sin agente está limitada a lo que el host o el dispositivo decide publicar, y en Zabbix los registros de eventos y los contadores de rendimiento detallados están detrás de claves de elemento del agente.
Cara a cara
La comparación gira en torno a cuatro cosas: si la herramienta sondea dispositivos de red por SNMP, si tiene un agente Windows, hasta dónde puede ver dentro de un host Windows y cuánto ensamblaje hay entre tú y un sistema funcional. La licencia figura al lado porque es el motivo por el que empezó la evaluación.
| Herramienta | Sondeo SNMP de dispositivos | Monitorización de Windows | Esfuerzo de configuración | Licencia |
|---|---|---|---|---|
| Zabbix | Incluido | Agente: registros de eventos, estado de servicios, contadores de rendimiento y WMI; estado básico por SNMP | Moderado: un servidor, luego plantillas | AGPLv3, sin cuota de licencia; soporte vendido aparte |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | No integrado; necesita snmp_exporter como componente aparte | Sin agente Windows nativo; las métricas de host vienen de exportadores separados; los registros de eventos no son nativos | Alto: varios componentes; el SNMP personalizado puede requerir trabajo con el generador | Componentes de código abierto, sin cuota de licencia |
| Monitores de disponibilidad y estado | Ninguna | Solo alcanzabilidad de servicios y tiempo de respuesta | Bajo: minutos | Varía según la herramienta |
Si el requisito es «avísame en menos de un minuto cuando un servicio deje de responder», un monitor de disponibilidad es la herramienta del tamaño correcto y las otras dos están sobredimensionadas para eso. Lo que no hará es sondear un switch para obtener el caudal de una interfaz ni leer un contador de rendimiento de Windows, así que no sustituye a PRTG ni a SolarWinds. Es un trabajo distinto que a veces se confunde con el mismo.

Cuál ejecutar
Ejecuta Zabbix. Para una red mayoritariamente Windows sin inversión previa en Prometheus, es con diferencia el camino más corto. Sigues teniendo un servidor, una base de datos y un frontend web que operar, pero el modelo de monitorización, las plantillas y las alertas viven en un solo producto en lugar de ensamblarse a partir de varios componentes de monitorización.
Para un despliegue de monitorización de larga duración, usa la rama LTS actual de Zabbix en lugar de una versión estándar de corta vida. El ciclo de vida LTS de Zabbix da a cada versión tres años de soporte completo seguidos de dos años de soporte limitado, lo que aquí importa más que perseguir la última versión con novedades.
La excepción es estrecha y concreta. Si tu equipo ya ejecuta Grafana y Prometheus en producción para métricas de aplicaciones y hosts, y alguien ya es dueño de esa pila, entonces snmp_exporter es un añadido a algo mantenido en lugar de un segundo sistema que mantener. Esa condición es conjunta: las dos mitades tienen que cumplirse. Una instancia de Grafana abandonada que alguien montó el año pasado no cuenta.
Y si nadie tiene las horas, renueva. No es una evasiva. Es una situación distinta con una respuesta correcta distinta. El cambio convierte una factura de licencias en una factura operativa: despliegues de agentes, trabajo con plantillas, actualizaciones y alguien que entienda el sistema lo bastante bien como para arreglarlo a las 2 de la madrugada. Un equipo ya al límite hará ese trabajo mal o no lo hará, y una monitorización sin mantener es peor que una monitorización cara, porque falla en silencio.
El híbrido es real: mantén la herramienta actual en un núcleo cada vez menor de sistemas críticos, mueve todo lo demás a Zabbix y deja que el nivel de licencia baje con el tiempo. Funciona. También implica operar dos sistemas de monitorización y conciliar sus alertas, así que trátalo como un estado de transición con fecha de fin.
Qué no sobrevive a la migración
La propia guía de migración de Zabbix tiene una sección titulada «Qué NO se migra», y la lista es más larga de lo que la palabra «migración» sugiere. Los datos históricos y las lecturas de sensores no pasan. Las notificaciones y dependencias personalizadas de PRTG tampoco. Los mapas y paneles tampoco, porque los dos productos los modelan de forma tan distinta que reconstruir gana a traducir. Los propios sensores tampoco, ya que Zabbix trabaja con un concepto completamente distinto.
Los nombres de dispositivos, las direcciones IP y los tipos de interfaz sí pueden trasladarse. Incluso eso pasa por scripts personalizados de exportación e importación contra ambas API. La guía dice sin rodeos que no existe ninguna herramienta oficial para migrar directamente entre las dos plataformas.
Un equipo documentó lo que eso cuesta en la práctica: unas 500 máquinas virtuales y servidores físicos, unos siete años en PRTG, reconstruidos desde cero a lo largo de seis meses de proyecto de baja prioridad. Sus 2500 sensores de PRTG se convirtieron en 43 000 elementos de Zabbix, una ilustración clara de lo distinto que cuentan los dos sistemas.
«Empieza de cero. No existe la opción de «pulsa este botón y migra» de PRTG a Zabbix, y aunque existiera, algo así es una buena oportunidad para no repetir los errores de diseño anteriores».
Es la experiencia de una organización, no una referencia. Un parque más pequeño no producirá esas cifras. Lo que sí se traslada es la premisa de planificación: presupuesta tiempo de reconstrucción, no tiempo de migración.
Ordena la reconstrucción según aquello sin lo que no puedes estar. Si tu preocupación es la continuidad de las alertas, reconstruye primero las reglas de notificación y deja que los paneles vayan detrás. Si es el historial de informes, exporta lo que necesites antes de que caduque la licencia antigua. No se irá contigo.
Dimensionar el servidor
Los requisitos de hardware de Zabbix sitúan una instalación pequeña de unas 1000 métricas monitorizadas en 2 núcleos de CPU y 8 GiB de memoria, y una instalación mediana de unas 10 000 métricas en 4 núcleos y 16 GiB. Esas son las cifras con las que hacer la solicitud.
La unidad es donde el dimensionamiento se equivoca. Zabbix define una métrica monitorizada como un elemento más un disparador más un gráfico. Una métrica no es un dispositivo y no es un host. Un solo Windows Server aporta tantas métricas como elementos configures: CPU, memoria, cada sistema de archivos, cada servicio, cada contador que muestrees. El número de dispositivos es una mala guía para la máquina que necesitas. Un parque que suena pequeño puede caer en la franja mediana sin que nadie haga nada raro.
Dos cosas hacen subir la cifra más rápido que el número de hosts. La frecuencia de sondeo es la primera: reducir a la mitad un intervalo de actualización duplica la tasa de escritura de cada elemento en ese intervalo. La retención del historial es la segunda, ya que la base de datos crece con el tiempo que conservas los valores brutos. El número de dispositivos importa sobre todo por el número de elementos monitorizados que aporta cada dispositivo.
Si tu parque se queda cerca del ejemplo de 1000 métricas con intervalos de actualización normales y retención modesta, la franja pequeña es un punto de partida razonable. Si muestreas contadores de rendimiento cada treinta segundos y guardas un año de historial bruto, no lo es. Zabbix es explícito en que sus cifras publicadas son «ejemplos de tamaño y configuración de hardware para empezar», y recomienda hacer pruebas de rendimiento en un entorno de preproducción antes de comprometer hardware de producción. Es la advertencia del propio fabricante. Tómala al pie de la letra.
Zabbix solo admite su componente servidor en Linux y UNIX; en Windows solo se admite el agente.
Las métricas no son dispositivos, y el multiplicador entre ambos es lo que determina el tamaño de la máquina.

Construye sobre un VPS Linux con acceso root, NVMe y la potencia de AMD EPYC.
Ver planes LinuxDónde colocar el servidor de monitorización
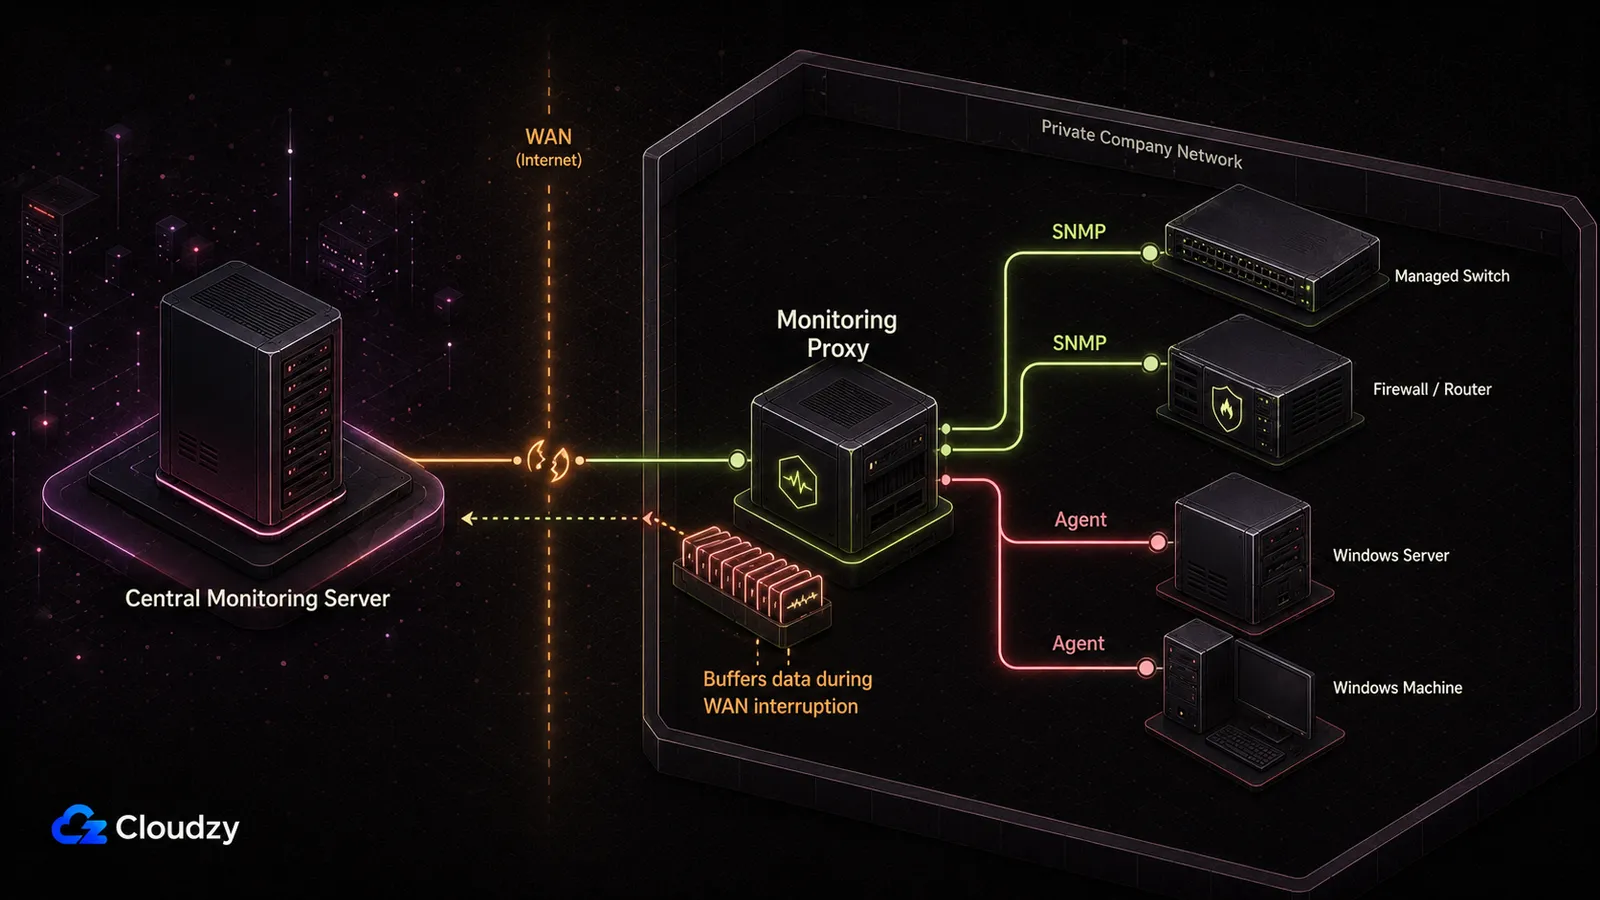
Si necesitas que la monitorización sobreviva a una caída de toda la sede, mantén el servidor Zabbix central fuera del dominio de fallo de esa sede. Perder el enlace de subida de la sede puede entonces dejar la red monitorizada fuera de línea sin tumbar también el servidor de monitorización.
Para una red privada, un proxy Zabbix puede situarse dentro de la sede y recopilar de los sistemas que lo rodean. El proxy puede gestionar localmente las comprobaciones SNMP y de agente, enviar los datos recopilados al servidor central y almacenar en búfer los datos de monitorización mientras la conectividad entre ambos no esté disponible. Eso permite que el servidor central se quede fuera de la sede sin exigir que cada switch, cortafuegos y host Windows privado sea accesible directamente desde Internet.
Un VPS es un lugar práctico para ejecutar ese servidor central. Cloudzy ofrece Servidor Zabbix como despliegue en un clic sobre Ubuntu Server 24.04 LTS si quieres saltarte la instalación inicial y pasar directamente a configurar hosts y plantillas.
Preguntas frecuentes
¿Zabbix es realmente gratuito?
Sí. Zabbix se publica bajo la GNU Affero General Public License versión 3 a partir de la versión 7.0, y no hay ninguna cuota de licencia por el software, monitorices los dispositivos o métricas que monitorices. Zabbix vende el soporte técnico como una suscripción opcional aparte, pero ninguna función del producto está bloqueada tras ella. El coste de ejecutar Zabbix es el servidor en el que corre y las horas que dedicas a operarlo.
¿Necesito instalar un agente en cada Windows Server?
No en cada máquina Windows, pero si quieres la profundidad de monitorización Windows nativa de Zabbix, planea instalar el agente en los servidores que más te importan. SNMP puede aportar datos básicos sin agente, aunque la función SNMP de Windows está obsoleta según Microsoft. Las comprobaciones WMI integradas de Zabbix también pasan por su agente Windows, así que WMI no es una vía directa de recopilación sin agente en Zabbix. Usa el agente para registros de eventos, descubrimiento de servicios, consultas WMI y contadores de rendimiento detallados; reserva el SNMP sin agente sobre todo para el hardware de red y los casos Windows heredados.
¿Puedo ejecutar el servidor de monitorización en Windows?
Con Zabbix, no. La documentación de requisitos de Zabbix lista el componente servidor como compatible solo con Linux y otras plataformas UNIX, y afirma que «UNIX es el único sistema operativo capaz de ofrecer de forma consistente el rendimiento, la tolerancia a fallos y la resiliencia necesarios». La compatibilidad con Windows cubre el agente Zabbix y el agente 2, que es lo que instalas en las máquinas monitorizadas. El servidor de monitorización reside en un host Linux; el parque Windows es lo que vigila.
¿Prometheus hace monitorización SNMP?
Por sí solo, no. Prometheus recopila endpoints HTTP y usa snmp_exporter para recopilar de dispositivos SNMP. Su configuración por defecto cubre muchos switches y routers comunes, mientras que los objetos específicos de fabricante o el sondeo personalizado pueden requerir configuración MIB adicional y el generador.



Debate
Comentarios
Inicia sesión para unirte al debate.