

Algo que construiste está en producción. Tu monitorización es o bien nada en absoluto o bien un ping de disponibilidad, y la semana pasada te enteraste de una caída por un usuario. Todas las respuestas que buscas apuntan al mismo nombre.
Este análisis de Prometheus trata sobre la distancia entre dos cosas que son ciertas a la vez. Es gratuito y de código abierto, sin licencia ni factura por métrica a ninguna escala. También te cuesta una tarde más un lenguaje de consulta que aún no conoces. Es un recolector de métricas de tipo pull con alertas incorporadas, y es una pieza de software excelente. Si es la pieza de software adecuada para la instalación que tienes ahora mismo es otra pregunta, y es la que merece respuesta.
La versión corta
- Veredicto: 3,5 / 5 para autoalojamiento en solitario o en equipos pequeños. Prometheus merece la pena si tu conjunto de hosts y servicios es razonablemente estable, vas a dedicar el tiempo necesario a aprender PromQL y quieres métricas que sean tuyas por completo, sin suscripción ni factura por retención.
- Descártalo si la pregunta que necesitas responder es «¿está en pie?». Un comprobador de disponibilidad te lleva ahí mucho más rápido, y recurrir a Prometheus para ese trabajo significa pagar un lenguaje de consulta para responder algo que podrías haber resuelto en diez minutos.
- PromQL es el coste que vuelve una y otra vez. Montarlo es un coste único. En cuanto tus preguntas superan los paneles prefabricados y el constructor visual de Grafana, vuelves a PromQL.
- El coste de mantenimiento sigue a la parte de la instalación que gestionas a mano. Un parque que mantiene su forma es barato de monitorizar. Uno que gana, pierde y renombra hosts es donde el coste se acumula en silencio.
- Este veredicto se limita al autoalojamiento a pequeña escala. A escala de Kubernetes y de SRE en producción, Prometheus es una propuesta distinta, y este análisis no intenta responder a esa pregunta.
Cómo se hizo este análisis: Prometheus es gratuito y de código abierto, así que aquí no hay relación comercial con ningún proveedor y nadie me ha enviado nada. Los datos de versiones y el comportamiento del almacenamiento vienen de la documentación oficial de Prometheus. Las cifras de consumo y los tiempos de instalación vienen de dos pruebas prácticas publicadas de forma independiente, acreditadas en el punto donde se usa cada una. Donde esas dos discrepan, verás ambas cifras en lugar de una media.
Qué cubre este análisis
El veredicto de arriba tiene límites, y esos límites importan más de lo habitual aquí, porque Prometheus se comporta como una herramienta distinta a distintas escalas.
- Prometheus evaluado para autoalojamiento en un solo VPS y en proyectos pequeños: un puñado de hosts y servicios, y una sola persona a cargo.
- No Kubernetes. Prometheus Operator, los ServiceMonitors y el kube-prometheus-stack son un mundo operativo aparte, y el veredicto de aquí no dice nada sobre ese.
- No es una guía de enrutado de Alertmanager. Las alertas existen y funcionan; configurar rutas, silencios y receptores es un tema en sí mismo.
- No es un tutorial de instalación. La pregunta aquí es si conviene ejecutarlo siquiera. Si ya has respondido a esa, nuestra guía de Grafana y Prometheus con Docker Compose cubre los pasos.
- No es un repaso de exporters. Los exporters aparecen solo donde cambian la respuesta.
En qué acierta Prometheus
Prometheus no cuesta nada. Ni «plan gratuito con mejoras de pago», ni «gratis hasta que cruces un límite de métricas». El repositorio tiene licencia Apache 2.0 de principio a fin, no hay edición de pago del proyecto principal y no hay facturación por host, por métrica ni por etiqueta en ninguna parte. La única factura que genera Prometheus es el servidor en el que se ejecuta.
Para algo de lo que piensas depender, «¿seguirá aquí dentro de tres años?» es una pregunta justa, y aquí las probabilidades son tan buenas como el código abierto permite. Prometheus se graduó en la CNCF en agosto de 2018, el segundo proyecto en lograrlo, después de Kubernetes. Las versiones salen con regularidad, con la v3.13.2 publicada a finales de julio de 2026, y como esa rama es una rama de soporte a largo plazo, recibe correcciones de errores, de seguridad y de documentación durante un año, así que mantenerse parcheado no significa perseguir cada versión menor.
El modelo de datos explica por qué el ecosistema a su alrededor es tan profundo. Prometheus recoge métricas por HTTP e identifica cada serie por un nombre de métrica más etiquetas clave/valor, lo que hace que escribir un exporter sea un trabajo pequeño. Así que existen exporters para casi cualquier cosa que puedas estar ejecutando: métricas del sistema, Postgres, Nginx, Redis, sondas blackbox para lo que solo puedes comprobar desde fuera.
Y eres dueño de lo que recoge, que es la parte que suele importar más adelante y no el primer día. El historial de una instalación pequeña ocupa una cantidad de disco irrelevante (los números están más abajo), nadie puede cambiarte el precio el trimestre que viene y no hay una línea de factura que crezca cada vez que alguien añade instrumentación a una aplicación. Si alguna vez has visto subir una factura de monitorización gestionada porque un desarrollador añadió una etiqueta, ahí tienes todo el argumento en una frase.
Dónde Prometheus te cuesta más de lo que parece
Una prueba de dev.to con siete herramientas de monitorización en un VPS pequeño midió 15 minutos de instalación para Prometheus por sí solo. Combínalo con Grafana, como hizo ese probador, porque el navegador de expresiones integrado es solo un sitio donde lanzar consultas. La misma prueba sitúa Grafana + Prometheus en 35 minutos hasta el primer gráfico, con configuración YAML de recolección por medio.
Los minutos son la parte barata. PromQL es la cara. Prometheus lo guarda todo como series temporales identificadas por nombre y etiquetas, y PromQL sigue siendo el lenguaje que hay debajo de las preguntas que le haces. Grafana ya tiene un constructor visual, así que no hace falta escribir cada consulta a mano. El veredicto del propio probador fue tajante: PromQL es maravilloso si vives dentro de él, y no era su caso. Si nunca has usado un lenguaje de consulta, presupuesta más de una tarde para eso, y cuenta con volver a él cada vez que el constructor visual se quede corto. Un panel copiado de otra persona responde a sus preguntas. Las tuyas son una consulta que todavía no has escrito.
El tercer coste es el que no aparece hasta más tarde. El informe de tres semanas de un operador describe exactamente lo que supuso añadir un solo servidor a una instalación de siete nodos: reetiquetar, revisar de nuevo las configuraciones de recolección, editar variables de los paneles y rehacer las consultas de las plantillas para que el nuevo host apareciera en los desplegables. Ese operador abandonó la pila al cabo de tres semanas, tras concluir que dedicaba más tiempo a ajustar paneles que a vigilar su infraestructura.
Fíjate a qué está atado ese coste en este tipo de instalación: objetivos y paneles gestionados a mano. Tener Prometheus funcionando durante dos años tranquilos no te cuesta casi nada más.
¿Cuánta RAM y cuánto disco necesita Prometheus en realidad?
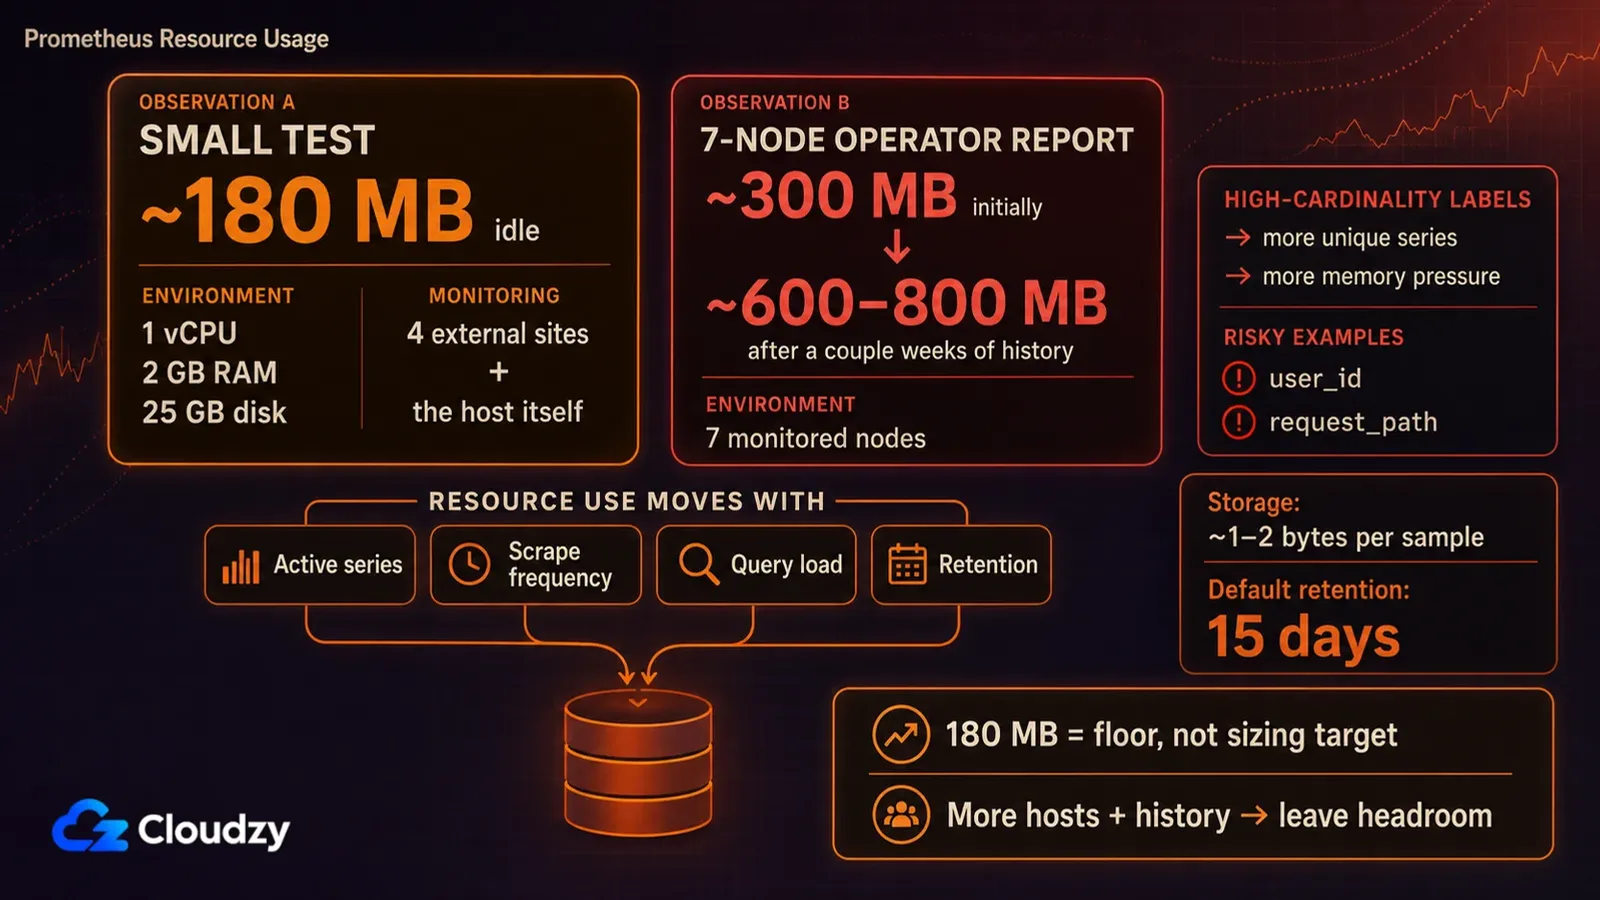
No hay un requisito fijo. Las series activas, la frecuencia de recolección, la carga de consultas y la retención importan más que el número bruto de servidores a los que lo apuntes. Dos pruebas prácticas publicadas sobre instalaciones pequeñas lo sitúan entre unos 180 MB y 800 MB, correspondiendo la cifra más alta a siete nodos con un par de semanas de historial.
Las dos pruebas no coinciden, y esa discrepancia es la parte útil. La misma comparativa de siete herramientas en VPS ejecutó cada una sobre hardware idéntico (1 vCPU, 2 GB de RAM, 25 GB de disco, Ubuntu 24.04) vigilando cuatro sitios externos más el propio host, y midió Prometheus en unos 180 MB en reposo. El mismo operador informó de que Prometheus por sí solo se mantenía en torno a 300 MB en el host central, subiendo hacia 600 u 800 MB una vez acumuladas un par de semanas de historial.
No son la misma medición, y por eso promediarlas tiraría la información a la basura. Una es una lectura casi en reposo en una máquina con muy poco que almacenar. La otra es un despliegue en funcionamiento, con un parque detrás e historial en disco. Mi lectura: trata el resultado de 180 MB como un suelo, no como un objetivo de dimensionamiento. En cuanto recojas de varios hosts y conserves historial, deja margen en lugar de dimensionar sobre esa cifra en reposo.
El disco es la mitad fácil. La documentación de almacenamiento de Prometheus lo sitúa en una media de 1 a 2 bytes por muestra, así que guardar un historial largo en una instalación pequeña sale barato. La trampa está en el valor por defecto: la retención está fijada en 15 días por defecto salvo que definas un tiempo o un tamaño de retención. Está a un solo parámetro de arranque de ser un año, y es el tipo de valor por defecto que prefieres descubrir ahora y no la primera vez que buscas los números del mes pasado y ves que caducaron hace tres semanas.
Lo que dispara la cifra de memoria es la cardinalidad: el número de series temporales distintas, donde cada combinación única de etiquetas de una métrica se convierte en su propia serie. Una sola etiqueta mal elegida en una métrica de mucho tráfico puede crear más series que cinco servidores extra, y lo hace en silencio, al ritmo al que vaya tu tráfico. (Un identificador de usuario o una ruta de petición parecen una etiqueta estupenda justo hasta que cuentas cuántos hay.)
Cualquier cifra de RAM que encuentres citada para Prometheus solo sirve si además sabes cuántas series había detrás.
¿Qué pasa cuando tu servidor de Prometheus se cae?
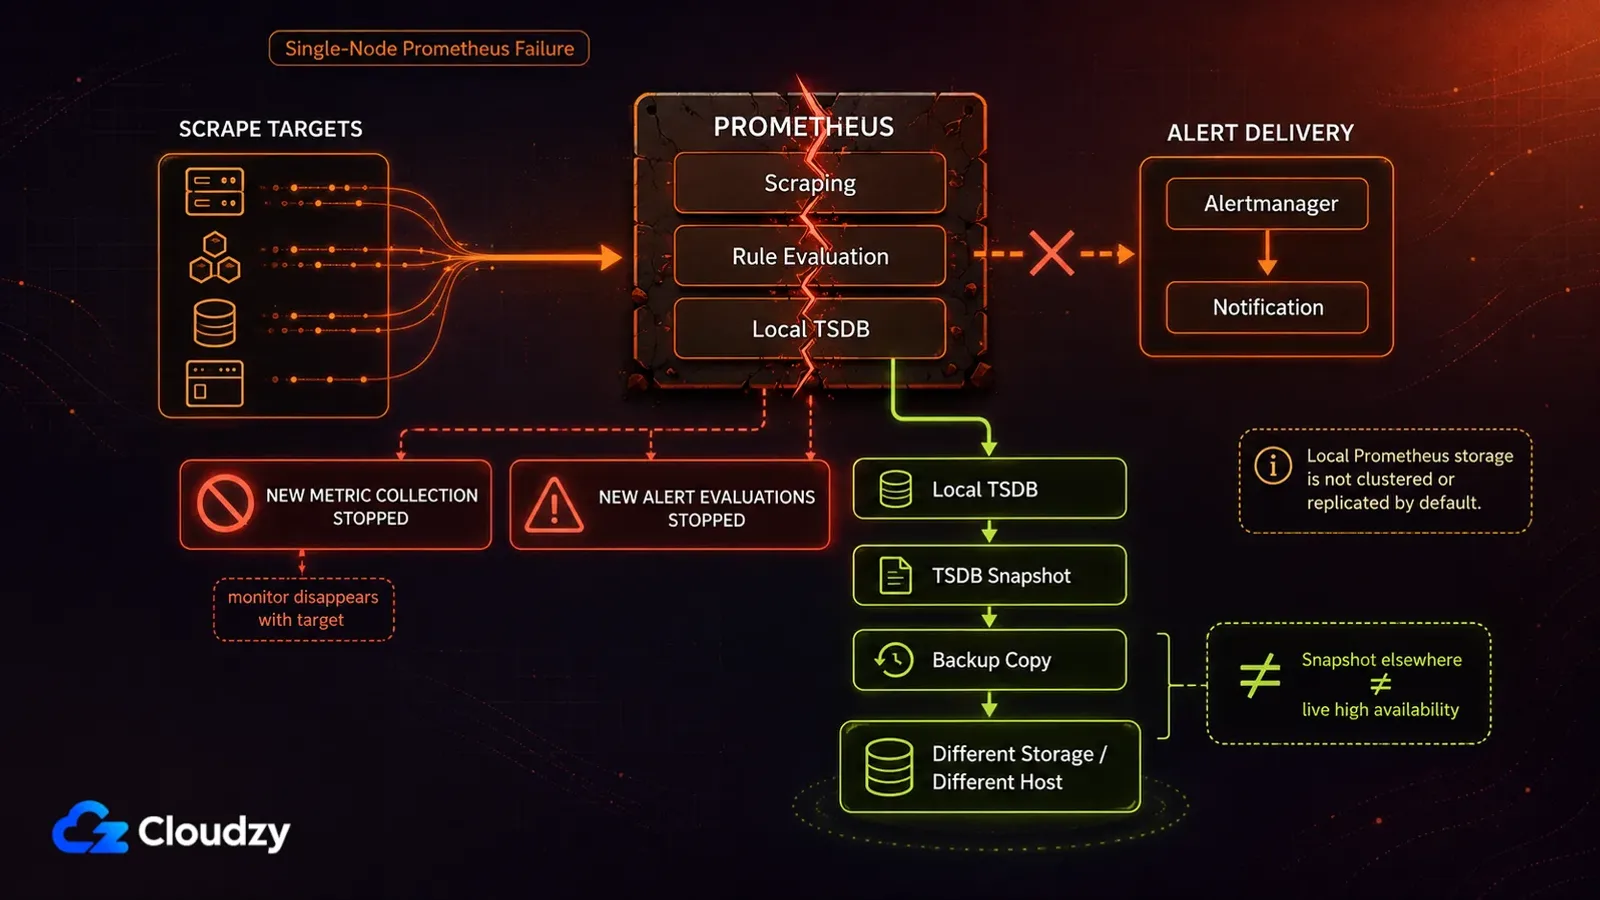
La propia documentación de almacenamiento de Prometheus es directa al respecto: el almacenamiento local no está en clúster ni replicado, así que no es duradero frente a un fallo de disco o de nodo. Cada servidor es autónomo por diseño y no depende de almacenamiento en red ni de servicios remotos, que es justo lo que lo hace fácil de operar y justo lo que lo deja expuesto.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Hay un segundo límite que el proyecto declara sobre sí mismo, y merece reconocimiento por declararlo: si necesitas una exactitud del 100 %, por ejemplo para facturar por petición, la documentación dice que Prometheus es la elección equivocada, porque los datos que recoge probablemente no serán lo bastante detallados ni completos. Usa otra cosa para las cifras que facturas y deja Prometheus para monitorizar. Los proveedores no suelen decir voluntariamente ese tipo de cosas sobre sí mismos.
Hay respuestas asentadas a esto a mayor escala, y quedan fuera del alcance de este texto por la misma razón que el instrumental de Kubernetes: suponen un compromiso operativo distinto del que cubre este análisis. Para un solo VPS, mi lectura es que la exposición es aceptable si guardas instantáneas de la TSDB en otro sitio o asumes de antemano que perderás el historial, y que es un problema real si Prometheus es lo único que hay entre tú y una caída silenciosa.
¿Quién debería autoalojar Prometheus?
La señal más clara de que Prometheus devolverá lo que cuesta no tiene nada que ver con cuántos servidores tienes. Es si dentro de seis meses seguirán siendo los mismos. Un conjunto estable de hosts configurados a mano significa que escribes la configuración una vez y recoges historial gratis; uno que cambia sin parar significa que tocas esa configuración sin parar.
En una instalación estática, tu configuración de Prometheus y Grafana es una descripción explícita de tu infraestructura: objetivos de recolección, las etiquetas asociadas a ellos y los paneles construidos sobre esas etiquetas. Por eso el historial es toda la recompensa. Un año de datos sobre un conjunto estable de hosts te dice qué aspecto tiene lo normal, que es la forma más fiable de reconocer lo anormal antes de que se convierta en una caída.
Así que el primer perfil es alguien con un conjunto pequeño de servidores que cambia despacio y que quiere más que un simple sí o no: latencia de peticiones a lo largo del tiempo, tendencias de memoria, un disco que se llena lo bastante despacio como para verlo venir con semanas de antelación. Si puedes describir tu infraestructura hoy y esperar que esa descripción siga siendo más o menos cierta dentro de un año, la tarde que dedicas a montarlo es la última factura grande.
El segundo es cualquiera que esté aprendiendo esta pila a propósito. Si esperas estar gestionando infraestructura dentro de unos años, la tuya o la de otro, la tarde de PromQL es justo a lo que venías y la monitorización es un efecto secundario. Este perfil invierte en parte el primero: la prueba de estabilidad importa menos aquí, porque el tiempo dedicado a reetiquetar es también tiempo dedicado a aprender qué es reetiquetar. Para este lector subiría la nota.
El tercer perfil va sobre propiedad, y es el que la gente infravalora hasta que le toca estar del lado equivocado. Prometheus no factura por host, ni por métrica, ni por etiqueta, y ninguna página de precios puede cambiarte bajo los pies el trimestre que viene. El intercambio frente a un servicio gestionado como Datadog: renuncias al acabado, al contrato de soporte y a la guardia de otra persona, y a cambio obtienes métricas que son tuyas con una factura que no se mueve cuando un desarrollador añade instrumentación. Si es un buen intercambio depende de cuánto valen tus propias horas, un número que solo puedes poner tú (y rara vez es cero, aunque lo parezca).
Una cosa que conviene saber antes de comprometerte: quedarse corto con el almacenamiento local de Prometheus no es un callejón sin salida. VictoriaMetrics acepta escrituras remotas de Prometheus, y su MetricsQL es retrocompatible con PromQL, así que la mayoría de las consultas y los paneles de Grafana que construyas ahora deberían sobrevivir al cambio. Es una migración, no una reescritura.
Conviene revisarlo una vez al año en lugar de decidirlo una sola vez: la instalación que hoy es barata de monitorizar se encarece el trimestre en que empiezas a reconstruirla.

Construye sobre un VPS Linux con acceso root, NVMe y la potencia de AMD EPYC.
Ver planes Linux¿Quién debería descartar Prometheus?
Si la frase que usarías para describir lo que necesitas es «avísame cuando el sitio se caiga», estás describiendo un comprobador de disponibilidad, y Prometheus es mucha maquinaria para llegar a esa respuesta. Uptime Kuma hace exactamente ese trabajo con una interfaz web y no te pide aprender un lenguaje de consulta de monitorización. La diferencia de capacidades entre las dos herramientas es enorme y completamente irrelevante para el trabajo que quieres encargar.
El segundo lector es quien quiere gráficos utilizables sin aprender antes un lenguaje de consulta. Netdata está construido exactamente para eso: métricas por host que puedes mirar de inmediato, con mucha menos configuración y sin nada entre tú y los gráficos. Si la pregunta que repites es «¿por qué va lenta esta máquina ahora mismo?», ese es un camino mucho más corto hasta una respuesta.
El tercero es cualquiera cuya infraestructura cambia de forma a menudo y que gestiona a mano los objetivos y las variables de los paneles. Hosts creados para una semana y destruidos, objetivos renombrados, proyectos renombrados a mitad de camino. Ese es el caso en el que pagas el coste de configuración una y otra vez mientras sacas el menor beneficio de aquello por lo que pagas, que es el historial continuo de un sistema que sigue siendo reconocible.
Nada de esto es un reproche a la herramienta. «Descartarlo» aquí significa descartarlo para este trabajo, a esta escala. A escala de Kubernetes, donde el descubrimiento de servicios se encarga de casi todo lo que si no cablearías a mano, varios de los costes anteriores se reducen o desaparecen del todo, y mi lectura de esa escala es que a Prometheus le cuesta mucho encontrar rival. Ese es otro análisis.

Preguntas frecuentes
¿Prometheus es gratis?
Sí, y no hay trampa de plan gratuito por debajo. Prometheus tiene licencia Apache 2.0 y no hay una edición comercial detrás, así que no hay cuota de métricas que cruzar ni aviso de mejora esperando al otro lado. Pagas la infraestructura y tu propio tiempo, no una licencia de Prometheus.
¿Prometheus necesita Grafana?
No, pero cuenta con ello. El navegador de expresiones de Prometheus existe para lanzar una consulta y mirar la respuesta, lo que cubre comprobar una cosa una vez. Todo lo que quieras dejar abierto en un segundo monitor es trabajo de Grafana, y los dos casi siempre se ejecutan juntos.
¿Es Prometheus excesivo para un solo servidor?
A menudo, sí. Si lo que necesitas es saber si el servidor y sus servicios están en pie, un comprobador de disponibilidad lo responde en una fracción del tiempo de instalación. Prometheus se gana su sitio cuando quieres métricas históricas que puedas consultar y estás dispuesto a aprender PromQL para llegar a ellas.
¿Cuánto tiempo guarda Prometheus las métricas por defecto?
15 días, y no te avisa antes. Prometheus descarta las muestras más antiguas que la ventana de retención salvo que la amplíes con un parámetro de tiempo o de tamaño de retención al arrancar. Configúralo el mismo día que lo instales, porque ampliar la ventana más tarde no recuperará los datos que ya caducaron.



Debate
Comentarios
Inicia sesión para unirte al debate.