
Si tu scraper de Playwright o Selenium se ralentiza en un VPS o se pasa del plazo, aumentar la RAM podría ayudar, pero un tiempo de espera agotado no basta para saber qué conviene ampliar. Para dimensionar un VPS para web scraping, mide la tarea completa, incluidos los procesos del navegador, la escritura de resultados y los servicios que comparten el servidor. Ajusta después la concurrencia y comprueba si los datos requeridos se guardan a tiempo.
Prueba una configuración de VPS con tu carga de trabajo
Para una tarea de navegador con concurrencia controlada y pocos servicios auxiliares, empezaría por probar 4 GB de RAM y 2 vCPU. Evalúa 8 GB de RAM y 4 vCPU si la configuración menor no permite terminar a tiempo o deja poco margen para otros servicios. Son puntos de partida para las pruebas. No representan requisitos mínimos oficiales de Playwright o Selenium ni garantizan una cantidad determinada de navegadores.
| Punto de partida | Cuándo probarlo |
|---|---|
| 4 GB RAM / 2 vCPU | Una tarea de navegador con concurrencia controlada y pocos servicios auxiliares |
| 8 GB RAM / 4 vCPU | Las mediciones muestran que la configuración menor carece de capacidad para la tarea o los servicios auxiliares |
| Otra combinación de RAM y CPU | Las mediciones detectan una necesidad que las dos primeras configuraciones no cubren |
| Menor concurrencia o menos trabajo en el navegador | Las tareas paralelas adicionales empeoran la ejecución, o los datos requeridos se pueden obtener sin renderizar la página |
Mantén el servidor actual entre tus opciones. Si ya completa la extracción requerida en tus condiciones de funcionamiento, las mediciones pueden justificar conservarlo. Si estás probando un servidor nuevo, consulta nuestros planes de VPS Linux para encontrar una configuración de RAM y vCPU acorde con tu carga. Ofrecemos acceso root para que puedas instalar Playwright o Selenium y configurar el entorno del navegador y los límites de recursos que necesitas probar.
Comprueba también si los datos requieren una página renderizada. Si una vía HTTP o API autorizada devuelve los datos necesarios, evalúa esa carga por separado. Mantén los requisitos de salida en la comparación. Si devuelves menos campos o saltas páginas difíciles, estás cambiando la tarea. Comparar la capacidad necesaria para una extracción completa con la de una incompleta no aporta una conclusión útil.
Ten en cuenta toda la carga del navegador
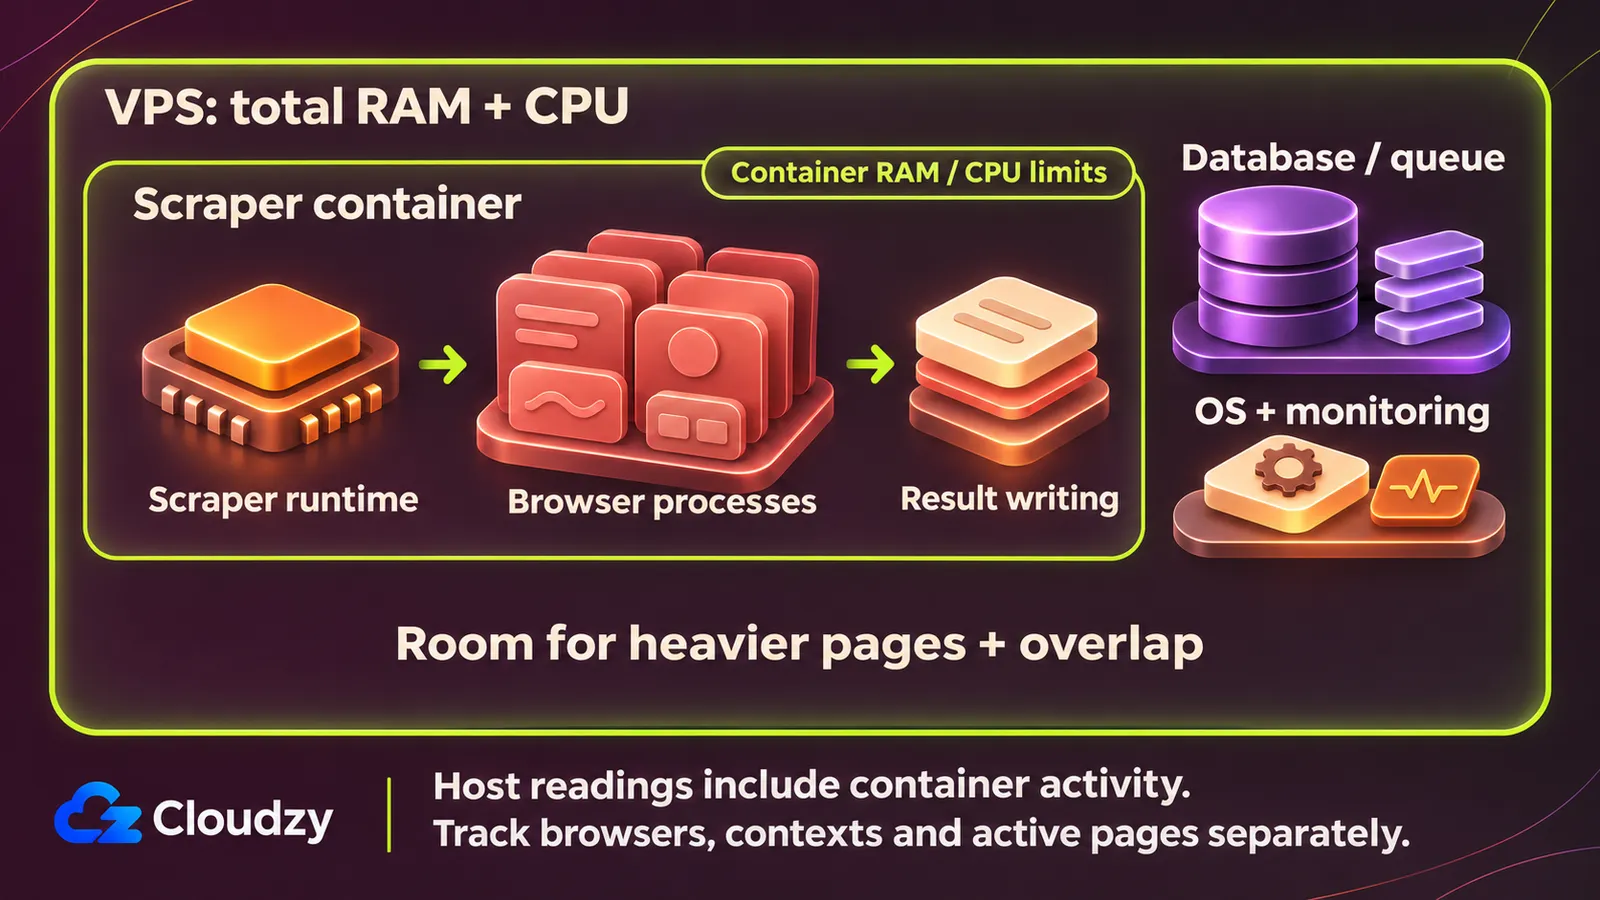
Cuando un scraper se ejecuta junto a una base de datos, su entorno de ejecución, los procesos del navegador, las páginas activas y las operaciones de la base de datos deben ajustarse a los recursos disponibles. La arquitectura multiproceso de Chromium separa el proceso del navegador de los procesos de renderizado y de otros tipos de procesos. Para dimensionar el VPS, recomiendo contabilizar toda la carga antes de interpretar las lecturas de un proceso concreto.
Una instancia de navegador es un navegador en ejecución gestionado por el código de automatización. En Playwright, cada contexto aísla el estado del navegador, y las páginas pertenecen a un contexto. La documentación de los contextos de navegador de Playwright describe un aislamiento similar al modo incógnito y permite varios contextos en un mismo navegador. Indica que crearlos cuesta pocos recursos, pero no cuantifica la RAM que requieren. Ten en cuenta las páginas que trabajan dentro de ellos.
La misma documentación distingue los contextos creados manualmente con la biblioteca de los que crea automáticamente Playwright Test. Un scraper que usa la biblioteca necesita su propio límite de concurrencia. La configuración de los procesos de trabajo del ejecutor de pruebas no establece ese límite. Registra por separado las instancias del navegador, los contextos y las páginas activas. Estas cifras no son intercambiables, y la relación entre pestañas y procesos de Chromium no es fija.
Para Selenium, registra las sesiones del controlador y sus procesos de navegador. La documentación de las sesiones del controlador distingue la ejecución local de la remota y recomienda quit para cerrar una sesión. Cerrar una ventana es una operación distinta. En Playwright, la API de cierre de contexto cierra las páginas del contexto. Usa el mismo procedimiento de limpieza en todas las ejecuciones y cierra las sesiones de tareas terminadas antes de la próxima prueba.
Describe la configuración antes de recopilar las mediciones de recursos:
- Sistema operativo, arquitectura, versión del entorno de ejecución, versión del paquete de automatización y versiones de los navegadores.
- Ejecución nativa o en contenedores, y dónde se ejecutan el entorno, el navegador y los servicios que gestionan la salida.
- Instancias del navegador, contextos de Playwright y páginas activas, o sesiones de Selenium, además del límite de concurrencia y el procedimiento de limpieza.
- Tipos de destinos y páginas, operaciones de extracción, escritura de resultados, descargas, registros y requisitos de almacenamiento.
- Servicios auxiliares que comparten el servidor, como bases de datos, colas y herramientas de monitorización.
- Configuración de memoria, CPU e IPC del contenedor, cuando corresponda.
- Calendario, solapamientos previstos, duración habitual y plazo de finalización.
Incluye cualquier dependencia del escritorio. La ejecución desatendida y la ejecución sin interfaz gráfica son cuestiones distintas: un flujo que manipula la interfaz de escritorio sigue necesitando su sesión gráfica. La distinción entre interfaz gráfica y modo headless importa si la automatización va más allá de las páginas del navegador. Incluye ese trabajo adicional en el registro de configuración para evitar atribuir su consumo de recursos a Playwright o Selenium.
Mide una ejecución representativa antes de aumentar la concurrencia
Empieza con una sola extracción activa. Mide cuántas extracciones terminan correctamente y cuánto tiempo transcurre. Después, aumenta el límite de concurrencia poco a poco sin cambiar la carga. Recomiendo registrar las observaciones del servidor junto con las de los contenedores, si los usas. Valida el límite en condiciones normales y durante los solapamientos programados antes de adoptarlo para el despliegue.
Usa tu tarea de extracción autorizada. Los comandos siguientes observan el servidor y el contenedor. No lanzan un scraper ni establecen una prueba de rendimiento. Necesitas acceso a la shell del servidor Linux. Para las observaciones de Docker también necesitas acceso al daemon y un contenedor existente. Sustituye scraper por el nombre del contenedor.
-
Registra la configuración y las mediciones de referencia. Completa el registro de configuración y observa la memoria y la CPU del servidor antes de iniciar la extracción. Mantén los servicios auxiliares en su estado normal. En ejecución nativa, usa las observaciones de procesos para contabilizar el entorno de ejecución y todo el árbol de procesos del navegador. Omite en ese caso los comandos de Docker y los campos relativos a contenedores. Si usas contenedores, determina qué procesos se ejecutan dentro de cada uno y cuáles permanecen fuera.
-
Observa el servidor y los límites efectivos del contenedor. Ejecuta en el servidor los comandos correspondientes al servidor, con los monitores continuos en terminales separadas mientras se ejecuta la tarea:
free -h
vmstat -y 1
docker inspect --type=container scraper
docker stats scraper
free -h muestra una lectura puntual en unidades fáciles de interpretar. El manual de free de procps define available como una estimación de la memoria que pueden usar aplicaciones nuevas sin recurrir al espacio de intercambio. Interpreta la estimación junto con los datos de la carga. La columna free cuenta la memoria sin usar y responde a una pregunta más concreta. Repite las lecturas durante la ejecución y conserva el valor disponible más bajo observado.
vmstat -y 1 muestra observaciones a intervalos de un segundo. El manual de vmstat de procps indica que -y omite el primer informe, que de lo contrario incluye estadísticas desde el arranque. Los campos si y so indican cuánta memoria se lee y se escribe en el espacio de intercambio por segundo. Entre los campos de CPU, id indica el tiempo de inactividad, wa la espera de E/S y st el tiempo sustraído a la máquina virtual. Correlaciona estas observaciones con el progreso y los errores de la tarea. Por sí solas no identifican la causa.
La referencia del comando inspect de Docker documenta la configuración en formato JSON y el filtro por tipo de contenedor. Registra los parámetros efectivos de memoria, CPU e IPC. Antes de compartir la salida, verifica si contiene secretos en variables de entorno. La documentación sobre límites de recursos de Docker distingue el límite --memory de restricciones de CPU como --cpus y la cuota de CPU. Una cuota restringe el tiempo de ejecución en CPU. El número de vCPU del servidor no basta para conocer la capacidad asignada al contenedor. Registra también los límites sin configurar y comprueba la configuración del espacio de intercambio.
La referencia del comando stats de Docker describe las lecturas en directo de CPU, uso y límite de memoria, red y E/S de bloques. En Linux, la CLI resta la caché al uso de memoria, por lo que sus cifras pueden diferir de las de otra fuente. PIDS incluye procesos e hilos del kernel y no cuenta navegadores. Las mediciones del servidor ya incluyen la actividad del contenedor. No sumes sus lecturas de memoria como si correspondieran a capacidades independientes. Conserva las unidades que se muestran, como GiB o MiB frente a GB o bytes sin convertir. Detén los monitores continuos con Ctrl-C.
-
Ejecuta una extracción activa con los distintos tipos de páginas. Incluye páginas representativas, tanto ligeras como exigentes, y incluye el inicio, la navegación, la extracción y la escritura de los resultados. Registra las extracciones correctas y fallidas y el tiempo total transcurrido. Una tarea se completa cuando se ha guardado la salida requerida. Si un reintento termina bien, cuenta el resultado como una sola extracción completada y conserva en el registro de errores los intentos fallidos. Es una convención de recuento propuesta para la comparación, y no una función predeterminada de la herramienta.
-
Aumenta el límite poco a poco. Mantén las mismas versiones, topología, tipos de páginas, requisitos de salida y demás ajustes. Lleva un registro separado para cada límite. Deja de aumentarlo cuando deje de aumentar la cantidad de extracciones útiles completadas, suban los errores, se supere el plazo o el margen restante sea insuficiente. Son criterios recomendados para detener la prueba, y no umbrales de utilización universales. Tener más trabajo en curso no es un avance por sí solo.
-
Valida el funcionamiento sostenido y el solapamiento. Prueba el límite elegido durante la duración habitual de la tarea y en los solapamientos previstos con servicios auxiliares u otra extracción programada. Repite la ejecución antes de aceptar la configuración. Si comparas con otro servidor, conserva la misma carga y cambia un solo recurso cada vez cuando resulte viable. Aumentar simultáneamente la RAM y las vCPU no permite aislar el efecto de la RAM ni establecer una mejora proporcional.
Para cada configuración de VPS y límite de concurrencia, registra los límites de recursos, las lecturas de memoria y CPU, la actividad de intercambio, las extracciones correctas y fallidas, el tiempo transcurrido y la decisión final.
Llama máximo observado en las muestras al valor más alto registrado. El muestreo puede omitir picos breves. La opción --no-stream de Docker solo devuelve el primer resultado, por lo que no sirve para determinar el pico de una ejecución. Deja como desconocidos los valores no observados. Completar un dato ausente con una estimación debilitaría la comparación.
El margen operativo es la capacidad que queda para páginas más exigentes, variaciones entre ejecuciones y tareas que se solapan. Determínalo según las condiciones probadas en vez de aplicar un porcentaje fijo. Si la tarea apenas se completa a tiempo o no deja margen para esas condiciones, reduce la concurrencia o prueba una configuración con más recursos.
Elige entre ajustar la configuración o ampliar la capacidad
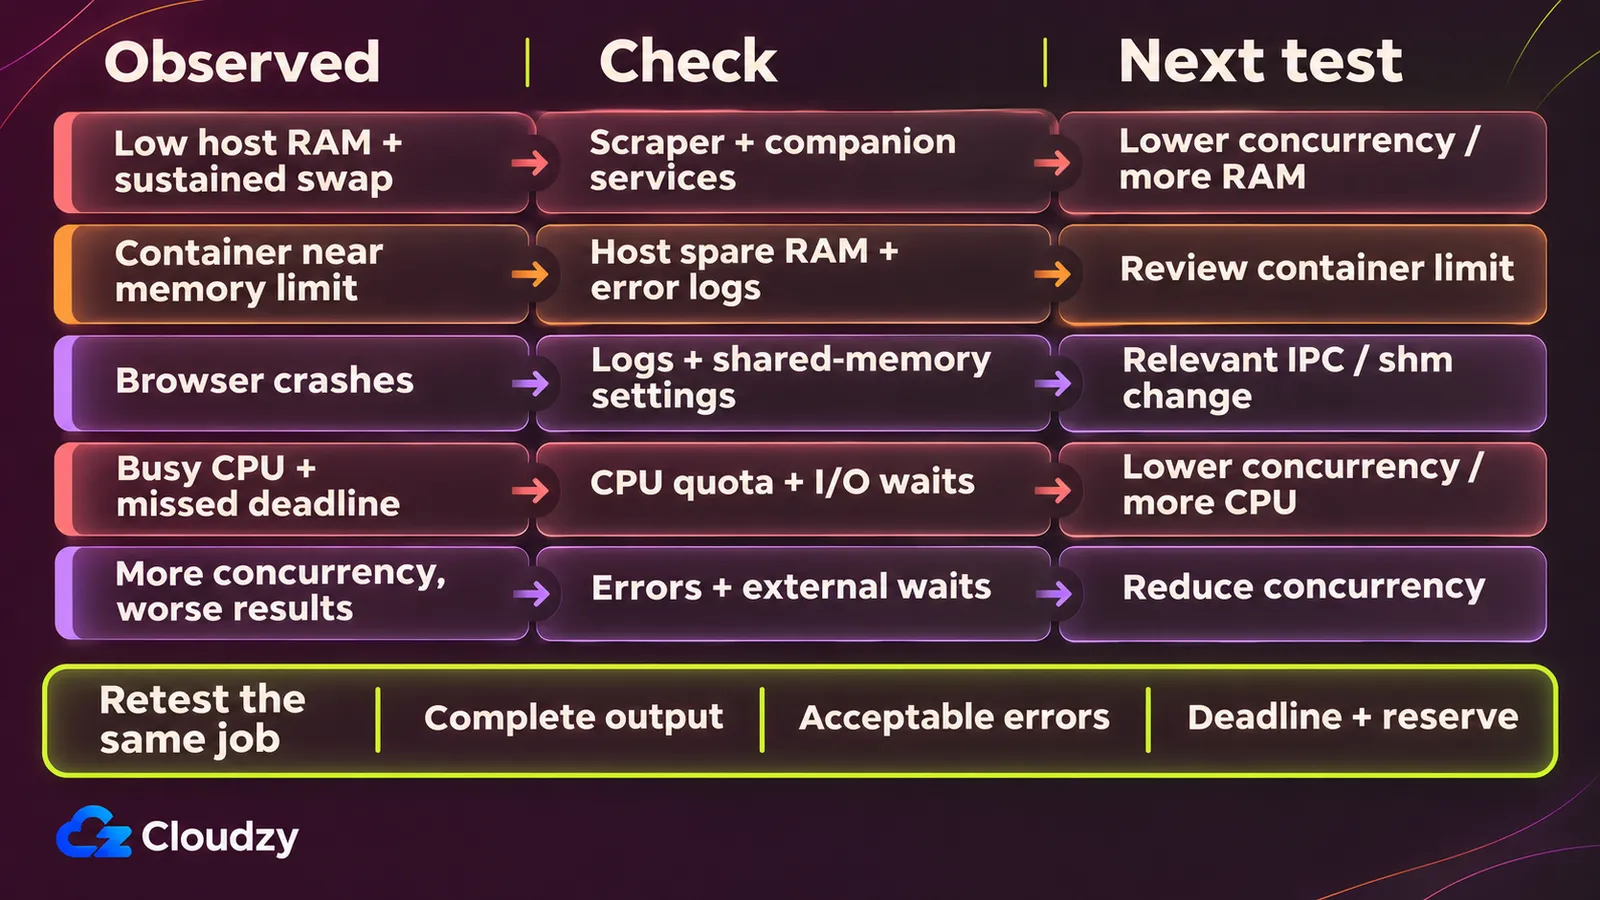
Si un contenedor alcanza su límite de memoria cuando al servidor todavía le sobra RAM, revisa ese límite antes de ampliar el VPS. Si la presión está en el propio servidor, compara una concurrencia menor con una asignación más alta. Usa la tabla para elegir el próximo cambio. Después, repite la misma extracción y compara los resultados obtenidos, los errores y el tiempo transcurrido.
| Situación observada | Siguiente comprobación o medida | Criterio de aceptación tras el cambio |
|---|---|---|
| Disminuye la memoria disponible en el servidor y hay actividad de intercambio sostenida junto con malos resultados | Compara la carga completa y los servicios auxiliares. Evalúa una concurrencia menor o más RAM | La extracción repetida termina a tiempo con un margen justificado |
| El contenedor se acerca a su límite de memoria mientras hay capacidad disponible en el servidor | Comprueba el límite efectivo y los indicios en errores o registros antes de decidir si lo cambias | Repite la prueba con la misma carga. Añadir RAM al servidor no demuestra por sí solo que hayas resuelto el problema |
| Los fallos del navegador justifican revisar la configuración de memoria compartida | Distingue /dev/shm de la RAM total y consulta las recomendaciones de IPC de Docker para Chromium |
Vuelve a probar la configuración relevante. Un mensaje de error por sí solo no diagnostica un agotamiento de memoria |
| La CPU permanece ocupada o parece intervenir un límite de CPU, y la tarea se pasa del plazo | Comprueba la cuota, la carga y el contexto de las operaciones de E/S y de las esperas. Evalúa el límite de concurrencia o la asignación de CPU | Más trabajo se completa correctamente dentro del plazo, sin dar por sentado que la mejora es proporcional |
| Al aumentar la concurrencia, suben los errores o el tiempo transcurrido sin mejorar las finalizaciones útiles | Reduce el límite y revisa el comportamiento de la carga y las esperas externas | La extracción de los datos requeridos termina correctamente dentro del plazo |
El modo en que Chromium usa la memoria compartida depende de su compilación y de la configuración de inicio. Si la configuración usa /dev/shm, revisa el sistema de archivos de memoria compartida del contenedor. La referencia de ejecución de contenedores de Docker indica que --shm-size controla el tamaño de /dev/shm y que, si se omite, el valor predeterminado es 64m. Ese parámetro determina el tamaño del sistema de archivos de memoria compartida y no equivale a toda la RAM asignada al contenedor. Ampliar el límite de memoria de Docker para Playwright y ajustar la configuración de memoria compartida son medidas distintas.
La guía de configuración de Docker de Playwright recomienda --ipc=host para Chromium y --init para gestionar los procesos. Para rastrear sitios de poca confianza recomienda un usuario separado y un perfil seccomp. Ejecutar navegadores como root desactiva el entorno aislado de Chromium. Aplica al completo la configuración indicada para el tipo de rastreo. Un ajuste de IPC no constituye una recomendación de seguridad general. Un ejemplo de pruebas de extremo a extremo en un sitio de confianza no sirve como configuración para rastrear sitios de poca confianza.
Conserva el registro de la carga validada junto con la configuración de la tarea. Repite la comprobación si cambian los tipos de páginas, las versiones, los límites efectivos o los solapamientos programados.
Si las mediciones justifican otro servidor Linux para desplegar contenedores, ofrecemos un despliegue de Docker con un clic. Usa el registro de la carga validada para elegir la asignación y trasladar al despliegue los ajustes del contenedor que probaste.
Preguntas frecuentes
¿La ejecución asíncrona hace que Playwright use menos RAM?
No necesariamente. Compara la implementación asíncrona con la actual con el mismo límite de concurrencia, las mismas páginas y los mismos requisitos de salida. Registra el uso de RAM, las extracciones correctas y el tiempo transcurrido antes de afirmar que hay un ahorro. La guía de límites de recursos de Docker recomienda probar los requisitos de memoria de la aplicación antes de pasar a producción.
¿Puedo usar la referencia de RAM de Selenium Grid para dimensionar un VPS de scraping?
La documentación de dimensionamiento de Grid de Selenium ofrece como referencia aproximada 1 CPU y 1 GB de RAM por navegador y advierte que podría no corresponder a tu contexto. Recomienda medir el rendimiento de forma continua. Ten presente esa salvedad al usar la referencia específica de Grid. No establece una fórmula de capacidad para un scraper ni un mínimo para WebDriver local.
Debate
Comentarios
Inicia sesión para unirte al debate.