
Dos bases de datos pueden ocupar el mismo espacio en disco y necesitar VPS distintos. Una lee repetidamente un conjunto pequeño de filas; otra mantiene escrituras, crea índices grandes o debe recuperarse rápido tras un fallo. Elegir el mejor VPS para bases de datos comienza por esas diferencias, antes de comparar proveedores.
Comprar un VPS no administrado implica responsabilizarse del funcionamiento de la base. PostgreSQL, MySQL y MariaDB necesitan presupuestos de memoria distintos, y la recuperación debe diseñarse junto al servidor principal. La configuración inicial debe dejar margen para copias y mantenimiento, y superar una prueba de carga representativa.
Dimensiona la carga de la base antes de elegir un plan
Mide datos e índices activos, consultas simultáneas en picos, crecimiento y requisitos de recuperación antes de elegir CPU, memoria o disco. Añade recursos según la restricción medida. Incluye espacio de mantenimiento y el consumo máximo de la aplicación si comparte servidor; el presupuesto debe cubrir tanto picos como operación normal.
El conjunto de trabajo son los datos e índices consultados con frecuencia suficiente para beneficiarse de permanecer en memoria. El tamaño almacenado incluye datos fríos. Tampoco equivalen conexiones abiertas y consultas activas: clientes inactivos y ordenaciones simultáneas consumen memoria y CPU de forma distinta. Registra ambos, el tipo de consultas y la proporción de lecturas/escrituras.
Define los requisitos de compra a partir de un periodo de alta actividad representativo:
- Mide la memoria máxima de la aplicación si compartirá el VPS.
- Registra tamaño de datos e índices, conjunto de trabajo estimado, operaciones simultáneas y crecimiento durante el horizonte de capacidad previsto.
- Mide la generación de registros e identifica la mayor creación de índice, reescritura de tabla u otra operación de mantenimiento prevista.
- Fija la latencia p95 objetivo, la pérdida de datos aceptable y el tiempo de restauración objetivo.
- Decide dónde se ejecutará la aplicación y prueba la conexión con la base.
La documentación de monitorización de PostgreSQL recomienda combinar estadísticas de la base con utilidades del sistema operativo. Recoge CPU, presión de memoria y actividad de disco junto con tiempos de consultas y confirmaciones. Investiga aumentos de latencia durante las copias aunque una comprobación en reposo parezca correcta.
Las vCPU dedicadas dan acceso sostenido a los recursos CPU asignados. No proporcionan todo un servidor físico ni determinan las IOPS. Evalúa por separado CPU, memoria y comportamiento del almacenamiento. Si los requisitos medidos exceden los VPS disponibles, estudia hardware dedicado en lugar de extrapolar a partir del nombre de un plan mayor.
Relaciona las cargas SQL con una configuración inicial
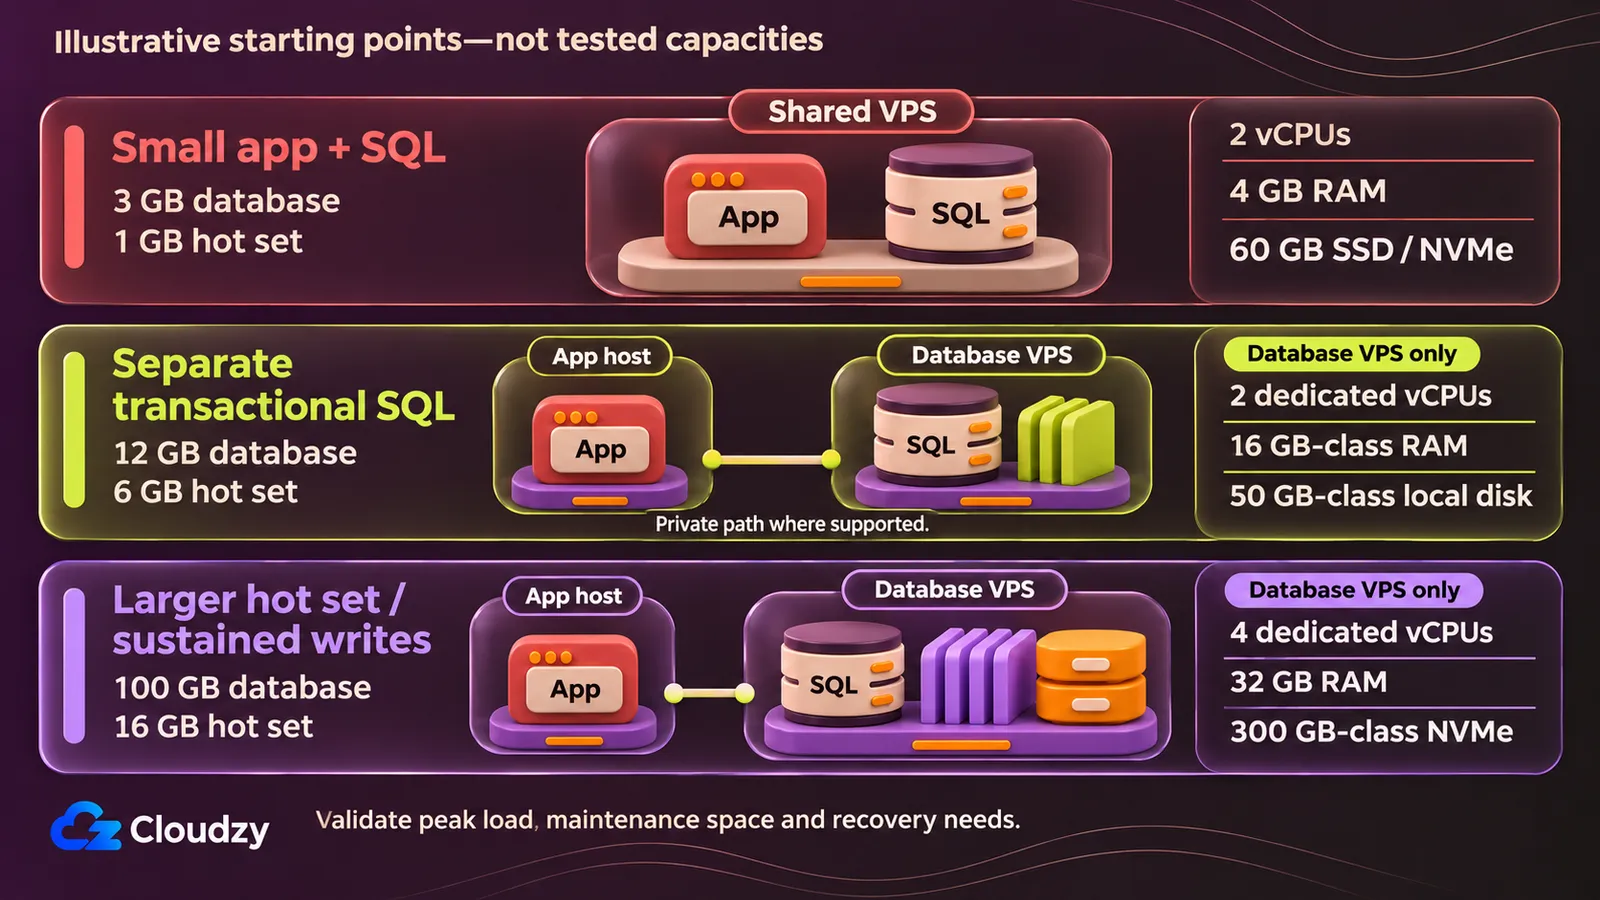
Utiliza PostgreSQL 16, MySQL 8.4 con InnoDB o MariaDB 11.4 con InnoDB como entornos de ejemplo alternativos, según la compatibilidad de la aplicación. No son motores intercambiables ni afirmaciones sobre la versión más reciente. Registra la versión de parche instalada antes de probar; los ejemplos no especifican la versión de imagen del proveedor.
Aloja juntos una aplicación pequeña y su base
Para una base supuesta de 3 GB, 1 GB de datos frecuentes y cinco consultas indexadas sencillas activas, prueba 2 vCPU, 4 GB de RAM y 60 GB nominales de SSD o NVMe. La conexión es local, pero aplicación y base deben caber en el mismo presupuesto de memoria máxima.
Supón una proporción 90/10 de lecturas/escrituras, crecimiento mensual de 1 GB y ningún informe largo durante las copias. Una CPU compartida puede servir en pruebas tolerantes. Elige CPU dedicada si la contención sostenida perjudica los tiempos de respuesta; la comparación de producción posterior usa solo vCPU dedicadas.
Esta distribución de RAM es una propuesta; todas las cifras están en GB:
| Consumidor | RAM supuesta |
|---|---|
| SO y agentes de monitorización | 0.75 |
| Aplicación en el pico | 1 |
| Caché de la base | 1 |
| Caché del sistema de archivos | 0.75 |
| Reserva para consultas, conexiones y mantenimiento | 0.5 |
| Total | 4 |
Para MySQL o MariaDB, ajusta el búfer InnoDB a este presupuesto. Aplicar a todo el servidor un porcentaje para bases dedicadas consumiría memoria asignada a la aplicación. En PostgreSQL, presupuesta por separado búferes compartidos y memoria de operaciones dentro de la asignación y reserva de la base. Mide el pico conjunto antes de aceptar cualquiera de las configuraciones.
Ejemplo de disco: 5 GB para SO/registros, 3 GB para datos/índices, 4 GB para registros del motor, 3 GB temporales y 6 GB de crecimiento: 21 GB. El resto nominal cubre sobrecarga del sistema de archivos y trabajo transitorio; no justifica retener las copias en el servidor principal.
Conecta por socket local o localhost. Prueba confirmaciones duraderas con aplicación y copias activas, incluida la sincronización (fsync), que pide al SO vaciar datos a almacenamiento duradero. Si el responsable acepta un RPO de 24 horas, la pérdida admisible, y un RTO de cuatro horas, el tiempo objetivo de recuperación, propón una copia nativa nocturna fuera del nodo y demuestra el tiempo de restauración en un simulacro. Si falla el presupuesto de memoria, latencia o recuperación, separa, redimensiona o revisa la recuperación tras diagnosticar consultas e índices.
Separa una base SQL transaccional
Con la aplicación en otro servidor, una base ilustrativa de 12 GB y 6 GB de datos frecuentes puede comenzar las pruebas con 2 vCPU dedicadas, unos 16 GB de RAM y 50 GB locales. Supone 20 consultas indexadas activas, escrituras cortas y poco cálculo sostenido; operaciones mayores pueden invalidar el presupuesto.
Supón 90/10 en lecturas/escrituras y 1 GB de crecimiento mensual durante tres meses. Es la carga de referencia del cuadro de proveedores. Las unidades varían: compara memoria realmente disponible y bytes utilizables antes de aplicar las asignaciones.
Para PostgreSQL en VPS, la guía de búferes compartidos de PostgreSQL 16 parte del 25 % de memoria del sistema en un servidor de base dedicado con al menos 1 GB de RAM. También utiliza caché del SO. Presupuesto propuesto de 16 GB: 4 GB compartidos, 2 GB SO/agentes, 2 GB de reserva para consultas/conexiones/mantenimiento y 8 GB de caché de archivos/margen.
La reserva no es un ajuste de work_mem. La documentación de memoria de operaciones de consulta de PostgreSQL explica que ordenaciones y hashes independientes pueden asignar memoria mientras trabajan varias sesiones. Los hashes usan también hash_mem_multiplier. Fija límites según el trabajo simultáneo permitido; un valor elevado por operación puede superar el presupuesto pese a disponer de suficientes búferes compartidos.
Para MySQL en VPS, la guía del búfer de MySQL 8.4 de Oracle suele recomendar el 50–75 % de memoria del sistema, considerando SO y otras asignaciones. Prueba un búfer InnoDB de 8 GB y reserva el resto para esos consumidores y picos.
MariaDB en VPS requiere otro cálculo. Su guía de asignación de memoria parte del 60–70 % de RAM disponible tras SO/servicios para sistemas mayoritariamente InnoDB. Con 13 GB disponibles, son 7,8–9,1 GB; un búfer inicial de 8 GB encaja. MyISAM o Aria requieren considerar su caché aparte. Estos presupuestos son alternativas: no los sumes.
Disco: 12 GB datos/índices + 3 GB crecimiento + 5 GB SO + 4 GB registros + 8 GB temporales/mantenimiento = 32 GB. Un disco de unos 50 GB deja aproximadamente 18 GB nominales antes de sobrecargas. Exige al menos 15 GB libres medidos; más registros retenidos o reescrituras invalidan el ejemplo.
Sitúa cerca aplicación y base, con ruta privada probada si se admite, autenticación, controles de acceso y cifrado. Comprueba latencia de consultas y confirmaciones duraderas durante checkpoints, vaciados y copias. Asigna almacenamiento de copias independiente; el caso de recuperación posterior lo desarrolla. Redimensiona si un recurso se satura, falta espacio libre o no se cumplen objetivos de recuperación tras diagnosticar consultas e índices.
Presupuesta conjuntos de trabajo grandes o escrituras sostenidas
Para una base supuesta de 100 GB y conjunto frecuente de 16 GB, prueba 4 vCPU dedicadas, 32 GB de RAM y unos 300 GB NVMe. Separa la aplicación. El ejemplo admite 30 consultas mixtas activas y proporción 60/40 de lecturas/escrituras; mide ejecución y presión de almacenamiento antes de decidir qué aumentar.
Supón 10 GB mensuales durante tres meses. PostgreSQL: 8 GB compartidos, 4 GB de reserva SO/consultas/mantenimiento y 20 GB de caché de archivos/margen. Para MySQL o MariaDB, un búfer InnoDB de unos 16 GB es una alternativa inicial tras reservar el resto. No trasplantes parámetros PostgreSQL a estos motores.
El almacenamiento incluye trabajo en curso: 100 GB datos/índices + 30 GB crecimiento + 30 GB registros retenidos o en cola + 60 GB para la mayor operación temporal/de mantenimiento prevista + 10 GB SO = 230 GB. Quedan unos 70 GB nominales. Una reescritura mayor obliga a recalcular aunque el crecimiento diario sea modesto.
La documentación de limpieza rutinaria de PostgreSQL distingue VACUUM, que hace reutilizable el espacio de filas muertas, de VACUUM FULL, que escribe otra copia de la tabla y necesita espacio adicional temporal. Comprar apenas más disco que datos puede impedir el mantenimiento para recuperar espacio.
Mide ejecución CPU, presión de caché y E/S físicas aparte de la latencia de escritura. Incluye escrituras temporales y checkpoints/vaciados. NVMe y CPU dedicada describen la configuración, no garantizan IOPS. Prueba transferencias sostenidas de copias y replicación, con conexión privada cercana y almacenamiento independiente. Generar más registros cambia retención y demanda de red. Aumenta núcleos, RAM o disco según la restricción observada, no porque el siguiente plan aumente los tres.
Añade capacidad de recuperación a producción
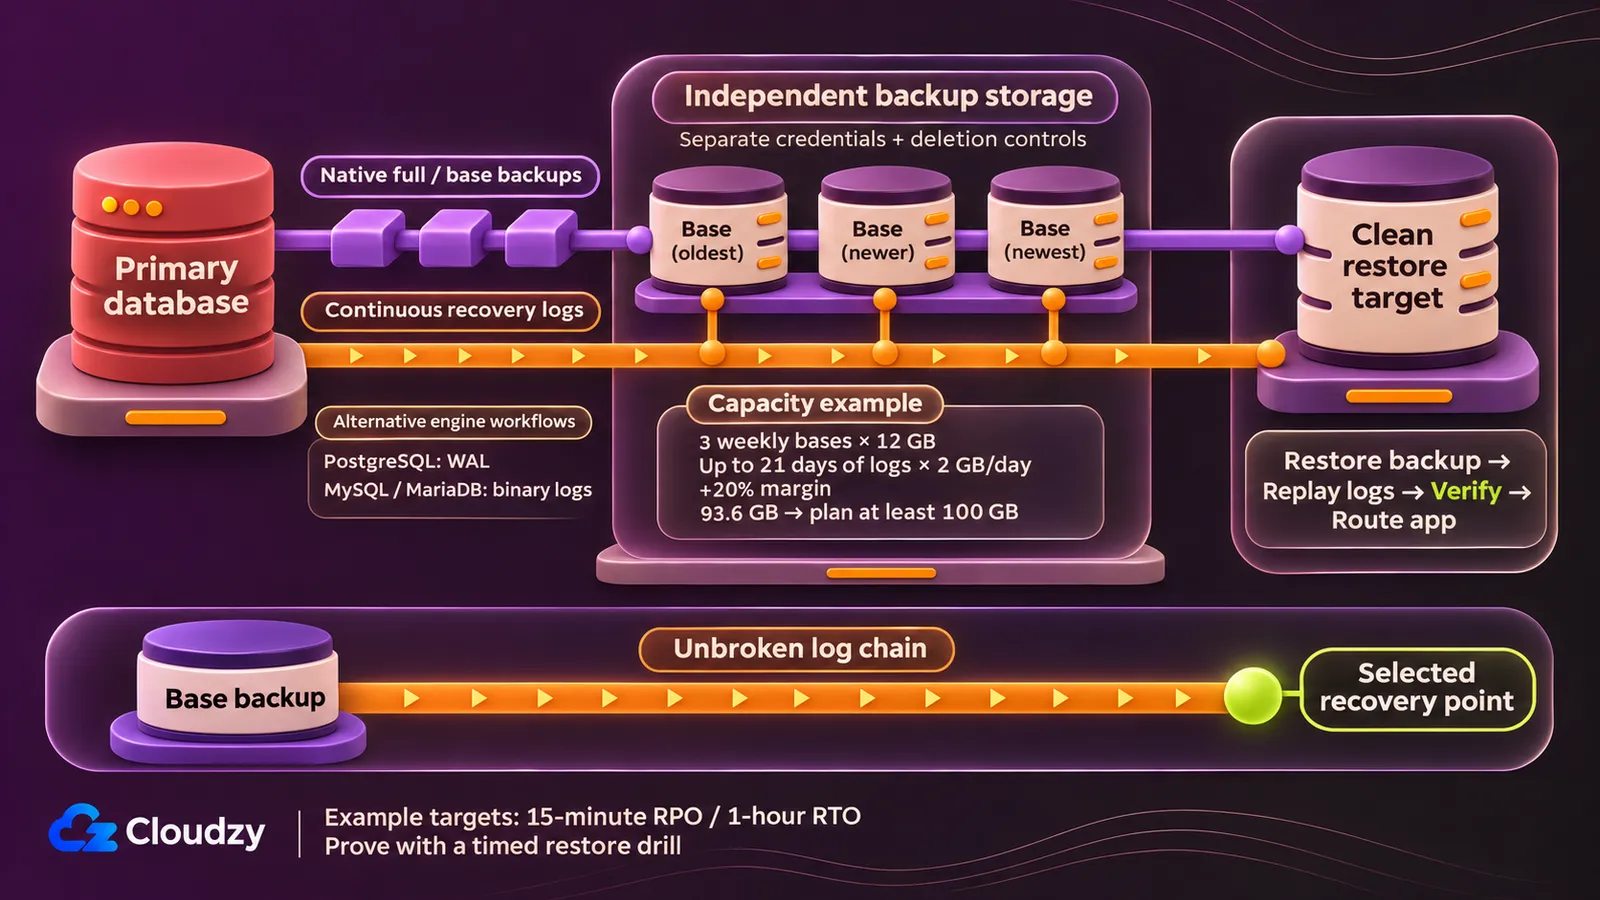
Aceptar 15 minutos de pérdida de datos y una hora para restaurar exige más que el presupuesto del principal. Mantén los supuestos transaccionales separados y añade copias nativas, registros retenidos, almacenamiento independiente y un simulacro cronometrado. Son objetivos de planificación; solo el simulacro demuestra su cumplimiento.
La documentación de archivado continuo de PostgreSQL describe una copia base y archivo ininterrumpido de WAL para recuperar a un punto temporal. La documentación de recuperación MySQL de Oracle usa una copia completa seguida de registros binarios. El procedimiento PITR de MariaDB restaura datos completos/incrementales antes de reproducir registros binarios. Deben habilitarse para estos flujos MySQL/MariaDB.
Ejemplo: cada copia completa/base sin comprimir ocupa 12 GB. Conserva tres bases semanales y registros continuos desde el inicio de la más antigua. Presupuesta hasta 21 días de registros a 2 GB diarios y un margen del 20 %:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
Planifica al menos 100 GB independientes sin contar con compresión. Vincula el borrado de registros a la caducidad de copias y su sustitución correcta. Comprueba la cadena completa de bases y registros para todos los puntos de recuperación prometidos.
Usa copias en un destino independiente, con credenciales y controles de borrado separados del principal. Una instantánea del proveedor no garantiza esta cadena nativa. El simulacro debe crear un destino limpio, transferir y restaurar, reproducir registros, verificar coherencia de base/aplicación y dirigir la aplicación. Cronometra también aprovisionamiento y transferencia.
Un objetivo de interrupción menor puede exigir una réplica independiente capaz de soportar toda la carga. Presupuesta su CPU, RAM y disco por separado; define promoción, aislamiento del antiguo principal y enrutamiento. Ensaya la secuencia. Replicar no sustituye las copias y un VPS no es alta disponibilidad. Revisa si restaurar supera una hora, el retraso del archivo supera el RPO, el respaldo no soporta carga o las copias se acercan a su límite de almacenamiento.
Cuándo elegir un VPS administrado
Si nadie puede atender alertas o restaurar la base durante un incidente, compra cobertura operativa explícita. Un VPS administrado puede transferir mantenimiento, pero el contrato debe nombrar las tareas de base incluidas. Un panel no garantiza cobertura y un VPS administrado difiere de una base gestionada.
La diferencia entre responsabilidades en VPS administrados y no administrados resulta útil tarea por tarea. Toma esto como lista de compra, no como promesa de cobertura uniforme. La infraestructura física sigue siendo del proveedor; el software invitado y la operación de la base necesitan responsables explícitos.
| Trabajo | VPS no administrado | Cobertura que debes acordar antes de contratar gestión |
|---|---|---|
| Parches y actualizaciones del SO invitado y la base | Tú los programas y ejecutas | Versiones admitidas, alcance de parches, pruebas de actualización y ventanas de mantenimiento |
| Ajuste de consultas, esquema e índices | Tú diagnosticas y modificas | Si el ajuste se incluye, se limita a configurar el servicio o se cobra aparte |
| Monitorización e incidentes | Tú configuras alertas y respondes | Horario de monitorización, responsables de respuesta/escalado y quién actúa tras una alerta |
| Copias y restauraciones | Tú respondes del procedimiento de recuperación | Retención, almacenamiento independiente, asistencia y pruebas de restauración |
Pregunta útil para el contrato: «Si la base se queda sin disco durante una copia, ¿quién diagnostica, restaura el servicio y comprueba que la siguiente copia funciona?». Distingue acceso al soporte de responsabilidad por el resultado. Pregunta también por una actualización fallida o un borrado accidental.
Las bases gestionadas tienen sus propios acuerdos de ciclo de vida del motor, copias y conmutación. Pueden convenir si quieres transferir recuperación y actualizaciones. No deduzcas ajuste de aplicaciones de esa etiqueta; diseño de consultas y comportamiento de la aplicación siguen necesitando responsable salvo acuerdo contrario.
Asigna cada tarea una sola vez, con escalado y comprobación de aceptación. Compara el coste con tu tiempo y disponibilidad. No hay valor horario universal para autogestionar y una factura informática barata no atiende incidentes sin dueño.
Elige una configuración VPS para cargas no SQL
Los ejemplos separan memoria, documentos e indexación de búsqueda. Acerca la aplicación y prueba conexiones y transferencias a copias y réplicas si se usan.
| Carga y supuestos | Configuración inicial que probar | Almacenamiento, recuperación y motivos para cambiar |
|---|---|---|
| Redis caché/clave-valor; conjunto medido de 2 GB | 2 vCPU dedicadas, 8 GB RAM; ajusta maxmemory por debajo de la memoria del servidor con margen para sobrecargas |
Una caché reconstruible admite pérdida. Un principal persistente necesita RDB/AOF deliberados, espacio de reescritura y copias independientes. Mide memoria/RSS, fragmentación, expulsiones, picos de persistencia y latencias extremas. |
| MongoDB; 20 GB de documentos/índices y conjunto frecuente pequeño medido | 2–4 vCPU dedicadas, 16 GB RAM, disco local de unos 100 GB | Presupuesta journal/oplog, crecimiento y temporales. Prueba restauración; vigila expulsiones, E/S y retraso de replicación. Asigna recursos CPU, RAM y disco a cada réplica según su función. |
| Elasticsearch; índices pequeños de 30 GB | 4 vCPU dedicadas, 16 GB RAM y unos 150 GB locales por nodo de datos pertinente | Presupuesta réplicas, fusiones, retención e instantáneas independientes. Comprueba heap/GC, latencias de búsqueda/indexación, E/S de fusiones y disco. La resiliencia exige topología de voto y enrutamiento adecuados. |
La guía de administración de Redis advierte que guardados RDB y reescrituras AOF con muchas escrituras pueden consumir el doble de memoria normal según las páginas modificadas. Los 2 GB de datos no pueden ocupar toda la asignación. Su documentación de persistencia distingue instantáneas periódicas RDB y registro AOF. Elige según la pérdida admisible y mide picos de RAM y disco durante su ejecución.
La documentación de caché WiredTiger de MongoDB describe cachés interna y de archivos. La interna predeterminada es el mayor de 50 % × (RAM − 1 GB) y 0,256 GB. La guía de conjuntos de réplicas recomienda tres miembros con datos. Un árbitro vota sin almacenar datos. Añade copias independientes e implementa autenticación MongoDB antes de conectar la aplicación.
La documentación JVM de Elastic recomienda dimensionar el heap automáticamente. Si es manual, iguala mínimo y máximo y no superes el 50 % de memoria disponible. La guía de resiliencia de clústeres pequeños describe dos nodos con datos elegibles como maestro y un desempate solo votante. Configura réplicas y clientes hacia nodos de datos; el desempate añade voto, no copia. Si fusiones o retención consumen la reserva, revisa el presupuesto antes de añadir documentos.
Compara planes no administrados para tu configuración
Para el ejemplo SQL transaccional separado, filtra por al menos 2 vCPU dedicadas, unos 16 GB RAM y 50 GB locales. Superar ese mínimo solo permite pasar a pruebas. Diferencias de CPU/disco, unidades y compromisos impiden tratarlos como hardware equivalente o clasificación de rendimiento.
Referencia: Linux autogestionado en Alemania o Europa central cercana, pocos datos y más memoria. La proximidad no implica igual latencia. Conexión privada donde se admita y cotizaciones con IPv4 pública estándar. Supón transferencias inferiores a todas las cuotas.
| Proveedor y plan no administrado | vCPU dedicadas / RAM / disco local | Ubicación y transferencia incluida | Precio, facturación e IPv4 |
|---|---|---|---|
| Cloudzy: nuestro Regular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | Ubicaciones en varias regiones del mundo; 10 TB | 49,98 $/mes; IPv4 e IPv6 incluidas |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1; al menos 20 TB en la UE | Tope 86,49 €/mes, incluidos 0,50 € de IPv4 principal, sin IVA |
| DigitalOcean Droplet Memory-Optimized combinado, CPU Regular, SSD 1× | 2 / 16 GiB / 50 GiB NVMe | Familia disponible en FRA1; 4000 GiB | Tope 84 $/mes; 0,125 $/hora; IPv4 pública incluida |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2 núcleos/16 GB/100 GB | 2 / 16 384 MB / 100 GB NVMe | Fráncfort (fra); 6144 GB |
80 $/mes; 0,11 $/hora; IPv4 predeterminada; confirma cargos aparte o descuento sin IPv4 antes de presupuestar |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16 384 MB / disco SSD 327 680 MB (clase 320 GB) | Fráncfort (de-fra-2) figura disponible; 6000 GB |
173 $/mes; 0,2595 $/hora; IPv4 pública estándar sin coste adicional |
La documentación de selección de DigitalOcean incluye Memory-Optimized para SQL/NoSQL y cachés. Recomiendo esta familia combinada para poco disco y mucha memoria. Un VPS optimizado para memoria no es exclusivo de SQL. Si las mediciones identifican capacidad o demanda sostenida de almacenamiento como restricción, evalúa Storage-Optimized por separado.
Los cinco cumplen el mínimo con distintos excedentes CPU/disco. Pueden permitir crecer, pero no demuestran mayor velocidad sin pruebas. El catálogo Hetzner no garantiza existencias. Akamai documenta SSD para G7 Dedicated. Optimized Memory de Vultr difiere de High Frequency Compute compartido.
Nuestra asignación dedicada encaja en la configuración autogestionada al precio indicado. Compara recursos, monedas, compromisos de facturación y cargos IPv4 antes de juzgar el valor total.
Coste de propiedad: cómputo + dirección + almacenamiento/solicitudes/transferencia de copias independientes + capacidad para probar restauraciones + respaldo opcional. Un coste desconocido no es cero. Obtén tarifas actuales de recuperación y verifica plan, ubicación y ampliaciones antes del compromiso. No infieras una factura anual multiplicando un equivalente mensual redondeado.
Elegido el motor SQL compatible, nuestras aplicaciones de un clic acortan la instalación. PostgreSQL, MySQL y MariaDB son selecciones separadas; elegir una no instala las tres. Sigue siendo autogestionado: parches, ajustes y recuperación son tu responsabilidad.
Preguntas frecuentes
¿El porcentaje de aciertos de caché PostgreSQL indica si el disco es lento?
No. La documentación de estadísticas de E/S de PostgreSQL explica que la caché del SO puede servir una lectura sin acceder al disco. Combina aciertos de caché con E/S del SO y tiempos de consulta. La proporción sola no distingue retraso físico de lecturas desde la memoria del kernel.
¿Sirve un volcado lógico PostgreSQL para recuperación puntual basada en WAL?
No. Los requisitos de archivado continuo de PostgreSQL indican que los volcados lógicos carecen de información para reproducir WAL. Restauran el estado capturado; la recuperación puntual WAL exige copia base adecuada y WAL archivado continuo. Elige el formato según tu método de recuperación.
¿Debe la caché MongoDB usar la RAM del anfitrión al ejecutarse en un contenedor?
Usa la memoria disponible del contenedor. La guía de memoria en contenedores de MongoDB advierte que WiredTiger puede ignorar un límite menor en ciertos casos. Configura la caché por debajo, dejando margen para otros procesos; la RAM total del anfitrión puede sobreestimar la disponible para la base.
Debate
Comentarios
Inicia sesión para unirte al debate.