
Un membre de r/linuxquestions a fait la comparaison sur laquelle tout le monde se dispute. Il a installé CachyOS, benchmarké plusieurs jeux sur un Ryzen 7 7800X3D avec une Radeon RX 7900 XTX, et n'a mesuré aucune différence par rapport aux autres distributions déjà présentes sur la machine. Les réponses ont suivi le schéma habituel. Un commentateur a placé le plafond assez bas pour être invisible à l'usage normal. Un autre a expliqué l'ordonnanceur. Un troisième a affirmé que les benchmarks ne peuvent pas montrer ce que fait l'ordonnanceur. Personne n'a produit la mesure qui aurait tranché.
La question revient toujours dans les mêmes termes : CachyOS est-il vraiment plus rapide ? La réponse courte est oui, sur des charges de travail précises. Les paquets recompilés peuvent aider le code que le compilateur sait vectoriser, les comparaisons en jeu citées ici montrent peu d'écart de FPS moyen, et un système qui semble plus rapide après la migration est plus difficile à attribuer, car un changement de distribution modifie bien plus qu'une seule variable.
La question reste ouverte parce que « plus rapide » recouvre trois affirmations distinctes avec trois réponses différentes, chacune exigeant son propre instrument. Les paquets recompilés terminent une tâche en moins de temps réel, ou non. Un ordonnanceur change le comportement du bureau sous contention, ou non. Et une machine plus réactive s'explique par CachyOS, ou par quelque chose arrivé en même temps.
La version courte
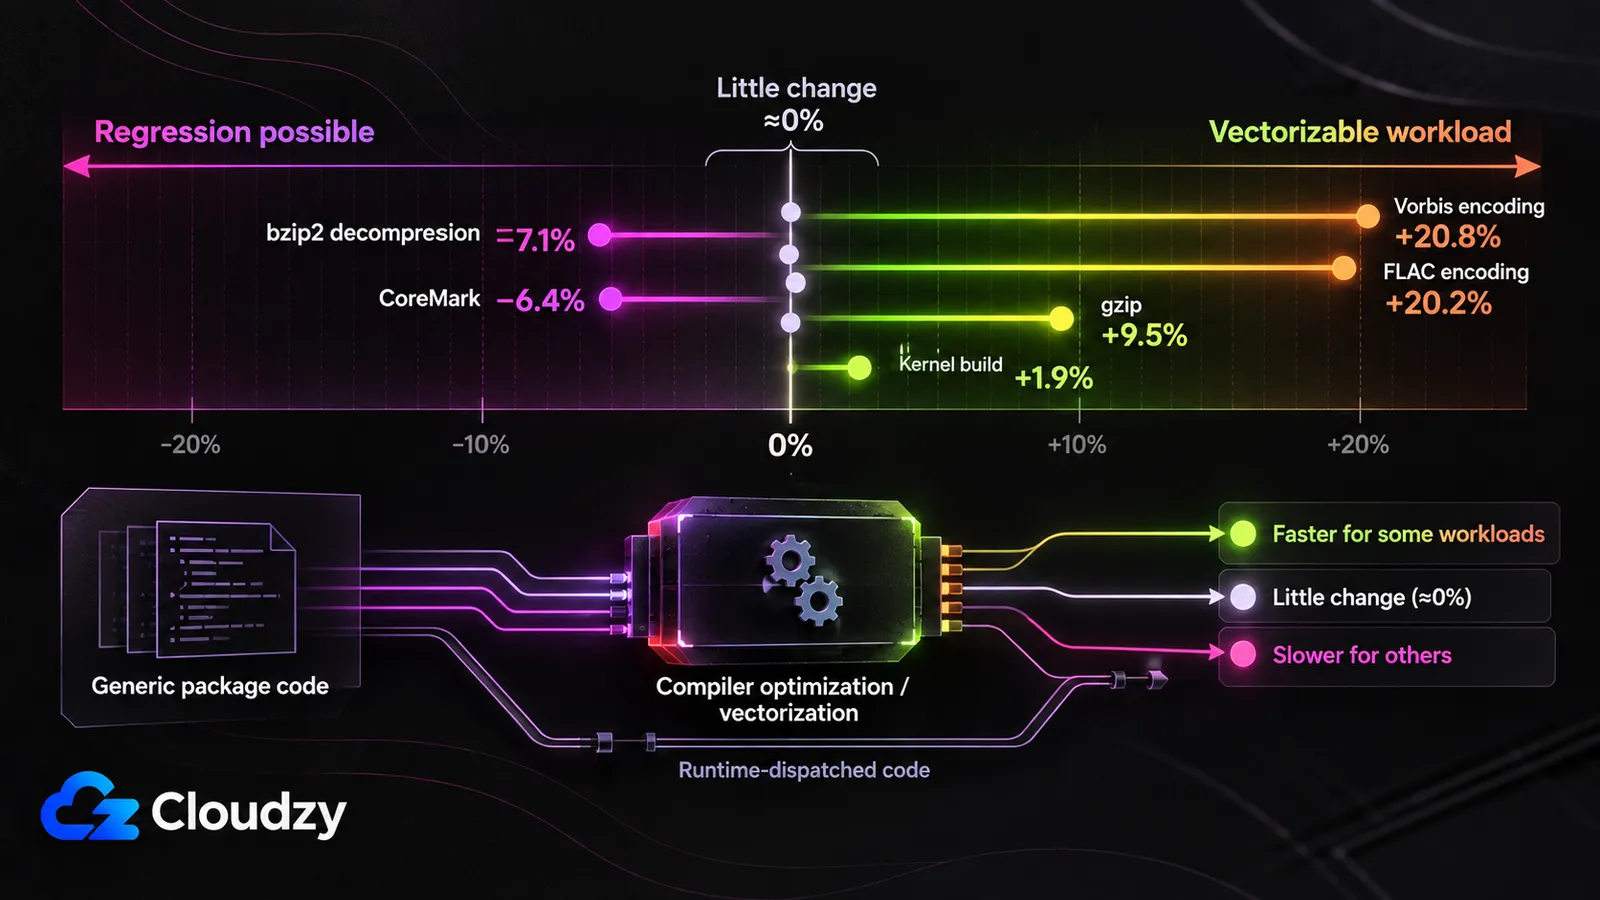
- Paquets recompilés : mesurablement plus rapides, sur une minorité de ce que vous exécutez. Les gains se concentrent dans le code que le compilateur peut vectoriser, plusieurs paquets ressortent plus lents, et la plupart ne changent pas. Une comparaison en arch-chroot de janvier 2023 sur sunnyflunk.github.io, sur un Intel NUC8i5BEK, a mesuré l'encodage flac 20,2 % plus rapide et la décompression bzip2 7,1 % plus lente dans la même série.
- L'histoire de l'ordonnanceur se divise en deux. Le noyau par défaut actuel de CachyOS utilise EEVDF, tandis que BORE est disponible séparément. Les comparaisons de distributions de mai 2026 ont trouvé peu d'écart de FPS moyen et ont aussi mesuré les 1 % les plus bas et la régularité des images, mais elles n'ont pas isolé BORE ni ajouté une charge CPU concurrente contrôlée. Le jeu prêt à l'emploi a été mesuré ; le bénéfice de BORE sous contention n'a pas été isolé.
- La sensation d'une machine plus rapide : expérience réelle, attribution peu fiable. Une installation neuve et la correction fortuite d'un bug sans rapport produisent toutes deux un système plus vif qui ne doit rien aux niveaux de jeu d'instructions. L'exception à connaître est la comparaison en configuration d'origine de Phoronix sur un Intel Core Ultra 9 285K, où CachyOS a devancé Arch standard sur un CPU qui ne peut pas du tout exploiter les optimisations AVX-512.
Ce que CachyOS change réellement sur votre système
CachyOS, c'est Arch Linux avec trois modifications distinctes empilées dessus : un noyau patché proposant des ordonnanceurs alternatifs, des dépôts dont les paquets sont recompilés pour des niveaux de jeu d'instructions CPU plus récents, et des optimisations de compilation supplémentaires sur un sous-ensemble de paquets de base. Chacune est un mécanisme distinct avec un effet distinct, et elles ne sont presque jamais mesurées séparément.
Le côté noyau est la surface la plus étendue. La liste des fonctionnalités du noyau CachyOS couvre Clang ThinLTO, le profilage AutoFDO, des modes de préemption sélectionnables à l'exécution et plusieurs options d'ordonnanceur. Le paquet actuel linux-cachyos utilise un EEVDF ajusté par CachyOS comme ordonnanceur par défaut. BORE et BMQ sont disponibles via des variantes de noyau séparées, tandis que linux-cachyos-eevdf applique un réglage supplémentaire de réactivité EEVDF et que linux-cachyos-server utilise l'EEVDF d'origine. sched-ext reste disponible sur les variantes qui le prennent en charge.
Côté paquets, les dépôts x86-64-v3 de CachyOS sont le mécanisme en question. La page des dépôts optimisés de CachyOS décrit la recompilation des paquets Arch pour trois cibles au-dessus de la base générique : x86-64-v3, x86-64-v4, et une cible dédiée Zen 4/5 qui ajoute d'autres extensions AVX-512, plus quelques instructions hors AVX-512, par-dessus v4. Un sous-ensemble de paquets sensibles aux performances reçoit aussi une optimisation guidée par profil et BOLT.
Ces noms de niveaux viennent de la spécification des niveaux de microarchitecture du psABI x86-64, et ce sont des seuils, pas des curseurs. x86-64-v3 exige les instructions de l'ère AVX et AVX2 arrivées avec le Haswell d'Intel en 2013 et les cœurs Excavator d'AMD ; x86-64-v4 exige AVX-512, ce qui signifie en pratique les puces Intel de classe Skylake-X et tout AMD Zen 4 ou plus récent. Un CPU franchit la barre ou ne la franchit pas.
Les trois affirmations cachées dans le mot « plus rapide »
Quand deux personnes ne sont pas d'accord sur le fait que CachyOS soit plus rapide, elles ont généralement toutes deux raison sur des choses différentes. Le débit, la régularité des images et la réactivité perçue sont des propriétés distinctes, et aucune métrique unique ne règle les trois. Une tâche chronométrée mesure le débit ; les mesures de temps d'image et de latence couvrent la fluidité en jeu ; une comparaison contrôlée sur installation neuve est nécessaire pour l'effet plus large au niveau du système.
| L'affirmation | Ce qui est avancé | Comment la mesurer | Ce que montrent les données | Confiance |
|---|---|---|---|---|
| Débit mesuré | Les paquets recompilés terminent la même tâche en moins de temps | Chronométrer une tâche sur un matériel fixe et un noyau fixe, en ne changeant que le dépôt d'origine des paquets | Gains solides sur le travail vectorisable, petites régressions sur plusieurs paquets, aucun changement sur la plupart | Élevée. Canonical, le CentOS ISA SIG et deux benchmarkers indépendants s'accordent sur la forme |
| Latence d'entrée et régularité des images | Le bureau reste réactif pendant qu'autre chose sature le CPU | Percentiles de temps d'image et latence d'entrée sous une charge concurrente, pas la fréquence d'images moyenne | Les tests publiés incluent désormais les 1 % les plus bas et la régularité des images, mais ils n'isolent pas l'ordonnanceur et n'introduisent pas de charge CPU concurrente contrôlée | Faible. Le mécanisme est documenté, la mesure manque |
| Réactivité perçue | La machine semble plus vive après la migration | Comparer à une installation neuve de la distribution précédente, pas à l'installation usée | Généralement expliqué par les effets d'installation neuve ou une correction fortuite ; une comparaison en configuration d'origine a trouvé une avance au niveau de la distribution | Moyenne. Expérience fondée, attribution peu fiable |
Une suite de benchmarks qui répond à la première ligne ne peut pas répondre à la deuxième, et aucune ne touche la troisième. Exécuter l'une des trois et présenter le résultat comme un verdict sur les trois est ce qui fait durer le débat.
Les paquets recompilés tournent-ils vraiment plus vite ?
Oui, sur une minorité de ce qu'un bureau exécute, et l'ampleur dépend de la charge de travail, pas de la distribution. Le travail vectorisable obtient des gains à deux chiffres, une poignée de paquets ressortent plus lents, et la plupart ne montrent rien. La page des dépôts optimisés de CachyOS situe le gain de x86-64-v3 entre 5 % et 20 % par rapport au x86-64 générique ; les mesures publiées se situent surtout dans le bas de cette fourchette.
La comparaison de performance CachyOS vs Arch la plus propre isole la variable des paquets et rien d'autre : un test en arch-chroot de janvier 2023 sur sunnyflunk.github.io. L'hôte tournait sous Arch standard sur un Intel NUC8i5BEK, les deux jeux de paquets ont été testés dans un arch-chroot pour que le noyau et l'environnement restent identiques, et les benchmarks ont tourné en RAM pour éliminer la latence disque. Face aux paquets Arch standard, les builds CachyOS étaient 20,2 % plus rapides pour encoder du flac en -8, 20,8 % plus rapides pour encoder du vorbis et 9,5 % plus rapides sur gzip -3. Dans la même série, ils étaient 7,1 % plus lents pour décompresser du bzip2, 1,6 % à 2,9 % plus lents pour compresser avec lz4, 3 % plus lents sur pybench et inchangés sur le benchmark R. Deux réserves viennent de l'auteur lui-même : CachyOS compilait avec -march=x86-64-v3 -mpclmul -O3 contre -march=x86-64 -O2pour Arch, et ses tests de suivi suggéraient que -O3 plutôt que le niveau de jeu d'instructions expliquait une partie des plus gros gains. Le billet précède le dépôt Zen 4 de CachyOS, arrivé avec la version de juillet 2024, mais pas son travail BOLT : l'auteur interprète le paquet Python de CachyOS derrière la régression pybench comme portant déjà BOLT par-dessus x86-64-v3.
Les benchmarks CachyOS sur du matériel plus récent répètent le schéma. Une comparaison de juillet 2024 sur mvermeulen.org a exécuté un sous-ensemble de la Phoronix Test Suite sur un Ryzen 7940HS Zen 4, CachyOS avec le dépôt Zen 4 contre Ubuntu 22.04. La plupart des résultats se sont situés à quelques pour cent près dans un sens ou dans l'autre : coremark 6,4 % plus lent, les sous-tests OpenSSL d'environ 1 % plus lent à 4 % plus rapide, le temps de compilation du noyau 1,9 % plus rapide, phpbench en valeur aberrante avec un score légèrement supérieur au double. L'auteur signale un décalage de version de GCC, 14.1 contre 11.4 pour Ubuntu, comme facteur de confusion probable. Son test NAMD séparé de mars 2024 a trouvé des améliorations de 6,5 % et 5,8 % sur deux charges de dynamique moléculaire.
Les tests institutionnels ont trouvé le même tableau contrasté, aux deux extrémités. Le propre benchmark x86-64-v3 de Canonical, publié en mars 2024 avec une image expérimentale Ubuntu 23.10 sur Azure, a rapporté des gains reproductibles allant jusqu'à 60 % sur le benchmark Log2 de la glibc, tandis que d'autres benchmarks régressaient nettement, dans un cas parce qu'activer v3 sur du code SSE déjà optimisé a poussé le compilateur à le développer en 17 fois plus d'instructions. La reconstruction de CentOS Stream 9 par le CentOS ISA SIG de v2 vers v3, sur des machines Intel de classe Ice Lake en août 2023, a qualifié les résultats de « plutôt mitigés », avec des accélérations de 2,2x concentrées dans Mocassin et le md5crypt de John the Ripper, tous deux très vectorisables, bien que l'équipe ait attribué le gain de Mocassin surtout à l'autovectorisation de GCC 12 plutôt qu'au niveau d'ISA.
De nombreuses bibliothèques mathématiques et cryptographiques critiques pour la performance embarquent plusieurs versions de leurs fonctions chaudes et en sélectionnent une à l'exécution via la détection des fonctionnalités du CPU, une technique appelée multiversioning de fonctions et implémentée dans la glibc via les résolveurs IFUNC. Autrement dit, certains chemins chauds peuvent déjà utiliser AVX2 sur une installation Arch standard sans recompiler tout le paquet. Le billet de sunnyflunk l'a constaté directement, en notant que le code source de flac inclut déjà des fonctions AVX2 à sélection dynamique qui n'ont pas besoin de -march pour être activées. La découverte de CentOS est l'image inverse : l'équipe a repéré des fonctions mathématiques de la glibc sans version IFUNC, ce qui est précisément là où une reconstruction statique a une marge pour aider. Ce qu'une reconstruction v3 atteint, c'est le code restant que l'autovectoriseur du compilateur peut améliorer seul, soit une tranche d'un bureau, et une petite.
C'est la forme de la charge de travail, pas l'étiquette sur le CPU, qui décide si un changement au niveau machine apparaît. Le verdict sur le débit est oui, mais borné : les variations à un chiffre sont courantes dans les mesures ci-dessus, les gains plus importants se regroupent autour des charges vectorisables comme l'encodage et la compression, et certains paquets régressent. C'est une meilleure description que de traiter x86-64-v3 comme un multiplicateur de vitesse pour tout le système.
Ce que l'ordonnanceur change, et pourquoi le FPS moyen passe à côté
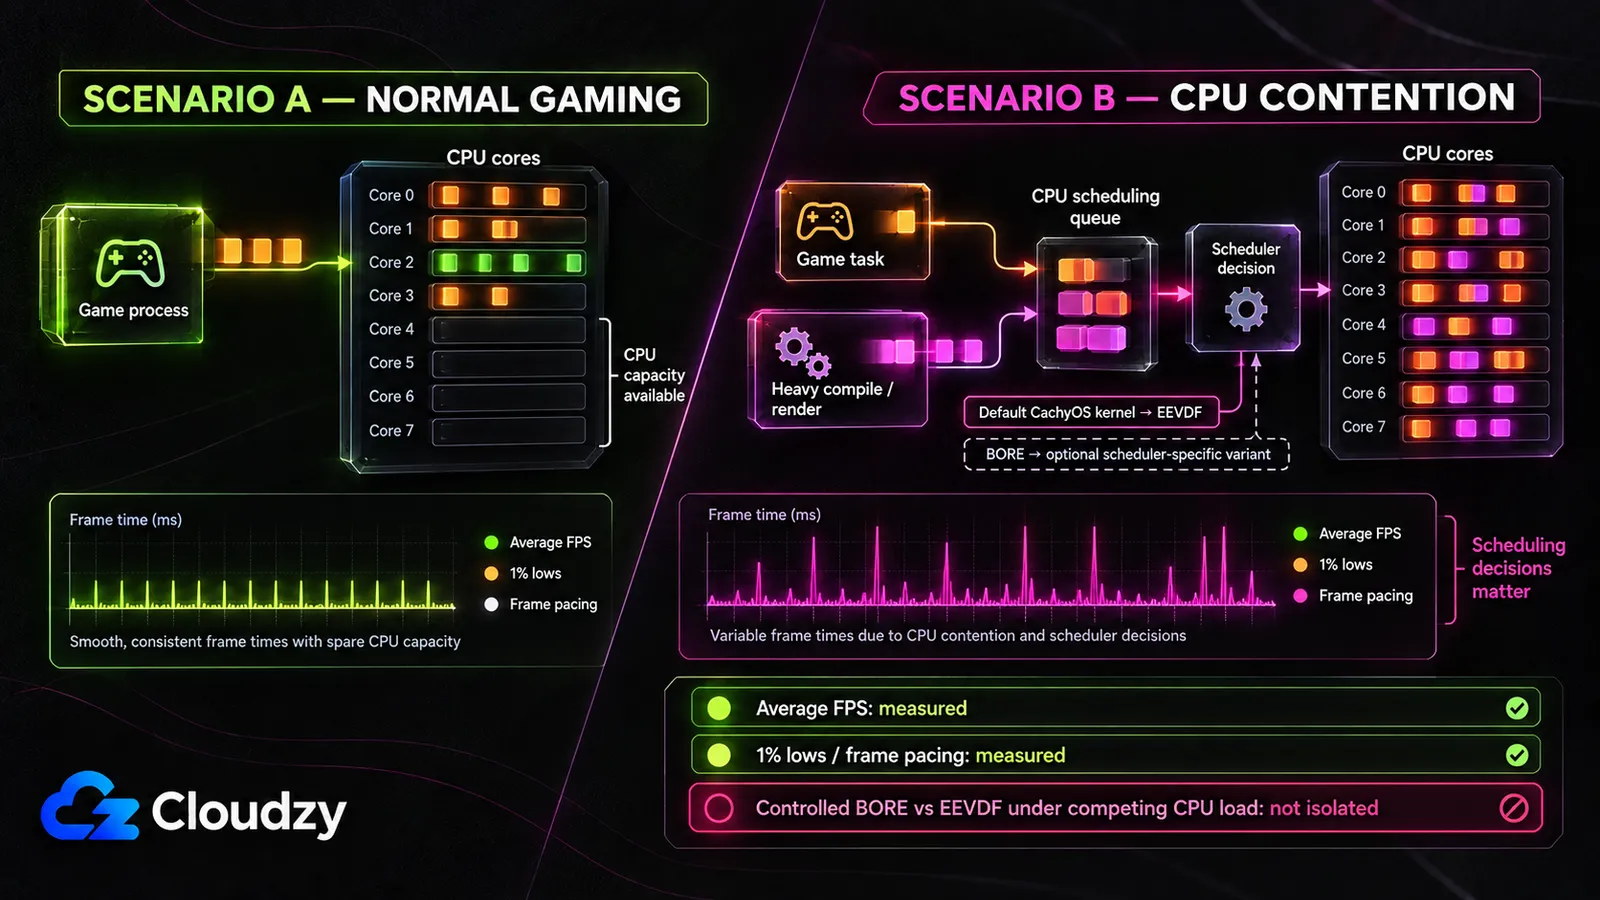
Le noyau par défaut actuel de CachyOS, linux-cachyos , utilise EEVDF, tandis que BORE est disponible via des variantes spécifiques à l'ordonnanceur comme linux-cachyos-bore. Cette distinction compte, car les comparaisons en jeu ci-dessous sont des tests au niveau de la distribution, pas des tests contrôlés BORE contre EEVDF. BORE reste pertinent pour l'affirmation de performance au sens large, parce que sa conception vise explicitement la réactivité sous charges mixtes, mais cette affirmation doit être évaluée séparément des performances en jeu de CachyOS en configuration d'origine.
Le README de BORE énonce clairement l'intention :
Pour y parvenir, BORE introduit une dimension de flexibilité appelée « burstiness » pour chaque tâche individuelle, en s'écartant partiellement du principe d'« équité complète » inhérent à CFS.
firelzrd/bore-scheduler, README du projet
La burstiness est le temps CPU qu'une tâche a accumulé depuis la dernière fois qu'elle a rendu le CPU en dormant, en attendant une E/S ou en cédant la main. BORE le convertit en score et s'en sert pour ajuster le poids de chaque tâche et l'agressivité de sa préemption au réveil, de sorte que les tâches qui cèdent souvent la main sont traitées comme interactives et favorisées face aux tâches qui monopolisent leur tranche. Le README nomme lui-même le compromis : BORE s'installe dans un « équilibre entre des tâches gourmandes et faibles (généralement des traitements par lots liés au CPU) et des tâches modestes et fortes (généralement des tâches interactives liées aux E/S) ». Augmenter le poids du travail interactif revient à diminuer celui du travail de débit par lots.
Cela indique quel instrument détecterait l'affirmation propre à BORE : introduire une charge CPU concurrente et mesurer les percentiles de temps d'image ou la latence d'entrée en ne changeant que l'ordonnanceur. Un ordonnanceur a beaucoup moins à arbitrer quand le jeu tourne avec de la capacité CPU inutilisée.
Un benchmark sur cinq jeux publié le 16 mai 2026 a utilisé des installations propres de CachyOS et d'Omarchy sur le même SSD et le même matériel, une RTX 5060 Ti et un Ryzen 9, avec le même build Proton-GE et des réglages 1440p. Le FPS moyen ne différait que d'une ou deux images. Deux jours plus tard, le même testeur a publié une seconde comparaison avec journalisation complète des images par MangoHUD, en ajoutant les 5 % les plus bas, les 1 % les plus bas et la variance de régularité des images. Ce second test utilisait un matériel différent, un Intel i7-13700 et une Radeon RX 9060 XT, il s'agit donc d'une preuve supplémentaire sur la régularité des images plutôt que d'une extension du premier test sur le même matériel. Aucune des deux comparaisons n'isole l'ordonnanceur CPU ni n'ajoute une charge CPU concurrente délibérée.
Le projet ne survend pas non plus. Dans un fil r/cachyos sur les performances en jeu, Peter Jung, l'un des développeurs fondateurs de CachyOS, a répondu directement à un utilisateur : « In gaming not all too much. The newer feature can make a difference tough :) » (en jeu, pas tant que ça ; la fonctionnalité plus récente peut quand même faire une différence).
Cela laisse deux conclusions distinctes. Pour le jeu sur CachyOS en configuration d'origine, les tests publiés montrent peu d'écart de FPS moyen et incluent désormais des mesures des 1 % les plus bas et de la régularité des images. Pour BORE en particulier sous contention CPU délibérée, je n'ai trouvé aucun test publié contrôlé qui ne change que l'ordonnanceur et mesure la réactivité sous cette charge.
Pourquoi une migration semble plus rapide même quand rien ne se mesure plus rapide
Deux mécanismes produisent une machine plus vive après un changement de distribution sans qu'aucune des optimisations de CachyOS n'entre en jeu : l'installation neuve elle-même, et la correction fortuite d'un problème sans rapport que l'ancien système avait. Les deux sont assez précis pour être reconnus dans votre propre cas, ce qui les distingue d'une accusation globale de placebo.
Commençons par l'installation neuve. Dans un fil r/linuxquestions sur la question, un utilisateur de CachyOS qui disait n'avoir lui-même remarqué aucune différence a suggéré que les personnes rapportant de gros gains comparent peut-être à une installation très usée plutôt qu'à une installation neuve. Des années d'entrées de démarrage automatique accumulées, de services orphelins, de configuration dérivée et un disque plein constituent une charge de travail, et une partition propre supprime tout cela d'un coup. Un changement de distribution déplace en même temps le noyau, l'environnement de bureau, chaque version de paquet et chaque réglage par défaut, et une comparaison complète Manjaro contre Ubuntu s'étend sur une douzaine d'axes distincts. Attribuer ensuite une amélioration à l'un d'eux relève de la devinette.
La correction fortuite est le cas le plus net. Dans le même fil, un commentateur a décrit une utilisation quotidienne de Fedora avec un problème de gestion de la VRAM qui dégradait sévèrement les performances, la migration vers CachyOS, et la disparition du problème. Il est ensuite passé à Arch nu et a rapporté à peu près les mêmes performances que CachyOS, concluant qu'il ne savait plus ce qui avait changé. L'amélioration était réelle ; les cibles de compilation de CachyOS n'y étaient pour rien.
Rien de tout cela n'autorise une réfutation nette, et la preuve la plus forte contre une telle réfutation est un test contrôlé. La comparaison de distributions sur Arrow Lake de Phoronix a placé Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux et CachyOS sur le même Intel Core Ultra 9 285K dans leur état par défaut, et CachyOS les a tous devancés, y compris Clear Linux, qui mène normalement sur le silicium Intel. Arrow Lake ne prend pas en charge AVX-512, donc cette avance ne peut pas venir de x86-64-v4 ; elle reflète une combinaison des choix de noyau et de compilation de CachyOS, des optimisations de paquets et de la configuration par défaut.
L'expérience peut être réelle alors que l'attribution reste incertaine. La comparaison Arrow Lake de Phoronix est un contre-exemple utile : une installation CachyOS en état par défaut peut surpasser Arch standard même quand x86-64-v4 n'est pas disponible.
Comment vérifier si tout cela s'applique à votre machine
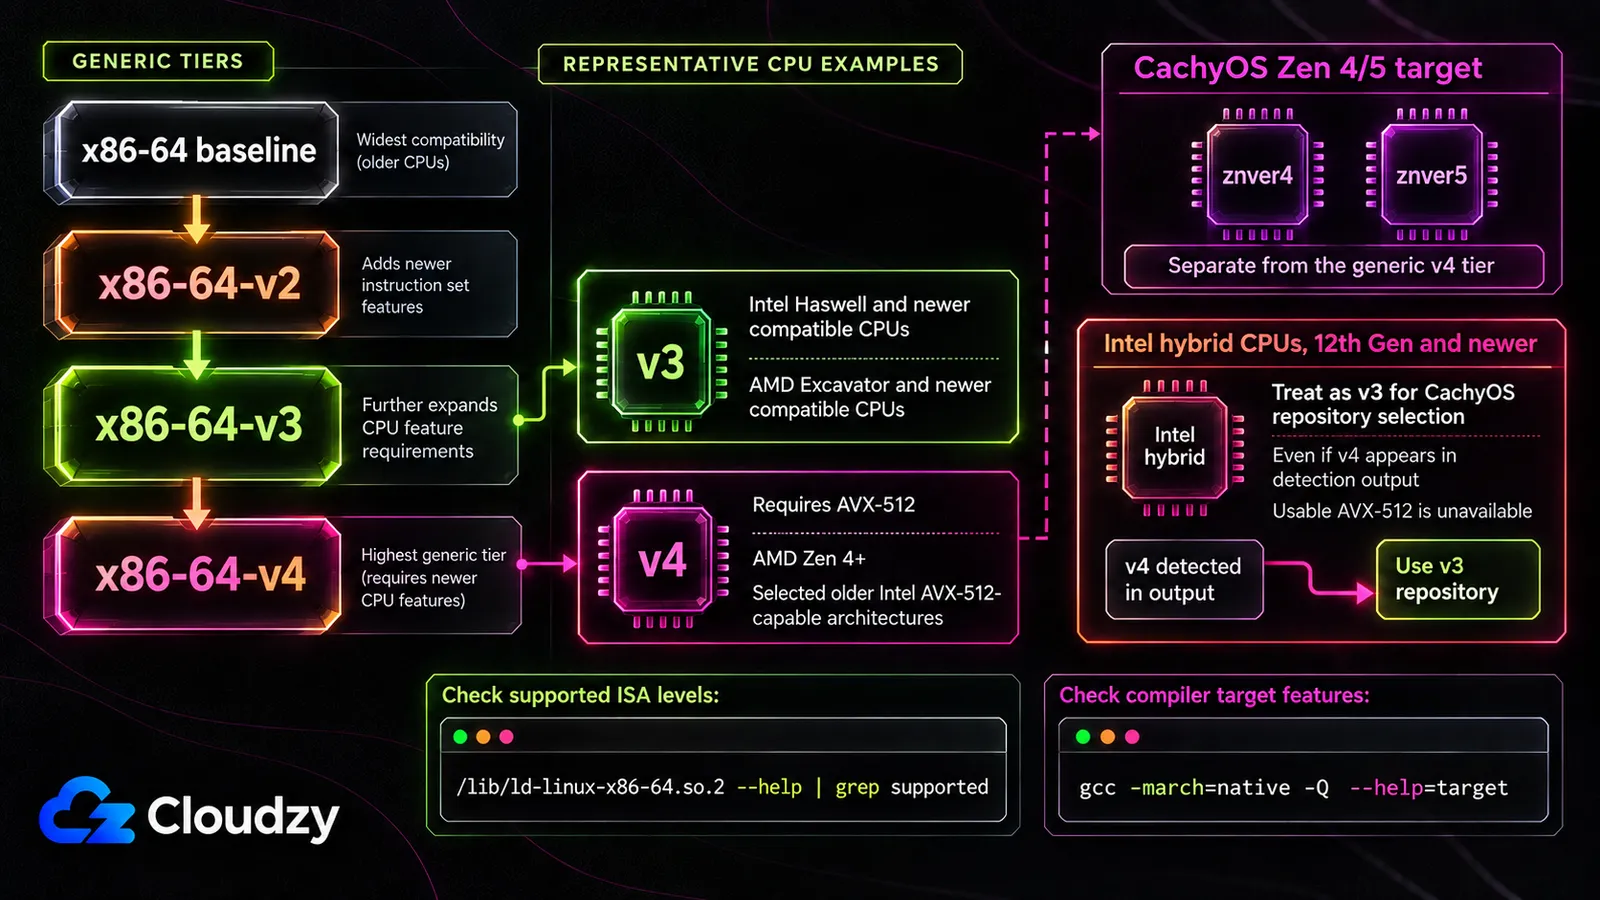
Savoir quel niveau standardisé de microarchitecture x86-64 votre CPU prend en charge se règle presque entièrement en une commande. L'éditeur de liens dynamique indique les niveaux glibc-hwcaps qu'il peut utiliser, donc l'entrée x86-64-vN la plus élevée prise en charge vous dit normalement si le CPU est éligible au palier de dépôt générique v2, v3 ou v4. Une exception importante concerne les CPU hybrides Intel de 12e génération et plus récents : CachyOS recommande de les traiter comme v3 même si v4 apparaît dans la sortie, parce qu'AVX-512 n'y est pas utilisable. La cible Zen 4/5 séparée de CachyOS demande aussi sa propre vérification d'architecture.
/lib/ld-linux-x86-64.so.2 --help | grep supportedPour AMD Zen 4/5, CachyOS documente aussi :
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"La première commande affiche quelque chose comme ceci :
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
C'est un CPU avec v3 et v2 mais sans AVX-512. Trois résultats, trois décisions :
- Rien au-dessus de x86-64-v2. L'avantage des reconstructions v3/v4/spécifiques Zen ne s'applique pas à ce CPU. CachyOS peut quand même tourner, et les optimisations de compilation propres à certains paquets ainsi que les changements de noyau et de configuration par défaut peuvent encore compter.
- x86-64-v3 pris en charge, x86-64-v4 indisponible. Cela inclut les CPU hybrides Intel modernes comme Arrow Lake pour le choix pratique du dépôt. Dans les comparaisons citées plus haut, beaucoup de variations étaient petites, certaines charges d'encodage et de compression ont gagné bien plus, et certains paquets ont régressé.
- x86-64-v4 pris en charge. AVX-512 crée davantage de marge théorique pour les charges vectorisables, mais ne garantit pas un gain important à l'échelle du système.
Si votre CPU est éligible et que la moitié « paquets » est ce que vous voulez, vous n'avez pas besoin de réinstaller pour l'obtenir. Les dépôts de CachyOS peuvent être ajoutés à un système Arch existant, et ALHP publie des reconstructions des dépôts officiels d'Arch à chaque niveau x86-64-vN, documentées sur le wiki Arch avec leurs propres réserves : des paquets DKMS sont requis à la place des modules noyau liés directement, et définir -march pour la compilation du noyau « n'apporterait aucun résultat significatif ». Les deux voies vous donnent les paquets recompilés et rien du jeu de correctifs du noyau ni des variantes d'ordonnanceur.
Lancez d'abord la commande. Elle transforme un débat sur les distributions en un fait sur votre propre machine, ce qui est la seule version de cette question que vous pouvez trancher vous-même ce soir.

Développez sur un VPS Linux avec accès root, NVMe et la puissance AMD EPYC.
Voir les plans LinuxFoire aux questions
CachyOS améliore-t-il vraiment les performances en jeu ?
Pour la fréquence d'images moyenne, à peine. Une comparaison sur cinq jeux de mai 2026 n'a trouvé qu'une différence d'une à deux images, et un suivi deux jours plus tard a aussi mesuré les 1 % les plus bas et la régularité des images. Aucun des deux tests n'a introduit de charge CPU concurrente délibérée, donc la question non résolue est la réactivité de l'ordonnanceur sous contention, pas la question de savoir si la régularité des images a été mesurée.
Mon CPU prend-il en charge x86-64-v3 ou v4 ?
Sur CachyOS ou Arch, lancez /lib/ld-linux-x86-64.so.2 --help | grep supported pour voir les niveaux glibc-hwcaps standardisés détectés pour votre CPU. x86-64-v3 exige le jeu de fonctionnalités de l'ère AVX/AVX2, tandis que v4 ajoute AVX-512. Pour les CPU hybrides Intel de 12e génération et plus récents, CachyOS recommande de traiter le système comme v3 même si v4 apparaît dans la sortie ; les utilisateurs de Zen 4/5 devraient aussi vérifier la cible znver4/znver5 séparée.
Pourquoi les paquets recompilés ne font-ils pas une plus grande différence ?
Parce qu'une partie du code fortement optimisé est déjà aiguillée à l'exécution vers des implémentations propres à chaque CPU. Les bibliothèques mathématiques et cryptographiques utilisent souvent le multiversioning de fonctions ou IFUNC pour leurs fonctions chaudes, donc recompiler les paquets aide surtout le code que le compilateur peut encore optimiser ou vectoriser globalement.
Puis-je obtenir les paquets optimisés de CachyOS sans changer de distribution ?
Oui. Les dépôts de CachyOS peuvent être ajoutés à une installation Arch Linux existante, et le projet ALHP publie des reconstructions des dépôts officiels d'Arch ciblant x86-64-v2, v3 et v4, documentées sur le wiki Arch. Les deux vous donnent uniquement les paquets recompilés, pas le jeu de correctifs du noyau CachyOS, les ordonnanceurs alternatifs ni les réglages par défaut de l'installateur.
Discussion
Commentaires
Connectez-vous pour participer à la discussion.