
同じディスク容量のデータベースでも必要なVPS構成は異なります。一方は少数の行を繰り返し読み、他方は書き込みを続け、大きなインデックスを作り、障害後の迅速な復旧を必要とします。VPS選びは事業者比較より先に、この違いから始めます。
非管理型VPSの購入にはデータベース運用の責任も伴います。PostgreSQL、MySQL、MariaDBではメモリ予算が異なり、復旧能力もプライマリと一緒に設計します。初期構成にはバックアップと保守の余裕を設け、代表的な負荷試験に合格させます。
プラン選定前にデータベース負荷を測る
CPU、メモリ、ディスクの選定前に、稼働データとインデックス、ピーク同時クエリ、成長、復旧要件を測定します。測った制約に応じて資源を追加します。共有ホストでは保守領域とアプリのピークも含め、繁忙時と通常運転を両立させます。
ワーキングセットは、メモリ保持の効果があるほど頻繁に使うデータとインデックスです。保存総量にはコールドデータも含みます。接続数と稼働クエリ数も別で、待機クライアントと同時ソートではCPU・メモリ要求が異なります。両方に加え、クエリ形状と読み書き比率を記録します。
代表的な繁忙時間から購入要件を作ります:
- VPSを共有する場合はアプリのメモリピークを測る。
- データ・インデックスサイズ、推定ワーキングセット、同時処理、計画期間内の成長を記録する。
- ログ生成量と、予想最大のインデックス構築、テーブル書き換え、その他保守処理を測る。
- アプリのp95遅延目標、許容データ損失時間、復元時間目標を定める。
- アプリの配置場所を決め、データベースまでの経路を試す。
PostgreSQLの監視ドキュメントは、データベース統計とOSツールの併用を勧めています。CPU、メモリ圧迫、ディスク活動をクエリ・コミット時間と合わせて記録します。無負荷で正常でも、バックアップ中の遅延増加は調査が必要です。
専用vCPUは割り当てCPUへの継続的アクセスを提供します。物理サーバー全体の占有でも、ストレージIOPSの保証でもありません。CPU割当、メモリ、ストレージ挙動を別々に評価します。実測要件がVPSの選択肢を超えたら、上位プラン名から推測せず専用ハードウェアを検討します。
SQL負荷に初期構成を合わせる
互換性に応じてPostgreSQL 16、InnoDBのMySQL 8.4、またはInnoDBのMariaDB 11.4を代替例とします。互換なエンジンではなく、最新バージョンという主張でもありません。試験前に導入済みパッチ版を記録します。例は事業者イメージの配備版を指定しません。
小規模アプリとデータベースを同居させる
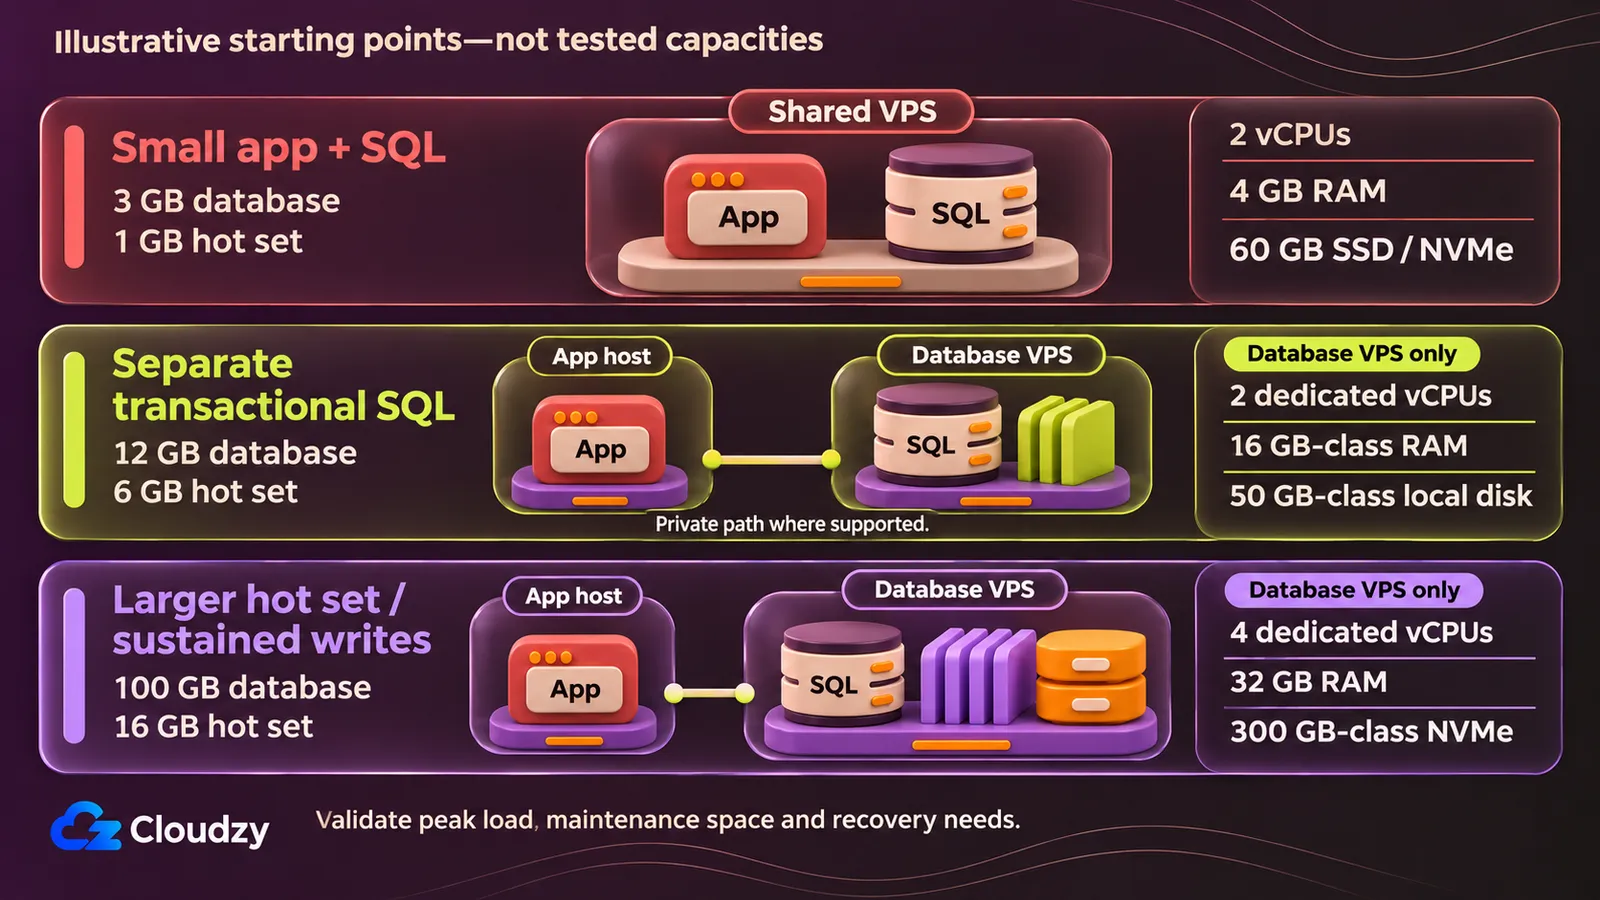
3 GBのデータ、1 GBのホットセット、5本の単純なインデックス付き稼働クエリを仮定し、2 vCPU、4 GB RAM、公称60 GB SSD/NVMeを試します。接続はローカルですが、両者の合計ピークを同じメモリ予算に収めます。
読み書き90/10、月1 GB成長、バックアップ中に長時間レポートなしと仮定します。変動を許容するステージングなら共有CPUでも構いません。継続的な競合で応答が悪化する場合は専用を選びます。後の本番プラン比較はすべて専用vCPUです。
RAM配分案です。数値の単位はすべてGB:
| 用途 | 想定RAM |
|---|---|
| OSと監視エージェント | 0.75 |
| アプリのピーク | 1 |
| データベースキャッシュ | 1 |
| ファイルシステムキャッシュ | 0.75 |
| クエリ・接続・保守の予備 | 0.5 |
| 合計 | 4 |
MySQL/MariaDBのInnoDBプールをこの枠内に収めます。専用データベース用の割合をホスト全体に適用するとアプリのメモリを消費します。PostgreSQLでは共有バッファと処理メモリをデータベース配分・予備内で別計算し、どちらの構成も合計ピーク測定後に採用します。
ディスク例はOS/ログ5 GB、データ/インデックス3 GB、エンジンログ4 GB、一時領域3 GB、成長6 GBで合計21 GBです。公称残量はファイルシステムの負担と一時作業に使い、プライマリでバックアップを保管する理由にはしません。
ローカルソケットかlocalhostで接続します。アプリ・バックアップ稼働中に、OSへ永続ストレージへの書き出しを求める同期(fsync)を含め、永続コミットを試します。責任者が24時間のRPO(許容損失時間)と4時間のRTO(復旧時間目標)を認めるなら、夜間のネイティブバックアップをノード外へ保存し、演習で復元時間を証明します。メモリ・遅延・復旧予算を超えたら、クエリ/インデックス診断後に分離、増強、設計変更します。
トランザクションSQLを分離する
別ホストのアプリ向けなら、12 GBデータ、6 GBホットセットの例を2専用vCPU、16 GB級RAM、50 GB級ローカルストレージで試せます。20本の稼働インデックスクエリ、短い書き込み、少ない継続計算を仮定し、大きな処理では予算が崩れます。
読み書き90/10、3か月間月1 GB成長を仮定します。事業者表の基準負荷です。容量単位が異なるため、配分前に実際の利用可能メモリとファイルシステムの利用可能バイトを比較します。
PostgreSQL VPSでは、PostgreSQL 16の共有バッファ指針は、RAM 1 GB以上の専用データベースでシステムメモリ25%から始めます。OSキャッシュも使います。16 GBの案は共有4 GB、OS/エージェント2 GB、クエリ/接続/保守予備2 GB、ファイルキャッシュと余裕8 GBです。
予備はwork_mem設定ではありません。PostgreSQLのクエリ処理メモリ文書は、複数セッションで各ソートとハッシュが別々にメモリを確保すると説明します。ハッシュはhash_mem_multiplierも使います。許可する同時処理から制限を決め、処理単位を大きくしすぎないこと。共有バッファが十分でもホスト予算を超えます。
MySQL VPSではOracleのMySQL 8.4バッファプール指針は、OSと他の割当を考慮して通常50–75%を勧めます。ここでは8 GB InnoDBを試し、残りを他用途とピークに残します。
MariaDBは計算が少し異なります。メモリ配分指針は主にInnoDBならOS/サービス後の利用可能RAMの60–70%から始めます。13 GBなら7.8–9.1 GBで、初期8 GBは適合します。MyISAMやAriaには別のキャッシュ計算が必要です。これらは代替予算で、足し合わせません。
ディスクはデータ/インデックス12 GB + 成長3 GB + OS 5 GB + ログ4 GB + 一時/保守8 GB = 32 GB。50 GB級ならファイルシステム負担前に公称約18 GB残ります。実測空き15 GB以上を条件とし、ログ保持や書き換えが増えたら再計算します。
アプリとデータベースを近接配置し、対応時は試験済み私設経路、認証、アクセス制御、暗号化を使います。チェックポイント、フラッシュ、バックアップ中のクエリと永続コミット遅延を確認します。独立バックアップ領域は下の復旧例で詳述します。診断後も資源飽和、空き不足、復旧未達なら増強します。
大きなワーキングセットや継続書き込みを計画する
100 GBデータと16 GBホットセットを仮定し、4専用vCPU、32 GB RAM、300 GB級NVMe、別アプリを試します。30本の混合稼働クエリ、読み書き60/40を想定し、増強前に実行とストレージ圧迫を測ります。
3か月間月10 GB成長と仮定します。PostgreSQLは共有8 GB、OS/クエリ/保守4 GB、ファイルキャッシュと余裕20 GB。MySQL/MariaDBは他用途を確保後、約16 GB InnoDBが代替初期値です。PostgreSQLの設定はそのまま移植できません。
ストレージには進行中の仕事も含めます。データ/インデックス100 GB + 成長30 GB + 保持/待機ログ30 GB + 最大保守/一時処理60 GB + OS 10 GB = 230 GB。公称約70 GB残ります。日々の成長が小さくても大きな表書き換えは再計算が必要です。
PostgreSQLの定期vacuum文書は、不要行の領域を再利用可能にするVACUUMと、新しい表コピーを作り一時的に追加領域が必要なVACUUM FULLを区別します。データより少し大きいだけのディスクでは空間回収の保守ができません。
CPU実行、キャッシュ圧迫、物理I/Oを書き込み遅延と別に測ります。一時書き込み、チェックポイント/フラッシュも試験に含めます。NVMeと専用CPUは構成であり、IOPS保証ではありません。近接した私設アプリ経路と独立復旧領域で継続バックアップ/複製転送も試します。ログ増加は保持容量と帯域を変えます。上位プランが全部増やすからではなく、観測した制約に応じてコア、RAM、ディスクを増やします。
本番環境に復旧能力を追加する
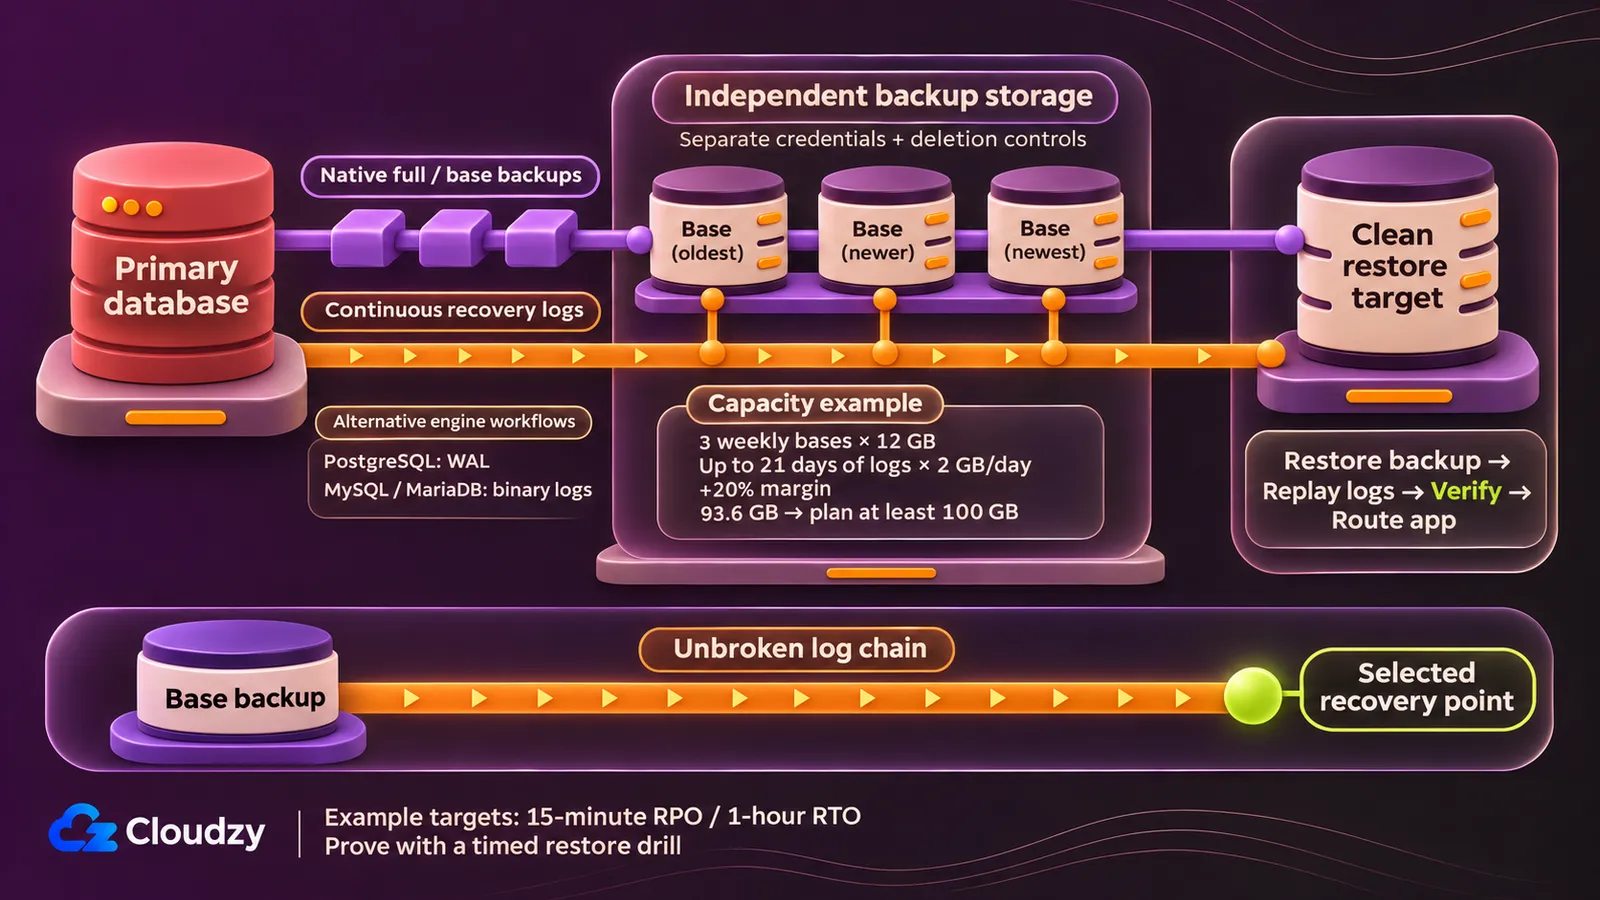
許容損失15分、復元目標1時間にはプライマリ予算以上の設計が必要です。分離SQLの仮定を保ち、ネイティブバックアップ、保持ログ、独立領域、計時復旧演習を追加します。これは計画目標で、達成を証明するのは演習だけです。
PostgreSQLの継続アーカイブ文書は、基本バックアップと途切れないWALで時点復旧を行います。OracleのMySQL復旧文書は完全バックアップ後にバイナリログを使います。MariaDBのPITR手順は完全/増分データ復元後にバイナリログを再生します。これらのMySQL/MariaDB手順にはバイナリログの有効化が必要です。
容量例として非圧縮の完全/基本バックアップ各12 GBを仮定します。週次3世代と最古の開始以降の連続ログを保持します。最大21日、日2 GB、20%余裕で計算します:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
圧縮を前提にせず独立バックアップ100 GB以上を計画します。ログ削除はバックアップ期限と正常な置換に連動させます。約束する各復旧点まで基本コピーとログの鎖が完全か確認します。
独立した保存先へのバックアップを使い、資格情報と削除権限もプライマリから分離します。事業者スナップショットだけではこのネイティブ復旧チェーンを証明できません。演習ではクリーンな復旧先を用意し、転送/復元、ログ再生、DB/アプリ整合性確認、経路切り替えまで行います。準備と転送時間も含めます。
停止時間短縮には独立配置され全負荷を処理できるレプリカが必要な場合があります。CPU、RAM、ディスクを別計算し、昇格、旧プライマリ隔離、クライアント経路を定めて演習します。複製はバックアップの代わりではなく、1台のVPSは高可用性ではありません。復元1時間超、アーカイブ遅れがRPO超、待機系の能力不足、保存領域逼迫なら再設計します。
管理型VPSを選ぶべきとき
アラート対応や障害復旧ができる人がいなければ、明確な運用範囲を購入します。管理型VPSは一部保守を移せますが、契約にDB作業を明記させます。管理画面は範囲を証明せず、管理型VPSと管理型DBは別です。
管理型・非管理型VPSの責任の違いは作業単位で役立ちます。以下は購入チェックで、全サービスの同一範囲を保証しません。物理インフラは事業者担当ですが、ゲストソフトとDB運用には明示的な担当者が必要です。
| 作業 | 非管理型VPS | 管理購入前に明確にする範囲 |
|---|---|---|
| ゲストOSとDBのパッチ/更新 | 自分で予定し実施 | 対応バージョン、パッチ範囲、更新試験、保守時間帯 |
| クエリ、スキーマ、インデックス調整 | 自分で診断し変更 | 調整を含むか、サービス設定のみか、別料金か |
| 監視と障害対応 | 自分でアラート設定し対応 | 監視時間、対応/エスカレーション担当、アラート後の実行者 |
| バックアップと復元 | 復旧手順は自分の責任 | 保持、独立領域、復元支援、復元試験の証拠 |
契約で有効な質問は「バックアップ中にディスクが満杯になったら、誰が診断し、サービスを戻し、次のバックアップ成功を確認するのか」です。サポート窓口と結果責任を区別できます。更新失敗や誤削除でも尋ねます。
管理型DBにはエンジン寿命、バックアップ、フェイルオーバーの独自契約があります。復旧と更新を移したいなら適します。名称からアプリ調整まで推測せず、別契約でなければクエリ設計とアプリ挙動にも担当者を置きます。
各作業を一度だけ割り当て、エスカレーションと受入確認を決めます。料金を自分の時間と対応可能性に照らします。自己管理の普遍的な時給はなく、安い計算費では担当不在の障害を解決できません。
SQL以外の負荷にVPSを選ぶ
メモリ、文書、検索索引の負荷を分けた例です。アプリを近接配置し、接続とバックアップ/使用するレプリカへの転送も試します。
| 負荷と仮定 | 試す初期構成 | ストレージ、復旧、変更条件 |
|---|---|---|
| Redisキャッシュ/キー値:実測2 GBデータ | 2専用vCPU、8 GB RAM:maxmemoryをホストRAM以下にし負担分を確保 |
再構築キャッシュは損失を許容できます。永続プライマリは意図したRDB/AOF、書き換え領域、独立バックアップが必要です。RAM/RSS、断片化、追い出し、永続化ピーク、テール遅延を測ります。 |
| MongoDB:20 GB文書/索引と小さな実測ホットセット | 2–4専用vCPU、16 GB RAM、100 GB級ローカルディスク | journal/oplog、成長、一時領域を計上します。復元時間、キャッシュ追い出し、I/O、複製遅れを確認し、各レプリカを役割ごとにCPU/RAM/ディスク計算します。 |
| Elasticsearch:小規模な30 GB索引 | 対象データノードごとに4専用vCPU、16 GB RAM、150 GB級ローカルディスク | レプリカ、セグメント統合、保持、独立スナップショットを計上します。heap/GC、検索/索引遅延、統合I/O、ディスクを確認します。耐障害性には適切な投票構成とクライアント経路も必要です。 |
Redisの管理指針は、書き込みが多いRDB保存/AOF再書き込みでは変更ページに応じて通常の2倍のRAMを使う場合があると警告します。2 GBのデータで全RAMを使えません。永続化文書は定期RDBとAOFログを区別します。許容損失から選び、稼働中のRAM/ディスクピークを測ります。
MongoDBのWiredTigerキャッシュ文書は内部とファイルシステムのキャッシュを説明します。既定内部値は50% × (RAM − 1 GB)と0.256 GBの大きい方です。レプリカセット指針はデータを持つ3メンバーを推奨します。仲裁役は投票しますがデータを持ちません。独立バックアップを確保し、接続前にMongoDB認証を実装します。
ElasticのJVM設定文書は自動heapを勧めます。手動なら最小/最大を同一にし、利用可能RAMの50%以下にします。小規模クラスタ耐障害指針はデータ保持・master適格ノード2台と投票専用の決定票ノードを説明します。レプリカを設定し、クライアントはデータノードへ。決定票は票を増やし、データコピーは増やしません。統合や保持で余裕が尽きたら、追加文書より先にディスクを見直します。
必要構成に合う非管理型プランを比較する
分離トランザクションSQL例では2専用vCPU、16 GB級RAM、50 GB級ローカル以上で絞ります。条件達成は試験候補になるだけです。CPU/ディスク構成、単位、支払条件が違うため同一ハードウェアや速度順位とはみなせません。
基準はドイツまたは近い中央ヨーロッパの自己管理Linuxで、小データと大きめのRAMです。近接は同一遅延を意味しません。対応時は私設接続を使い、見積もりには標準公開IPv4を残します。転送は全記載枠以下を仮定します。
| 事業者と非管理型プラン | 専用vCPU / RAM / ローカルディスク | 拠点と転送枠 | 料金、課金、IPv4 |
|---|---|---|---|
| Cloudzy:当社のRegular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | 世界の複数地域に拠点:10 TB | 49.98米ドル/月:IPv4とIPv6込み |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1:EUで最低20 TB | 月上限86.49ユーロ、主要IPv4の0.50ユーロ込み、VAT別 |
| DigitalOcean Memory-OptimizedバンドルDroplet、Regular CPU、1× SSD | 2 / 16 GiB / 50 GiB NVMe | FRA1に対応ファミリー:4,000 GiB | 月上限84米ドル:0.125米ドル/時:公開IPv4込み |
| Vultr Optimized Cloud Compute、Memory Optimized、AMD 2コア/16 GB/100 GB | 2 / 16,384 MB / 100 GB NVMe | フランクフルト(fra):6,144 GB |
80米ドル/月:0.11米ドル/時:既定IPv4。別料金やIPv4なし割引は予算前に確認 |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16,384 MB / SSD 327,680 MB(320 GB級プラン) | フランクフルト(de-fra-2)は利用可能と記載:6,000 GB |
173米ドル/月:0.2595米ドル/時:標準公開IPv4追加料金なし |
DigitalOceanの選択文書はSQL/NoSQLとキャッシュにMemory-Optimizedを挙げます。小ディスク・高RAMのこの例には当該バンドルを勧めます。メモリ最適化はSQL専用ではありません。容量や持続的ストレージ要求が制約ならStorage-Optimizedを別評価します。
5社とも下限を満たし、追加CPU/ディスク量が異なります。余裕は成長を支えても、試験なしで速度優位を証明しません。Hetznerの一覧は注文在庫保証ではありません。AkamaiはG7 DedicatedをSSDと説明します。Vultr Optimized Memoryは共有High Frequency Computeと別種です。
当社の専用割当は表示価格で自己管理構成に適します。総価値を判断する前に資源、通貨、課金契約、IPv4費用を比較します。
所有費は計算 + アドレス + 独立バックアップ領域/要求/転送 + 復元試験容量 + 任意待機系です。不明料金はゼロではありません。比較前に現行復旧料金を入手し、契約前に正確なプラン、拠点、更新経路を確認します。丸めた月額相当を掛けて年額請求を推測しません。
互換SQLエンジン決定後は当社のワンクリックアプリが導入を短縮します。PostgreSQL、MySQL、MariaDBは個別選択で、1つ選んでも3つ全部は入りません。更新、調整、復旧は引き続き自己管理です。
よくあるご質問
PostgreSQLのキャッシュ命中率で遅いストレージを判別できますか?
いいえ。PostgreSQLのI/O統計文書では、OSキャッシュがディスクなしで読み取りを満たせると説明します。命中率とOS I/O、クエリ時間を合わせます。比率だけでは物理遅延とカーネルメモリからの読み取りを区別できません。
論理PostgreSQLダンプをWALによる時点復旧に使えますか?
いいえ。PostgreSQLの継続アーカイブ要件は、論理ダンプにWAL再生情報がないと説明します。ダンプは取得時状態を復元し、WAL時点復旧には適切な基本コピーと連続WALが必要です。復旧方式に合う形式を選びます。
コンテナ内MongoDBのキャッシュはホスト全RAMを使うべきですか?
コンテナで使えるRAMを用います。MongoDBのコンテナメモリ指針は、WiredTigerが低い制限を認識しない場合を警告します。他プロセス分を残し、キャッシュを制限以下にします。ホスト総RAMはDB利用可能量を過大評価し得ます。
ディスカッション
コメント
ログインしてディスカッションに参加してください。