
r/linuxquestionsのある投稿者が、誰もが議論し続けている比較を実際にやってみました。CachyOSをインストールし、Ryzen 7 7800X3DとRadeon RX 7900 XTXでいくつかのゲームをベンチマークしたところ、同じマシンにすでに入っていた他のディストリビューションとの差はまったく測定できませんでした。返信はいつもの流れをたどりました。ある人は上限を通常利用では見えないほど低く見積もりました。別の人はスケジューラを解説しました。三人目はベンチマークではスケジューラの働きは示せないと述べました。決着をつける測定結果を出した人は誰もいませんでした。
この問いは同じ言葉で何度も戻ってきます。CachyOSは本当に速いのか? 短い答えは「特定のワークロードでは、はい」です。再コンパイルされたパッケージはコンパイラがベクトル化できるコードを助け、ここで引用するゲーム比較では平均FPSの差はほとんどなく、乗り換え後に速く感じるシステムは、ディストリビューションの変更が1つの変数よりはるかに多くのものを変えるため、原因の特定が難しくなります。
決着がつかないのは、「速い」という言葉に3つの別々の主張が含まれ、それぞれ答えが異なり、それぞれに固有の測定手段が必要だからです。再コンパイルされたパッケージは、タスクをより短い実時間で終えるか、終えないかのどちらかです。スケジューラは、競合下でデスクトップの振る舞いを変えるか、変えないかのどちらかです。そして、きびきび動くようになったマシンの原因は、CachyOSにあるか、一緒に入ってきた何かにあるかのどちらかです。
短いバージョン
- 再コンパイルされたパッケージ:測定可能なほど速い。ただし実行するものの少数だけ。 向上はコンパイラがベクトル化できるコードに集中し、いくつかのパッケージはむしろ遅くなり、大半は変化しません。sunnyflunk.github.ioの2023年1月のarch-chroot比較では、Intel NUC8i5BEK上で、同じ実行内でflacエンコードが20.2%速く、bzip2の展開が7.1%遅くなりました。
- スケジューラの話は2つに分かれます。 CachyOSの現在のデフォルトカーネルはEEVDFを使い、BOREは別途提供されます。2026年5月のディストリビューション比較では平均FPSの差はほとんどなく、1% lowとフレームペーシングも測定されましたが、BOREを分離したり、制御された競合CPU負荷を加えたりはしていません。素の状態でのゲーミングは測定済みですが、競合下でのBOREの利点は分離検証されていません。
- マシンが速くなったという感覚:体験は本物、原因の帰属は当てにならない。 クリーンインストールも、無関係なバグの偶然の解消も、どちらも命令セットレベルとは何の関係もなく、きびきび動くシステムを生みます。知っておく価値のある例外は、Intel Core Ultra 9 285KでのPhoronixの素の状態での比較で、AVX-512最適化をまったく使えないCPU上でCachyOSが素のArchを上回りました。
CachyOSがシステムに実際に加える変更
CachyOSは、Arch Linuxの上に3つの独立した変更を重ねたものです。代替スケジューラを備えたパッチ済みカーネル、より新しいCPU命令セットレベル向けにパッケージを再コンパイルしたリポジトリ、そしてコアパッケージの一部に対する追加のコンパイラ最適化です。それぞれが別個の効果を持つ別個の仕組みであり、別々に測定されることはほとんどありません。
カーネル側が最も大きな領域です。 CachyOSのカーネル機能一覧 には、Clang ThinLTO、AutoFDOプロファイリング、実行時に選択できるプリエンプションモード、複数のスケジューラオプションが含まれます。現在の linux-cachyos パッケージは、CachyOSがチューニングしたEEVDFをデフォルトスケジューラとして使います。BOREとBMQは別のカーネル派生版で提供され、 linux-cachyos-eevdf はEEVDFの応答性チューニングを追加で適用し、 linux-cachyos-server は素のEEVDFを使います。sched-extは対応する派生版で引き続き利用できます。
パッケージ側では、CachyOSのx86-64-v3リポジトリが論点となる仕組みです。 CachyOSの最適化リポジトリのページ は、汎用ベースラインより上の3つのターゲット向けにArchパッケージを再ビルドすると説明しています。x86-64-v3、x86-64-v4、そしてv4の上にさらなるAVX-512拡張とAVX-512以外のいくつかの命令を加えた専用のZen 4/5ターゲットです。パフォーマンスに敏感なパッケージの一部には、プロファイルガイド最適化とBOLTも適用されます。
これらのレベル名は x86-64 psABIのマイクロアーキテクチャレベル仕様に由来し、ダイヤルではなく関門です。x86-64-v3は2013年のIntel HaswellとAMDのExcavatorコアで登場したAVX・AVX2世代の命令を要求し、x86-64-v4はAVX-512を要求します。これは実質的にSkylake-XクラスのIntel製品と、AMD Zen 4以降のすべてを意味します。CPUは基準を超えるか超えないかのどちらかです。
「速い」という言葉の中に隠れた3つの主張
CachyOSが速いかどうかで2人の意見が食い違うとき、たいてい両者は別のことについて正しいのです。スループット、フレームの一貫性、体感の応答性は別々の性質であり、単一の指標で3つすべてを決着させることはできません。時間を計ったタスクはスループットを測り、フレームタイムとレイテンシの測定はゲームの滑らかさをカバーし、より広いシステムレベルの効果には制御されたクリーンインストール比較が必要です。
| 主張 | 何が主張されているか | どう測定するか | 証拠が示すもの | 確度 |
|---|---|---|---|---|
| 測定されたスループット | 再コンパイルされたパッケージが同じタスクをより短い時間で終える | 固定のハードウェアと固定のカーネルで1つのタスクの時間を計り、パッケージの取得元リポジトリだけを変える | ベクトル化可能な処理では確かな向上、いくつかのパッケージでは小さな退行、大半は変化なし | 高い。Canonical、CentOS ISA SIG、独立したベンチマーカー2名が全体像で一致 |
| 入力レイテンシとフレームの一貫性 | 他の処理がCPUを飽和させている間もデスクトップが応答し続ける | 平均フレームレートではなく、競合負荷下でのフレームタイムのパーセンタイルと入力レイテンシ | 公開されたテストには1% lowとフレームペーシングが含まれるようになったが、スケジューラの分離も制御された競合CPU負荷の導入もしていない | 低い。仕組みは文書化されているが、測定が欠けている |
| 体感の応答性 | 乗り換え後にマシンがきびきび感じられる | 使い古した環境ではなく、前のディストリビューションのクリーンインストールと比べる | 通常はクリーンインストール効果か偶然の修正で説明がつく。素の状態での比較1件がディストリビューションレベルの優位を確認 | 中程度。体験は正当だが、原因の帰属は当てにならない |
1行目に答えるベンチマークスイートは2行目には答えられず、どちらも3行目には触れません。3つのうち1つを実行し、その結果を3つすべてへの判決として報告することが、この議論を長引かせています。
再コンパイルされたパッケージは本当に速く動くのか?
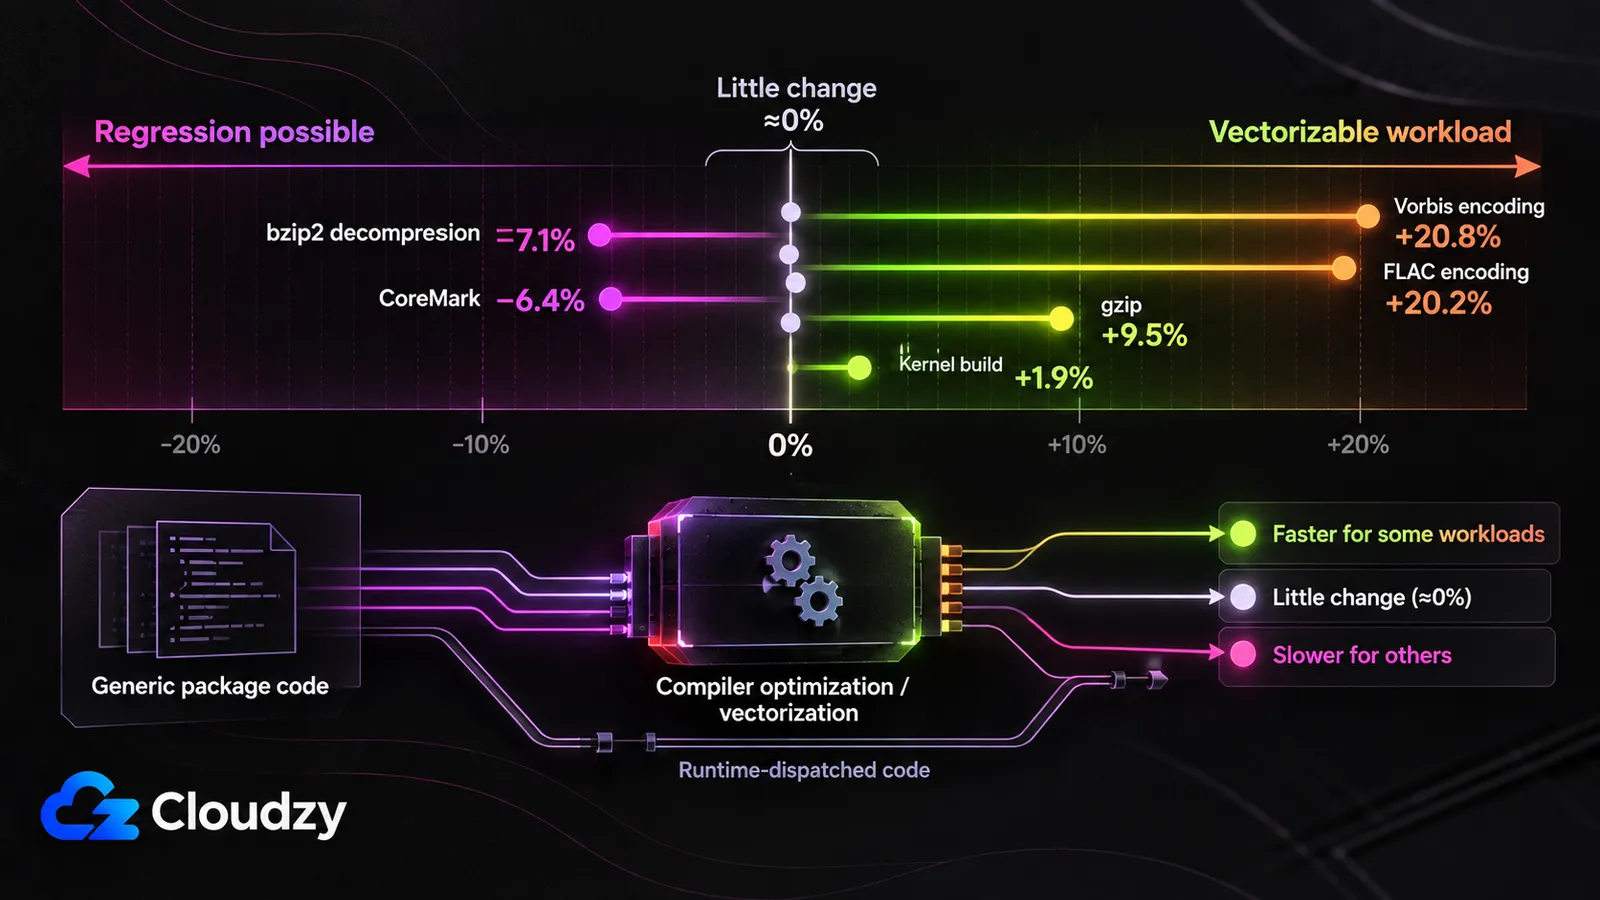
はい。ただしデスクトップが実行するものの少数に限られ、その大きさはディストリビューションではなくワークロードが決めます。ベクトル化可能な処理は2桁の向上を見せ、少数のパッケージは遅くなり、大半は何も示しません。CachyOSの最適化リポジトリのページは、x86-64-v3の向上幅を汎用x86-64比で5%から20%としていますが、公開された測定値の多くはその下限付近にあります。
最もクリーンなCachyOS対Archのパフォーマンス比較は、パッケージという変数だけを分離し、他は何も変えていません。 2023年1月のarch-chrootテスト がsunnyflunk.github.ioにあります。ホストはIntel NUC8i5BEK上で素のArchを実行し、カーネルと環境が同一のままになるよう両方のパッケージセットをarch-chroot内でテストし、ディスクのレイテンシを除くためベンチマークはRAM上で実行しました。素のArchパッケージと比べ、CachyOSビルドは -8でのflacエンコードが20.2%、vorbisエンコードが20.8%、gzip -3が9.5%速くなりました。同じ実行では、bzip2の展開が7.1%、lz4での圧縮が1.6%から2.9%、pybenchが3%遅く、Rベンチマークは変化なしでした。2つの但し書きは著者自身によるものです。CachyOSはArchの -march=x86-64-v3 -mpclmul -O3 に対して -march=x86-64 -O2でビルドしており、著者の追加テストは、大きな向上の一部が命令セットレベルではなく -O3 によるものだと示唆しました。この記事は2024年7月リリースで登場したCachyOSのZen 4リポジトリより前のものですが、BOLTの取り組みより前ではありません。著者は、pybench退行の原因となったCachyOSのPythonパッケージがx86-64-v3の上にすでにBOLTを適用していたと読んでいます。
より新しいハードウェアでのCachyOSベンチマークも同じパターンを繰り返します。 mvermeulen.orgの2024年7月の比較 は、Zen 4のRyzen 7940HS上でPhoronix Test Suiteの一部を実行し、Zen 4リポジトリを使うCachyOSをUbuntu 22.04と比べました。ほとんどの結果はどちらの方向にも数パーセント以内に収まりました。coremarkは6.4%遅く、OpenSSLのサブテストは約1%遅いものから4%速いものまで、カーネルビルド時間は1.9%速く、phpbenchはスコアが2倍を少し超える外れ値でした。著者は、Ubuntuの11.4に対する14.1というGCCのバージョン差を交絡要因の可能性として指摘しています。同氏の 2024年3月の別のNAMD実行 では、2つの分子動力学ワークロードで6.5%と5.8%の改善が見られました。
組織による検証も、両端で同じ混在した様相を確認しました。 Canonical自身によるx86-64-v3ベンチマークは、2024年3月にAzure上の実験的なUbuntu 23.10イメージで公開され、glibc Log2ベンチマークで最大60%の再現可能な向上を報告する一方、他のベンチマークは大きく退行しました。あるケースでは、最適化済みのSSEコードでv3を有効にしたためにコンパイラが命令を17倍に展開したことが原因でした。 CentOS ISA SIGによるCentOS Stream 9の再ビルド は、2023年8月にIce LakeクラスのIntelマシンでv2からv3へ行われ、結果を「かなり混在している」と評しました。2.2倍の高速化はMocassinとJohn the Ripperのmd5cryptに集中し、どちらもベクトル化の比重が大きいものでしたが、チームはMocassinの向上を主にISAレベルではなくGCC 12の自動ベクトル化によるものとしています。
パフォーマンスが重要な数学・暗号ライブラリの多くは、ホット関数を複数のバージョンで同梱し、CPU機能検出によって実行時に1つを選びます。この手法は関数マルチバージョニングと呼ばれ、glibcではIFUNCリゾルバで実装されています。つまり一部のホットパスは、パッケージ全体を再ビルドしなくても素のArchインストールですでにAVX2を使えます。sunnyflunkの記事はこれを直接確認し、flacのソースには有効化に -march を必要としないAVX2ランタイム関数がすでに含まれていると指摘しました。CentOSの発見はその鏡像です。チームは IFUNCバージョンを持たないglibcの数学関数を発見しましたが、まさにそこが静的な再ビルドの助けになる余地のある場所です。v3再ビルドが届くのは、コンパイラの自動ベクトル化器が自力で改善できる残りのコードであり、それはデスクトップのごく一部、しかも小さな一部です。
マシンレベルの変更が現れるかどうかを決めるのは、CPUのラベルではなくワークロードの形です。スループットについての判定は「はい」ですが、限定つきです。上記の測定では1桁の変化が一般的で、より大きな向上はエンコードや圧縮のようなベクトル化可能なワークロードに集中し、一部のパッケージは退行します。これはx86-64-v3をシステム全体の速度乗数として扱うより適切な説明です。
スケジューラが変えるもの、そして平均FPSがそれを見逃す理由
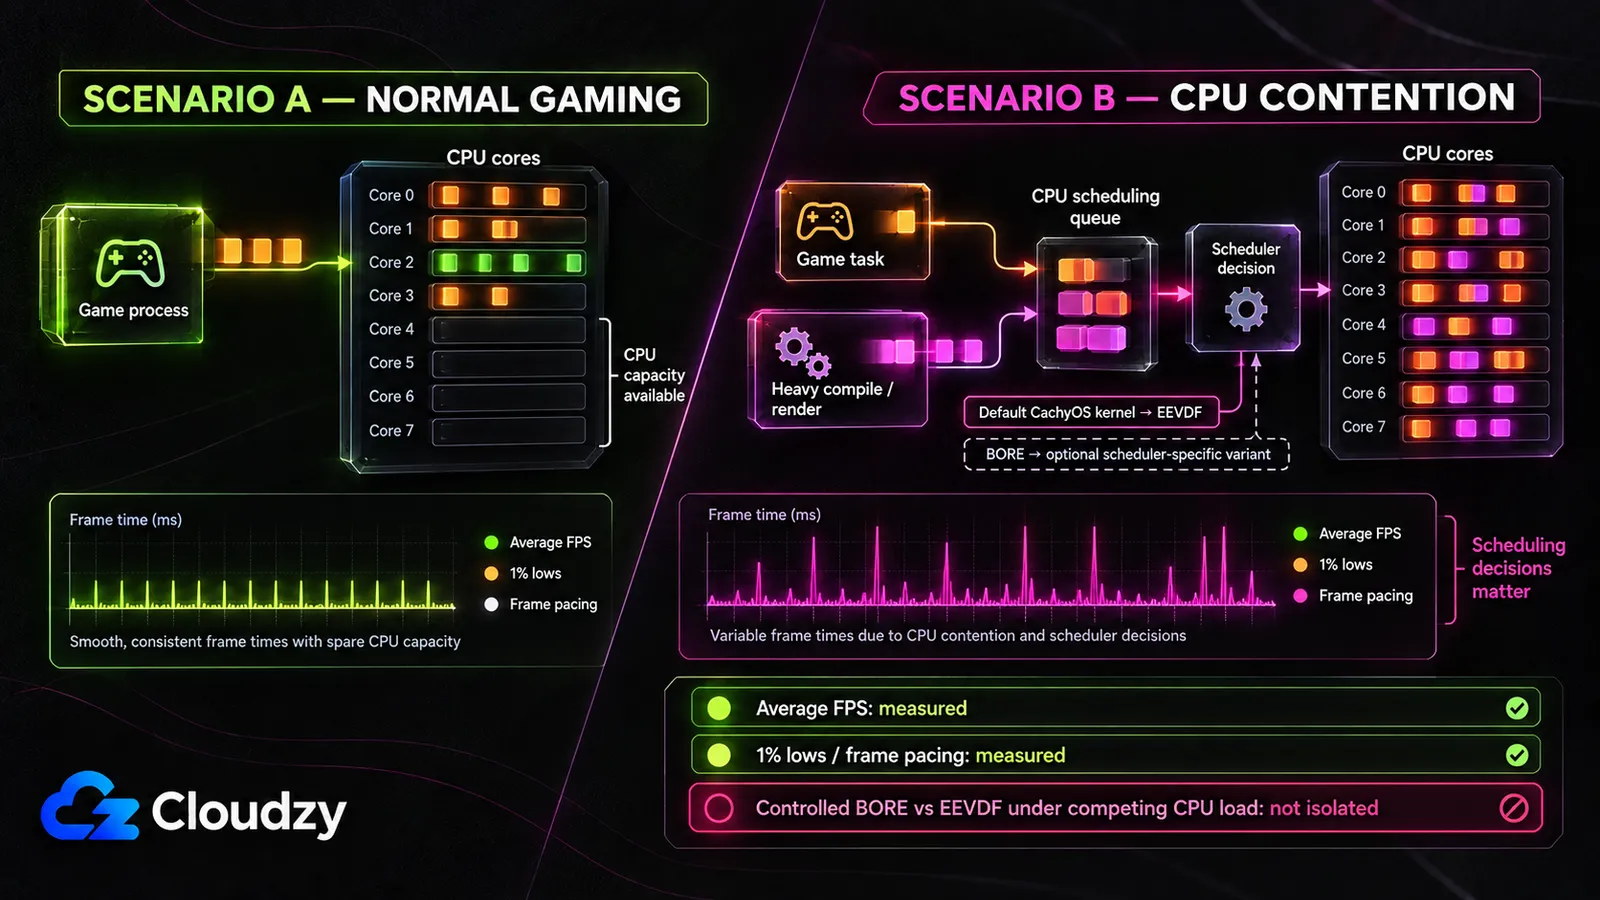
CachyOSの現在のデフォルトである linux-cachyos カーネルはEEVDFを使い、BOREは linux-cachyos-boreのようなスケジューラ別の派生版で提供されます。この区別が重要なのは、以下のゲーム比較が制御されたBORE対EEVDFテストではなく、ディストリビューションレベルのテストだからです。BOREの設計は混在ワークロード下での応答性を明示的に狙っているため、より広いパフォーマンス主張との関連は残りますが、その主張は素の状態のCachyOSのゲーム性能とは切り離して評価する必要があります。
BORE自身のREADME は意図を率直に述べています。
これを実現するため、BOREは個々のタスクに「バースト性」と呼ばれる柔軟性の次元を導入し、CFSに固有の「完全な公平性」の原則から部分的に離れる。
firelzrd/bore-scheduler、プロジェクトのREADME
バースト性とは、タスクがスリープ、I/O待ち、または譲渡によって最後にCPUを手放してから蓄積したCPU時間です。BOREはそれをスコアに変換し、各タスクの重みと起床時のプリエンプションの積極性を調整するのに使います。その結果、頻繁に譲渡するタスクは対話的とみなされ、割り当て時間を使い切るタスクより優遇されます。READMEはトレードオフを自ら名指ししています。BOREは「対立する貪欲で弱いタスク(通常はCPUバウンドのバッチタスク)と、控えめで強いタスク(通常はI/Oバウンドの対話的タスク)の間の均衡」に落ち着きます。対話的な処理の重みを上げることは、バッチのスループット処理の重みを下げることと同じ操作です。
これで、BORE固有の主張を検出できる手段が分かります。競合CPU負荷を導入し、スケジューラだけを変えてフレームタイムのパーセンタイルや入力レイテンシを測ることです。ゲームが空きCPU容量を残して動いているとき、スケジューラが裁定すべきことははるかに少なくなります。
5本のゲームのベンチマーク は2026年5月16日に公開され、同じSSDとハードウェア(RTX 5060 TiとRyzen 9)にCachyOSとOmarchyをクリーンインストールし、同じProton-GEビルドと1440p設定を使いました。平均FPSの差はわずか1〜2フレームでした。2日後、同じテスターが MangoHUDによる完全なフレームログつきの2回目の比較を公開し、5% low、1% low、フレームペーシングのばらつきを追加しました。この2回目のテストはIntel i7-13700とRadeon RX 9060 XTという別のハードウェアを使っており、同じハードウェアでの1回目の拡張ではなく、フレームの一貫性に関する追加の証拠です。どちらの比較もCPUスケジューラを分離しておらず、意図的な競合CPUワークロードも加えていません。
プロジェクト側も誇張していません。 ゲーム性能に関するr/cachyosのスレッドで、Peter Jung、 CachyOSの創設開発者の一人は、あるユーザーに直接こう答えました。「In gaming not all too much. The newer feature can make a difference tough :)」(ゲームではそれほどでもないが、新しい機能は違いを生むことがある、の意)
ここから2つの別々の結論が残ります。素の状態のCachyOSでのゲーミングについては、公開されたテストは平均FPSの差がほとんどないことを示し、今では1% lowとフレームペーシングの測定も含まれています。意図的なCPU競合下でのBOREについては、スケジューラだけを変えてその負荷下の応答性を測った、制御された公開テストを見つけることができませんでした。
何も速く測定されなくても乗り換えが速く感じられる理由
CachyOSの最適化がまったく関与しなくても、ディストリビューション変更後にマシンをきびきびさせる仕組みが2つあります。クリーンインストールそのものと、前のシステムが抱えていた無関係な問題の偶然の解消です。どちらも自分のケースで見分けられる程度に具体的で、それが十把一絡げのプラセボ批判との違いです。
まずクリーンインストールから。 この問いに関するr/linuxquestionsのスレッドで、自分では差を感じなかったというCachyOSユーザーが、大きな向上を報告する人はクリーンな環境ではなく使い込んだ環境と比べているのではないかと指摘しました。何年も溜まった自動起動項目、孤立したサービス、ずれた設定、満杯のディスクはそれ自体がワークロードであり、クリーンなパーティションはそれらを一度に取り除きます。ディストリビューションの変更はカーネル、デスクトップ環境、すべてのパッケージバージョン、すべてのデフォルトを同時に動かし、 Manjaro対Ubuntuの完全比較 は12もの別々の軸に及びます。後からそのうちの1つに改善を帰属させるのは当て推量です。
偶然の修正はもっと明確な例です。同じスレッドで、あるコメント投稿者は、パフォーマンスを著しく落とすVRAM管理の問題を抱えたままFedoraを常用し、CachyOSに移行したところ問題が消えたと述べました。その後、素のArchに移るとCachyOSと基本的に同じ性能が出て、何が違ったのかもう分からないと結論づけました。改善は本物でしたが、CachyOSのコンパイルターゲットは何の関係もありませんでした。
どちらも明快な否定を正当化するものではなく、そうした否定に対する最も強い証拠は制御されたテストです。 PhoronixのArrow Lakeディストリビューション比較 は、Ubuntu 24.10、Fedora Workstation 41、Arch Linux、Clear Linux、CachyOSを同じIntel Core Ultra 9 285Kにデフォルト状態で載せ、CachyOSは通常Intelシリコンで首位のClear Linuxを含むすべてをわずかに上回りました。Arrow LakeはAVX-512に対応していないため、この優位はx86-64-v4に由来するはずがなく、CachyOSのカーネルとビルドの選択、パッケージ最適化、デフォルト設定の何らかの組み合わせを反映しています。
体験が本物でありながら、原因の帰属は不確かなままということはあり得ます。PhoronixのArrow Lake比較は有用な反例です。デフォルト状態のCachyOSは、x86-64-v4が使えなくても素のArchを上回ることがあります。
自分のマシンに当てはまるかを確認する方法
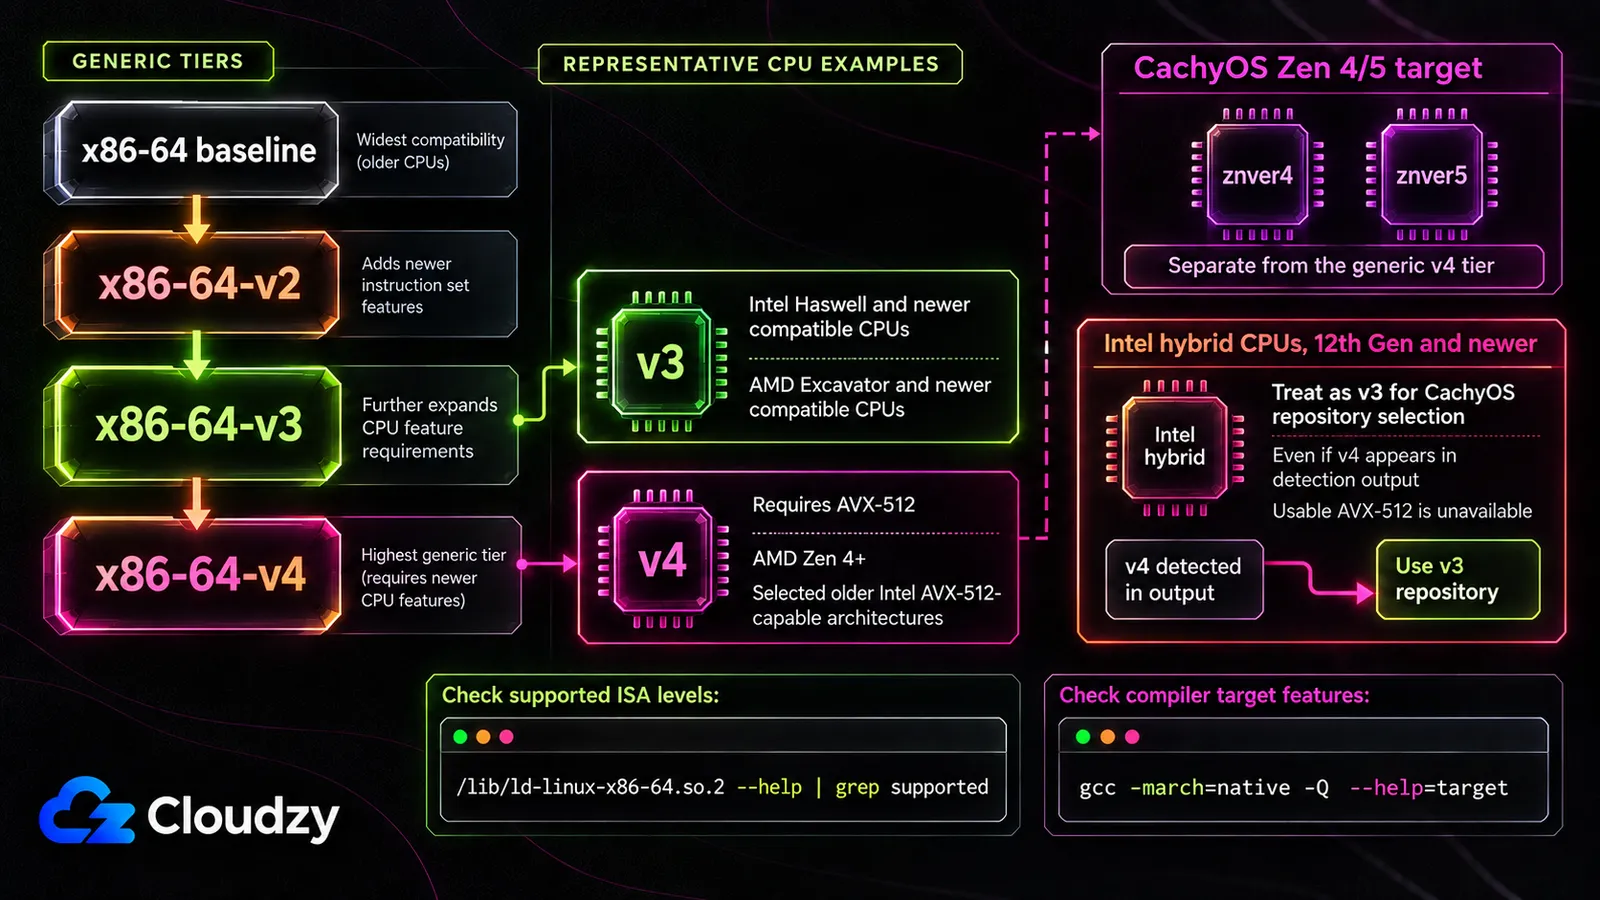
自分のCPUがどの標準x86-64マイクロアーキテクチャレベルに対応しているかは、ほぼコマンド1つで答えが出ます。動的リンカは使用できるglibc-hwcapsレベルを報告するので、対応している最も高いx86-64-vNの項目が、通常はCPUが汎用のv2、v3、v4いずれのリポジトリ層に該当するかを教えてくれます。重要な例外が1つ、Intel第12世代以降のハイブリッドCPUです。そこではAVX-512が使えないため、出力にv4が出てもv3として扱うようCachyOSは案内しています。CachyOSの独立したZen 4/5ターゲットにも、独自のアーキテクチャ確認が必要です。
/lib/ld-linux-x86-64.so.2 --help | grep supportedAMD Zen 4/5については、CachyOSは次も文書化しています。
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"最初のコマンドは次のような出力を表示します。
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
これはv3とv2はあるがAVX-512のないCPUです。3つの結果、3つの判断です。
- x86-64-v2より上は何もない。 v3/v4/Zen専用の再ビルドの利点はこのCPUには当てはまりません。CachyOSはそれでも動作しますし、パッケージ固有のコンパイラ最適化やカーネルとデフォルト設定の変更は依然として意味を持ち得ます。
- x86-64-v3に対応、x86-64-v4は利用不可。 実際のリポジトリ選択の観点では、Arrow Lakeのような最新のIntelハイブリッドCPUもここに含まれます。上で引用した比較では、多くの変化は小さく、一部のエンコードや圧縮のワークロードははるかに大きく向上し、いくつかのパッケージは退行しました。
- x86-64-v4に対応。 AVX-512はベクトル化可能なワークロードにより多くの理論上の余地を生みますが、システム全体での大きな向上を保証するものではありません。
CPUが条件を満たし、欲しいのがパッケージ側の半分だけなら、それを得るために再インストールする必要はありません。CachyOSのリポジトリは既存のArchシステムに追加でき、ALHPは公式Archリポジトリを各x86-64-vNレベルで再ビルドしたものを公開しており、 Arch Wikiに文書化 されています。ただし独自の注意点があります。直接リンクされたカーネルモジュールの代わりにDKMSパッケージが必要で、カーネルコンパイルに -march を設定しても「有意な結果は得られない」とされています。どちらの経路でも得られるのは再コンパイルされたパッケージだけで、カーネルパッチセットやスケジューラ派生版はまったく含まれません。
まずコマンドを実行してください。それはディストリビューションをめぐる議論を自分のマシンについての事実に変えてくれます。この問いのうち、今夜あなた自身で決着をつけられる唯一のバージョンです。

root権限、NVMe、AMD EPYCのパワーを備えたLinux VPSで開発を。
Linuxプランを見るよくある質問
CachyOSは本当にゲーム性能を向上させるのか?
平均フレームレートでは、ほとんど変わりません。2026年5月の5本のゲーム比較では1〜2フレームの差しか見られず、2日後のフォローアップでは1% lowとフレームペーシングも測定されました。どちらのテストも意図的な競合CPUワークロードを導入していないため、未解決の問いはフレームペーシングが測定されたかどうかではなく、競合下でのスケジューラの応答性です。
自分のCPUはx86-64-v3またはv4に対応しているか?
CachyOSまたはArchで /lib/ld-linux-x86-64.so.2 --help | grep supported を実行すると、CPUで検出された標準のglibc-hwcapsレベルを確認できます。x86-64-v3はAVX/AVX2世代の機能セットを要求し、v4はAVX-512を追加します。Intel第12世代以降のハイブリッドCPUについては、出力にv4が出てもシステムをv3として扱うようCachyOSは推奨しており、Zen 4/5ユーザーは独立したznver4/znver5ターゲットも確認すべきです。
再コンパイルされたパッケージはなぜもっと大きな差を生まないのか?
高度に最適化されたコードの一部は、すでに実行時にCPU固有の実装へ振り分けられているからです。数学・暗号ライブラリはホット関数に関数マルチバージョニングやIFUNCをよく使うため、パッケージの再ビルドが主に効くのは、コンパイラが全体的にさらに最適化またはベクトル化できるコードです。
ディストリビューションを変えずにCachyOSの最適化パッケージを使えるか?
はい。CachyOSのリポジトリは既存のArch Linuxインストールに追加でき、ALHPプロジェクトはx86-64-v2、v3、v4を対象に公式Archリポジトリを再ビルドしたものを公開しており、Arch Wikiに文書化されています。どちらも得られるのは再コンパイルされたパッケージだけで、CachyOSのカーネルパッチセット、代替スケジューラ、インストーラのデフォルトは含まれません。
ディスカッション
コメント
ログインしてディスカッションに参加してください。