
Un usuario de r/linuxquestions hizo la comparación sobre la que todo el mundo sigue discutiendo. Instaló CachyOS, hizo benchmarks de varios juegos en un Ryzen 7 7800X3D con una Radeon RX 7900 XTX y no midió ninguna diferencia frente a las otras distribuciones que ya tenía en la máquina. Las respuestas fueron las de siempre. Un comentarista puso el techo tan bajo que resulta invisible en el uso normal. Otro explicó el planificador. Un tercero dijo que los benchmarks no pueden mostrar lo que hace el planificador. Nadie aportó la medición que zanjaría la cuestión.
La pregunta vuelve una y otra vez con las mismas palabras: ¿CachyOS es realmente más rápido? La respuesta corta es sí, en cargas de trabajo concretas. Los paquetes recompilados pueden ayudar al código que el compilador sabe vectorizar, las comparaciones de juegos citadas aquí muestran poca separación en los FPS medios, y un sistema que se siente más rápido tras el cambio es más difícil de atribuir porque cambiar de distribución altera mucho más que una sola variable.
Sigue sin resolverse porque «más rápido» encierra tres afirmaciones distintas con tres respuestas diferentes, y cada una necesita su propio instrumento. Los paquetes recompilados terminan una tarea en menos tiempo real o no lo hacen. Un planificador cambia cómo se comporta el escritorio bajo contención o no lo hace. Y una máquina más ágil se explica por CachyOS o por algo que llegó junto con él.
La versión corta
- Paquetes recompilados: medible y realmente más rápidos, en una minoría de lo que ejecutas. Las ganancias se concentran en el código que el compilador puede vectorizar, varios paquetes salen más lentos y la mayoría no cambia. Una comparación en arch-chroot de enero de 2023 en sunnyflunk.github.io, sobre un Intel NUC8i5BEK, encontró la codificación flac un 20,2 % más rápida y la descompresión bzip2 un 7,1 % más lenta en la misma tanda.
- La historia del planificador se divide en dos. El kernel por defecto actual de CachyOS usa EEVDF, mientras que BORE está disponible por separado. Las comparaciones de distribuciones de mayo de 2026 encontraron poca separación en los FPS medios y también midieron los mínimos del 1 % y el ritmo de fotogramas, pero no aislaron BORE ni añadieron una carga de CPU competidora controlada. El rendimiento en juegos recién instalado se ha medido; el beneficio de BORE bajo contención no se ha aislado.
- La sensación de una máquina más rápida: experiencia real, atribución poco fiable. Una instalación limpia y un arreglo casual de un fallo sin relación producen ambos un sistema más ágil que no debe nada a los niveles de conjunto de instrucciones. La excepción que conviene conocer es la comparación de Phoronix con configuración de fábrica en un Intel Core Ultra 9 285K, donde CachyOS superó a Arch estándar en una CPU que no puede usar en absoluto las optimizaciones AVX-512.
Qué cambia realmente CachyOS en tu sistema
CachyOS es Arch Linux con tres modificaciones separadas apiladas encima: un kernel parcheado que ofrece planificadores alternativos, repositorios cuyos paquetes se recompilan para niveles de conjunto de instrucciones de CPU más nuevos, y optimizaciones adicionales del compilador en un subconjunto de paquetes básicos. Cada una es un mecanismo distinto con un efecto distinto, y casi nunca se miden por separado.
El lado del kernel es la superficie más grande. La lista de características del kernel de CachyOS cubre Clang ThinLTO, perfilado AutoFDO, modos de apropiación seleccionables en tiempo de ejecución y varias opciones de planificador. El paquete actual linux-cachyos usa un EEVDF ajustado por CachyOS como planificador por defecto. BORE y BMQ están disponibles mediante variantes de kernel separadas, mientras que linux-cachyos-eevdf aplica un ajuste adicional de capacidad de respuesta a EEVDF y linux-cachyos-server usa el EEVDF de serie. sched-ext sigue disponible en las variantes que lo admiten.
En el lado de los paquetes, los repositorios x86-64-v3 de CachyOS son el mecanismo en cuestión. La página de repositorios optimizados de CachyOS describe la recompilación de paquetes de Arch para tres objetivos por encima de la base genérica: x86-64-v3, x86-64-v4 y un objetivo dedicado Zen 4/5 que añade más extensiones AVX-512, más algunas instrucciones fuera de AVX-512, sobre v4. Un subconjunto de paquetes sensibles al rendimiento también recibe optimización guiada por perfil y BOLT.
Esos nombres de nivel vienen de la especificación de niveles de microarquitectura del psABI x86-64, y son umbrales, no diales. x86-64-v3 exige las instrucciones de la era AVX y AVX2 que llegaron con Haswell de Intel en 2013 y los núcleos Excavator de AMD; x86-64-v4 exige AVX-512, lo que en la práctica significa chips Intel de clase Skylake-X y cualquier AMD Zen 4 o posterior. Una CPU supera el listón o no lo supera.
Las tres afirmaciones escondidas dentro de la palabra «más rápido»
Cuando dos personas discrepan sobre si CachyOS es más rápido, normalmente ambas tienen razón sobre cosas distintas. El rendimiento bruto, la consistencia de fotogramas y la capacidad de respuesta percibida son propiedades separadas, y ninguna métrica única resuelve las tres. Una tarea cronometrada mide el rendimiento bruto; las mediciones de tiempo de fotograma y latencia cubren la fluidez en juegos; para el efecto más amplio a nivel de sistema hace falta una comparación controlada con instalación limpia.
| La afirmación | Qué se está sosteniendo | Cómo lo medirías | Qué muestra la evidencia | Confianza |
|---|---|---|---|---|
| Rendimiento medido | Los paquetes recompilados terminan la misma tarea en menos tiempo | Cronometrar una tarea en hardware fijo y kernel fijo, cambiando solo el repositorio del que vienen los paquetes | Ganancias sólidas en trabajo vectorizable, pequeñas regresiones en varios paquetes, sin cambios en la mayoría | Alta. Canonical, el CentOS ISA SIG y dos benchmarkers independientes coinciden en la forma |
| Latencia de entrada y consistencia de fotogramas | El escritorio sigue respondiendo mientras otra cosa satura la CPU | Percentiles de tiempo de fotograma y latencia de entrada bajo una carga competidora, no la tasa media de fotogramas | Las pruebas publicadas ya incluyen mínimos del 1 % y ritmo de fotogramas, pero no aíslan el planificador ni introducen una carga de CPU competidora controlada | Baja. El mecanismo está documentado, la medición falta |
| Capacidad de respuesta percibida | La máquina se siente más ágil tras el cambio | Comparar contra una instalación limpia de la distribución anterior, no contra la desgastada | Normalmente se explica por efectos de instalación limpia o un arreglo casual; una comparación con configuración de fábrica encontró una ventaja a nivel de distribución | Media. Experiencia sólida, atribución poco fiable |
Una suite de benchmarks que responde a la primera fila no puede responder a la segunda, y ninguna toca la tercera. Ejecutar una de las tres y presentar el resultado como veredicto sobre las tres es lo que mantiene vivo el hilo.
¿Los paquetes recompilados realmente corren más rápido?
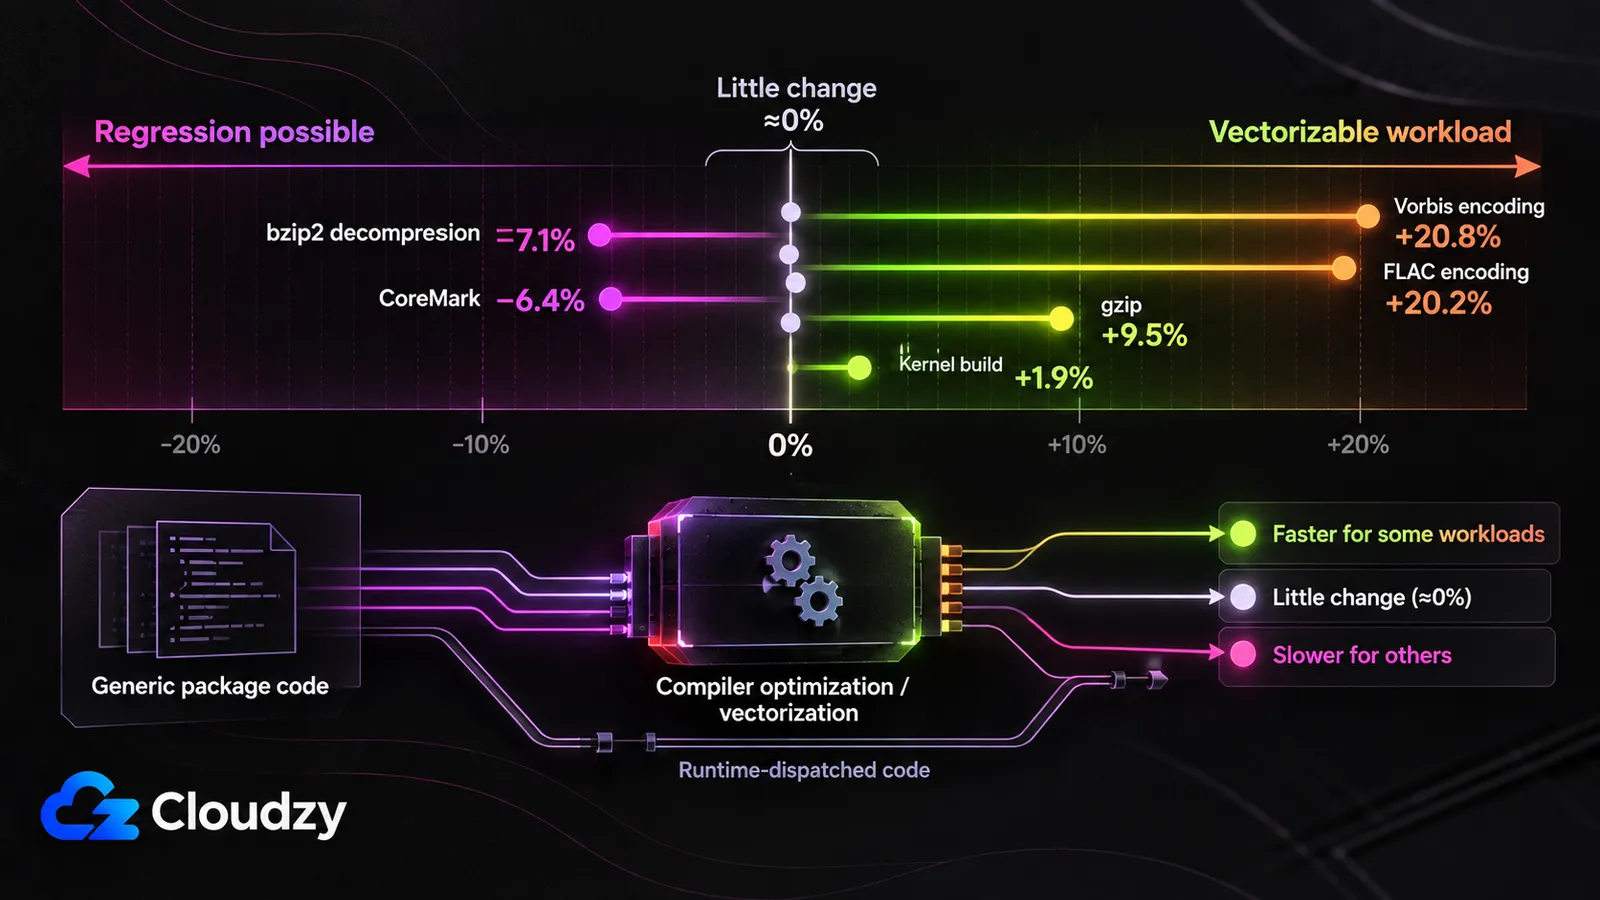
Sí, en una minoría de lo que ejecuta un escritorio, y el tamaño lo fija la carga de trabajo, no la distribución. El trabajo vectorizable ve ganancias de dos dígitos, un puñado de paquetes salen más lentos y la mayoría no muestra nada. La página de repositorios optimizados de CachyOS sitúa la mejora de x86-64-v3 entre el 5 % y el 20 % sobre el x86-64 genérico; las mediciones publicadas se quedan mayormente en el extremo bajo.
La comparación de rendimiento CachyOS vs Arch más limpia aísla la variable de los paquetes y nada más: una prueba en arch-chroot de enero de 2023 en sunnyflunk.github.io. El host corría Arch estándar en un Intel NUC8i5BEK, ambos conjuntos de paquetes se probaron dentro de un arch-chroot para que el kernel y el entorno fueran idénticos, y los benchmarks corrieron en RAM para eliminar la latencia de disco. Frente a los paquetes de Arch estándar, las compilaciones de CachyOS fueron un 20,2 % más rápidas codificando flac en -8, un 20,8 % más rápidas codificando vorbis y un 9,5 % más rápidas en gzip -3. En la misma tanda fueron un 7,1 % más lentas descomprimiendo bzip2, entre un 1,6 % y un 2,9 % más lentas comprimiendo con lz4, un 3 % más lentas en pybench y sin cambios en el benchmark de R. Dos salvedades vienen del propio autor: CachyOS compilaba con -march=x86-64-v3 -mpclmul -O3 frente al -march=x86-64 -O2de Arch, y sus pruebas de seguimiento sugerían que -O3 y no el nivel de conjunto de instrucciones explicaba parte de las mayores ganancias. La entrada es anterior al repositorio Zen 4 de CachyOS, que llegó con la versión de julio de 2024, pero no a su trabajo con BOLT: el autor interpreta que el paquete de Python de CachyOS detrás de la regresión de pybench ya llevaba BOLT sobre x86-64-v3.
Los benchmarks de CachyOS en hardware más nuevo repiten el patrón. Una comparación de julio de 2024 en mvermeulen.org ejecutó un subconjunto de Phoronix Test Suite en un Ryzen 7940HS Zen 4, CachyOS con el repositorio Zen 4 frente a Ubuntu 22.04. La mayoría de los resultados quedaron a unos pocos puntos porcentuales en un sentido u otro: coremark un 6,4 % más lento, las subpruebas de OpenSSL desde alrededor de un 1 % más lentas hasta un 4 % más rápidas, el tiempo de compilación del kernel un 1,9 % más rápido, y phpbench como valor atípico con algo más del doble de puntuación. El autor señala una discrepancia de versión de GCC, 14.1 frente a la 11.4 de Ubuntu, como probable factor de confusión. Su prueba separada de NAMD en marzo de 2024 encontró mejoras del 6,5 % y del 5,8 % en dos cargas de dinámica molecular.
Las pruebas institucionales encontraron el mismo panorama mixto en ambos extremos. El propio benchmarking x86-64-v3 de Canonical, publicado en marzo de 2024 con una imagen experimental de Ubuntu 23.10 en Azure, informó de ganancias reproducibles de hasta el 60 % en el benchmark Log2 de glibc mientras otros benchmarks retrocedían de forma significativa, en un caso porque activar v3 sobre código SSE ya optimizado hizo que el compilador lo expandiera en 17 veces más instrucciones. La reconstrucción de CentOS Stream 9 del CentOS ISA SIG de v2 a v3, en máquinas Intel de clase Ice Lake en agosto de 2023, calificó los resultados de «bastante mixtos», con aceleraciones de 2,2x concentradas en Mocassin y el md5crypt de John the Ripper, ambos muy vectorizables, aunque el equipo atribuyó la ganancia de Mocassin sobre todo a la autovectorización de GCC 12 y no al nivel de ISA.
Muchas bibliotecas matemáticas y criptográficas críticas para el rendimiento incluyen varias versiones de sus funciones calientes y eligen una en tiempo de ejecución mediante detección de características de la CPU, una técnica llamada multiversionado de funciones e implementada en glibc mediante resolutores IFUNC. Eso significa que algunas rutas calientes ya pueden usar AVX2 en una instalación estándar de Arch sin recompilar el paquete entero. La entrada de sunnyflunk lo vio directamente, señalando que el código fuente de flac ya incluye funciones AVX2 seleccionadas en tiempo de ejecución que no necesitan -march para activarse. El hallazgo de CentOS es la imagen especular: el equipo descubrió funciones matemáticas de glibc sin versiones IFUNC, que es precisamente donde una reconstrucción estática tiene margen para ayudar. Lo que alcanza una reconstrucción v3 es el código restante que el autovectorizador del compilador puede mejorar por sí solo, que es una porción de un escritorio, y pequeña.
La forma de la carga de trabajo, no la etiqueta de la CPU, decide si un cambio a nivel de máquina se nota en absoluto. El veredicto sobre el rendimiento bruto es sí, pero acotado: los cambios de un dígito son habituales en las mediciones anteriores, las mayores ganancias se agrupan en cargas vectorizables como codificación y compresión, y algunos paquetes retroceden. Esa es una descripción mejor que tratar x86-64-v3 como un multiplicador de velocidad para todo el sistema.
Qué cambia el planificador, y por qué los FPS medios no lo captan
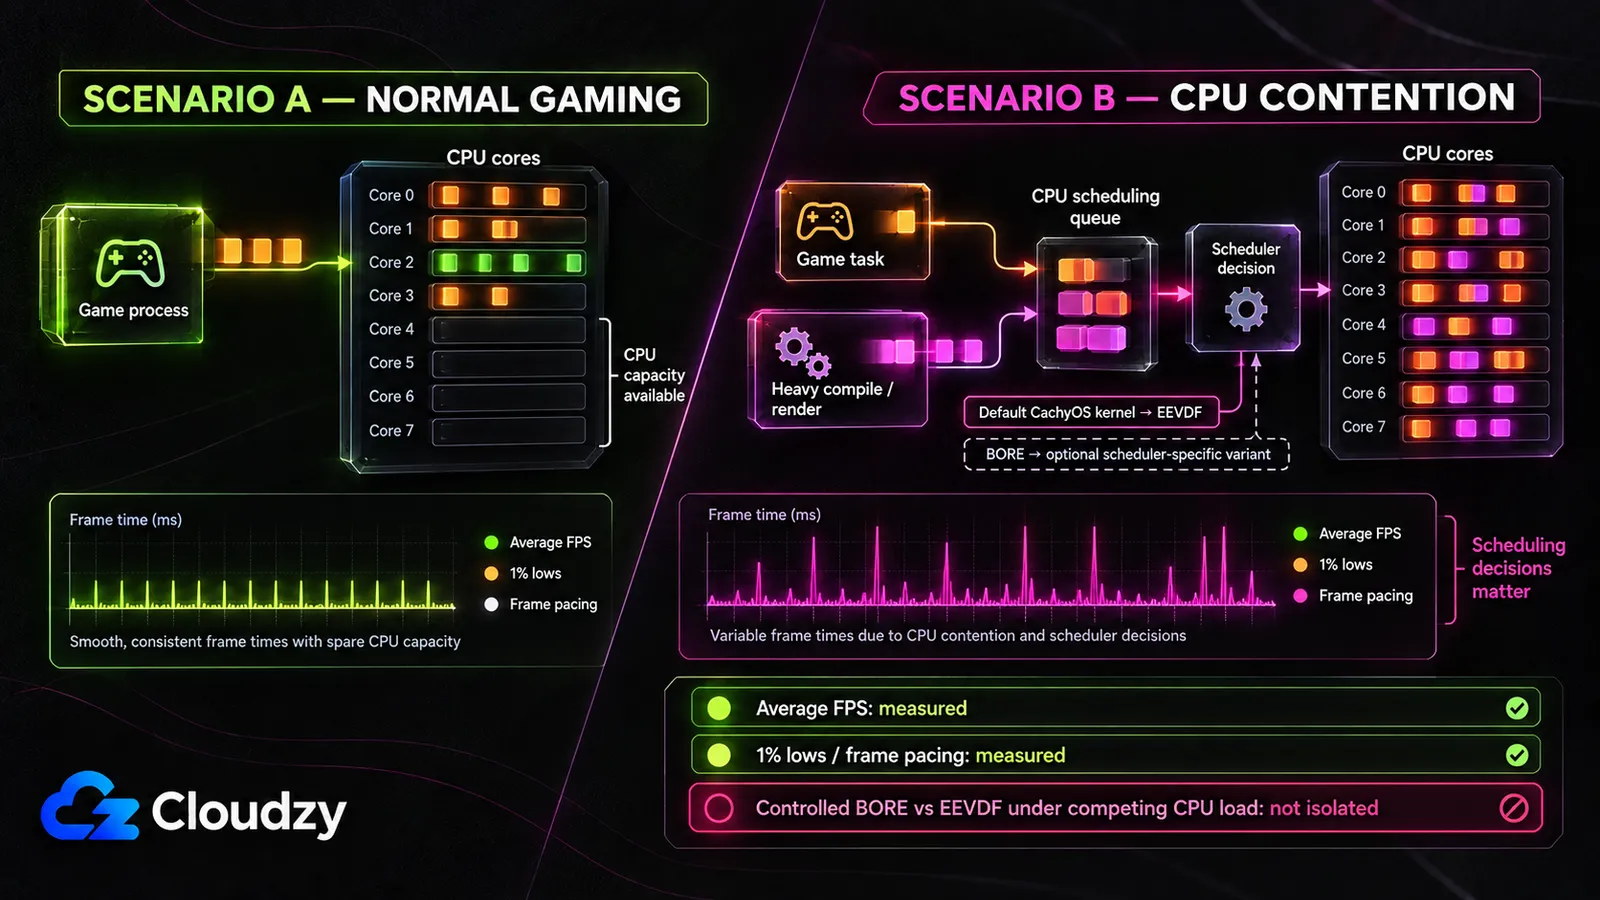
El kernel por defecto actual de CachyOS, linux-cachyos , usa EEVDF, mientras que BORE está disponible mediante variantes específicas de planificador como linux-cachyos-bore. Esa distinción importa porque las comparaciones de juegos de abajo son pruebas a nivel de distribución, no pruebas controladas de BORE frente a EEVDF. BORE sigue siendo relevante para la afirmación de rendimiento más amplia porque su diseño apunta explícitamente a la capacidad de respuesta con cargas mixtas, pero esa afirmación hay que evaluarla por separado del rendimiento en juegos de CachyOS recién instalado.
El propio README de BORE expone la intención con claridad:
Para lograrlo, BORE introduce una dimensión de flexibilidad conocida como «burstiness» para cada tarea individual, apartándose parcialmente del principio inherente de «equidad completa» de CFS.
firelzrd/bore-scheduler, README del proyecto
La burstiness es el tiempo de CPU que una tarea ha acumulado desde la última vez que cedió la CPU al dormir, esperar E/S o ceder el turno. BORE lo convierte en una puntuación y la usa para ajustar el peso de cada tarea y la agresividad de su apropiación al despertar, de modo que las tareas que ceden con frecuencia se tratan como interactivas y se favorecen frente a las que acaparan su porción. El README nombra él mismo la contrapartida: BORE se asienta en un «equilibrio entre tareas codiciosas y débiles (normalmente tareas por lotes ligadas a CPU) y tareas modestas y fuertes (normalmente tareas interactivas ligadas a E/S)». Dar más peso al trabajo interactivo es la misma operación que dar menos peso al trabajo de rendimiento por lotes.
Eso te dice qué instrumento detectaría la afirmación específica de BORE: introducir una carga de CPU competidora y medir percentiles de tiempo de fotograma o latencia de entrada cambiando solo el planificador. Un planificador tiene mucho menos que arbitrar cuando el juego corre con capacidad de CPU ociosa.
Un benchmark de cinco juegos publicado el 16 de mayo de 2026 usó instalaciones limpias de CachyOS y Omarchy en el mismo SSD y hardware, una RTX 5060 Ti y un Ryzen 9, con la misma compilación de Proton-GE y ajustes a 1440p. Los FPS medios difirieron solo en uno o dos fotogramas. Dos días después, el mismo probador publicó una segunda comparación con registro completo de fotogramas de MangoHUD, añadiendo mínimos del 5 %, mínimos del 1 % y varianza del ritmo de fotogramas. Esa segunda prueba usó hardware distinto, un Intel i7-13700 y una Radeon RX 9060 XT, así que es evidencia adicional sobre la consistencia de fotogramas y no una extensión de la primera prueba en el mismo hardware. Ninguna de las dos comparaciones aísla el planificador de CPU ni añade una carga de CPU competidora deliberada.
El proyecto tampoco lo vende de más. En un hilo de r/cachyos sobre rendimiento en juegos, Peter Jung, uno de los desarrolladores fundadores de CachyOS, respondió directamente a un usuario: «In gaming not all too much. The newer feature can make a difference tough :)» (en juegos, no demasiado; la función más nueva sí puede marcar diferencia).
Eso deja dos conclusiones separadas. Para juegos en CachyOS recién instalado, las pruebas publicadas muestran poca separación en los FPS medios y ahora incluyen mediciones de mínimos del 1 % y ritmo de fotogramas. Para BORE en concreto bajo contención de CPU deliberada, no pude encontrar una prueba publicada controlada que cambie solo el planificador y mida la capacidad de respuesta bajo esa carga.
Por qué un cambio se siente más rápido incluso cuando nada mide más rápido
Dos mecanismos producen una máquina más ágil tras cambiar de distribución sin que intervenga ninguna de las optimizaciones de CachyOS: la instalación limpia en sí, y un arreglo casual de un problema sin relación que tenía el sistema anterior. Ambos son lo bastante concretos para reconocerlos en tu propio caso, que es lo que los separa de una acusación genérica de placebo.
Empecemos por la instalación limpia. En un hilo de r/linuxquestions sobre la cuestión, un usuario de CachyOS que decía no haber notado diferencia él mismo sugirió que quienes reportan grandes ganancias quizá comparan contra una instalación muy usada y no contra una limpia. Años de entradas de autoarranque acumuladas, servicios huérfanos, configuración a la deriva y un disco lleno son una carga de trabajo, y una partición limpia lo elimina todo de golpe. Un cambio de distribución mueve a la vez el kernel, el entorno de escritorio, cada versión de paquete y cada valor por defecto, y una comparación completa de Manjaro frente a Ubuntu abarca una docena de ejes distintos. Atribuir después una mejora a uno de ellos es adivinar.
El arreglo casual es el caso más claro. En el mismo hilo, un comentarista describió usar Fedora a diario con un problema de gestión de VRAM que degradaba gravemente el rendimiento, cambiar a CachyOS y ver desaparecer el problema. Después pasó a Arch puro e informó de básicamente el mismo rendimiento que CachyOS, concluyendo que ya no sabía qué había sido diferente. La mejora era real; los objetivos de compilación de CachyOS no tuvieron nada que ver.
Nada de eso autoriza a desmontarlo del todo, y la evidencia más fuerte contra un desmentido limpio es una prueba controlada. La comparación de distribuciones en Arrow Lake de Phoronix puso Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux y CachyOS en el mismo Intel Core Ultra 9 285K en su estado por defecto, y CachyOS superó por poco a todos, incluido Clear Linux, que normalmente lidera en silicio Intel. Arrow Lake no tiene soporte de AVX-512, así que esa ventaja no puede venir de x86-64-v4; refleja alguna combinación de las decisiones de kernel y compilación de CachyOS, las optimizaciones de paquetes y la configuración por defecto.
La experiencia puede ser real mientras la atribución sigue siendo incierta. La comparación Arrow Lake de Phoronix es un contraejemplo útil: una instalación de CachyOS en estado por defecto puede superar a Arch estándar incluso cuando x86-64-v4 no está disponible.
Cómo comprobar si algo de esto aplica a tu máquina
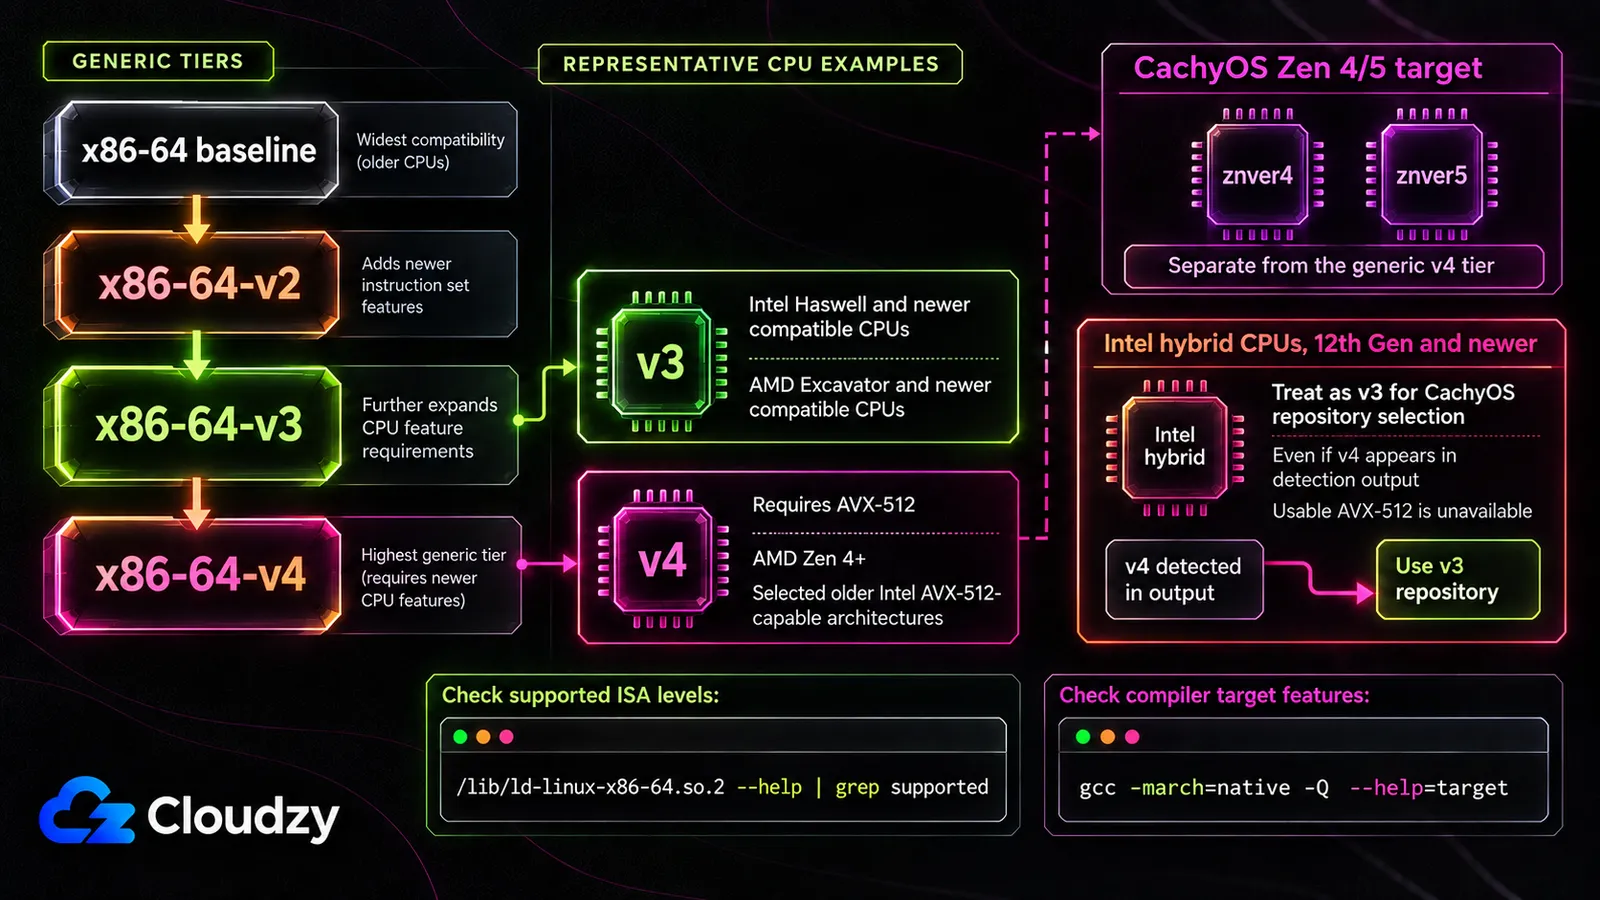
Qué nivel estandarizado de microarquitectura x86-64 soporta tu CPU se responde casi por completo con un comando. El enlazador dinámico informa de los niveles glibc-hwcaps que puede usar, así que la entrada x86-64-vN más alta soportada normalmente te dice si la CPU califica para el nivel de repositorio genérico v2, v3 o v4. Una excepción importante son las CPU híbridas de Intel de 12.ª generación y posteriores: CachyOS indica tratarlas como v3 aunque v4 aparezca en la salida, porque AVX-512 no es utilizable ahí. El objetivo Zen 4/5 separado de CachyOS también necesita su propia comprobación de arquitectura.
/lib/ld-linux-x86-64.so.2 --help | grep supportedPara AMD Zen 4/5, CachyOS también documenta:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"El primer comando imprime algo así:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Esa es una CPU con v3 y v2 pero sin AVX-512. Tres resultados, tres decisiones:
- Nada por encima de x86-64-v2. La ventaja de las reconstrucciones v3/v4/específicas de Zen no aplica a esta CPU. CachyOS puede funcionar igualmente, y las optimizaciones de compilador específicas de paquetes, junto con los cambios de kernel y configuración por defecto, aún pueden importar.
- x86-64-v3 soportado, x86-64-v4 no disponible. Esto incluye CPU híbridas modernas de Intel como Arrow Lake a efectos prácticos de selección de repositorio. En las comparaciones citadas arriba, muchos cambios fueron pequeños, algunas cargas de codificación y compresión ganaron mucho más, y algunos paquetes retrocedieron.
- x86-64-v4 soportado. AVX-512 crea más margen teórico para cargas vectorizables, pero no garantiza una gran ganancia en todo el sistema.
Si tu CPU califica y la mitad de los paquetes es lo que quieres, no tienes que reinstalar para conseguirla. Los repositorios de CachyOS pueden añadirse a un sistema Arch existente, y ALHP publica reconstrucciones de los repositorios oficiales de Arch en cada nivel x86-64-vN, documentadas en la Arch Wiki con sus propias salvedades: hacen falta paquetes DKMS en lugar de módulos de kernel enlazados directamente, y fijar -march para la compilación del kernel «no daría ningún resultado significativo». Cualquiera de las dos rutas te da los paquetes recompilados y nada del conjunto de parches del kernel ni de las variantes de planificador.
Ejecuta el comando primero. Convierte una discusión sobre distribuciones en un hecho sobre tu propia máquina, que es la única versión de esta pregunta que puedes zanjar tú mismo esta noche.

Construye sobre un VPS Linux con acceso root, NVMe y la potencia de AMD EPYC.
Ver planes LinuxPreguntas frecuentes
¿CachyOS mejora realmente el rendimiento en juegos?
En tasa media de fotogramas, apenas. Una comparación de cinco juegos de mayo de 2026 encontró solo una diferencia de uno a dos fotogramas, y un seguimiento dos días después también midió mínimos del 1 % y ritmo de fotogramas. Ninguna prueba introdujo una carga de CPU competidora deliberada, así que la cuestión sin resolver es la capacidad de respuesta del planificador bajo contención, no si el ritmo de fotogramas se ha medido.
¿Mi CPU soporta x86-64-v3 o v4?
En CachyOS o Arch, ejecuta /lib/ld-linux-x86-64.so.2 --help | grep supported para ver los niveles glibc-hwcaps estandarizados detectados para tu CPU. x86-64-v3 exige el conjunto de características de la era AVX/AVX2, mientras que v4 añade AVX-512. Para CPU híbridas de Intel de 12.ª generación y posteriores, CachyOS recomienda tratar el sistema como v3 aunque v4 aparezca en la salida; los usuarios de Zen 4/5 también deberían comprobar el objetivo znver4/znver5 separado.
¿Por qué los paquetes recompilados no marcan una diferencia mayor?
Porque parte del código muy optimizado ya se despacha en tiempo de ejecución a implementaciones específicas de cada CPU. Las bibliotecas matemáticas y criptográficas suelen usar multiversionado de funciones o IFUNC en sus funciones calientes, así que recompilar paquetes ayuda sobre todo al código que el compilador aún puede optimizar o vectorizar globalmente.
¿Puedo conseguir los paquetes optimizados de CachyOS sin cambiar de distribución?
Sí. Los repositorios de CachyOS pueden añadirse a una instalación existente de Arch Linux, y el proyecto ALHP publica reconstrucciones de los repositorios oficiales de Arch para x86-64-v2, v3 y v4, documentadas en la Arch Wiki. Ambos te dan solo los paquetes recompilados, no el conjunto de parches del kernel de CachyOS, los planificadores alternativos ni los valores por defecto del instalador.
Debate
Comentarios
Inicia sesión para unirte al debate.