

PRTG はセンサー単位で課金します。センサーとは、デバイスそのものではなく、1 台のデバイス上で監視する 1 つのメトリクスです。Paessler 自身の価格帯は実用上の比率をおよそ 10 対 1 としています。500 センサーで約 50 台、10,000 センサーで約 1,000 台です。スイッチスタックを追加してポートごとのスループットを見始めると、センサー数は機器数より速く増えます。SolarWinds は数え方が異なりますが、行き着く先は同じです。
Windows が中心のネットワークなら、PRTG と SolarWinds に代わるセルフホスト型の選択肢として 2 つを候補に挙げます。Zabbix か、チームがすでに運用しているなら Prometheus ベースのスタックです。どちらを選ぶかは、それぞれが Windows ホスト上で何を見られるか、そしてそれを見るために何が必要かで決まります。
何より先に断っておくことがあります。チームの誰にも余った時間がないなら、PRTG と SolarWinds が依然として正解です。その使いやすさは意図的に購入する製品であり、お金を払う価値があります。ここで説明する移行はライセンス料の代わりに時間を使うもので、アップグレードではなくトレードです。
要約
- 既定の選択は Zabbix です。 Zabbix は SNMP ポーリング、Windows エージェント、テンプレート、アラートを 1 つの監視プラットフォームにまとめています。Zabbix サーバー、データベース、Web フロントエンドの運用は自分で行いますが、始めるためだけに別々の監視コンポーネントを組み立てる必要はありません。
- 例外は、すでに Grafana と Prometheus を運用しているチームです アプリケーションとホストのメトリクス用に。すでに保守しているものを拡張する方が、2 つ目の監視システムを立ち上げるより安くつきます。
- Prometheus は単体ではネットワーク機器をポーリングしません。
snmp_exporterがその穴を埋めます。既定の設定で一般的なスイッチやルーターの多くをカバーしますが、ベンダー固有のオブジェクトやカスタムのポーリングにはジェネレーターと追加の MIB 作業が必要になることがあります。 - エージェントレスの収集では、ホストやデバイスが公開すると決めたものしか見えません。 Zabbix では、Windows のイベントログ、サービス状態、詳細なパフォーマンスカウンターはエージェントのアイテムキーです。
- サーバーはデバイス数ではなくメトリクス数でサイジングします。 Zabbix は 1 メトリクスを 1 アイテム + 1 トリガー + 1 グラフとして数え、およそ 1,000 メトリクスを CPU 2 コアとメモリ 8 GiB に、およそ 10,000 メトリクスを 4 コアと 16 GiB に割り当てています。
PRTG と SolarWinds が課金するもの
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
SolarWinds は別の単位で数えます。このルールは更新見積もりが届くまで見落としやすいものです。 SolarWinds の NPM ライセンスモデル は、NPM が「監視対象ネットワーク要素のうち、ノード、インターフェース、ボリュームの各種別で最も大きい数に基づいてライセンスされる」と述べています。合計ではありません。3 つのうち最大の値です。ノード 80 台、監視対象スイッチポート 900 個のネットワークは 80 ではなく 900 でライセンスされ、ティアは SL100 から SLX まであります。1 つのポーリングエンジンはティアに関係なく 12,000 要素(最大値ではなく、ノード、インターフェース、ボリュームの合計)が上限で、それを超えるとライセンス付きのポーリングエンジンを追加します。
両モデルの実際の効果は同じです。何を監視するかを決めるのはライセンスのティアであって、ネットワークではありません。監視したいインターフェースが、監視すると境界を越えてしまうという理由で監視されないまま残り、そのコストは請求書に決して現れません。
運用に値する 2 つのセルフホスト型の道
Zabbix は、中央サーバー、データベース、Web フロントエンドを中心に構成された 1 つの監視プラットフォームです。サーバーが SNMP 機器をポーリングし、Windows エージェントからデータを受け取り、同じ製品の中でテンプレート、トリガー、アラートを適用します。Prometheus ベースのネットワーク監視スタックを組み立てるのに比べ、自分で統合しなければならない個別コンポーネントは少なくなります。インストールし、ホストを指定し、テンプレートを割り当てるだけです。テンプレートとは、1 つのデバイスクラスをカバーするアイテム、トリガー、グラフの再利用可能なまとまりです。
まずライセンスからです。 Zabbix のライセンスページ は、7.0 以降のすべてのバージョンが GNU Affero General Public License バージョン 3 で公開され、6.4 までは GPLv2 だったと述べています。規模を問わず、ソフトウェアのライセンス料はありません。Zabbix は技術サポートを別売りの任意サブスクリプションとして販売し、商用ユーザーには何らかのレベルの購入を求めていますが、製品内のどの機能もその購入の裏に閉じ込められてはいません。
2 つ目の道は Grafana、Prometheus、VictoriaMetrics です。これが正解になる状況はただ 1 つ、このスタックをすでにアプリケーションとホストのメトリクス用に運用していて、すでに誰かが保守している場合です。それに当てはまるなら、 単一 VPS での完全構築 はすでに解決済みの問題で、慣れたものを拡張するだけです。誰も新しいデータモデルを学ぶ必要はありません。

この道の穴はネットワーク機器です。Prometheus は HTTP エンドポイントをスクレイプするもので、SNMP を直接は話しません。ネットワーク機器は通常 snmp_exporter経由で扱います。これがデバイスをポーリングし、結果を Prometheus がスクレイプできる形で公開します。その 既定の設定 には if_mibのようなモジュールが含まれているため、多くのスイッチやルーターでの標準的なインターフェース監視にカスタム設定の生成は不要です。ジェネレーターが追加作業になるのは、ベンダー固有のオブジェクト、カスタムの walk、既定で含まれない MIB が必要な場合です。したがって Prometheus の道は Zabbix より保守する部品が多いものの、ジェネレーターがすべてのデバイスで必須というわけではありません。
LibreNMS はこの分野の 3 番目の名前で、自動検出を中心に作られています。SNMP、CDP、LLDP、OSPF、BGP、ARP でネットワークを巡回し、何があるかを見つけ出します。検出が最優先なら妥当な選択肢です。ただし Windows の収集という問題は変わらず、この判断が決まるのはまさにそこです。
各方式が Windows ホストをどう見るか
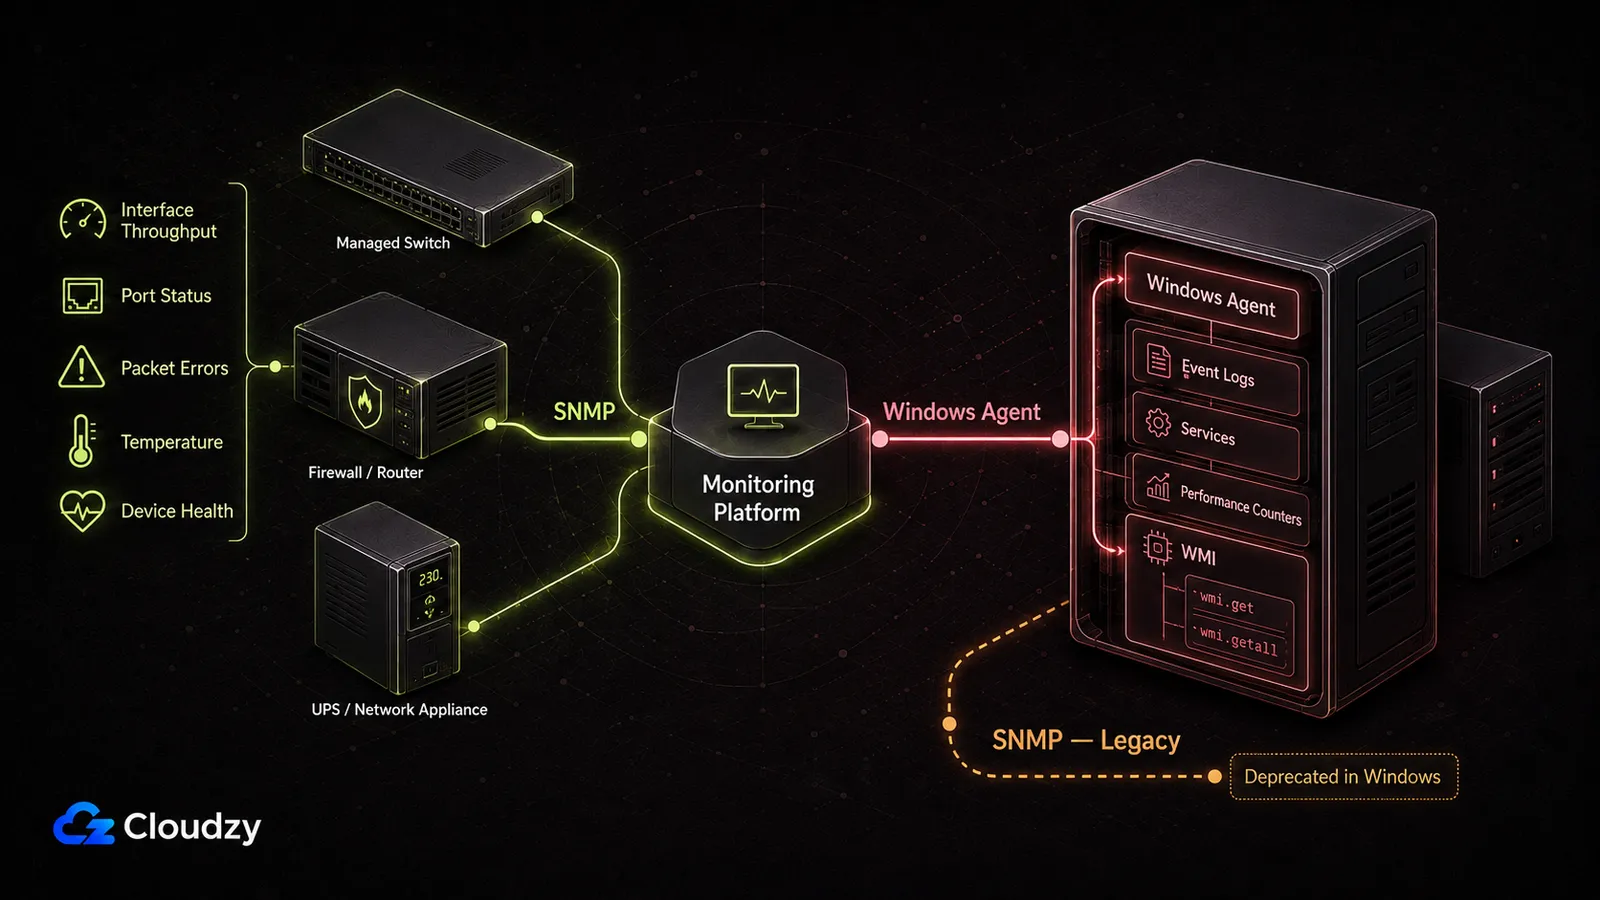
Windows の監視には SNMP、リモート WMI、インストール型エージェントが関わります。どの経路が使われるかは、監視製品と収集するメトリクスによります。特に Zabbix では、組み込みの WMI チェックは Windows エージェント経由で実行されます。
SNMP
SNMP ポーリングは、OID で指定された番号付きオブジェクトの現在値をデバイスに問い合わせます。OID はデバイスの MIB 内の位置です。返ってくるのはデバイスが公開しているものだけで、それ以外はありません。マネージドスイッチ、ファイアウォール、UPS なら通常それで十分です。インターフェースカウンター、ポート状態、エラー率、温度、シャーシの状態などです。
Windows では状況がより貧弱です。Microsoft の SNMP と WMI SNMP Provider の非推奨に関する通知 は、両機能が非推奨であることを裏付けています。そのため私は、新規導入の既定ではなく、レガシー互換の経路として Windows の SNMP を扱います。Zabbix は今も Windows by SNMP テンプレートを提供していますが、ネイティブエージェントの方がオペレーティングシステムをはるかに深く見通せます。
WMI
WMI は、対象に監視エージェントをインストールせずにリモートから問い合わせできます。PRTG のような製品がエージェントレスの Windows 収集方式として使えるのはそのためです。Zabbix の仕組みは異なります。 組み込みの WMI チェックである, wmi.get と wmi.getallは Windows エージェントのアイテムキーであり、監視対象マシン上で Zabbix エージェントまたはエージェント 2 がそれらのクエリを実行します。
リモート WMI には、監視製品が直接使う場合に固有のネットワーク要件も伴います。現行の Windows システムでは RPC は TCP ポート 135 で始まり 、通常は動的な上位 TCP ポート範囲(一般に 49152 から 65535)を通じて接続をネゴシエートします。対象側のファイアウォールと WMI の権限が接続を許可している必要があります。
この比較では、プロトコルそのものより区別の方が重要です。PRTG は監視エージェントをインストールせずにリモート WMI を使えますが、Zabbix は Windows 固有の WMI の可視性をエージェント経由で得ます。
ネイティブエージェント
Windows 固有の深さが宿るのはエージェントです。Zabbix のドキュメントに列挙されている Windows 固有のキー: eventlog は Windows イベントログの監視用、 perf_counter は任意の Windows パフォーマンスカウンター用、 service.discovery と service.info はサービス状態用です。いずれもエージェントのアイテムキーです。
コストは展開です。重要なすべての Windows Server とワークステーションにエージェントを置くということは、配布するパッケージ、最新に保つバージョン、維持するファイアウォールルールが 1 つずつ増えるということです。これは恒常的な運用上のコミットメントであり、ライセンス節約の対価です。
エージェントレスの収集はホストやデバイスが公開すると決めたものに限られ、Zabbix ではイベントログと詳細なパフォーマンスカウンターはエージェントのアイテムキーの向こう側にあります。
並べて比較
比較のポイントは 4 つです。ツールがそもそも SNMP でネットワーク機器をポーリングするか、Windows エージェントがあるか、Windows ホストをどこまで深く見られるか、そして動くシステムに至るまでにどれだけ組み立てが必要か。ライセンスはこの評価が始まった理由なので、その隣に置きます。
| ツール | SNMP 機器ポーリング | Windows 監視 | セットアップの手間 | ライセンス |
|---|---|---|---|---|
| Zabbix | 組み込み | エージェント: イベントログ、サービス状態、パフォーマンスカウンター、WMI。SNMP では大まかな状態のみ | 中程度: サーバー 1 台、その後テンプレート | AGPLv3、ライセンス料なし。サポートは別売り |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | 組み込みではない。 snmp_exporter を別コンポーネントとして必要とする | ネイティブの Windows エージェントなし。ホストメトリクスは別のエクスポーターから。イベントログはネイティブ非対応 | 高: 複数コンポーネント。カスタム SNMP にはジェネレーター作業が必要な場合あり | オープンソースコンポーネント、ライセンス料なし |
| 死活監視・ステータス監視ツール | なし | サービスの到達性と応答時間のみ | 低: 数分 | ツールによる |
要件が「サービスが応答しなくなったら 1 分以内に知らせてほしい」なら、死活監視ツールがちょうどよい大きさの道具で、他の 2 つはそれには過剰です。ただし、スイッチをポーリングしてインターフェースのスループットを取ったり、Windows のパフォーマンスカウンターを読んだりはできないので、PRTG や SolarWinds の代わりにはなりません。時々同じ仕事と勘違いされる、別の仕事です。

どちらを運用すべきか
Zabbix を運用してください。既存の Prometheus 投資がない Windows 中心のネットワークでは、圧倒的に短い道です。運用すべきサーバー、データベース、Web フロントエンドは残りますが、監視モデル、テンプレート、アラートが複数の監視コンポーネントから組み立てられるのではなく、1 つの製品の中に収まります。
長期運用する監視環境では、短命な標準リリースではなく現行の Zabbix LTS ブランチを使ってください。Zabbix の LTS ライフサイクル は各リリースに 3 年間のフルサポートと、それに続く 2 年間の限定サポートを提供します。ここでは最新の機能リリースを追いかけることよりそちらの方が重要です。
例外は狭く具体的です。チームがすでに本番でアプリケーションとホストのメトリクス用に Grafana と Prometheus を運用していて、そのスタックにすでに責任者がいるなら、 snmp_exporter は保守すべき 2 つ目のシステムではなく、保守されているものへの追加です。この条件は連言です。両方の半分が成り立たなければなりません。去年誰かが 1 人で立てて放置された Grafana インスタンスは該当しません。
そして誰にも時間がないなら、更新してください。逃げではありません。別の正解を持つ別の状況です。移行はライセンスの請求書を運用の請求書に変えます。エージェントの展開、テンプレート作業、アップグレード、そして午前 2 時に直せるほどシステムを理解している人が必要です。すでに手一杯のチームはその仕事を雑にこなすか、まったくやらないでしょう。保守されない監視は静かに壊れるので、高価な監視より悪いのです。
ハイブリッドは現実的です。既存製品を縮小していく重要システムの中核に残し、それ以外をすべて Zabbix に移し、ライセンスのティアを時間とともに下げていく。これは機能します。ただし 2 つの監視システムを運用し、そのアラートを突き合わせることにもなるので、終了日のある移行状態として扱ってください。
移行で失われるもの
Zabbix 自身の移行ガイド には「移行されないもの」という節があり、そのリストは「移行」という言葉が示唆するより長いものです。履歴データとセンサーの測定値は引き継がれません。カスタムの PRTG 通知や依存関係も同様です。マップやダッシュボードも引き継がれません。2 つの製品のモデル化があまりに異なるため、変換するより作り直す方がよいからです。センサーそのものも引き継がれません。Zabbix はまったく別の概念で動くからです。
デバイス名、IP アドレス、インターフェース種別は引き継げます。それすら両方の API に対するカスタムのエクスポート・インポートスクリプトを通す必要があります。ガイドは、2 つのプラットフォーム間を直接移行する公式ツールは存在しないと明言しています。
あるチームが実際のコストを記録しています。VM と物理サーバー約 500 台、PRTG 利用約 7 年、低優先度のプロジェクト時間 6 か月をかけてゼロから再構築。PRTG のセンサー 2,500 個は Zabbix のアイテム 43,000 個になりました。2 つのシステムの数え方がどれほど違うかを端的に示しています。
「ゼロから始めてください。PRTG から Zabbix へ『このボタンを押せば移行』という選択肢はありませんし、あったとしても、こうした機会は以前の設計ミスを繰り返さない良いチャンスです。」
これは 1 つの組織の経験であって、ベンチマークではありません。規模の小さい環境ではそうした数字にはなりません。持ち越せるのは計画上の前提です。移行の時間ではなく、再構築の時間を予算に組んでください。
再構築の順序は、欠かせないものを基準に決めてください。アラートの継続性が心配なら、通知ルールを先に作り直し、ダッシュボードは後回しにします。レポートの履歴が心配なら、古いライセンスが切れる前に必要なものをエクスポートしてください。履歴は付いてきません。
サーバーのサイジング
Zabbix のハードウェア要件 は、監視メトリクス約 1,000 の小規模構成を CPU 2 コアとメモリ 8 GiB、約 10,000 メトリクスの中規模構成を 4 コアと 16 GiB としています。これが調達の根拠にする数字です。
サイジングを誤るのは単位のところです。Zabbix は監視メトリクス 1 つを 1 アイテム + 1 トリガー + 1 グラフと定義しています。メトリクスはデバイスでもホストでもありません。Windows Server 1 台は、設定したアイテムの数だけメトリクスを生みます。CPU、メモリ、ファイルシステムごと、サービスごと、サンプリングするカウンターごとです。デバイス数は必要なマシンの目安として頼りになりません。小さく聞こえる環境でも、誰も特別なことをしていないのに中規模帯に入ることがあります。
ホスト数より速く数字を押し上げる要素が 2 つあります。1 つ目はポーリング頻度です。更新間隔を半分にすると、その間隔のすべてのアイテムで書き込み速度が 2 倍になります。2 つ目は履歴の保持期間です。生の値をどれだけ長く保持するかに応じてデータベースが肥大化します。デバイス数が効いてくるのは主に、各デバイスが持ち込む監視アイテムの数を通じてです。
環境が通常の更新間隔と控えめな保持期間で 1,000 メトリクスの例に近いなら、小規模帯は妥当な出発点です。30 秒ごとにパフォーマンスカウンターをサンプリングし、生の履歴を 1 年保持するなら、そうではありません。Zabbix は公開している数値を「出発点となる規模とハードウェア構成の例」だと明言し、本番ハードウェアを確定する前にステージング環境でベンチマークすることを推奨しています。ベンダー自身の注意書きです。文字どおりに受け取ってください。
Zabbix はサーバーコンポーネントを Linux と UNIX でのみサポートしており、Windows ではエージェントのみがサポートされます。
メトリクスはデバイスではなく、その間の倍率こそがマシンの大きさを決めます。

root権限、NVMe、AMD EPYCのパワーを備えたLinux VPSで開発を。
Linuxプランを見る監視サーバーをどこに置くか
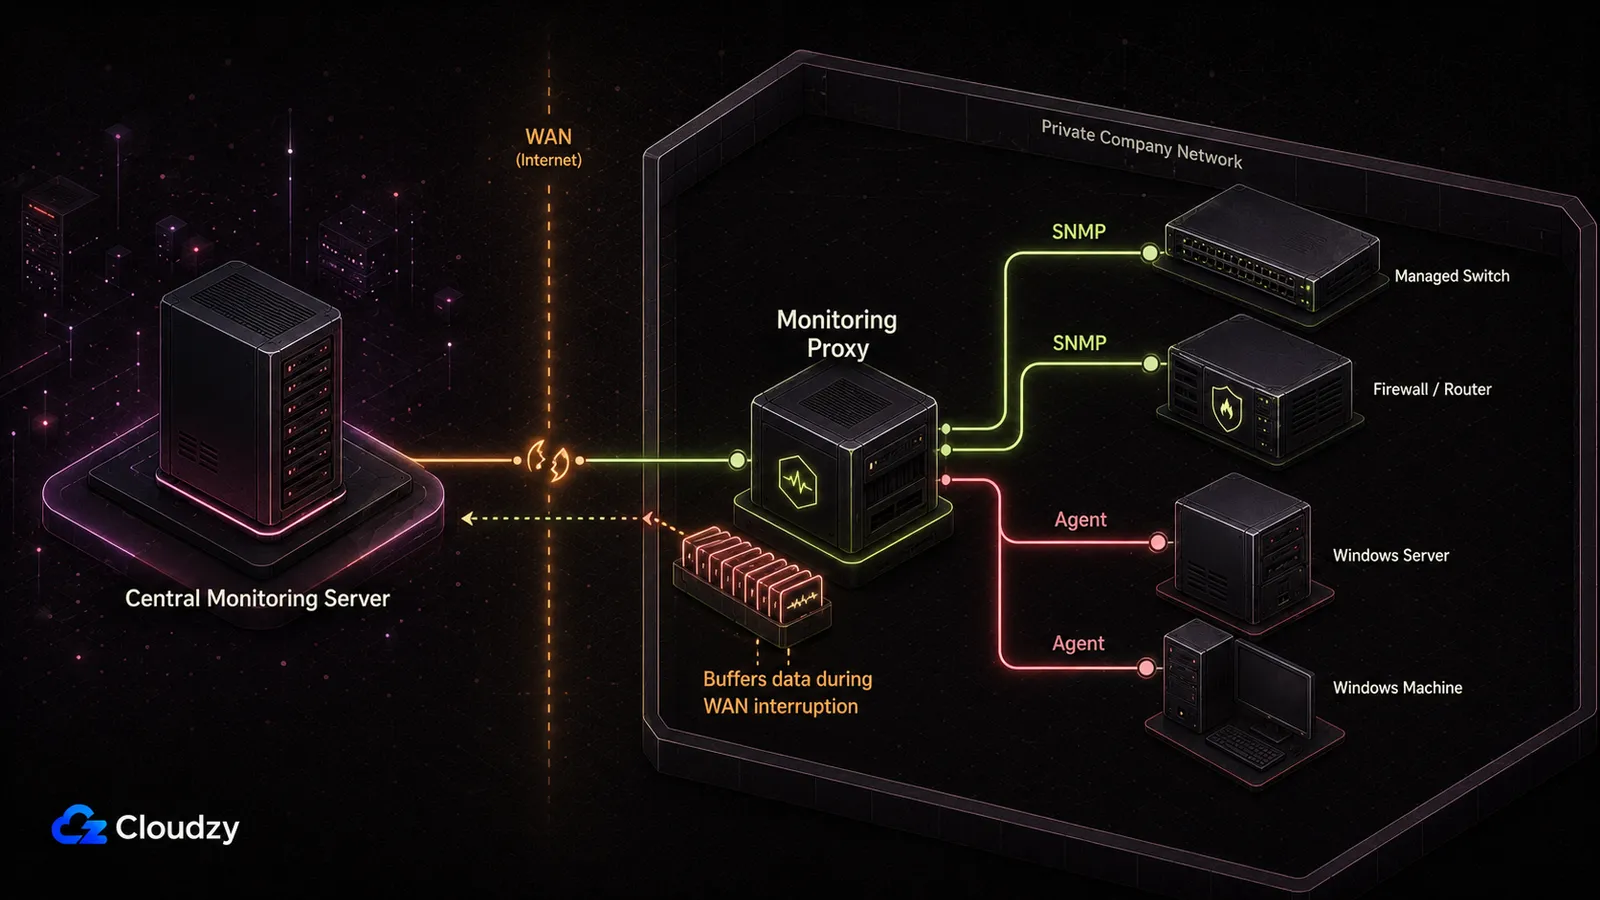
拠点全体の障害でも監視を生き残らせたいなら、中央の Zabbix サーバーをその拠点の障害ドメインの外に置いてください。そうすれば拠点のアップリンクが落ちても、監視対象ネットワークがオフラインになるだけで、監視サーバーまで道連れにはなりません。
プライベートネットワークでは、 Zabbix プロキシ を拠点内に置き、周囲のシステムから収集させることができます。プロキシは SNMP チェックとエージェントチェックをローカルで処理し、収集したデータを中央サーバーへ送り返し、両者の接続が途絶えている間は監視データをバッファリングできます。これにより、プライベートなスイッチ、ファイアウォール、Windows ホストのすべてをインターネットから直接到達可能にしなくても、中央サーバーを拠点外に置けます。
その中央サーバーの置き場所として、VPS は現実的な選択肢の 1 つです。初期インストールを飛ばしてホストとテンプレートの設定から始めたいなら、Cloudzy は Zabbixサーバー を Ubuntu Server 24.04 LTS 上のワンクリック展開として提供しています。
よくある質問
Zabbix は本当に無料ですか?
はい。Zabbix はバージョン 7.0 以降 GNU Affero General Public License バージョン 3 で公開されており、監視するデバイスやメトリクスの数にかかわらずソフトウェアのライセンス料はありません。Zabbix は技術サポートを別売りの任意サブスクリプションとして販売していますが、製品のどの機能もその裏に閉じ込められてはいません。Zabbix の運用コストは、動かすサーバーと運用に費やす時間です。
すべての Windows Server にエージェントをインストールする必要がありますか?
すべての Windows マシンに入れる必要はありませんが、Zabbix のネイティブな Windows 監視の深さを求めるなら、最も重要なサーバーにはエージェントをインストールする計画を立ててください。SNMP でも大まかなエージェントレスのデータは得られますが、Microsoft の Windows SNMP 機能は非推奨です。Zabbix の組み込み WMI チェックも Windows エージェント経由で動くため、Zabbix において WMI は直接のエージェントレス収集経路ではありません。イベントログ、サービス検出、WMI クエリ、詳細なパフォーマンスカウンターにはエージェントを使い、エージェントレスの SNMP は主にネットワーク機器とレガシーな Windows のケースに限ってください。
監視サーバーを Windows で運用できますか?
Zabbix では無理です。 Zabbix の要件ドキュメント は、サーバーコンポーネントを Linux とその他の UNIX プラットフォームでのみサポートすると記載し、「必要な性能、耐障害性、回復力を一貫して提供できるオペレーティングシステムは UNIX だけである」と述べています。Windows のサポートは、監視対象マシンにインストールする Zabbix エージェントとエージェント 2 が対象です。監視サーバーは Linux ホストに置かれ、Windows 環境はその監視対象です。
Prometheus は SNMP 監視ができますか?
単体ではできません。Prometheus は HTTP エンドポイントをスクレイプし、SNMP 機器からの収集には snmp_exporter を使います。既定の設定で一般的なスイッチやルーターの多くをカバーしますが、ベンダー固有のオブジェクトやカスタムのポーリングには追加の MIB 設定とジェネレーターが必要になることがあります。



ディスカッション
コメント
ログインしてディスカッションに参加してください。