

自分で作ったものが本番で動いています。監視はまったく無いか、あっても死活監視の ping ひとつ。先週は障害をユーザーから知らされました。探しにいく答えは、どれも同じ名前に行き着きます。
この Prometheus レビューが扱うのは、どちらも真である二つの事実のあいだにある落差です。無料でオープンソースであり、規模がどうであれライセンス料もメトリクス単位の請求もありません。同時に、一晩の時間と、まだ知らないクエリ言語ひとつを要求してきます。アラート機能を備えたプル型のメトリクス収集ツールであり、非常に優れたソフトウェアです。ただし、いまあなたが動かしている構成にとって適切なソフトウェアかどうかは別の問いであり、答える価値があるのはそちらです。
短いバージョン
- 結論:個人および小規模チームのセルフホストで 3.5 / 5。 ホストとサービスの構成がそれなりに安定していて、PromQL を学ぶ時間を割くつもりがあり、サブスクリプションも保持期間の請求もない完全に自分のものであるメトリクスが欲しいなら、Prometheus は動かす価値があります。
- 必要な答えが「動いているか」だけなら、見送ってください。 死活監視ツールならその答えにずっと早くたどり着けますし、その仕事のために Prometheus を持ち出すのは、10 分で片づいたはずのことに答えるためにクエリ言語の代金を払うようなものです。
- 何度でも戻ってくるコストが PromQL です。 セットアップは一度きりのコストです。ところが、あなたの問いが出来合いのダッシュボードと Grafana のビジュアルクエリビルダーを超えた瞬間、また PromQL に戻ってきます。
- 維持コストは、構成のうちどれだけを手作業で管理しているかに比例します。 形を保ち続けるサーバー群は監視が安く済みます。ホストが増え、減り、名前が変わり続ける側こそ、コストが静かに積み上がる場所です。
- この結論は小規模なセルフホストに限定したものです。 Kubernetes や本番 SRE の規模では Prometheus はまったく別の提案になりますし、本稿はその問いに答えようとはしていません。
このレビューの作り方: Prometheus は無料でオープンソースなので、ここにベンダーとの関係はありませんし、誰かから何かを送られたわけでもありません。バージョンやストレージの挙動に関する事実は Prometheus 自身のドキュメントによります。リソース使用量とセットアップ時間の数字は、独立に公開された二つの実地テストから取り、それぞれ使った箇所で出典を示しています。二つが食い違うところでは、平均を取らずに両方の数字をそのまま示します。
このレビューが扱う範囲
上の結論には境界があり、ここではその境界が普段以上に効いてきます。Prometheus は規模が変わると別のツールのように振る舞うからです。
- 対象は、VPS 1 台と小規模プロジェクトでのセルフホストにおける Prometheus の評価です。ホストとサービスがひと握り、面倒を見る人はひとり、という状況を指します。
- Kubernetes は対象外です。Prometheus Operator、ServiceMonitors、kube-prometheus-stack は別の運用世界であり、ここでの結論はそちらについて何も語りません。
- Alertmanager のルーティング解説でもありません。アラート機能は存在し、きちんと動きます。ただし、ルートやサイレンス、レシーバーの設定はそれ自体で一つの主題です。
- インストール手順書でもありません。ここでの問いは、そもそも動かすべきかどうかです。そちらにすでに答えが出ているなら、当社の Grafana と Prometheus を Docker Compose で動かすガイドが 手順を解説しています。
- エクスポーターの総覧でもありません。エクスポーターは、答えが変わる場面でだけ登場します。
Prometheus が正しくやっていること
Prometheus は一銭もかかりません。「有料アップグレード付きの無料プラン」でもなければ、「メトリクスの上限を超えるまで無料」でもありません。 リポジトリは全体が Apache 2.0 ライセンス下にあり コアプロジェクトに有料版は存在せず、ホスト単位、メトリクス単位、ラベル単位の課金もどこにもありません。Prometheus が生み出す唯一の請求は、それが動いているサーバーだけです。
これから頼りにしようというものについて、「三年後もここにあるのか」は当然の問いです。そしてこの点では、オープンソースとして望みうるかぎり良い見込みが立っています。Prometheus は 2018 年 8 月に CNCF を卒業しました。Kubernetes に次ぐ、史上二例目の卒業プロジェクトです。リリースも安定していて、 v3.13.2 が 2026 年 7 月末に出ています。このリリースラインは長期サポートラインなので、1 年間にわたって バグ修正、セキュリティ修正、ドキュメント修正を 受け取れます。つまり、パッチを当て続けることは、マイナーバージョンを一つ残らず追いかけることを意味しません。
周辺のエコシステムがこれほど厚いのは、データモデルのおかげです。Prometheus は HTTP でメトリクスを収集し、各時系列をメトリクス名とキー/値のラベルで識別します。そのおかげでエクスポーターを書くのは小さな仕事で済みます。だから、現実に動かしそうなものにはたいていエクスポーターが存在します。ノードのメトリクス、Postgres、Nginx、Redis、そして外側からしか突けない対象のための blackbox プローブまで。
そして収集したものはあなたのものです。この点は初日ではなく、あとになって効いてきます。小さな構成の履歴が使うディスクは取るに足らない量で(数字は後述します)、来四半期に誰かが値付けし直すこともなく、誰かがアプリに計測を一つ足すたびに膨らむ請求項目もありません。開発者がラベルを一つ足しただけでマネージド監視の請求が上がっていくのを見たことがあるなら、議論のすべてがその一文に収まっています。
Prometheus が見た目より高くつくところ
小さな VPS 1 台で 7 つの監視ツールを試した dev.to のテストでは Prometheus 単体のセットアップに 15 分かかると計測されました。そのテスト実施者がそうしたように、Grafana と組み合わせてください。組み込みの式ブラウザは、クエリを実行してみるだけの場所だからです。同じテストでは、Grafana + Prometheus は最初のグラフが出るまで 35 分、その途中に YAML のスクレイプ設定が挟まっています。
分単位の時間は安いほうです。高いのは PromQL です。Prometheus はすべてを名前とラベルで識別される時系列として保存し、あなたが投げる問いの下にあるのは依然として PromQL です。Grafana には今やビジュアルビルダーがあるので、すべてのクエリを手書きする必要はありません。テスト実施者自身の評価は率直でした。PromQL はその中で暮らす人には素晴らしい、そして自分はそうではなかった、と。クエリ言語を使ったことがないなら、一晩以上を見込んでおき、ビジュアルビルダーで足りなくなるたびにそこへ戻ることを覚悟してください。誰かからコピーしてきたダッシュボードは、その誰かの問いに答えます。あなたの問いは、まだ書いていないクエリです。
三つ目のコストは、しばらく経つまで表に出てきません。 ある運用者による三週間の記録は 7 ノード構成にサーバーを 1 台足すことが具体的に何を意味したかを克明に書いています。ラベルの付け直し、スクレイプ設定の再点検、ダッシュボード変数の編集、そして新しいホストがドロップダウンに現れるようテンプレートのクエリを作り直すこと。その運用者は三週間でこのスタックを手放しました。インフラを見ているよりダッシュボードを調整している時間のほうが長い、という結論に至ったからです。
この種の構成で、そのコストが何に結びついているかに注目してください。手作業で管理されたターゲットとダッシュボードです。静かな二年間 Prometheus を動かし続けること自体は、ほとんど追加コストになりません。
Prometheus には実際どれだけのメモリとディスクが要るのか?
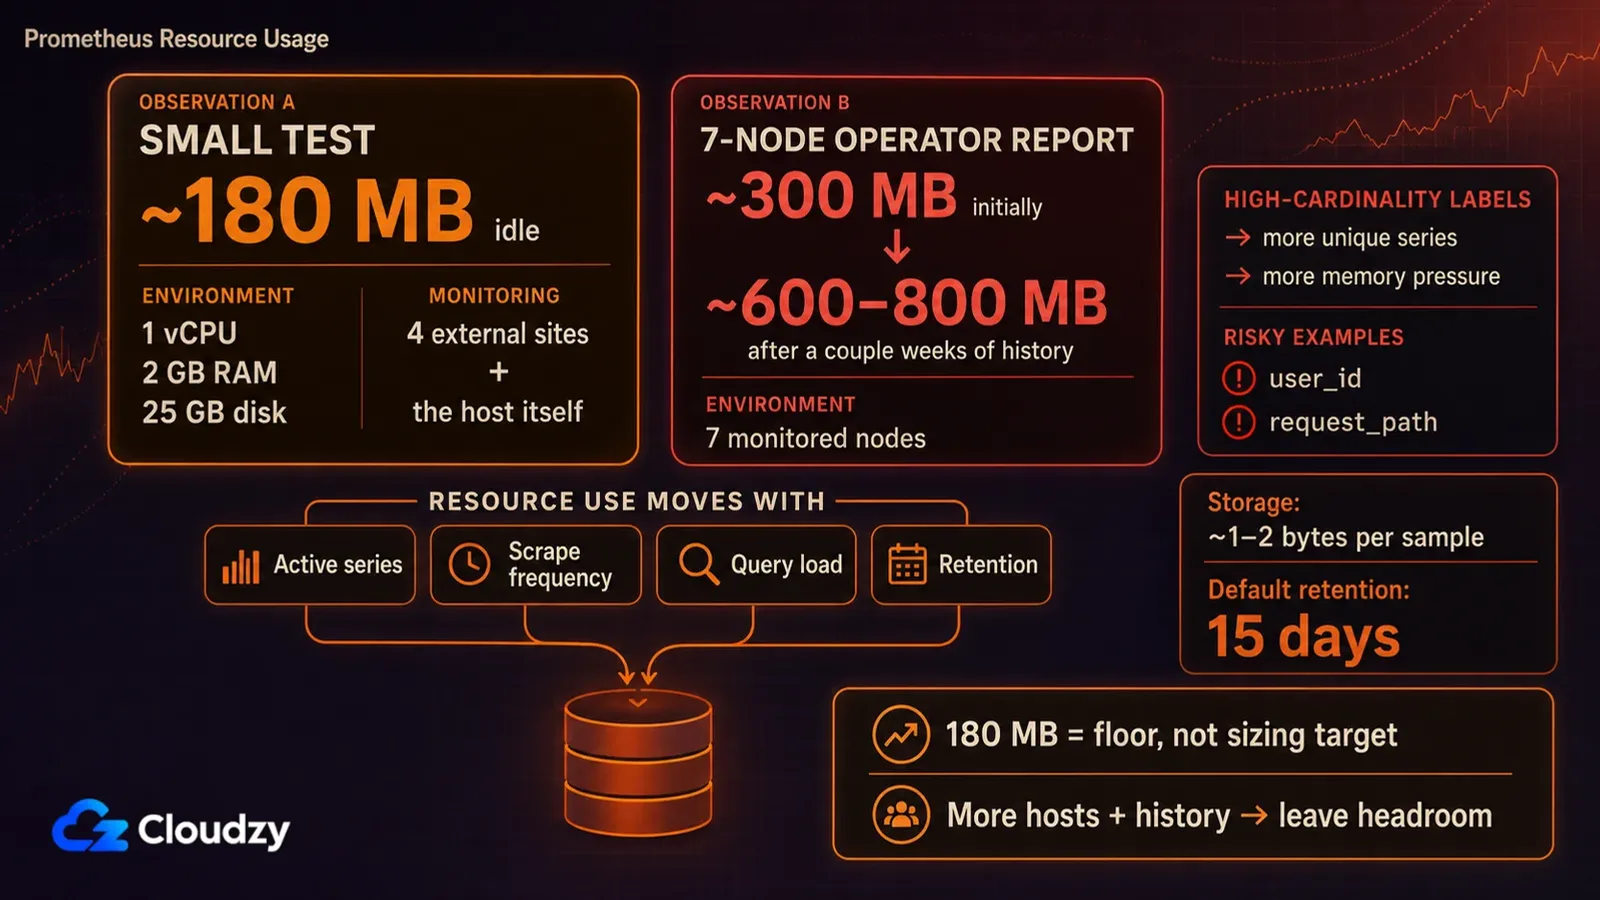
決まった要件はありません。アクティブな時系列数、スクレイプ頻度、クエリ負荷、保持期間のほうが、対象サーバーの台数そのものより効いてきます。小規模構成を扱った公開済みの実地テスト二件は、おおむね 180 MB から 800 MB のあいだに置いており、高いほうの数字は二週間ほどの履歴を持つ 7 ノードに対応します。
二つのテストは食い違っていて、有用なのはまさにその食い違いです。同じ 7 ツールの VPS 比較は、すべてを同一のハードウェア(1 vCPU、メモリ 2 GB、ディスク 25 GB、Ubuntu 24.04)で動かし、外部サイト 4 つとホスト自身を監視しながら、Prometheus をアイドル時約 180 MB と計測しました。同じ運用者は、中央ホスト上で Prometheus 単体がアイドル時に 300 MB 前後にとどまり、二週間ほどの履歴がたまると 600 〜 800 MB へ向かって上がったと報告しています。
この二つは同じ測定ではなく、だからこそ平均を取れば情報を捨てることになります。片方は、保存するものがほとんどない機械でのほぼアイドル時の値です。もう片方は、背後にサーバー群を抱え、ディスクに履歴を積んだ稼働中の環境です。私の読みはこうです。180 MB という結果は下限として扱い、サイジングの目標にはしないこと。複数ホストから収集して履歴を保持し始めたら、そのアイドル値に合わせて計画するのではなく、余裕を持たせてください。
ディスクは簡単なほうの半分です。Prometheus のストレージのドキュメントはサンプルあたり平均 1 〜 2 バイトとしており、小さな構成で長い履歴を保つのは安上がりです。落とし穴はデフォルト値のほうにあります。 保持期間のデフォルトは 15 日です 保持時間か保持サイズを設定しない限り、そのままです。1 年にするには起動フラグ一つ足りないだけであり、これはまさに、先月の数字を探しにいって三週間前に期限切れになっていたと知る場面ではなく、いま知っておきたい類のデフォルトです。
メモリの数字を押し上げるのはカーディナリティ、つまり異なる時系列の数です。あるメトリクスに付くラベルの組み合わせが一つ異なれば、それぞれが独立した時系列になります。トラフィックの多いメトリクスに選び方を誤ったラベルを一つ足すだけで、サーバーを 5 台増やすより多くの時系列が生まれることがあり、しかもそれはトラフィックの流れる速さのまま、静かに起こります。(ユーザー ID やリクエストパスは、いくつ値があるか数えるまでは素晴らしいラベルに見えます。)
Prometheus について引用されているメモリの数字は、その背後に時系列がいくつあったのかを併せて知っていて初めて使いものになります。
Prometheus サーバーが落ちたら何が起きるのか?
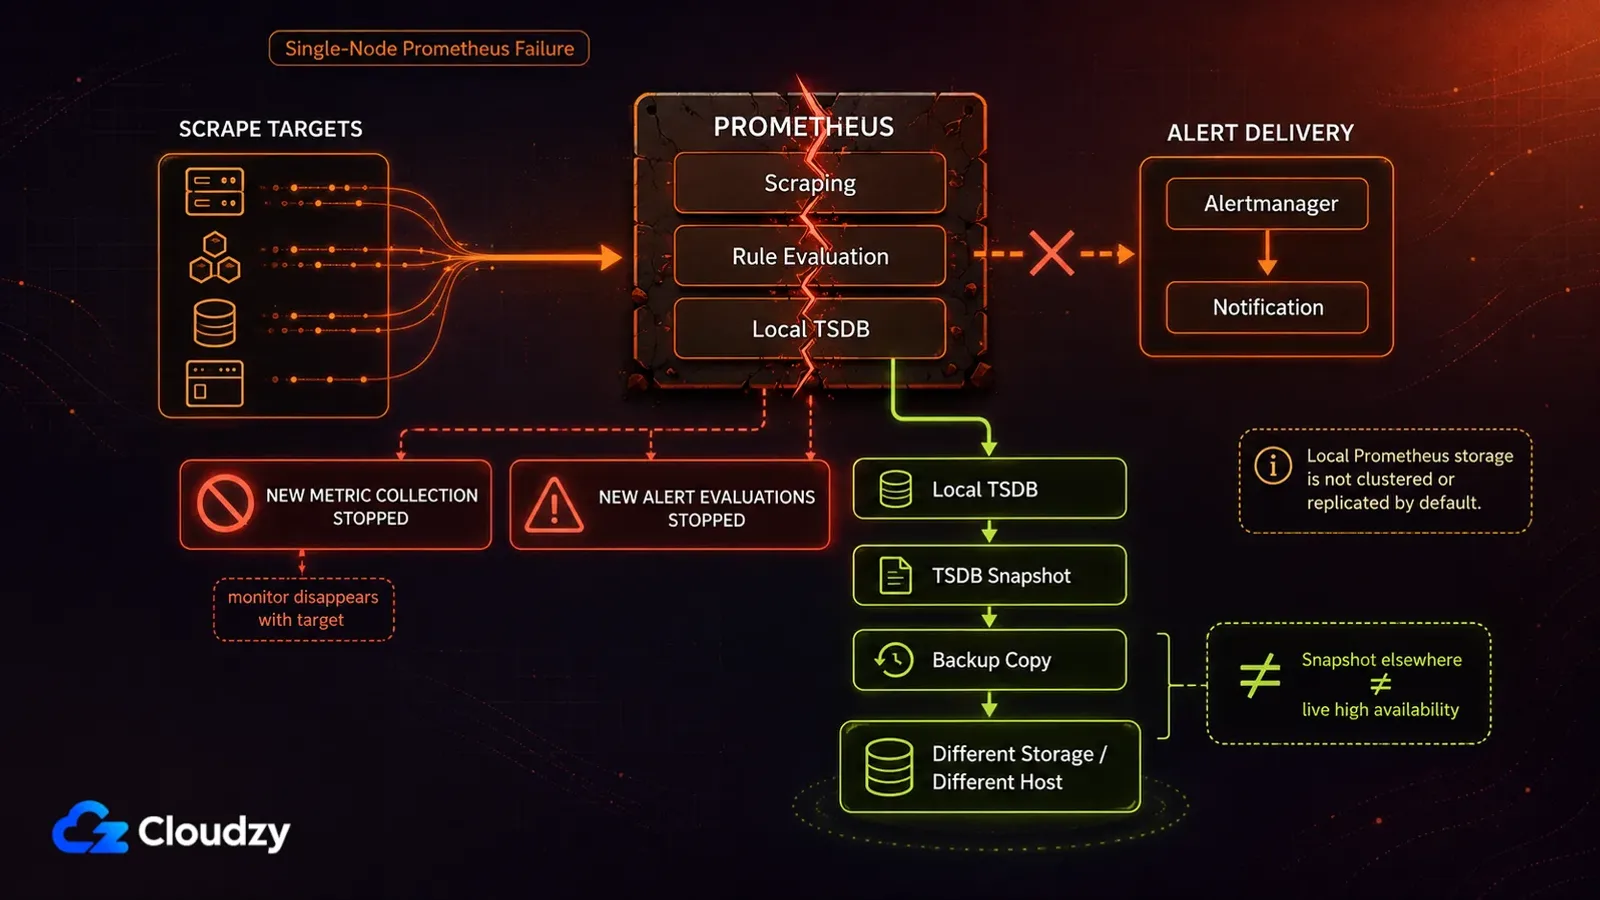
Prometheus 自身のストレージのドキュメントはこの点について率直です。ローカルストレージは クラスタ化もレプリケーションもされていません。したがって、ドライブやノードの障害には耐えられません。各サーバーは設計上そのまま独立していて、ネットワークストレージにもリモートサービスにも依存しません。それこそが運用を容易にしている理由であり、それこそが無防備なままにしている理由でもあります。
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
プロジェクトが自らについて述べているもう一つの境界があり、それを明言している点は評価に値します。 100% の正確さが必要なら、たとえばリクエスト単位の課金のような用途では、Prometheus は誤った選択だとドキュメントは述べています。収集されるデータが十分に詳細かつ完全である見込みが薄いからです。請求の根拠になる数字には別のものを使い、Prometheus は監視に充ててください。ベンダーが自分についてこの種のことを進んで言うのは、あまりないことです。
より大きな規模には定石となった答えがありますが、Kubernetes 周りのツールと同じ理由でここでは範囲外です。本稿が扱うのとは別の水準の運用コミットメントを伴うからです。VPS 1 台についての私の読みはこうです。TSDB のスナップショットを別の場所に保管するか、履歴を失うことを最初から受け入れるなら、この露出は許容できます。ただし、あなたと静かな障害のあいだに立っているのが Prometheus だけなら、それは本物の問題です。
誰が Prometheus を自前で運用すべきか?
Prometheus がかけたコストを返してくれるかどうかを最もはっきり示す手がかりは、サーバーが何台あるかとは無関係です。半年後もそれが同じサーバーかどうかです。手で設定した安定したホスト群なら、設定は一度書けば済み、履歴はただで積み上がります。変わり続ける構成なら、その設定に何度も手を入れ続けることになります。
静的な構成では、Prometheus と Grafana の設定はインフラそのものの明示的な記述になります。スクレイプ対象、そこに付いたラベル、そしてそのラベルの上に組み上げたダッシュボードです。だからこそ、見返りのすべては履歴にあります。安定したホスト群についての一年分のデータは、正常がどう見えるかを教えてくれます。それは、異常が障害になる前に気づくための最も確かな方法です。
そこで一つ目の像は、小さくゆっくりとしか変わらないサーバー群を運用していて、動いているか落ちているか以上のものを求めている人です。時間軸で見るリクエストの遅延、メモリの傾向、数週間先から見えるほどゆるやかに埋まっていくディスクといったものです。今日の自分のインフラを言葉にできて、その説明が一年後もおおむね正しいと見込めるなら、セットアップに費やすその一晩が最後の大きな支払いになります。
二つ目は、このスタックを意識して学ぼうとしている人すべてです。数年後も自分のものであれ他人のものであれインフラを扱っているつもりなら、PromQL に費やす一晩こそが目的であり、監視のほうが副産物です。この像は一つ目を部分的に裏返します。ここでは安定性という条件の重みが下がります。ラベルを付け直す時間は、ラベルの付け直しとは何かを学ぶ時間でもあるからです。この読者向けなら、評価は上げます。
三つ目の像は所有権についてで、痛い目を見るまで人が過小評価しがちなものです。Prometheus はホスト単位でもメトリクス単位でもラベル単位でも課金せず、どんな価格ページも来四半期にあなたの足元で書き換わることはありません。Datadog のようなマネージドサービスとの取引はこうです。洗練された仕上がりと、サポート契約と、他人が担ってくれるオンコールを手放す代わりに、開発者が計測を足しても動かない請求と、完全に自分のものであるメトリクスを手にします。それが良い取引かどうかは自分の時間がいくらの価値かによりますし、その数字を入れられるのはあなただけです(そしてゼロに感じるときでも、実際にゼロであることはめったにありません)。
決断の前に知っておくべきことが一つ。Prometheus のローカルストレージを超えて育つことは行き止まりではありません。VictoriaMetrics は Prometheus の remote write を受け付けます、そして MetricsQL は PromQL と後方互換です。ですから、いま組み立てているクエリと Grafana のダッシュボードは、その大半が移行後もそのまま生き残るはずです。これは移行であって、書き直しではありません。
一度決めて終わりにするより、年に一度見直す価値があります。今日は監視が安く済む構成も、それを作り直し始める四半期には高くつきます。

root権限、NVMe、AMD EPYCのパワーを備えたLinux VPSで開発を。
Linuxプランを見る誰が Prometheus を見送るべきか?
自分の必要を説明するのに使う一文が「サイトが落ちたら教えて」なら、あなたが説明しているのは死活監視ツールであり、その答えにたどり着くために Prometheus は装置として大がかりすぎます。 Uptime Kuma はまさにその仕事を Web の画面でこなし、監視用のクエリ言語を学べとも言いません。二つのツールの能力差はとてつもなく大きく、そしてあなたが任せたい仕事とはまったく関係がありません。
二人目の読者は、先にクエリ言語を学ばずに使えるグラフが欲しい人です。Netdata はまさにそれを軸に作られています。ホストごとのメトリクスをすぐに見られ、設定はずっと少なく、あなたとグラフのあいだに何も挟まりません。繰り返し投げかけている問いが「この機械はいまなぜ遅いのか」なら、答えまでの道のりははるかに短くなります。
三人目は、インフラの形が頻繁に変わり、そのうえターゲットとダッシュボード変数を手で管理している人すべてです。一週間だけ立てて壊すホスト、名前を変えられるターゲット、途中で改名されるプロジェクト。設定のコストを何度も何度も払いながら、支払っているもの、つまり見分けのつく状態を保った システムの連続した履歴からは、最も少ししか得られない状況です。
どれもこのツールへの非難ではありません。ここでの「見送る」は、この仕事について、この規模において見送る、という意味です。サービスディスカバリが手で配線するはずの大半を引き受ける Kubernetes の規模では、上に挙げたコストのいくつかは縮むか、まるごと消えます。その規模についての私の読みは、そこで Prometheus を上回るのは非常に難しい、というものです。ただしそれは別のレビューです。

よくある質問
Prometheus は無料ですか?
はい、そしてその下に無料プランの落とし穴もありません。Prometheus は Apache 2.0 ライセンスで、背後に商用版もないので、超えるべきメトリクスの上限も、向こう側で待っているアップグレードの案内もありません。あなたが払うのはインフラ代と自分の時間であって、Prometheus のライセンス料ではありません。
Prometheus に Grafana は必要ですか?
必要ではありませんが、使う前提で考えてください。Prometheus 付属の式ブラウザは、クエリを一つ実行して答えを見るためのもので、何かを一度確認する用途はそれで足ります。二枚目のモニターに開きっぱなしにしておきたいものは、すべて Grafana の仕事です。そして、この二つはほぼ必ず一緒に運用されます。
サーバー 1 台に Prometheus は大げさですか?
多くの場合そうです。サーバーとそのサービスが動いているかどうかを知りたいだけなら、死活監視ツールがセットアップ時間のごく一部で答えてくれます。Prometheus がその場所に値するのは、クエリできる過去のメトリクスが欲しく、そこへ手を伸ばすために PromQL を学ぶ気があるときです。
Prometheus はデフォルトでメトリクスをどれくらい保持しますか?
15 日です。しかも事前に警告はしてくれません。起動時に保持時間または保持サイズのフラグで広げない限り、Prometheus は保持期間より古いサンプルを捨てます。インストールしたその日に設定してください。あとから期間を広げても、すでに期限切れになったデータは戻ってきません。



ディスカッション
コメント
ログインしてディスカッションに参加してください。