

Iets dat je zelf hebt gebouwd draait in productie. Je monitoring is ofwel helemaal niets, ofwel een uptime-ping, en vorige week hoorde je van een storing via een gebruiker. Elk antwoord waar je naar zoekt wijst naar dezelfde naam.
Deze Prometheus-review gaat over het gat tussen twee dingen die allebei waar zijn. Het is gratis en open source, zonder licentie en zonder rekening per metriek, op welke schaal dan ook. Het kost je ook een avond plus een querytaal die je nog niet kent. Het is een pull-gebaseerde metriekverzamelaar met alerting erbij, en het is uitstekende software. Of het de juiste software is voor de setup die je nú draait, is een andere vraag, en dat is de vraag die het waard is om te beantwoorden.
De korte versie
- Oordeel: 3,5 / 5 voor zelf hosten in je eentje of met een klein team. Prometheus is het draaien waard als je verzameling hosts en services redelijk stabiel is, je de tijd neemt om PromQL te leren, en je metrieken wilt die helemaal van jou zijn, zonder abonnement en zonder rekening voor bewaartermijn.
- Sla het over als de vraag die je beantwoord wilt zien „doet het het nog” is. Een uptime-checker brengt je daar veel sneller, en Prometheus voor die taak inzetten betekent dat je een querytaal betaalt om iets te beantwoorden dat je in tien minuten had kunnen afhandelen.
- PromQL is de kostenpost die blijft terugkomen. Het opzetten is een eenmalige kostenpost. Zodra je vragen de kant-en-klare dashboards en de visuele bouwer van Grafana ontgroeien, zit je weer in PromQL.
- De onderhoudskosten volgen hoeveel van de setup je met de hand beheert. Een vloot die haar vorm behoudt is goedkoop te monitoren. Een vloot die hosts wint, verliest en hernoemt is precies waar de kosten stilletjes oplopen.
- Dit oordeel geldt alleen voor zelf hosten op kleine schaal. Op Kubernetes- en productie-SRE-schaal is Prometheus een heel ander voorstel, en deze review probeert die vraag niet te beantwoorden.
Hoe deze review tot stand kwam: Prometheus is gratis en open source, dus er is hier geen leveranciersrelatie en niemand heeft me iets gestuurd. De feiten over versies en het opslaggedrag komen uit de eigen documentatie van Prometheus. De resourcecijfers en installatietijden komen uit twee onafhankelijk gepubliceerde praktijktests, met bronvermelding op de plek waar elk ervan wordt gebruikt. Waar die twee elkaar tegenspreken, zie je beide cijfers in plaats van een gemiddelde.
Wat deze review behandelt
Het oordeel hierboven heeft grenzen, en die grenzen tellen hier zwaarder dan gebruikelijk, omdat Prometheus zich op verschillende schalen als een ander gereedschap gedraagt.
- Prometheus beoordeeld voor zelf hosten op één VPS en voor kleine projecten: een handvol hosts en services, één persoon die ernaar omkijkt.
- Niet Kubernetes. Prometheus Operator, ServiceMonitors en de kube-prometheus-stack vormen een aparte operationele wereld, en het oordeel hier zegt daar niets over.
- Geen handleiding voor Alertmanager-routing. Alerting bestaat en werkt; routes, silences en receivers configureren is een onderwerp op zich.
- Geen installatiehandleiding. De vraag hier is of je het überhaupt moet draaien. Heb je die al beantwoord, dan beschrijft onze gids voor Grafana en Prometheus met Docker Compose de stappen.
- Geen overzicht van exporters. Exporters komen alleen ter sprake waar ze het antwoord veranderen.
Wat Prometheus goed doet
Prometheus kost niets. Geen „gratis laag met betaalde upgrades”, geen „gratis totdat je een metriek-limiet overschrijdt”. De repository is van begin tot eind gelicentieerd onder Apache 2.0 en er is geen betaalde editie van het kernproject, en nergens wordt er per host, per metriek of per label afgerekend. De enige rekening die Prometheus ooit oplevert, is de server waarop het draait.
Voor iets waar je van plan bent op te leunen is „staat dit er over drie jaar nog” een terechte vraag, en hier zijn de kansen ongeveer zo goed als het bij open source wordt. Prometheus is in augustus 2018 als graduated project uit de CNCF gekomen, als tweede project ooit, na Kubernetes. Releases verschijnen gestaag, met v3.13.2 die eind juli 2026 uitkwam, en omdat die release-lijn een long-term-support-lijn is, krijgt hij bugfixes en beveiligings- en documentatiecorrecties een jaar lang, dus bijblijven met patches betekent niet dat je achter elke minor versie aan moet.
Het datamodel verklaart waarom het ecosysteem eromheen zo diep is. Prometheus haalt metrieken op via HTTP en identificeert elke reeks met een metrieknaam plus key/value-labels, waardoor een exporter schrijven een klein klusje is. Er bestaan dus exporters voor zo ongeveer alles wat je plausibel draait: node-metrieken, Postgres, Nginx, Redis, blackbox-probes voor de dingen die je alleen van buitenaf kunt aanprikken.
En jij bent eigenaar van wat het verzamelt, en dat is het deel dat later meer telt dan op dag één. De historie van een kleine setup neemt een onopvallende hoeveelheid schijfruimte in beslag (cijfers hieronder), niemand kan die volgend kwartaal opnieuw beprijzen, en er is geen regel op de rekening die groeit zodra iemand instrumentatie aan een applicatie toevoegt. Als je ooit een rekening voor beheerde monitoring hebt zien oplopen omdat een ontwikkelaar één label toevoegde, staat het hele argument in die ene zin.
Waar Prometheus je meer kost dan het lijkt
Een dev.to-test van zeven monitoringtools op één kleine VPS mat voor Prometheus alleen 15 minuten installatietijd. Combineer het met Grafana, zoals die tester deed, want de ingebouwde expression browser is alleen een plek om queries uit te voeren. Dezelfde test zet Grafana + Prometheus op 35 minuten tot de eerste grafiek, met YAML-scrapeconfiguratie ertussen.
De minuten zijn het goedkope deel. PromQL is het dure. Prometheus slaat alles op als tijdreeksen, geïdentificeerd met naam en labels, en PromQL blijft de taal onder de vragen die je stelt. Grafana heeft inmiddels een visuele bouwer, dus je hoeft niet elke query met de hand te schrijven. Het oordeel van de tester zelf was onomwonden: PromQL is geweldig als je erin leeft, en dat deed hij niet. Heb je nog nooit een querytaal gebruikt, reken dan op meer dan één avond, en ga ervan uit dat je erop terugkomt zodra de visuele bouwer niet meer volstaat. Een dashboard dat je van iemand anders hebt gekopieerd beantwoordt diens vragen. De jouwe zijn een query die je nog niet hebt geschreven.
De derde kostenpost is degene die pas later opduikt. Een verslag van drie weken door een beheerder beschrijft precies wat het toevoegen van één server aan een setup met zeven nodes inhield: opnieuw labelen, scrapeconfiguraties opnieuw nalopen, dashboardvariabelen aanpassen en templatequeries herzien zodat de nieuwe host in de keuzelijsten zou verschijnen. Die beheerder gaf de stack na drie weken op, met de conclusie dat hij meer tijd kwijt was aan het bijschaven van dashboards dan aan het bekijken van zijn infrastructuur.
Let op waar die kostenpost in dit soort setups aan vastzit: aan targets en dashboards die met de hand worden beheerd. Prometheus twee rustige jaren laten draaien kost je daarbovenop bijna niets.
Hoeveel RAM en schijfruimte heeft Prometheus echt nodig?
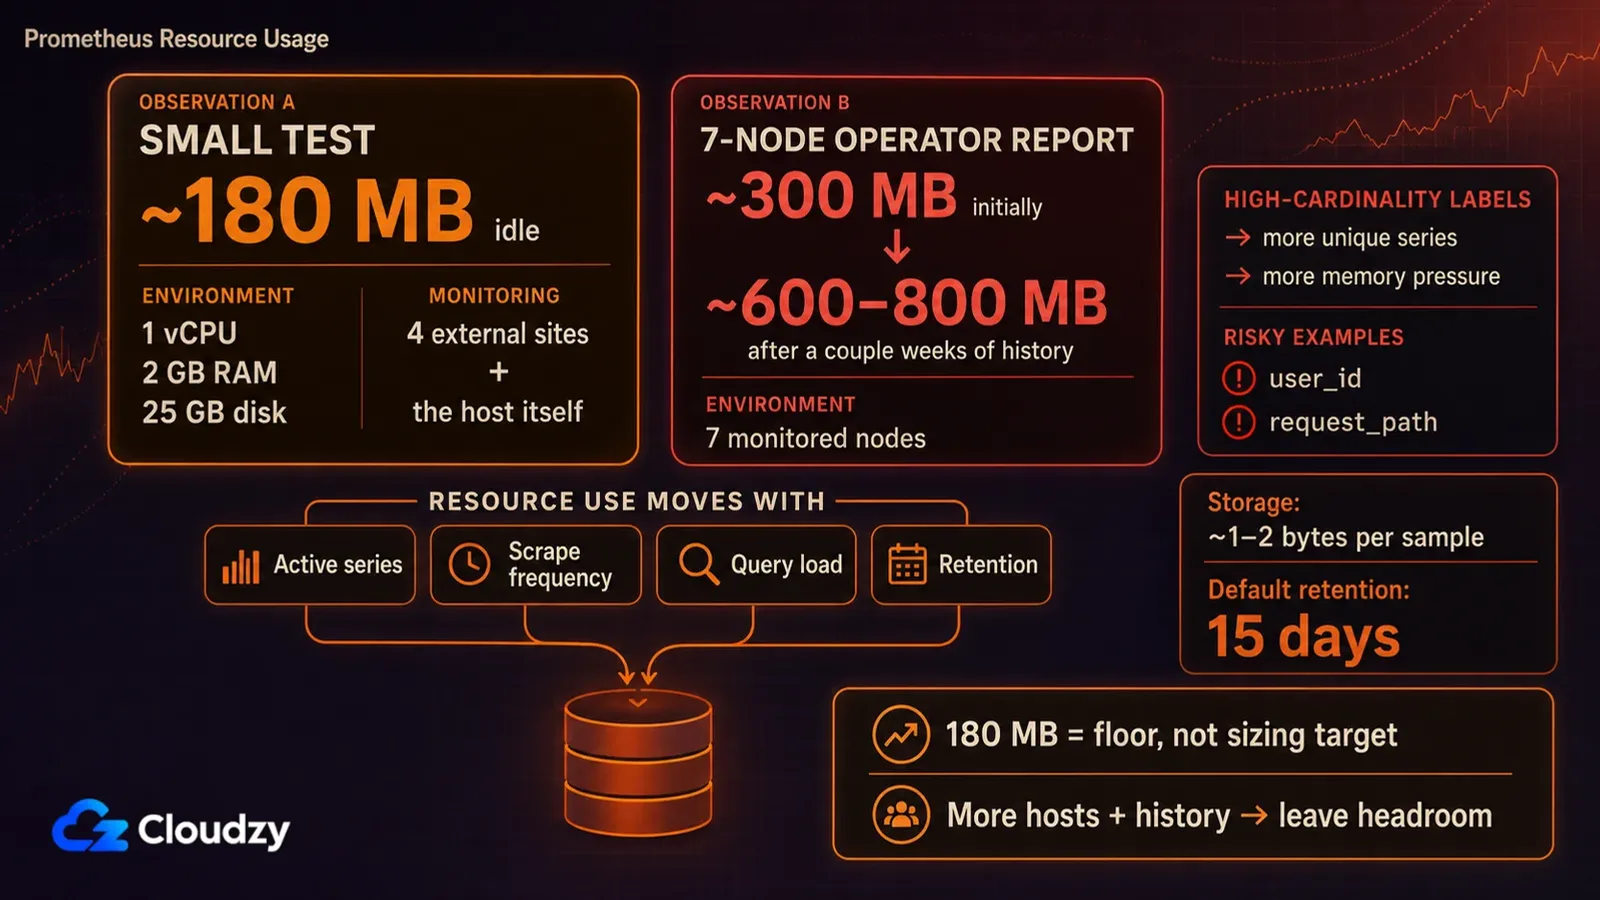
Er is geen vaste eis. Actieve reeksen, scrapefrequentie, querybelasting en bewaartermijn tellen zwaarder dan het kale aantal servers waar je het op richt. Twee gepubliceerde praktijktests van kleine setups zetten het tussen ruwweg 180 MB en 800 MB, waarbij het hoogste cijfer zeven nodes met een paar weken historie dekt.
De twee tests spreken elkaar tegen, en juist die tegenspraak is het nuttige deel. Diezelfde VPS-vergelijking van zeven tools draaide elk ervan op identieke hardware (1 vCPU, 2 GB RAM, 25 GB schijf, Ubuntu 24.04), hield vier externe sites plus de host zelf in de gaten, en mat Prometheus op ongeveer 180 MB in rust. Dezelfde beheerder meldde dat Prometheus alleen rond 300 MB stationair draaide op de centrale host, en richting 600 à 800 MB klom zodra er een paar weken historie was opgebouwd.
Dat zijn niet dezelfde metingen, en daarom zou middelen de informatie weggooien. De ene is een bijna stationaire aflezing op een machine met heel weinig op te slaan. De andere is een draaiende deployment met een vloot erachter en historie op schijf. Mijn lezing: behandel de 180 MB als ondergrens, niet als dimensioneringsdoel. Zodra je van meerdere hosts verzamelt en historie bewaart, houd dan marge aan in plaats van op dat stationaire getal te plannen.
Schijfruimte is de makkelijke helft. De opslagdocumentatie van Prometheus zet het op gemiddeld 1 tot 2 byte per sample, dus een lange historie bewaren voor een kleine setup is goedkoop. Het addertje zit in de standaardwaarde: de bewaartermijn staat standaard op 15 dagen tenzij je een bewaartijd of een bewaargrootte instelt. Eén startvlag scheidt dat van een heel jaar, en het is het soort standaardinstelling waarvan je liever nu hoort dan de eerste keer dat je de cijfers van vorige maand zoekt en merkt dat ze drie weken geleden zijn verlopen.
Wat het geheugengetal omhoog drijft is kardinaliteit: het aantal verschillende tijdreeksen, waarbij elke unieke combinatie van labels op een metriek een eigen reeks wordt. Eén slecht gekozen label op een metriek met veel verkeer kan meer reeksen aanmaken dan vijf extra servers ooit zouden doen, en het doet dat geruisloos, in precies het tempo waarin jouw verkeer toevallig loopt. (Een gebruikers-ID of een request-pad lijkt een prima label, tot je telt hoeveel er zijn.)
Elk RAM-getal dat je over Prometheus geciteerd vindt is alleen bruikbaar als je ook weet hoeveel reeksen erachter zaten.
Wat gebeurt er als je Prometheus-server uitvalt?
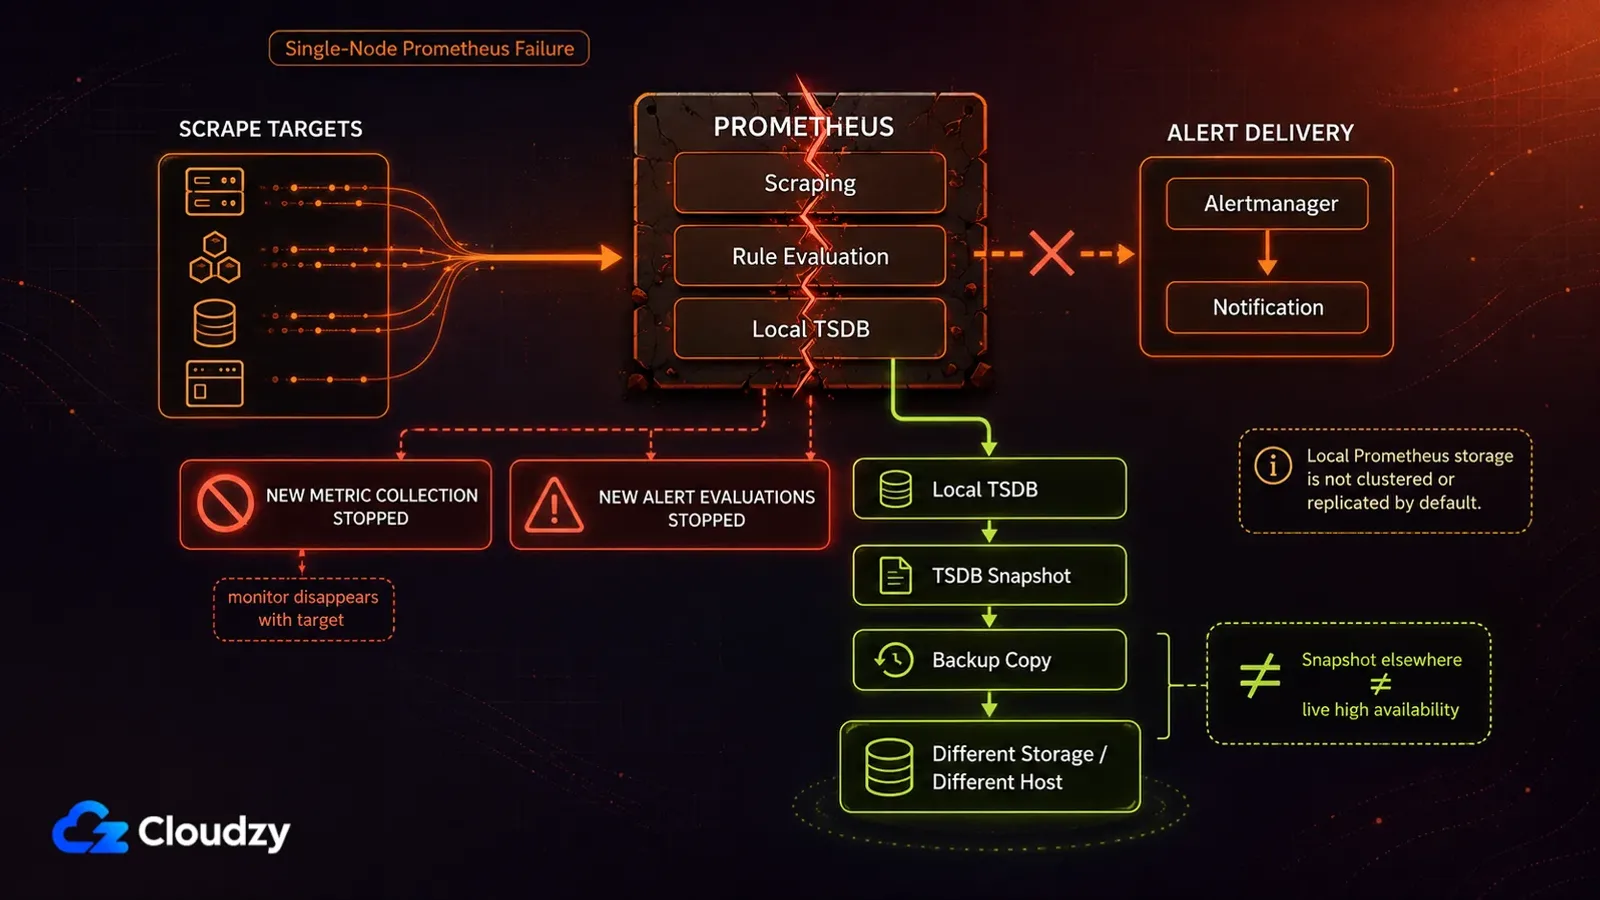
De eigen opslagdocumentatie van Prometheus is hier duidelijk over: lokale opslag is niet geclusterd of gerepliceerd, waardoor het een schijf- of node-storing niet overleeft. Elke server staat per ontwerp op zichzelf en is niet afhankelijk van netwerkopslag of externe diensten, en dat is precies wat het makkelijk te draaien maakt en precies wat het kwetsbaar laat.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Er is een tweede grens die het project over zichzelf uitspreekt, en dat verdient waardering: als je 100% nauwkeurigheid nodig hebt, bijvoorbeeld voor facturering per request, zegt de documentatie dat Prometheus de verkeerde keuze is, omdat de verzamelde gegevens waarschijnlijk niet gedetailleerd en volledig genoeg zijn. Gebruik iets anders voor de cijfers waarop je factureert en houd Prometheus voor monitoring. Leveranciers zeggen zoiets doorgaans niet uit zichzelf over zichzelf.
Op grotere schaal bestaan hier gevestigde antwoorden voor, en die vallen hier buiten het bestek om dezelfde reden als het Kubernetes-gereedschap: ze vragen een andere operationele toewijding dan die deze review behandelt. Voor één VPS is mijn lezing dat het risico aanvaardbaar is als je TSDB-snapshots elders bewaart of vooraf accepteert dat je de historie kwijtraakt, en dat het een echt probleem is als Prometheus het enige is dat tussen jou en een stille storing staat.
Wie zou Prometheus zelf moeten hosten?
Het duidelijkste signaal dat Prometheus terugverdient wat het kost heeft niets te maken met hoeveel servers je hebt. Het gaat erom of het over zes maanden dezelfde servers zijn. Een stabiele verzameling handmatig geconfigureerde hosts betekent dat je de configuratie één keer schrijft en de historie er gratis bij krijgt; een verzameling die blijft veranderen betekent dat je die configuratie blijft aanraken.
In een statische setup is je Prometheus- en Grafana-configuratie een expliciete beschrijving van je infrastructuur: scrapetargets, de labels die eraan hangen, en de dashboards die daarop zijn gebouwd. Daarom is de historie de hele opbrengst. Een jaar aan data over een stabiele verzameling hosts vertelt je hoe normaal eruitziet, en dat is de betrouwbaarste manier om abnormaal te herkennen voordat het een storing wordt.
Het eerste profiel is dus iemand met een kleine, langzaam veranderende verzameling servers die meer wil dan alleen up of down: requestlatentie over de tijd, geheugentrends, een schijf die zo geleidelijk volloopt dat je het weken van tevoren ziet aankomen. Kun je je infrastructuur vandaag beschrijven en verwacht je dat die beschrijving over een jaar nog ongeveer klopt, dan is de avond die je aan de installatie besteedt de laatste grote rekening.
Het tweede is iedereen die deze stack bewust leert. Verwacht je over een paar jaar infrastructuur te draaien, die van jezelf of van iemand anders, dan is de PromQL-avond precies waarvoor je kwam en is de monitoring een bijverschijnsel. Dit profiel keert het eerste deels om: de stabiliteitstoets telt hier minder, want tijd die je aan opnieuw labelen besteedt is ook tijd die je besteedt aan leren wat opnieuw labelen is. Voor deze lezer zou ik de beoordeling hoger zetten.
Het derde profiel gaat over eigenaarschap, en dat is het profiel dat mensen onderschatten tot ze zelf aan de verkeerde kant hebben gestaan. Prometheus rekent niet per host, niet per metriek en niet per label, en geen enkele prijspagina kan volgend kwartaal onder je voeten veranderen. De ruil tegenover een beheerde dienst als Datadog: je levert de afwerking in, het supportcontract en de piketdienst van iemand anders, en je krijgt er metrieken voor terug die van jou zijn, op een rekening die niet beweegt als een ontwikkelaar instrumentatie toevoegt. Of dat een goede ruil is hangt af van wat je eigen uren waard zijn, en dat getal kun alleen jij invullen (en het is zelden nul, ook al voelt het zo).
Eén ding om te weten voordat je je vastlegt: de lokale opslag van Prometheus ontgroeien is geen doodlopende weg. VictoriaMetrics accepteert remote writes van Prometheus, en de MetricsQL van VictoriaMetrics is achterwaarts compatibel met PromQL, dus de meeste queries en Grafana-dashboards die je nu bouwt zouden de overstap moeten overleven. Het is een migratie, geen herschrijving.
Waard om eens per jaar opnieuw te bekijken in plaats van één keer te beslissen: de setup die vandaag goedkoop te monitoren is wordt duur in het kwartaal waarin je hem gaat verbouwen.

Bouw op een Linux VPS met root-toegang, NVMe en AMD EPYC-kracht.
Bekijk Linux-plannenWie zou Prometheus moeten overslaan?
Als de zin waarmee je je behoefte zou beschrijven „laat het me weten als de site eruit ligt” is, dan beschrijf je een uptime-checker, en is Prometheus veel machinerie om bij dat antwoord te komen. Uptime Kuma doet precies dat werk met een webinterface en vraagt je niet om een monitoring-querytaal te leren. Het verschil in mogelijkheden tussen de twee tools is enorm en volstrekt irrelevant voor het werk waarvoor je ze inhuurt.
De tweede lezer is degene die bruikbare grafieken wil zonder eerst een querytaal te leren. Netdata is precies daaromheen gebouwd: metrieken per host waar je meteen naar kunt kijken, met veel minder configuratie en niets tussen jou en de grafieken. Is de vraag die je steeds stelt „waarom is deze bak nu traag”, dan is dat een veel kortere route naar een antwoord.
De derde is iedereen wiens infrastructuur vaak van vorm verandert en die targets en dashboardvariabelen met de hand beheert. Hosts die voor een week worden opgezet en weer vernietigd, targets die worden hernoemd, projecten die halverwege een andere naam krijgen. Dat is het geval waarin je de configuratiekosten keer op keer betaalt terwijl je het minst haalt uit datgene waarvoor je betaalt: doorlopende historie van een systeem dat herkenbaar blijft.
Niets hiervan is een verwijt aan de tool. „Overslaan” betekent hier: overslaan voor dit werk, op deze schaal. Op Kubernetes-schaal, waar service discovery het meeste afhandelt van wat je anders met de hand zou bedraden, krimpen verschillende van de bovenstaande kosten of verdwijnen ze helemaal, en mijn lezing van die schaal is dat Prometheus daar heel moeilijk te verslaan is. Dat is een andere review.

Veelgestelde vragen
Is Prometheus gratis?
Ja, en er zit geen free-tier-addertje onder. Prometheus is gelicentieerd onder Apache 2.0 zonder commerciële editie erachter, dus er is geen metriekquotum om te overschrijden en geen upgradeprompt die aan de andere kant staat te wachten. Je betaalt voor de infrastructuur en je eigen tijd, niet voor een Prometheus-licentie.
Heeft Prometheus Grafana nodig?
Nee, maar reken erop. De expression browser van Prometheus bestaat om een query uit te voeren en naar het antwoord te kijken, en dat dekt één ding één keer controleren. Alles wat je open wilt laten staan op een tweede monitor is werk voor Grafana, en die twee worden vrijwel altijd samen gedraaid.
Is Prometheus overkill voor één server?
Vaak wel. Moet je alleen weten of de server en zijn diensten draaien, dan beantwoordt een uptime-checker dat in een fractie van de installatietijd. Prometheus verdient zijn plek wanneer je historische metrieken wilt die je kunt bevragen, en je bereid bent PromQL te leren om erbij te komen.
Hoe lang bewaart Prometheus metrieken standaard?
15 dagen, en het waarschuwt je niet vooraf. Prometheus gooit samples weg die ouder zijn dan het bewaarvenster, tenzij je het bij het opstarten verhoogt met een vlag voor bewaartijd of bewaargrootte. Stel het in op de dag dat je het installeert, want het venster later vergroten haalt gegevens die al verlopen zijn niet terug.



Discussie
Reacties
Log in om mee te praten.