

PRTG rekent per sensor, dus per gemonitorde metriek op één apparaat, niet per apparaat. Paesslers eigen tiers zetten de praktische verhouding op ongeveer tien op één: 500 sensoren dekken zo'n 50 apparaten, 10.000 dekken er zo'n 1.000. Voeg een switch-stack toe en begin de doorvoer per poort te volgen, en de teller loopt sneller op dan het park. SolarWinds telt anders en komt op hetzelfde punt uit.
Voor een netwerk met veel Windows zou ik twee self-hosted alternatieven voor PRTG en SolarWinds op de shortlist zetten: Zabbix, of een op Prometheus gebaseerde stack als je team er al een draait. De keuze tussen die twee hangt af van wat elk ervan op een Windows-host kan zien, en wat het nodig heeft om dat te zien.
Eén kanttekening vooraf. Als niemand in het team uren over heeft, blijven PRTG en SolarWinds het juiste antwoord. Hun gebruiksgemak is een product dat je bewust koopt, en het is geld waard. De overstap die hier wordt beschreven besteedt uren in plaats van licentiekosten, en dat is een ruil, geen upgrade.
TL;DR
- De standaardkeuze is Zabbix. Zabbix brengt SNMP-polling, Windows-agents, templates en alerting samen in één monitoringplatform. Je beheert nog steeds de Zabbix-server, database en webfrontend, maar je hoeft geen losse monitoringcomponenten in elkaar te zetten om te kunnen beginnen.
- De uitzondering is een team dat al Grafana en Prometheus draait voor applicatie- en hostmetrieken. Uitbreiden wat je al onderhoudt is goedkoper dan een tweede monitoringsysteem optuigen.
- Prometheus pollt netwerkapparaten niet uit zichzelf.
snmp_exportervult dat gat; de standaardconfiguratie dekt veel gangbare switches en routers, terwijl leverancierspecifieke objecten of aangepaste polling de generator en extra MIB-werk kunnen vereisen. - Agentloze verzameling ziet alleen wat een host of apparaat zelf publiceert. In Zabbix zijn Windows-gebeurtenislogboeken, servicestatus en gedetailleerde prestatiemeters item keys van de agent.
- Dimensioneer de server op metrieken, niet op apparaten. Zabbix telt één metriek als één item plus één trigger plus één grafiek, en zet ruwweg 1.000 metrieken op 2 CPU-cores en 8 GiB geheugen, ruwweg 10.000 op 4 cores en 16 GiB.
Waar PRTG en SolarWinds voor laten betalen
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
SolarWinds telt een andere eenheid, en de regel is makkelijk te missen tot de verlengingsofferte binnenkomt. Het NPM-licentiemodel van SolarWinds stelt dat NPM "wordt gelicentieerd op basis van het grootste aantal van de volgende typen gemonitorde netwerkelementen: nodes, interfaces, volumes". Niet de som. Het grootste van de drie. Een netwerk met 80 nodes en 900 gemonitorde switchpoorten wordt gelicentieerd op de 900, niet op de 80, en de tiers lopen van SL100 tot SLX. Eén polling-engine is ongeacht de tier begrensd op 12.000 elementen (de som van nodes, interfaces en volumes, niet het grootste ervan), waarna je een extra gelicentieerde polling-engine toevoegt.
Het praktische effect van beide modellen is hetzelfde. De licentietier bepaalt wat er wordt gemonitord. Het netwerk niet. Interfaces die je graag zou volgen blijven ongemonitord omdat volgen een grens overschrijdt, en die kosten staan nooit op de factuur.
De twee self-hosted routes die de moeite waard zijn
Zabbix is één monitoringplatform rond een centrale server, database en webfrontend. De server pollt SNMP-apparaten, ontvangt data van Windows-agents en past templates, triggers en alerting toe binnen hetzelfde product. Vergeleken met het samenstellen van een op Prometheus gebaseerde netwerkmonitoringstack zijn er minder losse componenten die je zelf moet integreren. Je installeert het, richt het op hosts en koppelt templates, herbruikbare bundels van items, triggers en grafieken voor één klasse apparaten.
Begin bij de licentie. De licentiepagina van Zabbix stelt dat elke versie vanaf 7.0 wordt uitgebracht onder de GNU Affero General Public License versie 3, en dat alles tot en met 6.4 GPLv2 was. Er zijn geen licentiekosten voor de software, op welke schaal dan ook. Zabbix verkoopt technische ondersteuning als een aparte optionele abonnement en vraagt commerciële gebruikers om een bepaald niveau af te nemen, maar niets in het product zit achter die aankoop.
De tweede route is Grafana, Prometheus en VictoriaMetrics. Het is de juiste keuze in precies één situatie: je draait deze stack al voor applicatie- en hostmetrieken, en iemand onderhoudt hem al. Als dat op jou van toepassing is, is de volledige opzet op één VPS een opgelost probleem en breid je iets vertrouwds uit. Niemand hoeft een nieuw datamodel te leren.

Het gat op die route zijn netwerkapparaten. Prometheus scrapet HTTP-endpoints; het spreekt geen SNMP. Netwerkapparatuur loopt normaal via snmp_exporter, die het apparaat pollt en de resultaten beschikbaar maakt zodat Prometheus ze kan scrapen. De standaardconfiguratie bevat modules zoals if_mib, dus standaard interfacemonitoring op veel switches en routers vereist geen zelf gegenereerde configuratie. De generator wordt pas extra werk als je leverancierspecifieke objecten, aangepaste walks of MIB's nodig hebt die standaard niet zijn meegeleverd. De Prometheus-route heeft dus meer onderdelen om te onderhouden dan Zabbix, maar de generator is niet voor elk apparaat verplicht.
LibreNMS is de derde naam in dit veld, gebouwd rond automatische discovery: het doorloopt een netwerk via SNMP, CDP, LLDP, OSPF, BGP en ARP om te vinden wat er is. Het is een redelijke optie als discovery de prioriteit is. Het verandert niets aan de vraag over Windows-verzameling, en daar wordt deze beslissing beslecht.
Hoe elke route een Windows-host ziet
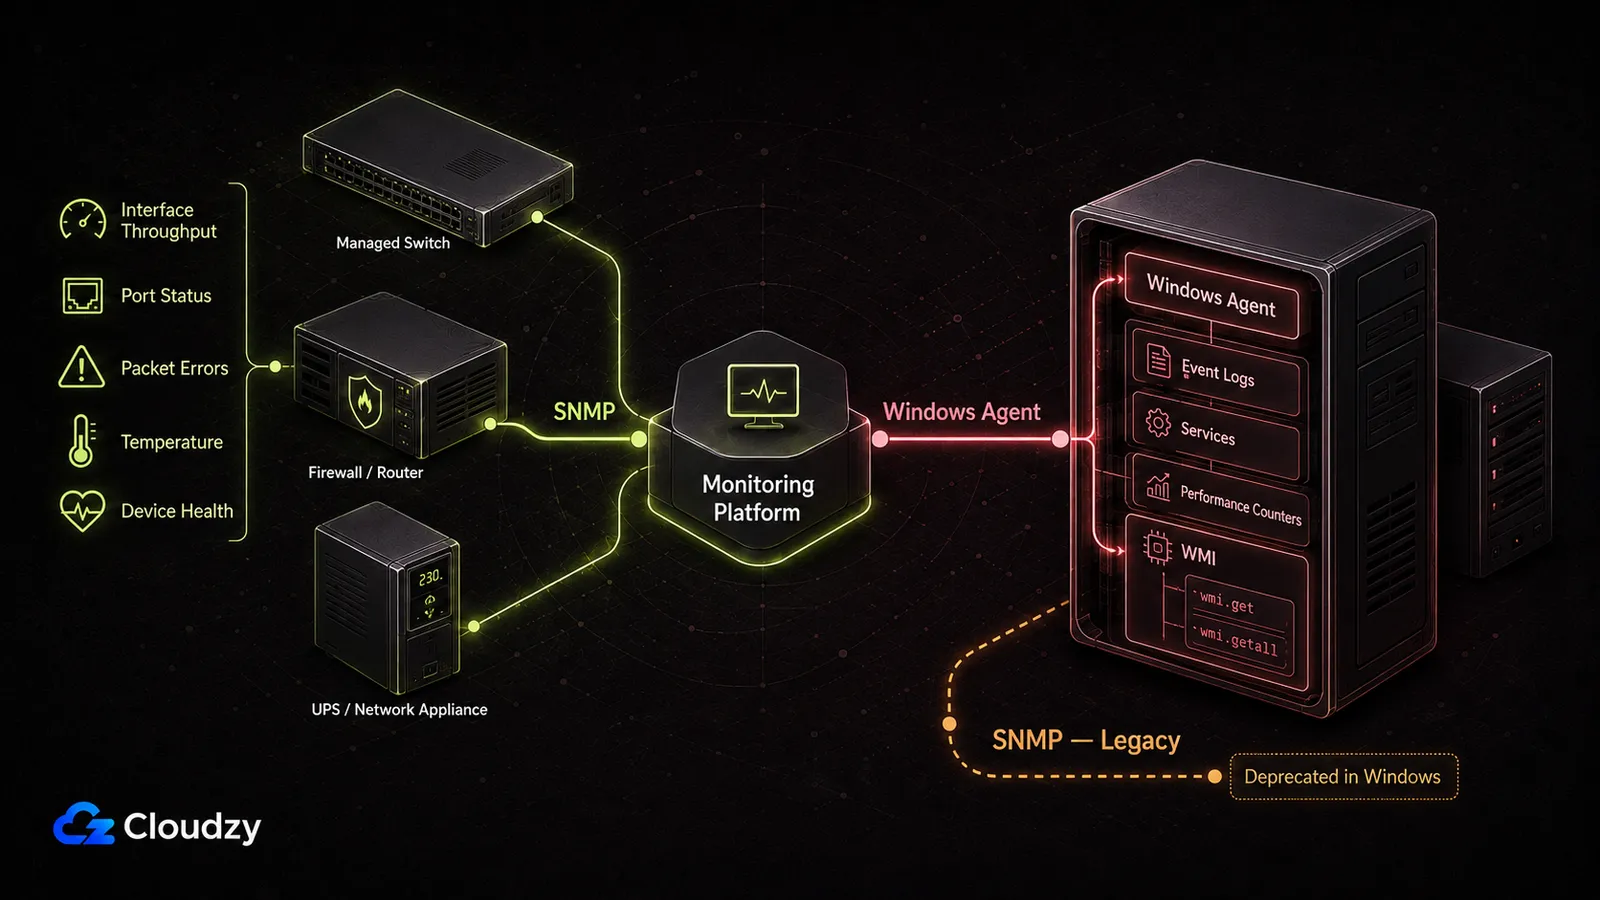
Windows-monitoring kan via SNMP, remote WMI of een geïnstalleerde agent verlopen. Welke route geldt, hangt af van het monitoringproduct en de metriek die wordt verzameld. Specifiek in Zabbix lopen de ingebouwde WMI-checks via de Windows-agent.
SNMP
Een SNMP-poll vraagt een apparaat om de huidige waarde van een genummerd object, geadresseerd via een OID, een positie in de MIB van het apparaat. Wat terugkomt is wat het apparaat publiceert en niets anders. Op een managed switch, een firewall of een UPS is dat meestal genoeg: interfacetellers, poortstatus, foutpercentages, temperatuur, chassisgezondheid.
Op Windows is het beeld magerder. Microsofts afschaffingsbericht voor SNMP en WMI SNMP Provider bevestigt dat beide functies verouderd zijn, dus ik zou Windows-SNMP behandelen als een legacy-compatibiliteitsroute en niet als standaard voor een nieuwe uitrol. Zabbix levert nog steeds een Windows by SNMP-template, maar de native agent geeft je aanzienlijk meer zicht op het besturingssysteem.
WMI
WMI kan op afstand worden bevraagd zonder een monitoringagent op het doelsysteem te installeren, en daarom kunnen producten als PRTG het als agentloze Windows-verzamelmethode gebruiken. Zabbix werkt anders. De ingebouwde WMI-checks, wmi.get en wmi.getall, zijn item keys van de Windows-agent, dus de Zabbix-agent of agent 2 voert die query's uit op de gemonitorde machine.
Remote WMI brengt ook eigen netwerkeisen mee wanneer een monitoringproduct het rechtstreeks gebruikt. Op huidige Windows-systemen start RPC op TCP-poort 135 en onderhandelt het verbindingen normaal via het dynamische hoge TCP-poortbereik, doorgaans 49152 tot en met 65535. De firewall en de WMI-rechten op het doelsysteem moeten de verbinding toestaan.
Voor deze vergelijking is het onderscheid belangrijker dan het protocol zelf: PRTG kan remote WMI gebruiken zonder geïnstalleerde monitoringagent, terwijl Zabbix zijn Windows-specifieke WMI-zicht via zijn agent krijgt.
De native agent
De agent is waar de Windows-specifieke diepgang zit. De documentatie van Zabbix bevat een lijst van Windows-specifieke keys: eventlog voor het monitoren van het Windows-gebeurtenislogboek, perf_counter voor elke Windows-prestatiemeter, service.discovery en service.info voor de servicestatus. Allemaal zijn het item keys van de agent.
De kosten zitten in de uitrol. Een agent op elke Windows Server en elk werkstation dat je belangrijk vindt, is een pakket om uit te rollen, een versie om actueel te houden en een firewallregel om te onderhouden. Dat is een blijvende operationele verplichting, en het is het tegenwicht van de licentiebesparing.
Agentloze verzameling is begrensd door wat de host of het apparaat zelf publiceert, en in Zabbix zitten de gebeurtenislogboeken en gedetailleerde prestatiemeters achter item keys van de agent.
Naast elkaar
De vergelijking draait om vier dingen: of de tool netwerkapparaten überhaupt via SNMP pollt, of hij een Windows-agent heeft, hoe diep hij in een Windows-host kan kijken, en hoeveel assemblage er tussen jou en een werkend systeem zit. Licentie staat ernaast omdat het de reden is dat de evaluatie begon.
| Tool | SNMP-polling van apparaten | Windows-monitoring | Installatiewerk | Licentie |
|---|---|---|---|---|
| Zabbix | Ingebouwd | Agent: gebeurtenislogboeken, servicestatus, prestatiemeters en WMI; grove status via SNMP | Gemiddeld: één server, daarna templates | AGPLv3, geen licentiekosten; ondersteuning apart verkocht |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | Niet ingebouwd; heeft snmp_exporter als aparte component nodig | Geen native Windows-agent; hostmetrieken komen van aparte exporters; gebeurtenislogboeken zijn niet native | Hoog: meerdere componenten; aangepaste SNMP kan generatorwerk vereisen | Open-sourcecomponenten, geen licentiekosten |
| Uptime- en statusmonitors | Niets | Alleen bereikbaarheid van services en responstijd | Laag: minuten | Verschilt per tool |
Als de eis is "waarschuw me binnen een minuut als een service niet meer reageert", dan is een uptime-monitor de tool van de juiste maat en zijn de andere twee daarvoor overdreven. Wat hij niet doet, is een switch pollen voor interfacedoorvoer of een Windows-prestatiemeter uitlezen, dus hij vervangt PRTG of SolarWinds niet. Het is een andere taak die soms voor dezelfde wordt aangezien.

Welke je moet draaien
Draai Zabbix. Voor een netwerk met veel Windows en zonder bestaande Prometheus-investering is het met afstand de kortste route. Je hebt nog steeds een server, database en webfrontend te beheren, maar het monitoringmodel, de templates en de alerting zitten in één product in plaats van samengesteld uit meerdere monitoringcomponenten.
Gebruik voor een monitoringomgeving die lang mee moet de huidige Zabbix LTS-tak in plaats van een kortlopende standaardrelease. De LTS-levenscyclus van Zabbix geeft elke release drie jaar volledige ondersteuning gevolgd door twee jaar beperkte ondersteuning, wat hier zwaarder weegt dan het najagen van de nieuwste featurerelease.
De uitzondering is smal en specifiek. Als je team Grafana en Prometheus al in productie draait voor applicatie- en hostmetrieken, en iemand die stack al in beheer heeft, dan is snmp_exporter een toevoeging aan iets dat wordt onderhouden in plaats van een tweede systeem om te onderhouden. Die voorwaarde is cumulatief: beide helften moeten gelden. Een verlaten Grafana-instantie die iemand vorig jaar heeft opgezet, telt niet.
En als niemand de uren heeft: verleng. Dat is geen slag om de arm. Het is een andere situatie met een ander juist antwoord. De overstap zet een licentierekening om in een operationele rekening: agent-uitrol, templatewerk, upgrades en iemand die het systeem goed genoeg begrijpt om het om 2 uur 's nachts te repareren. Een team dat al op volle capaciteit zit, doet dat werk slecht of helemaal niet, en onbeheerde monitoring is erger dan dure monitoring, omdat ze stilletjes faalt.
De hybride bestaat echt: houd het huidige product op een krimpende kern van kritieke systemen, verhuis al het andere naar Zabbix en laat de licentietier in de loop van de tijd zakken. Het werkt. Het betekent ook twee monitoringsystemen draaien en hun alerts op elkaar afstemmen, dus behandel het als een overgangsfase met een einddatum.
Wat de overstap niet overleeft
Zabbix' eigen migratiegids heeft een sectie met de kop "Wat NIET wordt gemigreerd", en de lijst is langer dan het woord "migratie" doet vermoeden. Historische data en sensorwaarden gaan niet mee. Aangepaste PRTG-notificaties en afhankelijkheden ook niet. Maps en dashboards ook niet, omdat de twee producten ze zo verschillend modelleren dat opnieuw bouwen wint van vertalen. De sensoren zelf ook niet, omdat Zabbix met een totaal ander concept werkt.
Apparaatnamen, IP-adressen en interfacetypen kunnen wel worden overgezet. Zelfs dat gaat via eigen export- en importscripts tegen beide API's. De gids stelt onomwonden dat er geen officiële tool is om rechtstreeks tussen de twee platforms te migreren.
Eén team heeft gedocumenteerd wat dat in de praktijk kost: ruwweg 500 VM's en fysieke servers, zo'n zeven jaar op PRTG, vanaf nul opnieuw opgebouwd in zes maanden projecttijd met lage prioriteit. Hun 2.500 PRTG-sensoren werden 43.000 Zabbix-items, wat helder laat zien hoe verschillend de twee systemen tellen.
"Begin vanaf nul. Er is geen 'druk op deze knop en migreer'-optie van PRTG naar Zabbix, en zelfs als die er was, is zoiets een goede kans om eerdere ontwerpfouten niet te herhalen."
Dat is de ervaring van één organisatie, geen maatstaf. Een kleiner park levert die cijfers niet op. Wat wel overdraagbaar is, is de planningsaanname: budgetteer herbouwtijd, geen migratietijd.
Bepaal de volgorde van de herbouw op basis van wat je niet kunt missen. Gaat het je om de continuïteit van alerting, bouw dan eerst de notificatieregels opnieuw en laat de dashboards achterlopen. Gaat het om rapportagehistorie, exporteer dan wat je nodig hebt voordat de oude licentie verloopt. Die gaat niet met je mee.
De server dimensioneren
De hardwarevereisten van Zabbix zetten een kleine installatie van ongeveer 1.000 gemonitorde metrieken op 2 CPU-cores en 8 GiB geheugen, en een middelgrote installatie van ongeveer 10.000 metrieken op 4 cores en 16 GiB. Dat zijn de cijfers om je aanvraag op te baseren.
De eenheid is waar dimensionering misgaat. Zabbix definieert één gemonitorde metriek als één item plus één trigger plus één grafiek. Een metriek is geen apparaat en geen host. Eén Windows Server levert zoveel metrieken als je items configureert: CPU, geheugen, elk bestandssysteem, elke service, elke meter die je bemonstert. Het aantal apparaten is een slechte leidraad voor de machine die je nodig hebt. Een park dat klein klinkt, kan in de middelgrote band belanden zonder dat iemand iets ongewoons doet.
Twee dingen drijven het aantal sneller op dan het aantal hosts. Pollingfrequentie is de eerste: een verversingsinterval halveren verdubbelt de schrijfsnelheid voor elk item op dat interval. Bewaartermijn van de historie is de tweede, want de database groeit met hoe lang je ruwe waarden bewaart. Het aantal apparaten telt vooral mee via het aantal gemonitorde items dat elk apparaat inbrengt.
Als je park in de buurt van het voorbeeld met 1.000 metrieken blijft, met normale verversingsintervallen en een bescheiden bewaartermijn, is de kleine band een redelijk startpunt. Als je elke dertig seconden prestatiemeters bemonstert en een jaar ruwe historie bewaart, niet. Zabbix zegt expliciet dat de gepubliceerde cijfers "voorbeelden van omvang en hardwareconfiguratie om mee te beginnen" zijn, en raadt aan te benchmarken in een stagingomgeving voordat je productiehardware vastlegt. Dat is het voorbehoud van de leverancier zelf. Neem het letterlijk.
Zabbix ondersteunt zijn servercomponent alleen op Linux en UNIX; op Windows wordt alleen de agent ondersteund.
Metrieken zijn geen apparaten, en de vermenigvuldigingsfactor daartussen bepaalt de grootte van de machine.

Bouw op een Linux VPS met root-toegang, NVMe en AMD EPYC-kracht.
Bekijk Linux-plannenWaar je de monitoringserver neerzet
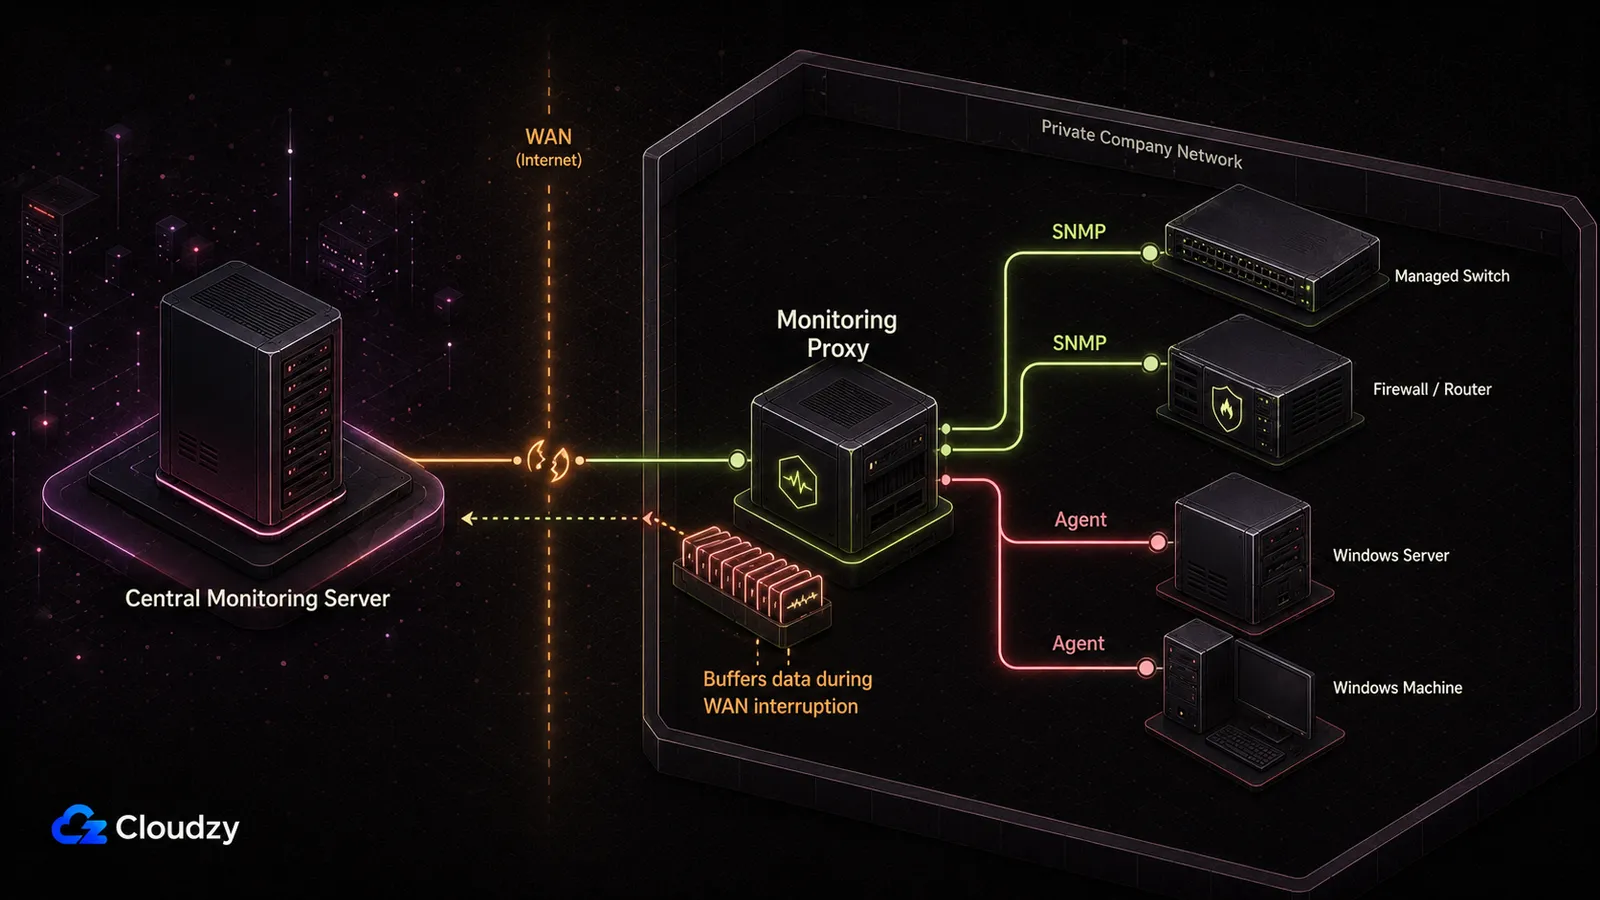
Als monitoring een storing van de hele locatie moet overleven, houd de centrale Zabbix-server dan buiten het storingsdomein van die locatie. Uitval van de uplink van de locatie kan dan het gemonitorde netwerk offline halen zonder de monitoringserver mee te nemen.
Voor een privaat netwerk kan een Zabbix-proxy binnen de locatie staan en verzamelen van de systemen eromheen. De proxy kan SNMP- en agentchecks lokaal afhandelen, de verzamelde data terugsturen naar de centrale server en monitoringdata bufferen zolang de verbinding tussen de twee wegvalt. Zo kan de centrale server buiten de locatie blijven zonder dat elke private switch, firewall en Windows-host rechtstreeks vanaf internet bereikbaar hoeft te zijn.
Een VPS is een praktische plek om die centrale server te draaien. Cloudzy biedt Zabbix Server aan als one-click-deployment op Ubuntu Server 24.04 LTS, als je de initiële installatie wilt overslaan en meteen hosts en templates wilt configureren.
Veelgestelde vragen
Is Zabbix echt gratis?
Ja. Zabbix wordt vanaf versie 7.0 uitgebracht onder de GNU Affero General Public License versie 3, en er zijn geen licentiekosten voor de software, hoeveel apparaten of metrieken je ook monitort. Zabbix verkoopt technische ondersteuning als een apart optioneel abonnement, maar geen enkele functie van het product zit daarachter. De kosten van Zabbix zijn de server waarop het draait en de uren die je aan het beheer besteedt.
Moet ik op elke Windows Server een agent installeren?
Niet op elke Windows-machine, maar als je de native Windows-monitoringdiepgang van Zabbix wilt, plan dan de agent op de servers die je het belangrijkst vindt. SNMP kan grove agentloze data leveren, al is de Windows-SNMP-functie door Microsoft afgeschaft. De ingebouwde WMI-checks van Zabbix lopen ook via de Windows-agent, dus WMI is in Zabbix geen rechtstreekse agentloze verzamelroute. Gebruik de agent voor gebeurtenislogboeken, servicediscovery, WMI-query's en gedetailleerde prestatiemeters; houd agentloze SNMP vooral voor netwerkhardware en legacy Windows-gevallen.
Kan ik de monitoringserver op Windows draaien?
Niet met Zabbix. De vereistendocumentatie van Zabbix vermeldt de servercomponent als alleen ondersteund op Linux en andere UNIX-platforms, en stelt dat "UNIX het enige besturingssysteem is dat consequent de vereiste prestaties, fouttolerantie en veerkracht kan leveren". Windows-ondersteuning omvat de Zabbix-agent en agent 2, wat je installeert op de gemonitorde machines. De monitoringserver staat op een Linux-host; het Windows-park is wat hij in de gaten houdt.
Doet Prometheus SNMP-monitoring?
Niet uit zichzelf. Prometheus scrapet HTTP-endpoints en gebruikt snmp_exporter om van SNMP-apparaten te verzamelen. De standaardconfiguratie dekt veel gangbare switches en routers, terwijl leverancierspecifieke objecten of aangepaste polling extra MIB-configuratie en de generator kunnen vereisen.



Discussie
Reacties
Log in om mee te praten.