
ผู้ใช้คนหนึ่งใน r/linuxquestions ได้ทำการเปรียบเทียบที่ทุกคนเถียงกันไม่จบ เขาติดตั้ง CachyOS รันเบนช์มาร์กหลายเกมบน Ryzen 7 7800X3D กับ Radeon RX 7900 XTX และวัดไม่พบความต่างใด ๆ เมื่อเทียบกับดิสโทรอื่นที่มีอยู่แล้วในเครื่อง คำตอบที่ตามมาก็เป็นไปตามเคย คนหนึ่งบอกว่าเพดานต่ำจนมองไม่เห็นในการใช้งานปกติ อีกคนอธิบายเรื่องตัวจัดตาราง คนที่สามบอกว่าเบนช์มาร์กแสดงสิ่งที่ตัวจัดตารางทำไม่ได้ ไม่มีใครเอาผลวัดที่จะตัดสินเรื่องนี้มาให้
คำถามนี้วนกลับมาด้วยถ้อยคำเดิมเสมอ: CachyOS เร็วกว่าจริงหรือ? คำตอบสั้น ๆ คือใช่ ในเวิร์กโหลดบางประเภท แพ็กเกจที่คอมไพล์ใหม่ช่วยโค้ดที่คอมไพเลอร์ทำเวกเตอร์ไรซ์ได้ การเปรียบเทียบด้านเกมที่อ้างถึงในบทความนี้แสดง FPS เฉลี่ยที่ต่างกันน้อยมาก และระบบที่รู้สึกเร็วขึ้นหลังย้ายนั้นระบุสาเหตุยากกว่า เพราะการเปลี่ยนดิสโทรเปลี่ยนตัวแปรมากกว่าหนึ่งตัวมาก
เรื่องนี้ยังไม่จบเพราะคำว่า "เร็วกว่า" ซ่อนข้ออ้างสามข้อที่แยกกัน มีคำตอบต่างกันสามแบบ และแต่ละข้อต้องใช้เครื่องมือวัดของตัวเอง แพ็กเกจที่คอมไพล์ใหม่ทำงานเสร็จในเวลาจริงที่สั้นลงหรือไม่ก็ไม่ ตัวจัดตารางเปลี่ยนพฤติกรรมของเดสก์ท็อปเมื่อมีการแย่งทรัพยากรหรือไม่ก็ไม่ และเครื่องที่ตอบสนองไวขึ้นนั้นมาจาก CachyOS หรือมาจากสิ่งที่ติดมาพร้อมกัน
เวอร์ชันสั้น
- แพ็กเกจที่คอมไพล์ใหม่: เร็วขึ้นแบบวัดได้ แต่กับส่วนน้อยของสิ่งที่คุณรัน ผลได้กระจุกอยู่ในโค้ดที่คอมไพเลอร์ทำเวกเตอร์ไรซ์ได้ หลายแพ็กเกจกลับช้าลง และส่วนใหญ่ไม่เปลี่ยน การเปรียบเทียบใน arch-chroot เมื่อมกราคม 2023 บน sunnyflunk.github.io บนเครื่อง Intel NUC8i5BEK พบว่าการเข้ารหัส flac เร็วขึ้น 20.2% และการคลายบีบอัด bzip2 ช้าลง 7.1% ในการรันเดียวกัน
- เรื่องของตัวจัดตารางแยกเป็นสองส่วน เคอร์เนลค่าเริ่มต้นปัจจุบันของ CachyOS ใช้ EEVDF ส่วน BORE มีให้แยกต่างหาก การเปรียบเทียบดิสโทรเมื่อพฤษภาคม 2026 พบ FPS เฉลี่ยต่างกันน้อย และวัด 1% low กับความสม่ำเสมอของเฟรมด้วย แต่ไม่ได้แยก BORE ออกมาทดสอบหรือเพิ่มโหลด CPU คู่แข่งแบบควบคุม การเล่นเกมแบบติดตั้งมาสด ๆ ถูกวัดแล้ว แต่ประโยชน์ของ BORE ภายใต้การแย่ง CPU ยังไม่ถูกแยกทดสอบ
- ความรู้สึกว่าเครื่องเร็วขึ้น: ประสบการณ์จริง แต่ระบุสาเหตุไม่น่าเชื่อถือ การติดตั้งใหม่และการที่บั๊กที่ไม่เกี่ยวข้องบังเอิญหาย ต่างก็ทำให้ระบบลื่นขึ้นโดยไม่เกี่ยวกับระดับชุดคำสั่งเลย ข้อยกเว้นที่ควรรู้คือการเปรียบเทียบแบบติดตั้งมาสด ๆ ของ Phoronix บน Intel Core Ultra 9 285K ซึ่ง CachyOS นำหน้า Arch มาตรฐานบน CPU ที่ใช้การปรับแต่ง AVX-512 ไม่ได้เลย
CachyOS เปลี่ยนอะไรในระบบของคุณจริง ๆ
CachyOS คือ Arch Linux ที่มีการปรับเปลี่ยนสามอย่างแยกกันซ้อนอยู่ข้างบน: เคอร์เนลที่แพตช์แล้วซึ่งมีตัวจัดตารางทางเลือก, รีโพซิทอรีที่แพ็กเกจถูกคอมไพล์ใหม่สำหรับระดับชุดคำสั่ง CPU ที่ใหม่กว่า และการปรับแต่งคอมไพเลอร์เพิ่มเติมกับแพ็กเกจหลักบางส่วน แต่ละอย่างเป็นกลไกแยกกันที่ให้ผลแยกกัน และแทบไม่เคยถูกวัดแยกจากกันเลย
ฝั่งเคอร์เนลคือพื้นที่ที่ใหญ่ที่สุด รายการฟีเจอร์เคอร์เนลของ CachyOS ครอบคลุม Clang ThinLTO, การทำโปรไฟล์ AutoFDO, โหมด preemption ที่เลือกได้ขณะรัน และตัวเลือกตัวจัดตารางหลายแบบ แพ็กเกจ linux-cachyos ปัจจุบันใช้ EEVDF ที่ CachyOS ปรับจูนเป็นตัวจัดตารางค่าเริ่มต้น BORE และ BMQ มีให้ผ่านเคอร์เนลรุ่นแยก ขณะที่ linux-cachyos-eevdf เพิ่มการปรับจูนความไวการตอบสนองของ EEVDF และ linux-cachyos-server ใช้ EEVDF แบบดั้งเดิม ส่วน sched-ext ยังมีให้ในรุ่นที่รองรับ
ฝั่งแพ็กเกจ รีโพซิทอรี x86-64-v3 ของ CachyOS คือกลไกที่เป็นประเด็น หน้ารีโพซิทอรีที่ปรับแต่งของ CachyOS อธิบายการบิลด์แพ็กเกจ Arch ใหม่สำหรับเป้าหมายสามแบบที่สูงกว่าฐานทั่วไป: x86-64-v3, x86-64-v4 และเป้าหมาย Zen 4/5 โดยเฉพาะที่เพิ่มส่วนขยาย AVX-512 เพิ่มเติมพร้อมคำสั่งบางส่วนนอก AVX-512 ไว้บน v4 แพ็กเกจที่ไวต่อประสิทธิภาพบางส่วนยังได้รับการปรับแต่งตามโปรไฟล์และ BOLT ด้วย
ชื่อระดับเหล่านั้นมาจาก ข้อกำหนดระดับสถาปัตยกรรมย่อยของ x86-64 psABIและมันคือประตูที่ต้องผ่าน ไม่ใช่ปุ่มปรับระดับ x86-64-v3 ต้องการคำสั่งยุค AVX และ AVX2 ที่มาพร้อม Haswell ของ Intel ในปี 2013 และคอร์ Excavator ของ AMD ส่วน x86-64-v4 ต้องการ AVX-512 ซึ่งในทางปฏิบัติหมายถึงชิป Intel ระดับ Skylake-X และ AMD Zen 4 ขึ้นไปทุกตัว CPU ผ่านเกณฑ์หรือไม่ผ่านเท่านั้น
สามข้ออ้างที่ซ่อนอยู่ในคำว่า "เร็วกว่า"
เมื่อสองคนเห็นต่างกันว่า CachyOS เร็วกว่าหรือไม่ มักจะถูกทั้งคู่แต่คนละเรื่อง ปริมาณงานที่ทำได้ ความสม่ำเสมอของเฟรม และความไวการตอบสนองที่รู้สึกได้ เป็นคุณสมบัติที่แยกกัน และไม่มีตัวชี้วัดเดียวที่ตัดสินได้ทั้งสาม งานที่จับเวลาวัดปริมาณงาน การวัดเวลาเฟรมและความหน่วงครอบคลุมความลื่นของเกม ส่วนผลระดับระบบที่กว้างกว่าต้องใช้การเปรียบเทียบการติดตั้งใหม่แบบควบคุม
| ข้ออ้าง | สิ่งที่อ้าง | วิธีวัด | หลักฐานบอกอะไร | ความมั่นใจ |
|---|---|---|---|---|
| ปริมาณงานที่วัดได้ | แพ็กเกจที่คอมไพล์ใหม่ทำงานเดียวกันเสร็จในเวลาที่สั้นลง | จับเวลางานหนึ่งบนฮาร์ดแวร์และเคอร์เนลที่คงที่ เปลี่ยนแค่ว่าแพ็กเกจมาจากรีโพซิทอรีไหน | ได้ผลชัดเจนกับงานที่ทำเวกเตอร์ไรซ์ได้ ถดถอยเล็กน้อยในหลายแพ็กเกจ ไม่เปลี่ยนในส่วนใหญ่ | สูง Canonical, CentOS ISA SIG และผู้ทำเบนช์มาร์กอิสระสองรายเห็นตรงกันในภาพรวม |
| ความหน่วงอินพุตและความสม่ำเสมอของเฟรม | เดสก์ท็อปยังตอบสนองได้ขณะที่มีอย่างอื่นกิน CPU จนเต็ม | เปอร์เซ็นไทล์ของเวลาเฟรมและความหน่วงอินพุตภายใต้โหลดคู่แข่ง ไม่ใช่เฟรมเรตเฉลี่ย | การทดสอบที่เผยแพร่ตอนนี้มี 1% low และความสม่ำเสมอของเฟรมแล้ว แต่ไม่ได้แยกตัวจัดตารางออกมาทดสอบ และไม่ได้ใส่โหลด CPU คู่แข่งแบบควบคุม | ต่ำ กลไกมีเอกสารรองรับ แต่ยังไม่มีการวัด |
| ความไวการตอบสนองที่รู้สึกได้ | เครื่องรู้สึกลื่นขึ้นหลังย้าย | เทียบกับการติดตั้งใหม่ของดิสโทรเดิม ไม่ใช่ตัวที่ใช้จนเก่า | มักอธิบายได้ด้วยผลของการติดตั้งใหม่หรือบั๊กที่บังเอิญหาย การเปรียบเทียบแบบติดตั้งมาสด ๆ หนึ่งรายการพบความได้เปรียบระดับดิสโทร | ปานกลาง ประสบการณ์มีมูล แต่ระบุสาเหตุไม่น่าเชื่อถือ |
ชุดเบนช์มาร์กที่ตอบแถวแรกได้ ตอบแถวที่สองไม่ได้ และทั้งสองไม่แตะแถวที่สามเลย การรันหนึ่งในสามแล้วรายงานผลราวกับเป็นคำตัดสินของทั้งสามข้อ คือสิ่งที่ทำให้กระทู้นี้ไม่จบ
แพ็กเกจที่คอมไพล์ใหม่รันเร็วขึ้นจริงหรือ?
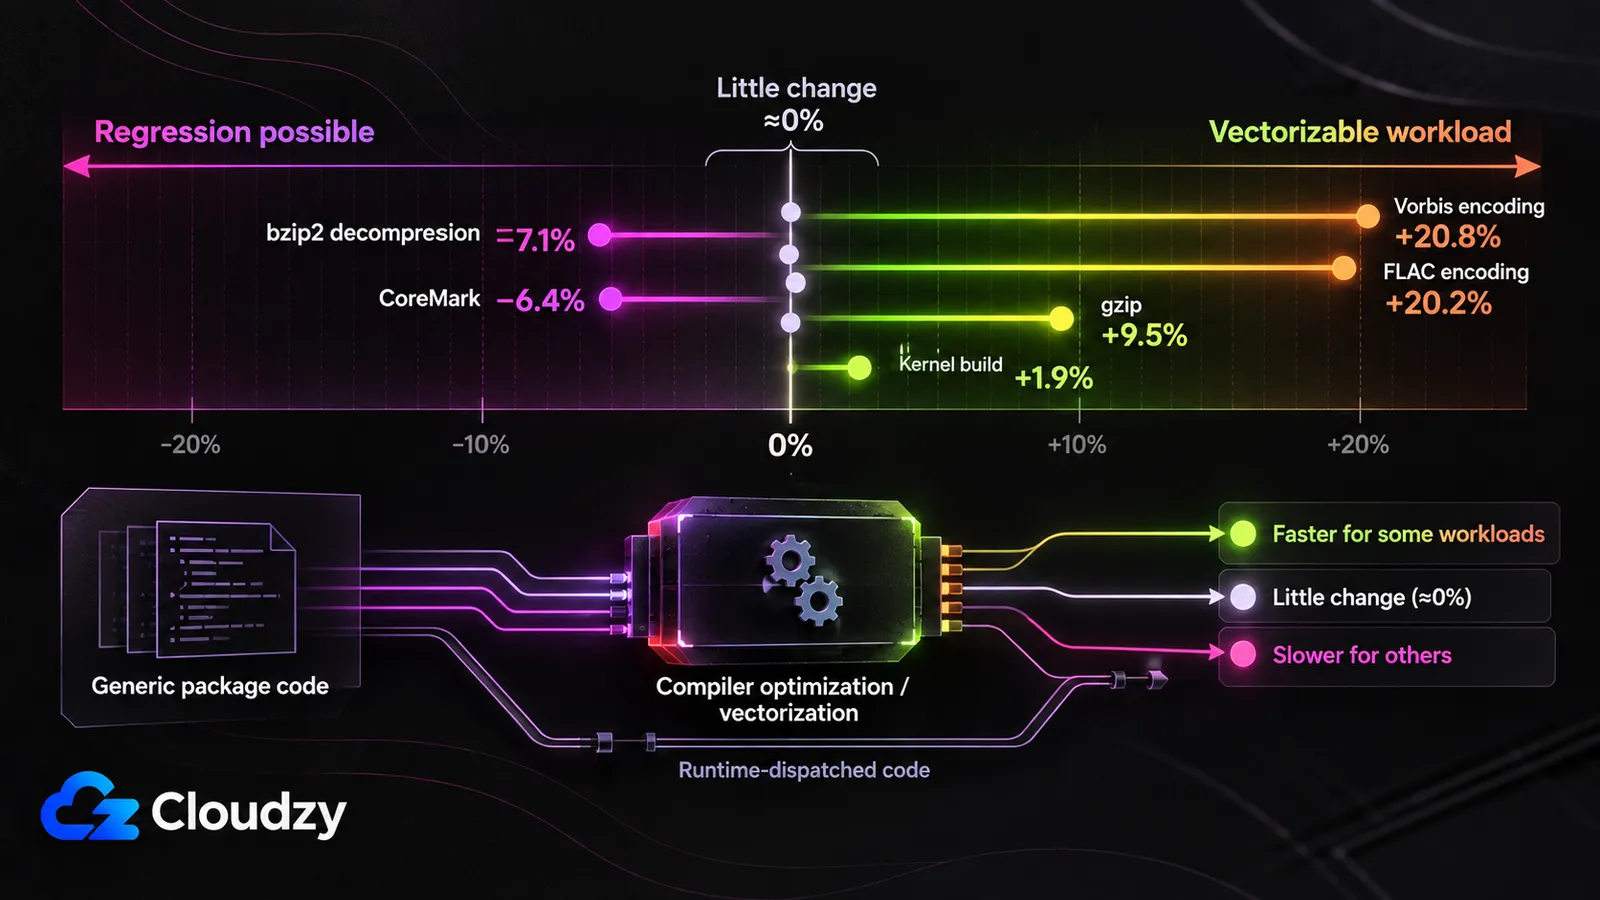
ใช่ กับส่วนน้อยของสิ่งที่เดสก์ท็อปรัน และขนาดของผลขึ้นกับเวิร์กโหลด ไม่ใช่ดิสโทร งานที่ทำเวกเตอร์ไรซ์ได้เพิ่มขึ้นสองหลัก แพ็กเกจจำนวนหนึ่งช้าลง และส่วนใหญ่ไม่แสดงอะไรเลย หน้ารีโพซิทอรีที่ปรับแต่งของ CachyOS ระบุว่า x86-64-v3 เร็วขึ้น 5% ถึง 20% เทียบกับ x86-64 ทั่วไป ส่วนผลวัดที่เผยแพร่ส่วนใหญ่อยู่ปลายล่างของช่วงนั้น
การเปรียบเทียบประสิทธิภาพ CachyOS กับ Arch ที่สะอาดที่สุดแยกเฉพาะตัวแปรแพ็กเกจและไม่มีอย่างอื่น: การทดสอบใน arch-chroot เมื่อมกราคม 2023 บน sunnyflunk.github.io เครื่องโฮสต์รัน Arch มาตรฐานบน Intel NUC8i5BEK แพ็กเกจทั้งสองชุดถูกทดสอบภายใน arch-chroot เพื่อให้เคอร์เนลและสภาพแวดล้อมเหมือนกัน และเบนช์มาร์กรันใน RAM เพื่อตัดความหน่วงของดิสก์ เมื่อเทียบกับแพ็กเกจ Arch มาตรฐาน บิลด์ของ CachyOS เข้ารหัส flac ด้วย -8เร็วขึ้น 20.2% เข้ารหัส vorbis เร็วขึ้น 20.8% และ gzip -3เร็วขึ้น 9.5% ในการรันเดียวกัน คลายบีบอัด bzip2 ช้าลง 7.1% บีบอัดด้วย lz4 ช้าลง 1.6% ถึง 2.9% pybench ช้าลง 3% และเบนช์มาร์ก R ไม่เปลี่ยน ข้อควรระวังสองข้อมาจากผู้เขียนเอง: CachyOS บิลด์ด้วย -march=x86-64-v3 -mpclmul -O3 เทียบกับ -march=x86-64 -O2ของ Arch และการทดสอบต่อเนื่องของเขาชี้ว่า -O3 ไม่ใช่ระดับชุดคำสั่ง ที่เป็นเหตุของผลได้ก้อนใหญ่บางส่วน บทความนี้เขียนก่อนรีโพซิทอรี Zen 4 ของ CachyOS ซึ่งมาพร้อมรุ่นกรกฎาคม 2024 แต่ไม่ได้มาก่อนงาน BOLT: ผู้เขียนมองว่าแพ็กเกจ Python ของ CachyOS ที่อยู่เบื้องหลังการถดถอยของ pybench มี BOLT ซ้อนบน x86-64-v3 อยู่แล้ว
เบนช์มาร์ก CachyOS บนฮาร์ดแวร์ที่ใหม่กว่าให้รูปแบบเดิม การเปรียบเทียบเมื่อกรกฎาคม 2024 บน mvermeulen.org รันชุดย่อยของ Phoronix Test Suite บน Ryzen 7940HS ที่เป็น Zen 4 โดยใช้ CachyOS กับรีโพซิทอรี Zen 4 เทียบกับ Ubuntu 22.04 ผลส่วนใหญ่อยู่ในช่วงไม่กี่เปอร์เซ็นต์ไม่ว่าทางไหน: coremark ช้าลง 6.4%, การทดสอบย่อย OpenSSL ตั้งแต่ช้าลงราว 1% ถึงเร็วขึ้น 4%, เวลาบิลด์เคอร์เนลเร็วขึ้น 1.9%, phpbench เป็นค่าผิดปกติที่ได้คะแนนมากกว่าสองเท่าเล็กน้อย ผู้เขียนชี้ว่าเวอร์ชัน GCC ไม่ตรงกัน คือ 14.1 กับ 11.4 ของ Ubuntu น่าจะเป็นปัจจัยรบกวน ส่วน การรัน NAMD แยกต่างหากเมื่อมีนาคม 2024 ของเขาพบว่าดีขึ้น 6.5% และ 5.8% ในเวิร์กโหลดพลวัตโมเลกุลสองรายการ
การทดสอบระดับสถาบันพบภาพผสมแบบเดียวกันที่ปลายทั้งสองข้าง การทำเบนช์มาร์ก x86-64-v3 ของ Canonical เองซึ่งเผยแพร่เมื่อมีนาคม 2024 ด้วยอิมเมจทดลอง Ubuntu 23.10 บน Azure รายงานผลที่ทำซ้ำได้ดีขึ้นถึง 60% ในเบนช์มาร์ก glibc Log2 ขณะที่เบนช์มาร์กอื่นถดถอยอย่างมีนัยสำคัญ กรณีหนึ่งเป็นเพราะการเปิด v3 กับโค้ด SSE ที่ปรับแต่งไว้แล้วทำให้คอมไพเลอร์ขยายมันเป็นคำสั่งมากกว่าเดิม 17 เท่า การบิลด์ CentOS Stream 9 ใหม่ของ CentOS ISA SIG จาก v2 เป็น v3 บนเครื่อง Intel ระดับ Ice Lake เมื่อสิงหาคม 2023 เรียกผลว่า "ค่อนข้างผสม" โดยความเร็วที่เพิ่ม 2.2 เท่ากระจุกอยู่ที่ Mocassin และ md5crypt ของ John the Ripper ซึ่งทั้งคู่พึ่งการทำเวกเตอร์ไรซ์อย่างหนัก แม้ทีมจะให้เครดิตผลของ Mocassin แก่การทำเวกเตอร์ไรซ์อัตโนมัติของ GCC 12 เป็นหลักมากกว่าระดับ ISA
ไลบรารีคณิตศาสตร์และการเข้ารหัสลับที่สำคัญต่อประสิทธิภาพจำนวนมากมีฟังก์ชันร้อนหลายเวอร์ชันและเลือกใช้ตอนรันผ่านการตรวจจับฟีเจอร์ของ CPU เทคนิคนี้เรียกว่า function multiversioning และใน glibc ทำผ่าน IFUNC resolver นั่นหมายความว่าบางเส้นทางร้อนใช้ AVX2 บน Arch มาตรฐานได้อยู่แล้วโดยไม่ต้องบิลด์แพ็กเกจใหม่ทั้งหมด บทความของ sunnyflunk เห็นเรื่องนี้โดยตรง โดยระบุว่าซอร์สของ flac มีฟังก์ชัน AVX2 แบบรันไทม์อยู่แล้วซึ่งไม่ต้องใช้ -march เพื่อเปิดใช้งาน สิ่งที่ CentOS พบคือภาพสะท้อนกลับด้าน: ทีมพบ ฟังก์ชันคณิตศาสตร์ของ glibc ที่ไม่มีเวอร์ชัน IFUNCซึ่งเป็นจุดที่การบิลด์ใหม่แบบสถิตมีที่ว่างจะช่วยได้พอดี สิ่งที่การบิลด์ v3 ใหม่เข้าถึงคือโค้ดที่เหลือซึ่งตัวทำเวกเตอร์ไรซ์อัตโนมัติของคอมไพเลอร์ปรับปรุงได้เอง ซึ่งเป็นเพียงเสี้ยวเล็ก ๆ ของเดสก์ท็อป
รูปร่างของเวิร์กโหลด ไม่ใช่ป้ายบน CPU ที่ตัดสินว่าการเปลี่ยนแปลงระดับเครื่องจะปรากฏหรือไม่ คำตัดสินเรื่องปริมาณงานคือใช่ แต่มีขอบเขต: การเปลี่ยนแปลงเลขหลักเดียวพบได้ทั่วไปในผลวัดข้างต้น ผลได้ก้อนใหญ่กระจุกอยู่ที่เวิร์กโหลดที่ทำเวกเตอร์ไรซ์ได้อย่างการเข้ารหัสและการบีบอัด และบางแพ็กเกจถดถอย นั่นเป็นคำอธิบายที่ดีกว่าการมอง x86-64-v3 เป็นตัวคูณความเร็วทั้งระบบ
ตัวจัดตารางเปลี่ยนอะไร และทำไม FPS เฉลี่ยถึงมองไม่เห็น
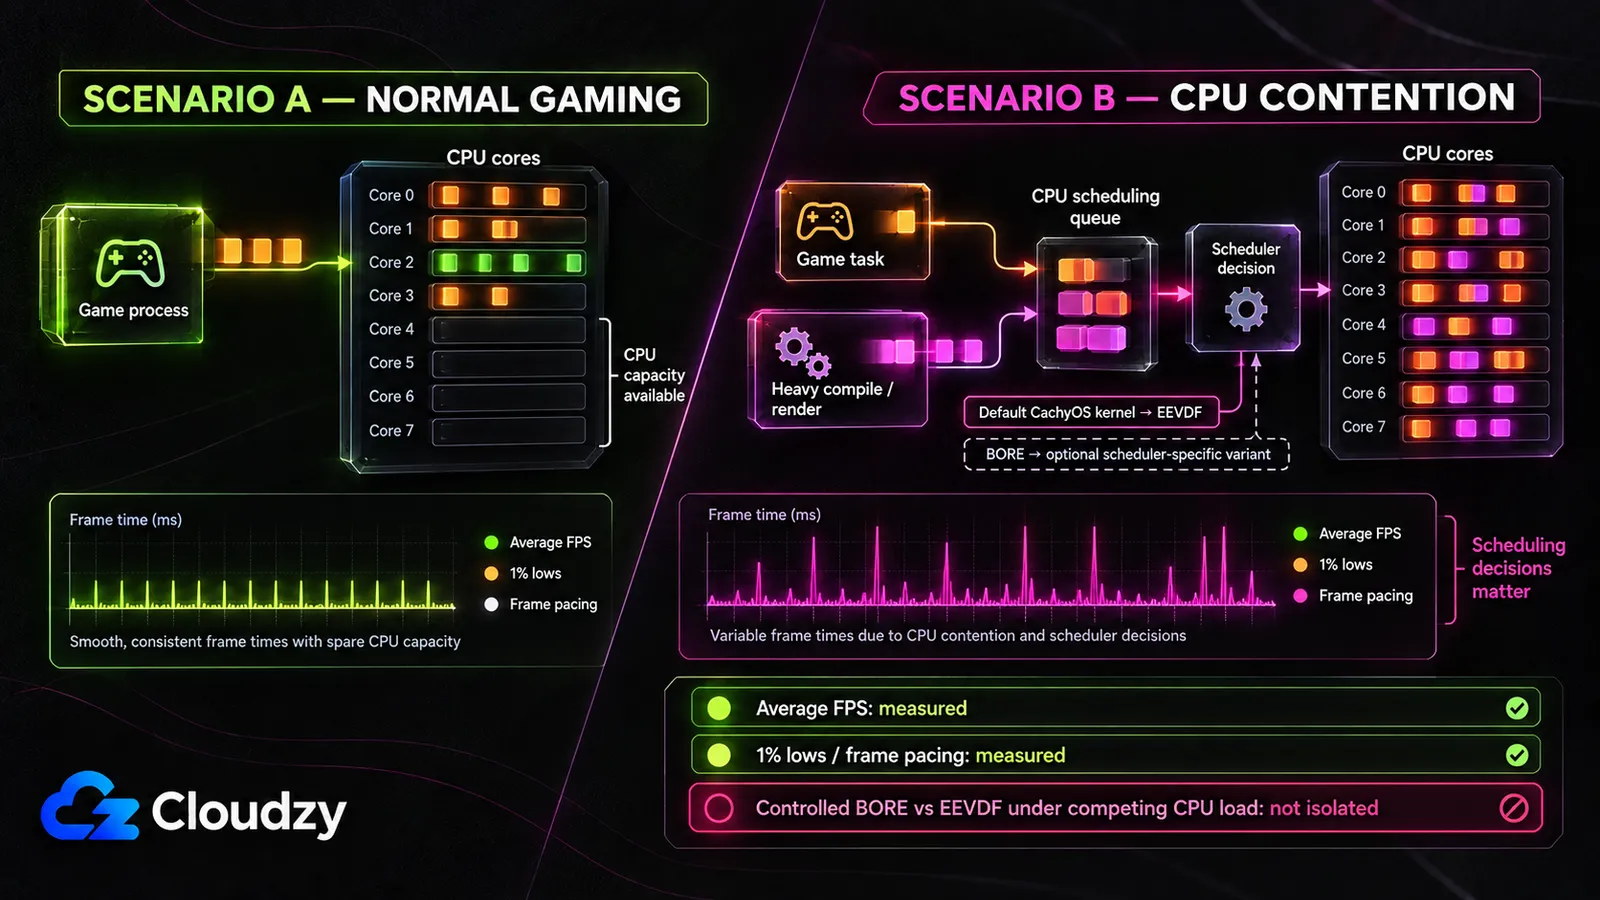
เคอร์เนลค่าเริ่มต้นปัจจุบันของ CachyOS คือ linux-cachyos ซึ่งใช้ EEVDF ส่วน BORE มีให้ผ่านรุ่นเฉพาะตัวจัดตาราง เช่น linux-cachyos-boreความแตกต่างนี้สำคัญเพราะการเปรียบเทียบด้านเกมด้านล่างเป็นการทดสอบระดับดิสโทร ไม่ใช่การทดสอบแบบควบคุมระหว่าง BORE กับ EEVDF BORE ยังเกี่ยวข้องกับข้ออ้างด้านประสิทธิภาพในภาพกว้าง เพราะการออกแบบมุ่งเป้าไปที่ความไวการตอบสนองภายใต้เวิร์กโหลดผสมโดยตรง แต่ข้ออ้างนั้นต้องประเมินแยกจากประสิทธิภาพเกมของ CachyOS แบบติดตั้งมาสด ๆ
README ของ BORE เอง ระบุเจตนาไว้ชัดเจน:
เพื่อให้บรรลุสิ่งนี้ BORE นำมิติของความยืดหยุ่นที่เรียกว่า "burstiness" มาใช้กับแต่ละงานเป็นรายตัว โดยเบี่ยงออกจากหลัก "ความเป็นธรรมโดยสมบูรณ์" ที่เป็นแก่นของ CFS บางส่วน
firelzrd/bore-scheduler, README ของโปรเจกต์
burstiness คือเวลา CPU ที่งานสะสมมาตั้งแต่ครั้งล่าสุดที่มันปล่อย CPU ด้วยการหลับ รอ I/O หรือยอมสละคิว BORE แปลงค่านี้เป็นคะแนนแล้วใช้ปรับน้ำหนักของแต่ละงานและระดับความก้าวร้าวของการแย่งคิวตอนตื่น ทำให้งานที่ยอมสละคิวบ่อยถูกมองว่าเป็นงานโต้ตอบและได้เปรียบงานที่กินเวลาเต็มสไลซ์ README ระบุข้อแลกเปลี่ยนไว้เองว่า BORE จะเข้าสู่ "สมดุลระหว่างงานที่โลภและอ่อนแอ (มักเป็นงานแบตช์ที่ผูกกับ CPU) กับงานที่ถ่อมตัวและแข็งแรง (มักเป็นงานโต้ตอบที่ผูกกับ I/O)" การเพิ่มน้ำหนักงานโต้ตอบก็คือการลดน้ำหนักงานแบตช์เชิงปริมาณงานนั่นเอง
นั่นบอกว่าเครื่องมือใดจะตรวจจับข้ออ้างเฉพาะของ BORE ได้: ใส่โหลด CPU คู่แข่งเข้าไปแล้ววัดเปอร์เซ็นไทล์เวลาเฟรมหรือความหน่วงอินพุตโดยเปลี่ยนแค่ตัวจัดตาราง ตัวจัดตารางมีเรื่องให้ตัดสินน้อยกว่ามากเมื่อเกมรันโดยมี CPU ว่างเหลือ
เบนช์มาร์กห้าเกม ที่เผยแพร่เมื่อ 16 พฤษภาคม 2026 ใช้การติดตั้ง CachyOS และ Omarchy ใหม่สะอาดบน SSD และฮาร์ดแวร์เดียวกัน คือ RTX 5060 Ti กับ Ryzen 9 ด้วยบิลด์ Proton-GE เดียวกันและการตั้งค่า 1440p FPS เฉลี่ยต่างกันเพียงหนึ่งถึงสองเฟรม สองวันต่อมา ผู้ทดสอบคนเดิมเผยแพร่ การเปรียบเทียบครั้งที่สองพร้อมการบันทึกเฟรมเต็มรูปแบบด้วย MangoHUDโดยเพิ่ม 5% low, 1% low และความแปรปรวนของความสม่ำเสมอของเฟรม การทดสอบครั้งที่สองใช้ฮาร์ดแวร์ต่างกัน คือ Intel i7-13700 กับ Radeon RX 9060 XT จึงเป็นหลักฐานเพิ่มเติมเรื่องความสม่ำเสมอของเฟรม ไม่ใช่การขยายผลการทดสอบแรกบนฮาร์ดแวร์เดียวกัน การเปรียบเทียบทั้งสองไม่ได้แยกตัวจัดตาราง CPU ออกมาทดสอบ และไม่ได้เพิ่มเวิร์กโหลด CPU คู่แข่งโดยเจตนา
โปรเจกต์เองก็ไม่ได้โฆษณาเกินจริง ใน กระทู้ r/cachyos เรื่องประสิทธิภาพเกมPeter Jung หนึ่งในนักพัฒนาผู้ก่อตั้ง CachyOSตอบผู้ใช้ตรง ๆ ว่า "In gaming not all too much. The newer feature can make a difference tough :)" (ในเกมไม่มากเท่าไร แต่ฟีเจอร์ใหม่กว่าอาจสร้างความต่างได้)
นั่นทิ้งข้อสรุปแยกกันสองข้อ สำหรับการเล่นเกมบน CachyOS แบบติดตั้งมาสด ๆ การทดสอบที่เผยแพร่แสดง FPS เฉลี่ยต่างกันน้อย และตอนนี้มีการวัด 1% low กับความสม่ำเสมอของเฟรมแล้ว ส่วน BORE โดยเฉพาะภายใต้การแย่ง CPU โดยเจตนา ผมหาการทดสอบแบบควบคุมที่เผยแพร่ซึ่งเปลี่ยนแค่ตัวจัดตารางและวัดความไวการตอบสนองภายใต้โหลดนั้นไม่พบ
ทำไมการย้ายถึงรู้สึกเร็วขึ้นแม้วัดอะไรไม่ได้ว่าเร็วขึ้น
กลไกสองอย่างทำให้เครื่องลื่นขึ้นหลังเปลี่ยนดิสโทรโดยไม่เกี่ยวกับการปรับแต่งใด ๆ ของ CachyOS: ตัวการติดตั้งใหม่เอง และการที่ปัญหาที่ไม่เกี่ยวข้องของระบบเดิมบังเอิญหายไป ทั้งสองอย่างเฉพาะเจาะจงพอที่จะสังเกตได้ในกรณีของคุณเอง ซึ่งเป็นสิ่งที่แยกมันออกจากข้อกล่าวหากว้าง ๆ ว่าเป็นแค่ยาหลอก
เริ่มจากการติดตั้งใหม่ ใน กระทู้ r/linuxquestions เรื่องคำถามนี้ผู้ใช้ CachyOS ที่บอกว่าตัวเองไม่สังเกตเห็นความต่าง เสนอว่าคนที่รายงานผลได้มาก ๆ อาจกำลังเทียบกับการติดตั้งที่ใช้มานานแทนที่จะเป็นการติดตั้งใหม่ รายการเริ่มอัตโนมัติที่สะสมมาหลายปี เซอร์วิสที่ถูกทิ้ง การตั้งค่าที่เพี้ยนไป และดิสก์ที่เต็ม ล้วนเป็นเวิร์กโหลด และพาร์ติชันสะอาดล้างทั้งหมดในคราวเดียว การเปลี่ยนดิสโทรเปลี่ยนเคอร์เนล สภาพแวดล้อมเดสก์ท็อป ทุกเวอร์ชันแพ็กเกจ และทุกค่าเริ่มต้นพร้อมกัน และ การเปรียบเทียบ Manjaro กับ Ubuntu ฉบับเต็ม กินพื้นที่กว่าสิบแกนแยกกัน การโยนผลที่ดีขึ้นให้แกนใดแกนหนึ่งในภายหลังเป็นแค่การเดา
บั๊กที่บังเอิญหายเป็นกรณีที่ชัดกว่า ในกระทู้เดียวกัน ผู้แสดงความเห็นคนหนึ่งเล่าว่าใช้ Fedora ประจำวันพร้อมปัญหาการจัดการ VRAM ที่ทำให้ประสิทธิภาพตกหนัก จากนั้นย้ายไป CachyOS แล้วปัญหาหายไป ต่อมาเขาย้ายไป Arch เปล่า ๆ และรายงานว่าประสิทธิภาพแทบเท่า CachyOS จนสรุปว่าไม่รู้แล้วว่าอะไรที่ต่างกัน การปรับปรุงเป็นของจริง แต่เป้าหมายคอมไพล์ของ CachyOS ไม่เกี่ยวเลย
ทั้งสองอย่างไม่ได้ให้สิทธิ์หักล้างเรื่องนี้แบบเด็ดขาด และหลักฐานที่แข็งแรงที่สุดต่อการหักล้างนั้นคือการทดสอบแบบควบคุม การเปรียบเทียบดิสโทรบน Arrow Lake ของ Phoronix นำ Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux และ CachyOS มาลงบน Intel Core Ultra 9 285K เครื่องเดียวกันในสภาพค่าเริ่มต้น และ CachyOS เฉือนชนะทั้งหมด รวมถึง Clear Linux ที่ปกติเป็นผู้นำบนซิลิคอนของ Intel Arrow Lake ไม่รองรับ AVX-512 ดังนั้นความได้เปรียบนี้มาจาก x86-64-v4 ไม่ได้ แต่สะท้อนการผสมกันของตัวเลือกเคอร์เนลและการบิลด์ของ CachyOS การปรับแต่งแพ็กเกจ และการตั้งค่าเริ่มต้น
ประสบการณ์อาจเป็นของจริงขณะที่การระบุสาเหตุยังไม่แน่นอน การเปรียบเทียบ Arrow Lake ของ Phoronix เป็นตัวอย่างแย้งที่มีประโยชน์: การติดตั้ง CachyOS ในสภาพค่าเริ่มต้นสามารถเหนือกว่า Arch มาตรฐานได้แม้ x86-64-v4 จะใช้ไม่ได้
วิธีตรวจสอบว่าเรื่องเหล่านี้ใช้กับเครื่องของคุณหรือไม่
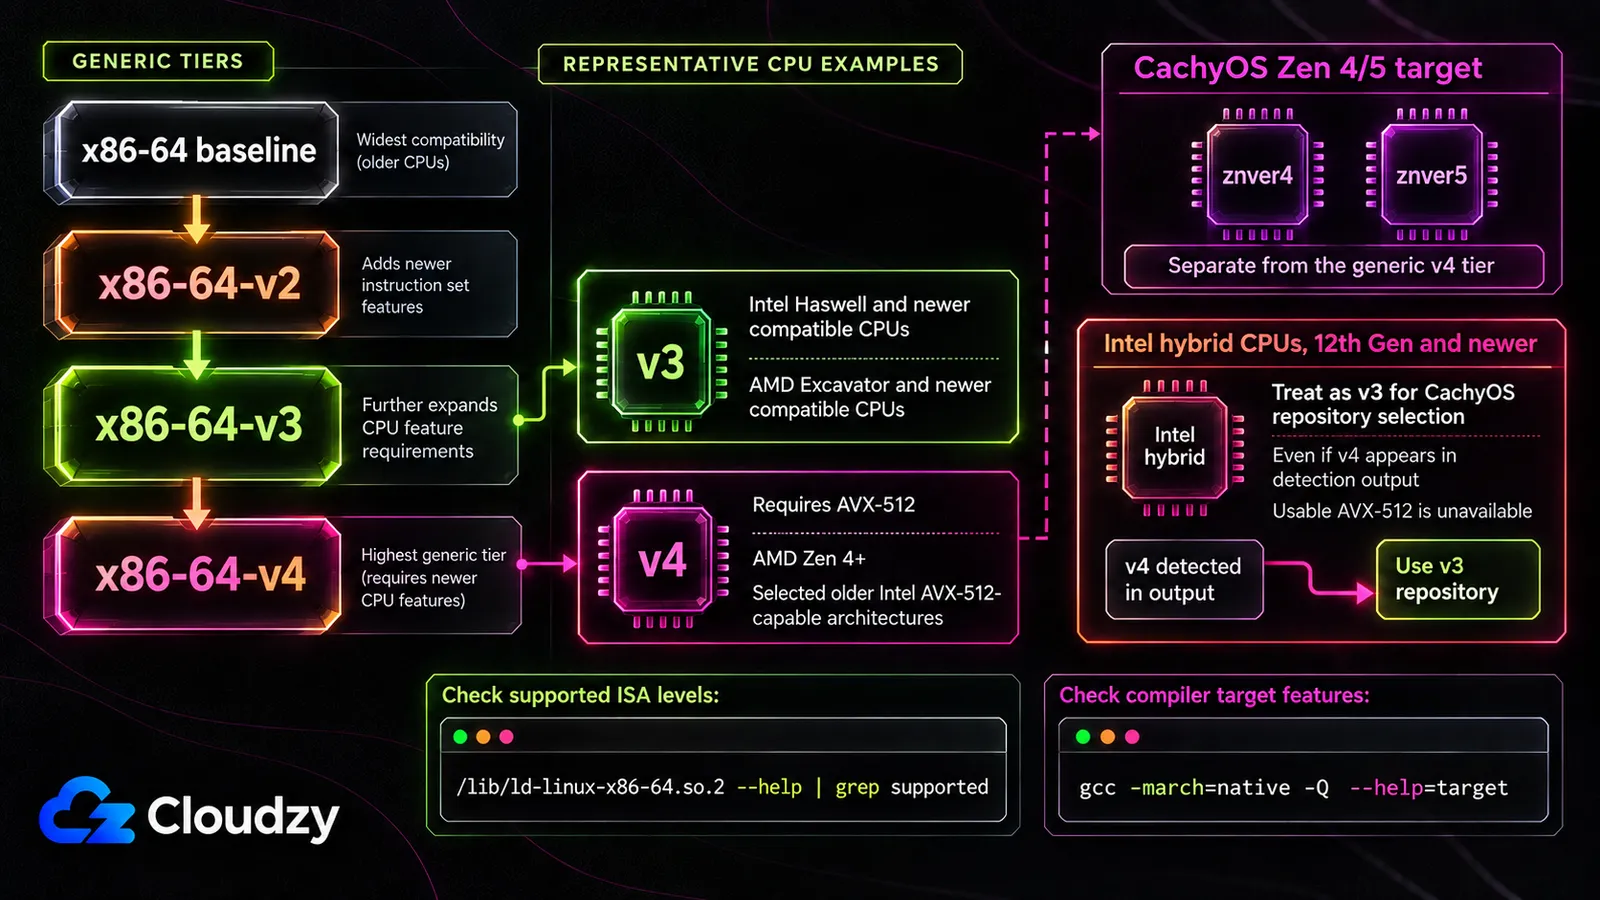
CPU ของคุณรองรับระดับสถาปัตยกรรมย่อย x86-64 มาตรฐานระดับใด ส่วนใหญ่ตอบได้ด้วยคำสั่งเดียว ตัวลิงก์แบบไดนามิกจะรายงานระดับ glibc-hwcaps ที่ใช้ได้ ดังนั้นรายการ x86-64-vN สูงสุดที่รองรับมักบอกได้ว่า CPU เข้าเกณฑ์ชั้นรีโพซิทอรีทั่วไป v2, v3 หรือ v4 ข้อยกเว้นสำคัญหนึ่งคือ CPU ไฮบริดของ Intel เจนเนอเรชัน 12 ขึ้นไป: CachyOS ให้ถือว่าเป็น v3 แม้ v4 จะปรากฏในผลลัพธ์ เพราะใช้ AVX-512 ไม่ได้ เป้าหมาย Zen 4/5 แยกต่างหากของ CachyOS ก็ต้องตรวจสอบสถาปัตยกรรมของตัวเองด้วย
/lib/ld-linux-x86-64.so.2 --help | grep supportedสำหรับ AMD Zen 4/5 CachyOS ยังระบุไว้ด้วยว่า:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"คำสั่งแรกจะพิมพ์อะไรทำนองนี้:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
นั่นคือ CPU ที่มี v3 และ v2 แต่ไม่มี AVX-512 สามผลลัพธ์ สามการตัดสินใจ:
- ไม่มีอะไรเหนือ x86-64-v2 ข้อได้เปรียบของการบิลด์ใหม่เฉพาะ v3/v4/Zen ใช้กับ CPU นี้ไม่ได้ CachyOS ยังรันได้ และการปรับแต่งคอมไพเลอร์เฉพาะแพ็กเกจรวมถึงการเปลี่ยนแปลงเคอร์เนลและการตั้งค่าเริ่มต้นยังอาจมีผล
- รองรับ x86-64-v3 แต่ใช้ x86-64-v4 ไม่ได้ ซึ่งรวมถึง CPU ไฮบริดรุ่นใหม่ของ Intel อย่าง Arrow Lake ในแง่การเลือกรีโพซิทอรีจริง ในการเปรียบเทียบที่อ้างข้างต้น การเปลี่ยนแปลงหลายรายการมีขนาดเล็ก เวิร์กโหลดการเข้ารหัสและการบีบอัดบางส่วนได้ผลมากกว่ามาก และบางแพ็กเกจถดถอย
- รองรับ x86-64-v4 AVX-512 สร้างพื้นที่ทางทฤษฎีมากขึ้นสำหรับเวิร์กโหลดที่ทำเวกเตอร์ไรซ์ได้ แต่ไม่รับประกันผลได้ก้อนใหญ่ทั่วทั้งระบบ
ถ้า CPU ของคุณเข้าเกณฑ์และคุณต้องการแค่ส่วนของแพ็กเกจ ไม่จำเป็นต้องติดตั้งใหม่เพื่อให้ได้มา รีโพซิทอรีของ CachyOS เพิ่มเข้าระบบ Arch ที่มีอยู่ได้ และ ALHP เผยแพร่การบิลด์ใหม่ของรีโพซิทอรีทางการของ Arch ในแต่ละระดับ x86-64-vN ซึ่งมีเอกสารบน Arch Wiki พร้อมข้อควรระวังของตัวเอง: ต้องใช้แพ็กเกจ DKMS แทนโมดูลเคอร์เนลที่ลิงก์โดยตรง และการตั้งค่า -march สำหรับการคอมไพล์เคอร์เนล "จะไม่ให้ผลที่มีนัยสำคัญ" ทั้งสองเส้นทางให้แพ็กเกจที่คอมไพล์ใหม่ แต่ไม่ได้ชุดแพตช์เคอร์เนลหรือตัวจัดตารางรุ่นต่าง ๆ เลย
รันคำสั่งก่อน มันเปลี่ยนการเถียงเรื่องดิสโทรให้เป็นข้อเท็จจริงเกี่ยวกับเครื่องของคุณเอง ซึ่งเป็นคำถามเวอร์ชันเดียวที่คุณตัดสินได้ด้วยตัวเองคืนนี้

พัฒนาบน Linux VPS พร้อมสิทธิ์รูท, NVMe และพลัง AMD EPYC
ดูแพ็กเกจ Linuxคำถามที่พบบ่อย
CachyOS ช่วยเพิ่มประสิทธิภาพเกมจริงหรือ?
ในแง่เฟรมเรตเฉลี่ย แทบไม่ การเปรียบเทียบห้าเกมเมื่อพฤษภาคม 2026 พบต่างกันแค่หนึ่งถึงสองเฟรม และการทดสอบต่อเนื่องสองวันต่อมาก็วัด 1% low และความสม่ำเสมอของเฟรมด้วย ทั้งสองการทดสอบไม่ได้ใส่เวิร์กโหลด CPU คู่แข่งโดยเจตนา คำถามที่ยังไม่มีคำตอบจึงเป็นความไวการตอบสนองของตัวจัดตารางภายใต้การแย่งทรัพยากร ไม่ใช่ว่าวัดความสม่ำเสมอของเฟรมแล้วหรือยัง
CPU ของฉันรองรับ x86-64-v3 หรือ v4 ไหม?
บน CachyOS หรือ Arch ให้รัน /lib/ld-linux-x86-64.so.2 --help | grep supported เพื่อดูระดับ glibc-hwcaps มาตรฐานที่ตรวจพบสำหรับ CPU ของคุณ x86-64-v3 ต้องการชุดฟีเจอร์ยุค AVX/AVX2 ส่วน v4 เพิ่ม AVX-512 สำหรับ CPU ไฮบริดของ Intel เจนเนอเรชัน 12 ขึ้นไป CachyOS แนะนำให้ถือว่าระบบเป็น v3 แม้ v4 จะปรากฏในผลลัพธ์ ผู้ใช้ Zen 4/5 ควรตรวจสอบเป้าหมาย znver4/znver5 แยกต่างหากด้วย
ทำไมแพ็กเกจที่คอมไพล์ใหม่ถึงไม่สร้างความต่างมากกว่านี้?
เพราะโค้ดที่ปรับแต่งอย่างหนักบางส่วนถูกส่งไปยังการใช้งานเฉพาะ CPU ตอนรันอยู่แล้ว ไลบรารีคณิตศาสตร์และการเข้ารหัสลับมักใช้ function multiversioning หรือ IFUNC กับฟังก์ชันร้อน ดังนั้นการบิลด์แพ็กเกจใหม่จึงช่วยโค้ดที่คอมไพเลอร์ยังปรับแต่งหรือทำเวกเตอร์ไรซ์เพิ่มได้ในภาพรวมเป็นหลัก
ฉันจะได้แพ็กเกจที่ปรับแต่งของ CachyOS โดยไม่เปลี่ยนดิสโทรได้ไหม?
ได้ รีโพซิทอรีของ CachyOS เพิ่มเข้ากับการติดตั้ง Arch Linux ที่มีอยู่ได้ และโปรเจกต์ ALHP เผยแพร่การบิลด์ใหม่ของรีโพซิทอรีทางการของ Arch สำหรับ x86-64-v2, v3 และ v4 ซึ่งมีเอกสารบน Arch Wiki ทั้งสองทางให้แค่แพ็กเกจที่คอมไพล์ใหม่ ไม่ได้ชุดแพตช์เคอร์เนลของ CachyOS ตัวจัดตารางทางเลือก หรือค่าเริ่มต้นของตัวติดตั้ง
การสนทนา
ความคิดเห็น
เข้าสู่ระบบเพื่อร่วมสนทนา