

Те, що ви побудували, працює в продакшені. Моніторингу у вас або немає зовсім, або це простий пінг доступності, а минулого тижня про збій вам повідомив користувач. Усі відповіді, яких ви шукаєте, вказують на одне й те саме ім'я.
Цей огляд Prometheus — про розрив між двома твердженнями, які обидва правдиві. Він безкоштовний і з відкритим кодом, без ліцензій і без рахунків за метрики на будь-якому масштабі. Він також коштує вам одного вечора плюс мови запитів, якої ви ще не знаєте. Це збирач метрик на основі pull із вбудованим алертингом, і це чудова програма. А от чи саме та це програма для установки, яку ви тримаєте просто зараз, — питання інше, і саме на нього варто відповісти.
Коротко
- Вердикт: 3,5 / 5 для self-hosted-установок соло-розробників і невеликих команд. Prometheus варто запускати, якщо ваш набір хостів і сервісів достатньо стабільний, якщо ви готові витратити час на вивчення PromQL і якщо вам потрібні метрики, які цілком належать вам, без підписки й без рахунку за зберігання.
- Відмовтеся, якщо питання, на яке вам потрібна відповідь, — «чи воно працює». Чекер доступності приведе вас до цієї відповіді значно швидше, а братися за Prometheus заради такого завдання — це платити мовою запитів за те, що можна було з'ясувати за десять хвилин.
- PromQL — це витрата, яка повертається знову і знову. Налаштування — разова витрата. Але щойно ваші питання переростають готові дашборди й візуальний конструктор Grafana, ви знову опиняєтеся в PromQL.
- Вартість обслуговування залежить від того, яку частину установки ви ведете вручну. Парк, що зберігає форму, обходиться в моніторингу дешево. А той, що додає, втрачає й перейменовує хости, — це саме те місце, де витрати тихо накопичуються.
- Цей вердикт обмежений self-hosted-установками невеликого масштабу. На масштабі Kubernetes і продакшен-SRE Prometheus — зовсім інша пропозиція, і на те питання цей огляд відповідати не береться.
Як готувався цей огляд: Prometheus безкоштовний і відкритий, тож жодних стосунків із вендором тут немає й ніхто мені нічого не надсилав. Факти про версії та поведінку сховища взято з власної документації Prometheus. Цифри щодо ресурсів і час налаштування взято з двох незалежно опублікованих практичних тестів, із посиланням у тому місці, де кожен із них використано. Там, де ці два тести розходяться, ви побачите обидві цифри, а не середнє.
Що охоплює цей огляд
Вердикт вище має межі, і тут ці межі важать більше, ніж зазвичай, бо на різних масштабах Prometheus поводиться як різний інструмент.
- Prometheus оцінюється для self-hosted-установок на одному VPS і невеликих проєктів: жменька хостів і сервісів, одна людина, яка за ними стежить.
- Не Kubernetes. Prometheus Operator, ServiceMonitors і kube-prometheus-stack — це окремий операційний світ, і вердикт тут не говорить про нього нічого.
- Не посібник із маршрутизації Alertmanager. Алертинг є і працює; налаштування маршрутів, сайленсів і отримувачів — тема сама по собі.
- Не покрокове встановлення. Питання тут у тому, чи взагалі його запускати. Якщо на це ви вже відповіли, наш посібник із Grafana та Prometheus у Docker Compose описує кроки.
- Не огляд експортерів. Експортери згадуються лише там, де вони змінюють відповідь.
У чому Prometheus добрий
Prometheus не коштує нічого. Не «безкоштовний тариф із платними покращеннями» і не «безкоштовно, доки не перевищите ліміт метрик». Репозиторій ліцензовано під Apache 2.0 від початку й до кінця, платної редакції основного проєкту немає, і ніде немає тарифікації за хост, за метрику чи за лейбл. Єдиний рахунок, який породжує Prometheus, — це сервер, на якому він працює.
Для того, на що ви збираєтеся спиратися, питання «чи буде це тут через три роки» цілком доречне, і тут шанси приблизно такі гарні, як це взагалі буває у відкритому коді. Prometheus випустився з CNCF у серпні 2018 року — другим проєктом в історії, після Kubernetes. Релізи виходять рівно, а v3.13.2 вийшла наприкінці липня 2026 року; оскільки ця гілка релізів належить до лінії довгострокової підтримки, вона отримує виправлення помилок, безпеки й документації протягом року, тож залишатися на актуальних патчах не означає ганятися за кожною мінорною версією.
Модель даних пояснює, чому екосистема навколо нього така глибока. Prometheus збирає метрики через HTTP і ідентифікує кожен ряд назвою метрики плюс лейблами ключ/значення, через що написати експортер — невелика робота. Тому експортери є майже для всього, що ви реально можете запускати: метрики вузла, Postgres, Nginx, Redis, blackbox-проби для того, що можна перевірити лише ззовні.
І ви володієте тим, що він збирає, — а це та частина, яка зазвичай важлива не першого дня, а пізніше. Історія невеликої установки займає незначний обсяг диска (цифри нижче), ніхто не перецінить її вам наступного кварталу, і немає рядка в рахунку, який росте щоразу, коли хтось додає інструментування в застосунок. Якщо ви хоч раз бачили, як рахунок за керований моніторинг повзе вгору через те, що розробник додав один лейбл, — увесь аргумент вміщається в це речення.
Де Prometheus коштує дорожче, ніж здається
Тест на dev.to, у якому сім інструментів моніторингу перевіряли на одному невеликому VPS виміряв 15 хвилин на налаштування самого лише Prometheus. Поєднайте його з Grafana, як зробив автор тесту, бо вбудований браузер виразів — це лише місце, де виконують запити. Той самий тест дає парі Grafana + Prometheus 35 хвилин до першого графіка, з YAML-конфігурацією збору десь посередині.
Хвилини — дешева частина. Дорога — PromQL. Prometheus зберігає все як часові ряди, визначені назвою та лейблами, і PromQL досі лишається мовою під тими питаннями, які ви йому ставите. У Grafana тепер є візуальний конструктор, тож писати кожен запит вручну не доведеться. Власний вердикт автора тесту був прямим: PromQL чудовий, якщо ви в ньому живете, а він не жив. Якщо ви ніколи не працювали з мовою запитів, закладайте на це більше ніж один вечір і розраховуйте повертатися до неї щоразу, коли візуального конструктора перестане вистачати. Дашборд, скопійований у когось іншого, відповідає на його питання. Ваші — це запит, який ви ще не написали.
Третя стаття витрат проявляється не одразу. Один тритижневий звіт оператора описує рівно те, у що обійшлося додавання одного сервера до установки із семи вузлів: перерозмітка лейблів, повторна перевірка конфігурацій збору, правка змінних дашбордів і переробка шаблонних запитів, щоб новий хост з'явився у випадних списках. Той оператор відмовився від стека за три тижні, дійшовши висновку, що витрачає більше часу на підкручування дашбордів, ніж на спостереження за інфраструктурою.
Зверніть увагу, до чого прив'язана ця витрата в такій установці: до цілей і дашбордів, якими керують вручну. Два спокійні роки роботи Prometheus не коштують вам майже нічого понад те.
Скільки RAM і диска насправді потрібно Prometheus?
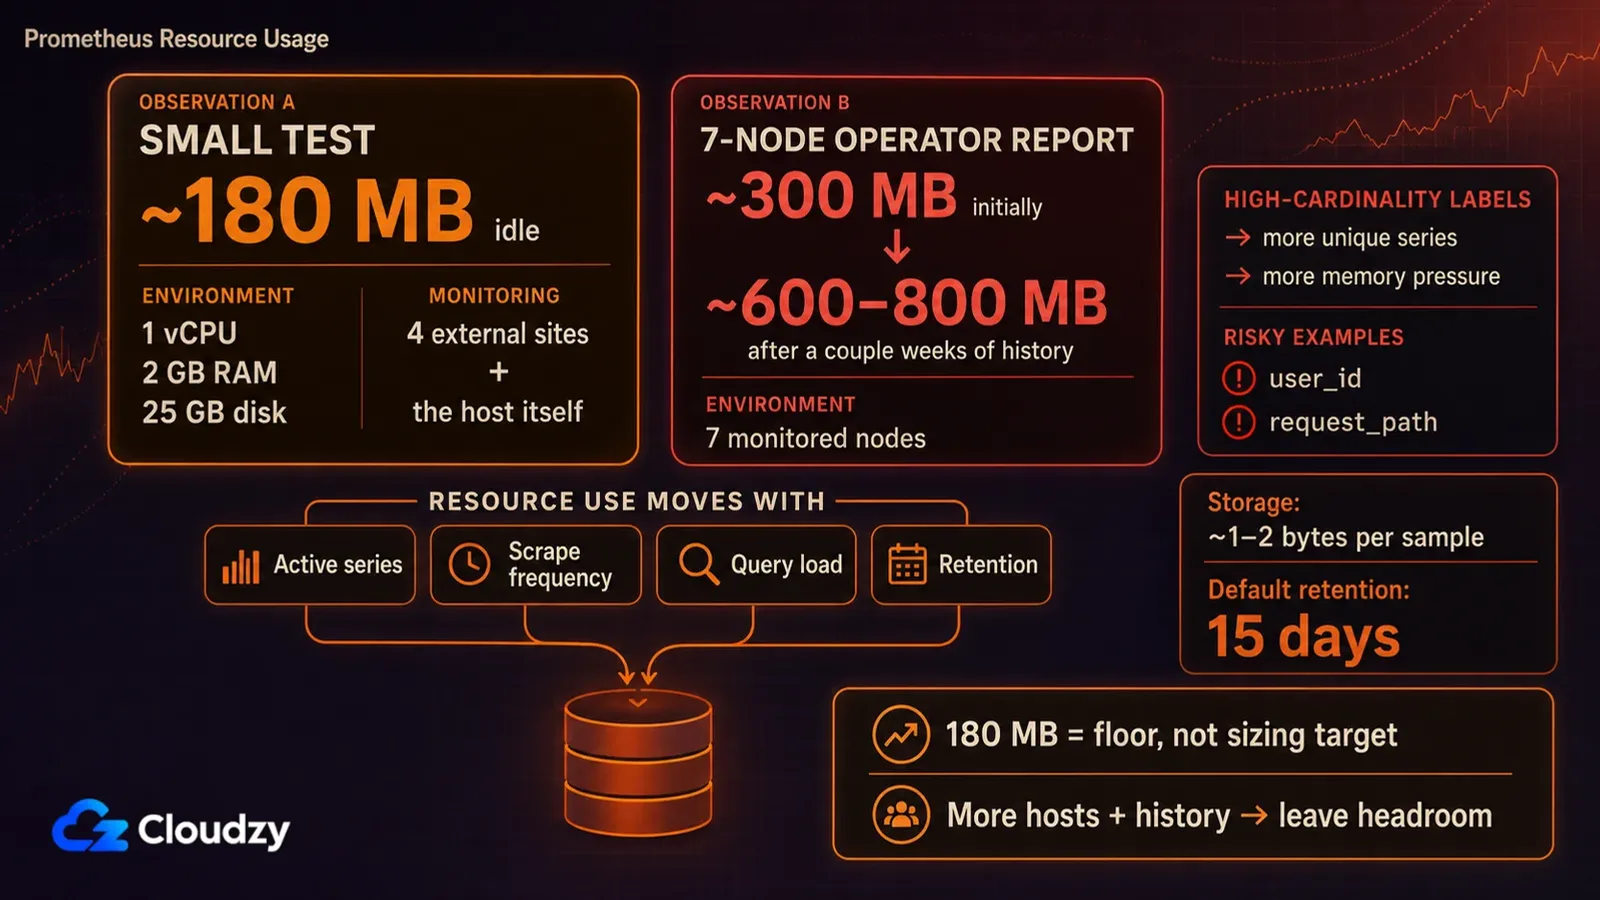
Фіксованої вимоги немає. Активні ряди, частота збору, навантаження запитами й термін зберігання важать більше, ніж проста кількість серверів, на які ви його націлили. Два опубліковані практичні тести невеликих установок дають діапазон приблизно від 180 МБ до 800 МБ, причому більша цифра стосується семи вузлів із кількома тижнями історії.
Два тести розходяться, і корисною є саме ця розбіжність. Те саме порівняння семи інструментів на VPS ганяло кожен із них на однаковому залізі (1 vCPU, 2 ГБ RAM, 25 ГБ диска, Ubuntu 24.04), спостерігаючи за чотирма зовнішніми сайтами та самим хостом, і намиряло Prometheus близько 180 МБ у простої. Той самий оператор повідомляв, що один лише Prometheus у простої тримався близько 300 МБ на центральному хості й піднімався до 600–800 МБ, щойно накопичувалося кілька тижнів історії.
Це не одне й те саме вимірювання, і саме тому усереднювати їх — означає викинути інформацію. Одне — майже холостий замір на машині, якій майже нічого зберігати. Друге — робоче розгортання з парком за спиною та історією на диску. Моє прочитання: вважайте результат у 180 МБ підлогою, а не цільовим розміром. Щойно ви збираєте з кількох хостів і зберігаєте історію, закладайте запас замість того, щоб планувати за цією цифрою простою.
Диск — проста половина. Документація Prometheus зі сховища оцінює його в середньому в 1–2 байти на семпл, тож тримати довгу історію для невеликої установки дешево. Підступ у значенні за замовчуванням: термін зберігання за замовчуванням дорівнює 15 дням якщо ви не задали час або розмір зберігання. Від року це відділяє один прапорець запуску, і це саме той тип замовчування, про який краще дізнатися зараз, а не тоді, коли ви вперше полізете по цифри минулого місяця й побачите, що вони спливли три тижні тому.
Цифру пам'яті вгору тягне кардинальність: кількість різних часових рядів, де кожна унікальна комбінація лейблів на метриці стає окремим рядом. Один невдало обраний лейбл на метриці з великим трафіком здатен породити більше рядів, ніж п'ять додаткових серверів, і робить це мовчки, рівно з тією швидкістю, з якою йде ваш трафік. (Ідентифікатор користувача або шлях запиту виглядають чудовим лейблом рівно до моменту, коли ви порахуєте, скільки їх.)
Будь-яка цифра RAM, яку ви знайдете щодо Prometheus, придатна лише разом зі знанням того, скільки рядів за нею стояло.
Що станеться, коли ваш сервер Prometheus впаде?
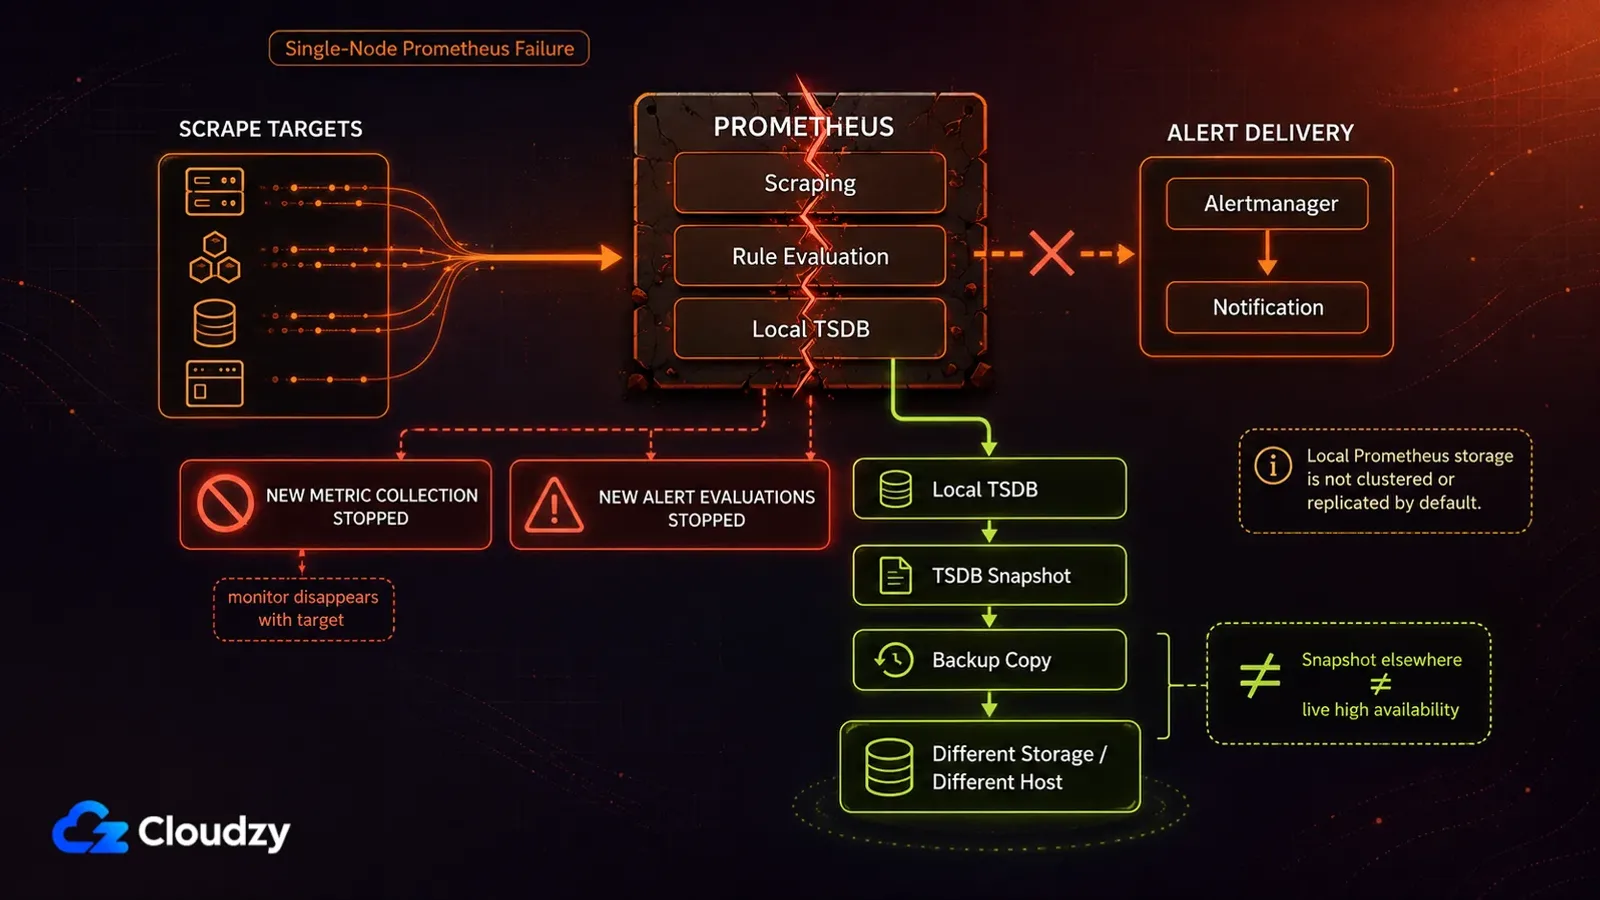
Власна документація Prometheus зі сховища каже про це прямо: локальне сховище не кластеризоване й не реплікується, тому воно не переживе відмову диска чи вузла. Кожен сервер за задумом автономний і не залежить ні від мережевого сховища, ні від віддалених сервісів, — саме це робить його простим в експлуатації і саме це лишає його вразливим.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Є й друга межа, яку проєкт заявляє про самого себе, і за це його варто похвалити: якщо вам потрібна 100 % точність, наприклад для потарифного виставлення рахунків, документація каже, що Prometheus — неправильний вибір, бо дані, які він збирає, найімовірніше будуть недостатньо детальними й повними. Для цифр, за якими ви виставляєте рахунки, візьміть щось інше, а Prometheus лишіть для моніторингу. Вендори зазвичай не повідомляють про себе такого з власної волі.
На більшому масштабі на це є усталені відповіді, і вони поза межами цього тексту з тієї самої причини, що й інструментарій Kubernetes: це інший рівень операційних зобов'язань, ніж той, який покриває огляд. Для одного VPS моє прочитання таке: ризик прийнятний, якщо ви тримаєте снапшоти TSDB в іншому місці або наперед погоджуєтеся втратити історію, і це справжня проблема, якщо Prometheus — єдине, що стоїть між вами та тихим збоєм.
Кому варто тримати Prometheus у себе?
Найясніший сигнал, що Prometheus окупить свою ціну, ніяк не пов'язаний із тим, скільки у вас серверів. Він пов'язаний із тим, чи будуть це ті самі сервери через півроку. Стабільний набір хостів, налаштованих вручну, означає, що конфігурацію ви пишете один раз, а історію отримуєте безкоштовно; набір, який постійно змінюється, означає, що ви постійно правите цю конфігурацію.
У статичній установці ваша конфігурація Prometheus і Grafana — це явний опис вашої інфраструктури: цілі збору, прив'язані до них лейбли й дашборди, побудовані поверх цих лейблів. Саме тому вся віддача — в історії. Рік даних по стабільному набору хостів показує вам, який вигляд має норма, а це найнадійніший спосіб розпізнати аномалію до того, як вона переросте у збій.
Отже, перший профіль — це той, хто тримає невеликий, повільно змінюваний набір серверів і хоче більшого, ніж «працює чи ні»: затримку запитів у часі, тренди пам'яті, диск, що наповнюється достатньо плавно, аби це було видно за тижні. Якщо ви можете описати свою інфраструктуру сьогодні й очікуєте, що за рік опис лишиться приблизно правдивим, той вечір, витрачений на налаштування, — останній великий рахунок.
Другий — це будь-хто, хто свідомо вивчає цей стек. Якщо ви розраховуєте за кілька років займатися інфраструктурою, своєю чи чужою, вечір із PromQL — це саме те, по що ви прийшли, а моніторинг — побічний ефект. Цей профіль почасти перевертає перший: перевірка на стабільність тут важить менше, бо час, витрачений на перерозмітку лейблів, — це водночас час, витрачений на розуміння того, чим перерозмітка є. Для такого читача я підняв би оцінку.
Третій профіль — про володіння, і його недооцінюють рівно доти, доки не опиняться не на тому боці. Prometheus не бере грошей ні за хост, ні за метрику, ні за лейбл, і жодна сторінка з цінами не зміниться у вас під ногами наступного кварталу. Розмін порівняно з керованим сервісом на кшталт Datadog: ви відмовляєтеся від лиску, контракту на підтримку й чужого чергування, а натомість отримуєте метрики, які належать вам, і рахунок, що не рухається, коли розробник додає інструментування. Чи це добрий розмін, залежить від того, скільки коштують ваші власні години, — число, яке можете підставити тільки ви (і воно рідко дорівнює нулю, навіть коли так здається).
Що варто знати, перш ніж підписуватися на це: перерости локальне сховище Prometheus — не глухий кут. VictoriaMetrics приймає remote write від Prometheus, а MetricsQL зворотно сумісний із PromQL, тож більшість запитів і дашбордів Grafana, які ви будуєте зараз, мають пережити переїзд. Це міграція, а не переписування.
Це варто переглядати раз на рік, а не вирішувати раз і назавжди: установка, яку сьогодні дешево моніторити, дорожчає в той квартал, коли ви починаєте її перебудовувати.

Розробляйте на Linux VPS з root-доступом, NVMe та потужністю AMD EPYC.
Переглянути тарифи LinuxКому Prometheus не потрібен?
Якщо фраза, якою ви описали б свою потребу, звучить як «повідом мені, коли сайт впаде», то ви описуєте чекер доступності, а Prometheus — забагато механіки заради такої відповіді. Uptime Kuma робить рівно цю роботу, має вебінтерфейс і не вимагає вчити мову запитів для моніторингу. Розрив у можливостях між двома інструментами величезний і геть не стосується того завдання, заради якого ви їх наймаєте.
Другий читач — той, кому потрібні придатні графіки без попереднього вивчення мови запитів. Netdata побудований саме навколо цього: метрики по хостах, на які можна подивитися одразу, зі значно меншою кількістю налаштувань і без нічого між вами та графіками. Якщо питання, яке ви ставите знову й знову, — «чому ця машина зараз гальмує», то це значно коротший шлях до відповіді.
Третій — будь-хто, чия інфраструктура часто змінює форму і хто веде цілі та змінні дашбордів вручну. Хости, підняті на тиждень і знесені, перейменовані цілі, проєкти, перейменовані на півдорозі. Це саме той випадок, коли ви платите за конфігурацію знову й знову, отримуючи при цьому найменше від того, за що платите, — від безперервної історії системи, яка лишається впізнаваною.
Ніщо з цього не є докором інструменту. «Відмовитися» тут означає відмовитися для цього завдання й на цьому масштабі. На масштабі Kubernetes, де service discovery бере на себе більшу частину того, що інакше довелося б зв'язувати руками, кілька з перелічених витрат зменшуються або зникають зовсім, і моє прочитання того масштабу таке, що Prometheus там дуже важко обійти. Але це вже інший огляд.

Часті запитання
Чи Prometheus безкоштовний?
Так, і жодного підступу з безкоштовним тарифом під цим немає. Prometheus ліцензовано під Apache 2.0, комерційної редакції за ним не стоїть, тож немає ні квоти на метрики, яку можна перевищити, ні пропозиції перейти на платну версію з того боку. Ви платите за інфраструктуру й за власний час, а не за ліцензію Prometheus.
Чи потрібна Prometheus Grafana?
Ні, але розраховуйте на неї. Власний браузер виразів Prometheus існує, щоб виконати запит і подивитися на відповідь, — цього досить, аби перевірити одну річ один раз. Усе, що ви хочете лишити відкритим на другому моніторі, — це робота Grafana, і ці два інструменти майже завжди запускають разом.
Чи не забагато Prometheus для одного сервера?
Часто так. Якщо вам треба знати, чи працюють сервер і його сервіси, чекер доступності відповість на це за частку того часу, що піде на налаштування. Prometheus виправдовує своє місце тоді, коли вам потрібні історичні метрики, які можна запитувати, і ви готові вивчити PromQL, щоб до них дістатися.
Скільки часу Prometheus зберігає метрики за замовчуванням?
15 днів, і наперед він не попереджає. Prometheus відкидає семпли, старші за вікно зберігання, якщо ви не збільшили його прапорцем часу або розміру зберігання під час запуску. Задайте його того самого дня, коли ставите, бо розширення вікна пізніше не поверне даних, термін яких уже сплив.



Обговорення
Коментарі
Увійдіть, щоб долучитися до обговорення.