
Zwei Datenbanken können gleich viel Speicherplatz belegen und unterschiedliche VPS-Konfigurationen brauchen. Eine liest wiederholt wenige Zeilen, die andere schreibt dauerhaft, erstellt große Indizes oder muss nach einem Ausfall schnell wiederhergestellt werden. Die Wahl des besten Datenbank-VPS beginnt mit diesen Unterschieden, noch vor dem Anbietervergleich.
Bei einem unverwalteten VPS übernehmen Sie den Datenbankbetrieb. PostgreSQL, MySQL und MariaDB brauchen unterschiedliche Speicherbudgets; auch die Wiederherstellungskapazität gehört in die Planung des Primärservers. Die Startkonfiguration muss Reserven für Backups und Wartung bieten und einen repräsentativen Lasttest bestehen.
Datenbanklast vor der Tarifwahl dimensionieren
Messen Sie aktive Daten und Indizes, gleichzeitige Abfragen bei Spitzenlast, Wachstum und Wiederherstellungsanforderungen vor der Auswahl von CPU, RAM und Speicher. Ergänzen Sie Ressourcen entsprechend dem gemessenen Engpass. Berücksichtigen Sie Wartungsplatz und Anwendungsspitzen auf gemeinsamem Host; das Budget muss Lastspitzen und Normalbetrieb abdecken.
Der Arbeitssatz umfasst häufig genutzte Daten und Indizes, die vom Verbleib im RAM profitieren. Die gespeicherte Größe umfasst auch selten genutzte Daten. Offene Verbindungen sind ebenfalls nicht dasselbe wie aktive Abfragen: inaktive Clients und gleichzeitige Sortierungen haben andere RAM- und CPU-Anforderungen. Erfassen Sie beides sowie Abfragetyp und Lese-/Schreibverhältnis.
Leiten Sie Kaufanforderungen aus einem repräsentativen Lastzeitraum ab:
- Messen Sie den maximalen RAM-Bedarf der Anwendung bei gemeinsamem VPS.
- Erfassen Sie Daten- und Indexgröße, geschätzten Arbeitssatz, gleichzeitige Vorgänge und Wachstum im geplanten Kapazitätszeitraum.
- Messen Sie die Protokollerzeugung und den größten erwarteten Indexaufbau, Tabellenneuschreibvorgang oder sonstigen Wartungsvorgang.
- Legen Sie p95-Latenzziel, tolerierbares Datenverlustfenster und Wiederherstellungsziel fest.
- Bestimmen Sie den Anwendungsstandort und testen Sie den Pfad zur Datenbank.
Die Überwachungsdokumentation von PostgreSQL empfiehlt Datenbankstatistiken zusammen mit Betriebssystemwerkzeugen. Erfassen Sie CPU, Speicherdruck und Datenträgeraktivität neben Abfrage- und Commit-Zeiten. Ein Latenzanstieg während des Backups muss untersucht werden, selbst wenn ein Leerlauftest unauffällig ist.
Dedizierte vCPUs bieten dauerhaft Zugriff auf zugewiesene CPU-Ressourcen. Sie sind weder ein ganzer physischer Server noch eine IOPS-Zusage. Bewerten Sie CPU-Zuweisung, RAM und Speicherverhalten getrennt. Übersteigen gemessene Anforderungen die VPS-Angebote, prüfen Sie dedizierte Hardware, statt aus dem Namen eines größeren Tarifs zu extrapolieren.
SQL-Lasten einer Startkonfiguration zuordnen
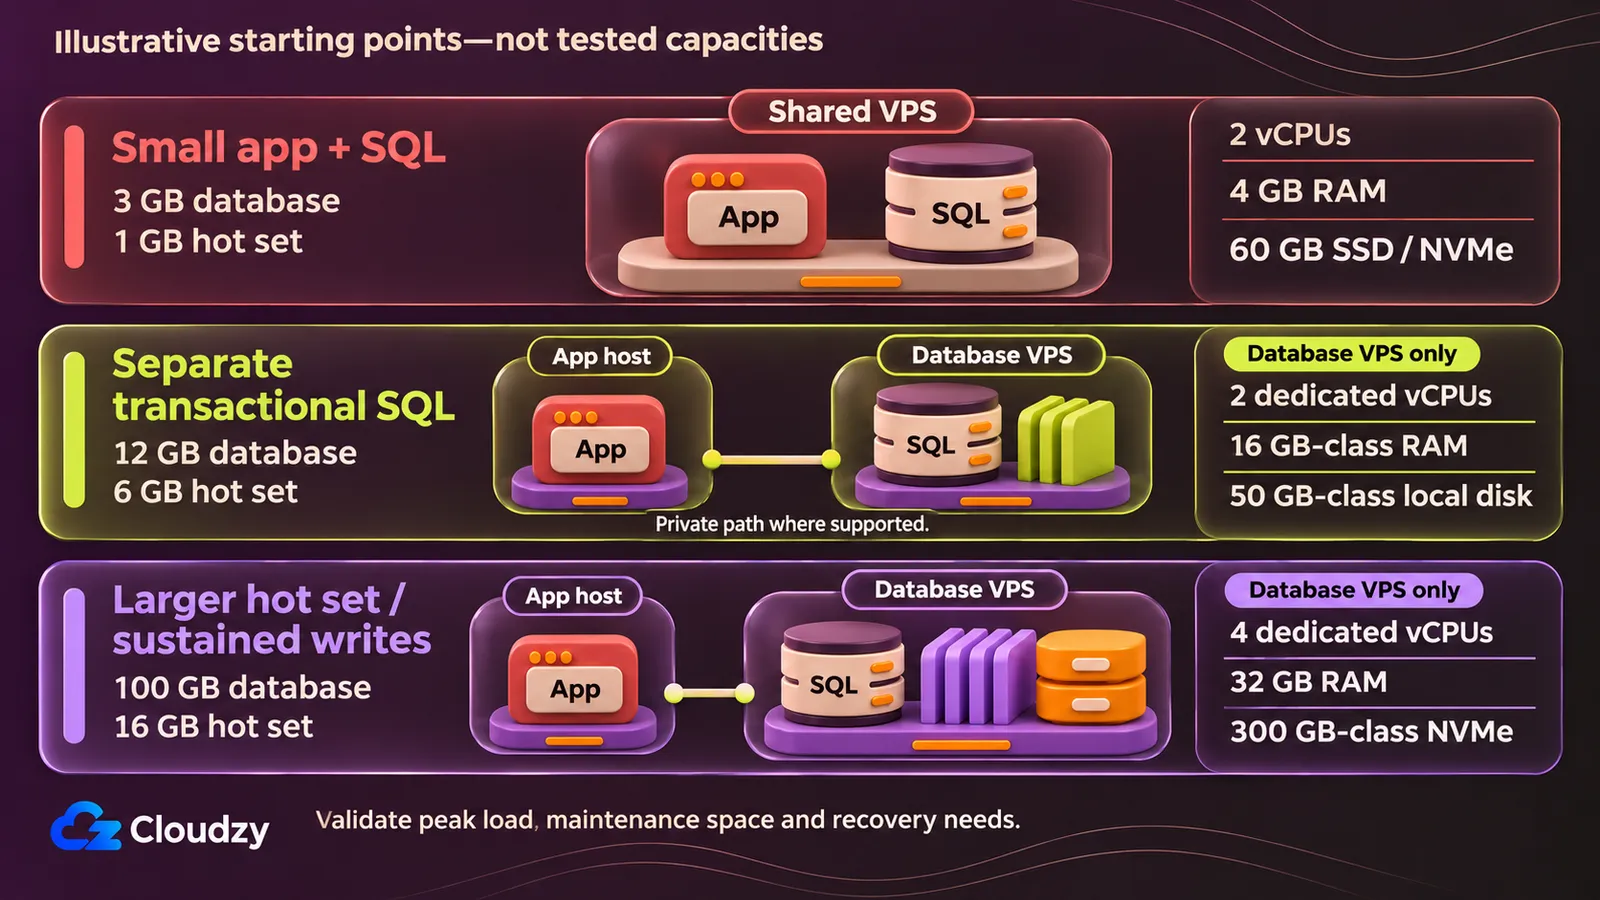
Nutzen Sie je nach Anwendungskompatibilität PostgreSQL 16, MySQL 8.4 mit InnoDB oder MariaDB 11.4 mit InnoDB als alternative Beispielumgebungen. Die Engines sind nicht austauschbar und werden nicht als neueste Versionen bezeichnet. Notieren Sie vor dem Test die installierte Patchversion; die Beispiele nennen keine bereitgestellte Imageversion eines Anbieters.
Kleine Anwendung und Datenbank gemeinsam betreiben
Testen Sie für angenommene 3 GB Daten, 1 GB häufig genutzte Daten und fünf aktive einfache indizierte Abfragen 2 vCPUs, 4 GB RAM und 60 GB nominalen SSD- oder NVMe-Speicher. Die Verbindung bleibt lokal, aber Anwendung und Datenbank müssen gemeinsam ins Spitzen-RAM-Budget passen.
Annahmen: 90/10 Lesen/Schreiben, 1 GB Wachstum monatlich, keine langen Berichte während Backups. Geteilte CPU kann für tolerantes Staging reichen. Wählen Sie dedizierte Zuweisung, wenn dauernde Konkurrenz die Antwortzeiten verschlechtert; der spätere Produktionsvergleich verwendet durchgehend dedizierte vCPUs.
Vorgeschlagenes RAM-Budget, alle Angaben in GB:
| Verbraucher | Angenommener RAM |
|---|---|
| Betriebssystem und Überwachungsagenten | 0.75 |
| Anwendung bei Spitzenlast | 1 |
| Datenbankcache | 1 |
| Dateisystemcache | 0.75 |
| Reserve für Abfragen, Verbindungen und Wartung | 0.5 |
| Gesamt | 4 |
Passen Sie den InnoDB-Pool von MySQL oder MariaDB in dieses Budget ein. Ein Prozentsatz für dedizierte Datenbankserver auf den ganzen Host angewendet würde Anwendungsspeicher aufbrauchen. Rechnen Sie bei PostgreSQL Shared Buffers und Arbeitsspeicher der Vorgänge getrennt innerhalb von Datenbankbudget und Reserve. Messen Sie die gemeinsame Spitze vor der Freigabe beider Varianten.
Beispiel für Speicherplatz: 5 GB Betriebssystem/Logs, 3 GB Daten/Indizes, 4 GB Engine-Logs, 3 GB temporär und 6 GB Wachstum, zusammen 21 GB. Der übrige nominale Platz deckt Dateisystemaufwand und temporäre Arbeiten; er rechtfertigt keine Backup-Aufbewahrung auf dem Primärserver.
Verbinden Sie per lokalem Socket oder localhost. Testen Sie dauerhafte Commits bei laufender Anwendung und Sicherung einschließlich Speichersynchronisation (fsync), die das Betriebssystem zur dauerhaften Speicherung auffordert. Akzeptiert der Verantwortliche 24 Stunden RPO als Datenverlustfenster und vier Stunden RTO als Wiederherstellungsziel, planen Sie nächtliche native Backups außerhalb des Knotens und beweisen Sie die Dauer im Test. Scheitern RAM-, Latenz- oder Wiederherstellungsbudgets, sind nach Abfrage-/Indexdiagnose Trennung, Vergrößerung oder ein anderes Wiederherstellungskonzept nötig.
Transaktionale SQL-Datenbank getrennt betreiben
Bei externer Anwendung kann eine beispielhafte 12-GB-SQL-Datenbank mit 6 GB häufig genutzten Daten auf 2 dedizierten vCPUs, etwa 16 GB RAM und 50 GB lokalem Speicher getestet werden. Annahmen sind 20 aktive indizierte Abfragen, kurze Schreibvorgänge und wenig dauerhafte Rechenlast; größere Vorgänge können das Budget sprengen.
Annahmen: 90/10 Lesen/Schreiben und 1 GB monatliches Wachstum über drei Monate. Dies ist die Referenzlast der Anbietertabelle. Vergleichen Sie wegen unterschiedlicher Einheiten tatsächlich verfügbaren RAM und nutzbare Dateisystembytes vor der Budgetanwendung.
Für einen PostgreSQL-VPS setzt die Shared-Buffer-Empfehlung von PostgreSQL 16 bei einem dedizierten Datenbankserver mit mindestens 1 GB RAM bei 25 % Systemspeicher an. PostgreSQL nutzt auch den Betriebssystemcache. Vorschlag für 16 GB: 4 GB Shared Buffers, 2 GB System/Agenten, 2 GB Abfrage-/Verbindungs-/Wartungsreserve und 8 GB Dateisystemcache/Spielraum.
Die Reserve ist kein work_mem-Wert. Die Dokumentation zum Abfrage-Arbeitsspeicher von PostgreSQL erklärt, dass einzelne Sortier- und Hashvorgänge bei mehreren gleichzeitigen Sitzungen jeweils Speicher belegen können. Hashvorgänge nutzen auch hash_mem_multiplier. Begrenzen Sie Vorgänge nach erlaubter Parallelität; hohe Einzelwerte können trotz ausreichender Shared Buffers das Hostbudget überschreiten.
Für MySQL-VPS empfiehlt Oracles MySQL-8.4-Buffer-Pool-Leitfaden üblicherweise 50–75 % Systemspeicher unter Berücksichtigung anderer Zuweisungen und des Betriebssystems. Testen Sie hier einen 8-GB-InnoDB-Pool; der Rest bleibt für andere Verbraucher und Spitzen.
MariaDB benötigt eine etwas andere Rechnung. Die Speicherzuweisungsempfehlung beginnt bei überwiegendem InnoDB mit 60–70 % des nach System/Diensten verfügbaren RAM. Bei 13 GB sind das 7,8–9,1 GB; 8 GB Startpool passen. MyISAM oder Aria brauchen eigene Cachebetrachtung. Diese Engine-Budgets sind Alternativen und dürfen nicht addiert werden.
Speicherbudget: 12 GB Daten/Indizes + 3 GB Wachstum + 5 GB System + 4 GB Logs + 8 GB temporär/Wartung = 32 GB. Ein Datenträger der 50-GB-Klasse lässt etwa 18 GB nominal vor Dateisystemaufwand frei. Verlangen Sie mindestens 15 GB gemessenen freien Platz; größere Logbestände oder Neuschreibvorgänge machen das Beispiel ungültig.
Platzieren Sie Anwendung und Datenbank nahe beieinander, möglichst mit getestetem privatem Pfad, Authentifizierung, Zugriffskontrolle und Verschlüsselung. Prüfen Sie Abfrage- und dauerhafte Commit-Latenz bei Checkpoints, Flushes und Backups. Planen Sie unabhängigen Backupspeicher; das Wiederherstellungsbeispiel folgt. Vergrößern Sie nach Abfrage-/Indexdiagnose bei Ressourcensättigung, Platzmangel oder verfehlten Wiederherstellungszielen.
Größere Arbeitssätze oder dauerhafte Schreiblast einplanen
Für angenommene 100 GB Daten mit 16 GB häufig genutztem Bestand testen Sie 4 dedizierte vCPUs, 32 GB RAM und etwa 300 GB NVMe. Halten Sie die Anwendung getrennt. Das Beispiel nimmt 30 aktive gemischte Abfragen und 60/40 Lesen/Schreiben an; messen Sie Ausführung und Speicherdruck vor der Ressourcenerhöhung.
Annahmen: 10 GB Wachstum monatlich für drei Monate. PostgreSQL-Budget: 8 GB Shared Buffers, 4 GB System-/Abfrage-/Wartungsreserve und 20 GB Dateisystemcache/Spielraum. Für MySQL oder MariaDB sind etwa 16 GB InnoDB nach Abzug anderer Verbraucher eine alternative Startzuweisung. PostgreSQL-Werte sind nicht übertragbar.
Speicher umfasst laufende Arbeiten: 100 GB Daten/Indizes + 30 GB Wachstum + 30 GB aufbewahrte oder wartende Logs + 60 GB für die größte erwartete Wartungs-/Temporäroperation + 10 GB System = 230 GB. Etwa 70 GB nominal bleiben. Größere Tabellenneuschreibvorgänge erfordern eine Neuberechnung, auch bei geringem täglichem Wachstum.
Die Dokumentation zur regelmäßigen Bereinigung von PostgreSQL unterscheidet VACUUM, das Platz toter Zeilen wiederverwendbar macht, von VACUUM FULL, das eine neue Tabellenkopie mit vorübergehend zusätzlichem Platz erstellt. Ein kaum größerer Datenträger als der Datenbestand kann notwendige Platzrückgewinnung verhindern.
Messen Sie CPU-Ausführung, Cachedruck und physische E/A getrennt von Schreiblatenz. Beziehen Sie temporäre Schreibvorgänge und Checkpoint-/Flushphasen ein. NVMe und dedizierte CPU beschreiben die Konfiguration, garantieren aber keine IOPS. Testen Sie dauerhafte Backup- und Replikationsübertragungen mit naher privater Anbindung und unabhängigem Wiederherstellungsspeicher. Schnellere Logerzeugung verändert Aufbewahrungskapazität und Netzwerkbedarf. Erhöhen Sie Kerne, RAM oder Speicher nach gemessenem Engpass, nicht weil der nächste Tarif alles erhöht.
Wiederherstellungskapazität für Produktion ergänzen
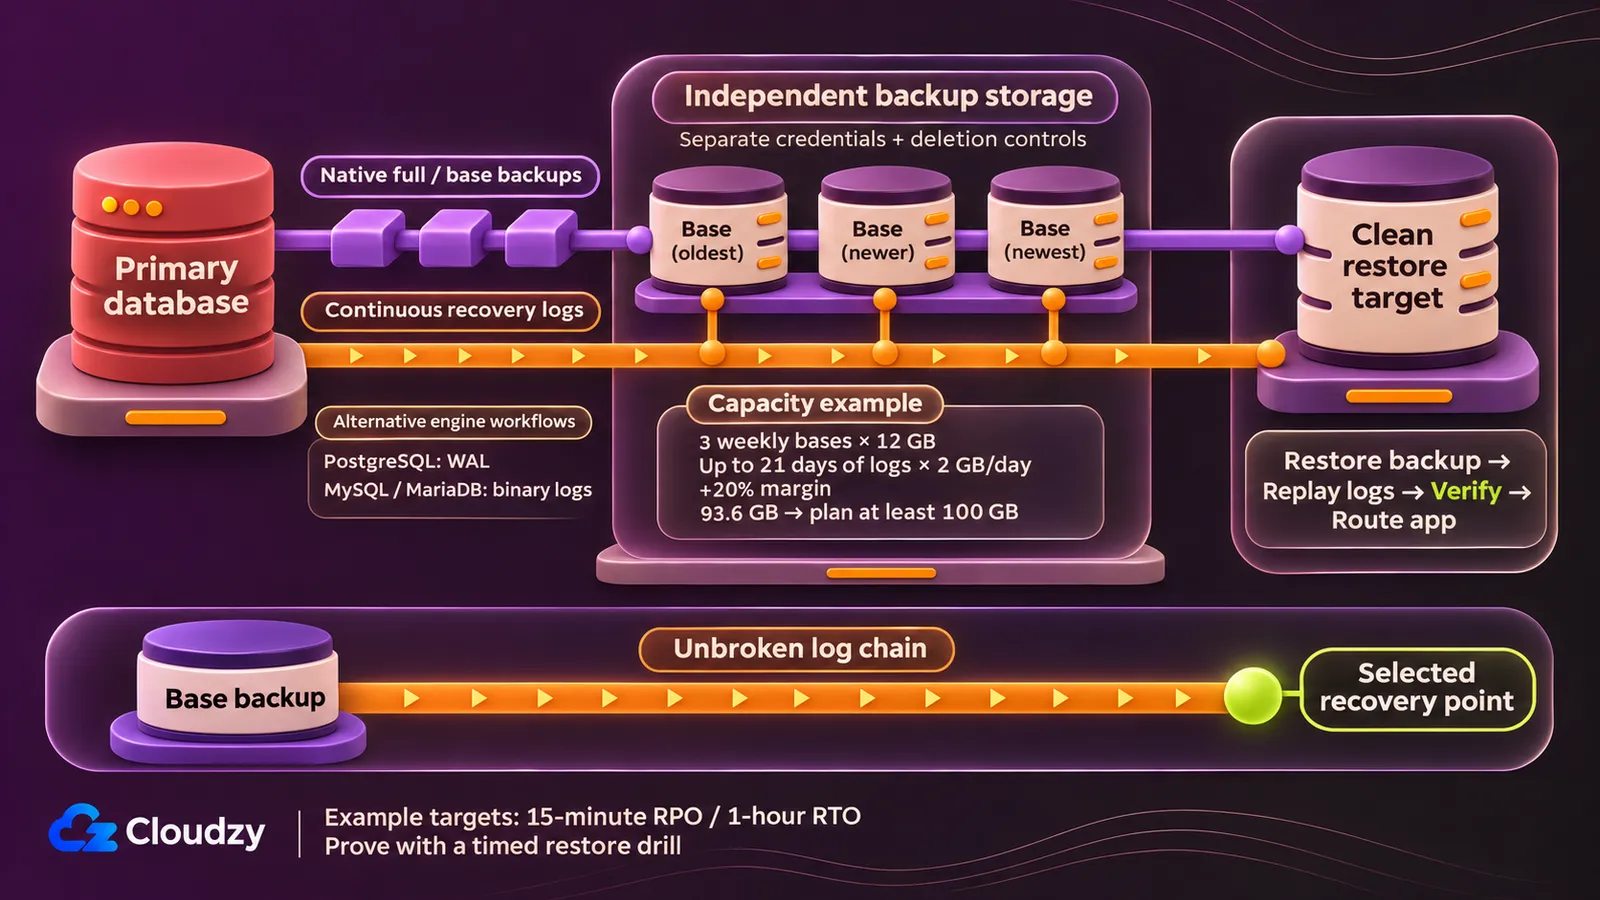
15 Minuten akzeptierter Datenverlust und eine Stunde Wiederherstellungsziel erfordern mehr als das Budget des Primärservers. Ergänzen Sie die getrennte SQL-Referenzlast um native Backups, aufbewahrte Logs, unabhängigen Speicher und einen zeitlich gemessenen Wiederherstellungstest. Die Zeiten sind Planungsziele; erst der Test belegt sie.
Die Dokumentation zur kontinuierlichen Archivierung von PostgreSQL beschreibt Basisbackup und lückenlose WAL-Aufzeichnung für zeitpunktgenaue Wiederherstellung. Oracles MySQL-Wiederherstellungsdokumentation nutzt Vollbackup und anschließende Binärlogs. MariaDBs PITR-Verfahren stellt Voll-/Inkrementaldaten vor dem Binärlog-Replay wieder her. Für diese MySQL-/MariaDB-Abläufe muss Binärlogging aktiviert sein.
Kapazitätsbeispiel: Jedes unkomprimierte Voll-/Basisbackup umfasst 12 GB. Bewahren Sie drei wöchentliche Basisbackups und durchgehende Logs seit Beginn des ältesten auf. Planen Sie bis zu 21 Tage mit 2 GB täglich und 20 % Speicherreserve:
(3 × 12 + 21 × 2) × 1.2 = 93.6 GB
Planen Sie mindestens 100 GB unabhängigen Backupspeicher ohne angenommene Kompression. Verknüpfen Sie Loglöschung mit Backupablauf und erfolgreichem Ersatz. Prüfen Sie eine vollständige Kette aus Basis und Logs für jeden zugesagten Wiederherstellungspunkt.
Nutzen Sie Backups auf einem unabhängigen Ziel mit vom Primärserver getrennten Zugangsdaten und Löschrechten. Ein Anbietersnapshot allein belegt keine native Wiederherstellungskette. Der Test muss ein sauberes Ziel bereitstellen, Backup übertragen und wiederherstellen, Logs einspielen, Datenbank-/Anwendungskonsistenz prüfen und die Anwendung umleiten. Messen Sie auch Bereitstellung und Transfer.
Ein kürzeres Ausfallziel kann ein unabhängig platziertes Replikat für die gesamte Last erfordern. Planen Sie CPU, RAM und Speicher separat sowie Beförderung, Sperrung des alten Primärservers und Clientrouting. Üben Sie den Ablauf. Replikation ersetzt keine Backups; ein VPS ist keine Hochverfügbarkeit. Überarbeiten Sie bei mehr als einer Stunde Wiederherstellung, Archivverzug über RPO, überlastetem Ersatz oder knappem Backupspeicher.
Wann ein verwalteter VPS sinnvoll ist
Kann niemand Datenbankalarme bearbeiten oder im Vorfall wiederherstellen, kaufen Sie ausdrücklich definierte Betriebsleistungen. Ein verwalteter VPS kann Wartung übertragen, doch der Vertrag muss Datenbankaufgaben benennen. Ein Control Panel belegt dies nicht; verwalteter VPS und verwaltete Datenbank sind verschieden.
Der Unterschied zwischen Verantwortlichkeiten bei verwalteten und unverwalteten VPS wird auf Aufgabenebene nützlich. Diese Liste dient dem Einkauf, nicht als Zusage identischer Leistungen. Physische Infrastruktur bleibt Anbietersache; Gastsoftware und Datenbankbetrieb brauchen ausdrückliche Zuständigkeiten.
| Aufgabe | Nicht verwalteter VPS | Vor dem Verwaltungskauf zu vereinbarende Leistungen |
|---|---|---|
| Patches und Upgrades für Gastbetriebssystem und Datenbank | Sie planen und führen sie durch | Unterstützte System-/Engineversionen, Patchumfang, Upgradetests und Wartungsfenster |
| Optimierung von Abfragen, Schema und Indizes | Sie diagnostizieren und ändern | Ob Optimierung enthalten, auf Dienstkonfiguration begrenzt oder zusätzlich berechnet ist |
| Überwachung und Vorfälle | Sie konfigurieren Alarme und reagieren | Überwachungszeiten, Reaktions-/Eskalationszuständigkeit und Handelnder nach Alarm |
| Backups und Wiederherstellung | Sie verantworten das Wiederherstellungsverfahren | Aufbewahrung, unabhängiger Speicher, Wiederherstellungshilfe und Testnachweise |
Sinnvolle Vertragsfrage: „Wenn während eines Backups der Speicher voll wird, wer diagnostiziert, stellt den Dienst wieder her und prüft das nächste Backup?“ Die Antwort trennt Supportzugang von Ergebnisverantwortung. Fragen Sie auch nach fehlgeschlagenem Engineupgrade und versehentlicher Löschung.
Verwaltete Datenbanken haben eigene Vereinbarungen zu Enginelebenszyklus, Backups und Failover. Sie können besser passen, wenn Sie Wiederherstellung und Upgrades übertragen möchten. Leiten Sie daraus keine Anwendungsoptimierung ab; Abfragedesign und Anwendungsverhalten brauchen weiter Zuständige, sofern nichts anderes vereinbart ist.
Weisen Sie jede Aufgabe einmal zu, mit Eskalationsweg und Abnahmeprüfung. Vergleichen Sie den Leistungspreis mit verfügbarer Zeit und Erreichbarkeit. Selbstverwaltung hat keinen universellen Stundenwert; günstige Rechenleistung löst keinen Vorfall ohne Zuständigen.
VPS-Konfiguration für Nicht-SQL-Lasten wählen
Die Beispiele trennen In-Memory-Last, Dokumentenspeicher und Suchindizierung. Platzieren Sie die Anwendung nahe und testen Sie Verbindungen sowie Übertragungen zu Backups und gegebenenfalls Replikaten.
| Arbeitslast und Annahmen | Zu testende Startkonfiguration | Speicher, Wiederherstellung und Änderungsgründe |
|---|---|---|
| Redis-Cache/Schlüssel-Wert; 2 GB gemessene Daten | 2 dedizierte vCPUs, 8 GB RAM; maxmemory unter Hostspeicher mit Overheadreserve setzen |
Ein neu aufbaubarer Cache kann Verlust tolerieren. Ein persistenter Primärknoten braucht bewusste RDB-/AOF-Wahl, Neuschreibplatz und unabhängige Backups. Messen Sie RAM/RSS, Fragmentierung, Verdrängungen, Persistenzspitzen und hohe Latenzperzentile. |
| MongoDB; 20 GB Dokumente/Indizes und kleiner gemessener heißer Bestand | 2–4 dedizierte vCPUs, 16 GB RAM, etwa 100 GB lokaler Speicher | Planen Sie Journal/Oplog, Wachstum und temporären Platz. Testen Sie Wiederherstellung; beobachten Sie Cacheverdrängung, E/A und Replikationsverzug. Budgetieren Sie jedes Replikat nach Rolle separat. |
| Elasticsearch; kleiner Indexbestand von 30 GB | 4 dedizierte vCPUs, 16 GB RAM, etwa 150 GB lokal je relevantem Datenknoten | Planen Sie Replikate, Segmentzusammenführung, Aufbewahrung und unabhängige Snapshots. Prüfen Sie Heap/GC, Such-/Indexlatenz, Merge-E/A und Speicherbelegung. Resilienz erfordert geeignete Abstimmungstopologie und Clientrouting. |
Redis' Administrationshinweise warnen, dass schreibintensive RDB-Sicherungen oder AOF-Neuschreibvorgänge je nach geänderten Seiten bis doppelt so viel RAM benötigen können. Die 2 GB Daten dürfen deshalb nicht das gesamte Budget beanspruchen. Die Persistenzdokumentation unterscheidet regelmäßige RDB-Snapshots vom AOF-Schreiblog. Wählen Sie nach tolerierbarem Verlust und messen Sie Spitzen bei RAM und Speicher während des Betriebs.
MongoDBs WiredTiger-Cache-Dokumentation beschreibt internen und Dateisystemcache. Standard ist das Maximum aus 50 % × (RAM − 1 GB) und 0,256 GB. Die Replica-Set-Empfehlung nennt drei datenhaltende Mitglieder. Ein Arbiter stimmt ab, hält aber keine Daten. Planen Sie unabhängige Backups und aktivieren Sie MongoDB-Authentifizierung vor der Anwendungsanbindung.
Elastics JVM-Einstellungsdokumentation empfiehlt automatische Heapdimensionierung. Manuell setzen Sie Minimum und Maximum gleich und höchstens 50 % verfügbaren RAM. Die Resilienzempfehlung für kleine Cluster beschreibt zwei datenfähige, masterberechtigte Knoten plus reinen Abstimmungsknoten. Richten Sie Replikate ein und routen Sie Clients zu Datenknoten; der dritte Knoten ergänzt eine Stimme, keine Datenkopie. Verbrauchen Merge oder Aufbewahrung die Reserve, überarbeiten Sie den Speicher vor weiteren Dokumenten.
Unverwaltete Tarife für Ihre Konfiguration vergleichen
Filtern Sie für die getrennte transaktionale SQL-Last nach mindestens 2 dedizierten vCPUs, etwa 16 GB RAM und 50 GB lokalem Speicher. Das macht einen Tarif zum Testkandidaten. Unterschiedliche CPU-/Speicherpakete, Einheiten und Abrechnungsbindungen verhindern Hardwaregleichsetzung oder Leistungsranglisten.
Referenz ist selbstverwaltetes Linux in Deutschland oder nahem Mitteleuropa mit kleinem Datenbestand und größerem RAM-Budget. Nähe bedeutet nicht identische Anwendungslatenz. Der Anwendungspfad ist möglichst privat; die Angebote behalten die reguläre öffentliche IPv4. Transfer bleibt annahmegemäß unter allen Freimengen.
| Anbieter und unverwalteter Tarif | Dedizierte vCPUs / RAM / lokaler Speicher | Standort und Transfervolumen | Preis, Abrechnung und IPv4 |
|---|---|---|---|
| Cloudzy: unser Regular Dedicated CPU | 8 / 16 GB / 350 GB NVMe | Standorte in mehreren Weltregionen; 10 TB | 49,98 $/Monat; IPv4 und IPv6 enthalten |
| Hetzner CCX23 | 4 / 16 GB / 160 GB NVMe | EU-central NBG1/HEL1; mindestens 20 TB in der EU | 86,49 €/Monat Obergrenze inklusive 0,50 € primärer IPv4, ohne MwSt. |
| DigitalOcean Memory-Optimized Droplet im Paket, Regular CPU, 1× SSD | 2 / 16 GiB / 50 GiB NVMe | Familie in FRA1 verfügbar; 4.000 GiB | 84 $/Monat Obergrenze; 0,125 $/Stunde; öffentliche IPv4 enthalten |
| Vultr Optimized Cloud Compute, Memory Optimized, AMD 2 Kerne/16 GB/100 GB | 2 / 16.384 MB / 100 GB NVMe | Frankfurt (fra); 6.144 GB |
80 $/Monat; 0,11 $/Stunde; standardmäßige IPv4; separate Gebühren oder IPv4-Verzichtsrabatt vor Budgetierung bestätigen |
| Akamai/Linode G7 Dedicated 16x8 | 8 / 16.384 MB / 327.680 MB SSD (320-GB-Tarifklasse) | Frankfurt (de-fra-2) als verfügbar gelistet; 6.000 GB |
173 $/Monat; 0,2595 $/Stunde; reguläre öffentliche IPv4 ohne Aufpreis |
DigitalOceans Auswahlhilfe nennt Memory-Optimized für SQL-/NoSQL-Datenbanken und Caches. Für diesen kleinen Speicherbedarf mit hohem RAM-Budget empfehle ich die genannte Paketfamilie. Ein speicheroptimierter VPS ist nicht auf SQL beschränkt. Zeigen Messungen stattdessen Kapazität oder dauerhafte Datenträgerlast als Engpass, prüfen Sie die Storage-Optimized-Paketfamilie getrennt.
Alle fünf erfüllen die Referenzuntergrenze mit unterschiedlichen zusätzlichen CPU-/Speicherreserven. Diese erlauben Wachstum, belegen aber ohne Tests keinen Geschwindigkeitsvorteil. Hetzners Liste garantiert keinen Bestellbestand. Akamai dokumentiert SSD für G7 Dedicated. Vultrs Optimized Memory ist von geteiltem High Frequency Compute getrennt.
Unsere dedizierte Zuweisung passt zum selbstverwalteten Aufbau zum genannten Preis. Vergleichen Sie Ressourcen, Währung, Abrechnungsbindung und IPv4-Kosten jedes Anbieters vor der Gesamtbewertung.
Gesamtkosten: Rechenleistung + Adresse + unabhängiger Backupspeicher/Anfragen/Transfer + Wiederherstellungstestkapazität + optionaler Ersatz. Unbekannte Gebühren sind nicht null. Erfragen Sie aktuelle Wiederherstellungspreise und prüfen Sie Tarif, Standort und Upgradepfad vor Vertragsbindung. Eine Jahresrechnung folgt nicht aus einem gerundeten Monatsäquivalent.
Nach Wahl der kompatiblen SQL-Engine verkürzen unsere Ein-Klick-Apps die Installation. PostgreSQL, MySQL und MariaDB sind getrennte Optionen; eine Auswahl installiert nicht alle drei. Der Betrieb bleibt selbstverwaltet, einschließlich Patches, Optimierung und Wiederherstellung.
Häufig gestellte Fragen
Zeigt die PostgreSQL-Cache-Trefferquote langsamen Speicher an?
Nein. PostgreSQLs E/A-Statistikdokumentation erklärt, dass der Systemcache eine Datenbankleseanforderung ohne Datenträgerzugriff bedienen kann. Kombinieren Sie Trefferquoten mit System-E/A und Abfragezeiten. Die Quote allein trennt physische Speicherverzögerung nicht von Zugriffen aus Kernelspeicher.
Kann ein logischer PostgreSQL-Dump für WAL-basierte Zeitpunktwiederherstellung dienen?
Nein. Die Anforderungen an kontinuierliche Archivierung von PostgreSQL sagen, dass logischen Dumps die Informationen für WAL-Replay fehlen. Ein Dump stellt den erfassten Zustand wieder her; WAL-basierte Wiederherstellung braucht geeignetes Basisbackup und durchgehend archiviertes WAL. Wählen Sie das Backupformat nach Wiederherstellungsmethode.
Soll MongoDB im Container den gesamten Host-RAM für den Cache verwenden?
Nutzen Sie den dem Container verfügbaren Speicher. MongoDBs Hinweise zu Containerspeicher warnen, dass WiredTiger ein niedrigeres Containerlimit teilweise nicht berücksichtigt. Halten Sie den Cache unter diesem Limit mit Platz für andere Prozesse; der gesamte Host-RAM kann das Datenbankbudget überschätzen.
Diskussion
Kommentare
Melden Sie sich an, um mitzudiskutieren.