

Etwas, das Sie gebaut haben, läuft in Produktion. Ihr Monitoring ist entweder gar nichts oder ein Uptime-Ping, und letzte Woche haben Sie von einem Ausfall durch einen Nutzer erfahren. Jede Antwort, nach der Sie suchen, führt zum selben Namen.
In diesem Prometheus-Test geht es um die Lücke zwischen zwei Dingen, die beide zutreffen. Es ist kostenlos und quelloffen, ohne Lizenz und ohne Rechnung pro Metrik, in jeder Größenordnung. Es kostet Sie außerdem einen Abend plus eine Abfragesprache, die Sie noch nicht können. Es ist ein Pull-basierter Metrik-Collector mit angeschlossenem Alerting, und es ist eine ausgezeichnete Software. Ob es die richtige Software für das Setup ist, das Sie gerade betreiben, ist eine andere Frage, und genau die lohnt eine Antwort.
Die Kurzfassung
- Urteil: 3,5 / 5 für Self-Hosting im Alleingang und im kleinen Team. Prometheus lohnt den Betrieb, wenn Ihre Menge an Hosts und Diensten einigermaßen stabil ist, Sie die Zeit investieren, PromQL zu lernen, und Sie Metriken wollen, die Ihnen vollständig gehören, ohne Abo und ohne Rechnung für die Aufbewahrung.
- Lassen Sie es, wenn die Frage, die Sie beantwortet haben wollen, lautet: „Läuft es noch?“ Ein Uptime-Checker bringt Sie dorthin sehr viel schneller, und Prometheus für diese Aufgabe heranzuziehen heißt, eine Abfragesprache dafür zu bezahlen, etwas zu beantworten, das in zehn Minuten erledigt gewesen wäre.
- PromQL ist der Posten, der immer wiederkommt. Die Einrichtung ist eine einmalige Ausgabe. Sobald Ihre Fragen über fertige Dashboards und den visuellen Query-Builder von Grafana hinausgehen, sind Sie wieder in PromQL.
- Die Wartungskosten hängen davon ab, wie viel vom Setup Sie von Hand pflegen. Eine Flotte, die ihre Form behält, ist günstig zu überwachen. Eine, die Hosts hinzugewinnt, verliert und umbenennt, ist genau der Ort, an dem sich die Kosten still aufsummieren.
- Dieses Urteil gilt ausschließlich für Self-Hosting im kleinen Maßstab. Auf Kubernetes- und Produktions-SRE-Ebene ist Prometheus eine ganz andere Angelegenheit, und dieser Test versucht nicht, diese Frage zu beantworten.
Wie dieser Test entstanden ist: Prometheus ist kostenlos und quelloffen, es gibt hier also keine Anbieterbeziehung und mir hat niemand etwas geschickt. Die Angaben zu Versionen und zum Speicherverhalten stammen aus der offiziellen Prometheus-Dokumentation. Die Ressourcenzahlen und Einrichtungszeiten stammen aus zwei unabhängig veröffentlichten Praxistests, jeweils an der Stelle nachgewiesen, an der sie verwendet werden. Wo die beiden voneinander abweichen, sehen Sie beide Zahlen statt eines Mittelwerts.
Was dieser Test abdeckt
Das Urteil oben hat Grenzen, und diese Grenzen zählen hier mehr als sonst, weil Prometheus sich in unterschiedlichen Größenordnungen wie ein anderes Werkzeug verhält.
- Prometheus bewertet für Self-Hosting auf einem einzelnen VPS und für kleine Projekte: eine Handvoll Hosts und Dienste, eine Person, die sich darum kümmert.
- Nicht Kubernetes. Prometheus Operator, ServiceMonitors und der kube-prometheus-stack sind eine eigene Betriebswelt, und das Urteil hier sagt über diese nichts aus.
- Keine Anleitung zum Alertmanager-Routing. Alerting existiert und funktioniert; Routen, Silences und Receiver zu konfigurieren ist ein Thema für sich.
- Keine Installationsanleitung. Die Frage hier lautet, ob Sie es überhaupt betreiben sollten. Wenn Sie die bereits beantwortet haben, beschreibt unser Leitfaden zu Grafana und Prometheus mit Docker Compose die einzelnen Schritte.
- Kein Überblick über Exporter. Exporter kommen nur dort vor, wo sie die Antwort verändern.
Was Prometheus richtig macht
Prometheus kostet nichts. Kein „kostenloser Tarif mit bezahlten Upgrades“, kein „kostenlos, bis Sie ein Metrik-Limit überschreiten“. Das Repository steht durchgehend unter Apache 2.0 und es gibt keine kostenpflichtige Ausgabe des Kernprojekts, und nirgendwo wird pro Host, pro Metrik oder pro Label abgerechnet. Die einzige Rechnung, die Prometheus je erzeugt, ist der Server, auf dem es läuft.
Bei etwas, worauf Sie sich verlassen wollen, ist „Gibt es das in drei Jahren noch?“ eine faire Frage, und hier stehen die Chancen etwa so gut, wie es bei Open Source überhaupt geht. Prometheus hat die CNCF im August 2018 als Graduated-Projekt verlassen, als zweites Projekt überhaupt, nach Kubernetes. Releases erscheinen regelmäßig, zuletzt mit v3.13.2 Ende Juli 2026, und weil diese Release-Linie eine Long-Term-Support-Linie ist, erhält sie Bugfixes sowie Sicherheits- und Dokumentationskorrekturen ein Jahr lang. Aktuell zu bleiben heißt also nicht, jeder Minor-Version hinterherzulaufen.
Das Datenmodell erklärt, warum das Ökosystem darum herum so tief ist. Prometheus holt Metriken über HTTP ab und identifiziert jede Zeitreihe über einen Metriknamen plus Key/Value-Labels, wodurch das Schreiben eines Exporters eine kleine Aufgabe ist. Deshalb gibt es Exporter für so ziemlich alles, was Sie plausibel betreiben: Node-Metriken, Postgres, Nginx, Redis, Blackbox-Probes für die Dinge, die Sie nur von außen antesten können.
Und Ihnen gehört, was es sammelt, und genau das zählt eher später als am ersten Tag. Die Historie eines kleinen Setups belegt eine unspektakuläre Menge Speicherplatz (Zahlen weiter unten), niemand kann sie Ihnen im nächsten Quartal neu bepreisen, und es gibt keinen Rechnungsposten, der wächst, sobald jemand eine Anwendung zusätzlich instrumentiert. Wenn Sie je zugesehen haben, wie eine Rechnung für gemanagtes Monitoring steigt, weil ein Entwickler ein Label ergänzt hat, steht das gesamte Argument in diesem einen Satz.
Wo Prometheus Sie mehr kostet, als es aussieht
Ein dev.to-Test von sieben Monitoring-Werkzeugen auf einem kleinen VPS hat für Prometheus allein 15 Minuten Einrichtungszeit gemessen. Kombinieren Sie es mit Grafana, so wie es der Tester getan hat, denn der eingebaute Expression Browser ist nur ein Ort, an dem man Abfragen ausführt. Derselbe Test setzt Grafana + Prometheus bei 35 Minuten bis zum ersten Diagramm an, mit YAML-Scrape-Konfiguration dazwischen.
Die Minuten sind der günstige Teil. PromQL ist der teure. Prometheus speichert alles als Zeitreihen, die über Name und Labels identifiziert werden, und PromQL bleibt die Sprache unter den Fragen, die Sie stellen. Grafana hat inzwischen einen visuellen Query-Builder, Sie müssen also nicht jede Abfrage von Hand schreiben. Das Urteil des Testers fiel deutlich aus: PromQL ist großartig, wenn man darin lebt, und er tat es nicht. Wenn Sie noch nie eine Abfragesprache benutzt haben, planen Sie mehr als einen Abend ein und rechnen Sie damit, immer wieder dorthin zurückzukehren, sobald der visuelle Builder nicht mehr reicht. Ein Dashboard, das Sie von jemandem kopiert haben, beantwortet dessen Fragen. Ihre sind eine Abfrage, die Sie noch nicht geschrieben haben.
Der dritte Kostenpunkt zeigt sich erst später. Ein dreiwöchiger Erfahrungsbericht eines Betreibers beschreibt genau, was das Hinzufügen eines einzigen Servers zu einem Setup mit sieben Nodes bedeutete: neu labeln, Scrape-Konfigurationen erneut prüfen, Dashboard-Variablen anpassen und Template-Abfragen überarbeiten, damit der neue Host in den Auswahllisten auftaucht. Dieser Betreiber gab den Stack nach drei Wochen auf, mit dem Fazit, mehr Zeit mit dem Tunen von Dashboards zu verbringen als mit dem Beobachten der Infrastruktur.
Beachten Sie, woran dieser Aufwand in einem solchen Setup hängt: an Targets und Dashboards, die von Hand gepflegt werden. Prometheus zwei ruhige Jahre lang zu betreiben kostet Sie darüber hinaus fast nichts.
Wie viel RAM und Speicherplatz braucht Prometheus wirklich?
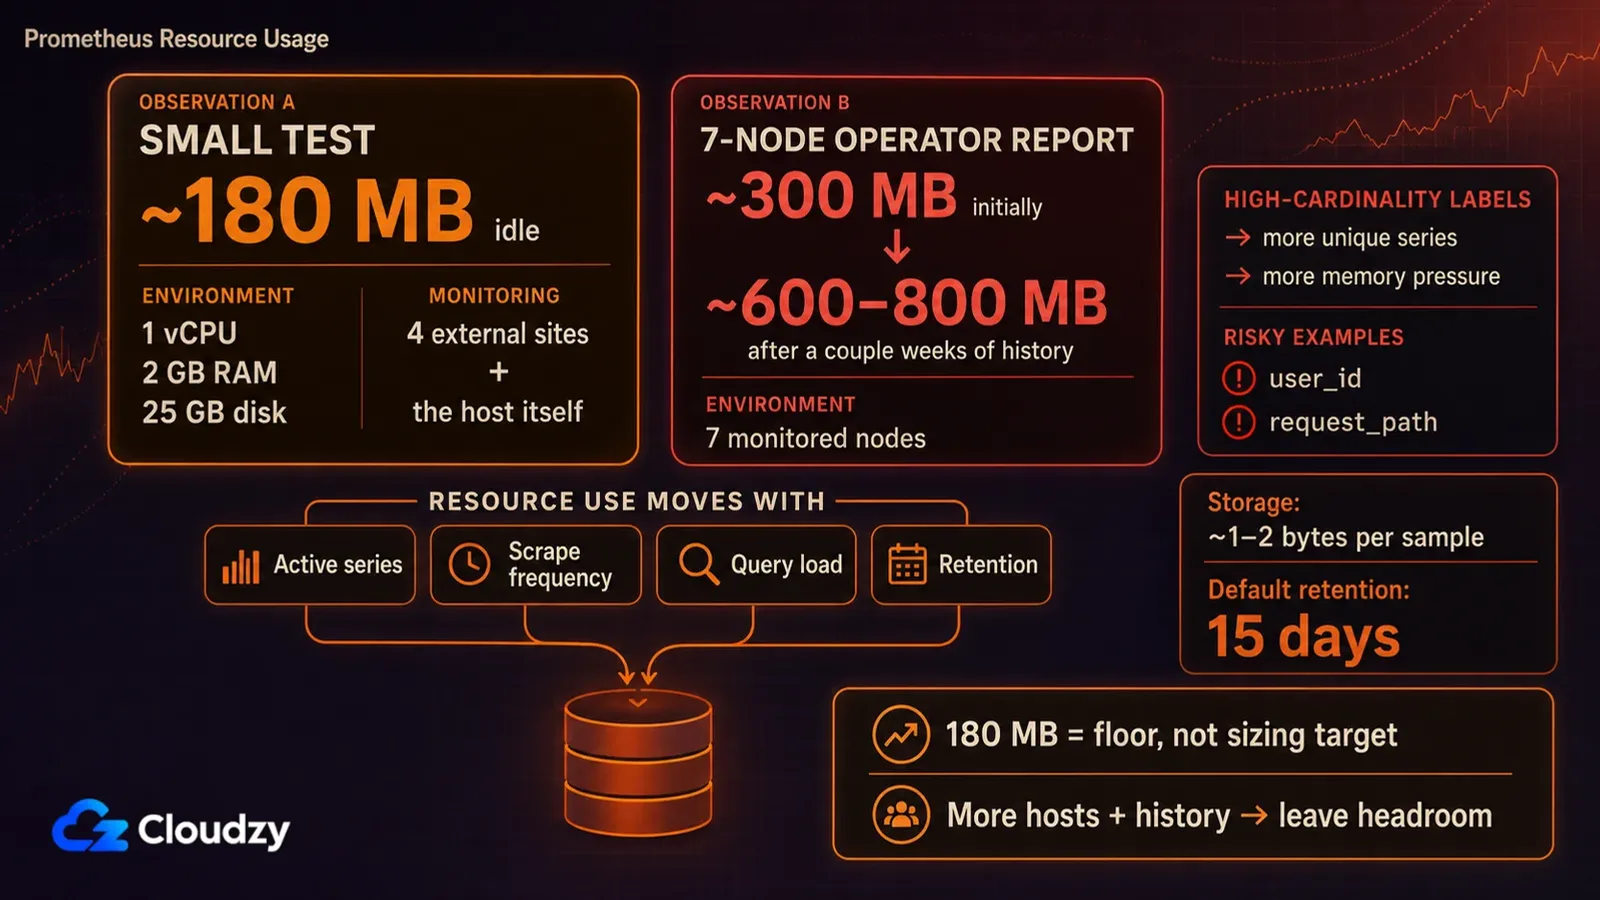
Es gibt keine feste Anforderung. Aktive Zeitreihen, Scrape-Frequenz, Abfragelast und Aufbewahrungsdauer zählen mehr als die bloße Zahl der Server, auf die Sie es richten. Zwei veröffentlichte Praxistests kleiner Setups verorten es zwischen etwa 180 MB und 800 MB, wobei der höhere Wert sieben Nodes mit ein paar Wochen Historie abdeckt.
Die beiden Tests widersprechen sich, und genau dieser Widerspruch ist der nützliche Teil. Derselbe VPS-Vergleich von sieben Werkzeugen ließ jedes davon auf identischer Hardware laufen (1 vCPU, 2 GB RAM, 25 GB Speicher, Ubuntu 24.04) und überwachte vier externe Websites plus den Host selbst; dabei wurden für Prometheus rund 180 MB im Leerlauf gemessen. Derselbe Betreiber berichtete, dass Prometheus allein auf dem zentralen Host bei etwa 300 MB im Leerlauf lag und in Richtung 600 bis 800 MB stieg, sobald sich ein paar Wochen Historie angesammelt hatten.
Das sind nicht dieselben Messungen, und deshalb würde ein Mittelwert die Information wegwerfen. Die eine ist ein Wert nahe dem Leerlauf auf einer Maschine, die sehr wenig zu speichern hat. Die andere ist ein laufender Betrieb mit einer Flotte dahinter und Historie auf der Platte. Meine Lesart: Behandeln Sie die 180 MB als Untergrenze, nicht als Dimensionierungsziel. Sobald Sie von mehreren Hosts sammeln und Historie behalten, planen Sie Reserve ein, statt sich an diesem Leerlaufwert zu orientieren.
Der Speicherplatz ist die leichte Hälfte. Die Storage-Dokumentation von Prometheus veranschlagt im Schnitt 1 bis 2 Byte pro Sample, eine lange Historie für ein kleines Setup ist also günstig. Der Haken liegt im Standardwert: die Aufbewahrung liegt standardmäßig bei 15 Tagen sofern Sie keine Aufbewahrungsdauer oder -größe setzen. Von einem ganzen Jahr trennt Sie ein einziges Startflag, und es ist die Art Standardeinstellung, von der man lieber jetzt erfährt als beim ersten Mal, wenn man die Zahlen des letzten Monats sucht und feststellt, dass sie vor drei Wochen verfallen sind.
Was den Speicherwert nach oben treibt, ist die Kardinalität: die Zahl unterschiedlicher Zeitreihen, wobei jede eindeutige Label-Kombination einer Metrik zu einer eigenen Zeitreihe wird. Ein einziges schlecht gewähltes Label auf einer stark frequentierten Metrik kann mehr Zeitreihen erzeugen als fünf zusätzliche Server, und es tut das lautlos, in genau dem Tempo, in dem Ihr Traffic gerade läuft. (Eine Nutzer-ID oder ein Request-Pfad sieht nach einem hervorragenden Label aus, bis Sie zählen, wie viele es davon gibt.)
Jede RAM-Zahl, die Sie zu Prometheus zitiert finden, ist nur dann brauchbar, wenn Sie auch wissen, wie viele Zeitreihen dahinterstanden.
Was passiert, wenn Ihr Prometheus-Server ausfällt?
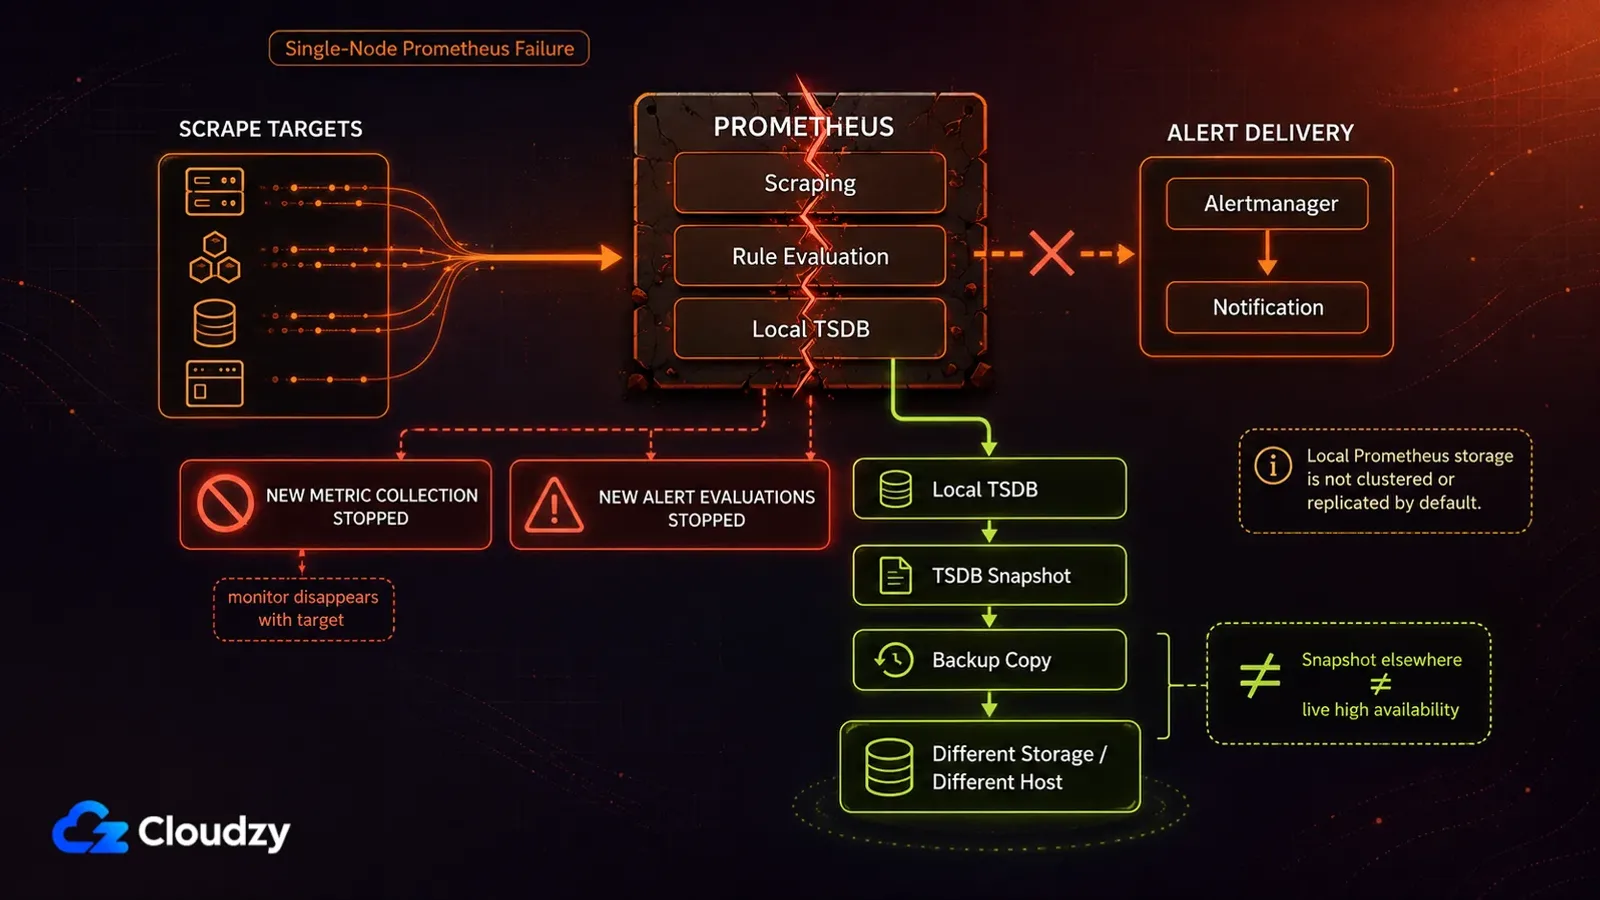
Die Storage-Dokumentation von Prometheus ist dazu unmissverständlich: Lokaler Speicher ist weder geclustert noch repliziert, und es übersteht damit weder einen Laufwerks- noch einen Node-Ausfall. Jeder Server ist bewusst eigenständig und hängt weder von Netzwerkspeicher noch von entfernten Diensten ab, und genau das macht ihn leicht zu betreiben und lässt ihn genau so ungeschützt.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Es gibt eine zweite Grenze, die das Projekt über sich selbst benennt, und dafür verdient es Anerkennung: wenn Sie 100 % Genauigkeit brauchen, etwa für die Abrechnung pro Request, sagt die Dokumentation, dass Prometheus die falsche Wahl ist, weil die gesammelten Daten vermutlich nicht detailliert und vollständig genug sind. Nehmen Sie für Zahlen, die Sie in Rechnung stellen, etwas anderes, und behalten Sie Prometheus fürs Monitoring. Anbieter sagen so etwas über sich selbst normalerweise nicht von sich aus.
Für größere Maßstäbe gibt es dafür etablierte Antworten, und sie liegen hier aus demselben Grund außerhalb des Rahmens wie das Kubernetes-Werkzeug: Sie bedeuten eine andere betriebliche Verpflichtung als die, um die es in diesem Test geht. Für einen einzelnen VPS lautet meine Lesart: Das Risiko ist vertretbar, wenn Sie TSDB-Snapshots anderswo aufbewahren oder von vornherein akzeptieren, dass Sie die Historie verlieren, und es ist ein echtes Problem, wenn Prometheus das Einzige ist, was zwischen Ihnen und einem lautlosen Ausfall steht.
Wer sollte Prometheus selbst hosten?
Das deutlichste Anzeichen dafür, dass Prometheus seinen Preis wieder einspielt, hat nichts damit zu tun, wie viele Server Sie haben. Es geht darum, ob es in sechs Monaten dieselben Server sein werden. Eine stabile Menge von Hand konfigurierter Hosts bedeutet, dass Sie die Konfiguration einmal schreiben und die Historie umsonst dazubekommen; eine, die sich ständig ändert, bedeutet, dass Sie diese Konfiguration ständig anfassen.
In einem statischen Setup ist Ihre Prometheus- und Grafana-Konfiguration eine explizite Beschreibung Ihrer Infrastruktur: Scrape-Targets, die daran hängenden Labels und die darauf aufbauenden Dashboards. Genau deshalb ist die Historie der eigentliche Gewinn. Ein Jahr Daten über eine stabile Menge Hosts sagt Ihnen, wie normal aussieht, und das ist der verlässlichste Weg, unnormal zu erkennen, bevor daraus ein Ausfall wird.
Das erste Profil ist also jemand mit einer kleinen, sich langsam verändernden Menge Server, der mehr will als nur oben oder unten: Request-Latenz über die Zeit, Speichertrends, eine Platte, die sich langsam genug füllt, dass Sie es Wochen im Voraus kommen sehen. Wenn Sie Ihre Infrastruktur heute beschreiben können und erwarten, dass diese Beschreibung in einem Jahr noch ungefähr stimmt, ist der Abend, den Sie in die Einrichtung stecken, die letzte große Rechnung.
Das zweite ist jeder, der diesen Stack bewusst lernt. Wenn Sie damit rechnen, in ein paar Jahren Infrastruktur zu betreiben, Ihre eigene oder die von jemand anderem, ist der PromQL-Abend genau das, weswegen Sie gekommen sind, und das Monitoring ist ein Nebeneffekt. Dieses Profil kehrt das erste teilweise um: Der Stabilitätstest zählt hier weniger, denn Zeit fürs Neu-Labeln ist zugleich Zeit dafür, zu lernen, was Neu-Labeln überhaupt ist. Für diesen Leser würde ich die Bewertung anheben.
Beim dritten Profil geht es um Eigentum, und es ist das, was Leute unterschätzen, bis sie einmal auf der falschen Seite standen. Prometheus rechnet weder pro Host noch pro Metrik noch pro Label ab, und keine Preisseite kann sich Ihnen im nächsten Quartal unter den Füßen verändern. Der Tausch gegenüber einem gemanagten Dienst wie Datadog: Sie geben den Feinschliff, den Supportvertrag und die Rufbereitschaft von jemand anderem auf und bekommen dafür Metriken, die Ihnen gehören, auf einer Rechnung, die sich nicht bewegt, wenn ein Entwickler zusätzlich instrumentiert. Ob das ein guter Tausch ist, hängt davon ab, was Ihre eigenen Stunden wert sind, und diese Zahl können nur Sie einsetzen (und sie ist selten null, auch wenn es sich so anfühlt).
Eines sollten Sie wissen, bevor Sie sich festlegen: Aus dem lokalen Speicher von Prometheus herauszuwachsen ist keine Sackgasse. VictoriaMetrics nimmt Remote Writes von Prometheus entgegen, und seine MetricsQL ist abwärtskompatibel zu PromQL, die meisten Abfragen und Grafana-Dashboards, die Sie heute bauen, sollten den Wechsel also überstehen. Das ist eine Migration, keine Neuentwicklung.
Lieber einmal im Jahr neu prüfen als einmal endgültig entscheiden: Das Setup, das heute günstig zu überwachen ist, wird in dem Quartal teuer, in dem Sie anfangen, es umzubauen.

Entwickeln Sie auf einem Linux-VPS mit Root-Zugriff, NVMe und AMD-EPYC-Power.
Linux-Pläne ansehenWer sollte auf Prometheus verzichten?
Wenn der Satz, mit dem Sie Ihren Bedarf beschreiben würden, lautet „Sag mir Bescheid, wenn die Seite ausfällt“, dann beschreiben Sie einen Uptime-Checker, und Prometheus ist eine Menge Maschinerie für diese Antwort. Uptime Kuma erledigt genau diese Aufgabe mit einer Weboberfläche und verlangt nicht, dass Sie eine Monitoring-Abfragesprache lernen. Der Funktionsunterschied zwischen den beiden Werkzeugen ist gewaltig und für die Aufgabe, für die Sie eines davon anheuern, vollkommen belanglos.
Der zweite Leser ist der, der brauchbare Diagramme will, ohne vorher eine Abfragesprache zu lernen. Netdata ist genau darauf gebaut: Metriken pro Host, die Sie sofort ansehen können, mit viel weniger Konfiguration und ohne etwas zwischen Ihnen und den Charts. Wenn die Frage, die Sie immer wieder stellen, lautet „Warum ist diese Kiste gerade langsam?“, ist das ein deutlich kürzerer Weg zu einer Antwort.
Der dritte ist jeder, dessen Infrastruktur häufig die Form wechselt und der Targets und Dashboard-Variablen von Hand pflegt. Hosts, die für eine Woche hochgezogen und wieder zerstört werden, umbenannte Targets, Projekte, die auf halbem Weg umbenannt werden. Das ist der Fall, in dem Sie die Konfigurationskosten immer wieder zahlen und dabei am wenigsten von dem bekommen, wofür Sie zahlen: einer durchgehenden Historie eines Systems, das wiedererkennbar bleibt.
Nichts davon ist ein Vorwurf an das Werkzeug. „Verzichten“ heißt hier: für diese Aufgabe und in dieser Größenordnung verzichten. Auf Kubernetes-Ebene, wo Service Discovery das meiste übernimmt, was Sie sonst von Hand verdrahten würden, schrumpfen mehrere der oben genannten Kosten oder verschwinden ganz, und meine Lesart dieser Größenordnung ist, dass Prometheus dort sehr schwer zu schlagen ist. Das ist ein anderer Test.

Häufig gestellte Fragen
Ist Prometheus kostenlos?
Ja, und darunter liegt kein Free-Tier-Haken. Prometheus steht unter Apache 2.0, ohne kommerzielle Ausgabe dahinter, es gibt also kein Metrik-Kontingent zu überschreiten und keine Upgrade-Aufforderung auf der anderen Seite. Sie bezahlen die Infrastruktur und Ihre eigene Zeit, keine Prometheus-Lizenz.
Braucht Prometheus Grafana?
Nein, planen Sie es aber ein. Der Expression Browser von Prometheus existiert, um eine Abfrage auszuführen und sich das Ergebnis anzusehen, und damit ist das einmalige Nachschauen abgedeckt. Alles, was Sie auf einem zweiten Monitor offen lassen wollen, ist Sache von Grafana, und beide werden fast immer zusammen betrieben.
Ist Prometheus für einen einzelnen Server überdimensioniert?
Oft ja. Wenn Sie nur wissen müssen, ob der Server und seine Dienste laufen, beantwortet ein Uptime-Checker das in einem Bruchteil der Einrichtungszeit. Prometheus verdient seinen Platz, wenn Sie historische Metriken wollen, die Sie abfragen können, und bereit sind, dafür PromQL zu lernen.
Wie lange speichert Prometheus Metriken standardmäßig?
15 Tage, und es warnt Sie vorher nicht. Prometheus verwirft Samples, die älter als das Aufbewahrungsfenster sind, sofern Sie es nicht beim Start über ein Flag für Aufbewahrungsdauer oder -größe anheben. Stellen Sie es am Tag der Installation ein, denn das Fenster später zu vergrößern holt bereits verfallene Daten nicht zurück.



Diskussion
Kommentare
Melden Sie sich an, um mitzudiskutieren.