
Użytkownik r/linuxquestions przeprowadził porównanie, o które wszyscy wciąż się spierają. Zainstalował CachyOS, przetestował kilka gier na Ryzenie 7 7800X3D z Radeonem RX 7900 XTX i nie zmierzył żadnej różnicy względem innych dystrybucji, które już były na maszynie. Odpowiedzi poszły utartym torem. Jeden komentujący ustawił sufit tak nisko, że w normalnym użyciu jest niewidoczny. Drugi wyjaśnił działanie planisty. Trzeci stwierdził, że benchmarki nie są w stanie pokazać, co robi planista. Nikt nie przedstawił pomiaru, który zamknąłby sprawę.
Pytanie wraca wciąż w tych samych słowach: czy CachyOS naprawdę jest szybszy? Krótka odpowiedź brzmi: tak, w konkretnych obciążeniach. Przekompilowane pakiety mogą pomóc kodowi, który kompilator potrafi zwektoryzować, przytoczone tu porównania w grach pokazują niewielką różnicę w średnim FPS, a system, który po przesiadce wydaje się szybszy, trudniej przypisać jednej przyczynie, bo zmiana dystrybucji zmienia znacznie więcej niż jedną zmienną.
Sprawa pozostaje nierozstrzygnięta, bo „szybszy” mieści w sobie trzy osobne twierdzenia z trzema różnymi odpowiedziami, a każde wymaga własnego narzędzia pomiarowego. Przekompilowane pakiety albo kończą zadanie w krótszym czasie zegarowym, albo nie. Planista albo zmienia zachowanie pulpitu pod obciążeniem konkurencyjnym, albo nie. A żwawsza maszyna wynika albo z CachyOS, albo z czegoś, co przyszło razem z nim.
Krótka wersja
- Przekompilowane pakiety: mierzalnie szybsze, w mniejszości tego, co uruchamiasz. Zyski koncentrują się w kodzie, który kompilator potrafi zwektoryzować, kilka pakietów wychodzi wolniej, a większość nie zmienia się wcale. Porównanie w arch-chroot ze stycznia 2023 na sunnyflunk.github.io, na Intelu NUC8i5BEK, wykazało kodowanie flac szybsze o 20,2% i dekompresję bzip2 wolniejszą o 7,1% w tym samym przebiegu.
- Historia planisty dzieli się na dwie części. Obecne domyślne jądro CachyOS używa EEVDF, a BORE jest dostępny osobno. Porównania dystrybucji z maja 2026 wykazały niewielką różnicę w średnim FPS, zmierzyły też 1% najniższych klatek i równomierność klatek, ale nie wyizolowały BORE ani nie dodały kontrolowanego konkurencyjnego obciążenia CPU. Granie „z pudełka” zostało zmierzone; korzyść z BORE pod obciążeniem nie została wyizolowana.
- Wrażenie szybszej maszyny: doświadczenie prawdziwe, przypisanie zawodne. Świeża instalacja i przypadkowa naprawa niezwiązanego błędu dają żwawszy system, który nic nie zawdzięcza poziomom zestawu instrukcji. Wyjątek, o którym warto wiedzieć, to porównanie Phoronix „z pudełka” na Intelu Core Ultra 9 285K, gdzie CachyOS wyprzedził standardowego Archa na procesorze, który w ogóle nie może korzystać z optymalizacji AVX-512.
Co CachyOS faktycznie zmienia w Twoim systemie
CachyOS to Arch Linux z trzema osobnymi modyfikacjami nałożonymi na wierzch: załatanym jądrem z alternatywnymi planistami, repozytoriami, których pakiety są przekompilowane pod nowsze poziomy zestawu instrukcji CPU, oraz dodatkowymi optymalizacjami kompilatora dla części pakietów podstawowych. Każda z nich to odrębny mechanizm z odrębnym skutkiem i prawie nigdy nie mierzy się ich osobno.
Strona jądra to największa powierzchnia. Lista funkcji jądra CachyOS obejmuje Clang ThinLTO, profilowanie AutoFDO, tryby wywłaszczania wybierane w czasie działania i kilka opcji planisty. Obecny pakiet linux-cachyos używa dostrojonego przez CachyOS EEVDF jako domyślnego planisty. BORE i BMQ są dostępne w osobnych wariantach jądra, przy czym linux-cachyos-eevdf stosuje dodatkowe strojenie EEVDF pod kątem responsywności, a linux-cachyos-server używa standardowego EEVDF. sched-ext pozostaje dostępny w wariantach, które go obsługują.
Po stronie pakietów mechanizmem, o który chodzi, są repozytoria CachyOS x86-64-v3. Strona zoptymalizowanych repozytoriów CachyOS opisuje przebudowę pakietów Archa dla trzech celów powyżej ogólnej bazy: x86-64-v3, x86-64-v4 oraz dedykowanego celu Zen 4/5, który na v4 dokłada kolejne rozszerzenia AVX-512 i kilka instrukcji spoza AVX-512. Część pakietów wrażliwych na wydajność dostaje też optymalizację sterowaną profilem i BOLT.
Te nazwy poziomów pochodzą ze specyfikacji poziomów mikroarchitektury x86-64 psABIi są to progi, a nie pokrętła. x86-64-v3 wymaga instrukcji z ery AVX i AVX2, które przyszły z Intelem Haswell w 2013 roku i rdzeniami AMD Excavator; x86-64-v4 wymaga AVX-512, co w praktyce oznacza układy Intela klasy Skylake-X i każdego AMD Zen 4 lub nowszego. Procesor albo bierze poprzeczkę, albo nie.
Trzy twierdzenia ukryte w słowie „szybszy”
Kiedy dwie osoby nie zgadzają się co do tego, czy CachyOS jest szybszy, zwykle obie mają rację, tylko w różnych sprawach. Przepustowość, stabilność klatek i odczuwana responsywność to osobne właściwości i żadna pojedyncza metryka nie rozstrzyga wszystkich trzech. Zadanie na czas mierzy przepustowość; pomiary czasu klatki i opóźnienia obejmują płynność w grach; szerszy efekt na poziomie systemu wymaga kontrolowanego porównania ze świeżą instalacją.
| Twierdzenie | Co się twierdzi | Jak to zmierzyć | Co pokazują dowody | Pewność |
|---|---|---|---|---|
| Zmierzona przepustowość | Przekompilowane pakiety kończą to samo zadanie w krótszym czasie | Zmierzyć czas jednego zadania na stałym sprzęcie i stałym jądrze, zmieniając tylko repozytorium, z którego pochodzą pakiety | Solidne zyski w pracy wektoryzowalnej, drobne regresje w kilku pakietach, brak zmian w większości | Wysoka. Canonical, CentOS ISA SIG i dwóch niezależnych testerów zgadzają się co do ogólnego obrazu |
| Opóźnienie wejścia i stabilność klatek | Pulpit pozostaje responsywny, gdy coś innego obciąża CPU | Percentyle czasu klatki i opóźnienie wejścia pod obciążeniem konkurencyjnym, a nie średnia liczba klatek | Opublikowane testy uwzględniają już 1% najniższych klatek i równomierność klatek, ale nie izolują planisty ani nie wprowadzają kontrolowanego konkurencyjnego obciążenia CPU | Niska. Mechanizm jest udokumentowany, pomiaru brak |
| Odczuwana responsywność | Maszyna wydaje się żwawsza po przesiadce | Porównać ze świeżą instalacją poprzedniej dystrybucji, a nie z tą zużytą | Zwykle tłumaczone efektem świeżej instalacji albo przypadkową naprawą; jedno porównanie „z pudełka” wykazało przewagę na poziomie dystrybucji | Średnia. Doświadczenie prawdziwe, przypisanie zawodne |
Zestaw benchmarków odpowiadający na pierwszy wiersz nie odpowie na drugi, a żaden z nich nie dotyka trzeciego. Uruchomienie jednego z trzech i ogłoszenie wyniku jako werdyktu dla wszystkich trzech to właśnie to, co podtrzymuje tę dyskusję.
Czy przekompilowane pakiety naprawdę działają szybciej?
Tak, w mniejszości tego, co uruchamia pulpit, a skalę wyznacza obciążenie, nie dystrybucja. Praca wektoryzowalna zyskuje dwucyfrowo, garstka pakietów wychodzi wolniej, a większość nie pokazuje nic. Strona zoptymalizowanych repozytoriów CachyOS szacuje zysk x86-64-v3 na 5% do 20% względem ogólnego x86-64; opublikowane pomiary mieszczą się głównie przy dolnej granicy.
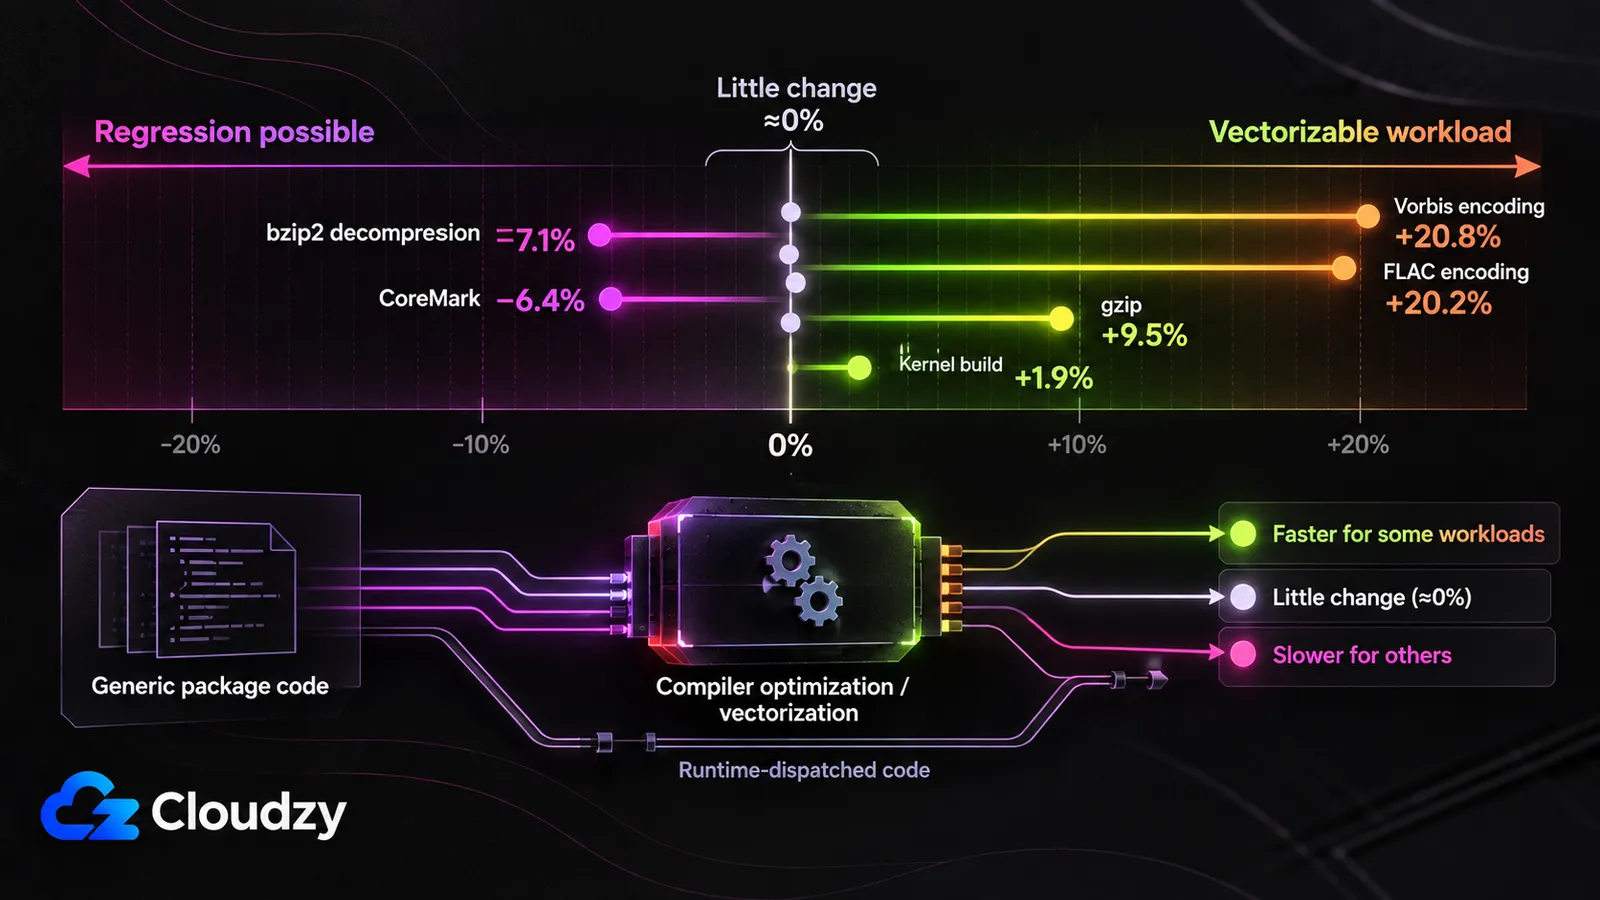
Najczystsze porównanie wydajności CachyOS vs Arch izoluje zmienną pakietów i nic więcej: test w arch-chroot ze stycznia 2023 na sunnyflunk.github.io. Host działał na standardowym Archu na Intelu NUC8i5BEK, oba zestawy pakietów testowano wewnątrz arch-chroot, aby jądro i środowisko pozostały identyczne, a benchmarki uruchamiano w RAM, by wyeliminować opóźnienia dysku. Względem standardowych pakietów Archa kompilacje CachyOS były szybsze o 20,2% przy kodowaniu flac z -8, o 20,8% przy kodowaniu vorbis i o 9,5% na gzip -3. W tym samym przebiegu były wolniejsze o 7,1% przy dekompresji bzip2, o 1,6% do 2,9% przy kompresji lz4, o 3% na pybench i bez zmian w benchmarku R. Dwa zastrzeżenia pochodzą od samego autora: CachyOS budował z -march=x86-64-v3 -mpclmul -O3 wobec -march=x86-64 -O2Archa, a jego testy uzupełniające sugerowały, że -O3 a nie poziom zestawu instrukcji odpowiadał za część największych zysków. Wpis powstał przed repozytorium Zen 4 CachyOS, które przyszło z wydaniem z lipca 2024, ale nie przed pracami nad BOLT: autor odczytuje pakiet Pythona CachyOS stojący za regresją pybench jako już niosący BOLT na x86-64-v3.
Benchmarki CachyOS na nowszym sprzęcie powtarzają ten wzorzec. Porównanie z lipca 2024 na mvermeulen.org uruchomiło podzbiór Phoronix Test Suite na Ryzenie 7940HS Zen 4, CachyOS z repozytorium Zen 4 kontra Ubuntu 22.04. Większość wyników mieściła się w kilku procentach w jedną lub drugą stronę: coremark wolniejszy o 6,4%, podtesty OpenSSL od około 1% wolniej do 4% szybciej, czas kompilacji jądra szybszy o 1,9%, phpbench jako wartość odstająca z wynikiem nieco ponad dwukrotnie wyższym. Autor wskazuje rozbieżność wersji GCC, 14.1 wobec 11.4 w Ubuntu, jako prawdopodobny czynnik zakłócający. Jego osobny test NAMD z marca 2024 wykazał poprawę o 6,5% i 5,8% w dwóch obciążeniach dynamiki molekularnej.
Testy instytucjonalne znalazły ten sam mieszany obraz na obu krańcach. Własne testy x86-64-v3 firmy Canonical, opublikowane w marcu 2024 z eksperymentalnym obrazem Ubuntu 23.10 na Azure, wykazały powtarzalne zyski do 60% w benchmarku glibc Log2, podczas gdy inne benchmarki znacząco się cofnęły, w jednym przypadku dlatego, że włączenie v3 na już zoptymalizowanym kodzie SSE sprawiło, że kompilator rozwinął go do 17 razy większej liczby instrukcji. Przebudowa CentOS Stream 9 przez CentOS ISA SIG z v2 na v3, na maszynach Intela klasy Ice Lake w sierpniu 2023, określiła wyniki jako „dość mieszane”, z przyspieszeniami 2,2x skupionymi w Mocassin i md5crypt z John the Ripper, oba silnie wektoryzowalne, choć zysk Mocassin zespół przypisał głównie autowektoryzacji GCC 12, a nie poziomowi ISA.
Wiele krytycznych dla wydajności bibliotek matematycznych i kryptograficznych dostarcza kilka wersji gorących funkcji i wybiera jedną w czasie działania na podstawie wykrywania możliwości CPU. Technika ta nazywa się wielowersyjnością funkcji i w glibc jest zaimplementowana przez resolwery IFUNC. Oznacza to, że niektóre gorące ścieżki mogą już korzystać z AVX2 na standardowej instalacji Archa bez przebudowy całego pakietu. Wpis sunnyflunk zobaczył to bezpośrednio, zauważając, że źródła flac zawierają już funkcje AVX2 wybierane w czasie działania, które nie potrzebują -march , by się włączyć. Odkrycie CentOS jest lustrzanym odbiciem: zespół znalazł funkcje matematyczne glibc bez wersji IFUNC, a to dokładnie tam statyczna przebudowa ma pole, by pomóc. To, do czego sięga przebudowa v3, to pozostały kod, który autowektoryzator kompilatora potrafi poprawić samodzielnie, czyli wycinek pulpitu, i to niewielki.
O tym, czy zmiana na poziomie maszyny w ogóle będzie widoczna, decyduje kształt obciążenia, a nie etykieta na procesorze. Werdykt w sprawie przepustowości brzmi: tak, ale z ograniczeniami. Zmiany jednocyfrowe są w powyższych pomiarach powszechne, większe zyski skupiają się wokół obciążeń wektoryzowalnych, takich jak kodowanie i kompresja, a niektóre pakiety się cofają. To lepszy opis niż traktowanie x86-64-v3 jako ogólnosystemowego mnożnika prędkości.
Co zmienia planista i dlaczego średni FPS tego nie widzi
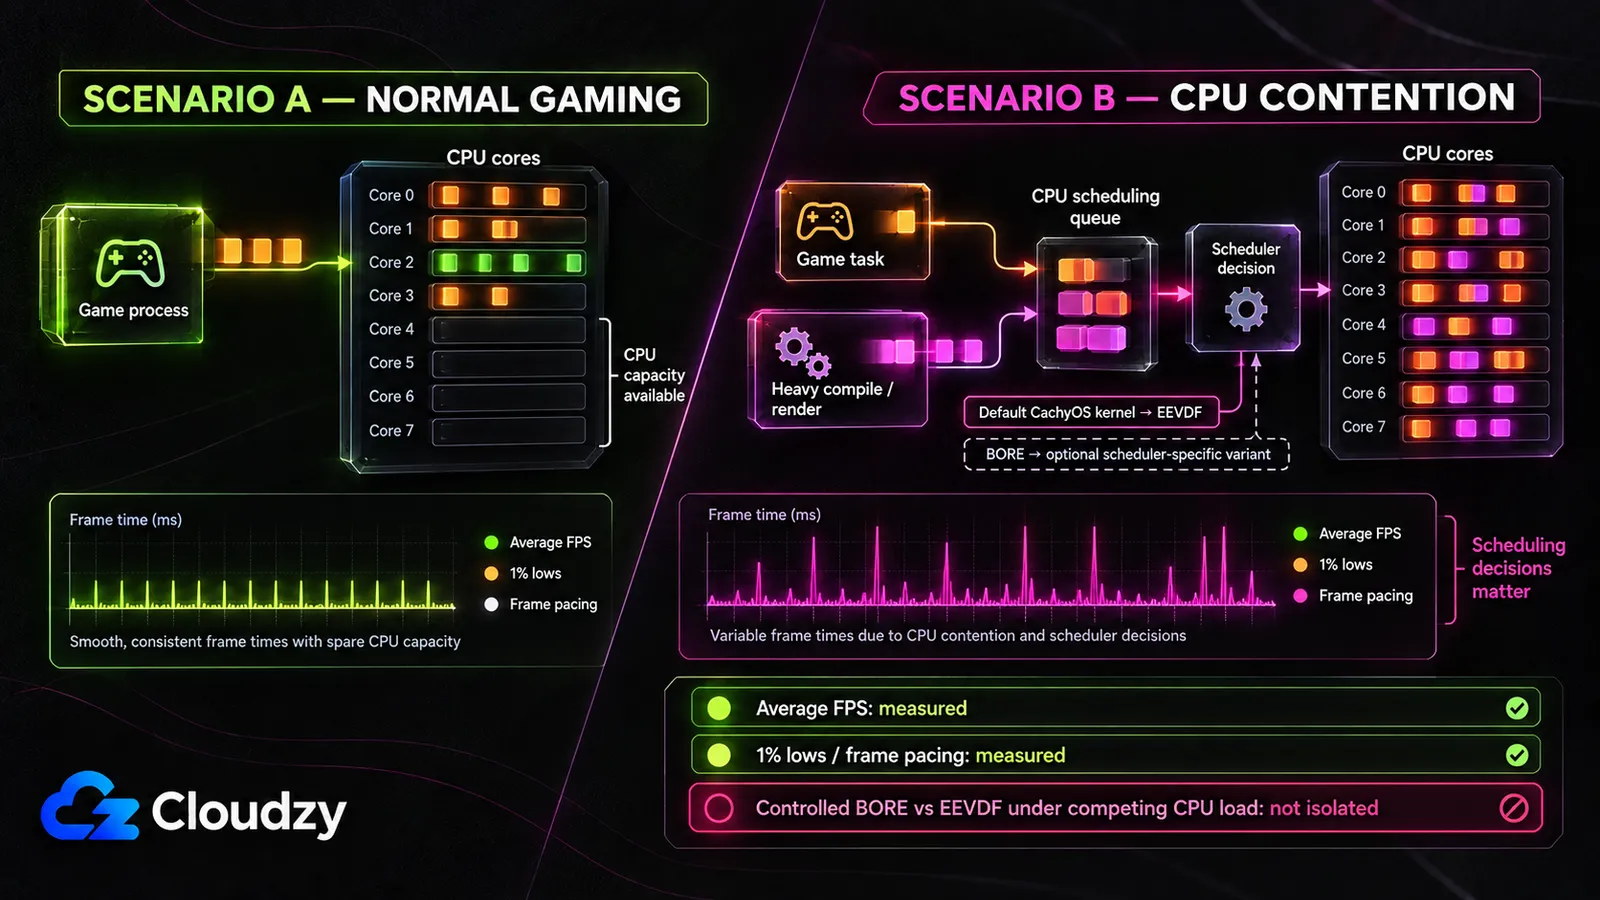
Obecne domyślne jądro CachyOS, linux-cachyos , używa EEVDF, a BORE jest dostępny przez warianty pod konkretnego planistę, takie jak linux-cachyos-bore. To rozróżnienie ma znaczenie, bo porównania w grach poniżej to testy na poziomie dystrybucji, a nie kontrolowane testy BORE kontra EEVDF. BORE wciąż ma znaczenie dla szerszego twierdzenia o wydajności, bo jego konstrukcja wprost celuje w responsywność przy mieszanych obciążeniach, ale to twierdzenie trzeba oceniać osobno od wydajności CachyOS w grach „z pudełka”.
README samego BORE wprost formułuje zamiar:
Aby to osiągnąć, BORE wprowadza dla każdego pojedynczego zadania wymiar elastyczności zwany „burstiness”, częściowo odchodząc od właściwej CFS zasady „pełnej sprawiedliwości”.
firelzrd/bore-scheduler, README projektu
Burstiness to czas CPU, który zadanie zgromadziło od chwili, gdy ostatnio oddało CPU przez uśpienie, oczekiwanie na I/O lub ustąpienie. BORE zamienia to w wynik i używa go do korygowania wagi każdego zadania oraz agresywności jego wywłaszczania po wybudzeniu, tak że zadania, które wciąż ustępują, są traktowane jako interaktywne i faworyzowane względem zadań zagarniających cały swój przydział. README samo nazywa kompromis: BORE ustala się w „równowadze między przeciwstawnymi zadaniami zachłannymi i słabymi (zwykle wsadowymi, ograniczonymi przez CPU) a zadaniami skromnymi i silnymi (zwykle interaktywnymi, ograniczonymi przez I/O)”. Podniesienie wagi pracy interaktywnej to ta sama operacja, co obniżenie wagi wsadowej pracy na przepustowość.
To mówi, jakie narzędzie wykryłoby konkretne twierdzenie BORE: wprowadzić konkurencyjne obciążenie CPU i mierzyć percentyle czasu klatki lub opóźnienie wejścia, zmieniając tylko planistę. Planista ma znacznie mniej do rozstrzygania, gdy gra działa przy wolnej mocy CPU.
Benchmark pięciu gier opublikowany 16 maja 2026 użył czystych instalacji CachyOS i Omarchy na tym samym SSD i sprzęcie, RTX 5060 Ti i Ryzen 9, z tą samą kompilacją Proton-GE i ustawieniami 1440p. Średni FPS różnił się tylko o jedną lub dwie klatki. Dwa dni później ten sam tester opublikował drugie porównanie z pełnym logowaniem klatek przez MangoHUD, dodając 5% i 1% najniższych klatek oraz wariancję równomierności klatek. Ten drugi test wykorzystał inny sprzęt, Intel i7-13700 i Radeon RX 9060 XT, więc jest dodatkowym dowodem na temat stabilności klatek, a nie rozszerzeniem pierwszego testu na tym samym sprzęcie. Żadne z porównań nie izoluje planisty CPU ani nie dodaje celowego konkurencyjnego obciążenia CPU.
Sam projekt też tego nie przecenia. W wątku r/cachyos o wydajności w grach, Peter Jung, jeden z założycieli i deweloperów CachyOS, odpowiedział użytkownikowi wprost: „In gaming not all too much. The newer feature can make a difference tough :)” (w grach niezbyt wiele, choć nowsza funkcja może zrobić różnicę).
Pozostają dwa osobne wnioski. Dla grania na CachyOS „z pudełka” opublikowane testy pokazują niewielką różnicę w średnim FPS i zawierają już pomiary 1% najniższych klatek oraz równomierności klatek. Dla BORE konkretnie pod celową konkurencją o CPU nie udało mi się znaleźć opublikowanego kontrolowanego testu, który zmienia tylko planistę i mierzy responsywność pod takim obciążeniem.
Dlaczego przesiadka wydaje się szybsza, nawet gdy nic nie mierzy się szybciej
Dwa mechanizmy dają żwawszą maszynę po zmianie dystrybucji bez udziału żadnej z optymalizacji CachyOS: sama świeża instalacja oraz przypadkowa naprawa niezwiązanego problemu, który miał poprzedni system. Oba są na tyle konkretne, że da się je rozpoznać we własnym przypadku, i to właśnie odróżnia je od hurtowego zarzutu placebo.
Zacznijmy od świeżej instalacji. W wątku r/linuxquestions na ten tematużytkownik CachyOS, który sam, jak twierdził, nie zauważył różnicy, zasugerował, że osoby zgłaszające duże zyski mogą porównywać z mocno zużytą instalacją, a nie ze świeżą. Lata nagromadzonych wpisów autostartu, osieroconych usług, rozjechanej konfiguracji i pełny dysk to obciążenie, a czysta partycja usuwa to wszystko naraz. Zmiana dystrybucji przesuwa jednocześnie jądro, środowisko graficzne, każdą wersję pakietu i każde ustawienie domyślne, a pełne porównanie Manjaro z Ubuntu rozciąga się na tuzin osobnych osi. Przypisywanie poprawy jednej z nich po fakcie to zgadywanie.
Przypadkowa naprawa to przypadek ostrzejszy. W tym samym wątku komentujący opisał codzienne używanie Fedory z problemem zarządzania VRAM, który poważnie obniżał wydajność, przesiadkę na CachyOS i zniknięcie problemu. Potem przeszedł na czystego Archa i zgłosił w zasadzie tę samą wydajność co na CachyOS, konkludując, że już nie wie, co było inne. Poprawa była prawdziwa; cele kompilacji CachyOS nie miały z tym nic wspólnego.
Żadne z tego nie uprawnia do czystego obalenia, a najmocniejszym dowodem przeciw takiemu obaleniu jest test kontrolowany. Porównanie dystrybucji na Arrow Lake od Phoronix postawiło Ubuntu 24.10, Fedorę Workstation 41, Arch Linux, Clear Linux i CachyOS na tym samym Intelu Core Ultra 9 285K w stanie domyślnym, a CachyOS minimalnie wyprzedził wszystkie, w tym Clear Linux, który na krzemie Intela zwykle prowadzi. Arrow Lake nie obsługuje AVX-512, więc ta przewaga nie może pochodzić z x86-64-v4; odzwierciedla jakąś kombinację decyzji CachyOS dotyczących jądra i kompilacji, optymalizacji pakietów i konfiguracji domyślnej.
Doświadczenie może być prawdziwe, a przypisanie wciąż niepewne. Porównanie Phoronix na Arrow Lake to użyteczny kontrprzykład: instalacja CachyOS w stanie domyślnym może wyprzedzić standardowego Archa nawet wtedy, gdy x86-64-v4 jest niedostępny.
Jak sprawdzić, czy cokolwiek z tego dotyczy Twojej maszyny
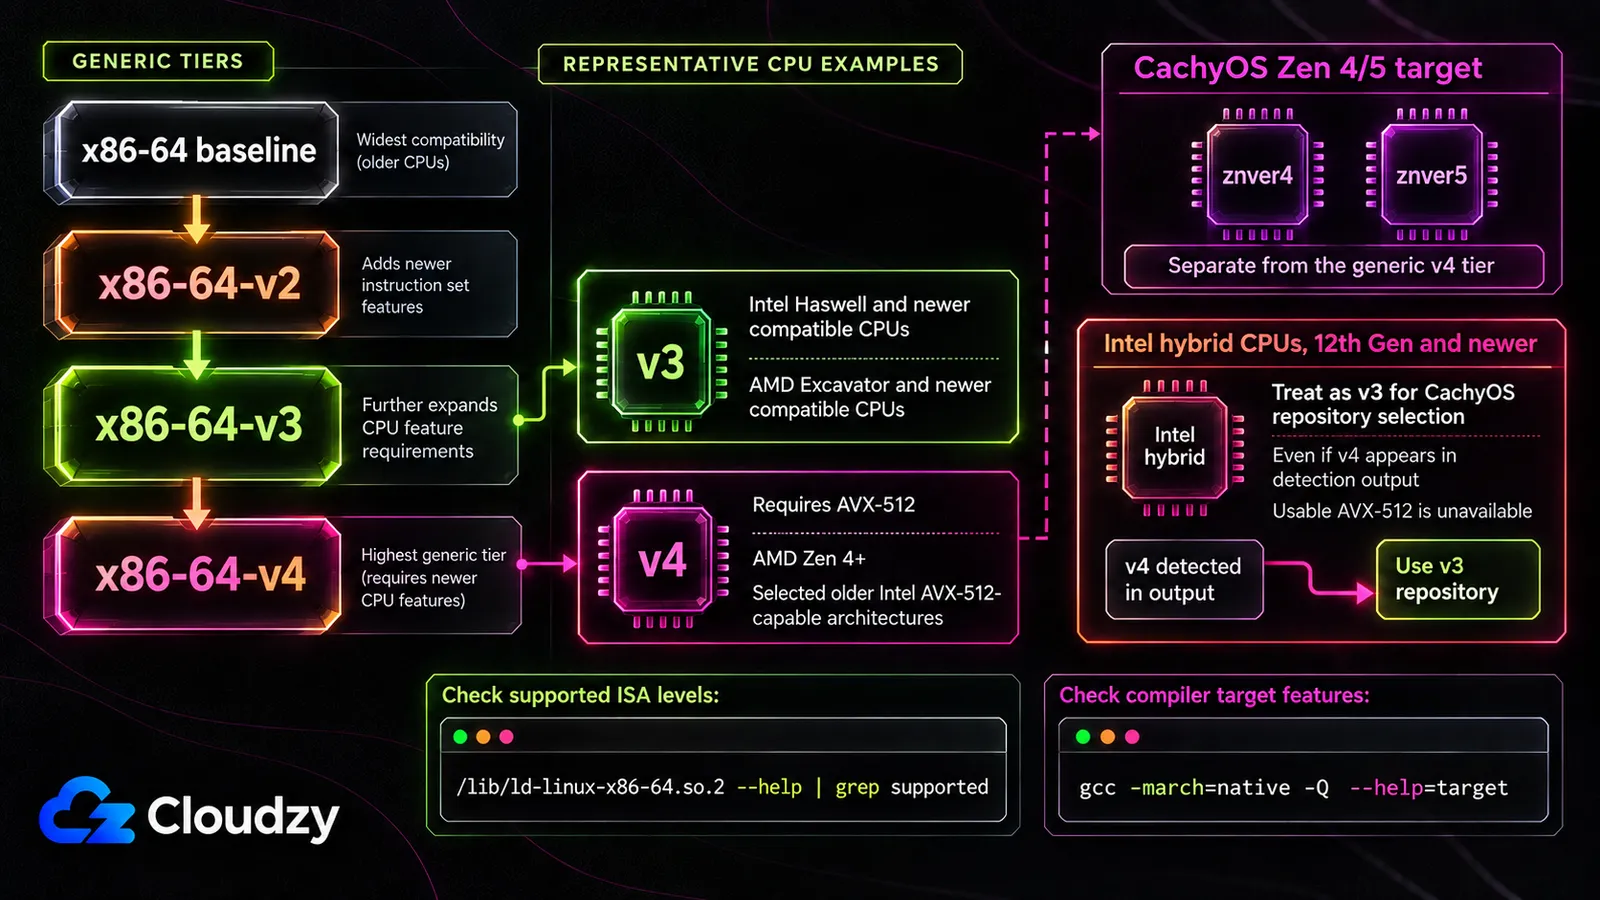
Który standaryzowany poziom mikroarchitektury x86-64 obsługuje Twój procesor, da się w większości ustalić jednym poleceniem. Dynamiczny linker zgłasza poziomy glibc-hwcaps, z których może korzystać, więc najwyższy obsługiwany wpis x86-64-vN zwykle mówi, czy CPU kwalifikuje się do ogólnego poziomu repozytorium v2, v3 lub v4. Jeden ważny wyjątek to hybrydowe procesory Intela 12. generacji i nowsze: CachyOS każe traktować je jako v3, nawet jeśli w wyniku pojawia się v4, bo AVX-512 nie jest tam użyteczne. Osobny cel CachyOS Zen 4/5 również wymaga własnego sprawdzenia architektury.
/lib/ld-linux-x86-64.so.2 --help | grep supportedDla AMD Zen 4/5 CachyOS dokumentuje też:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Pierwsze polecenie wypisuje coś takiego:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
To procesor z v3 i v2, ale bez AVX-512. Trzy wyniki, trzy decyzje:
- Nic powyżej x86-64-v2. Przewaga przebudów pod v3/v4/Zen nie dotyczy tego procesora. CachyOS nadal może działać, a optymalizacje kompilatora dla konkretnych pakietów oraz zmiany jądra i konfiguracji domyślnej wciąż mogą mieć znaczenie.
- x86-64-v3 obsługiwany, x86-64-v4 niedostępny. Do celów praktycznego wyboru repozytorium obejmuje to nowoczesne hybrydowe procesory Intela, takie jak Arrow Lake. W przytoczonych wyżej porównaniach wiele zmian było małych, niektóre obciążenia kodowania i kompresji zyskały znacznie więcej, a niektóre pakiety się cofnęły.
- x86-64-v4 obsługiwany. AVX-512 daje więcej teoretycznego zapasu dla obciążeń wektoryzowalnych, ale nie gwarantuje dużego zysku w całym systemie.
Jeśli Twój procesor się kwalifikuje, a chcesz tylko połowy dotyczącej pakietów, nie musisz reinstalować systemu, by ją dostać. Repozytoria CachyOS można dodać do istniejącego systemu Arch, a ALHP publikuje przebudowy oficjalnych repozytoriów Archa na każdym poziomie x86-64-vN, udokumentowane na Arch Wiki z własnymi zastrzeżeniami: zamiast bezpośrednio linkowanych modułów jądra wymagane są pakiety DKMS, a ustawienie -march przy kompilacji jądra „nie dałoby żadnych znaczących rezultatów”. Obie drogi dają przekompilowane pakiety i nic z zestawu łatek jądra ani wariantów planisty.
Najpierw uruchom polecenie. Zamienia ono spór o dystrybucje w fakt dotyczący Twojej własnej maszyny, a to jedyna wersja tego pytania, którą możesz dziś wieczorem rozstrzygnąć samodzielnie.

Twórz na VPS Linux z dostępem root, NVMe i mocą AMD EPYC.
Zobacz plany LinuxCzęsto zadawane pytania
Czy CachyOS naprawdę poprawia wydajność w grach?
W średniej liczbie klatek ledwo. Porównanie pięciu gier z maja 2026 wykazało tylko różnicę jednej lub dwóch klatek, a test uzupełniający dwa dni później zmierzył też 1% najniższych klatek i równomierność klatek. Żaden z testów nie wprowadził celowego konkurencyjnego obciążenia CPU, więc nierozstrzygnięte pytanie dotyczy responsywności planisty pod obciążeniem, a nie tego, czy równomierność klatek w ogóle zmierzono.
Czy mój procesor obsługuje x86-64-v3 lub v4?
Na CachyOS lub Archu uruchom /lib/ld-linux-x86-64.so.2 --help | grep supported , aby zobaczyć standaryzowane poziomy glibc-hwcaps wykryte dla Twojego procesora. x86-64-v3 wymaga zestawu funkcji z ery AVX/AVX2, a v4 dokłada AVX-512. Dla hybrydowych procesorów Intela 12. generacji i nowszych CachyOS zaleca traktować system jako v3, nawet jeśli w wyniku pojawia się v4; użytkownicy Zen 4/5 powinni też sprawdzić osobny cel znver4/znver5.
Dlaczego przekompilowane pakiety nie robią większej różnicy?
Bo część mocno zoptymalizowanego kodu jest już w czasie działania kierowana do implementacji specyficznych dla CPU. Biblioteki matematyczne i kryptograficzne często używają wielowersyjności funkcji lub IFUNC dla gorących funkcji, więc przebudowa pakietów pomaga głównie kodowi, który kompilator może jeszcze globalnie zoptymalizować lub zwektoryzować.
Czy mogę dostać zoptymalizowane pakiety CachyOS bez zmiany dystrybucji?
Tak. Repozytoria CachyOS można dodać do istniejącej instalacji Arch Linux, a projekt ALHP publikuje przebudowy oficjalnych repozytoriów Archa dla x86-64-v2, v3 i v4, udokumentowane na Arch Wiki. Obie drogi dają tylko przekompilowane pakiety, a nie zestaw łatek jądra CachyOS, alternatywne planisty ani domyślne ustawienia instalatora.
Dyskusja
Komentarze
Zaloguj się, aby dołączyć do dyskusji.