

Coś, co zbudowałeś, działa na produkcji. Monitoring albo nie istnieje, albo sprowadza się do pinga sprawdzającego dostępność, a w zeszłym tygodniu o awarii dowiedziałeś się od użytkownika. Każda odpowiedź, której szukasz, prowadzi do tej samej nazwy.
Ta recenzja Prometheusa dotyczy przepaści między dwiema rzeczami, które są prawdziwe jednocześnie. Jest darmowy i otwarty, bez licencji i bez rachunku za metrykę, w dowolnej skali. Kosztuje też jeden wieczór plus język zapytań, którego jeszcze nie znasz. To kolektor metryk działający w modelu pull z dołączonym alertowaniem i naprawdę świetny kawałek oprogramowania. Czy jest to właściwe oprogramowanie dla środowiska, które prowadzisz akurat teraz, to już inne pytanie i to właśnie na nie warto odpowiedzieć.
Krótka wersja
- Werdykt: 3,5 / 5 dla hostingu własnego w pojedynkę i w małym zespole. Prometheusa warto uruchomić, jeśli twój zestaw hostów i usług jest w miarę stabilny, znajdziesz czas na naukę PromQL i chcesz metryk, które należą wyłącznie do ciebie, bez abonamentu i bez rachunku za przechowywanie.
- Odpuść, jeśli pytanie, na które potrzebujesz odpowiedzi, brzmi „czy to działa”. Narzędzie do sprawdzania dostępności doprowadzi cię do tej odpowiedzi znacznie szybciej, a sięganie po Prometheusa do takiego zadania oznacza płacenie językiem zapytań za coś, co dałoby się rozstrzygnąć w dziesięć minut.
- PromQL to koszt, który wraca w kółko. Wdrożenie to koszt jednorazowy. Gdy tylko twoje pytania wyrosną z gotowych dashboardów i wizualnego kreatora zapytań w Grafanie, wracasz do PromQL.
- Koszt utrzymania zależy od tego, jak dużą część środowiska prowadzisz ręcznie. Flota, która zachowuje swój kształt, jest tania w monitorowaniu. Ta, która zyskuje, traci i zmienia nazwy hostów, to dokładnie miejsce, w którym koszt po cichu narasta.
- Ten werdykt dotyczy wyłącznie hostingu własnego w małej skali. W skali Kubernetes i produkcyjnego SRE Prometheus to zupełnie inna propozycja, a ta recenzja nie próbuje odpowiedzieć na tamto pytanie.
Jak powstała ta recenzja: Prometheus jest darmowy i otwarty, więc nie ma tu żadnej relacji z dostawcą i nikt niczego mi nie przysłał. Fakty o wersjach i zachowaniu magazynu pochodzą z własnej dokumentacji Prometheusa. Liczby dotyczące zasobów i czasy wdrożenia pochodzą z dwóch niezależnie opublikowanych testów praktycznych, a każdy z nich jest wskazany w miejscu, w którym go używam. Tam, gdzie te dwa testy się rozchodzą, zobaczysz obie liczby zamiast średniej.
Co obejmuje ta recenzja
Powyższy werdykt ma granice i te granice liczą się tutaj bardziej niż zwykle, ponieważ w różnych skalach Prometheus zachowuje się jak zupełnie inne narzędzie.
- Prometheus oceniany pod kątem hostingu własnego na jednym VPS i małych projektów: garstka hostów i usług oraz jedna osoba, która się nimi zajmuje.
- Nie Kubernetes. Prometheus Operator, ServiceMonitors i kube-prometheus-stack to osobny świat operacyjny, a tutejszy werdykt nie mówi o nim nic.
- Nie przewodnik po routingu w Alertmanagerze. Alertowanie istnieje i działa; konfigurowanie tras, wyciszeń i odbiorców to temat sam w sobie.
- Nie instrukcja instalacji. Pytanie brzmi tutaj, czy w ogóle go uruchamiać. Jeśli na tamto pytanie już odpowiedziałeś, kroki opisuje nasz przewodnik po Grafanie i Prometheusie z Docker Compose w całości.
- Nie przegląd exporterów. Exportery pojawiają się tylko tam, gdzie zmieniają odpowiedź.
Co Prometheus robi dobrze
Prometheus nie kosztuje nic. Nie „darmowy plan z płatnymi ulepszeniami”, nie „darmowy, dopóki nie przekroczysz limitu metryk”. Repozytorium jest objęte licencją Apache 2.0 od początku do końca, płatnej edycji głównego projektu nie ma, a nigdzie nie ma naliczania za hosta, za metrykę ani za etykietę. Jedyny rachunek, jaki Prometheus kiedykolwiek generuje, to serwer, na którym działa.
Przy czymś, na czym zamierzasz polegać, pytanie „czy to nadal tu będzie za trzy lata” jest jak najbardziej na miejscu, a szanse są tu mniej więcej tak dobre, jak to w otwartym oprogramowaniu bywa. Prometheus ukończył ścieżkę CNCF w sierpniu 2018 roku, jako drugi projekt w historii, zaraz po Kubernetes. Wydania wychodzą regularnie, a wersja v3.13.2 ukazała się pod koniec lipca 2026 roku; ponieważ ta linia wydań jest linią o długoterminowym wsparciu, otrzymuje poprawki błędów, bezpieczeństwa i dokumentacji przez rok, więc pozostawanie na bieżąco z łatkami nie oznacza gonienia za każdą wersją pomniejszą.
Model danych jest powodem, dla którego ekosystem wokół niego jest tak głęboki. Prometheus zbiera metryki po HTTP i identyfikuje każdą serię nazwą metryki plus etykietami klucz/wartość, przez co napisanie exportera jest drobną robotą. Dlatego exportery istnieją niemal do wszystkiego, co realnie mógłbyś uruchomić: metryki węzła, Postgres, Nginx, Redis, sondy blackbox do rzeczy, które da się sprawdzić tylko z zewnątrz.
I to, co zbiera, należy do ciebie, a akurat ta część zwykle zaczyna mieć znaczenie później, nie pierwszego dnia. Historia małego środowiska zajmuje niewartą wzmianki ilość miejsca na dysku (liczby poniżej), nikt nie przeceni ci jej w przyszłym kwartale i nie ma pozycji na rachunku, która rośnie za każdym razem, gdy ktoś dołoży instrumentację do aplikacji. Jeśli kiedykolwiek widziałeś, jak rachunek za zarządzany monitoring pnie się w górę, bo programista dodał jedną etykietę, cały argument mieści się w tym zdaniu.
Gdzie Prometheus kosztuje więcej, niż na to wygląda
Test na dev.to obejmujący siedem narzędzi monitorujących na jednym małym VPS zmierzył samemu Prometheusowi 15 minut wdrożenia. Połącz go z Grafaną, tak jak zrobił to autor testu, bo wbudowana przeglądarka wyrażeń to tylko miejsce, w którym uruchamiasz zapytania. Ten sam test daje parze Grafana + Prometheus 35 minut do pierwszego wykresu, z konfiguracją scrape w YAML gdzieś pośrodku.
Minuty to tania część. Droga jest PromQL. Prometheus przechowuje wszystko jako szeregi czasowe identyfikowane nazwą i etykietami, a PromQL wciąż pozostaje językiem pod pytaniami, które mu zadajesz. Grafana ma już wizualny kreator, więc nie musisz pisać każdego zapytania ręcznie. Werdykt samego autora testu był bezceremonialny: PromQL jest wspaniały, jeśli się w nim mieszka, a on w nim nie mieszkał. Jeśli nigdy nie używałeś języka zapytań, zaplanuj na to więcej niż jeden wieczór i licz się z powrotami za każdym razem, gdy kreator wizualny przestanie wystarczać. Dashboard skopiowany od kogoś innego odpowiada na jego pytania. Twoje są zapytaniem, którego jeszcze nie napisałeś.
Trzeci koszt to ten, który ujawnia się dopiero później. Pewien trzytygodniowy zapis pewnego operatora opisuje dokładnie, co oznaczało dodanie jednego serwera do środowiska z siedmioma węzłami: ponowne etykietowanie, ponowne sprawdzanie konfiguracji scrape, edytowanie zmiennych dashboardów i przerabianie zapytań w szablonach, żeby nowy host pojawił się na listach rozwijanych. Ten operator porzucił cały stos po trzech tygodniach, dochodząc do wniosku, że spędza więcej czasu na strojeniu dashboardów niż na obserwowaniu własnej infrastruktury.
Zwróć uwagę, z czym ten koszt jest w takim środowisku związany: z celami i dashboardami zarządzanymi ręcznie. Prowadzenie Prometheusa przez dwa spokojne lata nie kosztuje cię prawie nic ponadto.
Ile RAM-u i dysku Prometheus naprawdę potrzebuje?
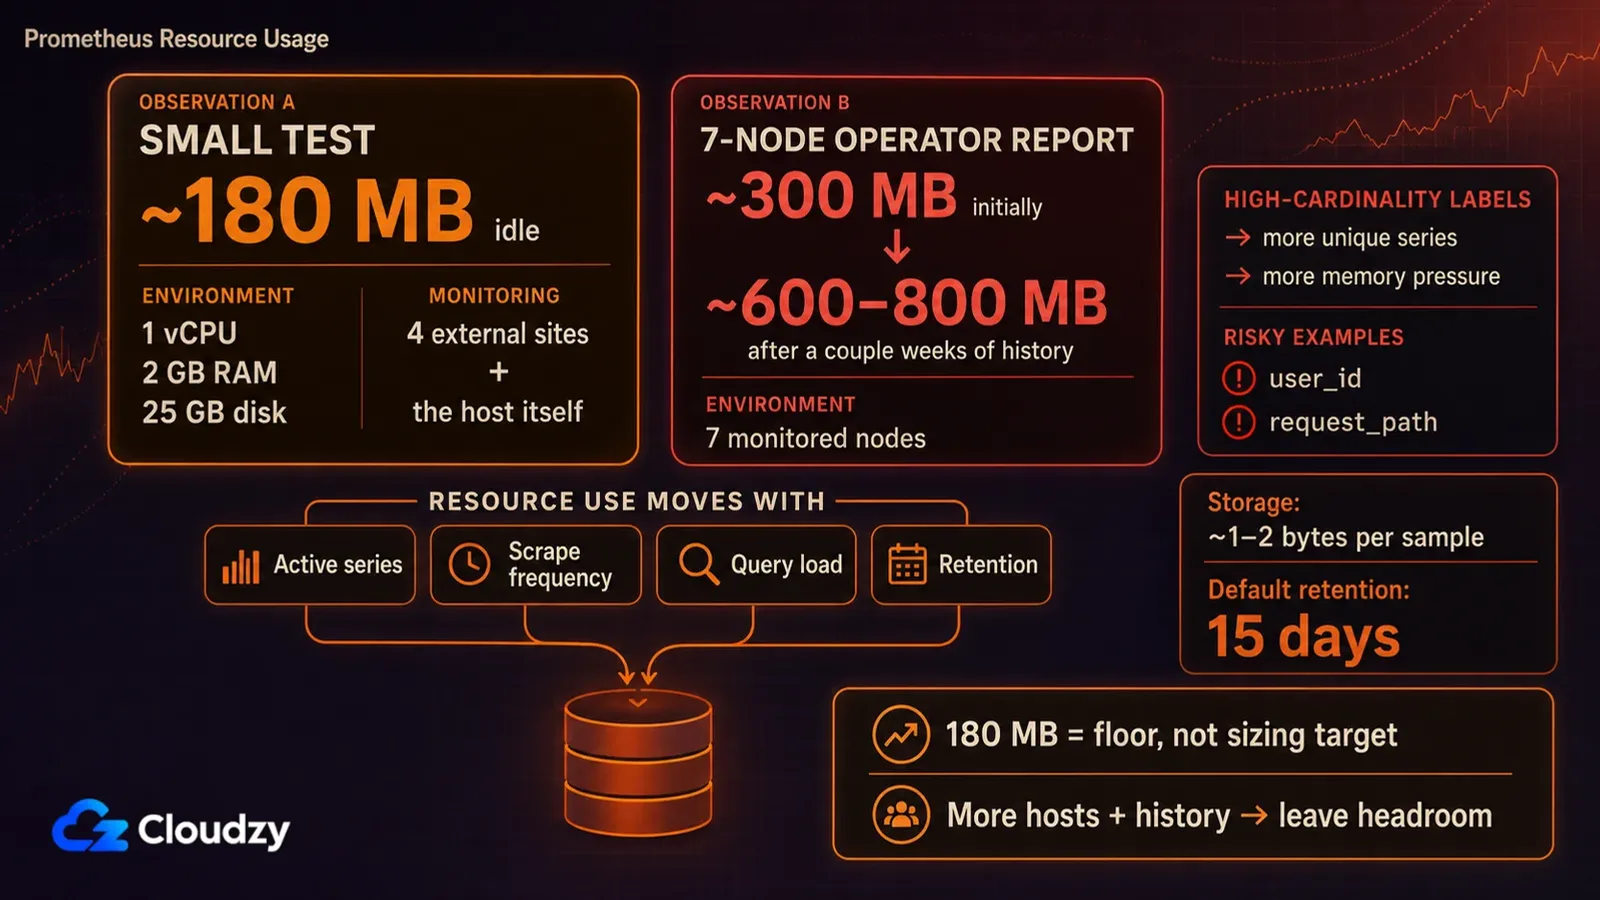
Nie ma stałego wymagania. Aktywne serie, częstotliwość zbierania, obciążenie zapytaniami i okres przechowywania liczą się bardziej niż sama liczba serwerów, na które go skierujesz. Dwa opublikowane testy praktyczne małych środowisk umieszczają go mniej więcej między 180 MB a 800 MB, przy czym wyższa liczba obejmuje siedem węzłów z kilkoma tygodniami historii.
Oba testy nie zgadzają się ze sobą i to właśnie ta rozbieżność jest użyteczna. To samo porównanie siedmiu narzędzi na VPS uruchamiało każde z nich na identycznym sprzęcie (1 vCPU, 2 GB RAM, 25 GB dysku, Ubuntu 24.04), obserwując cztery zewnętrzne witryny plus samego hosta, i zmierzyło Prometheusowi około 180 MB na biegu jałowym. Ten sam operator raportował, że sam Prometheus utrzymywał się w spoczynku w okolicach 300 MB na centralnym hoście i piął się ku 600 do 800 MB, gdy uzbierało się kilka tygodni historii.
To nie są te same pomiary i właśnie dlatego uśrednianie ich wyrzucałoby informację do kosza. Jeden to odczyt niemal jałowy na maszynie, która ma bardzo mało do przechowania. Drugi to działające wdrożenie z flotą za plecami i historią na dysku. Ja czytam to tak: potraktuj wynik 180 MB jako podłogę, a nie jako cel wymiarowania. Gdy tylko zbierasz z wielu hostów i trzymasz historię, zostaw zapas zamiast planować pod tę liczbę z biegu jałowego.
Dysk to łatwiejsza połowa. Dokumentacja magazynu Prometheusa podaje średnio 1 do 2 bajtów na próbkę, więc trzymanie długiej historii w małym środowisku jest tanie. Haczyk tkwi w wartości domyślnej: okres przechowywania wynosi domyślnie 15 dni o ile nie ustawisz czasu ani rozmiaru przechowywania. Od całego roku dzieli cię jedna flaga przy starcie i jest to dokładnie ten rodzaj domyślnej wartości, o którym wolisz dowiedzieć się teraz niż wtedy, gdy pierwszy raz sięgniesz po liczby z zeszłego miesiąca i odkryjesz, że wygasły trzy tygodnie temu.
To, co podbija liczbę pamięci, to kardynalność: liczba odrębnych szeregów czasowych, gdzie każda unikalna kombinacja etykiet na metryce staje się osobnym szeregiem. Jedna źle dobrana etykieta na metryce o dużym ruchu potrafi stworzyć więcej szeregów niż pięć dodatkowych serwerów i robi to po cichu, w takim tempie, w jakim akurat płynie twój ruch. (Identyfikator użytkownika albo ścieżka żądania wygląda na świetną etykietę dokładnie do momentu, w którym policzysz, ile ich jest.)
Każda liczba o RAM-ie, jaką znajdziesz przy Prometheusie, jest użyteczna tylko wtedy, gdy wiesz też, ile serii za nią stało.
Co się stanie, gdy twój serwer Prometheusa padnie?
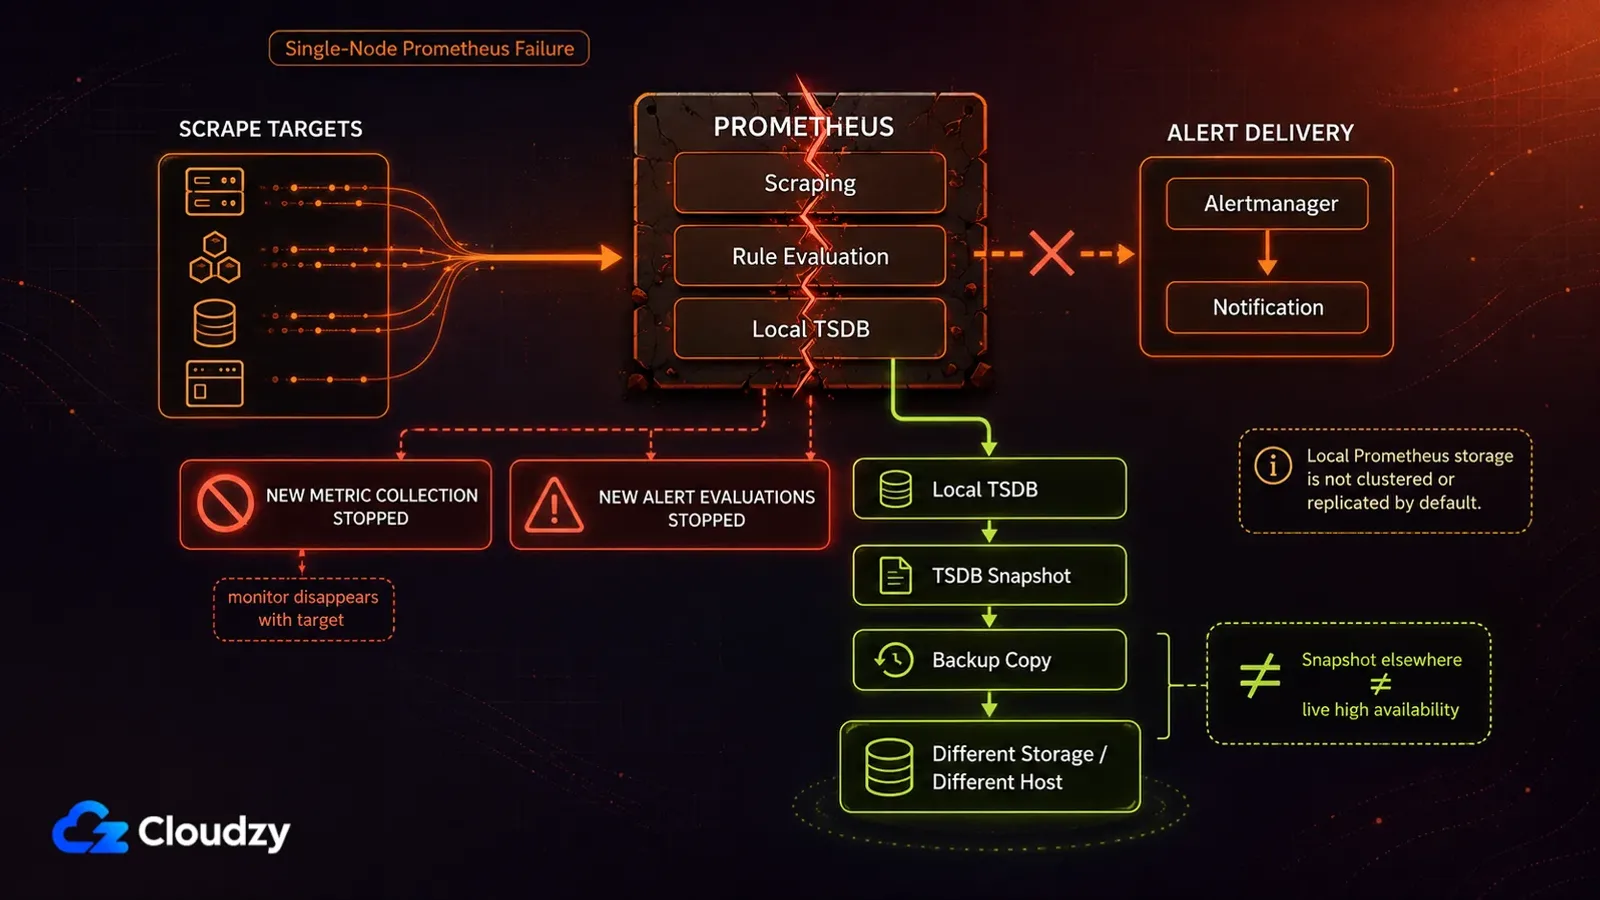
Własna dokumentacja magazynu Prometheusa mówi o tym wprost: magazyn lokalny nie jest klastrowany ani replikowany, więc nie przetrwa awarii dysku ani węzła. Każdy serwer jest z założenia samodzielny i nie zależy ani od magazynu sieciowego, ani od usług zdalnych, co jest dokładnie tym, co czyni go łatwym w prowadzeniu, i dokładnie tym, co zostawia go bez osłony.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Jest jeszcze druga granica, którą projekt sam o sobie ogłasza, i należy mu się za to uznanie: jeśli potrzebujesz stuprocentowej dokładności, na przykład do rozliczania za pojedyncze żądania, dokumentacja mówi, że Prometheus jest złym wyborem, bo zbierane przez niego dane najpewniej nie będą wystarczająco szczegółowe i kompletne. Do liczb, na podstawie których wystawiasz faktury, użyj czegoś innego, a Prometheusa zostaw do monitoringu. Dostawcy zwykle nie mówią takich rzeczy o sobie z własnej woli.
W większej skali istnieją na to utarte odpowiedzi i są tutaj poza zakresem z tego samego powodu, co narzędzia wokół Kubernetes: oznaczają inne zobowiązanie operacyjne niż to, którym zajmuje się ta recenzja. Dla pojedynczego VPS czytam to tak, że ryzyko jest do przyjęcia, jeśli trzymasz snapshoty TSDB gdzie indziej albo z góry godzisz się na utratę historii, i że to prawdziwy problem, jeśli Prometheus jest jedyną rzeczą stojącą między tobą a cichą awarią.
Kto powinien hostować Prometheusa u siebie?
Najwyraźniejszy sygnał, że Prometheus zwróci to, co kosztuje, nie ma nic wspólnego z tym, ile masz serwerów. Chodzi o to, czy za pół roku będą to te same serwery. Stabilny zestaw ręcznie skonfigurowanych hostów oznacza, że konfigurację piszesz raz, a historię zbierasz za darmo; zestaw, który wciąż się zmienia, oznacza, że w tę konfigurację wciąż grzebiesz.
W statycznym środowisku twoja konfiguracja Prometheusa i Grafany jest wprost opisem twojej infrastruktury: cele zbierania, przypięte do nich etykiety i dashboardy zbudowane na tych etykietach. Dlatego cały zysk tkwi w historii. Rok danych o stabilnym zestawie hostów mówi ci, jak wygląda normalność, a to najpewniejszy sposób, by rozpoznać nienormalność, zanim zmieni się w awarię.
Pierwszy profil to zatem ktoś, kto prowadzi mały, wolno zmieniający się zestaw serwerów i chce czegoś więcej niż tylko działa/nie działa: opóźnienia żądań w czasie, trendy pamięci, dysk zapełniający się na tyle stopniowo, że widać to na tygodnie przed. Jeśli potrafisz opisać swoją infrastrukturę dziś i spodziewasz się, że ten opis będzie z grubsza prawdziwy za rok, wieczór spędzony na wdrożeniu to ostatni duży rachunek.
Drugi to każdy, kto uczy się tego stosu świadomie. Jeśli spodziewasz się, że za kilka lat będziesz prowadził infrastrukturę, swoją albo cudzą, wieczór z PromQL jest właśnie tym, po co przyszedłeś, a monitoring to efekt uboczny. Ten profil częściowo odwraca pierwszy: test stabilności liczy się tu mniej, bo czas spędzony na ponownym etykietowaniu jest zarazem czasem spędzonym na nauce, czym to ponowne etykietowanie w ogóle jest. Dla takiego czytelnika podniósłbym ocenę.
Trzeci profil dotyczy własności i to on bywa niedoceniany, dopóki człowiek nie znajdzie się po niewłaściwej stronie. Prometheus nie nalicza za hosta, za metrykę ani za etykietę i żadna strona z cennikiem nie zmieni ci się pod nogami w przyszłym kwartale. Wymiana wobec usługi zarządzanej pokroju Datadog wygląda tak: rezygnujesz z dopracowania, z umowy wsparcia i z cudzego dyżuru, a w zamian dostajesz metryki, które są twoje, na rachunku, który nie drgnie, gdy programista dołoży instrumentację. Czy to dobra wymiana, zależy od tego, ile warte są twoje własne godziny, a tę liczbę możesz wstawić tylko ty (i rzadko bywa zerowa, nawet jeśli tak się wydaje).
Jedna rzecz, którą warto wiedzieć, zanim się zdecydujesz: wyrośnięcie z lokalnego magazynu Prometheusa nie jest ślepą uliczką. VictoriaMetrics przyjmuje remote write z Prometheusa, a MetricsQL jest wstecznie zgodny z PromQL, więc większość zapytań i dashboardów Grafany, które budujesz teraz, powinna przeżyć przeprowadzkę. To migracja, nie przepisywanie.
Warto sprawdzać to raz do roku, zamiast rozstrzygać raz na zawsze: środowisko, które dziś jest tanie w monitorowaniu, drożeje w kwartale, w którym zaczynasz je przebudowywać.

Twórz na VPS Linux z dostępem root, NVMe i mocą AMD EPYC.
Zobacz plany LinuxKto powinien odpuścić Prometheusa?
Jeśli zdanie, którym opisałbyś swoją potrzebę, brzmi „daj mi znać, gdy strona padnie”, to opisujesz narzędzie do sprawdzania dostępności, a Prometheus to bardzo dużo maszynerii, żeby dojść do tej odpowiedzi. Uptime Kuma robi dokładnie tę jedną rzecz, ma interfejs webowy i nie każe ci uczyć się języka zapytań do monitoringu. Przepaść w możliwościach między tymi dwoma narzędziami jest ogromna i całkowicie nieistotna dla zadania, do którego je zatrudniasz.
Drugi czytelnik to ten, kto chce użytecznych wykresów bez uprzedniej nauki języka zapytań. Netdata jest zbudowana dokładnie wokół tego: metryki per host, na które możesz spojrzeć od razu, przy znacznie mniejszej konfiguracji i bez niczego między tobą a wykresami. Jeśli pytanie, które ciągle sobie zadajesz, brzmi „dlaczego ta maszyna jest teraz wolna”, to jest to znacznie krótsza droga do odpowiedzi.
Trzeci to każdy, komu infrastruktura często zmienia kształt i kto ręcznie zarządza celami oraz zmiennymi dashboardów. Hosty stawiane na tydzień i kasowane, cele zmieniające nazwy, projekty przemianowywane w połowie drogi. To przypadek, w którym płacisz koszt konfiguracji raz za razem, mając jednocześnie najmniejszy pożytek z tego, za co płacisz, czyli z ciągłej historii systemu, który pozostaje rozpoznawalny.
Nic z tego nie jest zarzutem wobec narzędzia. „Odpuścić” znaczy tu odpuścić do tego zadania i w tej skali. W skali Kubernetes, gdzie service discovery bierze na siebie większość tego, co inaczej trzeba by okablować ręcznie, kilka z powyższych kosztów maleje albo znika zupełnie, a tę skalę czytam tak, że Prometheusa jest tam bardzo trudno pokonać. To już jednak inna recenzja.

Często zadawane pytania
Czy Prometheus jest darmowy?
Tak i nie ma pod tym żadnego haczyka z darmowym planem. Prometheus jest na licencji Apache 2.0 i nie stoi za nim żadna edycja komercyjna, więc nie ma limitu metryk do przekroczenia ani zachęty do przejścia wyżej czekającej po drugiej stronie. Płacisz za infrastrukturę i za własny czas, a nie za licencję Prometheusa.
Czy Prometheus potrzebuje Grafany?
Nie, ale licz się z nią. Przeglądarka wyrażeń w Prometheusie istnieje po to, żeby uruchomić zapytanie i spojrzeć na odpowiedź, co wystarcza do jednorazowego sprawdzenia jednej rzeczy. Wszystko, co chcesz zostawić otwarte na drugim monitorze, to zadanie dla Grafany, a te dwa narzędzia niemal zawsze uruchamia się razem.
Czy Prometheus to przerost formy dla jednego serwera?
Często tak. Jeśli potrzebujesz tylko wiedzieć, czy serwer i jego usługi działają, narzędzie do sprawdzania dostępności odpowie ci na to w ułamku czasu wdrożenia. Prometheus zasługuje na swoje miejsce wtedy, gdy chcesz historycznych metryk, które da się odpytywać, i jesteś gotów nauczyć się PromQL, żeby do nich dotrzeć.
Jak długo Prometheus domyślnie przechowuje metryki?
15 dni i nie ostrzega cię wcześniej. Prometheus odrzuca próbki starsze niż okno przechowywania, chyba że podniesiesz je flagą czasu albo rozmiaru przechowywania przy starcie. Ustaw to w dniu instalacji, bo poszerzenie okna później nie przywróci danych, które już wygasły.



Dyskusja
Komentarze
Zaloguj się, aby dołączyć do dyskusji.