

PRTG rozlicza się za sensor, czyli jedną monitorowaną metrykę na jednym urządzeniu, a nie za samo urządzenie. Progi Paesslera ustalają praktyczny stosunek na mniej więcej dziesięć do jednego: 500 sensorów obejmuje około 50 urządzeń, 10 000 obejmuje około 1000. Dołóż stos przełączników i zacznij obserwować przepustowość na port, a licznik rośnie szybciej niż infrastruktura. SolarWinds liczy inaczej i dochodzi do tego samego miejsca.
W sieci zdominowanej przez Windows wziąłbym pod uwagę dwie samodzielnie hostowane alternatywy dla PRTG i SolarWinds: Zabbix albo stos oparty na Prometheusie, jeśli zespół już taki utrzymuje. Wybór między nimi zależy od tego, co każde z nich widzi na hoście Windows i czego potrzebuje, żeby to zobaczyć.
Jedno zastrzeżenie na początek. Jeśli nikt w zespole nie ma wolnych godzin, PRTG i SolarWinds pozostają właściwą odpowiedzią. Ich łatwość obsługi to produkt, który kupujesz świadomie, i jest wart swojej ceny. Opisana tu zmiana wydaje godziny zamiast opłat licencyjnych, a to wymiana, nie ulepszenie.
TL;DR
- Domyślny wybór to Zabbix. Zabbix łączy odpytywanie SNMP, agenty Windows, szablony i alertowanie w jednej platformie monitoringu. Nadal utrzymujesz serwer Zabbix, bazę danych i frontend WWW, ale nie składasz osobnych komponentów monitoringu tylko po to, żeby zacząć.
- Wyjątkiem jest zespół, który już utrzymuje Grafanę i Prometheusa do metryk aplikacji i hostów. Rozszerzenie tego, co już utrzymujesz, jest tańsze niż stawianie drugiego systemu monitoringu.
- Prometheus sam nie odpytuje urządzeń sieciowych.
snmp_exporterwypełnia tę lukę; jego domyślna konfiguracja obejmuje wiele popularnych przełączników i routerów, natomiast obiekty specyficzne dla producenta lub niestandardowe odpytywanie mogą wymagać generatora i dodatkowej pracy z MIB. - Zbieranie bezagentowe widzi tylko to, co host lub urządzenie zdecyduje się opublikować. W Zabbiksie dzienniki zdarzeń Windows, stan usług i szczegółowe liczniki wydajności to klucze elementów agenta.
- Dobieraj serwer według metryk, nie urządzeń. Zabbix liczy jedną metrykę jako jeden element plus jeden wyzwalacz plus jeden wykres i umieszcza około 1000 metryk na 2 rdzeniach CPU i 8 GiB pamięci, a około 10 000 na 4 rdzeniach i 16 GiB.
Za co każą płacić PRTG i SolarWinds
Paessler publishes its PRTG tiers publicly, priced by sensor count and billed annually, starting from a few hundred dollars a month as of September 2026. Check the current figures yourself before budgeting. There is no perpetual-licence option in the current lineup. The freeware edition stops at 100 sensors, which Paessler describes as roughly 10 devices.
SolarWinds liczy inną jednostkę, a regułę łatwo przeoczyć, dopóki nie przyjdzie wycena odnowienia. Model licencjonowania NPM firmy SolarWinds stwierdza, że NPM „jest licencjonowany według największej liczby spośród następujących typów monitorowanych elementów sieci: węzły, interfejsy, wolumeny”. Nie sumy. Największej z trzech. Sieć z 80 węzłami i 900 monitorowanymi portami przełączników jest licencjonowana na 900, nie na 80, a progi biegną od SL100 do SLX. Pojedynczy silnik odpytywania ma limit 12 000 elementów (suma węzłów, interfejsów i wolumenów, nie największa z nich) niezależnie od progu, a powyżej dokładasz kolejny licencjonowany silnik odpytywania.
Praktyczny skutek obu modeli jest ten sam. O tym, co jest monitorowane, decyduje próg licencji. Nie sieć. Interfejsy, które chciałbyś obserwować, pozostają nieobserwowane, bo obserwowanie ich przekracza granicę, a ten koszt nigdy nie pojawia się na fakturze.
Dwie samodzielnie hostowane ścieżki, które warto rozważyć
Zabbix to jedna platforma monitoringu zbudowana wokół centralnego serwera, bazy danych i frontendu WWW. Serwer odpytuje urządzenia SNMP, odbiera dane od agentów Windows i stosuje szablony, wyzwalacze oraz alertowanie w ramach tego samego produktu. W porównaniu ze składaniem stosu monitoringu sieci opartego na Prometheusie jest mniej osobnych komponentów do samodzielnej integracji. Instalujesz go, wskazujesz hosty i podpinasz szablony, czyli wielokrotnego użytku pakiety elementów, wyzwalaczy i wykresów obejmujące jedną klasę urządzeń.
Zacznij od licencji. Strona licencji Zabbiksa stwierdza, że każda wersja od 7.0 wzwyż jest wydawana na licencji GNU Affero General Public License w wersji 3, a wszystko do 6.4 było na GPLv2. Za oprogramowanie nie ma żadnej opłaty licencyjnej w żadnej skali. Zabbix sprzedaje wsparcie techniczne jako osobną, opcjonalną subskrypcję i prosi użytkowników komercyjnych o wykupienie jakiegoś jej poziomu, ale nic w produkcie nie jest zablokowane za tym zakupem.
Druga ścieżka to Grafana, Prometheus i VictoriaMetrics. To właściwy wybór dokładnie w jednej sytuacji: już utrzymujesz ten stos do metryk aplikacji i hostów, a ktoś już się nim opiekuje. Jeśli to ty, pełna budowa na jednym VPS to rozwiązany problem i rozszerzasz coś znajomego. Nikt nie musi uczyć się nowego modelu danych.

Luką na tej ścieżce są urządzenia sieciowe. Prometheus zbiera z punktów końcowych HTTP; nie mówi bezpośrednio po SNMP. Sprzęt sieciowy obsługuje się zwykle przez snmp_exporter, który odpytuje urządzenie i wystawia wyniki do zebrania przez Prometheusa. Jego domyślna konfiguracja zawiera moduły takie jak if_mib, więc standardowy monitoring interfejsów na wielu przełącznikach i routerach nie wymaga generowania własnej konfiguracji. Generator staje się dodatkową pracą, gdy potrzebujesz obiektów specyficznych dla producenta, niestandardowych przejść lub MIB, których domyślnie nie ma. Ścieżka Prometheusa ma więc więcej elementów do utrzymania niż Zabbix, ale generator nie jest obowiązkowy dla każdego urządzenia.
LibreNMS to trzecia nazwa w tym obszarze, zbudowana wokół automatycznego wykrywania: przechodzi sieć po SNMP, CDP, LLDP, OSPF, BGP i ARP, żeby znaleźć, co w niej jest. To rozsądna opcja, gdy priorytetem jest wykrywanie. Nie zmienia jednak kwestii zbierania danych z Windows, a to właśnie tam rozstrzyga się ta decyzja.
Jak każda ścieżka widzi host Windows
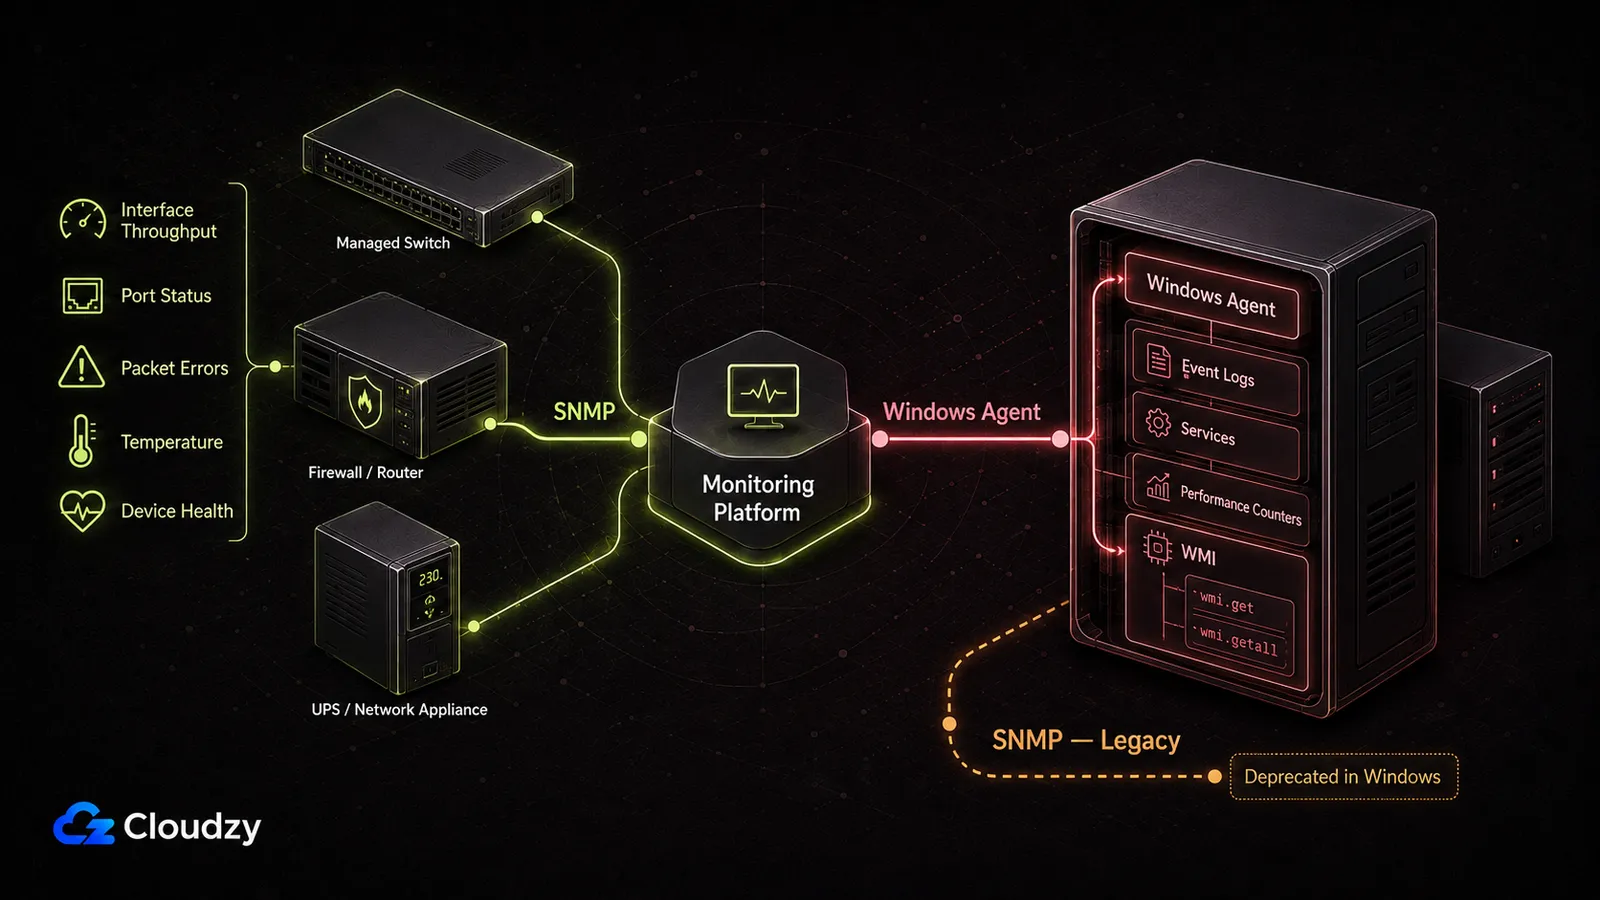
Monitoring Windows może obejmować SNMP, zdalne WMI lub zainstalowanego agenta. Która ścieżka ma zastosowanie, zależy od produktu monitoringu i zbieranej metryki. Konkretnie w Zabbiksie wbudowane sprawdzenia WMI działają przez agenta Windows.
SNMP
Odpytanie SNMP prosi urządzenie o bieżącą wartość ponumerowanego obiektu, adresowanego przez OID, czyli pozycję w MIB urządzenia. Wraca to, co urządzenie publikuje, i nic więcej. Na zarządzalnym przełączniku, zaporze czy UPS zwykle to wystarcza: liczniki interfejsów, stan portów, współczynniki błędów, temperatura, kondycja obudowy.
Na Windows obraz jest uboższy. Nota Microsoftu o wycofaniu SNMP i dostawcy WMI SNMP potwierdza, że obie funkcje są przestarzałe, więc traktowałbym SNMP w Windows jako ścieżkę zgodności wstecznej, a nie domyślną dla nowego wdrożenia. Zabbix nadal dostarcza szablon Windows by SNMP, ale natywny agent daje znacznie większy wgląd w system operacyjny.
WMI
WMI można odpytywać zdalnie bez instalowania agenta monitoringu na celu i dlatego produkty takie jak PRTG mogą używać go jako bezagentowej metody zbierania danych z Windows. Zabbix działa inaczej. Jego wbudowane sprawdzenia WMI, wmi.get oraz wmi.getall, to klucze elementów agenta Windows, więc to agent Zabbix lub agent 2 wykonuje te zapytania na monitorowanej maszynie.
Zdalne WMI niesie też własne wymagania sieciowe, gdy produkt monitoringu używa go bezpośrednio. W obecnych systemach Windows RPC startuje na porcie TCP 135 i zwykle negocjuje połączenia przez dynamiczny zakres wysokich portów TCP, typowo od 49152 do 65535. Zapora i uprawnienia WMI na celu muszą zezwalać na połączenie.
Dla tego porównania rozróżnienie jest ważniejsze niż sam protokół: PRTG może używać zdalnego WMI bez zainstalowanego agenta monitoringu, podczas gdy Zabbix uzyskuje swoją specyficzną dla Windows widoczność WMI przez agenta.
Natywny agent
To w agencie tkwi głębia specyficzna dla Windows. Dokumentacja Zabbiksa wymienia klucze specyficzne dla Windows: eventlog do monitorowania dziennika zdarzeń Windows, perf_counter do dowolnego licznika wydajności Windows, service.discovery oraz service.info do stanu usług. Wszystkie są kluczami elementów agenta.
Kosztem jest wdrożenie. Agent na każdym Windows Server i każdej stacji roboczej, na której ci zależy, to pakiet do rozesłania, wersja do utrzymywania i reguła zapory do pilnowania. To stałe zobowiązanie operacyjne i to ono równoważy oszczędność na licencji.
Zbieranie bezagentowe jest ograniczone do tego, co host lub urządzenie zdecyduje się opublikować, a w Zabbiksie dzienniki zdarzeń i szczegółowe liczniki wydajności kryją się za kluczami elementów agenta.
Obok siebie
Porównanie sprowadza się do czterech rzeczy: czy narzędzie w ogóle odpytuje urządzenia sieciowe po SNMP, czy ma agenta Windows, jak głęboko widzi host Windows i ile składania dzieli cię od działającego systemu. Licencjonowanie stoi obok, bo to od niego zaczęła się ta ocena.
| Narzędzie | Odpytywanie urządzeń SNMP | Monitoring Windows | Nakład na konfigurację | Licencjonowanie |
|---|---|---|---|---|
| Zabbix | Wbudowany | Agent: dzienniki zdarzeń, stan usług, liczniki wydajności i WMI; zgrubny stan po SNMP | Umiarkowany: jeden serwer, potem szablony | AGPLv3, bez opłaty licencyjnej; wsparcie sprzedawane osobno |
Grafana + Prometheus + VictoriaMetrics (+ snmp_exporter) | Niewbudowane; wymaga snmp_exporter jako osobnego komponentu | Brak natywnego agenta Windows; metryki hostów pochodzą z osobnych eksporterów; dzienniki zdarzeń nie są natywne | Wysoki: wiele komponentów; niestandardowe SNMP może wymagać pracy z generatorem | Komponenty open source, bez opłaty licencyjnej |
| Monitory dostępności i stanu | Nic | Tylko osiągalność usług i czas odpowiedzi | Niski: minuty | Zależy od narzędzia |
Jeśli wymaganie brzmi „powiadom mnie w ciągu minuty, gdy usługa przestanie odpowiadać”, monitor dostępności jest narzędziem właściwej wielkości, a dwa pozostałe są do tego przerośnięte. Czego nie zrobi: nie odpyta przełącznika o przepustowość interfejsu ani nie odczyta licznika wydajności Windows, więc nie zastępuje PRTG ani SolarWinds. To inne zadanie, które czasem bierze się za to samo.

Które uruchomić
Uruchom Zabbix. W sieci zdominowanej przez Windows bez istniejącej inwestycji w Prometheusa to zdecydowanie krótsza droga. Nadal masz serwer, bazę danych i frontend WWW do utrzymania, ale model monitoringu, szablony i alertowanie żyją w jednym produkcie, zamiast być składane z kilku komponentów monitoringu.
Do długo działającego wdrożenia monitoringu użyj bieżącej gałęzi LTS Zabbiksa zamiast krótkoterminowego wydania standardowego. Cykl życia LTS Zabbiksa daje każdemu wydaniu trzy lata pełnego wsparcia, a potem dwa lata wsparcia ograniczonego, co liczy się tu bardziej niż pogoń za najnowszym wydaniem z nowościami.
Wyjątek jest wąski i konkretny. Jeśli twój zespół już utrzymuje Grafanę i Prometheusa na produkcji do metryk aplikacji i hostów, a ktoś już jest właścicielem tego stosu, to snmp_exporter jest dodatkiem do czegoś utrzymywanego, a nie drugim systemem do utrzymania. Ten warunek jest koniunkcją: obie połowy muszą być spełnione. Porzucona instancja Grafany, którą ktoś postawił w zeszłym roku, się nie liczy.
A jeśli nikt nie ma godzin, odnów licencję. To nie jest wymówka. To inna sytuacja z inną poprawną odpowiedzią. Zmiana zamienia rachunek za licencję na rachunek operacyjny: rozsyłanie agentów, praca nad szablonami, aktualizacje i ktoś, kto rozumie system na tyle dobrze, żeby naprawić go o 2 w nocy. Zespół już na granicy wydolności zrobi tę pracę źle albo wcale, a nieutrzymywany monitoring jest gorszy od drogiego, bo zawodzi po cichu.
Hybryda istnieje naprawdę: zostaw obecne narzędzie na kurczącym się rdzeniu systemów krytycznych, przenieś całą resztę do Zabbiksa i pozwól progowi licencji spadać z czasem. To działa. Oznacza też utrzymywanie dwóch systemów monitoringu i uzgadnianie ich alertów, więc traktuj to jako stan przejściowy z datą końcową.
Co nie przetrwa migracji
Własny przewodnik migracji Zabbiksa ma sekcję zatytułowaną „Co NIE jest migrowane”, a lista jest dłuższa, niż sugeruje słowo „migracja”. Dane historyczne i odczyty sensorów nie przechodzą. Niestandardowe powiadomienia i zależności PRTG też nie. Mapy i pulpity też nie, bo oba produkty modelują je na tyle różnie, że odbudowa wygrywa z tłumaczeniem. Same sensory też nie, bo Zabbix pracuje na zupełnie innej koncepcji.
Nazwy urządzeń, adresy IP i typy interfejsów da się przenieść. Nawet to odbywa się przez własne skrypty eksportu i importu wobec obu API. Przewodnik mówi wprost, że nie ma oficjalnego narzędzia do bezpośredniej migracji między tymi platformami.
Jeden zespół udokumentował, ile to kosztuje w praktyce: około 500 maszyn wirtualnych i serwerów fizycznych, około siedem lat na PRTG, odbudowane od zera przez sześć miesięcy projektu o niskim priorytecie. Ich 2500 sensorów PRTG stało się 43 000 elementów Zabbiksa, co dobitnie pokazuje, jak różnie liczą oba systemy.
„Zacznij od zera. Nie ma opcji „naciśnij ten przycisk i zmigruj” z PRTG do Zabbiksa, a nawet gdyby była, coś takiego to dobra okazja, żeby nie powtarzać wcześniejszych błędów projektowych”.
To doświadczenie jednej organizacji, nie wzorzec. Mniejsza infrastruktura nie da takich liczb. Przenosi się założenie planistyczne: budżetuj czas odbudowy, nie czas migracji.
Ułóż odbudowę według tego, bez czego nie możesz się obejść. Jeśli chodzi ci o ciągłość alertowania, odbuduj najpierw reguły powiadomień, a pulpity niech poczekają. Jeśli o historię raportów, wyeksportuj to, czego potrzebujesz, zanim wygaśnie stara licencja. Ona z tobą nie pójdzie.
Dobór serwera
Wymagania sprzętowe Zabbiksa umieszczają małą instalację około 1000 monitorowanych metryk na 2 rdzeniach CPU i 8 GiB pamięci, a średnią instalację około 10 000 metryk na 4 rdzeniach i 16 GiB. To liczby, o które warto oprzeć zamówienie.
Jednostka to miejsce, w którym dobór idzie źle. Zabbix definiuje jedną monitorowaną metrykę jako jeden element plus jeden wyzwalacz plus jeden wykres. Metryka nie jest urządzeniem ani hostem. Pojedynczy Windows Server wnosi tyle metryk, ile elementów skonfigurujesz: CPU, pamięć, każdy system plików, każdą usługę, każdy licznik, który próbkujesz. Liczba urządzeń to kiepska wskazówka co do potrzebnej maszyny. Infrastruktura, która brzmi na małą, może wylądować w przedziale średnim, choć nikt nie robi nic niezwykłego.
Dwie rzeczy podbijają liczbę szybciej niż liczba hostów. Pierwsza to częstotliwość odpytywania: skrócenie interwału odświeżania o połowę podwaja tempo zapisu dla każdego elementu na tym interwale. Druga to retencja historii, bo baza danych rośnie wraz z tym, jak długo trzymasz surowe wartości. Liczba urządzeń liczy się głównie przez liczbę monitorowanych elementów, które wnosi każde urządzenie.
Jeśli twoja infrastruktura trzyma się blisko przykładu z 1000 metryk przy zwykłych interwałach odświeżania i skromnej retencji, mały przedział to rozsądny punkt wyjścia. Jeśli próbkujesz liczniki wydajności co trzydzieści sekund i trzymasz rok surowej historii, to nie. Zabbix mówi wprost, że publikowane liczby to „przykłady wielkości i konfiguracji sprzętowej na start”, i zaleca testy wydajności w środowisku testowym przed zamówieniem sprzętu produkcyjnego. To zastrzeżenie samego producenta. Potraktuj je dosłownie.
Zabbix wspiera komponent serwera tylko na Linuksie i UNIX-ie; na Windows wspierany jest tylko agent.
Metryki to nie urządzenia, a mnożnik między nimi decyduje o wielkości maszyny.

Twórz na VPS Linux z dostępem root, NVMe i mocą AMD EPYC.
Zobacz plany LinuxGdzie postawić serwer monitoringu
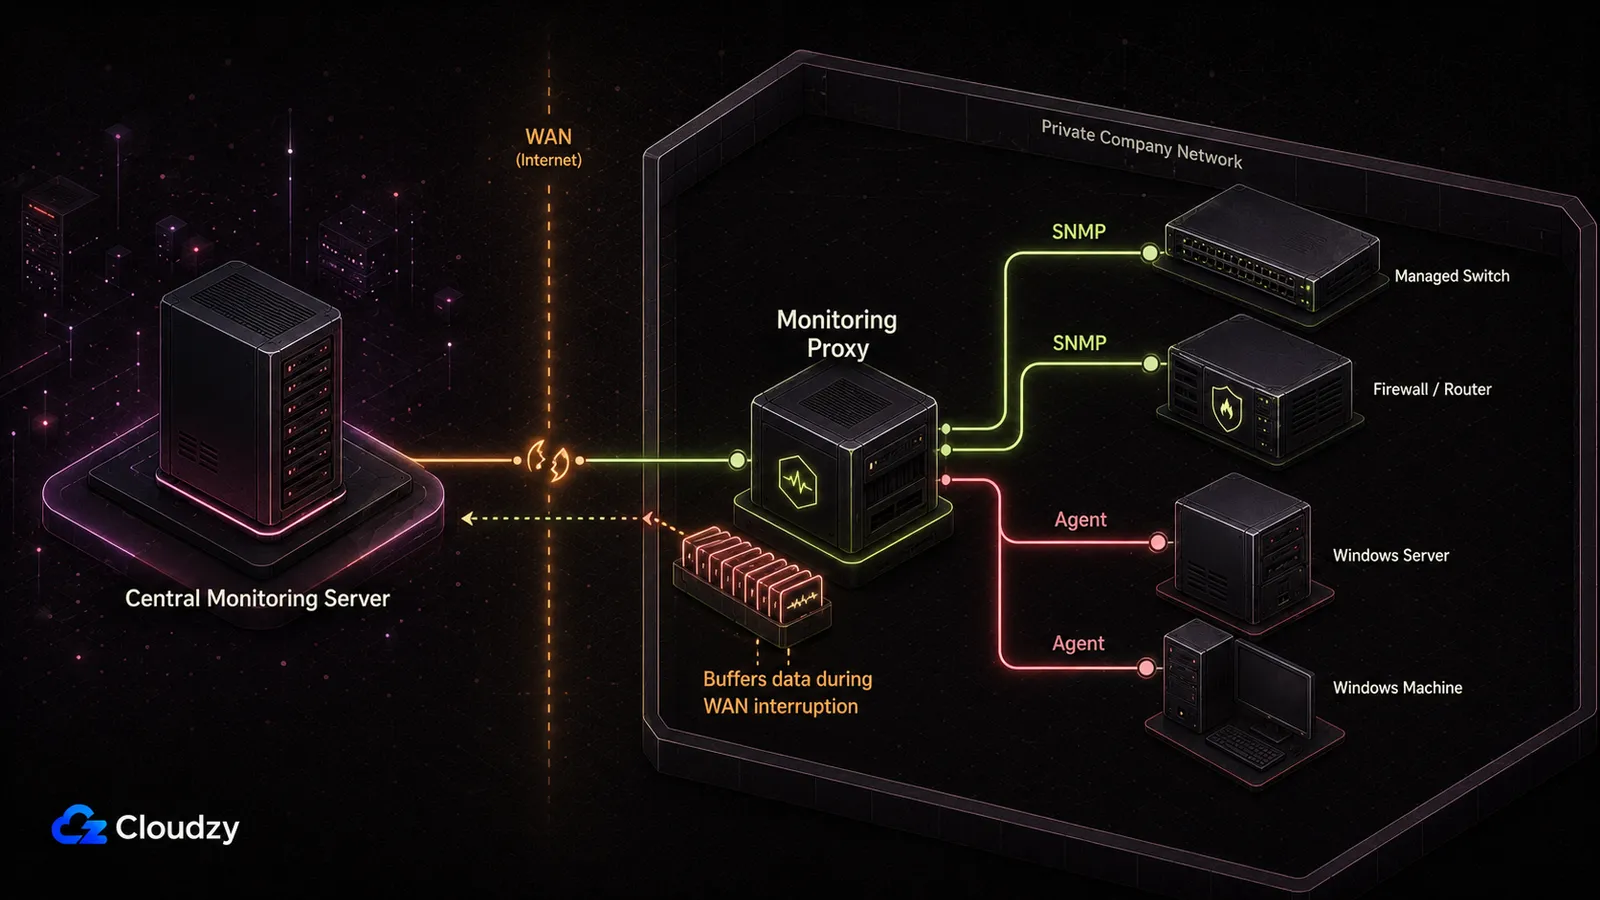
Jeśli monitoring ma przetrwać awarię całej lokalizacji, trzymaj centralny serwer Zabbix poza domeną awarii tej lokalizacji. Utrata łącza lokalizacji może wtedy odciąć monitorowaną sieć, nie zabierając ze sobą serwera monitoringu.
W sieci prywatnej proxy Zabbix może stać wewnątrz lokalizacji i zbierać dane z otaczających je systemów. Proxy potrafi lokalnie obsłużyć sprawdzenia SNMP i agentów, odesłać zebrane dane do serwera centralnego i buforować dane monitoringu, gdy łączność między nimi jest niedostępna. Dzięki temu serwer centralny może pozostać poza lokalizacją bez wymogu, by każdy prywatny przełącznik, zapora i host Windows były bezpośrednio osiągalne z internetu.
VPS to praktyczne miejsce na taki serwer centralny. Cloudzy oferuje Serwer Zabbix jako wdrożenie jednym kliknięciem na Ubuntu Server 24.04 LTS, jeśli chcesz pominąć instalację początkową i przejść od razu do konfigurowania hostów i szablonów.
Często zadawane pytania
Czy Zabbix jest naprawdę darmowy?
Tak. Zabbix od wersji 7.0 jest wydawany na licencji GNU Affero General Public License w wersji 3 i za oprogramowanie nie ma żadnej opłaty licencyjnej, niezależnie od liczby monitorowanych urządzeń czy metryk. Zabbix sprzedaje wsparcie techniczne jako osobną, opcjonalną subskrypcję, ale żadna funkcja produktu nie jest za nią zablokowana. Kosztem uruchomienia Zabbiksa jest serwer, na którym działa, i godziny, które poświęcasz na jego obsługę.
Czy muszę instalować agenta na każdym Windows Server?
Nie na każdej maszynie Windows, ale jeśli chcesz natywnej głębi monitoringu Windows w Zabbiksie, zaplanuj instalację agenta na serwerach, na których zależy ci najbardziej. SNMP może dostarczyć zgrubne dane bez agenta, choć funkcja SNMP w Windows jest przez Microsoft wycofywana. Wbudowane sprawdzenia WMI w Zabbiksie także działają przez agenta Windows, więc WMI nie jest w Zabbiksie bezpośrednią bezagentową ścieżką zbierania danych. Używaj agenta do dzienników zdarzeń, wykrywania usług, zapytań WMI i szczegółowych liczników wydajności; bezagentowe SNMP zostaw głównie dla sprzętu sieciowego i starszych przypadków Windows.
Czy mogę uruchomić serwer monitoringu na Windows?
Nie z Zabbiksem. Dokumentacja wymagań Zabbiksa wymienia komponent serwera jako wspierany wyłącznie na Linuksie i innych platformach UNIX oraz stwierdza, że „UNIX jest jedynym systemem operacyjnym, który potrafi konsekwentnie zapewnić wymaganą wydajność, odporność na awarie i niezawodność”. Wsparcie dla Windows obejmuje agenta Zabbix i agenta 2, czyli to, co instalujesz na monitorowanych maszynach. Serwer monitoringu stoi na hoście Linux; infrastruktura Windows jest tym, co obserwuje.
Czy Prometheus obsługuje monitoring SNMP?
Sam nie. Prometheus zbiera dane z punktów końcowych HTTP i używa snmp_exporter do zbierania danych z urządzeń SNMP. Jego domyślna konfiguracja obejmuje wiele popularnych przełączników i routerów, natomiast obiekty specyficzne dla producenta lub niestandardowe odpytywanie mogą wymagać dodatkowej konfiguracji MIB i generatora.



Dyskusja
Komentarze
Zaloguj się, aby dołączyć do dyskusji.