
Пользователь r/linuxquestions провёл то самое сравнение, о котором все не перестают спорить. Он установил CachyOS, прогнал бенчмарки нескольких игр на Ryzen 7 7800X3D с Radeon RX 7900 XTX и не намерил никакой разницы по сравнению с другими дистрибутивами, уже стоявшими на машине. Ответы пошли по привычному сценарию. Один комментатор опустил потолок так низко, что в обычной работе его не заметить. Другой объяснил про планировщик. Третий заявил, что бенчмарки не способны показать, что делает планировщик. Никто не привёл измерение, которое закрыло бы вопрос.
Вопрос возвращается снова и снова в одних и тех же словах: действительно ли CachyOS быстрее? Короткий ответ — да, на отдельных нагрузках. Перекомпилированные пакеты могут помочь коду, который компилятор умеет векторизовать, приведённые здесь игровые сравнения показывают небольшой разрыв по среднему FPS, а систему, которая кажется быстрее после переезда, сложнее объяснить, потому что смена дистрибутива меняет куда больше одной переменной.
Спор не утихает, потому что «быстрее» содержит три отдельных утверждения с тремя разными ответами, и каждому нужен свой инструмент. Перекомпилированные пакеты либо выполняют задачу за меньшее астрономическое время, либо нет. Планировщик либо меняет поведение рабочего стола под конкурирующей нагрузкой, либо нет. А более отзывчивая машина объясняется либо CachyOS, либо тем, что пришло вместе с ним.
Кратко
- Перекомпилированные пакеты: измеримо быстрее, но лишь для меньшей части того, что вы запускаете. Выигрыш сосредоточен в коде, который компилятор умеет векторизовать, несколько пакетов становятся медленнее, а большинство не меняется. Сравнение в arch-chroot от января 2023 года на sunnyflunk.github.io, на Intel NUC8i5BEK, показало кодирование flac на 20,2 % быстрее и распаковку bzip2 на 7,1 % медленнее в одном и том же прогоне.
- История с планировщиком распадается на две части. Текущее ядро CachyOS по умолчанию использует EEVDF, а BORE доступен отдельно. Сравнения дистрибутивов в мае 2026 года показали небольшой разрыв по среднему FPS, а также измерили 1 % худших кадров и равномерность кадров, но не изолировали BORE и не добавляли контролируемую конкурирующую нагрузку на CPU. Игры «из коробки» измерены; польза BORE под конкуренцией за CPU — нет.
- Ощущение более быстрой машины: опыт настоящий, атрибуция ненадёжная. И свежая установка, и случайное исправление несвязанной ошибки дают более шуструю систему, которая ничем не обязана уровням набора инструкций. Исключение, о котором стоит знать, — сравнение Phoronix «из коробки» на Intel Core Ultra 9 285K, где CachyOS обошёл стандартный Arch на процессоре, который вообще не может использовать оптимизации AVX-512.
Что CachyOS на самом деле меняет в вашей системе
CachyOS — это Arch Linux с тремя отдельными модификациями поверх: пропатченным ядром с альтернативными планировщиками, репозиториями, пакеты которых перекомпилированы под более новые уровни набора инструкций CPU, и дополнительными оптимизациями компилятора для части базовых пакетов. Каждая из них — отдельный механизм с отдельным эффектом, и их почти никогда не измеряют по отдельности.
Сторона ядра — самая большая поверхность. Список возможностей ядра CachyOS включает Clang ThinLTO, профилирование AutoFDO, переключаемые во время работы режимы вытеснения и несколько вариантов планировщика. Текущий пакет linux-cachyos использует настроенный CachyOS EEVDF как планировщик по умолчанию. BORE и BMQ доступны через отдельные варианты ядра, при этом linux-cachyos-eevdf применяет дополнительную настройку отзывчивости EEVDF, а linux-cachyos-server использует стандартный EEVDF. sched-ext по-прежнему доступен на вариантах, которые его поддерживают.
Со стороны пакетов речь идёт о репозиториях CachyOS x86-64-v3. Страница оптимизированных репозиториев CachyOS описывает пересборку пакетов Arch под три цели выше базового уровня: x86-64-v3, x86-64-v4 и отдельную цель Zen 4/5, добавляющую поверх v4 дополнительные расширения AVX-512 и несколько инструкций вне AVX-512. Часть чувствительных к производительности пакетов также получает оптимизацию по профилю и BOLT.
Эти названия уровней взяты из спецификации уровней микроархитектуры x86-64 psABI, и это пороги, а не регуляторы. x86-64-v3 требует инструкций эпохи AVX и AVX2, появившихся с Intel Haswell в 2013 году и ядрами AMD Excavator; x86-64-v4 требует AVX-512, что на практике означает процессоры Intel класса Skylake-X и любой AMD Zen 4 или новее. Процессор либо берёт планку, либо нет.
Три утверждения, спрятанные в слове «быстрее»
Когда два человека спорят о том, быстрее ли CachyOS, обычно оба правы — но о разном. Пропускная способность, стабильность кадров и воспринимаемая отзывчивость — разные свойства, и ни одна метрика не закрывает все три. Замер времени задачи измеряет пропускную способность; измерения времени кадра и задержки покрывают плавность в играх; для более широкого эффекта на уровне системы нужно контролируемое сравнение со свежей установкой.
| Утверждение | Что заявляется | Как это измерить | Что показывают данные | Уверенность |
|---|---|---|---|---|
| Измеренная пропускная способность | Перекомпилированные пакеты выполняют ту же задачу за меньшее время | Замерить одну задачу на фиксированном железе и фиксированном ядре, меняя только репозиторий, из которого взяты пакеты | Солидный выигрыш на векторизуемой работе, небольшие регрессии в нескольких пакетах, без изменений в большинстве | Высокая. Canonical, CentOS ISA SIG и два независимых тестировщика сходятся в общей картине |
| Задержка ввода и стабильность кадров | Рабочий стол остаётся отзывчивым, пока что-то другое загружает CPU | Процентили времени кадра и задержка ввода под конкурирующей нагрузкой, а не средняя частота кадров | Опубликованные тесты теперь включают 1 % худших кадров и равномерность кадров, но не изолируют планировщик и не вводят контролируемую конкурирующую нагрузку на CPU | Низкая. Механизм задокументирован, измерения нет |
| Воспринимаемая отзывчивость | Машина кажется шустрее после переезда | Сравнивать со свежей установкой предыдущего дистрибутива, а не с изношенной | Обычно объясняется эффектом свежей установки или попутным исправлением; одно сравнение «из коробки» показало преимущество на уровне дистрибутива | Средняя. Опыт реальный, атрибуция ненадёжная |
Набор бенчмарков, отвечающий на первую строку, не может ответить на вторую, и ни один из них не касается третьей. Прогнать одно из трёх и выдать результат за вердикт по всем трём — вот что не даёт спору закончиться.
Действительно ли перекомпилированные пакеты работают быстрее?
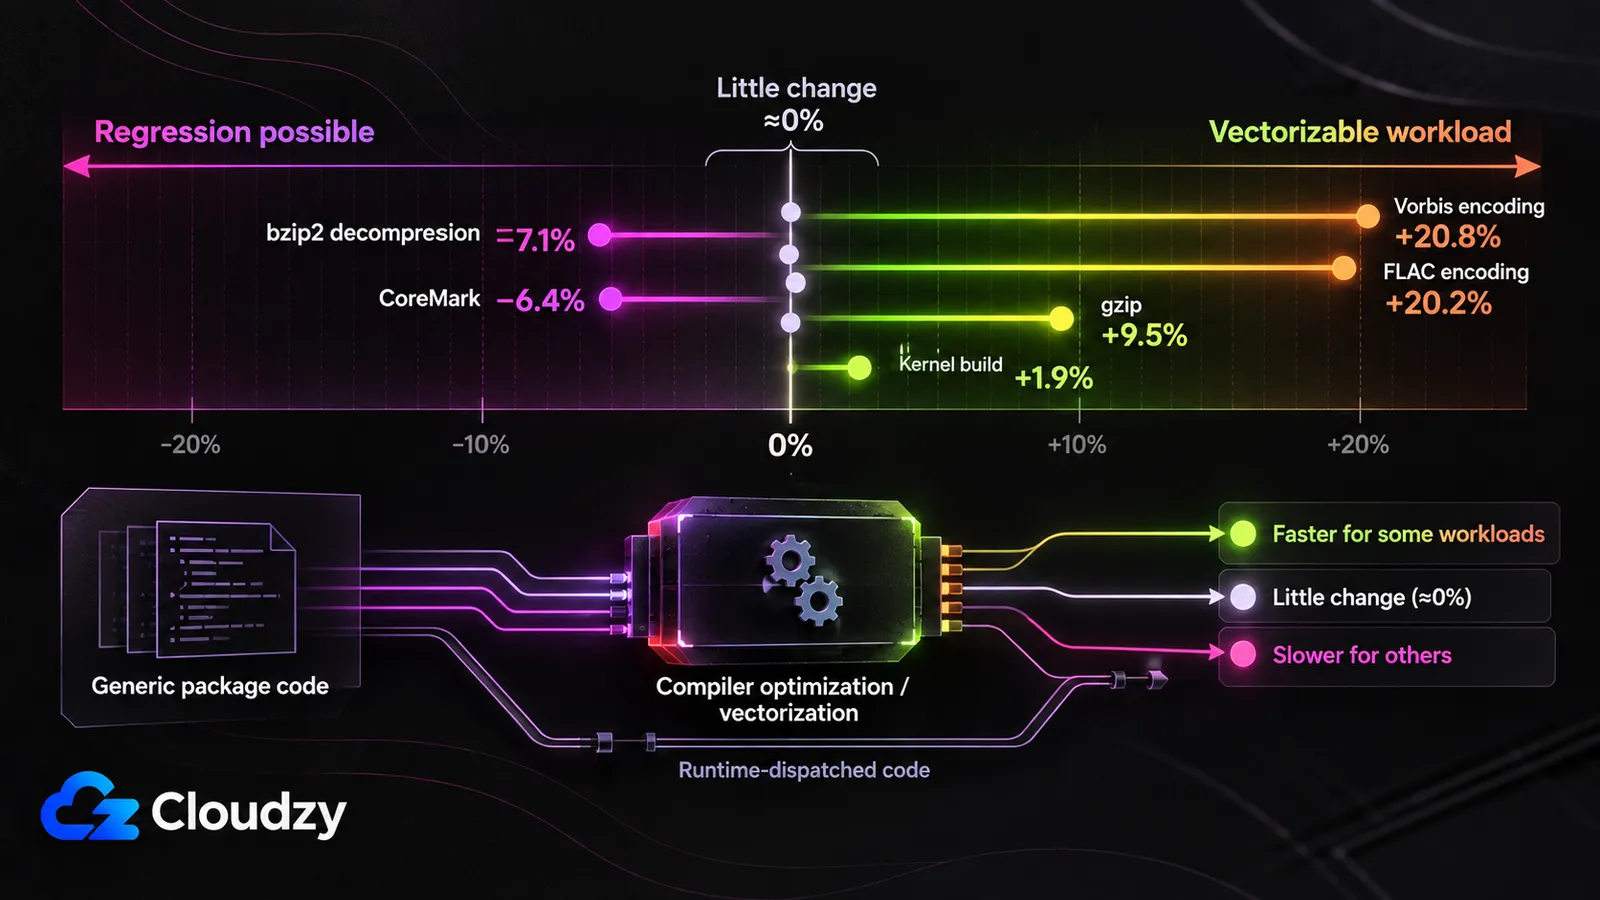
Да, для меньшей части того, что выполняет рабочий стол, и величину задаёт нагрузка, а не дистрибутив. Векторизуемая работа получает двузначный выигрыш, горстка пакетов становится медленнее, а большинство не показывает ничего. Страница оптимизированных репозиториев CachyOS оценивает прирост x86-64-v3 в 5–20 % относительно обычного x86-64; опубликованные измерения в основном лежат у нижней границы.
Самое чистое сравнение производительности CachyOS и Arch изолирует переменную пакетов и ничего больше: тест в arch-chroot от января 2023 года на sunnyflunk.github.io. Хост работал на стандартном Arch на Intel NUC8i5BEK, оба набора пакетов тестировались внутри arch-chroot, чтобы ядро и окружение оставались идентичными, а бенчмарки выполнялись в ОЗУ, чтобы исключить задержки диска. По сравнению со стандартными пакетами Arch сборки CachyOS были на 20,2 % быстрее при кодировании flac с -8, на 20,8 % быстрее при кодировании vorbis и на 9,5 % быстрее на gzip -3. В том же прогоне они были на 7,1 % медленнее при распаковке bzip2, на 1,6–2,9 % медленнее при сжатии lz4, на 3 % медленнее на pybench и без изменений на бенчмарке R. Две оговорки исходят от самого автора: CachyOS собирал с -march=x86-64-v3 -mpclmul -O3 против -march=x86-64 -O2у Arch, а его последующие тесты показали, что -O3 , а не уровень набора инструкций, объясняет часть крупнейших выигрышей. Заметка написана до появления репозитория Zen 4 у CachyOS, вышедшего с релизом июля 2024 года, но не до работы с BOLT: автор считает, что пакет Python CachyOS, стоящий за регрессией pybench, уже нёс BOLT поверх x86-64-v3.
Бенчмарки CachyOS на более новом железе повторяют картину. Сравнение от июля 2024 года на mvermeulen.org прогнало часть Phoronix Test Suite на Ryzen 7940HS (Zen 4): CachyOS с репозиторием Zen 4 против Ubuntu 22.04. Большинство результатов уложилось в несколько процентов в ту или другую сторону: coremark на 6,4 % медленнее, подтесты OpenSSL от примерно 1 % медленнее до 4 % быстрее, время сборки ядра на 1,9 % быстрее, phpbench как выброс с результатом чуть больше чем вдвое выше. Автор отмечает расхождение версий GCC, 14.1 против 11.4 у Ubuntu, как вероятный искажающий фактор. Его отдельный прогон NAMD в марте 2024 года показал улучшения на 6,5 % и 5,8 % на двух задачах молекулярной динамики.
Институциональные тесты нашли ту же смешанную картину — с обоих краёв. Собственное тестирование x86-64-v3 от Canonical, опубликованное в марте 2024 года на экспериментальном образе Ubuntu 23.10 в Azure, сообщило о воспроизводимом выигрыше до 60 % в бенчмарке glibc Log2, тогда как другие бенчмарки заметно просели, в одном случае потому, что включение v3 на уже оптимизированном SSE-коде заставило компилятор развернуть его в 17 раз больше инструкций. Пересборка CentOS Stream 9 силами CentOS ISA SIG с v2 на v3, на машинах Intel класса Ice Lake в августе 2023 года, назвала результаты «довольно смешанными»: ускорение в 2,2 раза сосредоточилось в Mocassin и md5crypt из John the Ripper, оба сильно векторизуемые, хотя выигрыш Mocassin команда приписала в основном автовекторизации GCC 12, а не уровню ISA.
Многие критичные к производительности математические и криптографические библиотеки поставляют несколько версий горячих функций и выбирают одну во время выполнения по определению возможностей CPU — техника называется мультиверсионированием функций и реализована в glibc через резолверы IFUNC. Это значит, что часть горячих путей уже может использовать AVX2 на стандартной установке Arch без пересборки всего пакета. Заметка sunnyflunk увидела это напрямую, отметив, что исходники flac уже содержат AVX2-функции времени выполнения, которым не нужен -march , чтобы включиться. Находка CentOS — зеркальное отражение: команда обнаружила математические функции glibc без версий IFUNC, и именно там у статической пересборки есть простор помочь. Пересборка под v3 достаёт оставшийся код, который автовекторизатор компилятора способен улучшить сам, — а это лишь ломтик рабочего стола, и небольшой.
Форма нагрузки, а не ярлык на процессоре, решает, проявится ли изменение на уровне машины вообще. Вердикт по пропускной способности — да, но с ограничениями: однозначные изменения обычны в приведённых измерениях, более крупные выигрыши группируются вокруг векторизуемых нагрузок вроде кодирования и сжатия, а некоторые пакеты регрессируют. Это более точное описание, чем считать x86-64-v3 общесистемным множителем скорости.
Что меняет планировщик и почему средний FPS этого не видит
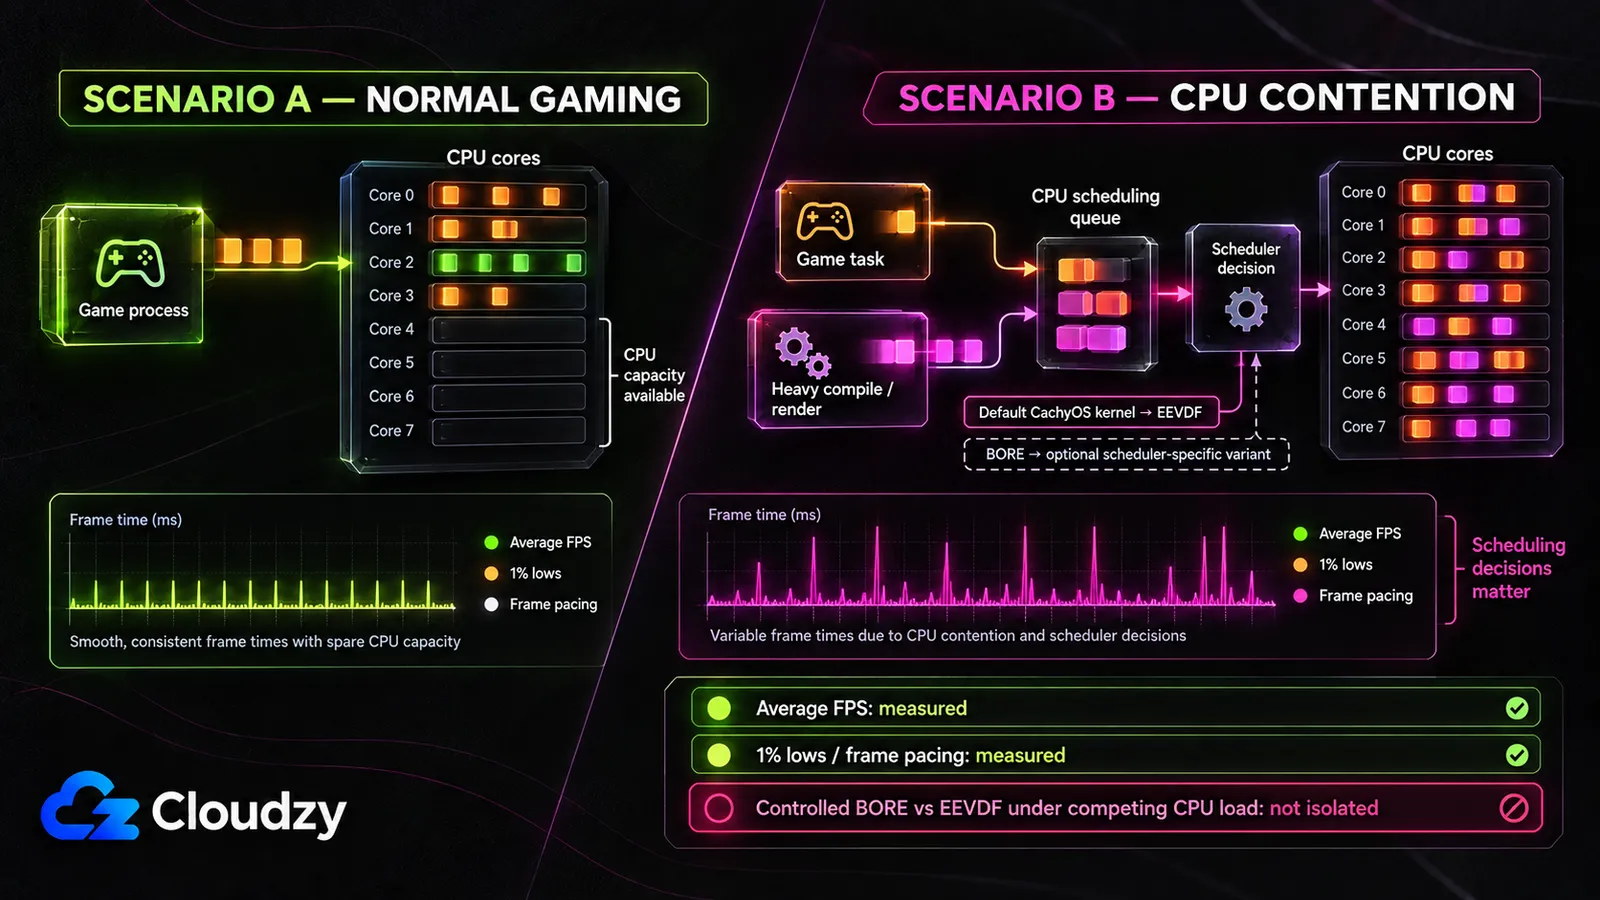
Текущее ядро CachyOS по умолчанию, linux-cachyos , использует EEVDF, а BORE доступен через варианты под конкретный планировщик, такие как linux-cachyos-bore. Это различие важно, потому что игровые сравнения ниже — тесты на уровне дистрибутива, а не контролируемые тесты BORE против EEVDF. BORE по-прежнему имеет отношение к более широкому утверждению о производительности, потому что его дизайн явно нацелен на отзывчивость при смешанных нагрузках, но это утверждение нужно оценивать отдельно от игровой производительности CachyOS «из коробки».
README самого BORE прямо формулирует замысел:
Для этого BORE вводит для каждой отдельной задачи измерение гибкости, известное как «burstiness», частично отходя от присущего CFS принципа «полной справедливости».
firelzrd/bore-scheduler, README проекта
Burstiness — это процессорное время, накопленное задачей с момента, когда она в последний раз отдала CPU, уснув, ожидая ввода-вывода или уступив его. BORE превращает его в оценку и использует её, чтобы корректировать вес каждой задачи и агрессивность её вытеснения при пробуждении, так что задачи, которые постоянно уступают CPU, считаются интерактивными и получают преимущество перед задачами, выбирающими свой квант целиком. README сам называет компромисс: BORE приходит к «равновесию между противостоящими жадными и слабыми задачами (обычно пакетными, ограниченными CPU) и скромными и сильными задачами (обычно интерактивными, ограниченными вводом-выводом)». Повысить вес интерактивной работы — та же операция, что понизить вес пакетной работы на пропускную способность.
Это подсказывает, какой инструмент выявил бы конкретное утверждение BORE: ввести конкурирующую нагрузку на CPU и измерять процентили времени кадра или задержку ввода, меняя только планировщик. Планировщику почти нечего разруливать, когда игра работает при свободных ресурсах CPU.
Бенчмарк пяти игр , опубликованный 16 мая 2026 года, использовал чистые установки CachyOS и Omarchy на одном SSD и одном железе, RTX 5060 Ti и Ryzen 9, с одной и той же сборкой Proton-GE и настройками 1440p. Средний FPS отличался лишь на один-два кадра. Двумя днями позже тот же тестировщик опубликовал второе сравнение с полным логированием кадров через MangoHUD, добавив 5 % и 1 % худших кадров и разброс равномерности кадров. Второй тест выполнялся на другом железе, Intel i7-13700 и Radeon RX 9060 XT, так что это дополнительное свидетельство о стабильности кадров, а не продолжение первого теста на том же железе. Ни одно из сравнений не изолирует планировщик CPU и не добавляет намеренную конкурирующую нагрузку на CPU.
Сам проект тоже не преувеличивает. В треде r/cachyos об игровой производительности, Peter Jung, один из разработчиков-основателей CachyOS, ответил пользователю напрямую: «In gaming not all too much. The newer feature can make a difference tough :)» (в играх не так уж и сильно, хотя новая функция может дать разницу).
Остаются два отдельных вывода. Для игр на CachyOS «из коробки» опубликованные тесты показывают небольшой разрыв по среднему FPS и теперь включают измерения 1 % худших кадров и равномерности кадров. Для BORE конкретно под намеренной конкуренцией за CPU я не смог найти опубликованный контролируемый тест, который меняет только планировщик и измеряет отзывчивость под такой нагрузкой.
Почему переезд кажется быстрее, даже когда ничего не измеряется быстрее
Два механизма дают более шуструю машину после смены дистрибутива без участия каких-либо оптимизаций CachyOS: сама свежая установка и случайное исправление несвязанной проблемы, которая была у прежней системы. Оба достаточно конкретны, чтобы распознать их в своём случае, — и именно это отличает их от огульного обвинения в эффекте плацебо.
Начнём со свежей установки. В треде r/linuxquestions на эту темупользователь CachyOS, который, по его словам, сам разницы не заметил, предположил, что люди, сообщающие о большом выигрыше, возможно, сравнивают с изрядно поработавшей установкой, а не со свежей. Годы накопленных записей автозапуска, осиротевшие службы, разъехавшаяся конфигурация и забитый диск — это нагрузка, и чистый раздел убирает всё это разом. Смена дистрибутива одновременно меняет ядро, окружение рабочего стола, версию каждого пакета и каждую настройку по умолчанию, а полное сравнение Manjaro и Ubuntu растягивается на дюжину отдельных осей. Приписать улучшение одной из них задним числом — гадание.
Случайное исправление — случай более острый. В том же треде комментатор описал, как ежедневно пользовался Fedora с проблемой управления VRAM, которая сильно снижала производительность, перешёл на CachyOS и увидел, что проблема исчезла. Затем он перешёл на чистый Arch и сообщил практически о той же производительности, что и на CachyOS, заключив, что больше не понимает, в чём была разница. Улучшение было реальным; цели компиляции CachyOS были здесь ни при чём.
Ничто из этого не даёт права на чистое разоблачение, и самое сильное свидетельство против него — контролируемый тест. Сравнение дистрибутивов на Arrow Lake от Phoronix поставило Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux и CachyOS на один Intel Core Ultra 9 285K в состоянии по умолчанию, и CachyOS немного обошёл всех, включая Clear Linux, который обычно лидирует на кремнии Intel. У Arrow Lake нет поддержки AVX-512, так что это преимущество не может исходить от x86-64-v4; оно отражает некую комбинацию решений CachyOS по ядру и сборке, оптимизаций пакетов и конфигурации по умолчанию.
Опыт может быть настоящим, пока атрибуция остаётся неопределённой. Сравнение Phoronix на Arrow Lake — полезный контрпример: установка CachyOS в состоянии по умолчанию может обойти стандартный Arch даже тогда, когда x86-64-v4 недоступен.
Как проверить, касается ли что-то из этого вашей машины
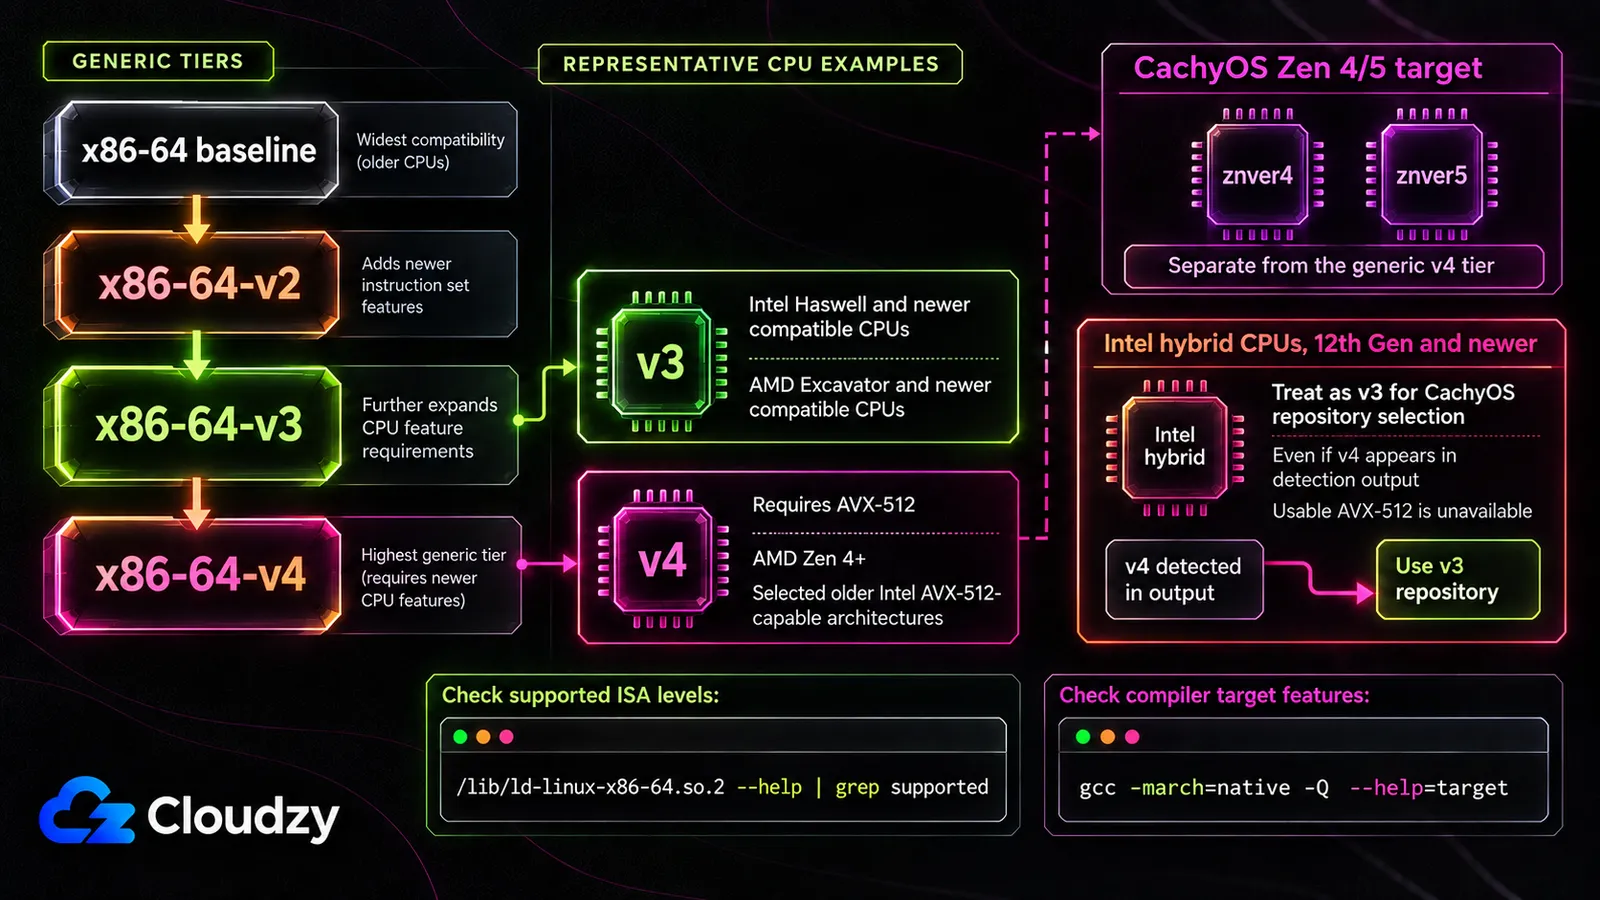
Какой стандартизированный уровень микроархитектуры x86-64 поддерживает ваш процессор, почти полностью выясняется одной командой. Динамический компоновщик сообщает уровни glibc-hwcaps, которые он может использовать, так что самая высокая поддерживаемая запись x86-64-vN обычно говорит, подходит ли CPU для общего яруса репозитория v2, v3 или v4. Одно важное исключение — гибридные процессоры Intel 12-го поколения и новее: CachyOS предписывает считать их v3, даже если в выводе появляется v4, потому что AVX-512 там непригоден. Отдельная цель CachyOS Zen 4/5 тоже требует собственной проверки архитектуры.
/lib/ld-linux-x86-64.so.2 --help | grep supportedДля AMD Zen 4/5 CachyOS также документирует:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Первая команда выводит примерно следующее:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Это процессор с v3 и v2, но без AVX-512. Три исхода, три решения:
- Ничего выше x86-64-v2. Преимущество пересборок под v3/v4/Zen к этому процессору не относится. CachyOS всё равно может работать, а оптимизации компилятора для отдельных пакетов вместе с изменениями ядра и конфигурации по умолчанию всё ещё могут иметь значение.
- x86-64-v3 поддерживается, x86-64-v4 недоступен. Сюда для практического выбора репозитория относятся современные гибридные процессоры Intel вроде Arrow Lake. В приведённых выше сравнениях многие изменения были небольшими, некоторые нагрузки кодирования и сжатия выиграли гораздо больше, а некоторые пакеты регрессировали.
- x86-64-v4 поддерживается. AVX-512 даёт больше теоретического запаса для векторизуемых нагрузок, но не гарантирует большого общесистемного выигрыша.
Если ваш процессор подходит и вам нужна только пакетная половина, переустанавливаться ради неё не нужно. Репозитории CachyOS можно добавить к существующей системе Arch, а ALHP публикует пересборки официальных репозиториев Arch для каждого уровня x86-64-vN, задокументированные в Arch Wiki со своими оговорками: вместо напрямую слинкованных модулей ядра требуются пакеты DKMS, а установка -march для компиляции ядра «не даст сколько-нибудь значимых результатов». Любой из путей даёт вам перекомпилированные пакеты и ничего из набора патчей ядра или вариантов планировщика.
Сначала выполните команду. Она превращает спор о дистрибутивах в факт о вашей собственной машине — единственную версию этого вопроса, которую вы можете закрыть сами уже сегодня вечером.

Разрабатывайте на Linux VPS с root-доступом, NVMe и мощью AMD EPYC.
Посмотреть тарифы LinuxЧасто задаваемые вопросы
Действительно ли CachyOS улучшает производительность в играх?
По средней частоте кадров — едва. Сравнение пяти игр в мае 2026 года нашло лишь разницу в один-два кадра, а повторный тест двумя днями позже также измерил 1 % худших кадров и равномерность кадров. Ни один из тестов не вводил намеренную конкурирующую нагрузку на CPU, так что нерешённый вопрос — отзывчивость планировщика под конкуренцией, а не то, измерялась ли равномерность кадров вообще.
Поддерживает ли мой процессор x86-64-v3 или v4?
На CachyOS или Arch выполните /lib/ld-linux-x86-64.so.2 --help | grep supported , чтобы увидеть стандартизированные уровни glibc-hwcaps, определённые для вашего процессора. x86-64-v3 требует набора возможностей эпохи AVX/AVX2, а v4 добавляет AVX-512. Для гибридных процессоров Intel 12-го поколения и новее CachyOS рекомендует считать систему v3, даже если в выводе появляется v4; пользователям Zen 4/5 стоит также проверить отдельную цель znver4/znver5.
Почему перекомпилированные пакеты не дают большей разницы?
Потому что часть сильно оптимизированного кода уже во время выполнения направляется к реализациям под конкретный процессор. Математические и криптографические библиотеки часто используют мультиверсионирование функций или IFUNC для горячих функций, поэтому пересборка пакетов помогает в основном коду, который компилятор способен дополнительно оптимизировать или векторизовать глобально.
Могу ли я получить оптимизированные пакеты CachyOS, не меняя дистрибутив?
Да. Репозитории CachyOS можно добавить к существующей установке Arch Linux, а проект ALHP публикует пересборки официальных репозиториев Arch под x86-64-v2, v3 и v4, задокументированные в Arch Wiki. Оба варианта дают только перекомпилированные пакеты, а не набор патчей ядра CachyOS, альтернативные планировщики или настройки установщика по умолчанию.
Обсуждение
Комментарии
Войдите, чтобы присоединиться к обсуждению.