

สิ่งที่คุณสร้างขึ้นกำลังทำงานอยู่บนโปรดักชัน การมอนิเตอร์ของคุณไม่มีอะไรเลยหรือมีแค่การ ping เช็กว่าเว็บยังอยู่ และเมื่อสัปดาห์ก่อนคุณรู้ว่าระบบล่มจากผู้ใช้ ทุกคำตอบที่คุณไปตามหาล้วนชี้ไปที่ชื่อเดียวกัน
รีวิว Prometheus ชิ้นนี้ว่าด้วยช่องว่างระหว่างสองเรื่องที่จริงทั้งคู่ มันฟรีและเป็นโอเพนซอร์ส ไม่มีค่าไลเซนส์และไม่มีบิลต่อเมตริกไม่ว่าจะสเกลไหน ขณะเดียวกันมันก็กินเวลาคุณไปหนึ่งค่ำคืน บวกกับภาษาคิวรีที่คุณยังไม่รู้จัก มันคือตัวเก็บเมตริกแบบ pull ที่มีระบบแจ้งเตือนติดมาด้วย และเป็นซอฟต์แวร์ที่ดีเยี่ยม ส่วนคำถามว่ามันเป็นซอฟต์แวร์ที่ใช่สำหรับระบบที่คุณดูแลอยู่ตอนนี้หรือเปล่า เป็นคนละคำถาม และนั่นคือคำถามที่ควรค่าแก่การตอบ
เวอร์ชันสั้น
- คำตัดสิน: 3.5 / 5 สำหรับการโฮสต์เองของคนเดียวและทีมเล็ก Prometheus คุ้มที่จะรันถ้าชุดโฮสต์และเซอร์วิสของคุณค่อนข้างนิ่ง คุณยอมลงเวลาเรียน PromQL และคุณอยากได้เมตริกที่เป็นของคุณเต็ม ๆ โดยไม่มีค่าสมาชิกและไม่มีบิลค่าเก็บย้อนหลัง
- ข้ามไปเลยถ้าคำถามที่คุณต้องการคำตอบคือ “มันยังทำงานอยู่ไหม” เครื่องมือเช็กสถานะพาคุณไปถึงคำตอบนั้นได้เร็วกว่ามาก และการหยิบ Prometheus มาทำงานนี้ก็เท่ากับจ่ายค่าภาษาคิวรีเพื่อตอบสิ่งที่คุณตอบได้ในสิบนาที
- PromQL คือต้นทุนที่วนกลับมาเรื่อย ๆ การติดตั้งเป็นต้นทุนครั้งเดียว แต่ทันทีที่คำถามของคุณโตเกินแดชบอร์ดสำเร็จรูปและตัวสร้างคิวรีแบบภาพของ Grafana คุณก็กลับเข้า PromQL อีกครั้ง
- ต้นทุนดูแลรักษาแปรผันตามสัดส่วนของระบบที่คุณจัดการด้วยมือ ฟลีตที่คงรูปเดิมไว้นั้นมอนิเตอร์ได้ถูก ส่วนฟลีตที่เพิ่มโฮสต์ ลดโฮสต์ และเปลี่ยนชื่อโฮสต์ไปเรื่อย ๆ คือจุดที่ต้นทุนค่อย ๆ สะสมอย่างเงียบ ๆ
- คำตัดสินนี้จำกัดอยู่ที่การโฮสต์เองในสเกลเล็กเท่านั้น ในสเกลของ Kubernetes และงาน SRE ระดับโปรดักชัน Prometheus เป็นข้อเสนอคนละแบบ และรีวิวนี้ไม่ได้พยายามตอบคำถามนั้น
รีวิวนี้ทำขึ้นอย่างไร: Prometheus ฟรีและเป็นโอเพนซอร์ส จึงไม่มีความสัมพันธ์กับผู้ขายรายใดในที่นี้ และไม่มีใครส่งอะไรมาให้ผม ข้อมูลเรื่องเวอร์ชันและพฤติกรรมของสตอเรจมาจากเอกสารทางการของ Prometheus เอง ส่วนตัวเลขการใช้ทรัพยากรและเวลาติดตั้งมาจากการทดสอบภาคปฏิบัติสองชิ้นที่เผยแพร่แยกกัน โดยให้เครดิตไว้ตรงจุดที่หยิบมาใช้ ตรงไหนที่ทั้งสองชิ้นไม่ตรงกัน คุณจะเห็นตัวเลขทั้งคู่แทนที่จะเป็นค่าเฉลี่ย
รีวิวนี้ครอบคลุมอะไรบ้าง
คำตัดสินข้างต้นมีขอบเขต และขอบเขตนั้นสำคัญกว่าปกติในกรณีนี้ เพราะ Prometheus ทำตัวเหมือนเครื่องมือคนละตัวเมื่อสเกลต่างกัน
- เป็นการประเมิน Prometheus สำหรับการโฮสต์เองบน VPS เครื่องเดียวและโปรเจกต์เล็ก ๆ นั่นคือโฮสต์และเซอร์วิสไม่กี่ตัว กับคนดูแลเพียงคนเดียว
- ไม่ใช่ Kubernetes ทั้ง Prometheus Operator, ServiceMonitors และ kube-prometheus-stack เป็นโลกปฏิบัติการอีกใบหนึ่ง และคำตัดสินตรงนี้ไม่ได้พูดถึงโลกใบนั้นเลย
- ไม่ใช่คู่มือการจัดเส้นทางของ Alertmanager ระบบแจ้งเตือนมีอยู่และทำงานได้ดี แต่การตั้งค่า route, silence และ receiver เป็นเรื่องของมันเอง
- ไม่ใช่คู่มือติดตั้งทีละขั้น คำถามตรงนี้คือควรรันมันหรือเปล่าตั้งแต่แรก ถ้าคุณตอบคำถามนั้นไปแล้ว คู่มือ Grafana และ Prometheus ด้วย Docker Compose ของเรา อธิบายขั้นตอนไว้ครบ
- ไม่ใช่การสำรวจ exporter ทั้งหมด exporter จะถูกพูดถึงเฉพาะตรงที่มันเปลี่ยนคำตอบเท่านั้น
สิ่งที่ Prometheus ทำได้ดี
Prometheus ไม่มีค่าใช้จ่ายเลย ไม่ใช่ “แพลนฟรีที่มีอัปเกรดแบบเสียเงิน” และไม่ใช่ “ฟรีจนกว่าจะเกินโควตาเมตริก” ที่เก็บโค้ดใช้สัญญาอนุญาต Apache 2.0 ตลอดทั้งโปรเจกต์ ไม่มีรุ่นเสียเงินของโปรเจกต์หลัก และไม่มีการคิดเงินต่อโฮสต์ ต่อเมตริก หรือต่อเลเบลอยู่ที่ไหนเลย บิลเดียวที่ Prometheus สร้างขึ้นคือเซิร์ฟเวอร์ที่มันรันอยู่
สำหรับสิ่งที่คุณวางแผนจะพึ่งพา คำถามว่า “อีกสามปีมันจะยังอยู่ไหม” เป็นคำถามที่สมเหตุสมผล และในกรณีนี้โอกาสก็ดีเท่าที่โอเพนซอร์สจะเป็นได้ Prometheus จบการบ่มเพาะจาก CNCF ในเดือนสิงหาคม 2018 โดยเป็นโปรเจกต์ที่สองในประวัติศาสตร์ที่ทำได้ ถัดจาก Kubernetes การออกเวอร์ชันก็สม่ำเสมอ โดย v3.13.2 ออกเมื่อปลายเดือนกรกฎาคม 2026 และเพราะสายเวอร์ชันนั้นเป็นสายที่รองรับระยะยาว มันจึงได้รับ การแก้บั๊ก แก้ช่องโหว่ความปลอดภัย และแก้เอกสาร ต่อเนื่องเป็นเวลาหนึ่งปี การอัปเดตแพตช์จึงไม่ได้แปลว่าต้องวิ่งไล่ทุกเวอร์ชันย่อย
โมเดลข้อมูลคือเหตุผลที่ระบบนิเวศรอบตัวมันลึกขนาดนี้ Prometheus ดึงเมตริกผ่าน HTTP และระบุแต่ละซีรีส์ด้วยชื่อเมตริกบวกเลเบลแบบคีย์/ค่า ซึ่งทำให้การเขียน exporter เป็นงานเล็ก ๆ ดังนั้นจึงมี exporter สำหรับแทบทุกอย่างที่คุณน่าจะรัน ทั้งเมตริกของเครื่อง, Postgres, Nginx, Redis และ blackbox probe สำหรับสิ่งที่ตรวจได้จากภายนอกเท่านั้น
และคุณเป็นเจ้าของสิ่งที่มันเก็บ ซึ่งเป็นส่วนที่มักจะสำคัญในภายหลังมากกว่าวันแรก ประวัติของระบบเล็ก ๆ กินพื้นที่ดิสก์น้อยจนไม่ต้องพูดถึง (ตัวเลขอยู่ด้านล่าง) ไม่มีใครมาตั้งราคาใหม่กับคุณได้ในไตรมาสหน้า และไม่มีรายการในบิลที่โตขึ้นทุกครั้งที่มีคนเพิ่มการเก็บเมตริกในแอป ถ้าคุณเคยเห็นบิลบริการมอนิเตอร์แบบจัดการให้ไต่ขึ้นเพราะนักพัฒนาเพิ่มเลเบลไปหนึ่งตัว เหตุผลทั้งหมดก็อยู่ในประโยคนั้นแล้ว
จุดที่ Prometheus แพงกว่าที่ตาเห็น
การทดสอบบน dev.to ที่ลองเครื่องมือมอนิเตอร์เจ็ดตัวบน VPS ขนาดเล็กเครื่องเดียว วัดได้ว่า Prometheus เพียงลำพังใช้เวลาติดตั้ง 15 นาที จับคู่มันกับ Grafana เหมือนที่ผู้ทดสอบคนนั้นทำ เพราะตัว expression browser ที่ติดมาด้วยเป็นแค่ที่ไว้รันคิวรีเท่านั้น การทดสอบเดียวกันให้ Grafana + Prometheus อยู่ที่ 35 นาทีกว่าจะได้กราฟแรก โดยมีการตั้งค่า scrape แบบ YAML คั่นอยู่ตรงกลาง
นาทีเหล่านั้นคือส่วนที่ถูก ส่วนที่แพงคือ PromQL Prometheus เก็บทุกอย่างเป็นไทม์ซีรีส์ที่ระบุด้วยชื่อและเลเบล และ PromQL ก็ยังเป็นภาษาที่อยู่ใต้คำถามทุกข้อที่คุณถามมัน ตอนนี้ Grafana มีตัวสร้างคิวรีแบบภาพแล้ว คุณจึงไม่ต้องเขียนทุกคิวรีด้วยมือ คำตัดสินของผู้ทดสอบเองนั้นตรงไปตรงมา PromQL ยอดเยี่ยมสำหรับคนที่ใช้ชีวิตอยู่กับมัน และเขาไม่ใช่คนแบบนั้น ถ้าคุณไม่เคยใช้ภาษาคิวรีมาก่อน เผื่อเวลาไว้มากกว่าหนึ่งค่ำคืน และเตรียมใจว่าจะต้องกลับมาหามันทุกครั้งที่ตัวสร้างแบบภาพเอาไม่อยู่ แดชบอร์ดที่คุณก๊อปมาจากคนอื่นตอบคำถามของคนคนนั้น ส่วนคำถามของคุณคือคิวรีที่คุณยังไม่ได้เขียน
ต้นทุนก้อนที่สามคือก้อนที่ไม่โผล่มาจนกว่าจะผ่านไปสักพัก บันทึกสามสัปดาห์ของผู้ดูแลระบบรายหนึ่ง เล่าไว้อย่างชัดเจนว่าการเพิ่มเซิร์ฟเวอร์แค่เครื่องเดียวเข้าไปในระบบเจ็ดโหนดต้องทำอะไรบ้าง ทั้งการตั้งเลเบลใหม่ ตรวจไฟล์ตั้งค่า scrape ซ้ำ แก้ตัวแปรของแดชบอร์ด และรื้อคิวรีในเทมเพลตเพื่อให้โฮสต์ใหม่โผล่ในดรอปดาวน์ ผู้ดูแลคนนั้นเลิกใช้สแตกนี้หลังผ่านไปสามสัปดาห์ โดยสรุปว่าตัวเองใช้เวลาไปกับการปรับแดชบอร์ดมากกว่าการเฝ้าดูอินฟราจริง ๆ
สังเกตว่าต้นทุนก้อนนั้นผูกอยู่กับอะไรในระบบแบบนี้ นั่นคือ target และแดชบอร์ดที่จัดการด้วยมือ การรัน Prometheus ไปสองปีอย่างสงบแทบไม่มีค่าใช้จ่ายเพิ่มเลย
จริง ๆ แล้ว Prometheus ต้องการ RAM และดิสก์เท่าไหร่
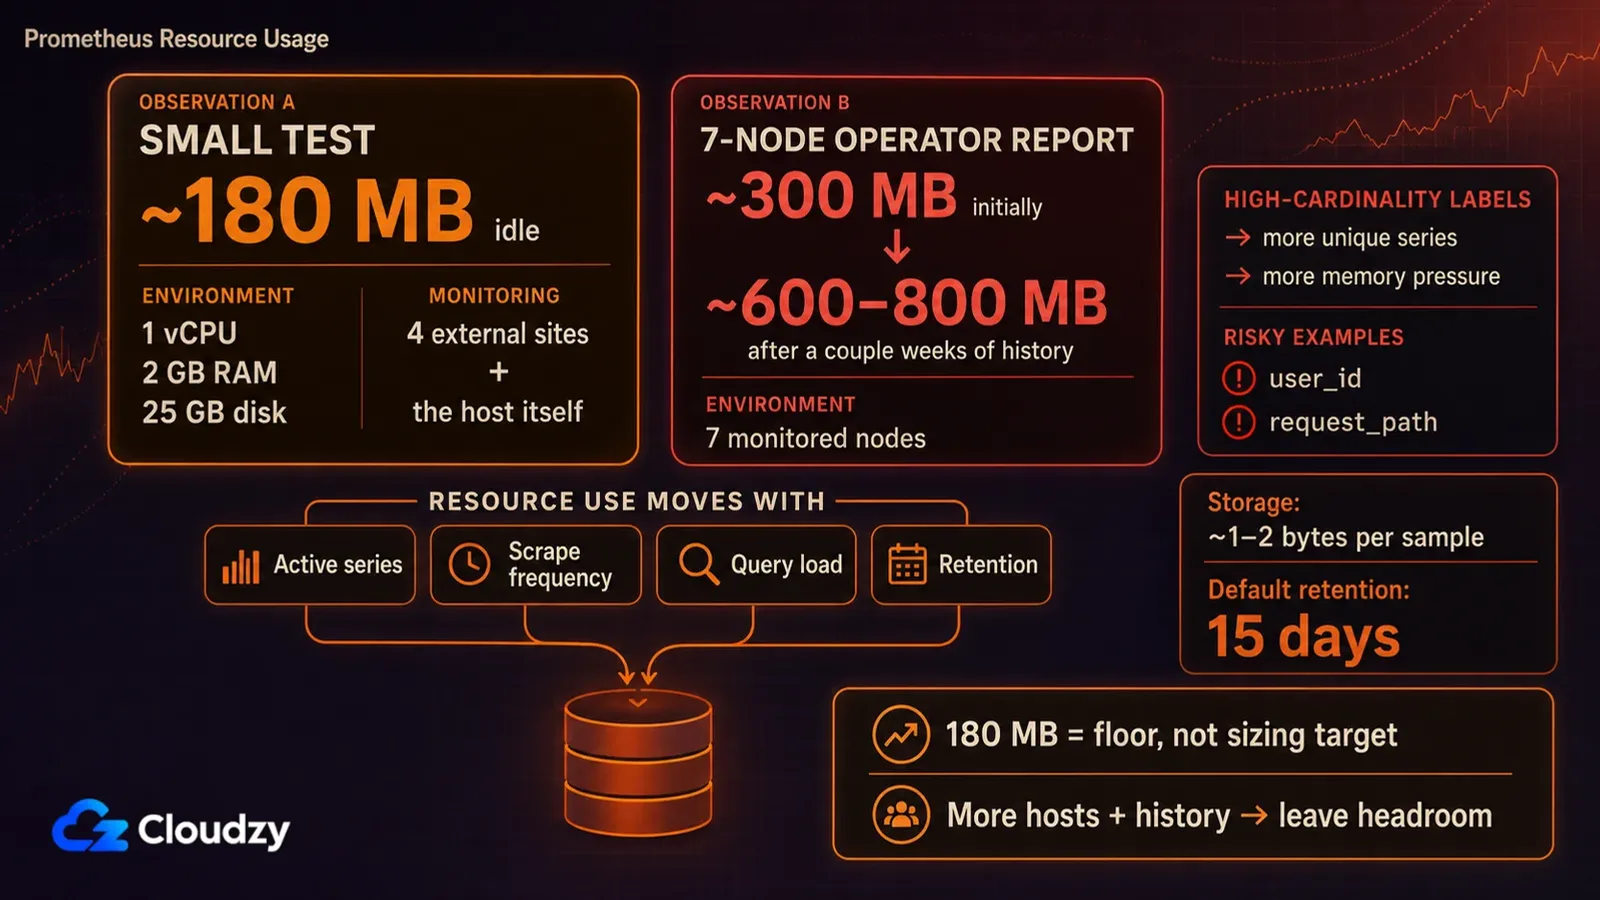
ไม่มีข้อกำหนดตายตัว จำนวนซีรีส์ที่ใช้งาน ความถี่ในการดึงข้อมูล ภาระการคิวรี และระยะเก็บข้อมูล ล้วนสำคัญกว่าจำนวนเซิร์ฟเวอร์ที่คุณชี้ให้มันดู การทดสอบภาคปฏิบัติที่เผยแพร่แล้วสองชิ้นบนระบบเล็ก ๆ ให้ตัวเลขอยู่ราว 180 MB ถึง 800 MB โดยตัวเลขที่สูงกว่านั้นครอบคลุมเจ็ดโหนดพร้อมประวัติราวสองสัปดาห์
การทดสอบทั้งสองไม่ตรงกัน และความไม่ตรงกันนั่นแหละคือส่วนที่มีประโยชน์ การเปรียบเทียบเครื่องมือเจ็ดตัวบน VPS ชุดเดียวกันรันทุกตัวบนฮาร์ดแวร์เดียวกัน (1 vCPU, RAM 2 GB, ดิสก์ 25 GB, Ubuntu 24.04) ขณะเฝ้าดูเว็บไซต์ภายนอกสี่แห่งบวกตัวโฮสต์เอง และวัด Prometheus ได้ราว 180 MB ในสภาวะว่าง ส่วนผู้ดูแลคนเดิมรายงานว่า Prometheus เพียงลำพังนิ่งอยู่ราว 300 MB บนโฮสต์ศูนย์กลาง แล้วไต่ไปทาง 600 ถึง 800 MB เมื่อประวัติสะสมได้ราวสองสัปดาห์
ทั้งสองไม่ใช่การวัดแบบเดียวกัน และนั่นคือเหตุผลที่การเอามาเฉลี่ยกันเท่ากับทิ้งข้อมูลไปเปล่า ๆ อันหนึ่งคือค่าที่อ่านได้เกือบว่างบนเครื่องที่แทบไม่มีอะไรต้องเก็บ อีกอันคือระบบที่ใช้งานจริง มีฟลีตอยู่ข้างหลังและมีประวัติอยู่บนดิสก์ ผมอ่านแบบนี้ ให้ถือว่าตัวเลข 180 MB คือพื้น ไม่ใช่เป้าหมายในการจัดสเปก เมื่อไหร่ที่คุณเก็บจากหลายโฮสต์และเก็บประวัติไว้ ให้เผื่อไว้แทนที่จะวางแผนตามตัวเลขสภาวะว่างนั้น
ดิสก์คือครึ่งที่ง่าย เอกสารเรื่องสตอเรจของ Prometheus ให้ค่าเฉลี่ยไว้ที่ 1 ถึง 2 ไบต์ต่อหนึ่งตัวอย่าง การเก็บประวัติยาว ๆ สำหรับระบบเล็ก ๆ จึงถูกมาก จุดที่ต้องระวังคือค่าเริ่มต้น ระยะเก็บข้อมูลตั้งค่าเริ่มต้นไว้ที่ 15 วัน เว้นแต่คุณจะกำหนดระยะเวลาหรือขนาดของการเก็บข้อมูลเอง มันห่างจากการเป็นหนึ่งปีแค่แฟล็กตอนสตาร์ตอันเดียว และมันคือค่าเริ่มต้นชนิดที่คุณอยากรู้ตอนนี้มากกว่าจะไปรู้ตอนที่ไปหาตัวเลขของเดือนที่แล้วแล้วพบว่ามันหมดอายุไปตั้งแต่สามสัปดาห์ก่อน
สิ่งที่ดันตัวเลขหน่วยความจำให้สูงขึ้นคือคาร์ดินาลิตี นั่นคือจำนวนไทม์ซีรีส์ที่แตกต่างกัน โดยทุกชุดค่าผสมของเลเบลบนเมตริกหนึ่ง ๆ จะกลายเป็นซีรีส์ของตัวเอง เลเบลที่เลือกผิดเพียงตัวเดียวบนเมตริกที่มีทราฟฟิกสูงสามารถสร้างซีรีส์ได้มากกว่าการเพิ่มเซิร์ฟเวอร์ห้าเครื่องเสียอีก และมันทำแบบนั้นอย่างเงียบ ๆ ด้วยอัตราเท่ากับทราฟฟิกที่วิ่งอยู่ (รหัสผู้ใช้หรือ path ของ request ดูเหมือนเลเบลชั้นดี จนกระทั่งคุณลองนับว่ามันมีกี่ค่า)
ตัวเลข RAM ใด ๆ ที่คุณเห็นคนอ้างถึงเกี่ยวกับ Prometheus จะใช้ได้ก็ต่อเมื่อคุณรู้ด้วยว่ามีกี่ซีรีส์อยู่เบื้องหลังตัวเลขนั้น
เกิดอะไรขึ้นเมื่อเซิร์ฟเวอร์ Prometheus ของคุณล่ม
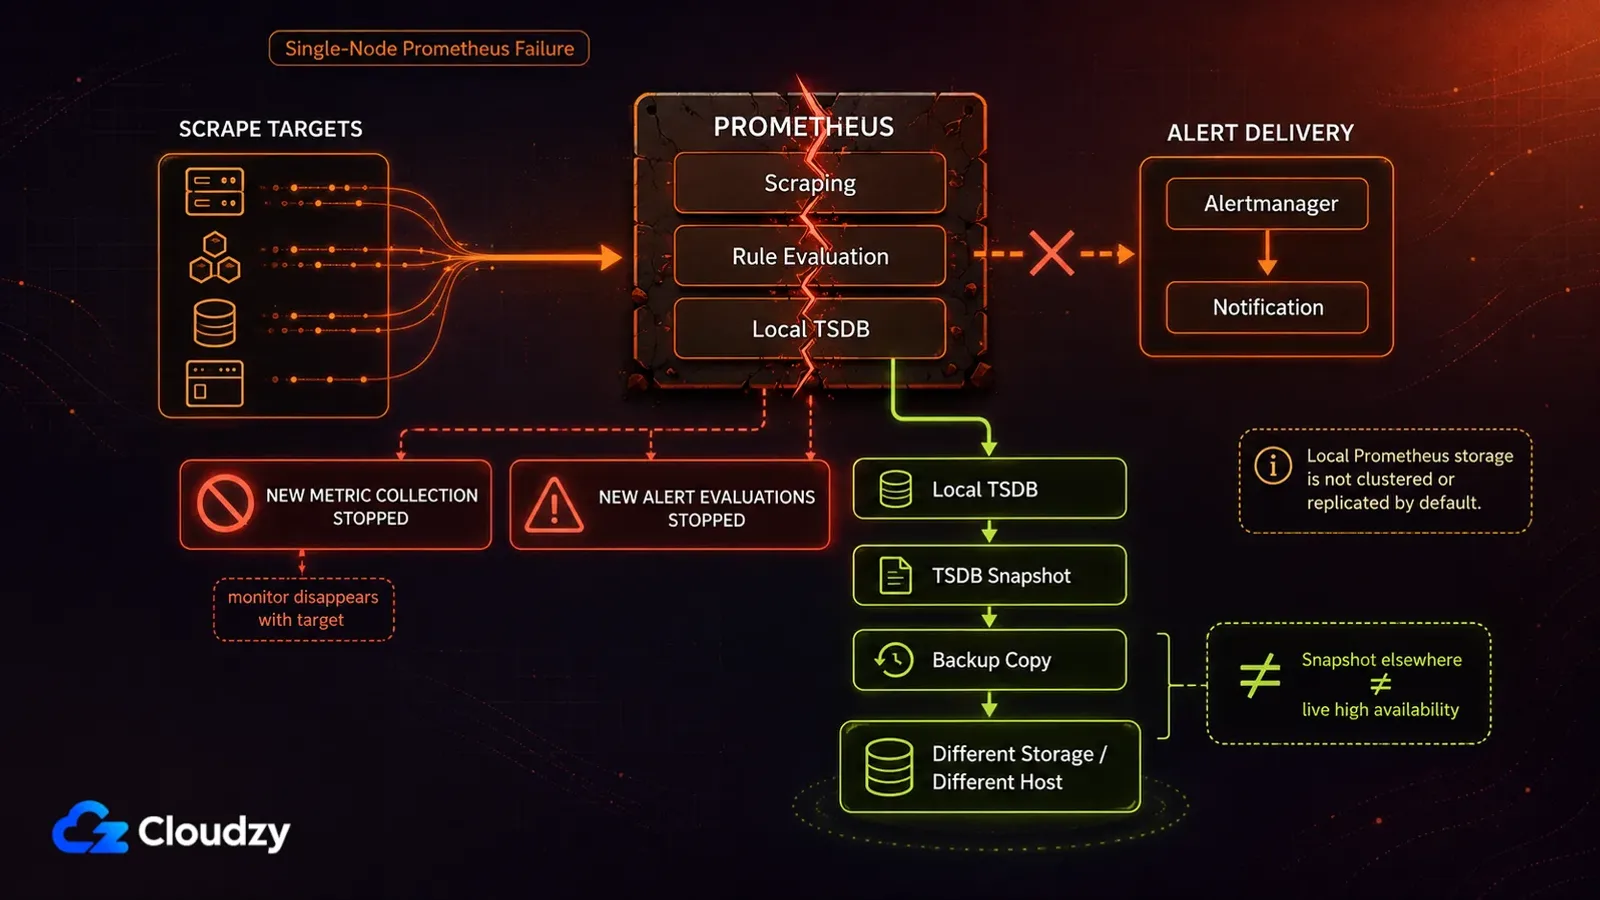
เอกสารเรื่องสตอเรจของ Prometheus เองพูดเรื่องนี้ตรง ๆ ว่าสตอเรจในเครื่อง ไม่ได้ทำคลัสเตอร์และไม่ได้ทำสำเนา จึงไม่ทนทานต่อความเสียหายของไดรฟ์หรือของโหนด เซิร์ฟเวอร์แต่ละตัวถูกออกแบบให้ยืนอยู่ลำพังและไม่พึ่งทั้งสตอเรจบนเครือข่ายและบริการระยะไกล ซึ่งเป็นสิ่งที่ทำให้มันรันง่าย และเป็นสิ่งเดียวกันที่ทำให้มันเปราะ
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
ยังมีขอบเขตข้อที่สองที่โปรเจกต์นี้ประกาศเกี่ยวกับตัวเอง และควรได้เครดิตที่กล้าประกาศ ถ้าคุณต้องการความแม่นยำ 100% เช่นสำหรับการคิดเงินต่อ request เอกสารบอกว่า Prometheus เป็นตัวเลือกที่ผิด เพราะข้อมูลที่มันเก็บน่าจะละเอียดและครบถ้วนไม่พอ ให้ใช้อย่างอื่นกับตัวเลขที่คุณเอาไปออกใบแจ้งหนี้ แล้วเก็บ Prometheus ไว้ทำมอนิเตอร์ ผู้ขายส่วนใหญ่ไม่ค่อยพูดเรื่องแบบนี้เกี่ยวกับตัวเองก่อน
ในสเกลที่ใหญ่กว่านี้มีคำตอบที่ลงตัวอยู่แล้ว แต่มันอยู่นอกขอบเขตตรงนี้ด้วยเหตุผลเดียวกับเครื่องมือฝั่ง Kubernetes นั่นคือมันเป็นภาระในการดูแลคนละระดับกับที่รีวิวนี้พูดถึง สำหรับ VPS เครื่องเดียว ผมอ่านว่าความเสี่ยงนี้ยอมรับได้ถ้าคุณเก็บสแนปช็อต TSDB ไว้ที่อื่น หรือยอมรับตั้งแต่ต้นว่าจะเสียประวัติไป และมันเป็นปัญหาจริงจังถ้า Prometheus เป็นสิ่งเดียวที่กั้นระหว่างคุณกับเหตุขัดข้องแบบเงียบ ๆ
ใครควรโฮสต์ Prometheus เอง
สัญญาณที่ชัดที่สุดว่า Prometheus จะคืนทุนที่คุณลงไปนั้นไม่เกี่ยวกับว่าคุณมีเซิร์ฟเวอร์กี่เครื่อง แต่เกี่ยวกับว่าอีกหกเดือนมันจะยังเป็นเซิร์ฟเวอร์ชุดเดิมหรือเปล่า ชุดโฮสต์ที่ตั้งค่าด้วยมือและนิ่งอยู่ตัว แปลว่าคุณเขียนคอนฟิกครั้งเดียวแล้วได้ประวัติมาฟรี ส่วนชุดที่เปลี่ยนไปเรื่อย ๆ แปลว่าคุณต้องกลับไปแตะคอนฟิกนั้นเรื่อย ๆ
ในระบบที่นิ่ง คอนฟิก Prometheus และ Grafana ของคุณคือคำอธิบายอินฟราของคุณอย่างชัดแจ้ง ทั้ง target ที่ดึงข้อมูล เลเบลที่ผูกกับมัน และแดชบอร์ดที่สร้างทับบนเลเบลเหล่านั้น นั่นคือเหตุผลที่ประวัติคือผลตอบแทนทั้งหมด ข้อมูลหนึ่งปีบนชุดโฮสต์ที่นิ่งจะบอกคุณว่าภาวะปกติหน้าตาเป็นอย่างไร ซึ่งเป็นวิธีที่เชื่อถือได้ที่สุดในการจับความผิดปกติก่อนที่มันจะกลายเป็นเหตุขัดข้อง
ดังนั้นโปรไฟล์แรกคือคนที่ดูแลเซิร์ฟเวอร์ชุดเล็กที่เปลี่ยนช้า และอยากได้มากกว่าแค่ว่ามันขึ้นหรือล่ม เช่น latency ของ request ตามเวลา แนวโน้มการใช้หน่วยความจำ หรือดิสก์ที่ค่อย ๆ เต็มช้าพอจะเห็นล่วงหน้าเป็นสัปดาห์ ถ้าคุณอธิบายอินฟราของตัวเองได้ในวันนี้ และคาดว่าคำอธิบายนั้นจะยังใช้ได้คร่าว ๆ ในอีกหนึ่งปี ค่ำคืนที่คุณเสียไปกับการติดตั้งก็คือบิลก้อนใหญ่ก้อนสุดท้าย
โปรไฟล์ที่สองคือใครก็ตามที่ตั้งใจเรียนสแตกนี้จริงจัง ถ้าคุณคิดว่าอีกไม่กี่ปีข้างหน้าคุณจะยังดูแลอินฟรา ไม่ว่าของตัวเองหรือของคนอื่น ค่ำคืนกับ PromQL คือสิ่งที่คุณมาเพื่อมันตั้งแต่ต้น ส่วนการมอนิเตอร์เป็นผลพลอยได้ โปรไฟล์นี้กลับด้านกับโปรไฟล์แรกอยู่บ้าง เพราะเงื่อนไขเรื่องความนิ่งสำคัญน้อยลงตรงนี้ ในเมื่อเวลาที่เสียไปกับการตั้งเลเบลใหม่ก็คือเวลาที่ใช้เรียนรู้ว่าการตั้งเลเบลใหม่คืออะไร สำหรับผู้อ่านกลุ่มนี้ผมจะให้คะแนนสูงขึ้น
โปรไฟล์ที่สามว่าด้วยความเป็นเจ้าของ และเป็นข้อที่คนมองข้ามจนกว่าจะเคยไปอยู่ผิดฝั่งมาก่อน Prometheus ไม่คิดเงินต่อโฮสต์ ต่อเมตริก หรือต่อเลเบล และไม่มีหน้าราคาไหนเปลี่ยนใต้เท้าคุณได้ในไตรมาสหน้า การแลกกับบริการแบบจัดการให้อย่าง Datadog เป็นแบบนี้ คุณยอมสละความเนียน สัญญาซัพพอร์ต และการเข้าเวรของคนอื่น แล้วได้เมตริกที่เป็นของคุณกลับมา บนบิลที่ไม่ขยับเวลานักพัฒนาเพิ่มการเก็บเมตริก ส่วนจะคุ้มหรือไม่ขึ้นอยู่กับว่าเวลาของคุณมีค่าเท่าไหร่ ซึ่งเป็นตัวเลขที่มีแต่คุณเท่านั้นที่ใส่ได้ (และมันแทบไม่เคยเป็นศูนย์ ต่อให้รู้สึกแบบนั้นก็ตาม)
มีอีกเรื่องที่ควรรู้ก่อนตัดสินใจผูกมัด การโตเกินสตอเรจในเครื่องของ Prometheus ไม่ใช่ทางตัน VictoriaMetrics รับ remote write จาก Prometheus ได้ และ MetricsQL ก็เข้ากันได้ย้อนหลังกับ PromQL ดังนั้นคิวรีและแดชบอร์ด Grafana ส่วนใหญ่ที่คุณสร้างตอนนี้น่าจะรอดจากการย้ายไปได้ นี่คือการย้ายระบบ ไม่ใช่การเขียนใหม่
เรื่องนี้ควรกลับมาทบทวนปีละครั้ง มากกว่าจะตัดสินครั้งเดียวจบ ระบบที่มอนิเตอร์ได้ถูกในวันนี้จะแพงขึ้นในไตรมาสที่คุณเริ่มรื้อสร้างใหม่

พัฒนาบน Linux VPS พร้อมสิทธิ์รูท, NVMe และพลัง AMD EPYC
ดูแพ็กเกจ Linuxใครควรข้าม Prometheus ไป
ถ้าประโยคที่คุณจะใช้อธิบายความต้องการของตัวเองคือ “บอกฉันตอนเว็บล่ม” สิ่งที่คุณกำลังอธิบายคือเครื่องมือเช็กสถานะ และ Prometheus ก็เป็นกลไกที่หนักเกินไปสำหรับคำตอบนั้น Uptime Kuma ทำงานนั้นได้ตรงเป๊ะผ่านหน้าเว็บ และไม่บังคับให้คุณเรียนภาษาคิวรีสำหรับมอนิเตอร์ ช่องว่างด้านความสามารถระหว่างสองเครื่องมือนั้นมหาศาล และไม่เกี่ยวอะไรเลยกับงานที่คุณกำลังจะจ้างมันทำ
ผู้อ่านกลุ่มที่สองคือคนที่อยากได้กราฟที่ใช้งานได้จริงโดยไม่ต้องเรียนภาษาคิวรีก่อน Netdata ถูกสร้างมาเพื่อสิ่งนี้พอดี คือเมตริกรายโฮสต์ที่ดูได้ทันที ตั้งค่าน้อยกว่ามาก และไม่มีอะไรมาขวางระหว่างคุณกับกราฟ ถ้าคำถามที่คุณถามซ้ำ ๆ คือ “ทำไมเครื่องนี้ช้าอยู่ตอนนี้” นั่นคือทางที่สั้นกว่ามากในการไปถึงคำตอบ
กลุ่มที่สามคือใครก็ตามที่อินฟราเปลี่ยนรูปบ่อย และจัดการ target กับตัวแปรของแดชบอร์ดด้วยมือ ทั้งโฮสต์ที่ปั้นขึ้นมาใช้สัปดาห์เดียวแล้วทิ้ง target ที่ถูกเปลี่ยนชื่อ โปรเจกต์ที่เปลี่ยนชื่อกลางทาง นั่นคือกรณีที่คุณจ่ายต้นทุนการตั้งค่าซ้ำแล้วซ้ำอีก ขณะที่ได้ประโยชน์น้อยที่สุดจากสิ่งที่คุณจ่ายเงินซื้อ นั่นคือประวัติต่อเนื่องของระบบที่ยังจำหน้าตาได้
ไม่มีข้อไหนในนี้เป็นการตำหนิตัวเครื่องมือ คำว่า “ข้ามไป” ตรงนี้หมายถึงข้ามไปสำหรับงานนี้ ที่สเกลนี้ ในสเกลของ Kubernetes ซึ่ง service discovery จัดการสิ่งที่คุณต้องต่อสายเองเสียเป็นส่วนใหญ่ ต้นทุนหลายข้อข้างบนจะหดลงหรือหายไปเลย และผมอ่านสเกลนั้นว่า Prometheus แทบไม่มีคู่แข่ง แต่นั่นเป็นรีวิวอีกชิ้นหนึ่ง

คำถามที่พบบ่อย
Prometheus ฟรีไหม
ฟรีครับ และไม่มีกับดักแบบแพลนฟรีซ่อนอยู่ข้างใต้ Prometheus ใช้สัญญาอนุญาต Apache 2.0 และไม่มีรุ่นเชิงพาณิชย์อยู่ข้างหลัง จึงไม่มีโควตาเมตริกให้ชน และไม่มีข้อความชวนอัปเกรดรออยู่อีกฝั่ง สิ่งที่คุณจ่ายคือค่าอินฟราและเวลาของตัวเอง ไม่ใช่ค่าไลเซนส์ Prometheus
Prometheus ต้องใช้ Grafana ไหม
ไม่ต้อง แต่ควรเผื่อไว้ expression browser ของ Prometheus มีไว้เพื่อรันคิวรีแล้วดูคำตอบ ซึ่งพอสำหรับการเช็กอะไรสักอย่างครั้งเดียว ส่วนอะไรก็ตามที่คุณอยากเปิดค้างไว้บนจอที่สองนั้นคือ งานของ Grafana และทั้งสองตัวมักถูกรันคู่กันแทบทุกครั้ง
Prometheus เกินความจำเป็นสำหรับเซิร์ฟเวอร์เครื่องเดียวไหม
บ่อยครั้งก็ใช่ ถ้าสิ่งที่คุณต้องรู้คือเซิร์ฟเวอร์และเซอร์วิสของมันยังทำงานอยู่ไหม เครื่องมือเช็กสถานะตอบให้ได้ในเวลาเพียงเศษเสี้ยวของเวลาติดตั้ง Prometheus จะคุ้มค่าที่ของมันเมื่อคุณอยากได้เมตริกย้อนหลังที่คิวรีได้ และยอมเรียน PromQL เพื่อเข้าถึงมัน
โดยค่าเริ่มต้น Prometheus เก็บเมตริกไว้นานแค่ไหน
15 วัน และมันไม่เตือนคุณล่วงหน้า Prometheus จะทิ้งตัวอย่างที่เก่ากว่าช่วงเก็บข้อมูล เว้นแต่คุณจะขยายด้วยแฟล็กระยะเวลาหรือขนาดของการเก็บข้อมูลตอนสตาร์ต ตั้งค่ามันตั้งแต่วันที่ติดตั้งเลย เพราะการขยายช่วงเก็บทีหลังไม่ได้ดึงข้อมูลที่หมดอายุไปแล้วกลับมา



การสนทนา
ความคิดเห็น
เข้าสู่ระบบเพื่อร่วมสนทนา