

Andrej Karpathy, a co-founder of OpenAI, spent a Saturday morning in March 2026 on a small side project: he had an LLM score how "digitally exposed" a few hundred U.S. occupations are, on a 0-to-10 scale. Software developers landed at 9 out of 10. The story spread fast, and by the next morning Karpathy had taken it down (it has since been restored with added disclaimers). He said it had been "wildly misinterpreted," even though the project notes explicitly warned that a high score did not mean a job would disappear.
Yapay zekâ iş riski puanlarının nasıl hesaplandığı, manşetteki rakamın kendisinden daha önemli. Karpathy'nin projesi, Goldman Sachs, Uluslararası Para Fonu (IMF) ve Anthropic "maruziyet" için farklı yapılar kullanıyor, bu yüzden yüzdeleri birbirinin yerine geçmiyor.
Aynı meslek, arkasındaki yönteme bağlı olarak çok farklı puanlar alabilir ve bu ölçümlerin hiçbiri tek başına işinizi kaybedip kaybetmeyeceğinizi söylemez.
Özetle
- Kamuya açık "yapay zekâ iş riski" rakamları tek bir metrik değil. Birçoğu işin yetenek veya görevlerine dayalı teorik maruziyetle başlarken Anthropic gözlemlenen yapay zekâ kullanımını da ölçüyor; Dünya Ekonomik Forumu'nunki gibi işveren anketleri ise bambaşka bir araç kullanıyor.
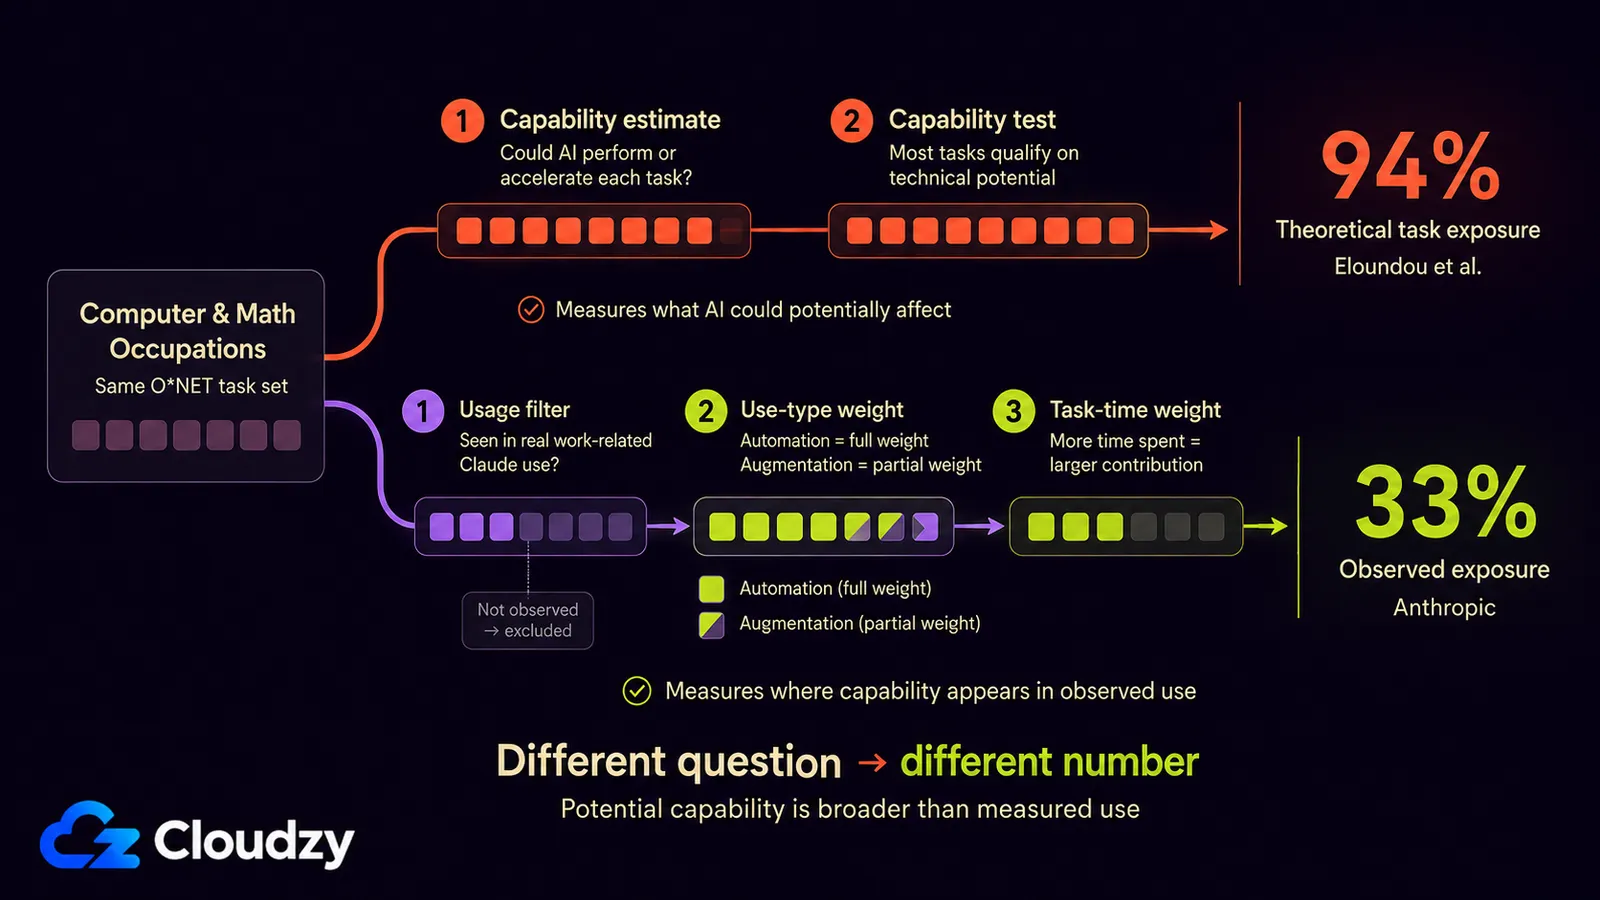
- Teorik ölçümlerle gözlemlenen kullanıma dayalı ölçümler aynı meslek için ciddi biçimde ayrışabilir. Anthropic'in Mart 2026 karşılaştırmasında Eloundou ve diğerlerinin teorik ölçümü bilgisayar ve matematik görevlerini %94 maruziyete koyarken Anthropic'in gözlemlenen maruziyet ölçümü %33'e ulaştı.
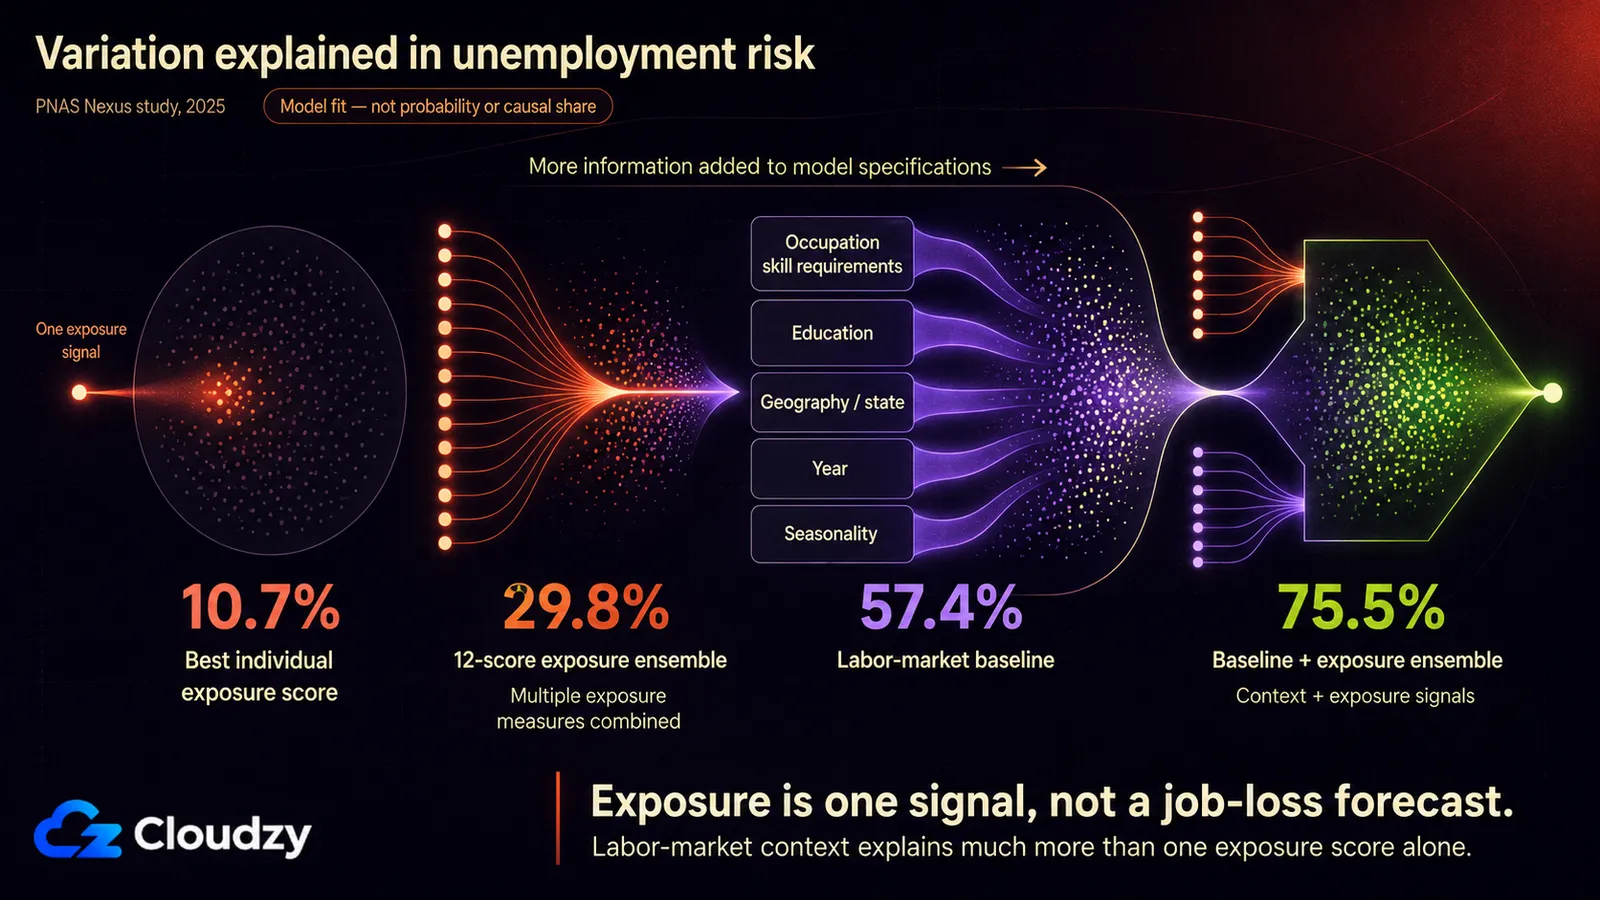
- 2025'te PNAS Nexus'ta yayımlanan hakemli bir çalışma, on iki maruziyet puanını işsizlik riskiyle karşılaştırdı ve en iyi tekil puanın varyansın yalnızca %10,7'sini açıkladığını buldu; on ikisinin birleşimi bunu %29,8'e çıkardı.
- Gördüğünüz bir sonraki "yapay zekâ iş riski" rakamına güvenmeden önce sorulacak faydalı soru, rakamın ne söylediği değil, onu hangi yöntemin ürettiği.
Bu Makalenin Kapsamadığı Konular
Bu yazı bir mekanizmayı açıklıyor, belirli bir iş hakkında hüküm vermiyor; dolayısıyla birkaç yakın soru kapsamı dışında kalıyor:
- Hangi mesleklerin en güvenli veya en riskli olduğunu sıralamıyor. O başka türden bir yazı.
- Yaşa veya kıdeme göre güncel işe alım eğilimlerini analiz etmiyor; bu işgücü piyasası sonuçları, maruziyet puanlarından ayrı bir kanıt tabanı gerektiriyor.
- Yapay zekâ yeteneğinin nereye gideceğini öngörmüyor. Yöntem sorusu, gelecekteki modeller ne kadar iyi olursa olsun geçerliliğini koruyor.
Teorik Maruziyet Puanlaması Nasıl Çalışır: O*NET, AIOE, Goldman Sachs ve IMF
AIOE olarak bilinen AI Occupational Exposure endeksi, on yapay zekâ uygulama kategorisini O*NET'teki 52 mesleki yetenekle çapraz eşleştirir. Kitle kaynaklı bir matris, her yapay zekâ uygulamasının her insan yeteneğiyle ne kadar ilişkili olduğunu derecelendirir; puan daha sonra bu yeteneklerin belirli bir meslekte ne kadar yaygın ve önemli olduğuna göre ağırlıklandırılır. Ekonomistler Edward Felten, Manav Raj ve Robert Seamans yöntemi 2021'de Strategic Management Journal dergisinde yayımladı. Bu, mesleki yapay zekâ maruziyetini ölçmeye yönelik sonraki girişimlerin etkili temellerinden biri oldu.
AIOE ile ilgili önemli nokta, bunun bir benimseme değil maruziyet ölçümü olması. Yapay zekâ uygulamalarındaki ilerlemelerin bir mesleğin gerektirdiği yeteneklerle ne kadar örtüştüğünü tahmin eder; işverenlerin orada yapay zekâ kullanıp kullanmadığını, benimsemenin ekonomik olarak değip değmediğini ya da istihdamın düşüp düşmeyeceğini söylemez.
IMF, Felten, Raj ve Seamans'ın maruziyet ölçümünü Ocak 2024 tarihli bir personel tartışma notunda uyarladı ve bunu, bir mesleğin insan muhakemesi, sosyal bağlam ve fiziksel varlık gibi etkenlerle doğrudan ikameden ne ölçüde korunduğunu yakalayan ayrı bir tamamlayıcılık endeksiyle eşleştirdi. Bu çerçeveyle IMF, küresel istihdamın neredeyse %40'ının yüksek maruziyetli mesleklerde olduğunu, bu oranın gelişmiş ekonomilerde yaklaşık %60'a çıktığını tahmin etti.
Goldman Sachs'ın Nisan 2026 analizi benzer bir sonraki adımı atıyor: Olası ikameyi güçlendirmeden ayırmak için önceki bir yapay zekâ yerinden etme puanını IMF ekonomistlerinin tamamlayıcılık endeksiyle birleştiriyor. Goldman, geçtiğimiz yıl ABD istihdam artışı üzerinde ayda yaklaşık 16.000 işlik net bir fren olduğunu, yapay zekâ ile güçlendirme potansiyeli taşıyan mesleklerin ise ayda yaklaşık 9.000 iş eklediğini tahmin ediyor.
Not: Dünya Ekonomik Forumu'nun Future of Jobs Raporu 2030'a kadar 92 milyon işin yerinden edileceğini ve 170 milyon iş yaratılacağını öngörüyor, ancak hiç de aynı şekilde kurulmamış. Bekledikleri personel sayısı değişikliklerini bildiren 1.000'den fazla işverenle yapılan bir anketten geliyor: görev ayrıştırmalı puanlama değil, işveren öz beyanı. Yapısal olarak farklı iki araç, aynı "X milyon iş" cümlesinde alıntılanıyor.
Anthropic "Gözlemlenen Maruziyeti" Nasıl Farklı Ölçüyor
Anthropic'in Economic Index'i, ilk olarak Şubat 2025'te yayımlandı ve bambaşka türden bir veriden yola çıkıyor: yaklaşık bir milyon gerçek Claude.ai konuşması, Clio adlı dâhili bir araçtan geçiriliyor; bu araç her konuşmayı, görev ayrıştırmalı puanların da yararlandığı aynı O*NET veritabanındaki belirli bir göreve eşliyor ve bunu bir araştırmacı konuşmayı okumadan yapıyor. AIOE yapay zekânın bir görevi makul biçimde yapıp yapamayacağını sorarken Index insanların ondan ne yapmasını istediğini soruyor. Bu ilk rapor konuşmaları %57,4 güçlendirme (Claude yardım ederken işi hâlâ bir insanın yönettiği durum) ve %42,6 otomasyon (Claude'un görevi fiilen baştan sona yaptığı durum) olarak ayırdı.
Anthropic, Mart 2026 tarihli devam çalışmasında bu kullanım verisini yeni bir "gözlemlenen maruziyet" ölçümüne dönüştürdü. Ölçüm, O*NET görevleri ve Eloundou ve diğerlerinin (2023) teorik görev maruziyeti tahminleriyle başlıyor, ardından bir görevi ancak işle ilgili Claude kullanımında yeterince sık görünüyorsa kapsanmış sayıyor. Tamamen otomatikleştirilmiş kullanımlar tam ağırlık, güçlendirici kullanımlar yarım ağırlık alıyor ve görev kapsamı, çalışanların her göreve harcadığı zaman payına göre ağırlıklandırılıyor. Bilgisayar ve matematik mesleklerinde Eloundou ve diğerlerinin teorik β ölçümü görevlerin %94'üne ulaşırken Anthropic'in gözlemlenen maruziyet ölçümü %33'e ulaşıyor. Aradaki fark bir çelişki değil: Biri teknik fizibiliteyi ölçüyor, diğeri buna gözlemlenen benimseme ve kullanımı ekliyor.
Anthropic'in kendi raporlarını okuyan herkes karşılaştırmayı olduğu gibi kabul etmedi. Ocak 2026 tarihli ilgili bir rapora tepki olarak bir Hacker News yorumcusu şunu yazdı: "Yapay zekâ kullanımı sonucunda üretilen ekonomik verimliliğin ölçümlerini görmeyi bekliyordum. Bunun yerine gördüğüm şey, yapay zekâ kullanımının ölçümleri." Akılda tutulmaya değer bir ayrım: Kullanım hacmi ile ekonomik verimlilik aynı şey değil ve ikisi de iş kaybıyla aynı şey değil.
O Ocak 2026 raporu, yani Anthropic'in kendi ekonomik ilkeller güncellemesi, güçlendirme-otomasyon dağılımının yeniden değiştiğini gösteriyor: Güçlendirme konuşmaların %52'siyle önde, otomasyon %45'te; buna görev karmaşıklığı, beceriler, kullanım amacı, yapay zekâ özerkliği ve görev başarısını izleyen beş parçalı yeni bir çerçeve eşlik ediyor. Bunu Şubat 2025 rakamlarıyla çelişki olarak değil, gelişen bir endeksin yeni bir anlık görüntüsü olarak düşünün. İnsanlar devretmeye değer yeni şeyler buldukça kullanım kalıpları değişiyor.
%94'lük bir teorik maruziyet rakamı ile %33'lük bir gözlemlenen maruziyet rakamı, farklı şeyleri ölçtükleri için birbiriyle çelişmeden aynı meslek kategorisini tanımlayabilir.
"Maruziyet" Neden "İş Kaybı" ile Aynı Şey Değil
"Maruziyet göstergeleri işgücü piyasası sonuçlarını değil, teknolojik duyarlılığı ortaya koyar."
Uluslararası Çalışma Örgütü, Nisan 2026
Teorik maruziyet puanı da gözlemlenen maruziyet puanı da bir işin yapay zekâ yeteneğiyle ilişkisi hakkında gerçek bir şeyi yakalıyor. Ama ikisi de o işin gelecek yıl hâlâ var olup olmayacağını söylemiyor.
2025'te Morgan Frank, Yong-Yeol Ahn ve Esteban Moro bu boşluğu ABD işsizlik verileriyle sınadı. Yayımlanmış on iki maruziyet puanını, eyalet işsizlik sigortası kayıtlarından oluşturulan meslek ve eyalet bazlı aylık işsizlik riskiyle karşılaştırdılar. En iyi tekil puan, meslekler, eyaletler ve aylar arasındaki işsizlik riski varyansının %10,7'sini açıkladı; on iki puanlık topluluk %29,8'ini açıkladı. Mesleğin beceri gereksinimleri, eğitim, eyalet, yıl ve mevsimselliği kullanan bir taban modeli %57,4'ünü açıkladı ve maruziyet puanı topluluğunun eklenmesi bunu %75,5'e çıkardı.
Açıkça söylemek gerekirse tek bir maruziyet puanı, işsizlik riskinin tek başına zayıf bir öngörücüsü. Varyansın çok daha büyük kısmı, puanın içermediği işgücü piyasası yapısıyla ilişkili: beceri gereksinimleri, eğitim, coğrafya ve mevsimsellik dâhil.
| Boyut | Teorik / Görev Tabanlı Maruziyet | Gözlemlenen Maruziyet (Anthropic) |
|---|---|---|
| Neyi ölçüyor | Yapay zekânın bir işin ne kadarını potansiyel olarak etkileyebileceği veya hızlandırabileceği | Teorik olarak yapılabilir görevlerden hangilerinin işle ilgili Claude kullanımında göründüğü |
| Kim kullanır | Birçok akademik ve kurumsal maruziyet çerçevesinde kullanılıyor | Anthropic, kendi Claude.ai kullanımı için |
| Veri kaynağı | O*NET iş bileşenleri artı yönteme özgü yapay zekâ yetenek derecelendirmeleri | Claude kullanımı artı O*NET görevleri ve teorik fizibilite |
| İyi yakaladığı şey | Yapay zekâ yeteneğinin işi potansiyel olarak nerede etkileyebileceği | Gözlemlenen benimseme ve işin Claude'a nasıl devredildiği |
| Kaçırdığı şey | Talep, maliyet, düzenleme ve birinin buna zahmet edip etmeyeceği | Claude dışı kullanım; tek bir ürünün kullanıcılarını yansıtıyor |
| Örnek rakam | Bilgisayar ve Matematik: %94 teorik (Eloundou ve diğerleri) | Bilgisayar ve Matematik: %33 gözlemlenen |
OpenAI'ın Nisan 2026'da yayımladığı AI Jobs Transition Framework aynı noktaya farklı bir açıdan varıyor. Teknik maruziyeti bir yerinden etme tahmini olarak ele almak yerine üç soru soruyor: Yapay zekâ bir mesleğin görevlerinin anlamlı bir kısmını yapabilir mi, işi teslim etmede veya denetlemede bir insan merkezde kalıyor mu ve düşen maliyetler talebi verimlilik kazancını soğuracak kadar artırabilir mi? Yaklaşık 148 milyon ABD işini kapsayan 921 mesleğe uygulandığında çerçeve, işlerin yaklaşık %18'ini daha yüksek otomasyon riski kategorisine, %24'ünü yeniden örgütlenmesi muhtemel işlere, %12'sini yapay zekâ ile büyüyebilecek işlere ve %46'sını daha az ani değişim beklenen işlere yerleştiriyor.
PNAS Nexus çalışmasında en güçlü tekil maruziyet puanı, işsizlik riski varyansının tek başına yalnızca %10,7'sini açıkladı.
Yani bir sonraki "yapay zekâ iş riski" rakamı akışınıza düştüğünde, endişelenip endişelenmemeye karar vermeden önce yapılacak faydalı şey, onu bu yöntemlerden hangisinin ürettiğini bulmak. Teorik maruziyet puanı, yapay zekâ yeteneğinin bir işin bileşenleriyle nerede örtüştüğünü söyler. Gözlemlenen maruziyet puanı, insanların yapay zekâyı pratikte hâlihazırda nerede kullandığına dair kanıt ekler. İkisi de tek başına o meslekteki istihdamın artıp azalacağını söylemez; bunun için işe alım, talep, ücretler ve personel sayısı hakkında işgücü piyasası kanıtı gerekir.
Sıkça Sorulan Sorular
Yapay Zekâ İş Maruziyeti, İş Kaybıyla Aynı Şey mi?
Hayır. Teorik maruziyet, yapay zekâ yeteneğinin bir işin çalışmasıyla nerede örtüştüğünü tanımlar; gözlemlenen maruziyet ise yapay zekânın pratikte nerede kullanıldığına dair kanıt ekler. Hiçbiri iş kaybının doğrudan ölçümü değildir. 2025 tarihli hakemli bir çalışma bunu, on iki maruziyet puanını gerçek ABD işsizlik sigortası başvuru verileriyle karşılaştırarak doğrudan sınadı: En iyi performans gösteren tekil puan, işsizlik riski varyansının tek başına %10,7'sini açıkladı.
Yapay Zekâ İş Riski Aslında Nasıl Hesaplanıyor?
"Yapay zekâ iş riski" etiketli rakamların arkasında birden fazla yöntem var. Teorik maruziyet yöntemleri meslekleri O*NET yeteneklerine veya görevlerine ayırır ve yapay zekâ yeteneklerinin bunlarla ne kadar örtüştüğünü puanlar; kesin puanlama yöntemi çalışmadan çalışmaya değişir. Anthropic'in gözlemlenen maruziyet yaklaşımı, teorik görev fizibilitesini gerçek Claude kullanımı, iş bağlamı ve otomasyon derecesiyle birleştirir. Ortaya çıkan rakamlar, teknik olasılık ile gerçek dünyadaki benimseme arasındaki farklı aşamaları ölçtükleri için farklılaşır.
Farklı Yapay Zekâ İş Riski Sıralamaları Aynı İş Hakkında Neden Uyuşmuyor?
Kısmen yapısal olarak farklı yöntemlere dayandıkları için (görev ayrıştırma, işveren anketi ve gözlemlenen kullanım hepsi farklı sorulara yanıt verir), kısmen de tek bir yöntemin bile zamanla değişmesi nedeniyle. Anthropic'in kendi Economic Index'i güçlendirmeyi Şubat 2025'te Claude konuşmalarının %57,4'ü, Ocak 2026 raporunda ise %52'si olarak verdi; otomasyon da buna göre hareket etti. Tek bir tarihe ait anlık görüntü sabit bir yasa değildir.
Yüksek Bir Yapay Zekâ Maruziyet Puanı İşimin Yok Olduğu Anlamına mı Geliyor?
Tek başına hayır. Mart 2026'da kendi viral yapay zekâ maruziyet projesini kaldıran Andrej Karpathy, projenin kendi README dosyasına doğrudan, puanların "kaba LLM tahminleri… titiz öngörüler değil" olduğunu ve yüksek maruziyetli işlerin daha çok "yerini almak yerine yeniden şekillendirileceğini" yazdı. Anthropic'in karşılaştırması ayrımı görünür kılıyor: Bilgisayar ve matematikte Eloundou ve diğerlerinin teorik ölçümü %94'e ulaşırken Anthropic'in gözlemlenen maruziyet ölçümü %33'e ulaşıyor. Bir yetenek ölçeğindeki yüksek rakam, bir işin ele geçirilmesiyle aynı şey değil.



Tartışma
Yorumlar
Tartışmaya katılmak için giriş yapın.