
Ein Nutzer in r/linuxquestions hat den Vergleich gemacht, über den alle ständig streiten. Er installierte CachyOS, benchmarkte mehrere Spiele auf einem Ryzen 7 7800X3D mit einer Radeon RX 7900 XTX und maß keinen Unterschied zu den anderen Distributionen, die bereits auf der Maschine lagen. Die Antworten liefen wie immer. Ein Kommentator setzte die Obergrenze so niedrig an, dass sie im Alltag unsichtbar ist. Ein anderer erklärte den Scheduler. Ein dritter meinte, Benchmarks könnten gar nicht zeigen, was der Scheduler tut. Niemand lieferte die Messung, die die Frage entschieden hätte.
Die Frage kommt immer wieder mit denselben Worten zurück: Ist CachyOS wirklich schneller? Die kurze Antwort lautet ja, bei bestimmten Workloads. Neu kompilierte Pakete können Code helfen, den der Compiler vektorisieren kann, die hier zitierten Gaming-Vergleiche zeigen kaum Abstand bei den durchschnittlichen FPS, und ein System, das sich nach dem Wechsel schneller anfühlt, ist schwerer zuzuordnen, weil ein Distributionswechsel weit mehr als eine Variable ändert.
Sie bleibt ungeklärt, weil „schneller“ drei getrennte Behauptungen mit drei verschiedenen Antworten enthält, von denen jede ihr eigenes Messinstrument braucht. Neu kompilierte Pakete erledigen eine Aufgabe entweder in weniger Wanduhrzeit oder nicht. Ein Scheduler ändert entweder, wie sich der Desktop unter Last verhält, oder nicht. Und eine flottere Maschine geht entweder auf CachyOS zurück oder auf etwas, das gleichzeitig mitkam.
Die Kurzfassung
- Neu kompilierte Pakete: messbar schneller, bei einer Minderheit dessen, was Sie ausführen. Die Gewinne konzentrieren sich auf Code, den der Compiler vektorisieren kann, mehrere Pakete werden langsamer, und die meisten ändern sich nicht. Ein arch-chroot-Vergleich vom Januar 2023 auf sunnyflunk.github.io, auf einem Intel NUC8i5BEK, fand flac-Encoding 20,2 % schneller und bzip2-Dekompression 7,1 % langsamer im selben Durchlauf.
- Die Scheduler-Geschichte zerfällt in zwei Teile. Der aktuelle Standardkernel von CachyOS verwendet EEVDF, während BORE separat verfügbar ist. Distributionsvergleiche vom Mai 2026 fanden kaum Abstand bei den durchschnittlichen FPS und maßen auch 1%-Lows und Frame-Pacing, isolierten aber BORE nicht und fügten keine kontrollierte konkurrierende CPU-Last hinzu. Gaming ab Werk wurde gemessen; der Nutzen von BORE unter Last wurde nicht isoliert.
- Das Gefühl einer schnelleren Maschine: echte Erfahrung, unzuverlässige Zuordnung. Eine frische Installation und die zufällige Behebung eines unabhängigen Fehlers erzeugen beide ein flotteres System, das den Instruktionssatz-Stufen nichts verdankt. Die Ausnahme, die man kennen sollte, ist der Out-of-the-box-Vergleich von Phoronix auf einem Intel Core Ultra 9 285K, bei dem CachyOS vor Stock-Arch lag, und das auf einer CPU, die die AVX-512-Optimierungen gar nicht nutzen kann.
Was CachyOS an Ihrem System tatsächlich ändert
CachyOS ist Arch Linux mit drei getrennten Änderungen obendrauf: einem gepatchten Kernel mit alternativen Schedulern, Repositories, deren Pakete für neuere CPU-Instruktionssatz-Stufen neu kompiliert sind, und zusätzlichen Compiler-Optimierungen für eine Teilmenge der Kernpakete. Jede davon ist ein eigener Mechanismus mit eigener Wirkung, und sie werden fast nie getrennt gemessen.
Die Kernel-Seite ist die größte Angriffsfläche. Die Feature-Liste des CachyOS-Kernels umfasst Clang ThinLTO, AutoFDO-Profiling, zur Laufzeit wählbare Preemption-Modi und mehrere Scheduler-Optionen. Das aktuelle Paket linux-cachyos verwendet ein von CachyOS abgestimmtes EEVDF als Standard-Scheduler. BORE und BMQ sind über separate Kernel-Varianten verfügbar, während linux-cachyos-eevdf zusätzliches EEVDF-Tuning für bessere Reaktionsfähigkeit anwendet und linux-cachyos-server das unveränderte EEVDF nutzt. sched-ext bleibt auf den Varianten verfügbar, die es unterstützen.
Auf der Paketseite sind die x86-64-v3-Repositories von CachyOS der fragliche Mechanismus. Die Seite zu den optimierten Repositories von CachyOS beschreibt das Neukompilieren von Arch-Paketen für drei Ziele oberhalb der generischen Basis: x86-64-v3, x86-64-v4 und ein dediziertes Zen-4/5-Ziel, das weitere AVX-512-Erweiterungen sowie einige Befehle außerhalb von AVX-512 auf v4 draufsetzt. Eine Teilmenge leistungskritischer Pakete erhält außerdem profilgesteuerte Optimierung und BOLT.
Diese Stufennamen stammen aus der Spezifikation der Mikroarchitektur-Stufen im x86-64-psABI, und sie sind Schwellen, keine Regler. x86-64-v3 verlangt die Befehle der AVX- und AVX2-Ära, die 2013 mit Intels Haswell und AMDs Excavator-Kernen kamen; x86-64-v4 verlangt AVX-512, was in der Praxis Intel-Chips der Skylake-X-Klasse und jeden AMD Zen 4 oder neuer bedeutet. Eine CPU nimmt die Hürde oder nicht.
Die drei Behauptungen, die im Wort „schneller“ stecken
Wenn zwei Leute darüber streiten, ob CachyOS schneller ist, haben meist beide recht, nur in verschiedenen Dingen. Durchsatz, Frame-Konsistenz und gefühlte Reaktionsfähigkeit sind getrennte Eigenschaften, und keine einzelne Metrik klärt alle drei. Eine gestoppte Aufgabe misst den Durchsatz; Frametime- und Latenzmessungen decken die Flüssigkeit beim Spielen ab; für den breiteren Effekt auf Systemebene braucht es einen kontrollierten Vergleich mit frischer Installation.
| Die Behauptung | Was behauptet wird | Wie man es messen würde | Was die Belege zeigen | Vertrauen |
|---|---|---|---|---|
| Gemessener Durchsatz | Neu kompilierte Pakete erledigen dieselbe Aufgabe in weniger Zeit | Eine Aufgabe auf fester Hardware und festem Kernel stoppen und nur das Repository ändern, aus dem die Pakete stammen | Solide Gewinne bei vektorisierbarer Arbeit, kleine Rückschritte bei mehreren Paketen, keine Änderung bei den meisten | Hoch. Canonical, die CentOS ISA SIG und zwei unabhängige Benchmarker stimmen im Muster überein |
| Eingabelatenz und Frame-Konsistenz | Der Desktop bleibt reaktionsfähig, während etwas anderes die CPU auslastet | Frametime-Perzentile und Eingabelatenz unter konkurrierender Last, nicht die durchschnittliche Bildrate | Veröffentlichte Tests enthalten inzwischen 1%-Lows und Frame-Pacing, isolieren aber den Scheduler nicht und führen keine kontrollierte konkurrierende CPU-Last ein | Niedrig. Der Mechanismus ist dokumentiert, die Messung fehlt |
| Gefühlte Reaktionsfähigkeit | Die Maschine fühlt sich nach dem Wechsel flotter an | Gegen eine frische Installation der vorherigen Distribution vergleichen, nicht gegen die abgenutzte | Meist durch Effekte der frischen Installation oder eine zufällige Fehlerbehebung erklärt; ein Out-of-the-box-Vergleich fand einen Vorsprung auf Distributionsebene | Mittel. Stimmige Erfahrung, unzuverlässige Zuordnung |
Eine Benchmark-Suite, die die erste Zeile beantwortet, kann die zweite nicht beantworten, und keine von beiden berührt die dritte. Eine der drei auszuführen und das Ergebnis als Urteil über alle drei zu verkünden, hält den Thread am Leben.
Laufen neu kompilierte Pakete wirklich schneller?
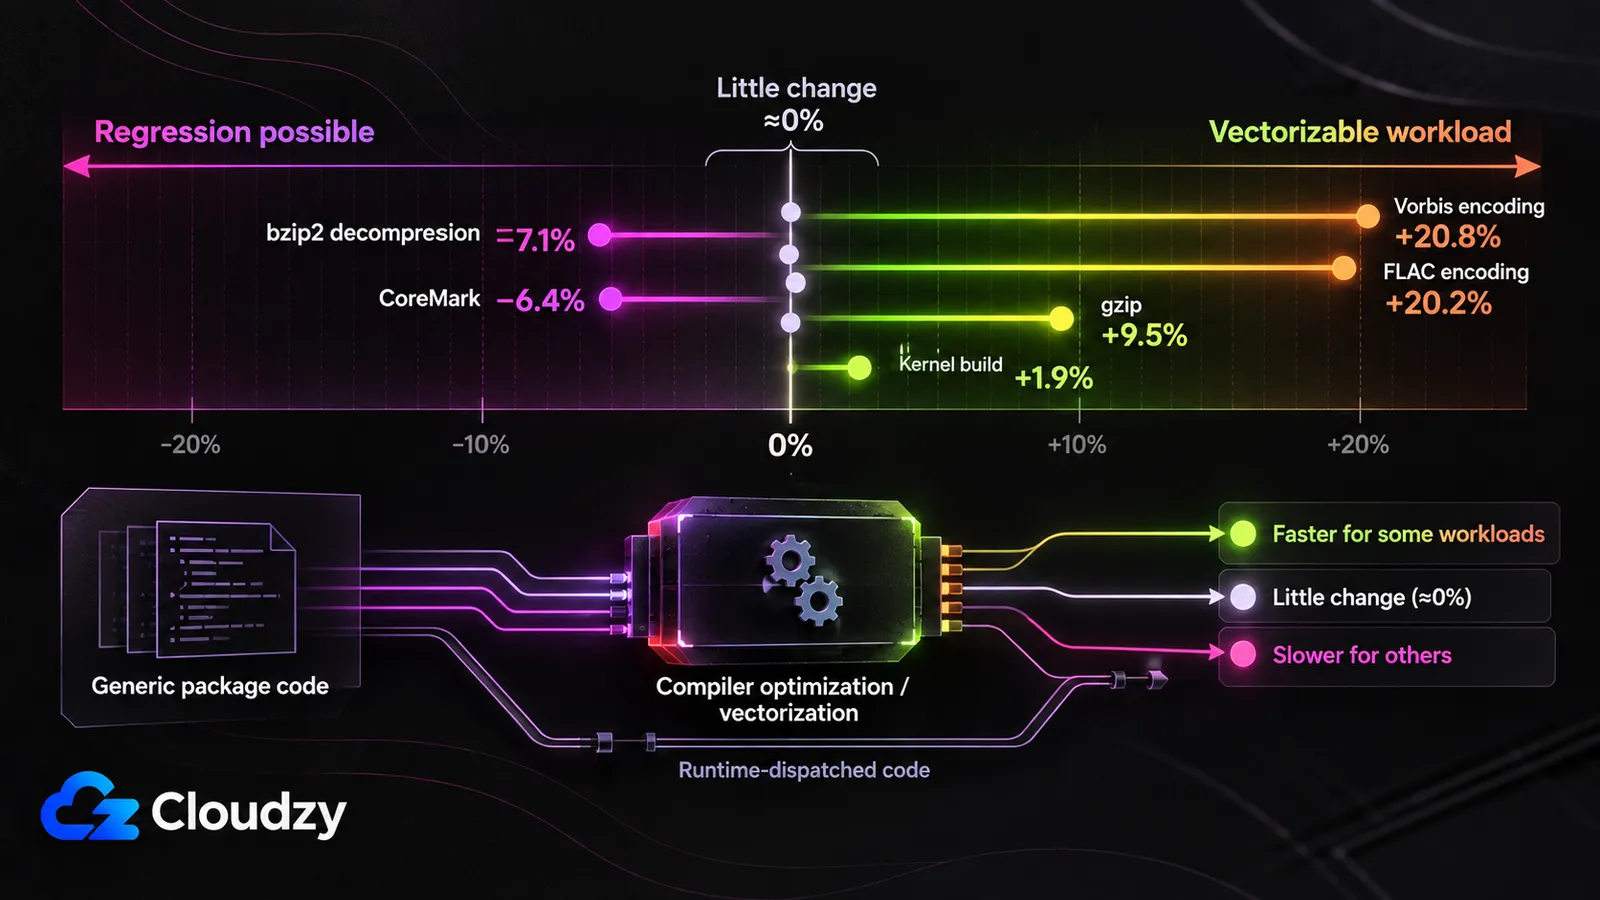
Ja, bei einer Minderheit dessen, was ein Desktop ausführt, und die Größe bestimmt der Workload, nicht die Distribution. Vektorisierbare Arbeit erzielt zweistellige Gewinne, eine Handvoll Pakete werden langsamer, und die meisten zeigen nichts. Die Seite zu den optimierten Repositories von CachyOS beziffert den x86-64-v3-Zuwachs auf 5 % bis 20 % gegenüber generischem x86-64; veröffentlichte Messungen liegen meist am unteren Ende.
Der sauberste CachyOS-vs-Arch-Leistungsvergleich isoliert die Paketvariable und sonst nichts: ein arch-chroot-Test vom Januar 2023 auf sunnyflunk.github.io. Der Host lief mit Stock-Arch auf einem Intel NUC8i5BEK, beide Paketsätze wurden in einem arch-chroot getestet, damit Kernel und Umgebung identisch blieben, und die Benchmarks liefen im RAM, um Festplattenlatenz auszuschließen. Gegenüber den Stock-Arch-Paketen waren die CachyOS-Builds 20,2 % schneller beim flac-Encoding mit -8, 20,8 % schneller beim vorbis-Encoding und 9,5 % schneller bei gzip -3. Im selben Durchlauf waren sie 7,1 % langsamer beim bzip2-Dekomprimieren, 1,6 % bis 2,9 % langsamer beim Komprimieren mit lz4, 3 % langsamer bei pybench und unverändert im R-Benchmark. Zwei Vorbehalte stammen vom Autor selbst: CachyOS baute mit -march=x86-64-v3 -mpclmul -O3 gegenüber Archs -march=x86-64 -O2, und seine Folgetests deuteten darauf hin, dass -O3 statt der Instruktionssatz-Stufe einen Teil der größeren Gewinne erklärte. Der Beitrag entstand vor dem Zen-4-Repository von CachyOS, das mit dem Release vom Juli 2024 kam, aber nicht vor dessen BOLT-Arbeit: Der Autor liest das CachyOS-Python-Paket hinter dem pybench-Rückschritt so, dass es bereits BOLT auf x86-64-v3 trug.
Die CachyOS-Benchmarks auf neuerer Hardware wiederholen das Muster. Ein Vergleich vom Juli 2024 auf mvermeulen.org ließ eine Teilmenge der Phoronix Test Suite auf einem Zen-4-Ryzen 7940HS laufen, CachyOS mit dem Zen-4-Repository gegen Ubuntu 22.04. Die meisten Ergebnisse lagen wenige Prozent in die eine oder andere Richtung: coremark 6,4 % langsamer, die OpenSSL-Untertests von etwa 1 % langsamer bis 4 % schneller, Kernel-Build-Zeit 1,9 % schneller, phpbench als Ausreißer mit etwas mehr als doppeltem Score. Der Autor nennt eine GCC-Versionsabweichung, 14.1 gegenüber Ubuntus 11.4, als wahrscheinlichen Störfaktor. Sein separater NAMD-Lauf vom März 2024 fand Verbesserungen von 6,5 % und 5,8 % bei zwei Molekulardynamik-Workloads.
Institutionelle Tests fanden dasselbe gemischte Bild, an beiden Enden. Canonicals eigenes x86-64-v3-Benchmarking, veröffentlicht im März 2024 mit einem experimentellen Ubuntu-23.10-Image auf Azure, meldete reproduzierbare Gewinne von bis zu 60 % im glibc-Log2-Benchmark, während andere Benchmarks deutlich zurückfielen, in einem Fall, weil das Aktivieren von v3 auf bereits optimiertem SSE-Code den Compiler dazu brachte, ihn auf 17-mal mehr Befehle aufzublähen. Der Rebuild von CentOS Stream 9 durch die CentOS ISA SIG von v2 auf v3, auf Intel-Maschinen der Ice-Lake-Klasse im August 2023, nannte die Ergebnisse „ziemlich gemischt“, mit 2,2-fachen Beschleunigungen konzentriert in Mocassin und John the Rippers md5crypt, beide stark vektorisierbar, wobei das Team den Gewinn von Mocassin hauptsächlich der Autovektorisierung von GCC 12 zuschrieb und nicht der ISA-Stufe.
Viele leistungskritische Mathematik- und Kryptografiebibliotheken liefern mehrere Versionen ihrer Hot-Functions mit und wählen zur Laufzeit per CPU-Feature-Erkennung eine aus, eine Technik namens Function Multiversioning, in der glibc über IFUNC-Resolver umgesetzt. Das heißt, manche Hot-Paths können auf einer Stock-Arch-Installation bereits AVX2 nutzen, ohne dass das ganze Paket neu gebaut wird. Der sunnyflunk-Beitrag sah das direkt und merkte an, dass der flac-Quellcode bereits AVX2-Laufzeitfunktionen enthält, die kein -march brauchen, um aktiv zu werden. Der CentOS-Befund ist das Spiegelbild: Das Team entdeckte glibc-Mathematikfunktionen ohne IFUNC-Versionen, und genau dort hat ein statischer Rebuild Spielraum zu helfen. Was ein v3-Rebuild erreicht, ist der verbleibende Code, den der Autovektorisierer des Compilers von sich aus verbessern kann, und das ist ein Ausschnitt eines Desktops, und zwar ein kleiner.
Die Form des Workloads, nicht das Etikett auf der CPU, entscheidet, ob eine Änderung auf Maschinenebene überhaupt sichtbar wird. Das Durchsatz-Urteil lautet ja, aber begrenzt: Einstellige Änderungen sind in den obigen Messungen üblich, größere Gewinne häufen sich bei vektorisierbaren Workloads wie Encoding und Kompression, und manche Pakete fallen zurück. Das ist eine bessere Beschreibung, als x86-64-v3 als systemweiten Geschwindigkeitsmultiplikator zu behandeln.
Was der Scheduler ändert, und warum die durchschnittlichen FPS es verfehlen
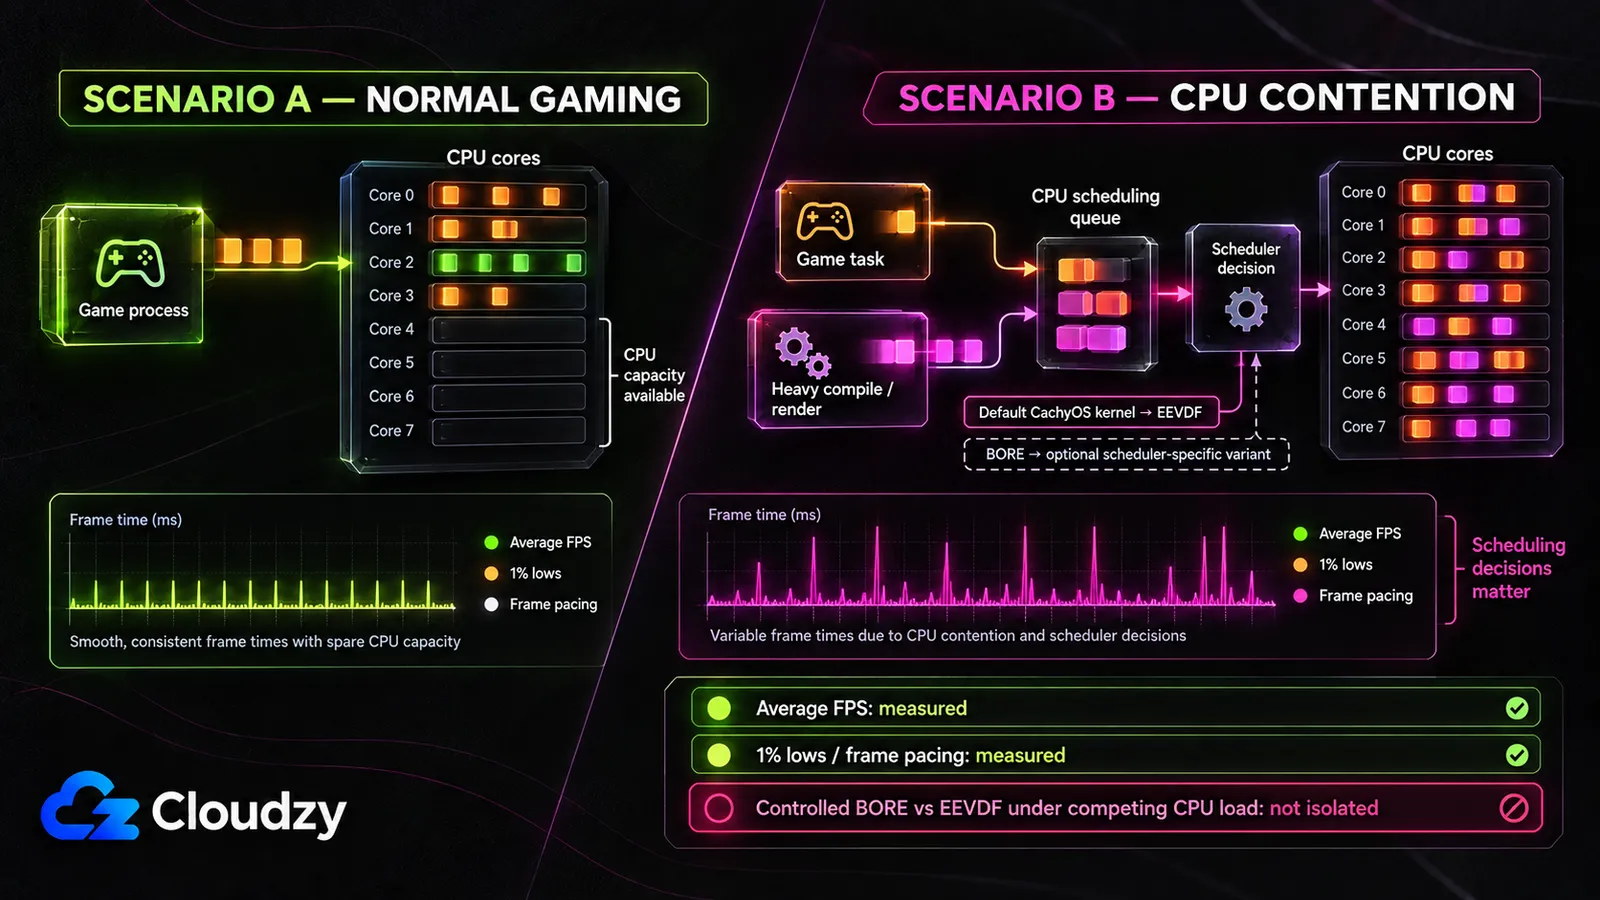
Der aktuelle Standardkernel von CachyOS, linux-cachyos , verwendet EEVDF, während BORE über Scheduler-spezifische Varianten wie linux-cachyos-boreverfügbar ist. Diese Unterscheidung zählt, weil die Gaming-Vergleiche unten Tests auf Distributionsebene sind, keine kontrollierten BORE-gegen-EEVDF-Tests. BORE bleibt für die breitere Leistungsbehauptung relevant, weil sein Design ausdrücklich auf Reaktionsfähigkeit bei gemischten Workloads zielt, aber diese Behauptung muss getrennt von der Gaming-Leistung eines CachyOS ab Werk bewertet werden.
Die README von BORE benennt die Absicht klar:
Um dies zu erreichen, führt BORE eine Dimension der Flexibilität namens „Burstiness“ für jede einzelne Task ein und weicht damit teilweise vom CFS-eigenen Prinzip der „vollständigen Fairness“ ab.
firelzrd/bore-scheduler, README des Projekts
Burstiness ist die CPU-Zeit, die eine Task angesammelt hat, seit sie die CPU zuletzt durch Schlafen, Warten auf I/O oder Yielding abgegeben hat. BORE wandelt das in einen Score um und passt damit das Gewicht jeder Task und die Aggressivität ihrer Wakeup-Preemption an, sodass Tasks, die immer wieder abgeben, als interaktiv behandelt und gegenüber Tasks bevorzugt werden, die ihre Zeitscheibe ausreizen. Die README nennt den Kompromiss selbst: BORE pendelt sich in einem „Gleichgewicht zwischen gegensätzlichen gierigen und schwachen Tasks (meist CPU-gebundene Batch-Tasks) und bescheidenen und starken Tasks (meist I/O-gebundene interaktive Tasks)“ ein. Interaktive Arbeit höher zu gewichten ist derselbe Vorgang wie Batch-Durchsatzarbeit niedriger zu gewichten.
Das sagt Ihnen, welches Instrument die spezifische Behauptung von BORE nachweisen würde: eine konkurrierende CPU-Last einführen und Frametime-Perzentile oder Eingabelatenz messen, während nur der Scheduler geändert wird. Ein Scheduler hat weit weniger zu vermitteln, wenn das Spiel mit ungenutzter CPU-Kapazität läuft.
Ein Benchmark mit fünf Spielen , veröffentlicht am 16. Mai 2026, nutzte saubere CachyOS- und Omarchy-Installationen auf derselben SSD und Hardware, einer RTX 5060 Ti und einem Ryzen 9, mit demselben Proton-GE-Build und 1440p-Einstellungen. Die durchschnittlichen FPS unterschieden sich nur um ein bis zwei Bilder. Zwei Tage später veröffentlichte derselbe Tester einen zweiten Vergleich mit vollständigem MangoHUD-Frame-Logging, der 5%-Lows, 1%-Lows und Frame-Pacing-Varianz hinzufügte. Dieser zweite Test lief auf anderer Hardware, einem Intel i7-13700 und einer Radeon RX 9060 XT, und ist daher ein zusätzlicher Beleg zur Frame-Konsistenz statt einer Erweiterung des ersten Tests auf derselben Hardware. Keiner der beiden Vergleiche isoliert den CPU-Scheduler oder fügt eine gezielte konkurrierende CPU-Last hinzu.
Das Projekt selbst übertreibt es auch nicht. In einem r/cachyos-Thread zur Gaming-Leistung, Peter Jung, einer der Gründungsentwickler von CachyOS, antwortete einem Nutzer direkt: „In gaming not all too much. The newer feature can make a difference tough :)“ (beim Gaming nicht allzu viel, die neuere Funktion kann aber einen Unterschied machen).
Das lässt zwei getrennte Schlüsse zu. Für CachyOS-Gaming ab Werk zeigen veröffentlichte Tests kaum Abstand bei den durchschnittlichen FPS und enthalten inzwischen 1%-Low- und Frame-Pacing-Messungen. Für BORE speziell unter gezielter CPU-Konkurrenz konnte ich keinen kontrollierten veröffentlichten Test finden, der nur den Scheduler ändert und die Reaktionsfähigkeit unter dieser Last misst.
Warum sich ein Wechsel schneller anfühlt, auch wenn nichts schneller misst
Zwei Mechanismen erzeugen nach einem Distributionswechsel eine flottere Maschine, ohne dass eine der CachyOS-Optimierungen beteiligt wäre: die frische Installation selbst und die zufällige Behebung eines unabhängigen Problems, das das vorherige System hatte. Beide sind konkret genug, um sie im eigenen Fall zu erkennen, und das unterscheidet sie von einem pauschalen Placebo-Vorwurf.
Beginnen wir mit der frischen Installation. In einem r/linuxquestions-Thread zu der Fragevermutete ein CachyOS-Nutzer, der nach eigener Aussage selbst keinen Unterschied bemerkt hatte, dass Leute, die große Gewinne melden, womöglich mit einer abgenutzten statt einer frischen Installation vergleichen. Jahre angesammelter Autostart-Einträge, verwaister Dienste, verdrifteter Konfiguration und eine volle Platte sind ein Workload, und eine saubere Partition entfernt all das auf einmal. Ein Distributionswechsel verschiebt Kernel, Desktop-Umgebung, jede Paketversion und jede Voreinstellung gleichzeitig, und ein vollständiger Manjaro-gegen-Ubuntu-Vergleich umfasst ein Dutzend getrennter Achsen. Eine Verbesserung hinterher einer davon zuzuordnen, ist Raterei.
Die zufällige Fehlerbehebung ist der schärfere Fall. Im selben Thread beschrieb ein Kommentator, wie er Fedora täglich mit einem VRAM-Verwaltungsproblem nutzte, das die Leistung massiv beeinträchtigte, zu CachyOS wechselte und das Problem verschwinden sah. Danach wechselte er zu reinem Arch und berichtete im Wesentlichen dieselbe Leistung wie unter CachyOS, mit dem Schluss, dass er nicht mehr wisse, was anders gewesen sei. Die Verbesserung war real; die Compile-Ziele von CachyOS hatten nichts damit zu tun.
Nichts davon erlaubt eine saubere Entzauberung, und der stärkste Beleg gegen eine solche ist ein kontrollierter Test. Der Arrow-Lake-Distributionsvergleich von Phoronix setzte Ubuntu 24.10, Fedora Workstation 41, Arch Linux, Clear Linux und CachyOS auf denselben Intel Core Ultra 9 285K in ihrem Standardzustand, und CachyOS lag knapp vor allen, auch vor Clear Linux, das auf Intel-Silizium normalerweise führt. Arrow Lake hat keine AVX-512-Unterstützung, also kann dieser Vorsprung nicht von x86-64-v4 kommen; er spiegelt eine Kombination aus den Kernel- und Build-Entscheidungen von CachyOS, den Paketoptimierungen und der Standardkonfiguration wider.
Die Erfahrung kann echt sein, während die Zuordnung unsicher bleibt. Der Arrow-Lake-Vergleich von Phoronix ist ein nützliches Gegenbeispiel: Eine CachyOS-Installation im Standardzustand kann Stock-Arch auch dann schlagen, wenn x86-64-v4 nicht verfügbar ist.
So prüfen Sie, ob irgendetwas davon auf Ihre Maschine zutrifft
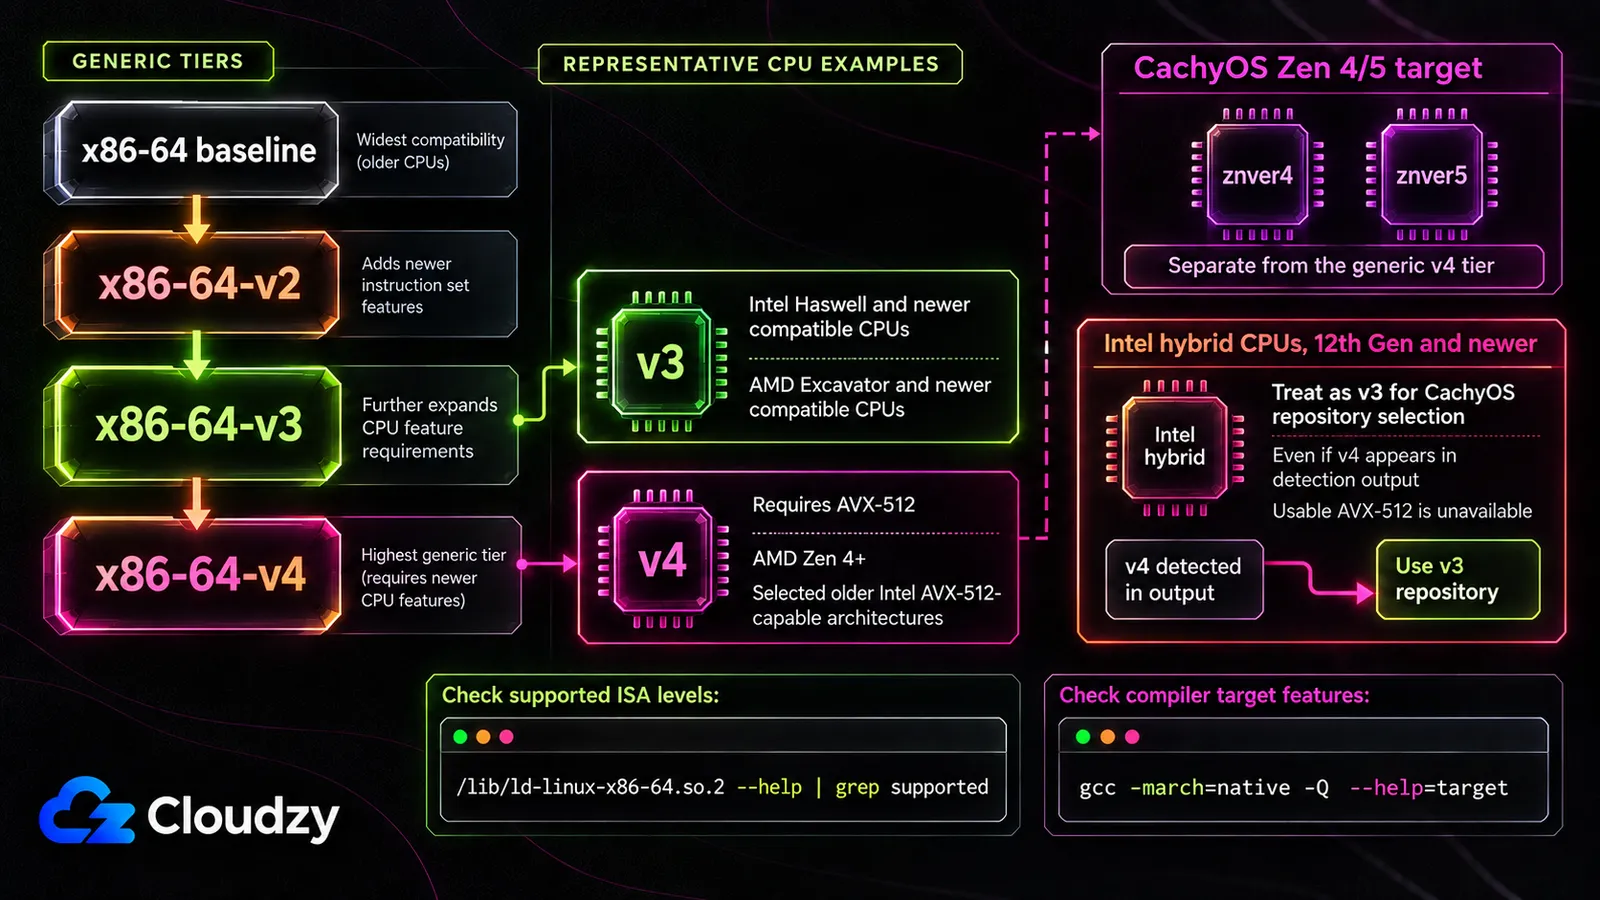
Welche standardisierte x86-64-Mikroarchitektur-Stufe Ihre CPU unterstützt, lässt sich größtenteils mit einem Befehl beantworten. Der dynamische Linker meldet die glibc-hwcaps-Stufen, die er nutzen kann, sodass der höchste unterstützte x86-64-vN-Eintrag normalerweise sagt, ob die CPU für die generische Repository-Stufe v2, v3 oder v4 infrage kommt. Eine wichtige Ausnahme sind Intels Hybrid-CPUs ab der 12. Generation: CachyOS empfiehlt, sie als v3 zu behandeln, auch wenn v4 in der Ausgabe erscheint, weil AVX-512 dort nicht nutzbar ist. Das separate Zen-4/5-Ziel von CachyOS braucht zudem eine eigene Architekturprüfung.
/lib/ld-linux-x86-64.so.2 --help | grep supportedFür AMD Zen 4/5 dokumentiert CachyOS außerdem:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Der erste Befehl gibt etwa Folgendes aus:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Das ist eine CPU mit v3 und v2, aber ohne AVX-512. Drei Ergebnisse, drei Entscheidungen:
- Nichts oberhalb von x86-64-v2. Der Vorteil der v3-/v4-/Zen-spezifischen Rebuilds gilt für diese CPU nicht. CachyOS kann trotzdem laufen, und paketspezifische Compiler-Optimierungen sowie Kernel- und Standardkonfigurationsänderungen können weiterhin zählen.
- x86-64-v3 unterstützt, x86-64-v4 nicht verfügbar. Das schließt für die praktische Repository-Wahl moderne Intel-Hybrid-CPUs wie Arrow Lake ein. In den oben zitierten Vergleichen waren viele Änderungen klein, manche Encoding- und Kompressions-Workloads gewannen deutlich mehr, und manche Pakete fielen zurück.
- x86-64-v4 unterstützt. AVX-512 schafft mehr theoretischen Spielraum für vektorisierbare Workloads, garantiert aber keinen großen systemweiten Gewinn.
Wenn Ihre CPU infrage kommt und Sie nur die Paket-Hälfte wollen, müssen Sie dafür nicht neu installieren. Die Repositories von CachyOS lassen sich zu einem bestehenden Arch-System hinzufügen, und ALHP veröffentlicht Rebuilds der offiziellen Arch-Repositories auf jeder x86-64-vN-Stufe, dokumentiert im Arch Wiki mit eigenen Vorbehalten: DKMS-Pakete sind anstelle direkt gelinkter Kernelmodule erforderlich, und -march für die Kernel-Kompilierung zu setzen „würde keine nennenswerten Ergebnisse bringen“. Beide Wege liefern Ihnen die neu kompilierten Pakete und nichts vom Kernel-Patchset oder den Scheduler-Varianten.
Führen Sie zuerst den Befehl aus. Er verwandelt einen Streit über Distributionen in eine Tatsache über Ihre eigene Maschine, und das ist die einzige Fassung dieser Frage, die Sie heute Abend selbst klären können.

Entwickeln Sie auf einem Linux-VPS mit Root-Zugriff, NVMe und AMD-EPYC-Power.
Linux-Pläne ansehenHäufig gestellte Fragen
Verbessert CachyOS wirklich die Gaming-Leistung?
Bei der durchschnittlichen Bildrate kaum. Ein Fünf-Spiele-Vergleich vom Mai 2026 fand nur einen Unterschied von ein bis zwei Bildern, und eine Nachmessung zwei Tage später maß auch 1%-Lows und Frame-Pacing. Keiner der Tests führte eine gezielte konkurrierende CPU-Last ein, also ist die offene Frage die Reaktionsfähigkeit des Schedulers unter Last, nicht ob Frame-Pacing überhaupt gemessen wurde.
Unterstützt meine CPU x86-64-v3 oder v4?
Unter CachyOS oder Arch führen Sie /lib/ld-linux-x86-64.so.2 --help | grep supported aus, um die standardisierten glibc-hwcaps-Stufen zu sehen, die für Ihre CPU erkannt wurden. x86-64-v3 verlangt den Funktionsumfang der AVX/AVX2-Ära, während v4 AVX-512 hinzufügt. Für Intel-Hybrid-CPUs ab der 12. Generation empfiehlt CachyOS, das System als v3 zu behandeln, auch wenn v4 in der Ausgabe erscheint; Zen-4/5-Nutzer sollten zusätzlich das separate znver4/znver5-Ziel prüfen.
Warum machen neu kompilierte Pakete keinen größeren Unterschied?
Weil ein Teil des stark optimierten Codes bereits zur Laufzeit an CPU-spezifische Implementierungen verteilt wird. Mathematik- und Kryptografiebibliotheken nutzen für Hot-Functions oft Function Multiversioning oder IFUNC, sodass das Neukompilieren von Paketen vor allem Code hilft, den der Compiler global noch weiter optimieren oder vektorisieren kann.
Bekomme ich die optimierten Pakete von CachyOS auch ohne Distributionswechsel?
Ja. Die Repositories von CachyOS lassen sich zu einer bestehenden Arch-Linux-Installation hinzufügen, und das ALHP-Projekt veröffentlicht Rebuilds der offiziellen Arch-Repositories für x86-64-v2, v3 und v4, dokumentiert im Arch Wiki. Beide liefern nur die neu kompilierten Pakete, nicht das Kernel-Patchset von CachyOS, die alternativen Scheduler oder die Voreinstellungen des Installers.
Diskussion
Kommentare
Melden Sie sich an, um mitzudiskutieren.