
Egy r/linuxquestions-felhasználó elvégezte azt az összehasonlítást, amelyen mindenki folyton vitatkozik. Telepítette a CachyOS-t, több játékot lemért egy Ryzen 7 7800X3D-n egy Radeon RX 7900 XTX-szel, és semmilyen különbséget nem mért a gépen már meglévő többi disztribúcióhoz képest. A válaszok a szokásos mederben folytak. Az egyik hozzászóló olyan alacsonyra tette a plafont, hogy normál használatban láthatatlan. Egy másik elmagyarázta az ütemezőt. Egy harmadik azt mondta, a benchmarkok nem tudják megmutatni, mit csinál az ütemező. Senki sem hozta elő azt a mérést, amely eldöntené a kérdést.
A kérdés újra és újra ugyanazokkal a szavakkal tér vissza: tényleg gyorsabb a CachyOS? A rövid válasz: igen, bizonyos munkaterheléseknél. Az újrafordított csomagok segíthetnek annak a kódnak, amelyet a fordító vektorizálni tud, az itt idézett játékos összehasonlítások kevés különbséget mutatnak az átlagos FPS-ben, és egy váltás után gyorsabbnak érződő rendszert nehezebb egyetlen okra visszavezetni, mert egy disztribúcióváltás sokkal többet változtat egyetlen változónál.
Azért marad eldöntetlen, mert a „gyorsabb” három különálló állítást hordoz három különböző válasszal, és mindegyikhez saját mérőeszköz kell. Az újrafordított csomagok vagy kevesebb faliórás idő alatt végeznek egy feladattal, vagy nem. Egy ütemező vagy megváltoztatja, hogyan viselkedik az asztal versengő terhelés alatt, vagy nem. És egy fürgébb gép vagy a CachyOS-ra vezethető vissza, vagy valamire, ami vele együtt érkezett.
A rövid verzió
- Újrafordított csomagok: mérhetően gyorsabbak, de csak annak a kisebbségén, amit futtatsz. A nyereség a fordító által vektorizálható kódban összpontosul, több csomag lassabb lesz, a többség pedig nem változik. Egy 2023. januári arch-chroot-összehasonlítás a sunnyflunk.github.io oldalon, egy Intel NUC8i5BEK-en, ugyanabban a futásban a flac-kódolást 20,2%-kal gyorsabbnak, a bzip2-kicsomagolást 7,1%-kal lassabbnak találta.
- Az ütemező története kettéválik. A CachyOS jelenlegi alapértelmezett kernelje EEVDF-et használ, a BORE külön érhető el. A 2026. májusi disztribúció-összehasonlítások kevés különbséget találtak az átlagos FPS-ben, és mérték az 1%-os minimumokat és a képkocka-ütemezést is, de nem izolálták a BORE-t, és nem adtak hozzá kontrollált versengő CPU-terhelést. A dobozból kivett játékteljesítményt megmérték; a BORE versengés alatti előnyét nem izolálták.
- A gyorsabb gép érzése: valódi tapasztalat, megbízhatatlan tulajdonítás. Egy friss telepítés és egy független hiba véletlen javítása egyaránt fürgébb rendszert ad, amely semmit sem köszönhet az utasításkészlet-szinteknek. A megjegyzésre érdemes kivétel a Phoronix dobozból kivett összehasonlítása egy Intel Core Ultra 9 285K-n, ahol a CachyOS megelőzte a sima Archot egy olyan CPU-n, amely egyáltalán nem tudja használni az AVX-512-optimalizációkat.
Mit változtat valójában a CachyOS a rendszereden
A CachyOS Arch Linux három különálló, egymásra rakott módosítással: egy patchelt kernel alternatív ütemezőkkel, tárolók, amelyek csomagjai újabb CPU-utasításkészlet-szintekre vannak újrafordítva, és extra fordítóoptimalizációk az alapcsomagok egy részhalmazán. Mindegyik külön mechanizmus külön hatással, és szinte sosem mérik őket külön.
A kerneloldal a legnagyobb felület. A CachyOS kerneljének funkciólistája lefedi a Clang ThinLTO-t, az AutoFDO-profilozást, a futásidőben választható megszakítási módokat és több ütemezőopciót. A jelenlegi linux-cachyos csomag CachyOS-ra hangolt EEVDF-et használ alapértelmezett ütemezőként. A BORE és a BMQ külön kernelváltozatokban érhető el, míg a linux-cachyos-eevdf további EEVDF-válaszkészségi hangolást alkalmaz, a linux-cachyos-server pedig alap EEVDF-et használ. A sched-ext továbbra is elérhető az azt támogató változatokon.
A csomagoldalon a CachyOS x86-64-v3 tárolói a szóban forgó mechanizmus. A CachyOS optimalizált tárolókról szóló oldala leírja az Arch-csomagok újraépítését három, az általános alapszint feletti célra: x86-64-v3, x86-64-v4, valamint egy dedikált Zen 4/5 cél, amely a v4-re további AVX-512-bővítéseket és néhány AVX-512-n kívüli utasítást tesz. A teljesítményérzékeny csomagok egy részhalmaza profilvezérelt optimalizációt és BOLT-ot is kap.
Ezek a szintnevek az x86-64 psABI mikroarchitektúra-szint specifikációjábólszármaznak, és küszöbök, nem tekerőgombok. Az x86-64-v3 az AVX- és AVX2-korszak utasításait követeli meg, amelyek az Intel 2013-as Haswelljével és az AMD Excavator-magjaival érkeztek; az x86-64-v4 AVX-512-t követel, ami a gyakorlatban Skylake-X osztályú Intel-processzorokat és minden AMD Zen 4-et vagy újabbat jelent. Egy CPU vagy átugorja a lécet, vagy nem.
A „gyorsabb” szóban rejtőző három állítás
Amikor két ember nem ért egyet abban, hogy gyorsabb-e a CachyOS, általában mindkettőnek igaza van, csak más-más dologban. Az átbocsátás, a képkocka-konzisztencia és az érzékelt válaszkészség különálló tulajdonságok, és egyetlen mérőszám sem dönti el mindhármat. Egy időzített feladat az átbocsátást méri; a képkockaidő- és késleltetésmérések a játék folyamatosságát fedik le; a tágabb rendszerszintű hatáshoz kontrollált, friss telepítéses összehasonlítás kell.
| Az állítás | Mit állítanak | Hogyan mérnéd | Mit mutatnak a bizonyítékok | Bizonyosság |
|---|---|---|---|---|
| Mért átbocsátás | Az újrafordított csomagok ugyanazt a feladatot rövidebb idő alatt végzik el | Egy feladat időzítése rögzített hardveren és rögzített kernelen, csak azt változtatva, melyik tárolóból jöttek a csomagok | Szilárd nyereség vektorizálható munkán, kis visszaesések több csomagnál, nincs változás a többségnél | Magas. A Canonical, a CentOS ISA SIG és két független benchmarkoló egyetért a mintázatban |
| Bemeneti késleltetés és képkocka-konzisztencia | Az asztal válaszkész marad, miközben valami más telíti a CPU-t | Képkockaidő-percentilisek és bemeneti késleltetés versengő terhelés alatt, nem az átlagos képkockasebesség | A közzétett tesztek már tartalmazzák az 1%-os minimumokat és a képkocka-ütemezést, de nem izolálják az ütemezőt, és nem vezetnek be kontrollált versengő CPU-terhelést | Alacsony. A mechanizmus dokumentált, a mérés hiányzik |
| Érzékelt válaszkészség | A gép fürgébbnek érződik a váltás után | Az előző disztribúció friss telepítésével hasonlíts össze, ne az elhasználttal | Általában a friss telepítés hatásaival vagy egy mellékes javítással magyarázható; egy dobozból kivett összehasonlítás disztribúciószintű előnyt talált | Közepes. Megalapozott tapasztalat, megbízhatatlan tulajdonítás |
Az első sort megválaszoló benchmarkcsomag nem tudja megválaszolni a másodikat, és egyik sem érinti a harmadikat. A háromból egyet lefuttatni, és az eredményt mindháromról szóló ítéletként közölni: ez tartja életben a vitát.
Tényleg gyorsabban futnak az újrafordított csomagok?
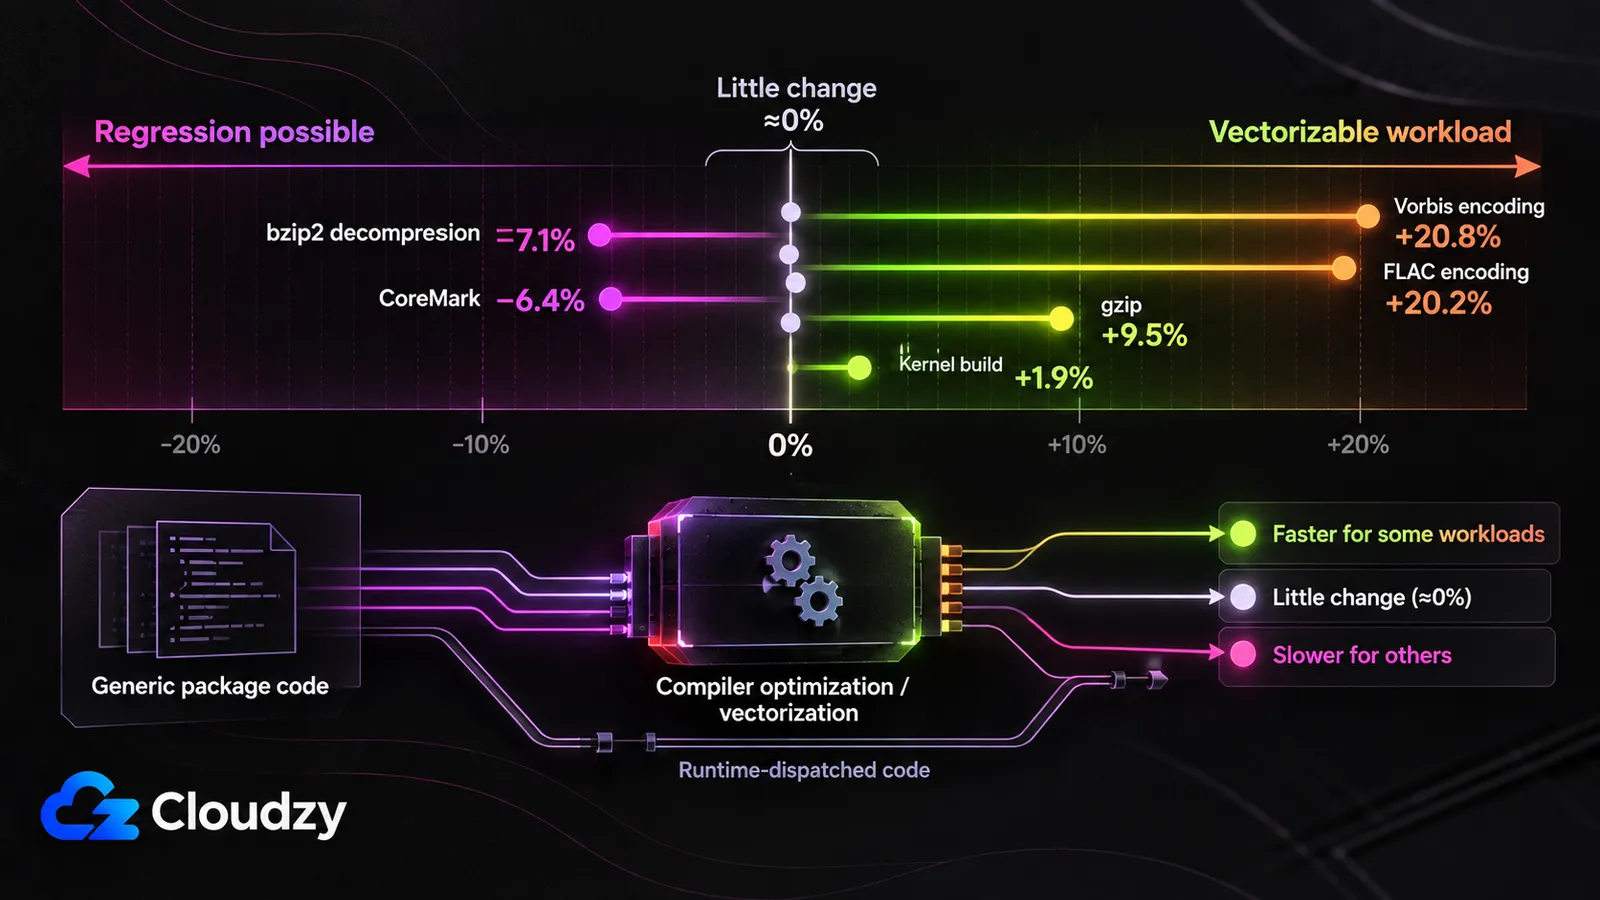
Igen, annak a kisebbségén, amit egy asztali gép futtat, és a mértéket a munkaterhelés szabja meg, nem a disztribúció. A vektorizálható munka kétszámjegyű nyereséget lát, egy maroknyi csomag lassabb lesz, a többség pedig semmit sem mutat. A CachyOS optimalizált tárolókról szóló oldala az x86-64-v3 nyereségét 5–20%-ra teszi az általános x86-64-hez képest; a közzétett mérések többnyire ennek az alsó végén vannak.
A legtisztább CachyOS vs Arch teljesítmény-összehasonlítás a csomagváltozót izolálja, és semmi mást: egy 2023. januári arch-chroot-teszt a sunnyflunk.github.io oldalon. A gazdagép sima Archot futtatott egy Intel NUC8i5BEK-en, mindkét csomagkészletet arch-chrooton belül tesztelték, hogy a kernel és a környezet azonos maradjon, a benchmarkok pedig RAM-ban futottak a lemezkésleltetés kiküszöbölésére. A sima Arch-csomagokhoz képest a CachyOS-buildek 20,2%-kal gyorsabban kódoltak flacet -8beállítással, 20,8%-kal gyorsabban kódoltak vorbist, és 9,5%-kal gyorsabbak voltak gzip -3beállítással. Ugyanabban a futásban 7,1%-kal lassabban csomagoltak ki bzip2-t, 1,6–2,9%-kal lassabban tömörítettek lz4-gyel, 3%-kal lassabbak voltak a pybenchen, és változatlanok az R-benchmarkon. Két fenntartás magától a szerzőtől származik: a CachyOS -march=x86-64-v3 -mpclmul -O3 kapcsolókkal fordított az Arch -march=x86-64 -O2beállításával szemben, és utólagos tesztjei arra utaltak, hogy nem az utasításkészlet-szint, hanem az -O3 felelt a nagyobb nyereségek egy részéért. A bejegyzés a CachyOS Zen 4 tárolója előtt született, amely a 2024. júliusi kiadással érkezett, de nem a BOLT-munka előtt: a szerző úgy olvassa, hogy a pybench-visszaesés mögötti CachyOS Python-csomag már az x86-64-v3 tetején BOLT-ot hordozott.
Az újabb hardveren futtatott CachyOS-benchmarkok ugyanezt a mintát ismétlik. Egy 2024. júliusi összehasonlítás az mvermeulen.org oldalon a Phoronix Test Suite egy részhalmazát futtatta egy Zen 4-es Ryzen 7940HS-en, CachyOS a Zen 4 tárolóval az Ubuntu 22.04 ellen. A legtöbb eredmény néhány százalékon belül maradt bármelyik irányban: a coremark 6,4%-kal lassabb, az OpenSSL-résztesztek nagyjából 1%-kal lassabbtól 4%-kal gyorsabbig, a kernelfordítási idő 1,9%-kal gyorsabb, a phpbench pedig kiugró, alig több mint kétszeres pontszámmal. A szerző valószínű zavaró tényezőként jelzi a GCC-verzióeltérést, 14.1 az Ubuntu 11.4-ével szemben. Az ő külön NAMD-futása 2024 márciusában 6,5%-os és 5,8%-os javulást talált két molekuladinamikai munkaterhelésen.
Az intézményi tesztek ugyanezt a vegyes képet találták, mindkét végén. A Canonical saját x86-64-v3-benchmarkolása, amelyet 2024 márciusában tettek közzé egy kísérleti Ubuntu 23.10 lemezképpel az Azure-on, akár 60%-os, reprodukálható nyereséget jelentett a glibc Log2-benchmarkon, miközben más benchmarkok jelentősen visszaestek, egy esetben azért, mert a v3 engedélyezése már optimalizált SSE-kódon arra késztette a fordítót, hogy 17-szer több utasításra bontsa ki. A CentOS ISA SIG CentOS Stream 9 újraépítése v2-ről v3-ra, Ice Lake osztályú Intel-gépeken 2023 augusztusában, „meglehetősen vegyesnek” nevezte az eredményeket, a 2,2-szeres gyorsulás a Mocassinban és a John the Ripper md5cryptjében összpontosult, mindkettő erősen vektorizálható, bár a csapat a Mocassin nyereségét főleg a GCC 12 autovektorizálásának tulajdonította, nem az ISA-szintnek.
Sok teljesítménykritikus matematikai és kriptográfiai könyvtár a forró függvényeinek több változatát szállítja, és futásidőben, CPU-funkciódetektálással választ egyet; ezt a technikát függvény-többverziózásnak hívják, és a glibc-ben IFUNC-feloldókkal valósul meg. Ez azt jelenti, hogy egyes forró útvonalak már egy sima Arch-telepítésen is használhatnak AVX2-t az egész csomag újraépítése nélkül. A sunnyflunk-bejegyzés ezt közvetlenül látta, megjegyezve, hogy a flac forráskódja már tartalmaz AVX2-futásidejű függvényeket, amelyekhez nem kell -march az engedélyezéshez. A CentOS megállapítása a tükörképe: a csapat IFUNC-változat nélküli glibc-matematikai függvényeketfedezett fel, és pontosan ott van tere segíteni egy statikus újraépítésnek. Amit egy v3-újraépítés elér, az a fennmaradó kód, amelyet a fordító autovektorizálója magától javítani tud, és ez egy asztali gépnek csak egy szelete, méghozzá kicsi.
A munkaterhelés alakja dönti el, nem a CPU-n lévő címke, hogy egy gépszintű változás egyáltalán megmutatkozik-e. Az átbocsátási ítélet: igen, de korlátozottan: az egyszámjegyű változások gyakoriak a fenti mérésekben, a nagyobb nyereség a vektorizálható munkaterhelések, például a kódolás és a tömörítés körül csoportosul, és néhány csomag visszaesik. Ez jobb leírás annál, mint az x86-64-v3-at rendszerszintű sebességszorzóként kezelni.
Mit változtat az ütemező, és miért nem látja ezt az átlagos FPS
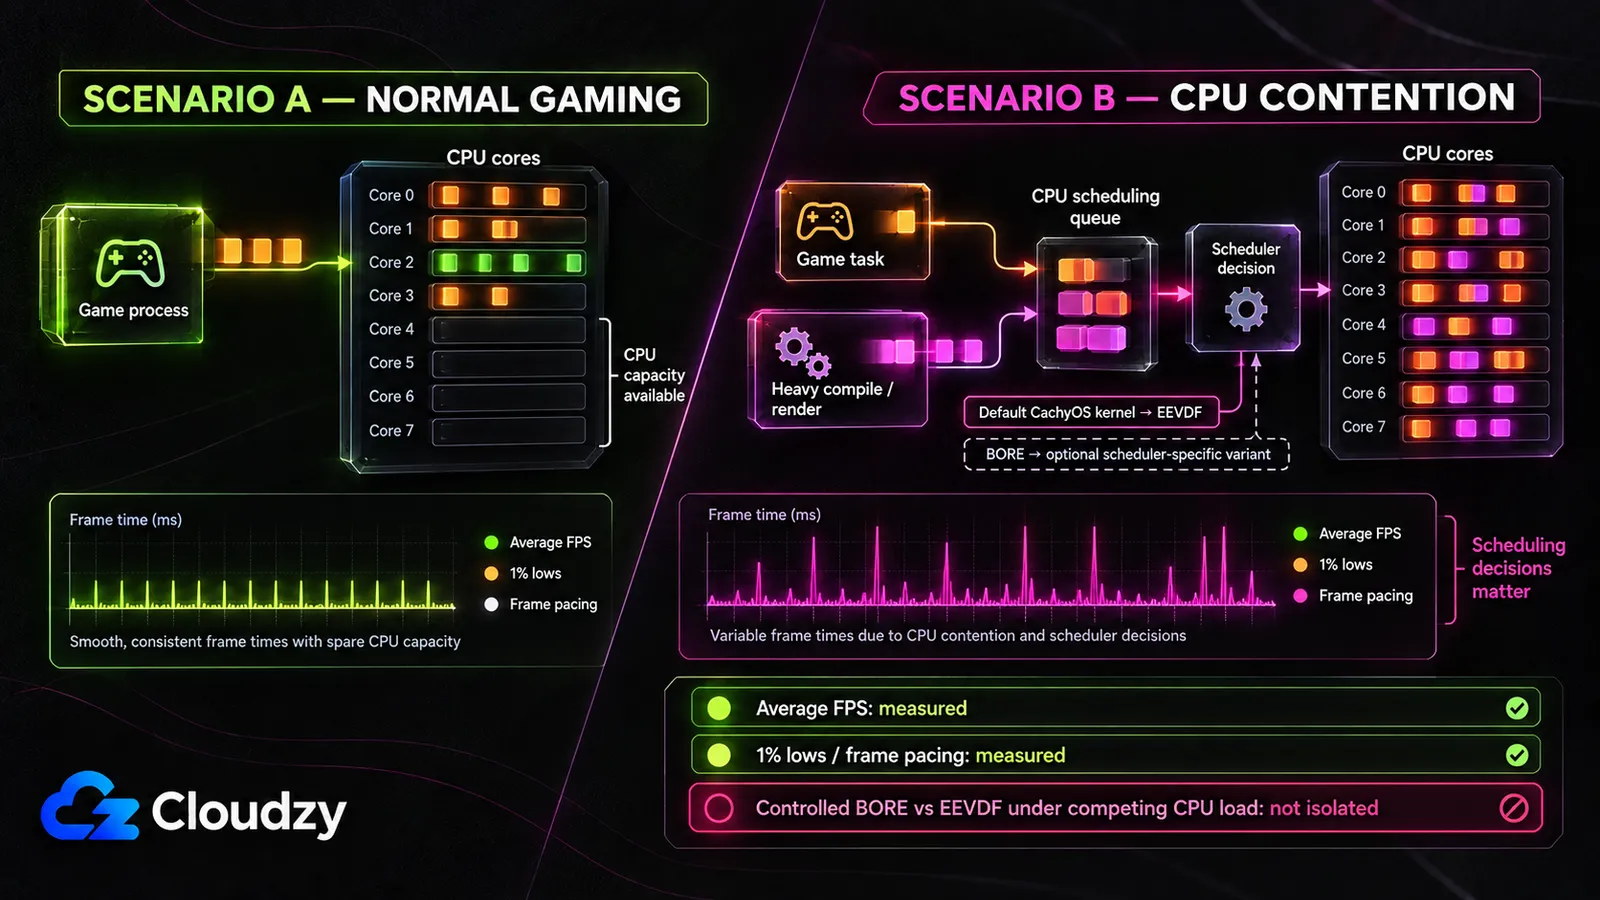
A CachyOS jelenlegi alapértelmezett kernelje, a linux-cachyos , EEVDF-et használ, míg a BORE ütemezőspecifikus változatokon keresztül érhető el, mint például a linux-cachyos-bore. Ez a különbségtétel azért számít, mert az alábbi játékos összehasonlítások disztribúciószintű tesztek, nem kontrollált BORE–EEVDF tesztek. A BORE továbbra is releváns a tágabb teljesítményállítás szempontjából, mert a tervezése kifejezetten a vegyes munkaterhelés alatti válaszkészséget célozza, de ezt az állítást a CachyOS dobozból kivett játékteljesítményétől külön kell értékelni.
A BORE saját README-je nyíltan kimondja a szándékot:
Ennek elérésére a BORE minden egyes feladathoz bevezet egy „burstiness” néven ismert rugalmassági dimenziót, részben eltérve a CFS-ben rejlő „teljes méltányosság” elvétől.
firelzrd/bore-scheduler, a projekt README-je
A burstiness az a CPU-idő, amelyet egy feladat azóta halmozott fel, hogy utoljára átadta a CPU-t alvással, I/O-ra várással vagy lemondással. A BORE ezt pontszámmá alakítja, és ezzel igazítja minden feladat súlyát és ébredéskori megszakítási agresszivitását, így a folyton lemondó feladatokat interaktívnak tekinti, és előnyben részesíti azokkal szemben, amelyek kisajátítják az időszeletüket. A README maga nevezi meg a kompromisszumot: a BORE „egyensúlyba áll az ellentétes, mohó és gyenge feladatok (általában CPU-kötött kötegelt feladatok) és a szerény és erős feladatok (általában I/O-kötött interaktív feladatok) között”. Az interaktív munka felsúlyozása ugyanaz a művelet, mint a kötegelt átbocsátási munka lesúlyozása.
Ez megmondja, melyik eszköz mutatná ki a BORE konkrét állítását: vezess be versengő CPU-terhelést, és mérj képkockaidő-percentiliseket vagy bemeneti késleltetést úgy, hogy csak az ütemezőt változtatod. Egy ütemezőnek sokkal kevesebb dolga van, amikor a játék kihasználatlan CPU-kapacitással fut.
Egy ötjátékos benchmark , amelyet 2026. május 16-án tettek közzé, tiszta CachyOS- és Omarchy-telepítéseket használt ugyanazon az SSD-n és hardveren, egy RTX 5060 Ti-n és egy Ryzen 9-en, ugyanazzal a Proton-GE-builddel és 1440p-s beállításokkal. Az átlagos FPS csak egy-két képkockával tért el. Két nappal később ugyanaz a tesztelő közzétett egy második összehasonlítást teljes MangoHUD-képkockanaplózással, hozzáadva az 5%-os minimumokat, az 1%-os minimumokat és a képkocka-ütemezés szórását. Ez a második teszt más hardvert használt, egy Intel i7-13700-at és egy Radeon RX 9060 XT-t, így inkább további bizonyíték a képkocka-konzisztenciáról, nem az első teszt azonos hardveres kiterjesztése. Egyik összehasonlítás sem izolálja a CPU-ütemezőt, és nem ad hozzá szándékos versengő CPU-munkaterhelést.
A projekt sem adja el túl. Egy játékteljesítményről szóló r/cachyos-szálban, Peter Jung, a CachyOS egyik alapító fejlesztője, közvetlenül válaszolt egy felhasználónak: „In gaming not all too much. The newer feature can make a difference tough :)” (játékban nem túl sokat; az újabb funkció azért számíthat).
Ebből két külön következtetés adódik. A dobozból kivett CachyOS-játékteljesítménynél a közzétett tesztek kevés különbséget mutatnak az átlagos FPS-ben, és már tartalmaznak 1%-os minimum- és képkocka-ütemezési méréseket. A BORE-nál kifejezetten szándékos CPU-versengés alatt nem találtam olyan közzétett, kontrollált tesztet, amely csak az ütemezőt változtatja, és ez alatt a terhelés alatt méri a válaszkészséget.
Miért érződik gyorsabbnak egy váltás akkor is, amikor semmi sem mér gyorsabbat
Két mechanizmus ad fürgébb gépet egy disztribúcióváltás után anélkül, hogy a CachyOS bármelyik optimalizációja szerepet játszana: maga a friss telepítés, és egy független probléma véletlen javítása, amely az előző rendszerben megvolt. Mindkettő elég konkrét ahhoz, hogy a saját esetedben felismerd, és ez különbözteti meg őket egy általános placebo-vádtól.
Kezdjük a friss telepítéssel. Egy a kérdésről szóló r/linuxquestions-szálbanegy CachyOS-felhasználó, aki elmondása szerint maga nem vett észre különbséget, felvetette, hogy a nagy nyereségről beszámolók talán egy agyonhasznált telepítéssel hasonlítanak össze, nem egy frissel. Az évek alatt felhalmozott automatikus indítási bejegyzések, árva szolgáltatások, elcsúszott konfiguráció és egy teli lemez munkaterhelést jelentenek, és egy tiszta partíció ezt mind egyszerre eltünteti. Egy disztribúcióváltás egyszerre mozdítja el a kernelt, az asztali környezetet, minden csomagverziót és minden alapértelmezést, és egy teljes Manjaro–Ubuntu összehasonlítás tucatnyi különálló tengelyre terjed ki. Utólag egyetlen ilyennek tulajdonítani a javulást találgatás.
A véletlen javítás az élesebb eset. Ugyanabban a szálban egy hozzászóló leírta, hogy napi szinten Fedorát használt egy VRAM-kezelési problémával, amely súlyosan rontotta a teljesítményt, átváltott CachyOS-ra, és a probléma eltűnt. Aztán csupasz Archra váltott, és lényegében ugyanazt a teljesítményt jelentette, mint CachyOS-on, arra jutva, hogy már nem tudja, mi volt más. A javulás valódi volt; a CachyOS fordítási céljainak semmi közük nem volt hozzá.
Egyik sem jogosít fel tiszta cáfolatra, és a legerősebb bizonyíték egy ilyen cáfolat ellen egy kontrollált teszt. A Phoronix Arrow Lake disztribúció-összehasonlítása az Ubuntu 24.10-et, a Fedora Workstation 41-et, az Arch Linuxot, a Clear Linuxot és a CachyOS-t ugyanarra az Intel Core Ultra 9 285K-ra tette alapértelmezett állapotukban, és a CachyOS mindet megelőzte hajszállal, a Clear Linuxot is beleértve, amely Intel-szilíciumon rendszerint vezet. Az Arrow Lake nem támogatja az AVX-512-t, így ez az előny nem jöhet az x86-64-v4-ből; a CachyOS kernel- és fordítási döntéseinek, csomagoptimalizációinak és alapértelmezett konfigurációjának valamilyen kombinációját tükrözi.
A tapasztalat lehet valódi, miközben a tulajdonítás bizonytalan marad. A Phoronix Arrow Lake-összehasonlítása hasznos ellenpélda: egy alapértelmezett állapotú CachyOS-telepítés akkor is felülmúlhatja a sima Archot, amikor az x86-64-v4 nem elérhető.
Hogyan ellenőrizd, vonatkozik-e mindebből bármi a gépedre
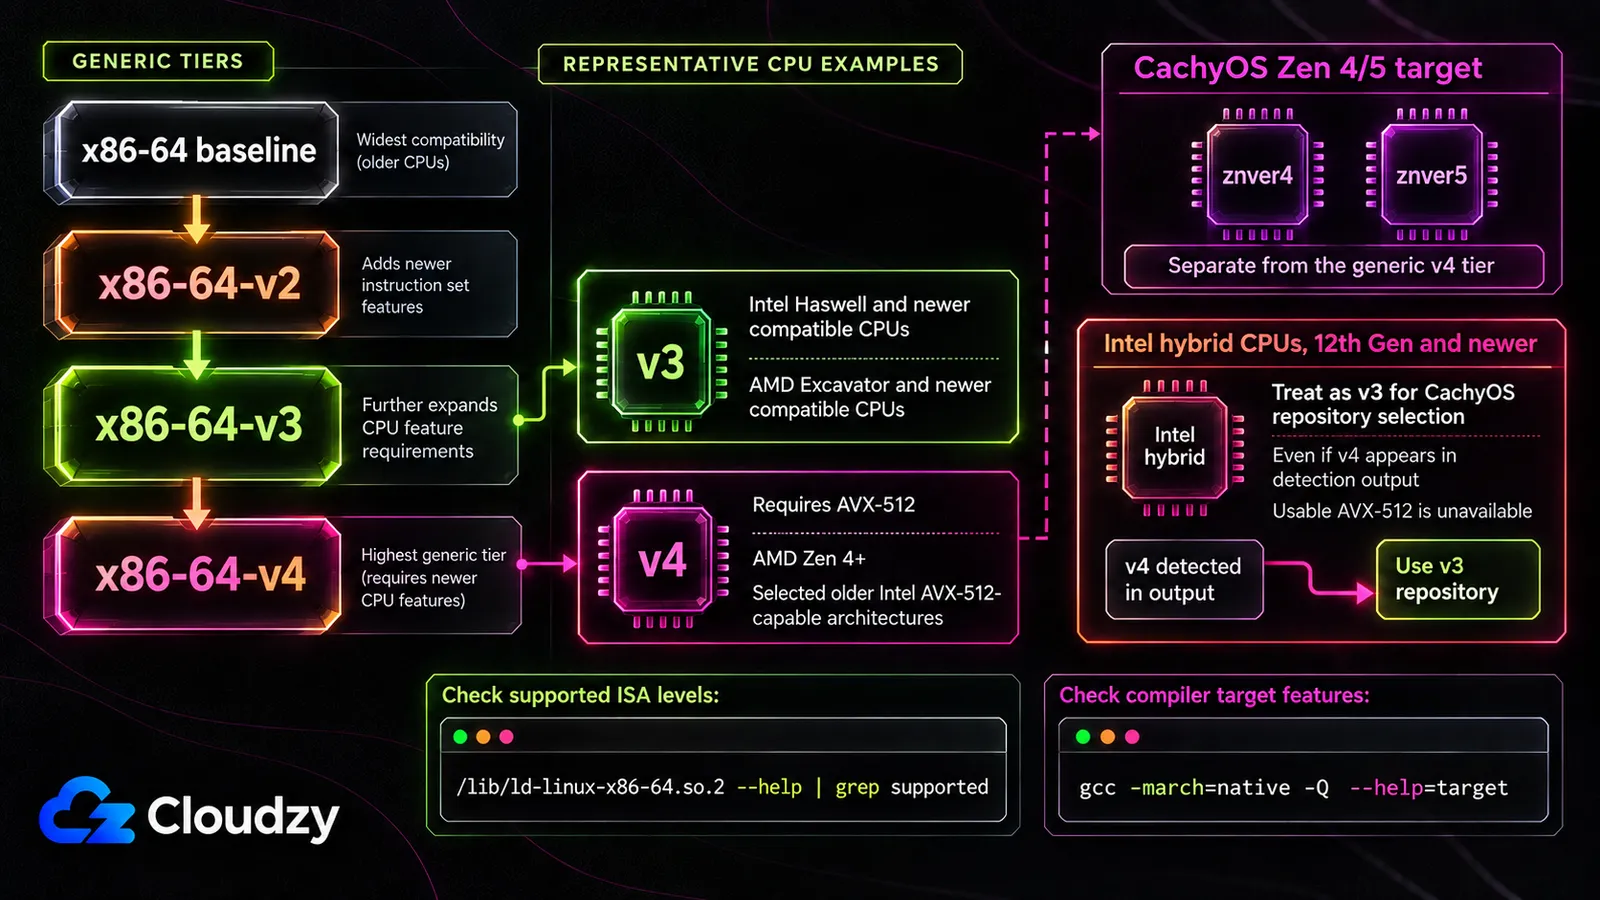
Az, hogy a CPU-d melyik szabványosított x86-64 mikroarchitektúra-szintet támogatja, nagyrészt egyetlen paranccsal megválaszolható. A dinamikus linker jelenti az általa használható glibc-hwcaps-szinteket, így a legmagasabb támogatott x86-64-vN bejegyzés rendszerint megmondja, hogy a CPU jogosult-e az általános v2, v3 vagy v4 tárolószintre. Egy fontos kivétel az Intel 12. generációs és újabb hibrid CPU-i: a CachyOS szerint v3-ként kell kezelni őket akkor is, ha a v4 megjelenik a kimenetben, mert az AVX-512 ott nem használható. A CachyOS külön Zen 4/5 céljához saját architektúra-ellenőrzés is kell.
/lib/ld-linux-x86-64.so.2 --help | grep supportedAMD Zen 4/5-höz a CachyOS ezt is dokumentálja:
gcc -march=native -Q --help=target 2>&1 | grep -Po "^\s+-march=\s+\K(\w+)$"Az első parancs valami ilyesmit ír ki:
Subdirectories of glibc-hwcaps directories, in priority order:
  x86-64-v4
  x86-64-v3 (supported, searched)
  x86-64-v2 (supported, searched)
Ez egy v3-mal és v2-vel rendelkező, de AVX-512 nélküli CPU. Három kimenet, három döntés:
- Semmi az x86-64-v2 felett. A v3/v4/Zen-specifikus újraépítés előnye erre a CPU-ra nem vonatkozik. A CachyOS ettől még futhat, és a csomagspecifikus fordítóoptimalizációk, valamint a kernel- és alapértelmezett konfigurációs változások továbbra is számíthatnak.
- x86-64-v3 támogatott, x86-64-v4 nem elérhető. Ez a gyakorlati tárolóválasztás szempontjából a modern Intel hibrid CPU-kat, például az Arrow Lake-et is magában foglalja. A fent idézett összehasonlításokban sok változás kicsi volt, egyes kódolási és tömörítési munkaterhelések sokkal többet nyertek, néhány csomag pedig visszaesett.
- x86-64-v4 támogatott. Az AVX-512 több elméleti mozgásteret teremt a vektorizálható munkaterheléseknek, de nem garantál nagy, rendszerszintű nyereséget.
Ha a CPU-d jogosult, és csak a csomagos felét szeretnéd, nem kell újratelepítened hozzá. A CachyOS tárolói hozzáadhatók egy meglévő Arch-rendszerhez, az ALHP pedig minden x86-64-vN szinten közzéteszi a hivatalos Arch-tárolók újraépítéseit, az Arch Wikin dokumentálva , saját fenntartásokkal: közvetlenül linkelt kernelmodulok helyett DKMS-csomagok kellenek, és a -march beállítása a kernelfordításhoz „nem hozna számottevő eredményt”. Mindkét út az újrafordított csomagokat adja, és semmit a kernel-patchkészletből vagy az ütemezőváltozatokból.
Először futtasd a parancsot. A disztribúciókról szóló vitát a saját gépedről szóló ténnyé alakítja, és ennek a kérdésnek ez az egyetlen változata, amelyet ma este magad eldönthetsz.

Építkezz Linux VPS-en root hozzáféréssel, NVMe-vel és AMD EPYC teljesítménnyel.
Linux csomagok megtekintéseGyakran ismételt kérdések
Tényleg javítja a CachyOS a játékteljesítményt?
Az átlagos képkockasebességnél alig. Egy 2026. májusi ötjátékos összehasonlítás csak egy-két képkockányi különbséget talált, egy két nappal későbbi folytatás pedig az 1%-os minimumokat és a képkocka-ütemezést is mérte. Egyik teszt sem vezetett be szándékos versengő CPU-munkaterhelést, így a megválaszolatlan kérdés az ütemező válaszkészsége versengés alatt, nem az, hogy mérték-e egyáltalán a képkocka-ütemezést.
Támogatja a CPU-m az x86-64-v3-at vagy a v4-et?
CachyOS-on vagy Archon futtasd a /lib/ld-linux-x86-64.so.2 --help | grep supported parancsot, hogy lásd a CPU-dhoz detektált szabványosított glibc-hwcaps-szinteket. Az x86-64-v3 az AVX/AVX2-korszak funkciókészletét követeli meg, a v4 pedig AVX-512-t ad hozzá. Az Intel 12. generációs és újabb hibrid CPU-inál a CachyOS azt javasolja, hogy a rendszert v3-ként kezeld akkor is, ha a v4 megjelenik a kimenetben; a Zen 4/5 felhasználóinak a külön znver4/znver5 célt is ellenőrizniük kell.
Miért nem jelentenek nagyobb különbséget az újrafordított csomagok?
Mert az erősen optimalizált kód egy része már futásidőben CPU-specifikus megvalósításokhoz irányítódik. A matematikai és kriptográfiai könyvtárak gyakran függvény-többverziózást vagy IFUNC-ot használnak a forró függvényekhez, így a csomagok újrafordítása főleg annak a kódnak segít, amelyet a fordító globálisan tovább tud optimalizálni vagy vektorizálni.
Megkaphatom a CachyOS optimalizált csomagjait disztribúcióváltás nélkül?
Igen. A CachyOS tárolói hozzáadhatók egy meglévő Arch Linux-telepítéshez, az ALHP projekt pedig az Arch Wikin dokumentálva közzéteszi a hivatalos Arch-tárolók x86-64-v2, v3 és v4 célú újraépítéseit. Mindkettő csak az újrafordított csomagokat adja, nem a CachyOS kernel-patchkészletét, az alternatív ütemezőket vagy a telepítő alapértelmezéseit.
Beszélgetés
Hozzászólások
Jelentkezzen be a beszélgetéshez.