

Valami, amit te építettél, éles üzemben fut. A monitorozásod vagy egyáltalán nincs, vagy csak egy elérhetőségi ping, és a múlt heti kiesésről egy felhasználótól értesültél. Minden válasz, amit keresel, ugyanarra a névre mutat.
Ez a Prometheus teszt arról a szakadékról szól, ami két egyszerre igaz állítás között tátong. Ingyenes és nyílt forráskódú, licenc nélkül és metrikánkénti számla nélkül, bármekkora méretben. Ugyanakkor elvisz egy estét, plusz egy lekérdezőnyelvet, amit még nem ismersz. Lekéréses metrikagyűjtő beépített riasztással, és kiváló szoftver. Hogy a mostani rendszeredhez ez-e a megfelelő szoftver, az viszont másik kérdés, és épp ez az, amit érdemes megválaszolni.
A rövid verzió
- Végeredmény: 3,5 / 5 egyéni és kiscsapatos önüzemeltetésre. A Prometheust érdemes üzemeltetni, ha a gépeid és szolgáltatásaid köre észszerűen stabil, ha rászánod az időt a PromQL megtanulására, és ha olyan metrikákat akarsz, amelyek teljesen a tieid, előfizetés és megőrzési számla nélkül.
- Hagyd ki, ha a kérdés, amire választ vársz, annyi: „fut még?” Egy elérhetőségfigyelő sokkal gyorsabban elvisz addig a válaszig, és a Prometheust erre a feladatra elővenni annyi, mint egy lekérdezőnyelv árát megfizetni olyasmiért, amit tíz perc alatt is elintéztél volna.
- A PromQL az a költség, ami újra és újra visszatér. A beüzemelés egyszeri költség. Amint a kérdéseid túlnőnek a kész műszerfalakon és a Grafana vizuális lekérdezésépítőjén, máris visszakerülsz a PromQL-be.
- A karbantartási költség attól függ, mekkora részét kezeled kézzel a rendszernek. Egy flotta, amely megtartja a formáját, olcsón monitorozható. Az, amelyik gépeket kap, veszít és nevez át, pontosan ott van, ahol a költség csendben halmozódik.
- Ez a végeredmény kizárólag a kisméretű önüzemeltetésre vonatkozik. Kubernetes- és éles SRE-méretben a Prometheus egészen más ajánlat, és ez a teszt nem próbálja megválaszolni azt a kérdést.
Hogyan készült ez a teszt: A Prometheus ingyenes és nyílt forráskódú, tehát itt semmiféle gyártói kapcsolat nincs, és senki nem küldött nekem semmit. A verziókra és a tárolás viselkedésére vonatkozó tények a Prometheus saját dokumentációjából származnak. Az erőforrásszámok és a telepítési idők két, egymástól függetlenül publikált gyakorlati tesztből valók, mindkettő ott hivatkozva, ahol éppen használom. Ahol a kettő eltér, ott mindkét számot látod majd, nem pedig átlagot.
Mit fed le ez a teszt
A fenti végeredménynek vannak határai, és ezek a határok itt a szokásosnál is fontosabbak, mert a Prometheus különböző méretekben másik eszközként viselkedik.
- A Prometheus egyetlen VPS-en és kis projektekben történő önüzemeltetésre értékelve: néhány gép és szolgáltatás, egyetlen emberrel, aki gondoskodik róluk.
- Nem Kubernetes. A Prometheus Operator, a ServiceMonitors és a kube-prometheus-stack külön üzemeltetési világ, és az itteni végeredmény arról semmit sem mond.
- Nem Alertmanager-útvonalkezelési útmutató. A riasztás létezik és működik; az útvonalak, a némítások és a fogadók beállítása viszont önálló téma.
- Nem telepítési leírás. Itt az a kérdés, hogy egyáltalán érdemes-e futtatni. Ha erre már megvan a válaszod, a mi Grafana és Prometheus Docker Compose útmutatónk ismerteti a lépéseket.
- Nem exporter-körkép. Az exporterek csak ott kerülnek elő, ahol megváltoztatják a választ.
Amit a Prometheus jól csinál
A Prometheus semmibe sem kerül. Nem „ingyenes csomag fizetős bővítésekkel”, és nem is „ingyenes, amíg át nem lépsz egy metrikakorlátot”. A tároló elejétől a végéig Apache 2.0 licenc alatt áll és a fő projektnek nincs fizetős kiadása, sehol nincs gépenkénti, metrikánkénti vagy címkénkénti számlázás. Az egyetlen számla, amit a Prometheus valaha előállít, az a szerver, amin fut.
Olyasminél, amire építeni készülsz, jogos a kérdés, hogy „meglesz-e ez három év múlva is”, és itt az esélyek nagyjából olyan jók, amilyenek nyílt forráskódban lenni szoktak. A Prometheus 2018 augusztusában végzett a CNCF-ben, a történelem során másodikként, a Kubernetes után. A kiadások egyenletesen jönnek, a v3.13.2 2026 július végén jelent meg, és mivel ez a kiadási ág hosszú távú támogatású ág, megkapja a hiba-, biztonsági és dokumentációs javításokat egy éven át, így a foltozottság fenntartása nem jelenti azt, hogy minden apró verzió után rohanni kell.
Az adatmodell az oka annak, hogy a körülötte lévő ökoszisztéma ilyen mély. A Prometheus HTTP-n keresztül gyűjti a metrikákat, és minden idősort egy metrikanévvel plusz kulcs/érték címkékkel azonosít, amitől egy exporter megírása kis munka. Ezért szinte mindenre létezik exporter, amit reálisan futtathatsz: gépmetrikák, Postgres, Nginx, Redis, blackbox szondák azokhoz a dolgokhoz, amiket csak kívülről lehet megpiszkálni.
És a tiéd az, amit összegyűjt, ami jellemzően nem az első napon, hanem később számít igazán. Egy kis rendszer előzményei jelentéktelen mennyiségű lemezt foglalnak (a számok lentebb), senki nem árazhatja át neked jövő negyedévben, és nincs olyan számlasor, ami minden alkalommal nő, amikor valaki új mérést tesz egy alkalmazásba. Ha láttál már felügyelt monitorozási számlát felkúszni azért, mert egy fejlesztő hozzáadott egy címkét, az egész érvelés benne van abban az egy mondatban.
Hol kerül a Prometheus többe, mint amennyinek látszik
Egy dev.to-teszt hét monitorozóeszközzel, egyetlen kis VPS-en azt mérte, hogy önmagában a Prometheus telepítése 15 percet vett igénybe. Párosítsd Grafanával, ahogy a tesztelő is tette, mert a beépített kifejezésböngésző csak egy hely, ahol lekérdezéseket futtatsz. Ugyanez a teszt a Grafana + Prometheus párost 35 percre teszi az első grafikonig, benne a YAML-alapú begyűjtési konfigurációval.
A percek az olcsó rész. A drága a PromQL. A Prometheus mindent névvel és címkékkel azonosított idősorként tárol, és a kérdéseid alatt továbbra is a PromQL van. A Grafanának mostanra van vizuális építője, tehát nem kell minden lekérdezést kézzel megírnod. A tesztelő saját ítélete kertelés nélküli volt: a PromQL nagyszerű annak, aki benne él, ő pedig nem élt benne. Ha még sosem használtál lekérdezőnyelvet, számolj egy esténél többel, és készülj rá, hogy visszatérsz hozzá, valahányszor a vizuális építő már nem elég. Egy műszerfal, amit valaki mástól másoltál, az ő kérdéseire válaszol. A tieid egy olyan lekérdezés, amit még nem írtál meg.
A harmadik költség az, amelyik csak később bukkan elő. Egy háromhetes üzemeltetői beszámoló pontosan leírja, mivel járt egyetlen szerver hozzáadása egy hétcsomópontos rendszerhez: újracímkézés, a begyűjtési konfigurációk újbóli átnézése, a műszerfalak változóinak szerkesztése és a sablonlekérdezések átdolgozása, hogy az új gép megjelenjen a legördülő listákban. Az az üzemeltető három hét után feladta a rendszert, arra jutva, hogy több időt tölt a műszerfalak hangolásával, mint az infrastruktúrája figyelésével.
Figyeld meg, mihez kötődik ez a költség egy ilyen rendszerben: a kézzel kezelt célpontokhoz és műszerfalakhoz. Két csendes éven át futtatni a Prometheust szinte semmibe sem kerül ezen felül.
Mennyi memóriára és lemezre van valójában szüksége a Prometheusnak?
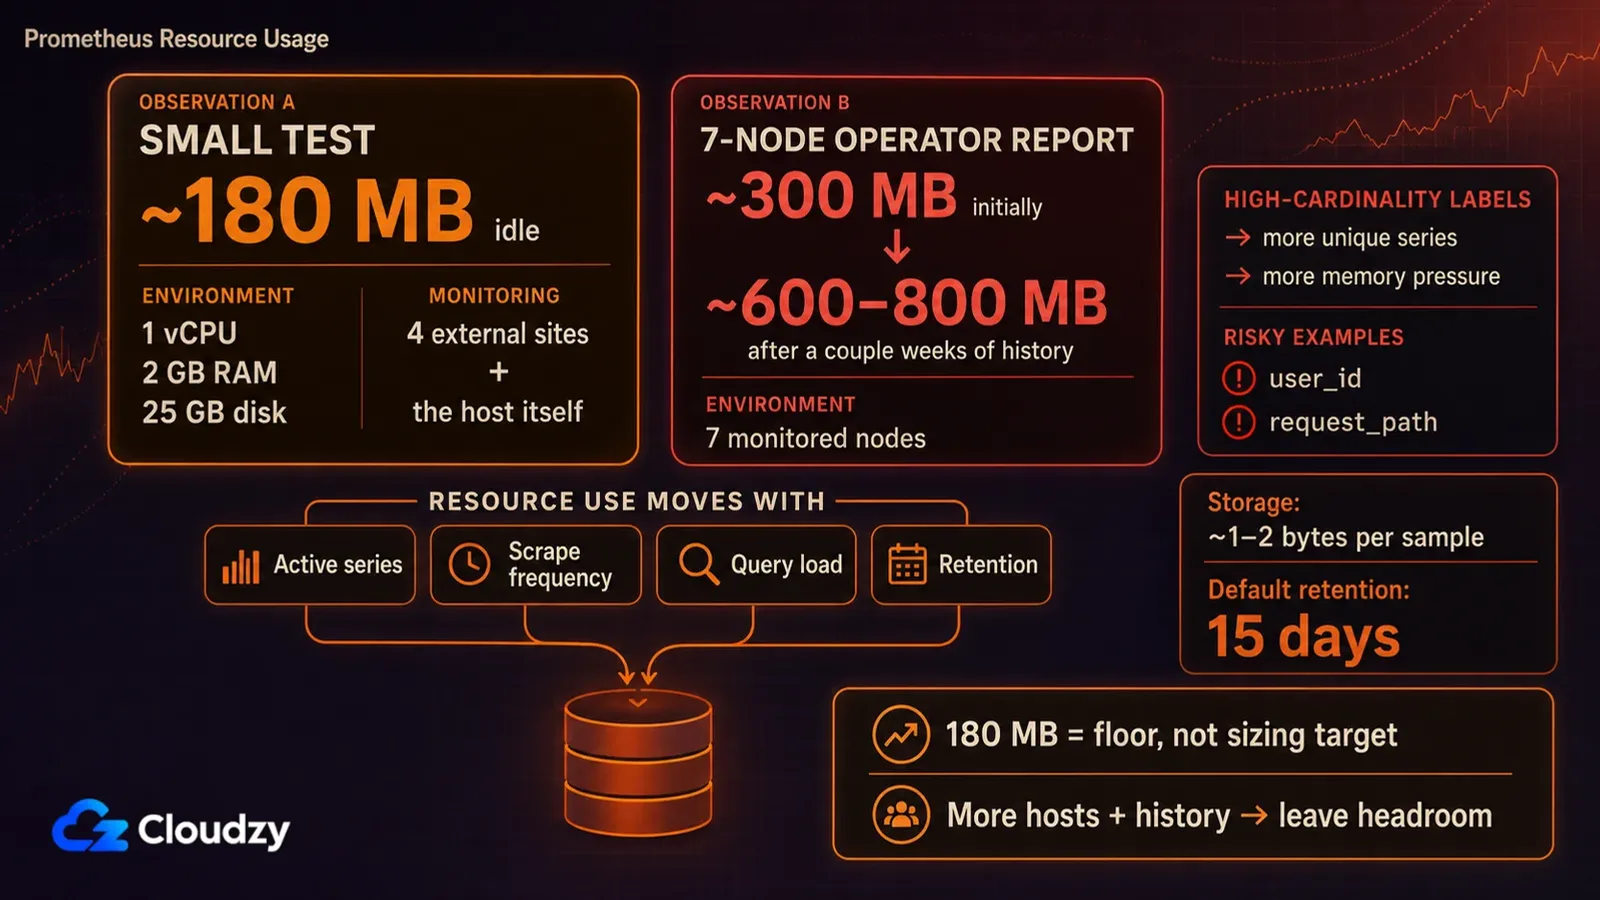
Nincs rögzített követelmény. Az aktív idősorok, a begyűjtési gyakoriság, a lekérdezési terhelés és a megőrzési idő többet nyom a latban, mint a szerverek puszta száma, amelyekre ráállítod. Két publikált gyakorlati teszt kis rendszereken nagyjából 180 MB és 800 MB közé teszi, a magasabb szám hét csomópontot fed le, néhány hétnyi előzménnyel.
A két teszt ellentmond egymásnak, és épp ez az ellentmondás a hasznos rész. Ugyanaz a hét eszközt összevető VPS-teszt mindegyiket azonos hardveren futtatta (1 vCPU, 2 GB RAM, 25 GB lemez, Ubuntu 24.04), négy külső oldalt és magát a gépet figyelve, és a Prometheust nagyjából 180 MB-on mérte üresjáratban. Ugyanaz az üzemeltető arról számolt be, hogy önmagában a Prometheus a központi gépen 300 MB körül állt üresjáratban, és 600-800 MB felé kúszott, amint néhány hétnyi előzmény összegyűlt.
Ezek nem ugyanazok a mérések, és épp ezért az átlagolásuk eldobná az információt. Az egyik egy szinte üresjárati leolvasás egy olyan gépen, amelynek nagyon kevés tárolnivalója van. A másik egy működő üzem, mögötte flottával és lemezen lévő előzményekkel. Az én olvasatom: a 180 MB-os eredményt tekintsd alsó határnak, ne méretezési célnak. Amint több gépről gyűjtesz és előzményt tartasz, hagyj tartalékot ahelyett, hogy arra az üresjárati számra terveznél.
A lemez a könnyebbik fele. A Prometheus tárolási dokumentációja átlagosan 1-2 bájtot ad meg mintánként, tehát hosszú előzményt tartani egy kis rendszernél olcsó. A csapda az alapértelmezésben van: a megőrzés alapértelmezetten 15 nap hacsak nem állítasz be megőrzési időt vagy megőrzési méretet. Egyetlen indítási kapcsoló választja el egy egész évtől, és pontosan az a fajta alapértelmezés, amiről szívesebben értesülsz most, mint akkor, amikor először keresed a múlt havi számokat, és kiderül, hogy három hete lejártak.
A memóriaszámot a kardinalitás hajtja felfelé: a különböző idősorok száma, ahol egy metrikán a címkék minden egyedi kombinációja saját idősorrá válik. Egyetlen rosszul választott címke egy nagy forgalmú metrikán több idősort hozhat létre, mint amennyit öt további szerver valaha, és ezt csendben teszi, pontosan olyan ütemben, ahogy a forgalmad éppen zajlik. (Egy felhasználói azonosító vagy egy kérésútvonal remek címkének látszik egészen addig, amíg meg nem számolod, hányféle van belőle.)
Bármilyen memóriaszámot is találsz a Prometheusról idézve, csak akkor használható, ha azt is tudod, hány idősor állt mögötte.
Mi történik, ha leáll a Prometheus szervered?
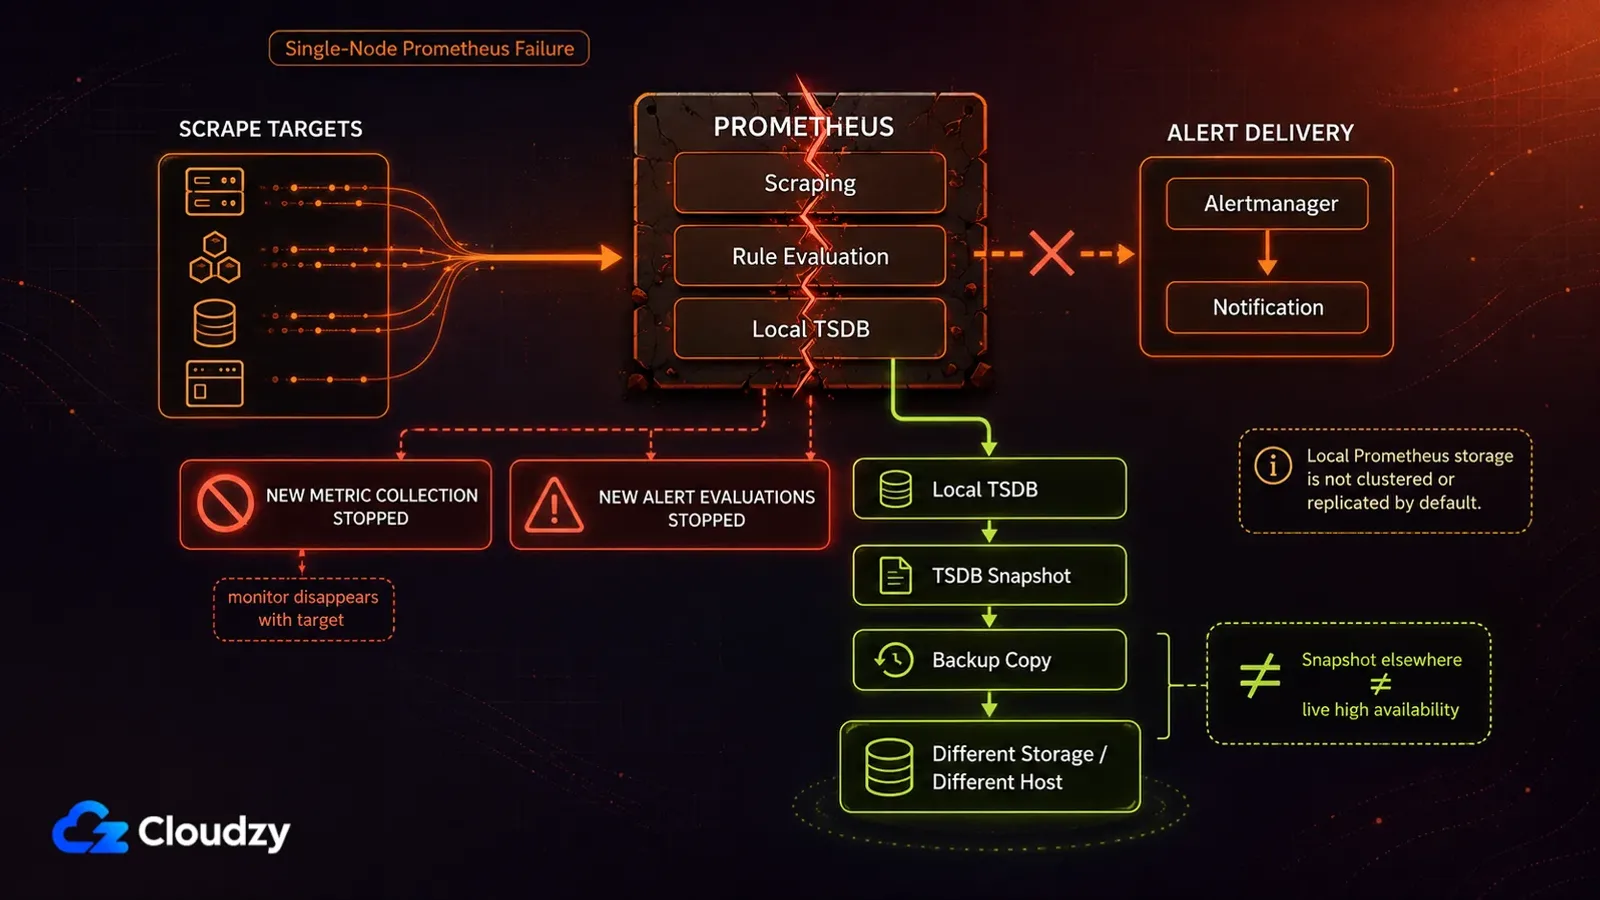
A Prometheus saját tárolási dokumentációja egyenesen fogalmaz erről: a helyi tároló nincs fürtözve és nincs replikálva, ezért nem éli túl egy meghajtó vagy egy csomópont meghibásodását. Minden szerver tervezetten önálló, és sem hálózati tárolótól, sem távoli szolgáltatásoktól nem függ, és pontosan ez az, ami könnyen üzemeltethetővé teszi, és pontosan ez az, ami kiszolgáltatottá hagyja.
At solo scale that turns into two problems. If the box holding Prometheus dies, new alert evaluations stop, and your history goes with it unless you were taking TSDB snapshots and managing it like the single-node database it is, taking TSDB snapshots and copying them somewhere else. And if that box is also one of the machines being monitored, which on a one-server setup it inevitably is, then the thing that tells you something broke is the same thing that broke. (Yes, that's about as useful as it sounds.)
Van egy másik határ is, amit a projekt saját magáról kijelent, és ezért elismerés jár neki: ha 100%-os pontosságra van szükséged, például kérésenkénti számlázáshoz, a dokumentáció szerint a Prometheus rossz választás, mert az általa gyűjtött adatok valószínűleg nem lesznek elég részletesek és teljesek. Amiről számlát állítasz ki, ahhoz használj mást, a Prometheust pedig tartsd meg monitorozásra. A gyártók általában nem szoktak maguktól ilyet mondani magukról.
Nagyobb méretben erre vannak bevett válaszok, és ugyanazért esnek itt kívül a kereteken, mint a Kubernetes-eszközök: más üzemeltetési elkötelezettséget jelentenek, mint amiről ez a teszt szól. Egyetlen VPS esetén az én olvasatom az, hogy a kockázat elfogadható, ha a TSDB-pillanatfelvételeket máshol tartod, vagy előre elfogadod, hogy elveszíted az előzményeket, és hogy valódi probléma, ha a Prometheus az egyetlen, ami közted és egy csendes kiesés között áll.
Kinek érdemes saját kézben tartania a Prometheust?
A legvilágosabb jel arra, hogy a Prometheus visszahozza az árát, semmi köze ahhoz, hány szervered van. Ahhoz van köze, hogy fél év múlva ugyanazok a szerverek lesznek-e. Kézzel beállított gépek stabil köre azt jelenti, hogy a konfigurációt egyszer írod meg, az előzményt pedig ingyen kapod; egy folyton változó kör azt jelenti, hogy folyton hozzá kell nyúlnod ahhoz a konfigurációhoz.
Egy statikus rendszerben a Prometheus- és Grafana-konfigurációd az infrastruktúrád kifejezett leírása: a begyűjtési célpontok, a rájuk aggatott címkék, és az ezekre a címkékre épített műszerfalak. Ezért van az, hogy a teljes hozadék az előzményben van. Egy évnyi adat egy stabil gépkörről megmutatja, hogy néz ki a normális, és ez a legmegbízhatóbb módja annak, hogy felismerd a rendellenest, mielőtt kieséssé válna.
Az első profil tehát az, aki kicsi, lassan változó szerverkört üzemeltet, és többet akar a fut vagy nem fut kérdésnél: kérések késleltetése az idő függvényében, memóriatrendek, egy lemez, amely elég fokozatosan telik ahhoz, hogy hetekkel előre lásd. Ha ma le tudod írni az infrastruktúrádat, és arra számítasz, hogy ez a leírás egy év múlva is nagyjából igaz lesz, akkor az az est, amit a beüzemeléssel töltesz, az utolsó nagy számla.
A második bárki, aki szándékosan tanulja ezt a rendszert. Ha arra számítasz, hogy néhány év múlva infrastruktúrát fogsz üzemeltetni, a sajátodat vagy valaki másét, akkor a PromQL-est pontosan az, amiért jöttél, a monitorozás pedig csak mellékhatás. Ez a profil részben megfordítja az elsőt: a stabilitási próba itt kevesebbet nyom, mert az újracímkézésre fordított idő egyben az arra fordított idő is, hogy megtanuld, mi is az újracímkézés. Ennek az olvasónak feljebb tenném az értékelést.
A harmadik profil a tulajdonlásról szól, és ezt szokták alábecsülni egészen addig, amíg egyszer a rossz oldalára nem kerülnek. A Prometheus nem számláz gépenként, metrikánként vagy címkénként, és semmilyen árlista nem változhat meg a lábad alatt jövő negyedévben. A csere egy felügyelt szolgáltatáshoz, például a Datadoghoz képest: lemondasz a kidolgozottságról, a támogatási szerződésről és valaki más ügyeletéről, cserébe olyan metrikákat kapsz, amelyek a tieid, egy számlán, ami nem mozdul, amikor egy fejlesztő új mérést vezet be. Hogy ez jó csere-e, attól függ, mennyit érnek a saját óráid, és ezt a számot csak te tudod beírni (és ritkán nulla, még akkor is, ha annak érződik).
Egy dolgot érdemes tudni, mielőtt elköteleződsz: kinőni a Prometheus helyi tárolóját nem zsákutca. A VictoriaMetrics fogadja a Prometheus remote write kéréseit, a MetricsQL visszafelé kompatibilis a PromQL-lel, tehát a legtöbb lekérdezés és Grafana-műszerfal, amit most építesz, túl kellene hogy élje a költözést. Ez migráció, nem újraírás.
Inkább évente egyszer érdemes újragondolni, mint egyszer s mindenkorra eldönteni: az a rendszer, amit ma olcsó monitorozni, abban a negyedévben drágul meg, amikor átépíteni kezded.

Építkezz Linux VPS-en root hozzáféréssel, NVMe-vel és AMD EPYC teljesítménnyel.
Linux csomagok megtekintéseKinek érdemes kihagynia a Prometheust?
Ha az a mondat, amivel a saját igényedet leírnád, úgy hangzik, hogy „szólj, ha leáll az oldal”, akkor egy elérhetőségfigyelőt írsz le, és a Prometheus rengeteg gépezet ahhoz, hogy eljuss addig a válaszig. Uptime Kuma pontosan ezt a munkát végzi el webes felülettel, és nem kéri, hogy megtanulj egy monitorozási lekérdezőnyelvet. A két eszköz közti képességbeli szakadék hatalmas, és teljesen lényegtelen ahhoz a feladathoz, amire felfogadod őket.
A második olvasó az, aki használható grafikonokat akar anélkül, hogy előbb lekérdezőnyelvet tanulna. A Netdata pontosan e köré épült: gépenkénti metrikák, amiket azonnal megnézhetsz, sokkal kevesebb konfigurációval, és semmi nem áll közted és a grafikonok között. Ha az a kérdés, amit újra és újra felteszel, hogy „miért lassú ez a gép most”, akkor ez sokkal rövidebb út a válaszig.
A harmadik bárki, akinek az infrastruktúrája gyakran vált alakot, és aki a célpontokat és a műszerfal-változókat kézzel kezeli. Egy hétre felhúzott, majd elpusztított gépek, átnevezett célpontok, félúton átnevezett projektek. Ez az az eset, amikor újra és újra megfizeted a konfigurációs költséget, miközben a legkevesebbet kapod abból, amiért fizetsz: egy felismerhető maradó rendszer folyamatos előzményéből.
Ebből semmi nem az eszköz bírálata. A „kihagyni” itt azt jelenti: kihagyni erre a feladatra, ebben a méretben. Kubernetes-méretben, ahol a szolgáltatásfelderítés elvégzi annak nagy részét, amit egyébként kézzel kellene összedrótoznod, a fenti költségek közül több összezsugorodik vagy teljesen eltűnik, és az én olvasatom arról a méretről az, hogy ott a Prometheust nagyon nehéz überelni. De az egy másik teszt.

Gyakran ismételt kérdések
Ingyenes a Prometheus?
Igen, és nincs alatta ingyenescsomag-csapda. A Prometheus Apache 2.0 licenc alatt áll, nem áll mögötte kereskedelmi kiadás, tehát nincs metrikakvóta, amit át lehetne lépni, és nincs bővítésre buzdító üzenet sem a túloldalon. Az infrastruktúráért és a saját idődért fizetsz, nem Prometheus-licencért.
Szüksége van a Prometheusnak Grafanára?
Nincs, de számolj vele. A Prometheus saját kifejezésböngészője arra való, hogy lefuttass egy lekérdezést és megnézd a választ, ami elég egyetlen dolog egyszeri ellenőrzéséhez. Bármi, amit nyitva akarsz hagyni egy második monitoron, az a Grafana dolga, és a kettőt szinte mindig együtt üzemeltetik.
Túlzás a Prometheus egyetlen szerverhez?
Gyakran igen. Ha csak azt kell tudnod, fut-e a szerver és futnak-e a szolgáltatásai, egy elérhetőségfigyelő ezt a telepítési idő töredéke alatt megválaszolja. A Prometheus akkor érdemli ki a helyét, ha lekérdezhető, múltbeli metrikákat akarsz, és hajlandó vagy megtanulni a PromQL-t, hogy hozzájuk férj.
Meddig őrzi meg a Prometheus a metrikákat alapértelmezetten?
15 napig, és előre nem figyelmeztet. A Prometheus eldobja a megőrzési ablaknál régebbi mintákat, hacsak indításkor meg nem emeled egy megőrzési idő vagy megőrzési méret kapcsolóval. Állítsd be azon a napon, amikor telepíted, mert az ablak későbbi kitágítása nem hozza vissza a már lejárt adatokat.



Beszélgetés
Hozzászólások
Jelentkezzen be a beszélgetéshez.