

O drugiej w nocy na VPS-ie, który nigdy nie zasnął, uruchamia się zaplanowane zadanie. Bezgłowe uruchomienie claude -p przetwarza zadanie z kolejki w sklonowanym repozytorium, nikogo o nic nie pytając, i kończy pracę. Rano czeka na ciebie commit, raport albo log pokazujący dokładnie, gdzie i dlaczego się zatrzymał. Nikt tego nie pilnował.
To coś innego niż zostawianie otwartego terminala na całą noc i liczenie na to, że połączenie SSH wytrzyma. Częstym punktem awarii nocnego uruchomienia agenta jest sam host: laptop zasypia, klapa się zamyka, sieć pada albo aktualizacja systemu restartuje maszynę w połowie zadania. Błędy uwierzytelniania, błędy API i zawieszenia na pytaniach o uprawnienia nadal mogą zabić zadanie, ale host działający bez przerwy usuwa najprostszą przyczynę awarii.
Ten przewodnik opisuje faktyczny mechanizm: flagi headless dostępne w każdym większym CLI agenta programistycznego, dwa sposoby uruchamiania zadania według harmonogramu i to, który wybrać, czego potrzebuje host pod spodem oraz zabezpieczenia, które nie pozwolą, by uruchomienie bez nadzoru kosztowało lub zepsuło więcej, niż chciałbyś później tłumaczyć.
Krótka wersja
- Każde większe CLI agenta programistycznego ma udokumentowany tryb nieinteraktywny, który wykonuje jeden prompt do końca i kończy pracę. Claude Code ma
claude -p, Codex CLI macodex exec, a Gemini CLI magemini -p. To nie obejście, tylko oficjalna funkcja. - Claude Code ma też własne harmonogramy: Routines, zaplanowane zadania Desktop oraz
/loop. Dla części czytelników to naprawdę wystarczy i jest mniej do utrzymania niż przy VPS-ie. - Cron w zupełności wystarczy do nocnego zadania. Na maszynie, która może się zrestartować, lepszym domyślnym wyborem jest timer systemd, ponieważ
Persistent=truewyłapuje uruchomienie, które cron po cichu by pominął. - Samo CLI jest lekkie, bo wnioskowanie odbywa się w API dostawcy. Dobierz VPS pod komendy, które będzie uruchamiał (testy, buildy, kontenery, zadania równoległe), a nie pod model.
- To zabezpieczenia sprawiają, że można bezpiecznie zostawić harmonogram samemu sobie: zawężone narzędzia, limit tur i rozgałęzianie po kodzie wyjścia. Sam harmonogram nie jest mechanizmem bezpieczeństwa.
Czego będziesz potrzebować
Przygotuj te pięć rzeczy, zanim napiszesz choćby jedną linię crontaba lub plik jednostki:
- VPS, do którego masz dostęp przez SSH, z dystrybucją Linuksa opartą na systemd.
- CLI agenta zainstalowane na tym VPS-ie: Claude Code, Codex CLI lub Gemini CLI.
- Nieinteraktywne poświadczenie dla wybranego CLI. Tryb bare w Claude Code nie czyta logowania do konta, więc potrzebuje
ANTHROPIC_API_KEYw środowisku alboapiKeyHelperw ustawieniach. Zwykłe uruchomienie w trybie print, Codex i Gemini mogą też korzystać z udokumentowanych poświadczeń logowania do konta. - Repozytorium lub katalog zadania, na którym agent będzie pracował.
- Dostęp do powłoki z prawem edycji crontaba lub zapisu pliku jednostki systemd.
Uruchamianie agenta bez podłączonej sesji
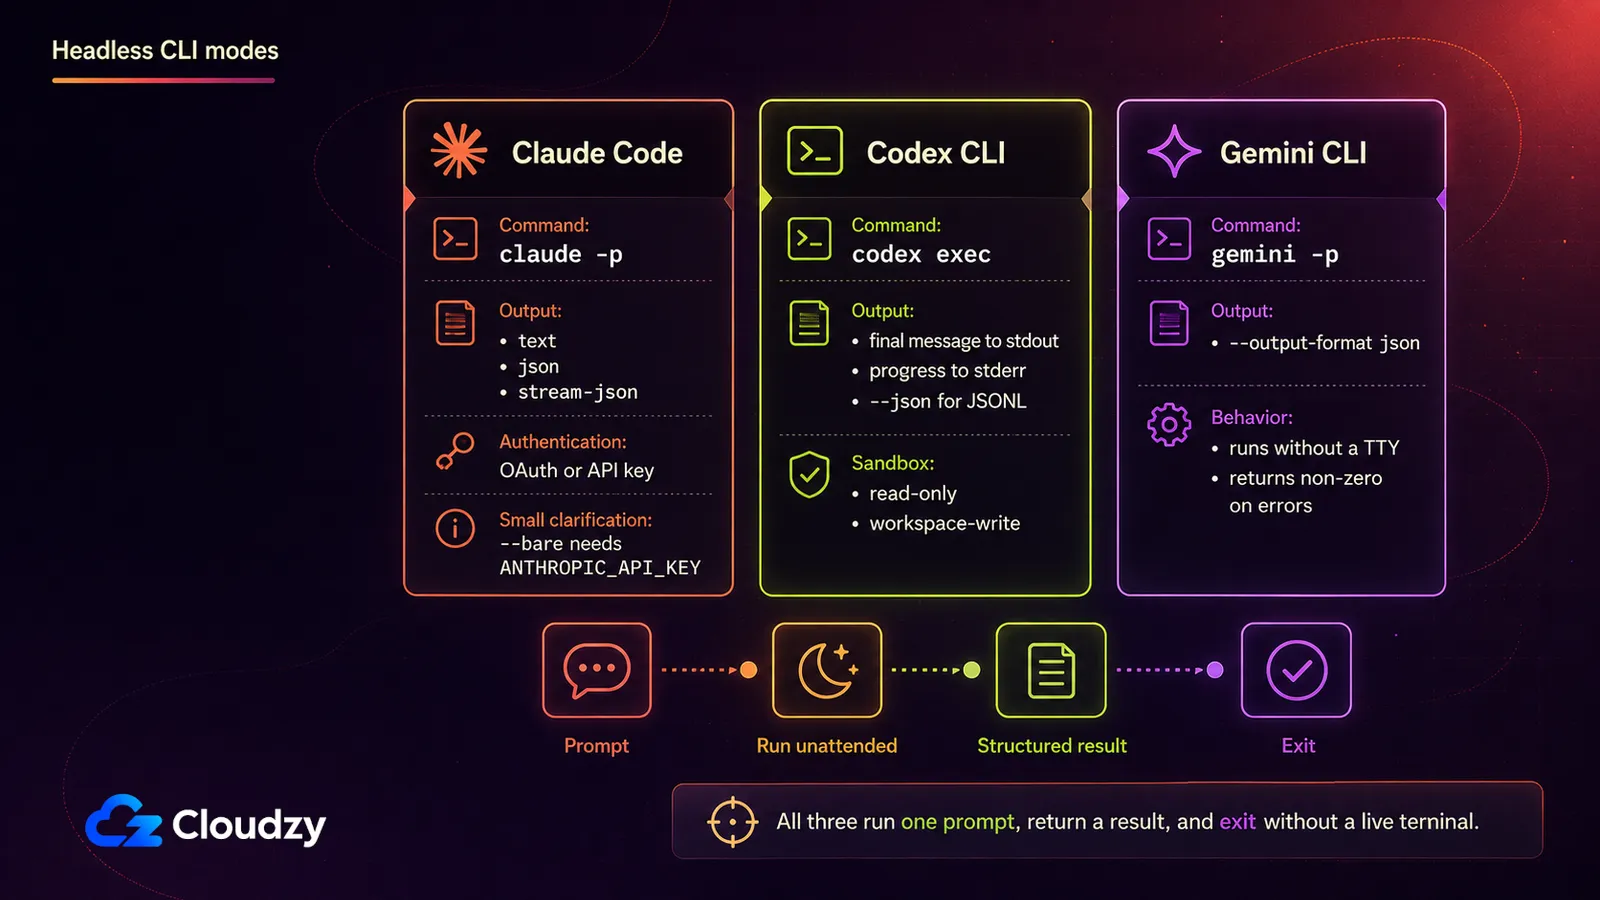
Każde większe CLI agenta programistycznego ma tryb nieinteraktywny stworzony dokładnie do tego. Claude Code przyjmuje -p, zapisywane też jako --print. Codex CLI przyjmuje codex exec. Gemini CLI przyjmuje -p, zapisywane też jako --prompt. Każdy z nich przyjmuje prompt, wykonuje go do końca i kończy pracę. Bez pętli czatu, bez terminala, który trzeba trzymać otwarty, bez niczego, do czego trzeba by wracać.
Czy Claude Code może działać bez aktywnej sesji? Tak. Podanie -p uruchamia prompt w trybie nieinteraktywnym: Claude Code wykonuje go do końca, wypisuje wynik i kończy pracę. Nie ma pętli czatu ani niczego, co trzeba utrzymywać przy życiu, a całość działa na tym samym Agent SDK co interaktywne CLI, według własna dokumentacja Anthropic dotycząca trybu headless.
| CLI | Flaga nieinteraktywna | Zachowanie | Wyjście strukturalne |
|---|---|---|---|
| Claude Code | -p / --print | Wykonuje prompt do końca, wypisuje wynik, kończy pracę | --output-format ustawione na text, json lub stream-json |
| Codex CLI | codex exec | Strumieniuje postęp na stderr, zapisuje końcowy komunikat na stdout, kończy pracę | --json dla strumienia zdarzeń JSONL |
| Gemini CLI | -p / --prompt | Wykonuje prompt nieinteraktywnie i kończy pracę | --output-format json |
Najważniejsze są tutaj własne flagi Claude Code, bo to pod nie faktycznie będziesz pisać skrypty. Dwie z nich pozwalają uruchomieniu iść dalej bez zatrzymywania się na pytanie o uprawnienie, którego nikt o tej porze nie udzieli: --allowedTools, która z góry zatwierdza konkretne narzędzia, oraz --permission-mode, która ustala poziom bazowy dla całego uruchomienia. --max-turns ogranicza liczbę tur agenta, jakie może wykonać uruchomienie, zanim zakończy się błędem.
--bare pomija hooki, skille, wtyczki, serwery MCP i instrukcje projektu takie jak CLAUDE.md, dla szybszego i bardziej deterministycznego uruchomienia ze skryptu. To oznacza też, że każda instrukcja, od której zależy zadanie, musi znaleźć się w promptzie albo w poleceniu. Tryb bare nie czyta również logowania do konta, więc dokumentacja Anthropic mówi, żeby ustawić klucz API w środowisku przed uruchomieniem. Claude Code odrzuca --bg wprost, gdy zostanie połączone z -p, i odrzuca --cloud tak samo, gdy podasz mu opis zadania. Nazywa konflikt i zatrzymuje się, zamiast robić coś niejednoznacznego.
Gotowe wywołanie, dostosuj prompt i listę narzędzi do swojego zadania:
claude --bare -p "Review open PRs in this repo and summarize any blockers in NOTES.md" \
  --allowedTools "Bash(gh pr list *),Bash(gh pr view *),Bash(gh pr diff *),Read,Edit" \
  --permission-mode dontAsk \
  --max-turns 8 \
  --max-budget-usd 5.00 \
  --output-format json
Dopasuj budżet i wzorce poleceń do zadania; ten przykład zakłada też, że uwierzytelnianie GitHub CLI jest już skonfigurowane dla konta, które go uruchamia.
Jeśli konfigurujesz Claude Code na świeżym VPS-ie i chcesz instrukcję uwierzytelniania na maszynie bez przeglądarki, opisujemy to osobno w jak uwierzytelnić Claude Code na serwerze headless; krótka wersja powyżej wystarczy, by zaplanowane uruchomienie działało.
Tryb exec w Codex CLI, opisany w dokumentacja OpenAI dotycząca trybu nieinteraktywnego, przyjmuje --sandbox do wyboru polityki. read-only to wartość domyślna, workspace-write pozwala agentowi zapisywać w jego przestrzeni roboczej, a --json zamienia stdout w strumień zdarzeń możliwy do sparsowania maszynowo zamiast zwykłego tekstu. Unikaj danger-full-access w zadaniu bez nadzoru, chyba że proces jest odizolowany, a to ryzyko jest świadome.
Tryb headless w Gemini CLI, udokumentowany w własna dokumentacja headless projektu, włącza się automatycznie w środowisku bez TTY albo jawnie przez -p. Kończy się osobnym niezerowym kodem dla błędu ogólnego, błędu wejścia i osiągnięcia limitu tur, zamiast jednego ogólnego kodu błędu.
Gdzie powinien mieszkać harmonogram
Zanim zabierzesz się za całą tę konfigurację: być może dostawca agenta już to za ciebie planuje. Claude Code oferuje trzy wbudowane opcje, a jedna z nich może naprawdę pasować lepiej niż samodzielnie zarządzany VPS.
| Chmura (Routines) | Zaplanowane zadanie Desktop | /loop | |
|---|---|---|---|
| Działa na | Chmura Anthropic | Twoja maszyna | Twoja maszyna |
| Maszyna musi być włączona | Nie wymagane | Wymagane | Wymagane |
| Wymaga otwartej sesji | Nie wymagane | Nie wymagane | Wymagane |
| Minimalny interwał | 1 godzina | 1 minuta | 1 minuta |
| Dostęp do plików lokalnych | Brak, działa na świeżym klonie | Pełny dostęp | Pełny dostęp |
Własna dokumentacja Anthropic o zaplanowanych zadaniach przedstawia to jako prawdziwy wybór spośród trzech opcji, a nie hierarchię z VPS-em na szczycie. Jeśli twoje zadanie nie potrzebuje stanu lokalnego, zniesie godzinny próg, a używasz tylko Claude Code, Routines wymaga mniej utrzymania niż to, co opisujemy dalej: Anthropic uruchamia je w chmurze ze świeżego klonu, kiedy twoja maszyna jest wyłączona.
/loop warto znać, ale nie pasuje do tego zastosowania, bo wymaga otwartej, bezczynnej sesji, czyli dokładnie tego ograniczenia, które chcesz usunąć. Ta sama dokumentacja wskazuje też GitHub Actions jako czwartą opcję, dla zespołów, których wyzwalacz i tak żyje w CI, a nie w harmonogramie przypiętym do jednej konkretnej maszyny.
Samodzielnie zarządzany VPS zasługuje na swoje miejsce, gdy zadanie potrzebuje pełnego dostępu do lokalnego systemu plików i narzędzi, gdy chcesz, by ten sam mechanizm działał identycznie w Claude Code, Codex CLI i Gemini CLI, albo gdy interwał dopuszczany przez Routines jest zbyt zgrubny. Klasyczna funkcja serverless zwykle się tu nie sprawdza, bo musi odtworzyć poświadczenia, sklonować repozytorium i zmieścić się w limitach czasu wykonania platformy. Efemeryczny runner CI, taki jak GitHub Actions, pozostaje sensowną trzecią drogą, jeśli świeży checkout przy każdym uruchomieniu jest do przyjęcia. Jeśli masz już bezczynny sprzęt działający bez przerwy, maszyna w domowym labie też się nada; w zamian polegasz na niezawodności swojej sieci domowej i zdalnego dostępu zamiast na dostawcy.
Cron czy timer systemd?
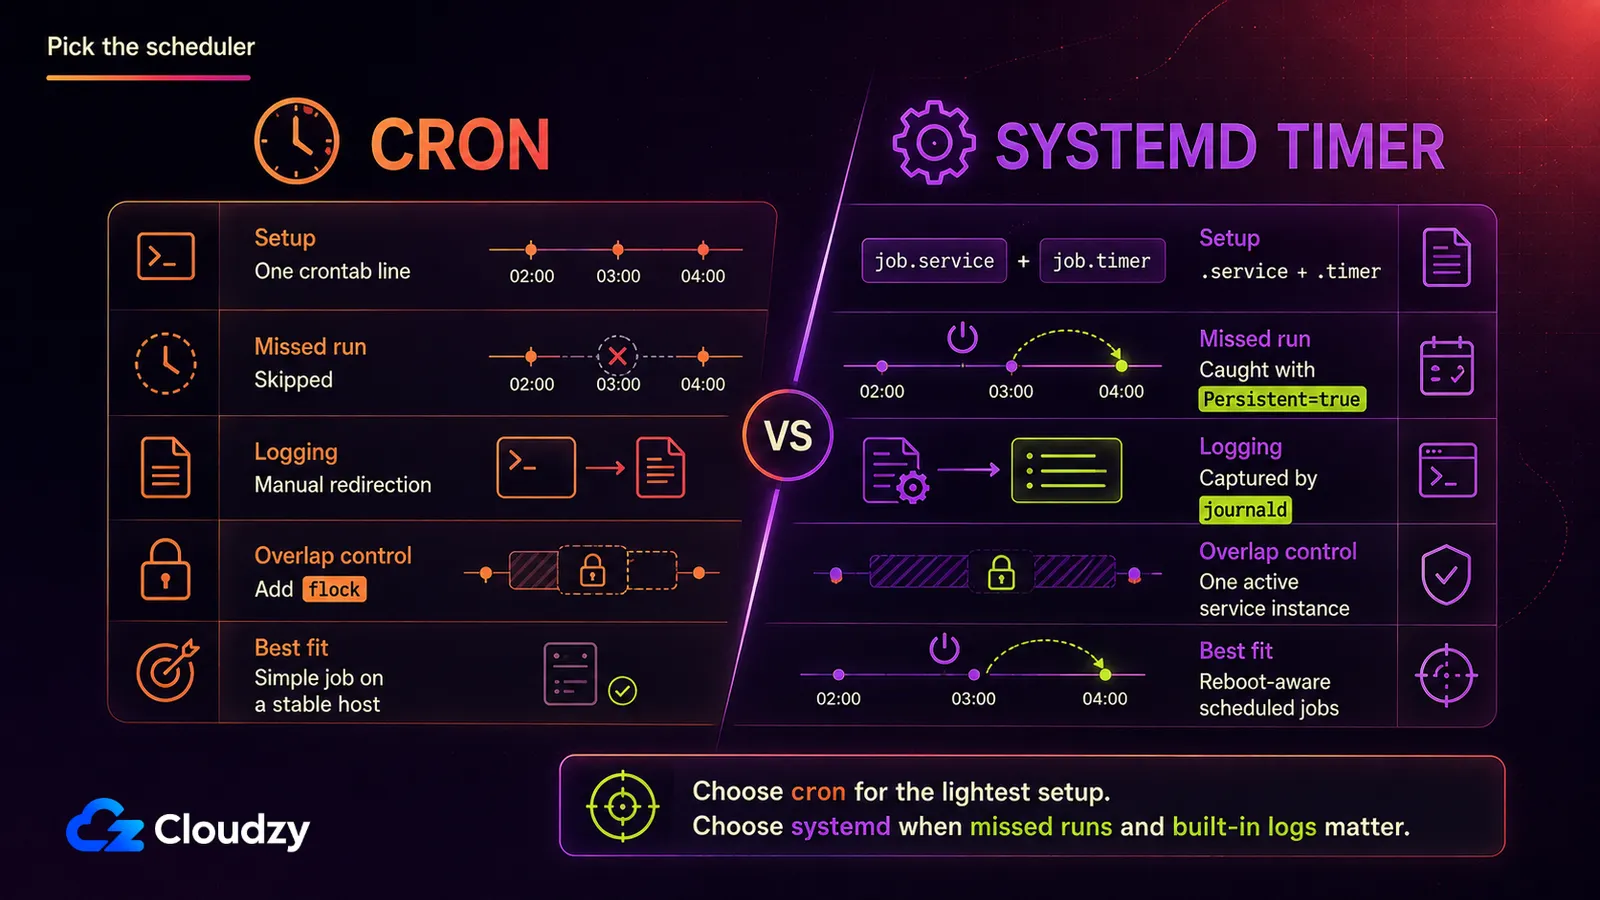
Oba narzędzia potrafią odpalić to samo polecenie według tego samego harmonogramu, ale różnią się tym, co dzieje się po restarcie maszyny, i tym, ile kosztuje konfiguracja każdego z nich:
| cron | timer systemd | |
|---|---|---|
| Nakład na konfigurację | Jedna linia crontaba | Plik .timer i plik .service |
| Nadrabianie pominiętych uruchomień | Brak, pominięte uruchomienie po prostu przepada | Persistent=true uruchamia je, gdy tylko system wróci |
| Rejestrowanie | Ręcznie, sam przekierowujesz wyjście | Automatycznie, przechwytuje journald |
| Kolejność zależności | Nic | Pełna kolejność systemd z After= i Requires= |
Zwykły cron w zupełności wystarczy do nocnego zadania na maszynie, która rzadko się restartuje. Haczyk tkwi w środowisku: cron startuje z minimalnym PATHPATH, nie wchodzi za ciebie do repozytorium i bez wahania uruchomi drugą kopię, gdy pierwsza jeszcze działa. Ścieżkę repozytorium, wąsko określone polecenie agenta i wczytywanie poświadczeń umieść w zabezpieczonym skrypcie opakowującym, a następnie użyj flock , aby nie dopuścić do nakładających się uruchomień.
# /usr/local/bin/agent-nightly
#!/usr/bin/env bash
set -euo pipefail
export PATH=/usr/local/bin:/usr/bin:/bin
export ANTHROPIC_API_KEY="$(
  cat "$HOME/.config/agent-nightly/anthropic_api_key"
)"
cd /srv/myrepo
exec /usr/local/bin/claude --bare -p \
  "Run the nightly dependency audit and write the findings to NOTES.md" \
  --allowedTools "Bash(npm audit *),Read,Edit" \
  --permission-mode dontAsk \
  --max-turns 8 \
  --max-budget-usd 5.00 \
  --output-format json
# crontab -e
0 2 * * * /usr/bin/flock -n "$HOME/.local/state/agent-runs/nightly.lock" /usr/local/bin/agent-nightly >> "$HOME/.local/state/agent-runs/nightly.log" 2>&1Raz utwórz katalogi na poświadczenia i logi, a następnie nadaj skryptowi opakowującemu prawo wykonywania:
install -d -m 700 \
  "$HOME/.config/agent-nightly" \
  "$HOME/.local/state/agent-runs"
touch "$HOME/.config/agent-nightly/anthropic_api_key"
chmod 600 "$HOME/.config/agent-nightly/anthropic_api_key"
"${EDITOR:-nano}" \
  "$HOME/.config/agent-nightly/anthropic_api_key"
sudo chmod 755 /usr/local/bin/agent-nightly
Do pliku poświadczeń wklej wyłącznie klucz API. Nie umieszczaj go bezpośrednio w crontabie.
Timer systemd wymaga więcej konfiguracji i daje dwie rzeczy, których cron nie ma: logowanie przez journald bez ręcznego przekierowania oraz Persistent=true. Poniższy przykład zakłada, że dedykowane konto agent-runner jest właścicielem katalogu /srv/myrepo. Klucz API trzymaj w pliku poświadczeń dostępnym tylko dla roota, zamiast wpisywać go w jednostkę.
Według podręcznik systemd.timer, ustawienie Persistent=true oznacza, że „jednostka usługi zostaje wyzwolona natychmiast, jeśli zostałaby wyzwolona co najmniej raz w czasie, gdy timer był nieaktywny". Uruchomienie, które nastąpiłoby, gdy twój VPS restartował się z powodu aktualizacji jądra, odpali więc, gdy tylko maszyna wróci, zamiast po cichu przepaść do następnego zaplanowanego terminu.
Utwórz plik poświadczeń dostępny tylko dla roota, z którego korzysta usługa:
sudo install -d -m 700 /etc/agent-nightly
sudo touch /etc/agent-nightly/anthropic_api_key
sudo chmod 600 /etc/agent-nightly/anthropic_api_key
sudoedit /etc/agent-nightly/anthropic_api_key
Do pliku wklej wyłącznie klucz API.
# /etc/systemd/system/agent-nightly.service
[Unit]
Description=Nightly scoped agent run
After=network-online.target
Wants=network-online.target

[Service]
Type=oneshot
User=agent-runner
Group=agent-runner
WorkingDirectory=/srv/myrepo
Environment=HOME=/home/agent-runner
Environment=PATH=/usr/local/bin:/usr/bin:/bin
LoadCredential=anthropic_api_key:/etc/agent-nightly/anthropic_api_key
ExecStart=/bin/sh -c 'export ANTHROPIC_API_KEY="$(cat "$CREDENTIALS_DIRECTORY/anthropic_api_key")"; exec /usr/local/bin/claude --bare -p "Run the nightly dependency audit and write the findings to NOTES.md" --allowedTools "Bash(npm audit *),Read,Edit" --permission-mode dontAsk --max-turns 8 --max-budget-usd 5.00 --output-format json'
StandardOutput=journal
StandardError=journal
UMask=0077
# /etc/systemd/system/agent-nightly.timer
[Unit]
Description=Run agent-nightly.service at 2am daily, catching up missed runs
[Timer]
# Uses the VPS's configured local timezone
OnCalendar=*-*-* 02:00:00
Persistent=true
Unit=agent-nightly.service
[Install]
WantedBy=timers.targetPrzeładuj systemd, włącz timer i od razu raz uruchom usługę, żeby problemy z poświadczeniami, uprawnieniami i ścieżkami wyszły teraz, a nie o drugiej w nocy:
sudo systemctl daemon-reload
sudo systemctl enable --now agent-nightly.timer
sudo systemctl start agent-nightly.service
systemctl list-timers agent-nightly.timer
sudo journalctl \
  -u agent-nightly.service \
  -n 100 \
  --no-pager
Persistent=true to różnica decydująca: timer pamięta pominięte uruchomienie kalendarzowe, zamiast po cichu je porzucać.
Czego naprawdę potrzebuje VPS
To właśnie zaskakuje tych, którzy dobierają zasoby po raz pierwszy: samo CLI jest lekkie, bo wnioskowanie odbywa się w API dostawcy. Ale agent wciąż może lokalnie uruchamiać buildy, testy, menedżery pakietów, serwery języków i kontenery, więc realny próg wyznacza obciążenie repozytorium.
Dla jednego lekkiego zadania cyklicznego przyjmij jako punkt wyjścia 1-2 vCPU i 2-4 GB RAM z dyskiem NVMe. Duże repozytoria, kompilatory, buildy Dockera, zestawy testów albo równoległe uruchomienia mogą wymagać znacznie więcej. Do zwiększania zasobów zmusza najcięższe lokalne polecenie, które uruchomi agent, a nie model po drugiej stronie API. Jeśli na tym VPS-ie już uruchamiasz obciążenia Dockera i chcesz pełniejszy obraz budżetu, dobór zasobów i zabezpieczenie maszyny buildowej omawia ten sam kompromis dla innego obciążenia działającego bez nadzoru.
Jeszcze jedna rzecz warta zaplanowania: uruchomienie bez nadzoru produkuje logi każdej nocy, niezależnie od tego, czy coś poszło nie tak. Dodaj logrotate , jeśli cron pisze do pliku, i sprawdź limity retencji journalda, zamiast zakładać, że domyślne wartości pasują do dysku VPS-a.
Całe podejście opiera się na hoście, który o drugiej w nocy nie śpi i taki pozostaje, niezależnie od tego, co robi twój laptop. To dokładnie zadanie dla Linux VPS z dostępem root. Nic go nie uśpi, a nie dzielisz go z czyimiś zadaniami cron.

Twórz na VPS Linux z dostępem root, NVMe i mocą AMD EPYC.
Zobacz plany LinuxJak nie dopuścić, by uruchomienie bez nadzoru poszło źle
Największa różnica między zaplanowanym uruchomieniem, które działa, a takim, które nie działa, polega na tym, czy zadanie jest na tyle wąskie, by skończyć się bez człowieka odpowiadającego na pytanie w trakcie. Ambitne prompty utykają w oczekiwaniu na decyzję, której nikt nie podejmie; wąskie, samowystarczalne zadania kończą się i zamykają czysto.
Te dwie flagi uprawnień istnieją po to, by uruchomienie nie utknęło o drugiej w nocy na pytaniu, ale goły dostęp do Bash nie jest wąskim zabezpieczeniem: może zrobić prawie wszystko, co może konto usługi. Wybieraj reguły dla konkretnych poleceń, takie jak Bash(git status *), łącz je z --permission-mode dontAsk i uruchamiaj usługę na dedykowanym koncie innym niż root. Liczba tur i wydatki mają własne pułapy: --max-turns ogranicza, jak długo agent może błądzić, a --max-budget-usd nakłada limit na to, ile pojedyncze uruchomienie może wydać na wywołania API.
Wskazówka: uruchamiaj z --output-format json i zapisuj pole total_cost_usd z każdego wywołania. To najczystszy punkt zaczepienia, żeby śledzić, ile zaplanowane uruchomienie naprawdę kosztuje na noc, i żeby dostać alert, gdy jedno uruchomienie kosztuje wyraźnie więcej niż pozostałe. Warte tych pięciu minut, bo śledzi twój rachunek, a nie abstrakcję.
Przekroczenia kosztów przy uruchomieniach bez nadzoru nie są hipotetyczne. W jednym z wpisów na Hacker Newsużytkownik opisał rachunek brutto z AWS Bedrock na 37 901,73 dolara, wynikający z codziennego workflow z agentem programistycznym, w którym cachowanie promptów działało tylko częściowo, przez co około 6,47 miliarda tokenów wejściowych pozostało bez cache'u. Stało się to w innym stosie, nie w trybie headless Claude Code, ale pokazuje, dlaczego logowanie kosztów i twardy budżet na uruchomienie należą do harmonogramu.
Wskazówka: Claude Code kończy się kodem 0 przy powodzeniu i kodem niezerowym przy niepowodzeniu. Skrypt opakowujący sprawdzający status wyjścia może wysłać ci powiadomienie o błędzie, dzięki czemu nieudana noc wyjdzie na jaw następnego ranka, a nie trzy dni później, kiedy przypadkiem zajrzysz.
Co najmniej uruchamiaj każde zadanie na osobnej gałęzi albo w jednorazowym worktree i wymagaj przeglądu przez człowieka przed scaleniem. Poświadczenia o wąskim zakresie, izolacja systemu plików i kontrola zasięgu szkód na poziomie serwera to większy temat, który zasługuje na osobne opracowanie, a nie na akapit doklejony do poradnika o harmonogramach.
To zabezpieczenia sprawiają, że harmonogram można bezpiecznie zostawić samemu sobie: sam harmonogram nie jest mechanizmem bezpieczeństwa.
Kiedy cron przestaje wystarczać
Jeden prompt na timerze nie potrzebuje niczego ponad to, co już tu opisano. Trzy połączone kroki z warunkiem, ponowieniem i powiadomieniem na Slacku potrzebują czegoś innego.
Warto znać trzy opcje, każda o poziom wyżej z innego powodu:
- Dagu to najlżejszy krok wyżej: samodzielne zadania definiowane w YAML, z zależnościami w formie DAG, ponowieniami i interfejsem webowym do podglądu tego, co się wykonało.
- n8n sprawdza się najlepiej, gdy uruchomienie agenta jest jednym węzłem wśród kilku integracji i powiadomień, a nie całym workflow.
- Kestra jest najcięższy z całej trójki, zbudowany do orkiestracji potoków danych i infrastruktury, i jest właściwą odpowiedzią, gdy zaplanowanie agenta stanowi część większego potoku, a nie jego cel.
Dla czytelnika uruchamiającego jeden nocny prompt wszystkie trzy to przesada i lepiej powiedzieć to wprost, niż wciskać ci cięższą konfigurację, niż potrzebujesz. Jeśli łańcuch kroków kiedyś naprawdę któryś uzasadni, Dagu, n8n oraz Kestra wdrażają się jednym kliknięciem, co jest realnym udogodnieniem dokładnie w chwili, gdy ważysz, czy koszt konfiguracji się opłaca.
Frameworki do orkiestracji wielu agentów, takie jak LangChain czy CrewAI, to zupełnie inny temat: budowanie systemów agentowych, a nie planowanie już istniejącego CLI.
Często zadawane pytania
Czy Claude Code może działać bez aktywnej sesji?
Tak. Podanie -p uruchamia prompt w trybie nieinteraktywnym: Claude Code wykonuje go do końca, wypisuje wynik i kończy pracę, bez pętli czatu i bez sesji, którą trzeba trzymać otwartą.
Czy potrzebuję VPS-a, skoro Claude Code ma już Routines?
Nie zawsze. Routines działa w chmurze Anthropic przy wyłączonej maszynie i startuje ze świeżego klonu, ale nie sięgnie po pliki istniejące tylko na twoim komputerze i ma minimalny interwał jednej godziny. Samodzielnie zarządzany VPS zasługuje na swoje miejsce, gdy zadanie potrzebuje plików lokalnych, dowolnych interwałów albo mechanizmu działającego tak samo w CLI więcej niż jednego dostawcy.
Cron czy timer systemd dla zaplanowanego agenta?
Timer systemd, jeśli VPS kiedykolwiek restartuje się do konserwacji. Persistent=true uruchamia zadanie, które miało odpalić w czasie przestoju, gdy tylko system wróci, a cron nie ma żadnego odpowiednika. Do nocnego zadania na maszynie, która nie gaśnie, cron w zupełności wystarczy.
Ile pamięci RAM potrzebuje zaplanowany agent AI na VPS?
Zacznij od około 1-2 vCPU i 2-4 GB RAM dla jednego lekkiego zadania cyklicznego, a potem dobierz zasoby pod najcięższe lokalne polecenie, które uruchomi agent. Buildy, testy, Docker, duże repozytoria i równoległe uruchomienia liczą się o wiele bardziej niż zdalne wnioskowanie modelu.
Czy uruchamianie agenta według harmonogramu zmienia sposób rozliczania?
Harmonogram nie tworzy osobnego trybu rozliczania. Claude Code -p może korzystać z poświadczeń subskrypcji albo klucza API, ale --bare ignoruje logowanie do subskrypcji, więc potrzebuje ANTHROPIC_API_KEY w środowisku albo apiKeyHelper w ustawieniach. Codex i Gemini korzystają z tej metody uwierzytelniania, którą skonfigurowałeś dla ich CLI. Ponieważ ceny i warunki korzystania szybko się zmieniają, przy wdrażaniu sprawdź aktualny cennik dostawcy i własne dane o zużyciu. Przy uruchomieniach Claude Code przez API możesz dodatkowo logować pole total_cost_usd z wyjścia JSON.



Dyskusja
Komentarze
Zaloguj się, aby dołączyć do dyskusji.