Najlepsze narzędzia AI typu design-to-code, uporządkowane według tego, od czego zaczynasz
Wybierz właściwe narzędzie AI design-to-code dla pliku Figma, zrzutu ekranu, promptu lub bazy kodu. Zobacz kompromisy i sposób testowania każdej ścieżki.
Wybierz kraj, aby zobaczyć Cloudzy w swoim języku.
Kategoria
41 posts
Wybierz właściwe narzędzie AI design-to-code dla pliku Figma, zrzutu ekranu, promptu lub bazy kodu. Zobacz kompromisy i sposób testowania każdej ścieżki.
SOTA to studencka społeczność, która przygotowuje uczniów do IOAI i krajowych olimpiad AI. Zobacz, jak Cloudzy napędza jej rosnącą platformę.
Najlepsze narzędzia AI dla startupów według ceny, darmowego planu i samoobsługi oraz ile kosztuje praktyczny zestaw AI dla małej firmy.
Wskaźniki ryzyka utraty pracy przez AI powstają różnymi metodami, od teoretycznej ekspozycji po obserwowane użycie, i żaden nie przewiduje wprost utraty pracy. Oto jak działa każda
Czołowe firmy od układów AI porównane według realnego dostępu: zobacz, które akceleratory w 2026 roku wynajmiesz, kupisz, użyjesz przez API albo zdobędziesz tylko przez sprzedaż ko
Uruchamiaj Claude Code, Codex CLI lub Gemini CLI bez nadzoru w nocy: flagi headless, cron kontra timery systemd na stale włączonym VPS, dobór zasobów i limity kosztów.
Przygotuj serwis na agentów AI: które roboty blokować, co naprawdę wymusza robots.txt, dlaczego nikt nie czyta llms.txt i jak dobrać zasoby pod obciążenie od robotów.
Nie uruchomisz agentów AI 24/7 na MacBooku, który wciąż zamykasz. Dlaczego sposoby na blokowanie uśpienia zawodzą, co zamiast nich robi serwer za $5 i ile kosztuje dziś Mac mini.
Uczenie maszynowe chroniące prywatność zabezpiecza wrażliwe dane dzięki uczeniu federacyjnemu, prywatności różnicowej, FHE i SMPC. Sprawdź, co każda z tych metod potrafi, a czego n
Agenty kodowania AI czytają CLAUDE.md, AGENTS.md, reguły i pamięć przed Twoim wpisem. Oto co robi wstępne ładowanie kontekstu i kiedy szkodzi.
OpenClaw, OpenHuman i Hermes Agent przyjmują trzy różne podejścia do samodzielnie hostowanej osobistej AI. Porównaj architekturę, bezpieczeństwo i wdrożenie.
Porównaj GPT-5.6 Sol i Claude Fable 5 przed migracją z Claude Code do Codex. Zobacz, co importuje się bez problemu i jak przetestować Sol bez utraty konfiguracji.
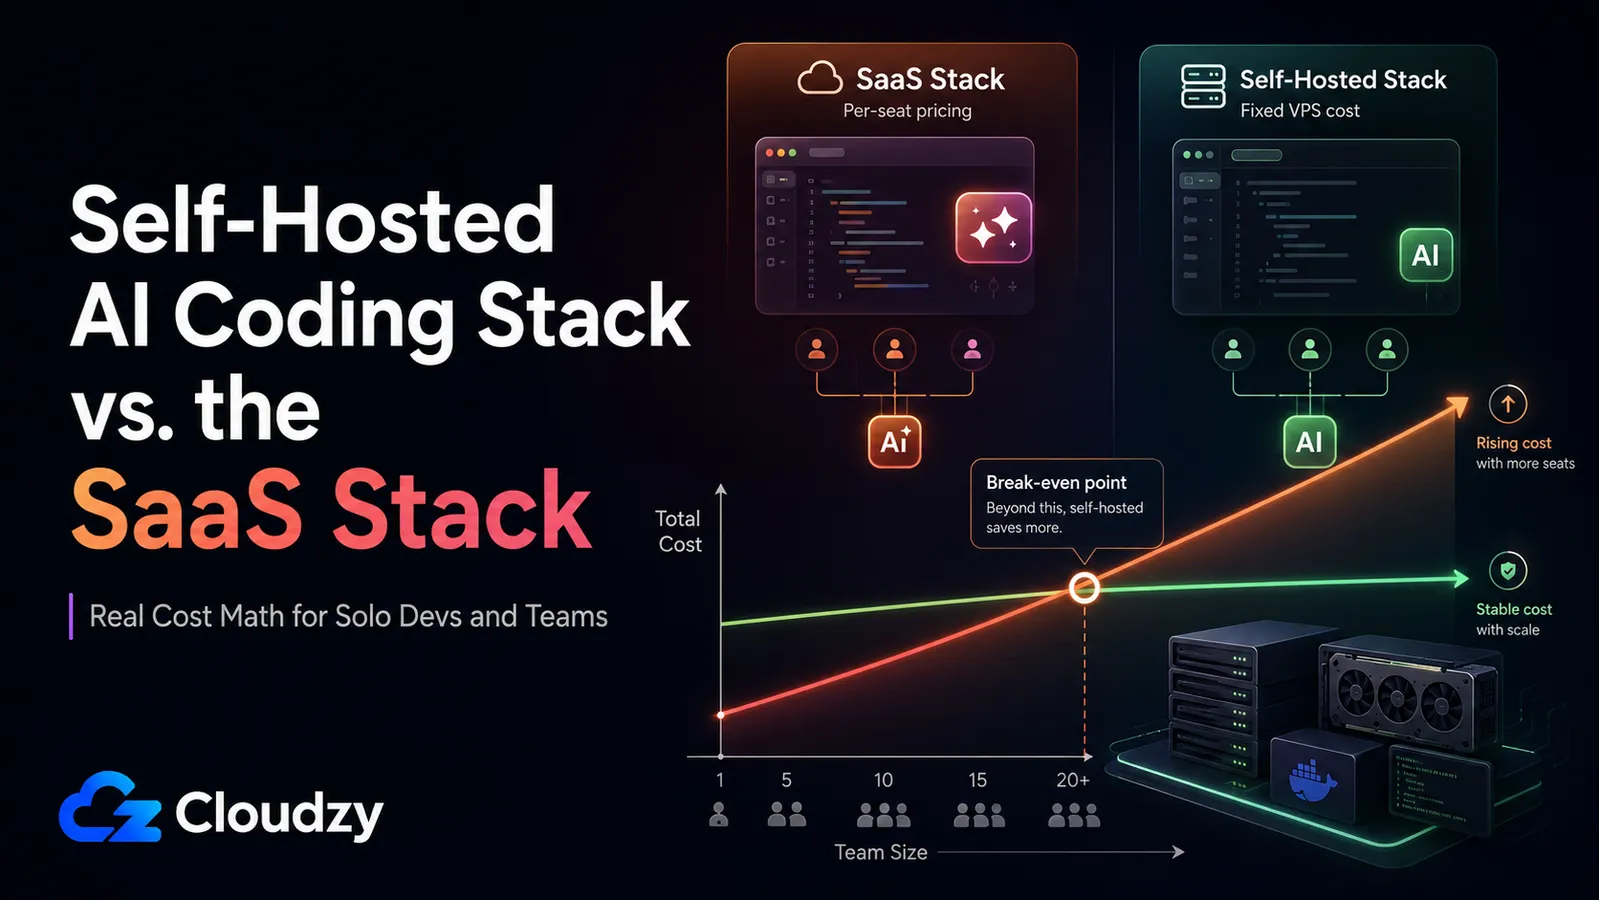
Samodzielnie hostowany stack kodowania AI: Ollama, Code Server, n8n vs. Copilot, Cursor, Windsurf. Realne wyliczenie kosztów dla pojedynczych devów i zespołów oraz kiedy każdy wygr
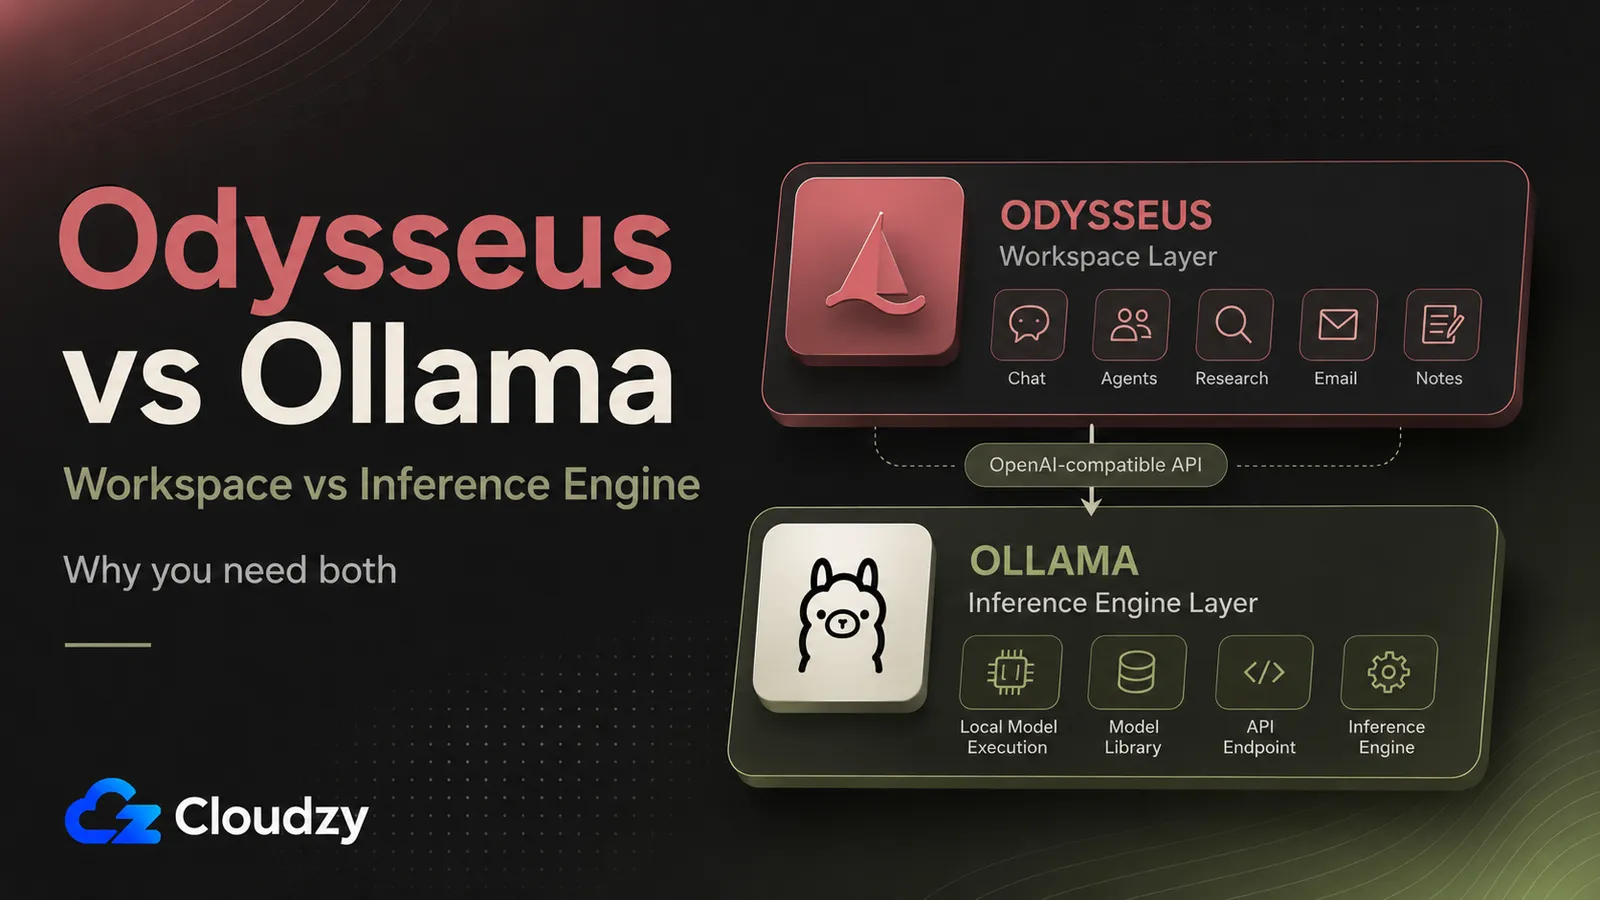
Odysseus i Ollama to nie konkurenci, jedno to twoja przestrzeń robocza AI, drugie uruchamia model. Oto jak do siebie pasują i jak samodzielnie hostować oba.
Samodzielne hostowanie LLM na otwartych wagach na GPU VPS bije API tylko powyżej punktu opłacalności, którego większość samodzielnych builderów nigdy nie osiąga. Matematyka kosztów
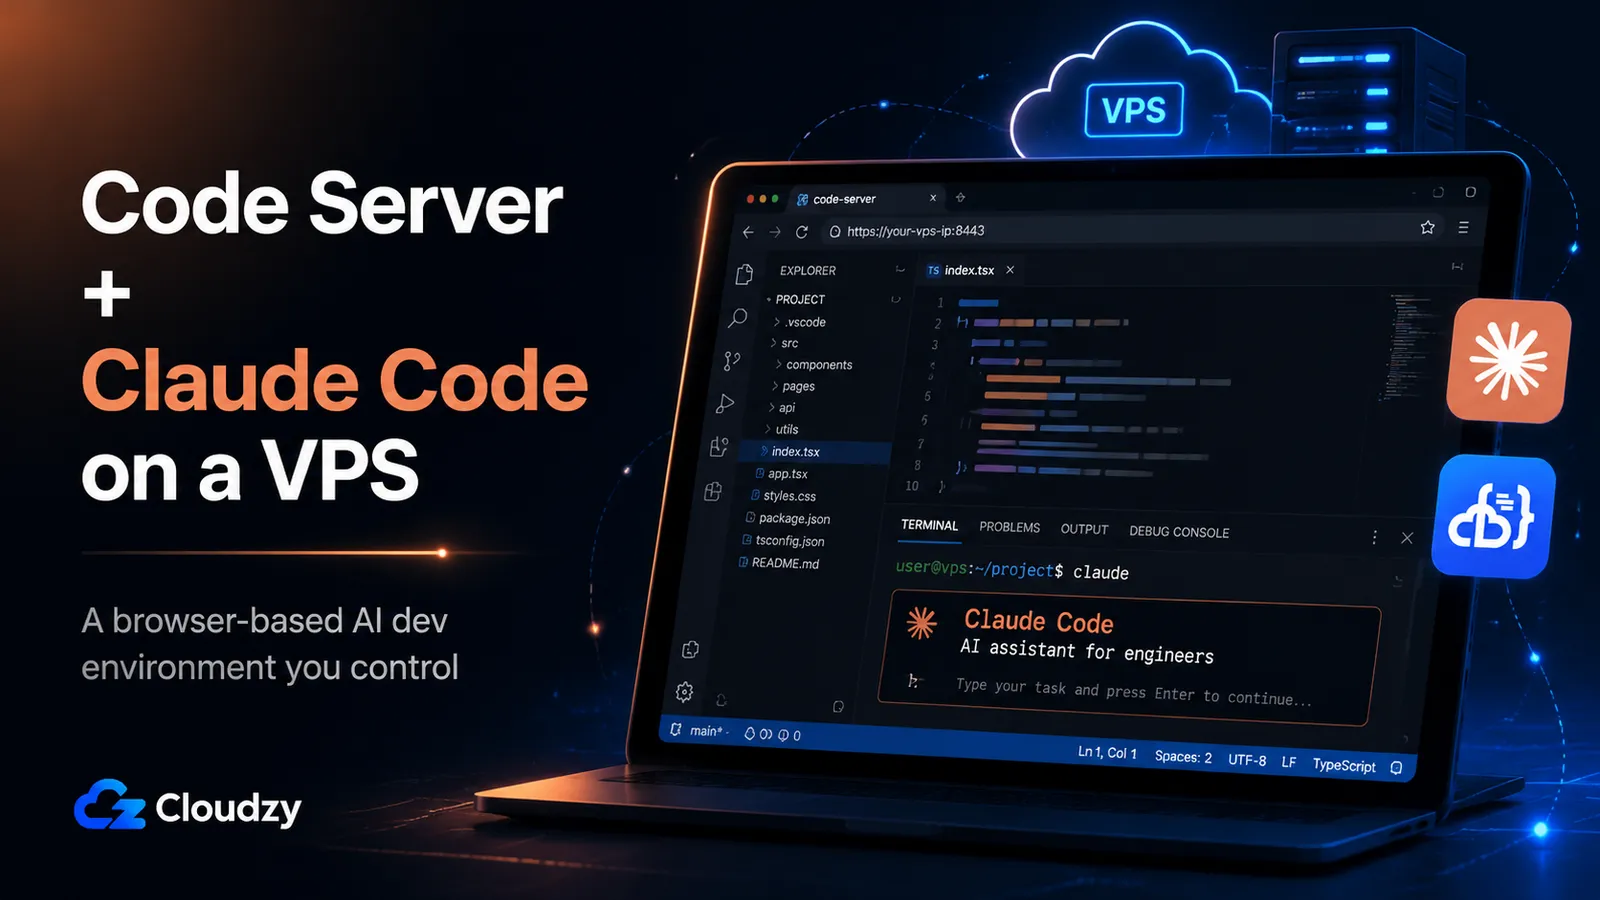
Skonfiguruj Code Server i Claude Code na jednym Linuksowym VPS dla opartego na przeglądarce, wspomaganego AI środowiska programistycznego. Rozmiar, instalacja, uwierzytelnianie bez
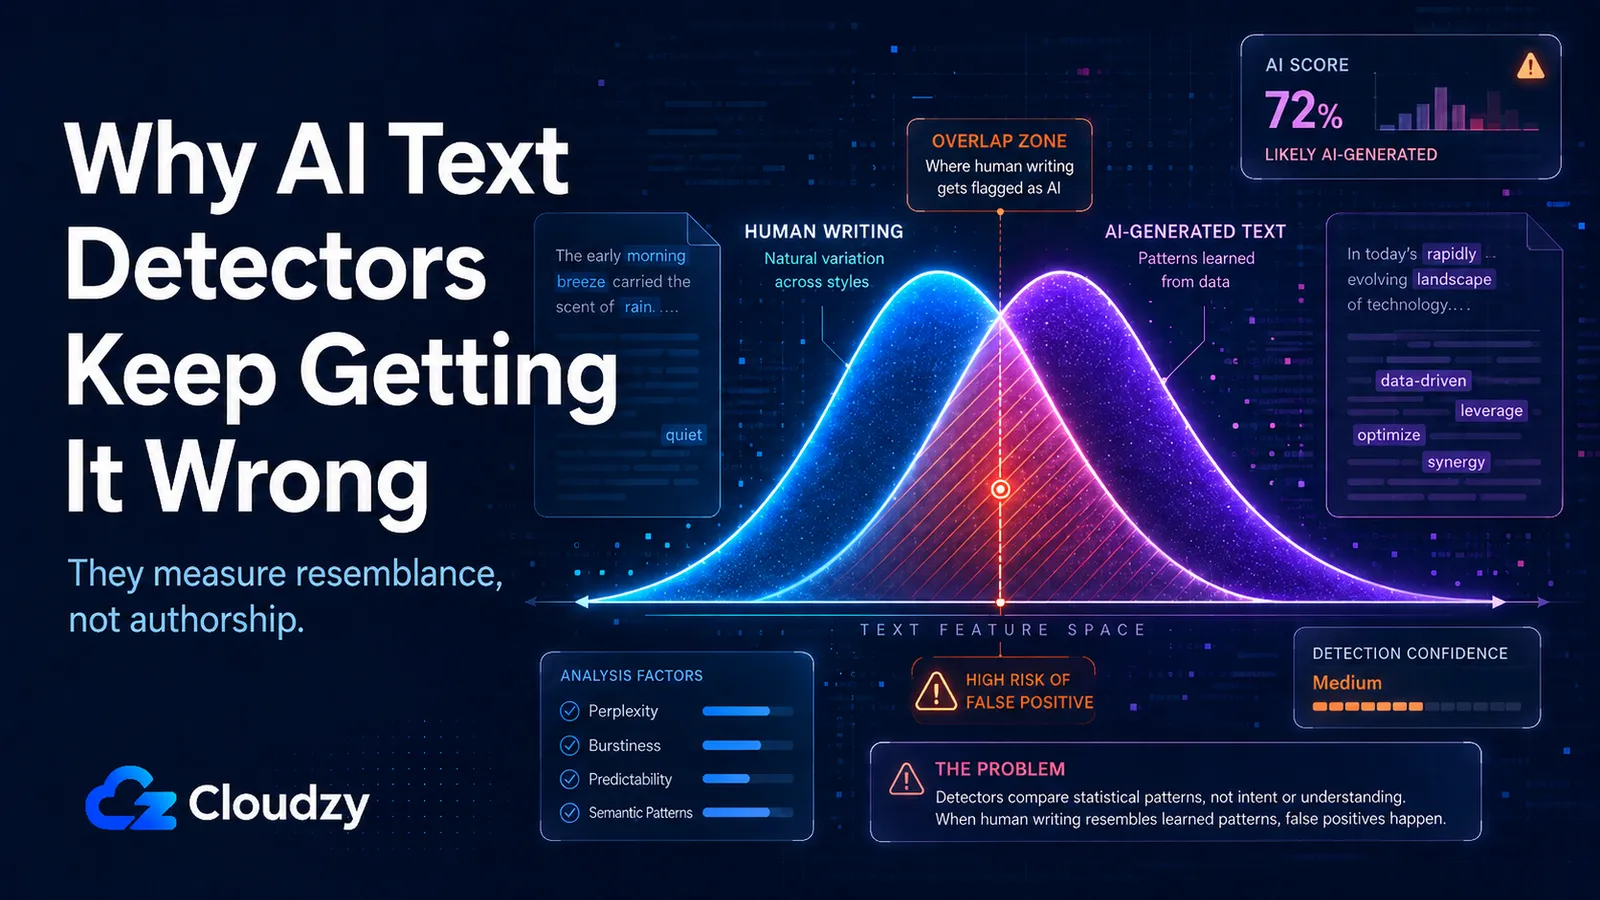
Detektory AI nie dowodzą autorstwa. Mierzą statystyczne podobieństwo. Oto dlaczego zdarzają się fałszywe alarmy i co działa lepiej.
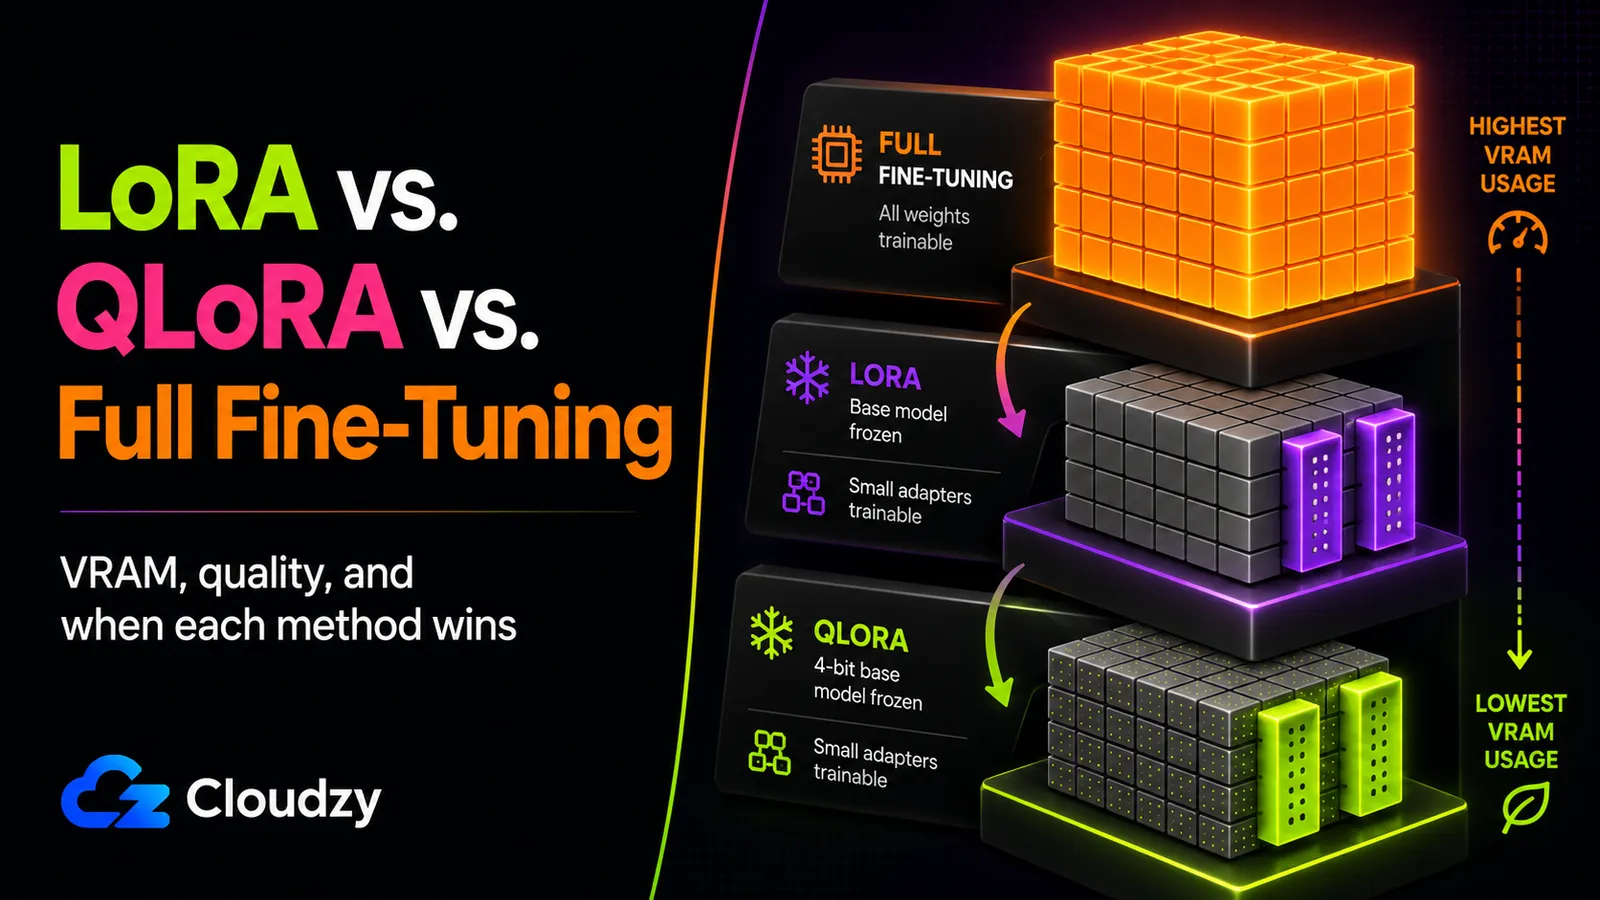
Porównaj LoRA, QLoRA i full fine-tuning pod względem VRAM, jakości i zastosowania. Sprawdź, która metoda fine-tuningu LLM odpowiada twojemu budżetowi na GPU.
Sonnet 5 jest tańszy od Opus 4.8, ale tokenizator się zmienił, a przy wysokich ustawieniach wysiłku rachunek się odwraca. Sprawdź, którego modelu używać i kiedy Opus nadal wygrywa.
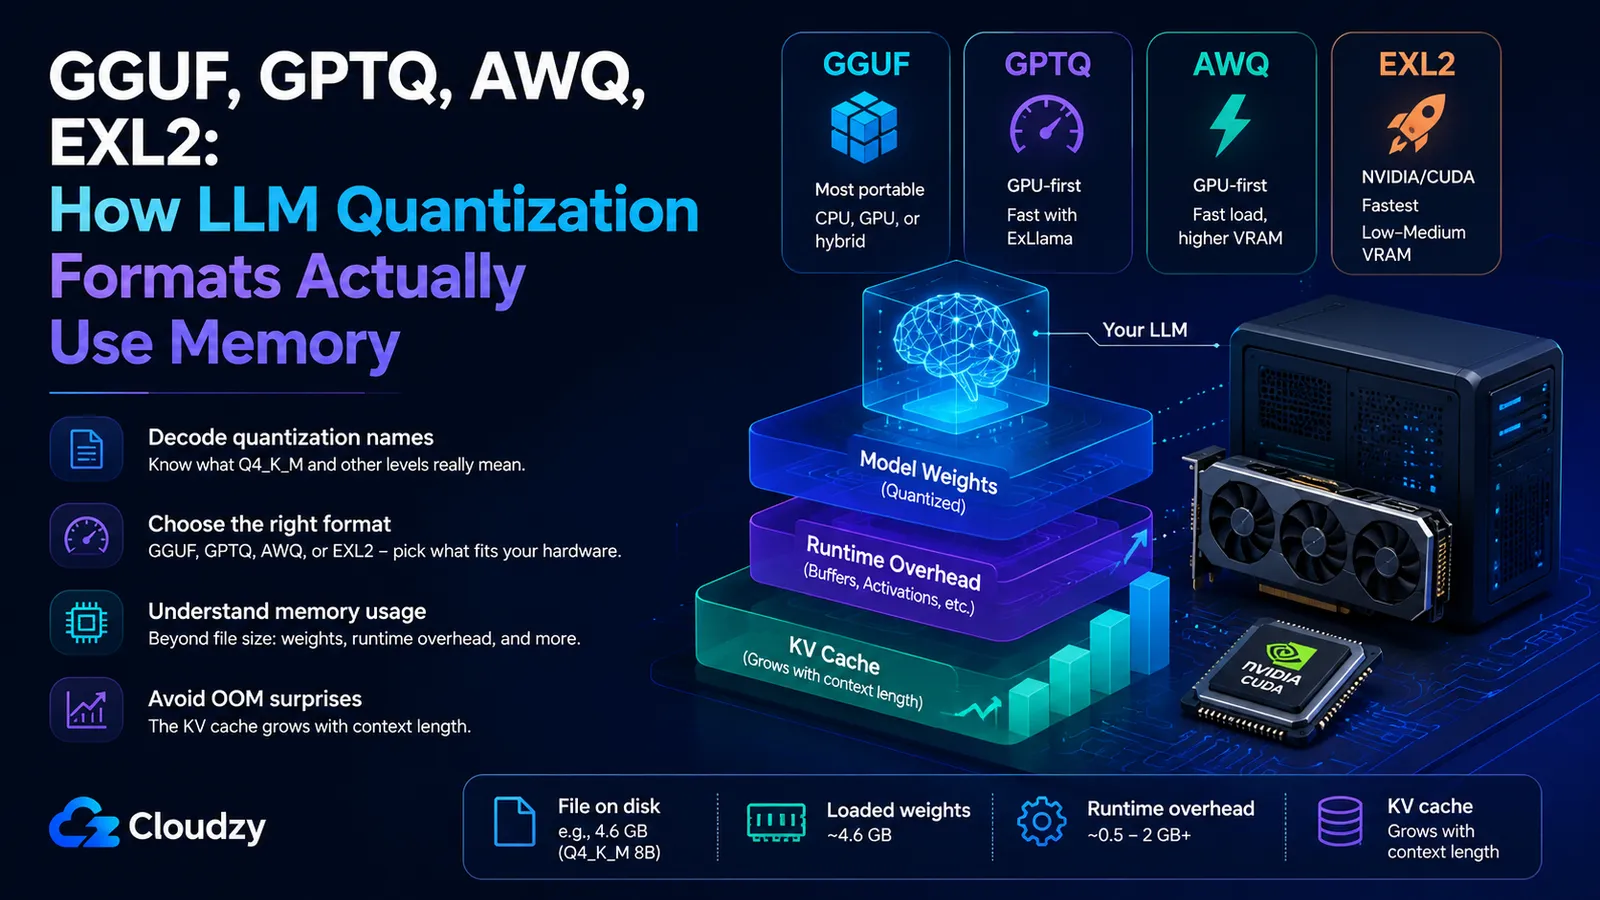
Porównanie wykorzystania pamięci GGUF, GPTQ, AWQ i EXL2, od rozmiaru pliku Q4_K_M po wzrost pamięci podręcznej KV i narzut środowiska uruchomieniowego.
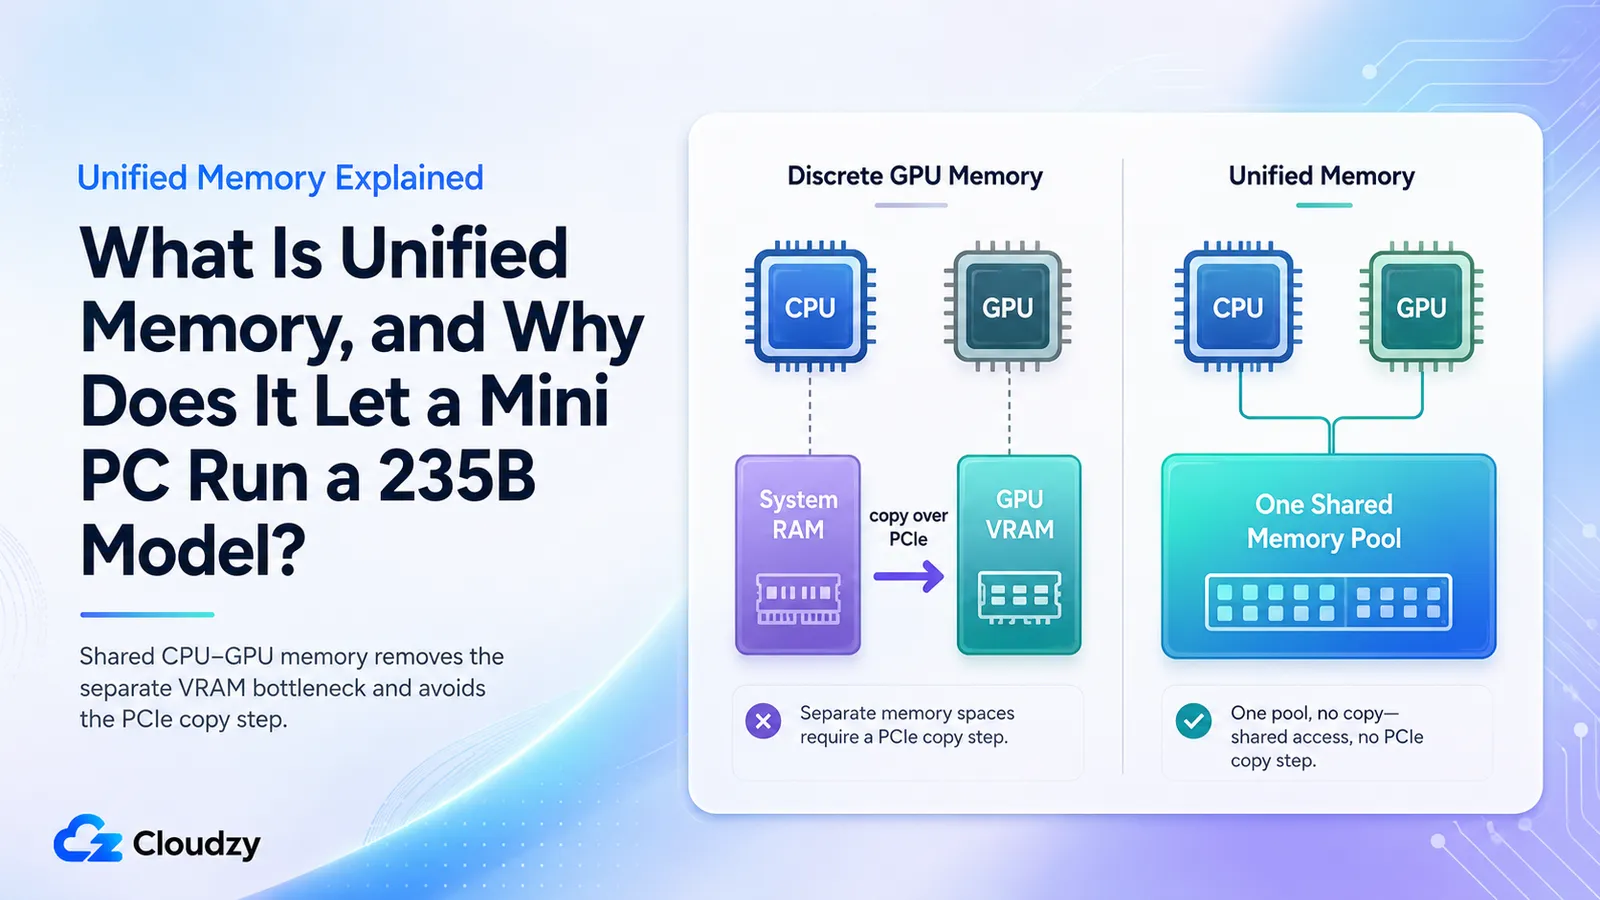
Pamięć zunifikowana pozwala kompaktowemu komputerowi AI wczytać modele klasy 235B, których nie pomieści żadna pojedyncza karta GPU o pojemności 24-32 GB. Czym jest, dlaczego działa
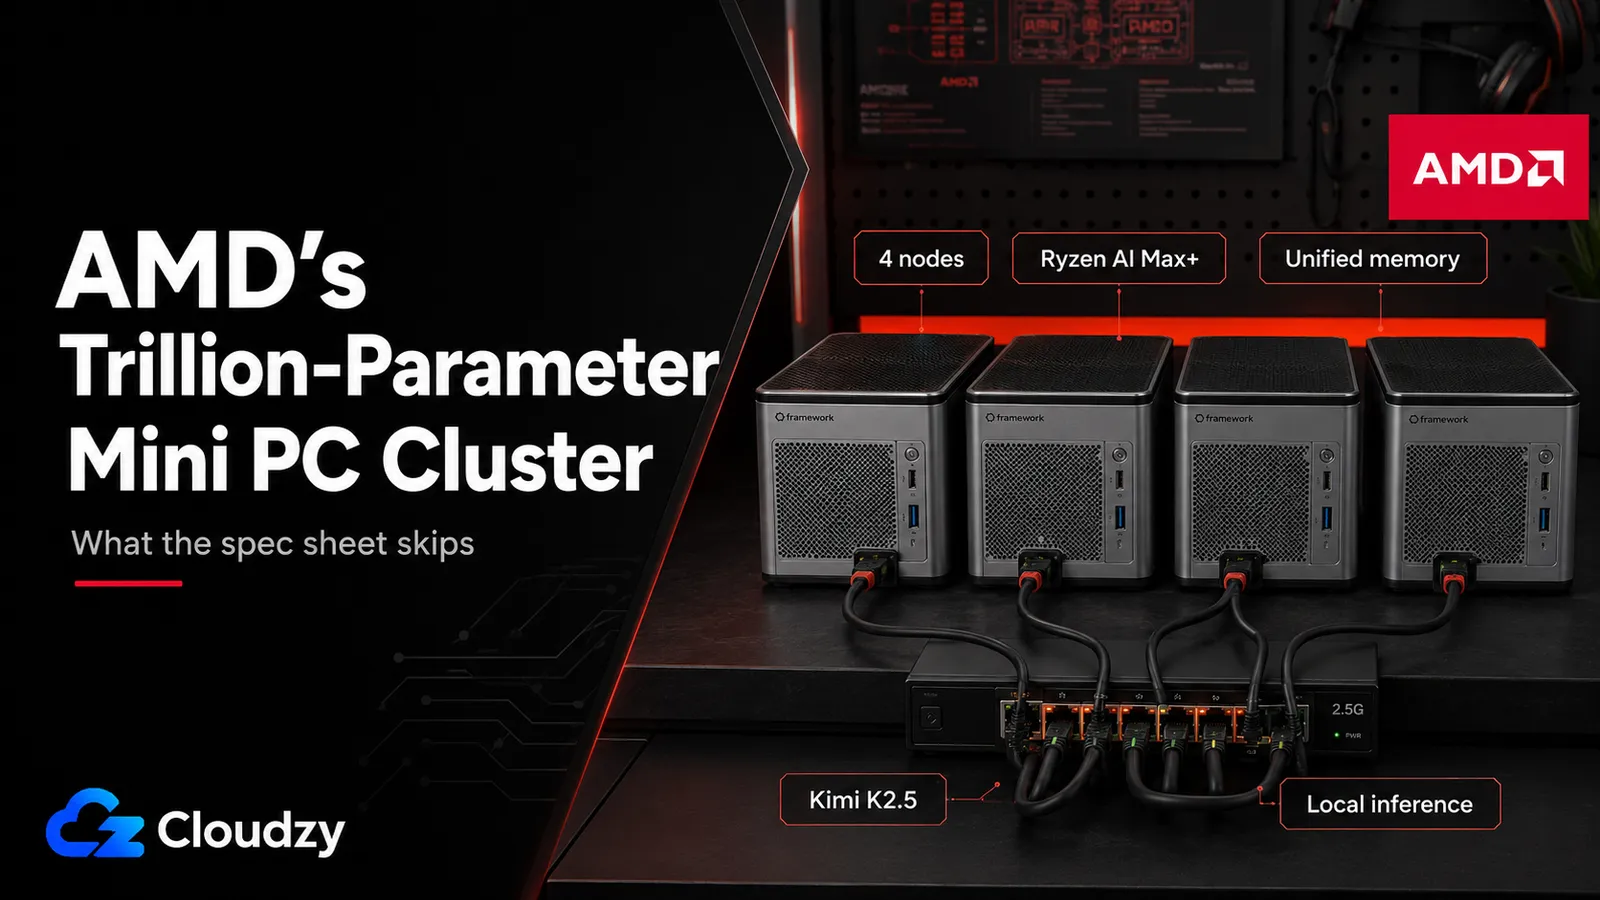
AMD uruchomiło model z 1 bilionem parametrów na czterech mini PC. Prawdziwą historią jest sztuczka architektoniczna, która czyni to prawdą, oraz oczekiwanie od 40 sekund do 4 minut
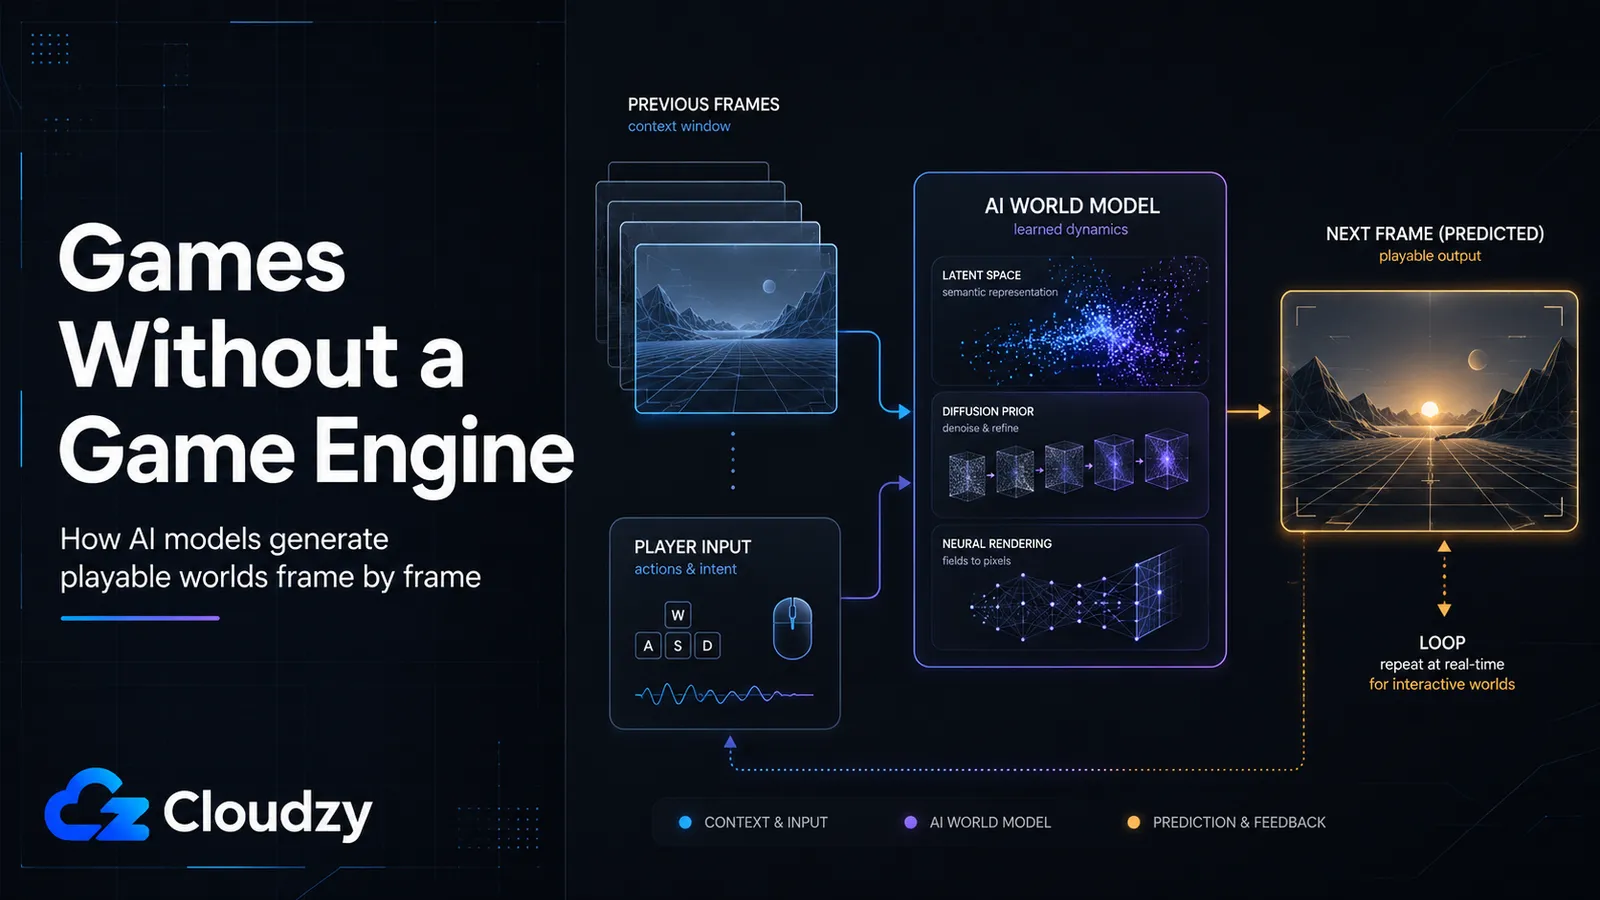
Jak modele AI takie jak GameNGen, Oasis i Genie 3 generują grywalne gry bez silnika gier? Jasne spojrzenie na to, jak działa przewidywanie kolejnej klatki, dlaczego te światy dryfu
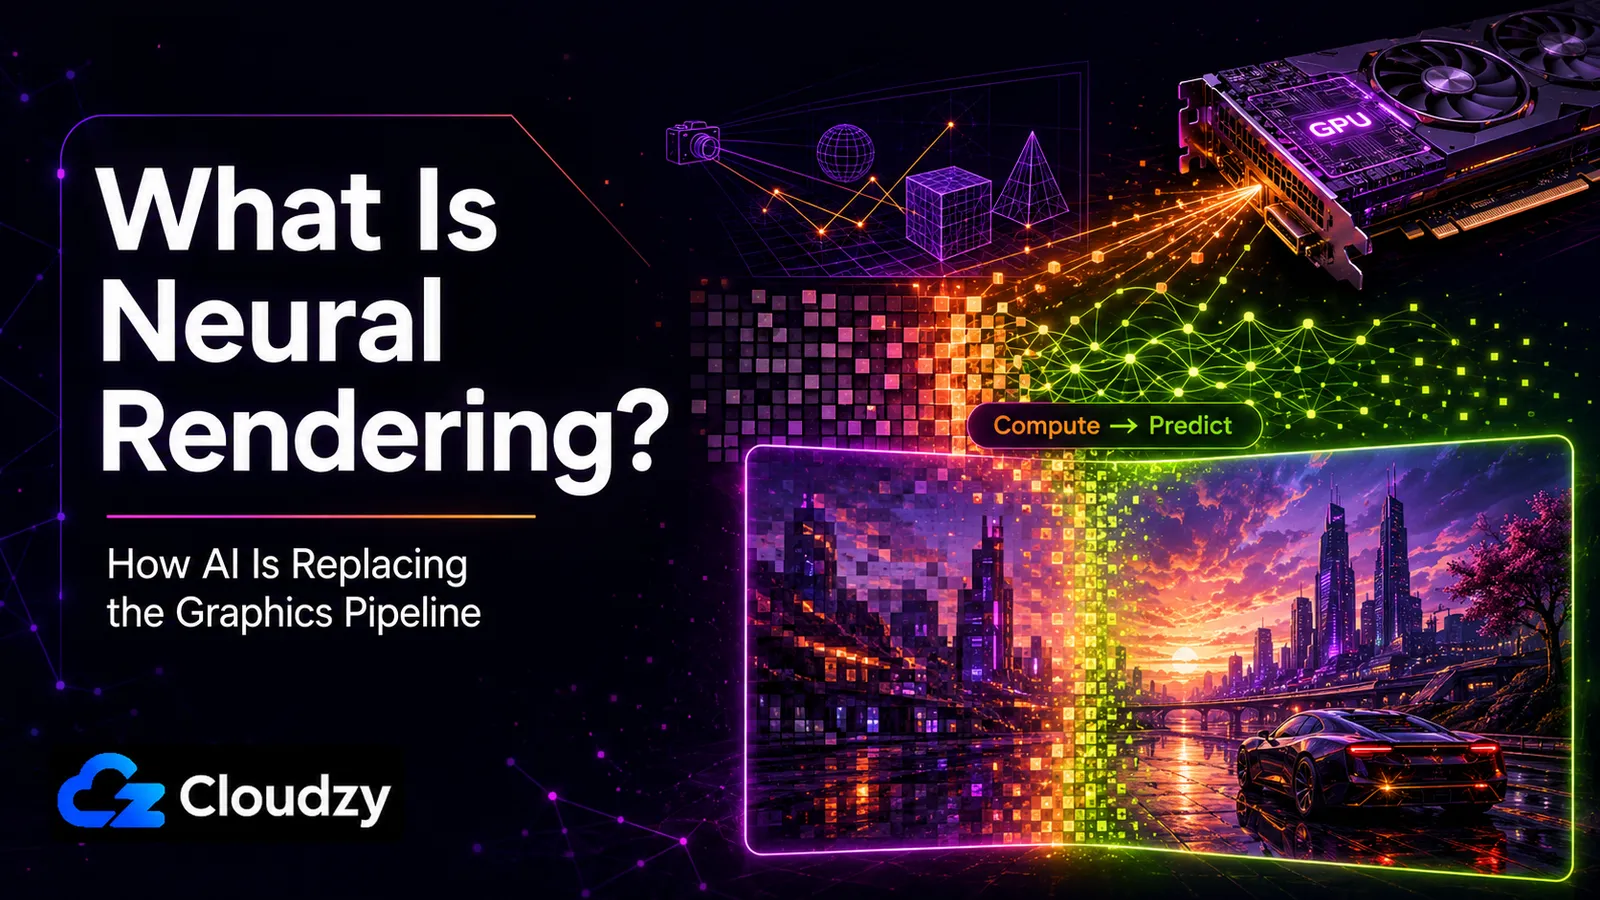
Rendering neuronowy to AI, które przewiduje piksele, oświetlenie i detale zamiast je obliczać. Oto co to naprawdę oznacza, jak pasuje do tego DLSS i co jest prawdą, a co szumem.
Claude Code, Codex CLI, Gemini CLI i Cline porównane pod kątem elastyczności, autonomii, cen i benchmarków, plus co oznacza wyłączenie Gemini CLI w 2026 roku.
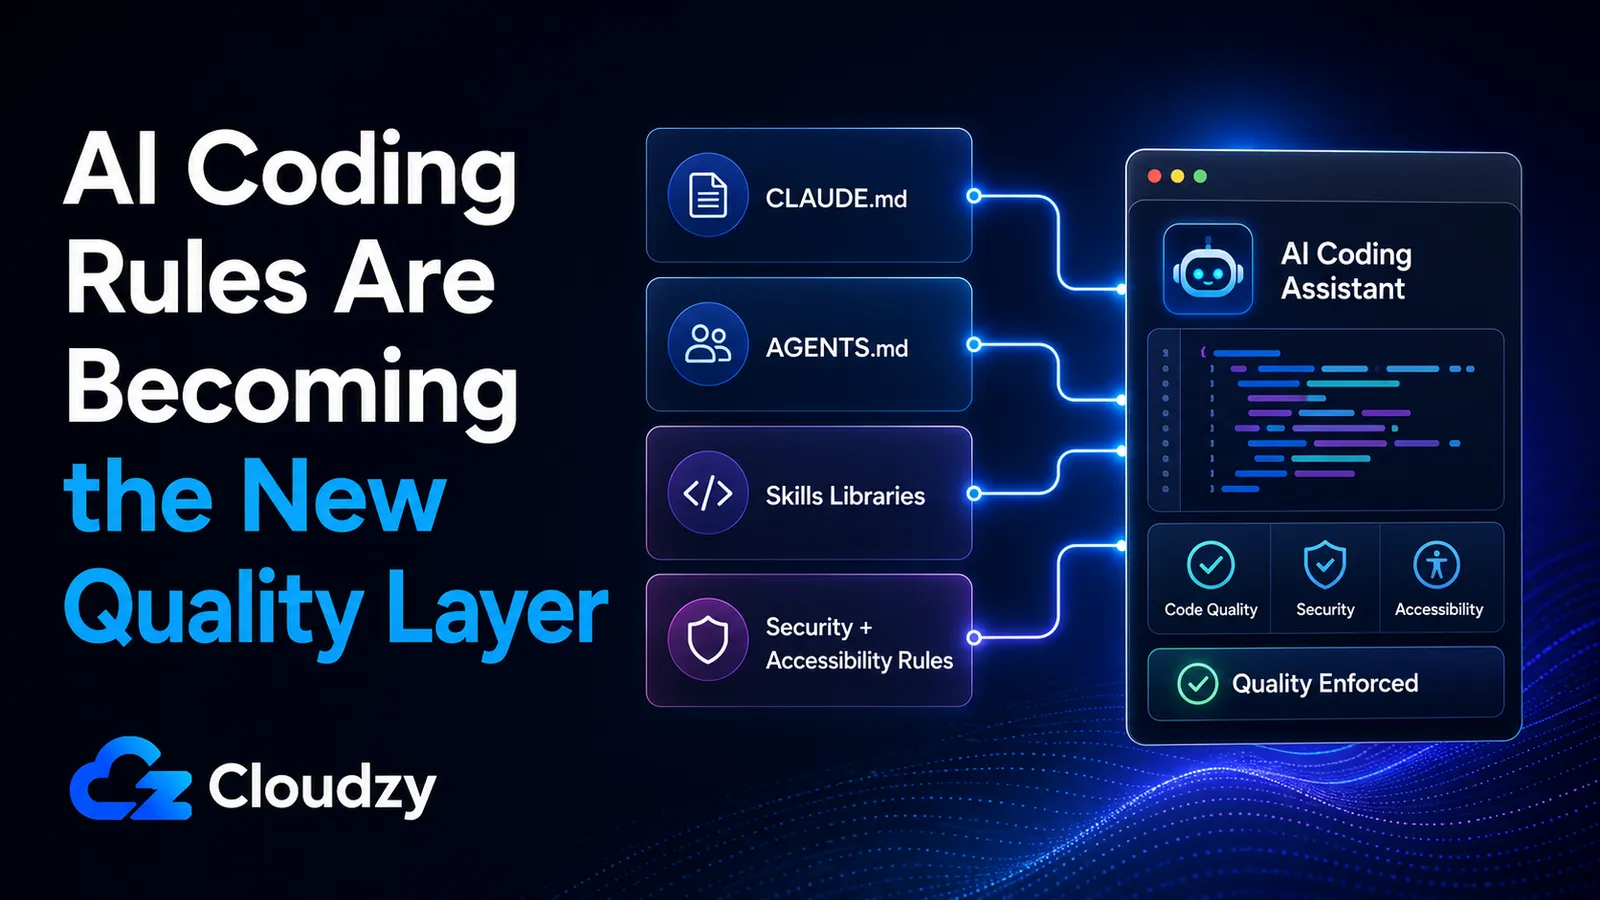
Pojedynczy plik markdown właśnie powiedział 178 000 programistów, jak sprawić, by AI się zachowywało. Agenty bezpieczeństwa, reguły dostępności, organizacje standaryzacyjne, co nap
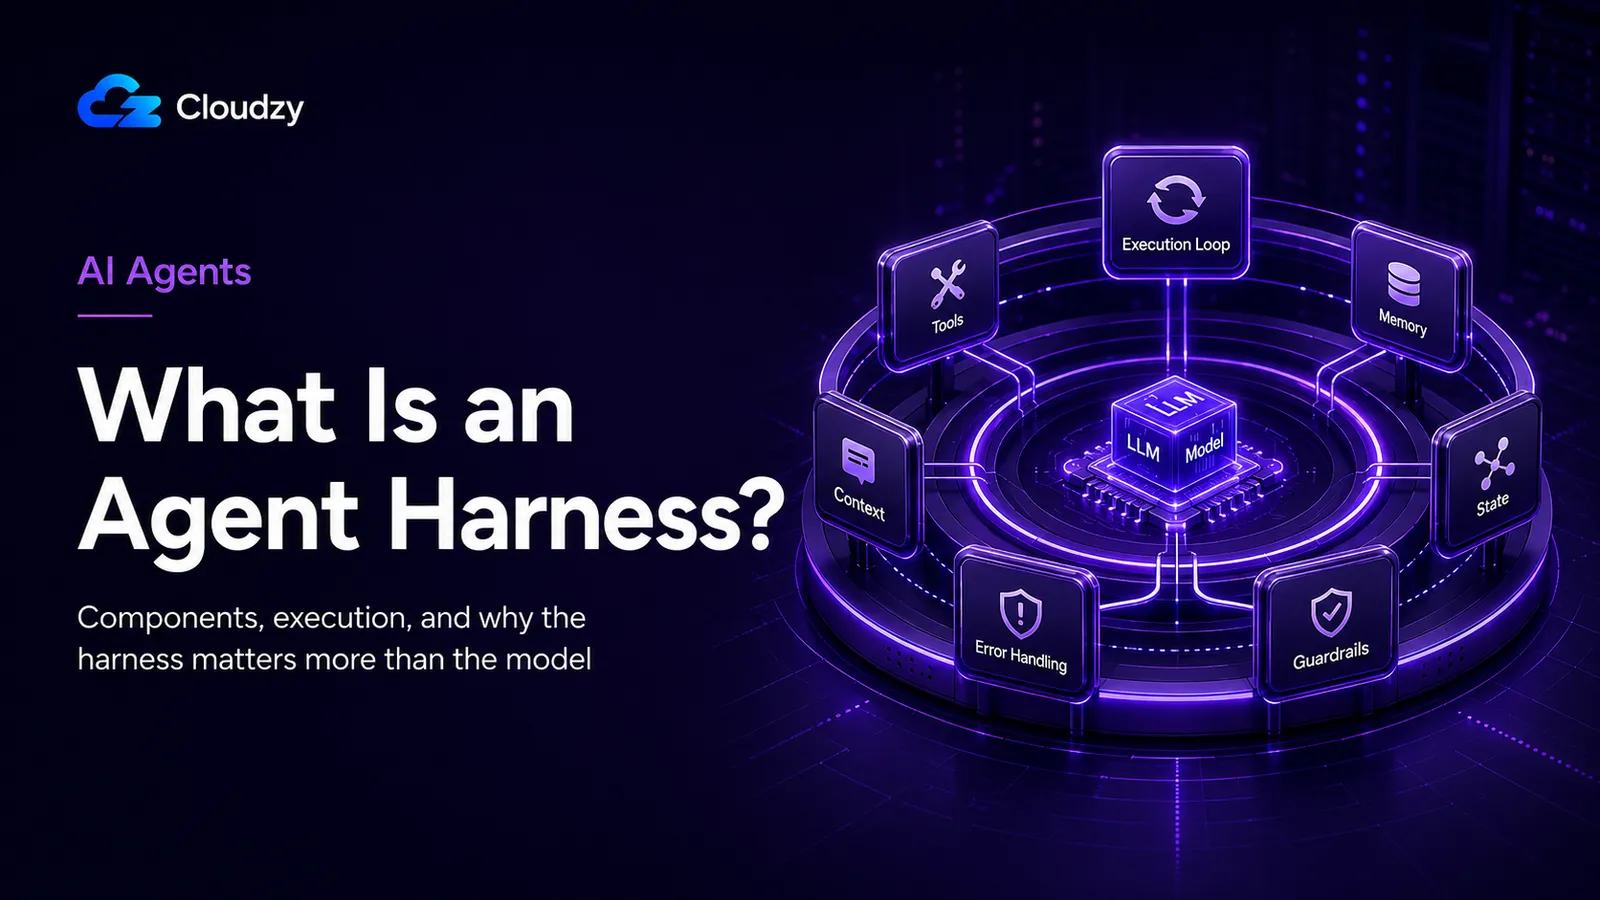
Agent harness to oprogramowanie otaczające LLM, które sprawia, że zachowuje się jak agent. Oto czym jest harness, jego komponenty i dlaczego liczy się bardziej niż model.
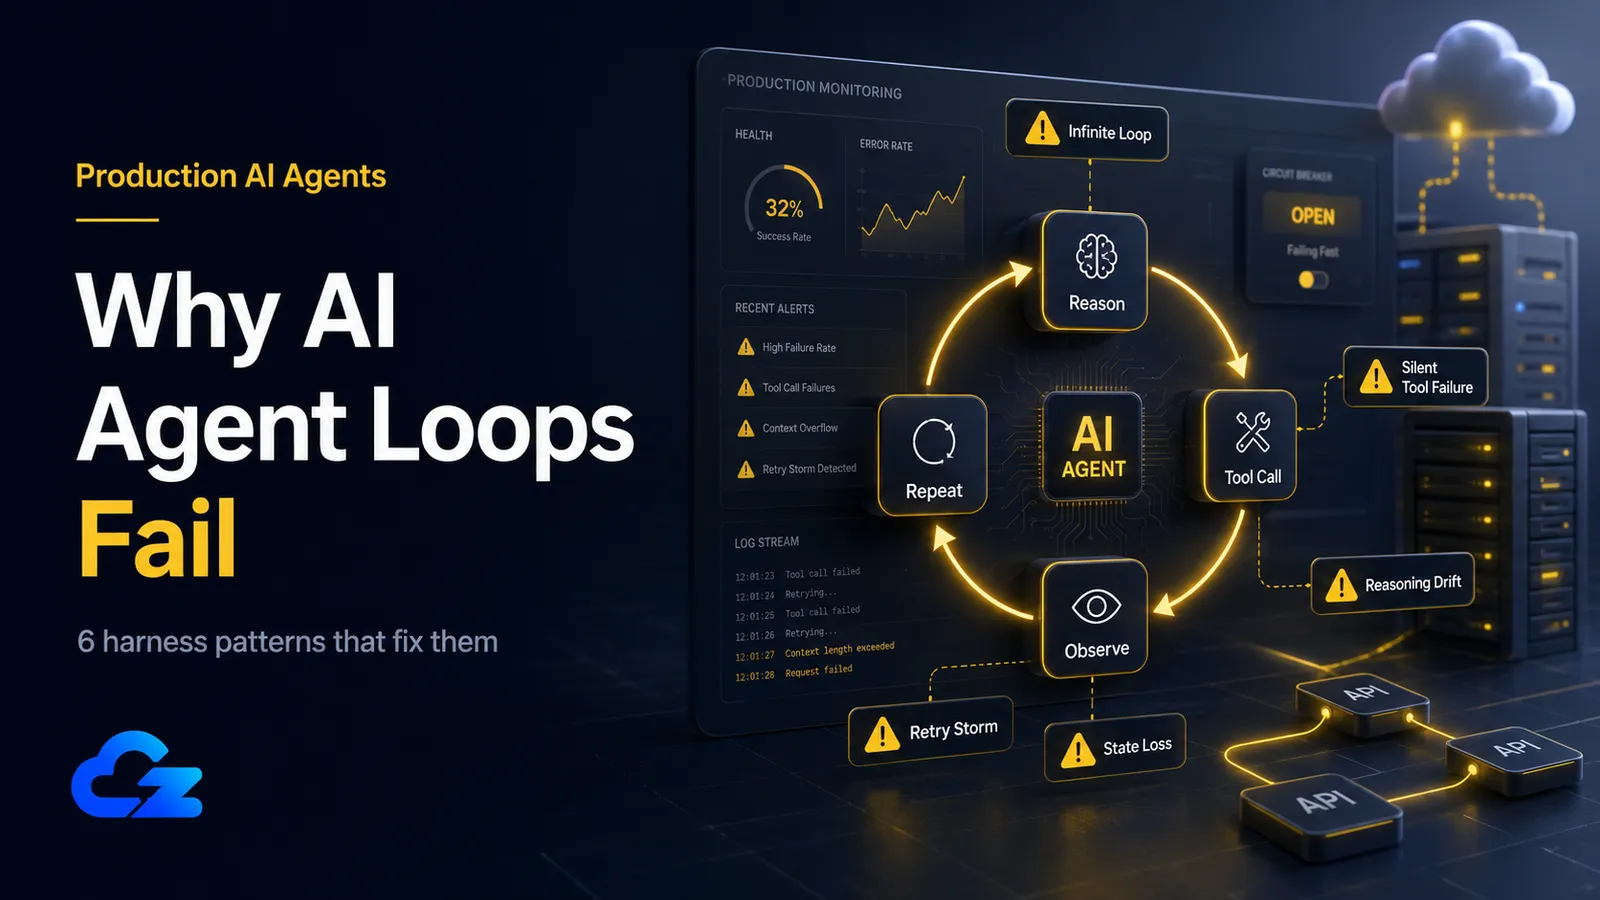
Pętle agentów AI zawodzą na produkcji z sześciu przewidywalnych powodów: od nieskończonych pętli po burze ponownych prób. Oto co się psuje i jak to naprawić za pomocą odpowiedniego
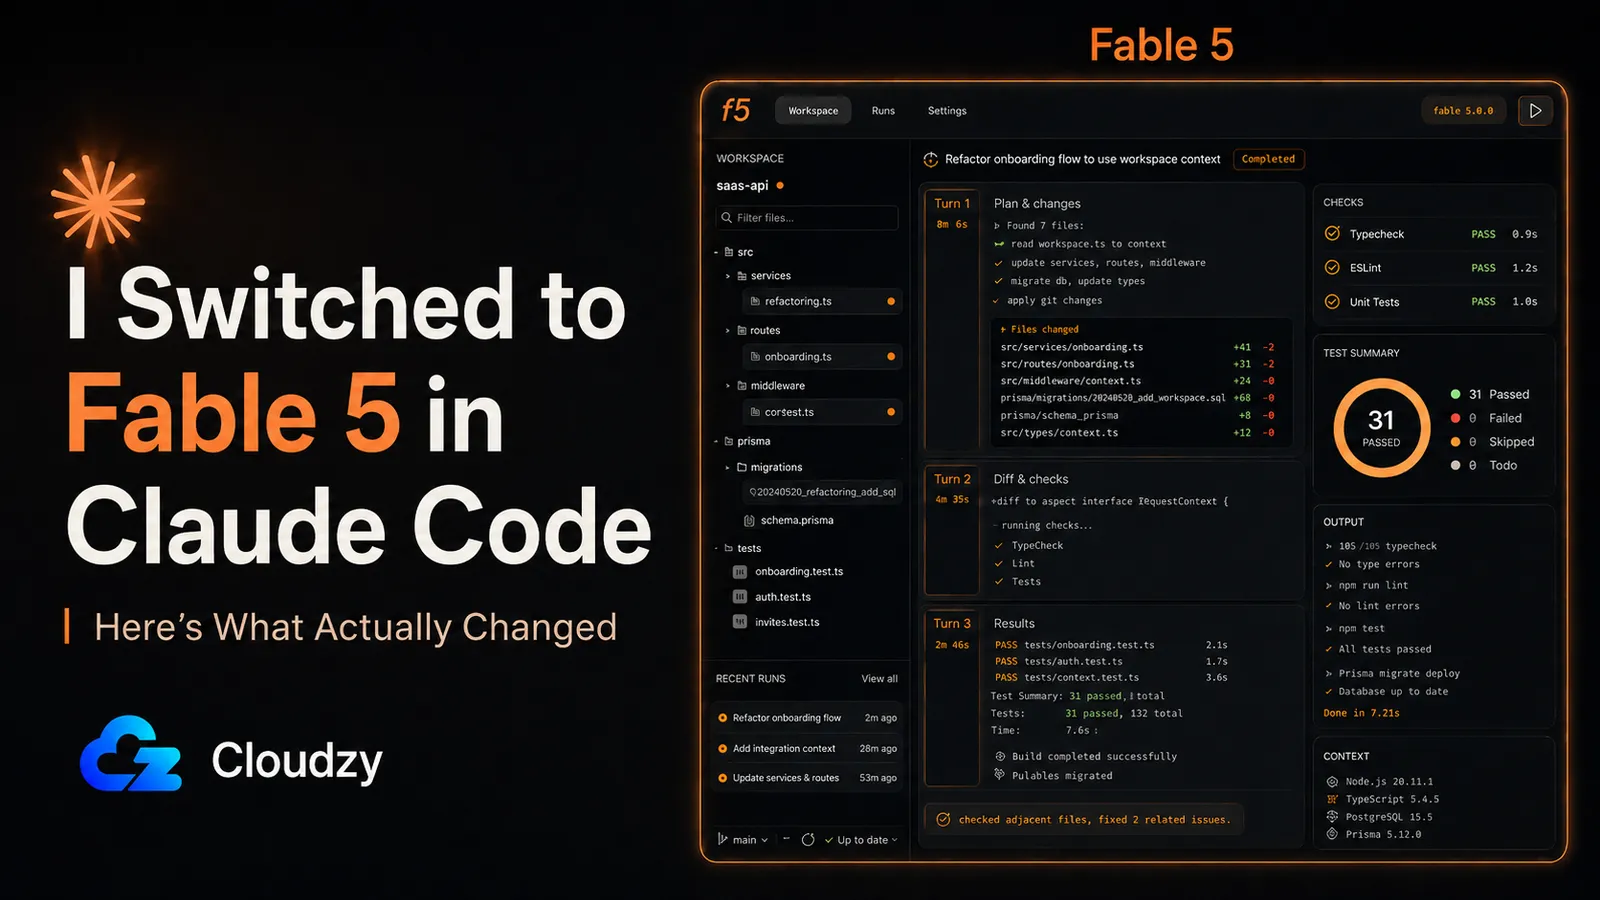
Zmieniłem domyślny model w Claude Code na Fable 5 pierwszego dnia. Trzy rzeczy naprawdę się zmieniły w moim przepływie pracy, a jedna jest frustrująca. Oto moja szczera ocena.
OpenCode vs OpenClaw to głównie wybór między agentem kodowania działającym wewnątrz Twojego repozytorium a stale dostępnym gatewayem asystenta łączącym aplikacje czatu, narzędzia i
OpenCode vs Claude Code sprowadza się do wyboru między zarządzanym agentem AI do kodowania a agentem, którego możesz uruchomić we własnym środowisku. Claude Code jest łatwiejszy na
Claude Code wciąż jest jednym z najmocniejszych agentów do kodowania, ale wielu deweloperów wybiera teraz narzędzia w oparciu o workflow, dostęp do modeli i długoterminowy koszt, z
Wraz z ciągle rosnącym zapotrzebowaniem na lokalne LLM-y wielu użytkowników gubi się przy wyborze najodpowiedniejszego, ale ich używanie nie jest tak proste, jak Ci się wydaje. Byc
Wybór GPU VPS może być przytłaczający, gdy patrzysz na arkusze specyfikacji pełne liczb. Liczba rdzeni skacze od 2 560 do 21 760, ale co to właściwie oznacza? Rdzeń CUDA to
Jeśli wybierasz między H100 a RTX 4090 do zastosowań AI, pamiętaj, że większość "benchmarków" nie ma znaczenia, dopóki model i cache faktycznie nie zmieszczą się w VRAM. RTX 4090 t
Jeśli planujesz kupić nową GPU, żeby pozbyć się błędów braku pamięci, spór 5070 Ti vs 5080 jest bez sensu. Obie karty mają po 16 GB VRAM, a ten limit pojawia się w d
Uczenie zespołowe to technika uczenia maszynowego, w której łączy się dwa lub więcej modeli, aby uzyskać lepsze predykcje. Model to algorytm lub proces, który przyjmuje dane i uczy
Jednym z najważniejszych - jeśli nie najważniejszym - aspektów uczenia maszynowego jest uzyskiwanie trafnych i wiarygodnych predykcji. Jednym z podejść, które zyskało tu szczególną
Kiedy OpenAI udostępniło ChatGPT publicznie w listopadzie 2022 roku, błyskawicznie stało się ono fenomenem na masową skalę, oferując możliwości, które naprawdę wydawały się nieogra
Uczenie maszynowe i jego podkategoria - głębokie uczenie - wymagają znacznej mocy obliczeniowej, którą mogą zapewnić tylko GPU. Nie każdy GPU jednak się sprawdzi, dlatego oto naj
W ostatnich latach sztuczna inteligencja (AI) gruntownie zmieniła sposób, w jaki podchodzimy do różnych zadań, od tworzenia treści i rozwiązywania problemów technicznych po pisanie