รีวิว AllTube Download: ยังคุ้มค่าที่จะใช้อยู่ไหมในปี 2026?
AllTube Download ถูกเก็บเข้าคลัง (archived) ไปตั้งแต่ปี 2023 และไม่น่าเชื่อถืออีกต่อไป นี่คือรีวิวแบบตรงไปตรงมาว่ามันอยู่ตรงจุดไหน พร้อมทางเลือกที่ยังพัฒนาอยู่และคุ้มค่ากับ VPS…
เลือกประเทศเพื่อดู Cloudzy ในภาษาของคุณ
บล็อก Cloudzy
AllTube Download ถูกเก็บเข้าคลัง (archived) ไปตั้งแต่ปี 2023 และไม่น่าเชื่อถืออีกต่อไป นี่คือรีวิวแบบตรงไปตรงมาว่ามันอยู่ตรงจุดไหน พร้อมทางเลือกที่ยังพัฒนาอยู่และคุ้มค่ากับ VPS…
Odysseus และ Ollama ไม่ใช่คู่แข่งกัน ตัวหนึ่งคือพื้นที่ทำงาน AI ของคุณ อีกตัวหนึ่งรันโมเดล นี่คือวิธีที่ทั้งคู่ประกอบเข้ากันและวิธี self-host ทั้งสองตัว
การ self-host LLM แบบ open-weight บน GPU VPS เอาชนะ API ได้เฉพาะเหนือจุดคุ้มทุนที่ solo builder ส่วนใหญ่ไม่มีวันถึง การคำนวณต้นทุนปี 2026 แยกตามโมเดล + การใช้งาน
เปรียบเทียบ Gitea, Forgejo และ OneDev สำหรับการทำ self-hosting เรื่องการกำกับดูแล CI/CD ต้นทุน RAM และตัวไหนที่เหมาะกับทีมของคุณ คู่มือการตัดสินใจแบบตรงไปตรงมา ไม่มีน้ำ
ตั้งค่า Code Server และ Claude Code บน Linux VPS เครื่องเดียวเพื่อสภาพแวดล้อมพัฒนาที่ช่วยด้วย AI บนเบราว์เซอร์ การกำหนดขนาด การติดตั้ง การยืนยันตัวตนแบบไม่มีจอ และ HTTPS ในขั้นตอน…
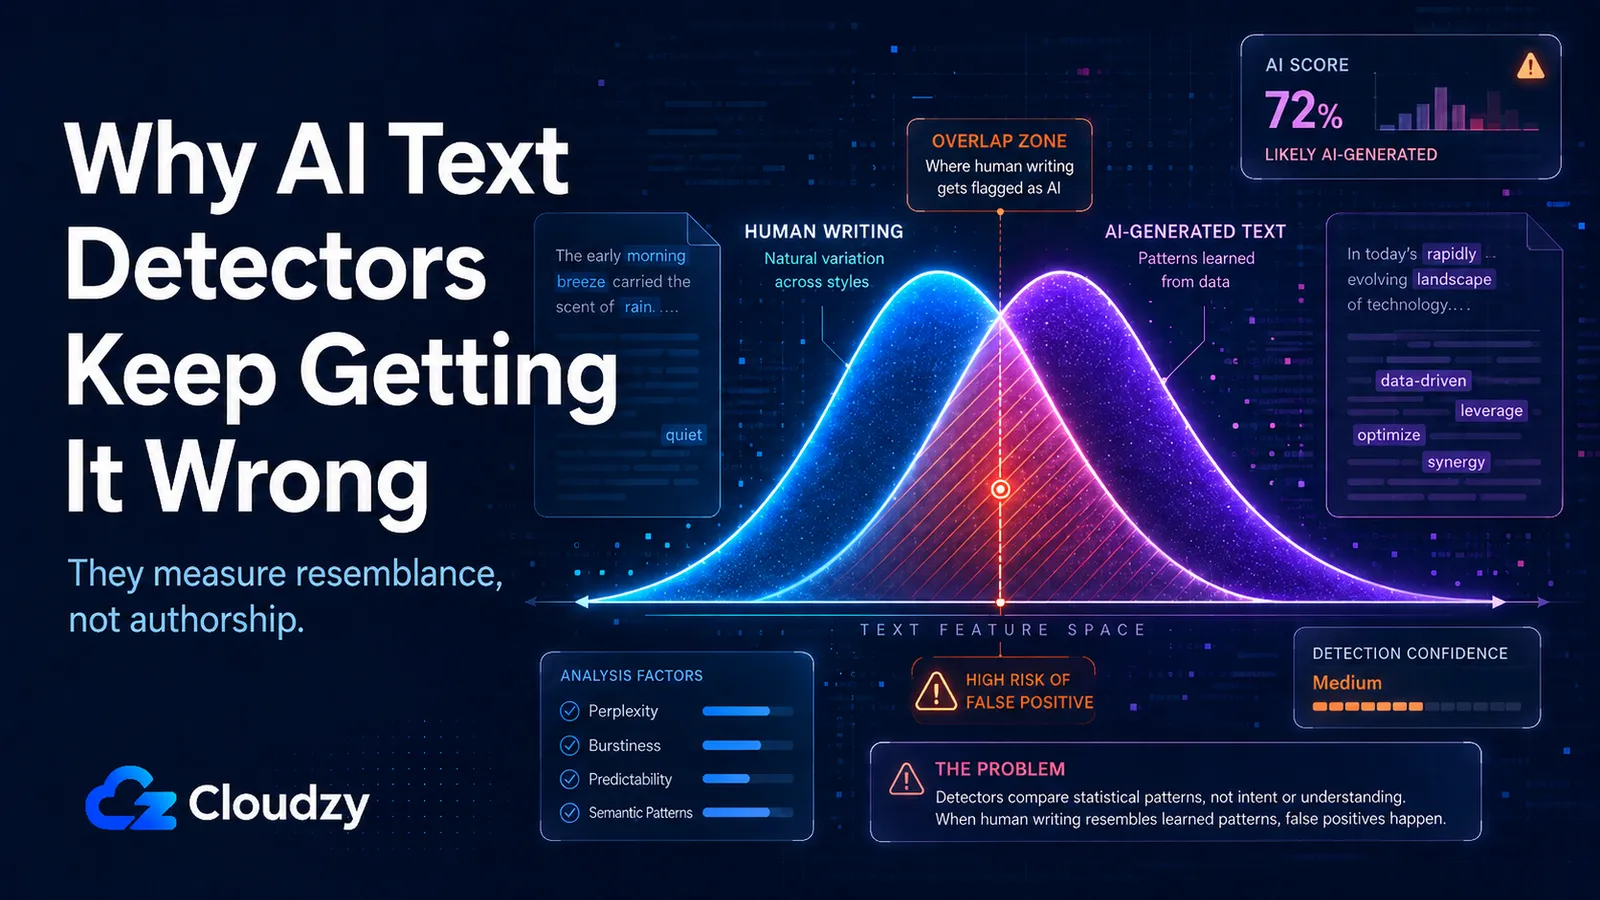
เครื่องมือตรวจจับ AI ไม่ได้พิสูจน์ความเป็นผู้เขียน มันวัดความคล้ายเชิงสถิติ นี่คือเหตุผลว่าทำไมผลบวกลวงจึงเกิดขึ้น และอะไรใช้ได้ผลดีกว่า
การอัปเกรดตรงจาก Gitea ไปยัง Forgejo หยุดที่ Gitea 1.22 สำหรับ Gitea 1.23+ ให้เปรียบเทียบการดาวน์เกรด SQL เครื่องมือย้ายข้อมูล การนำเข้าผ่าน API การสำรองข้อมูล และสิ่งที่จะเสียหาย
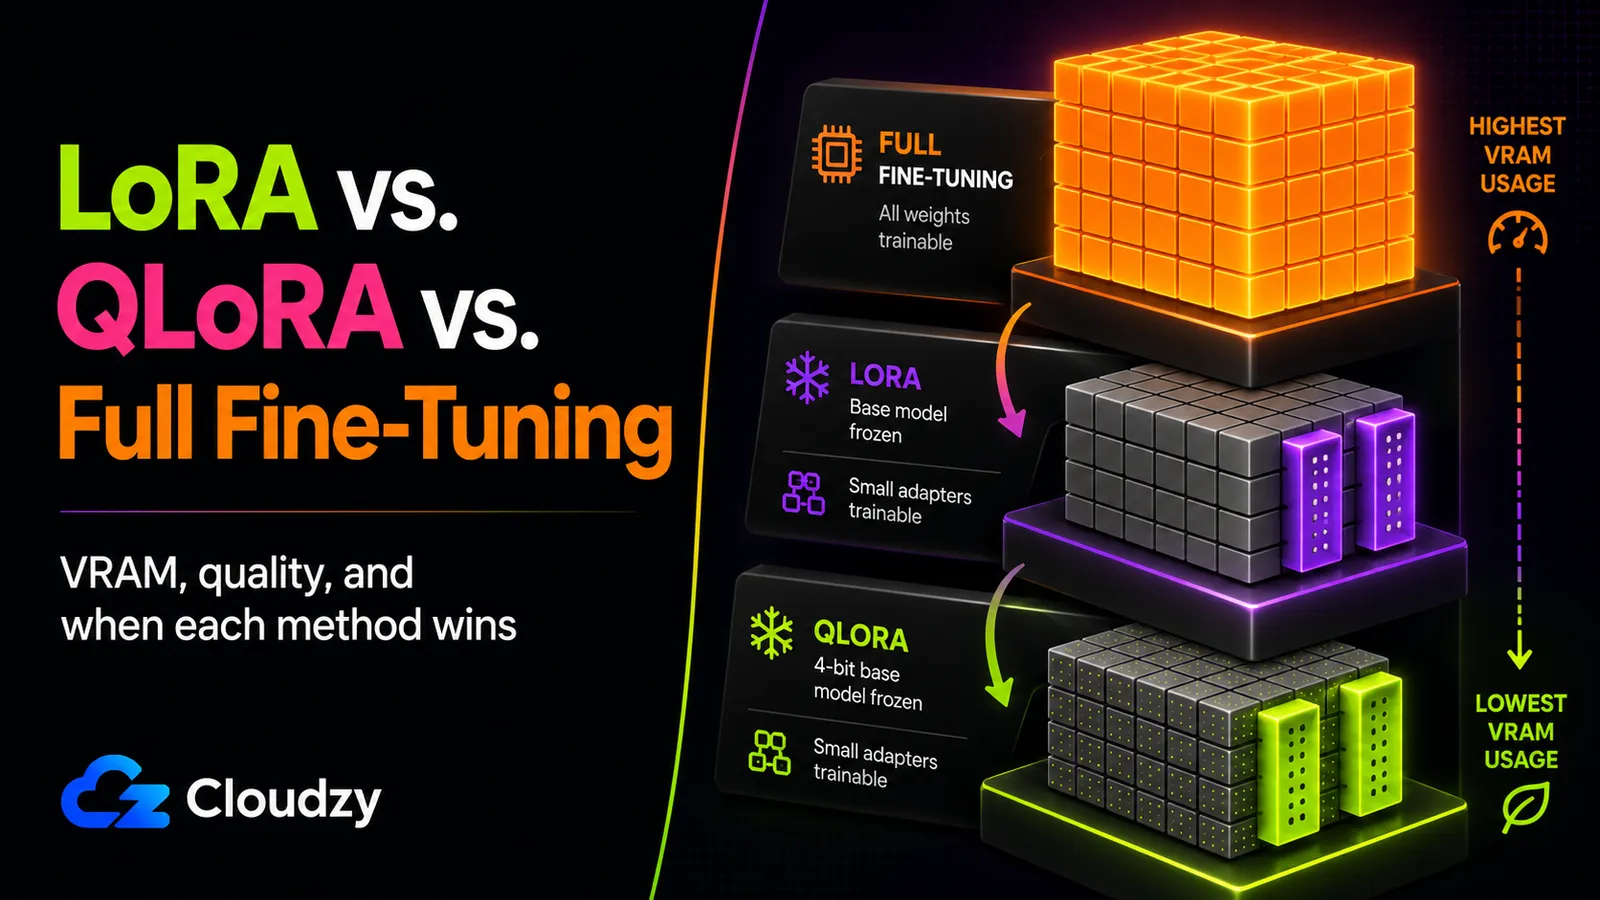
เปรียบเทียบ LoRA, QLoRA และ full fine-tuning ในด้าน VRAM คุณภาพ และกรณีใช้งาน เรียนรู้ว่าวิธี fine-tuning LLM แบบไหนเหมาะกับงบ GPU ของคุณ
คุณต้องจ่ายเท่าไหร่สำหรับคอมพิวเตอร์สเปคสูงที่ตอบโจทย์ความต้องการ? ค่าอินเทอร์เน็ตเป็นอุปสรรคต่อการใช้การเชื่อมต่อที่เร็วและเสถียรที่สุดหรือเปล่า? คุณเคยอยากได้…
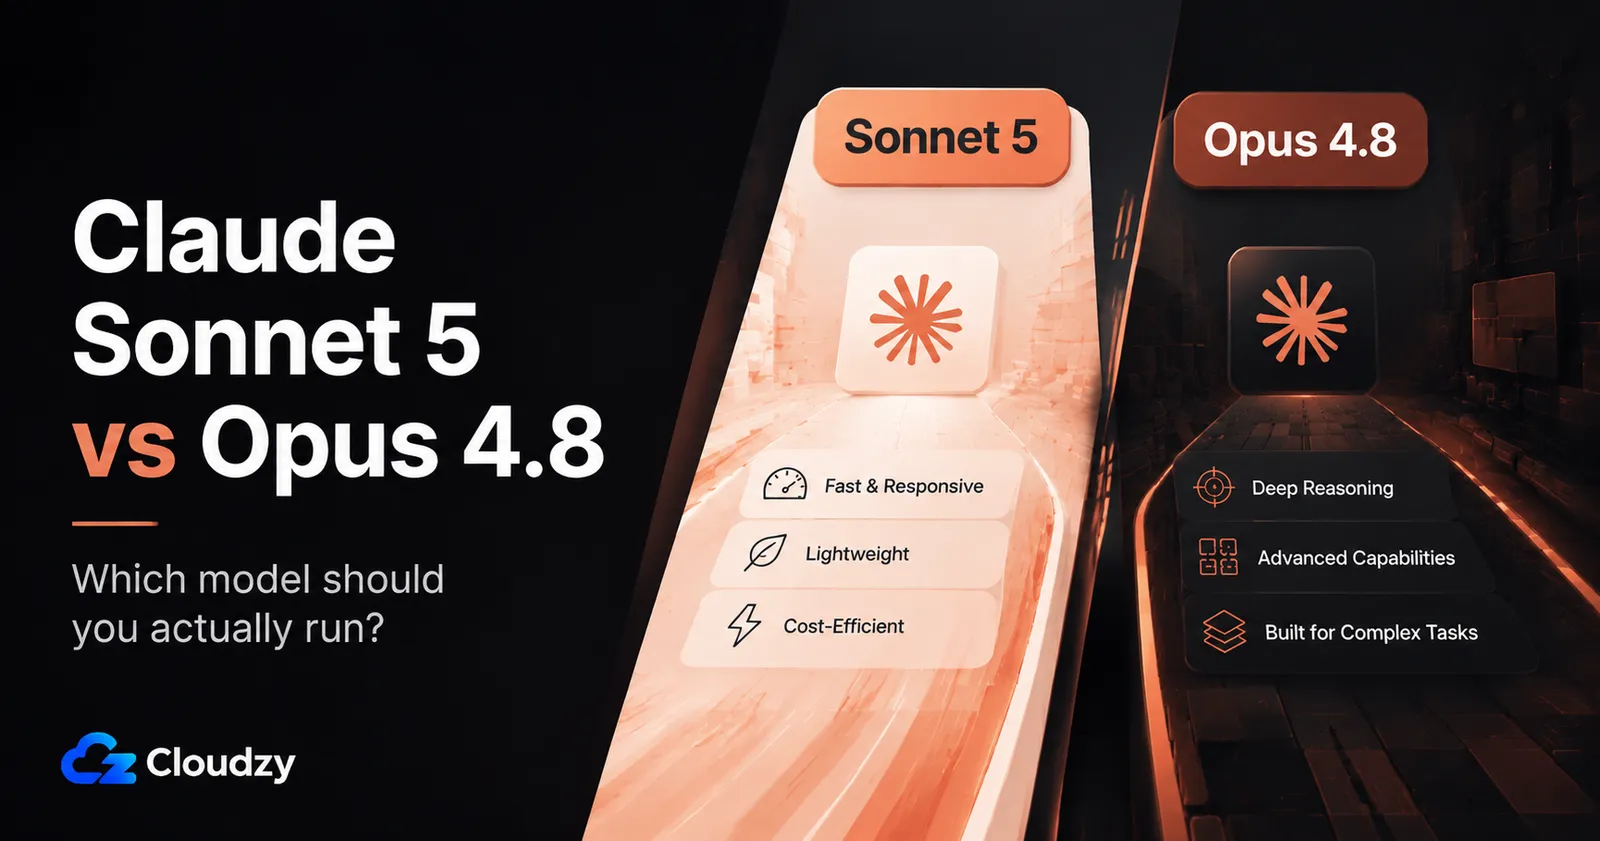
Sonnet 5 ราคาถูกกว่า Opus 4.8 แต่ tokenizer เปลี่ยนไป และงานที่ใช้ effort สูงจะพลิกตัวเลขค่าใช้จ่าย นี่คือโมเดลที่ควรใช้ และเมื่อไรที่ Opus ยังชนะอยู่
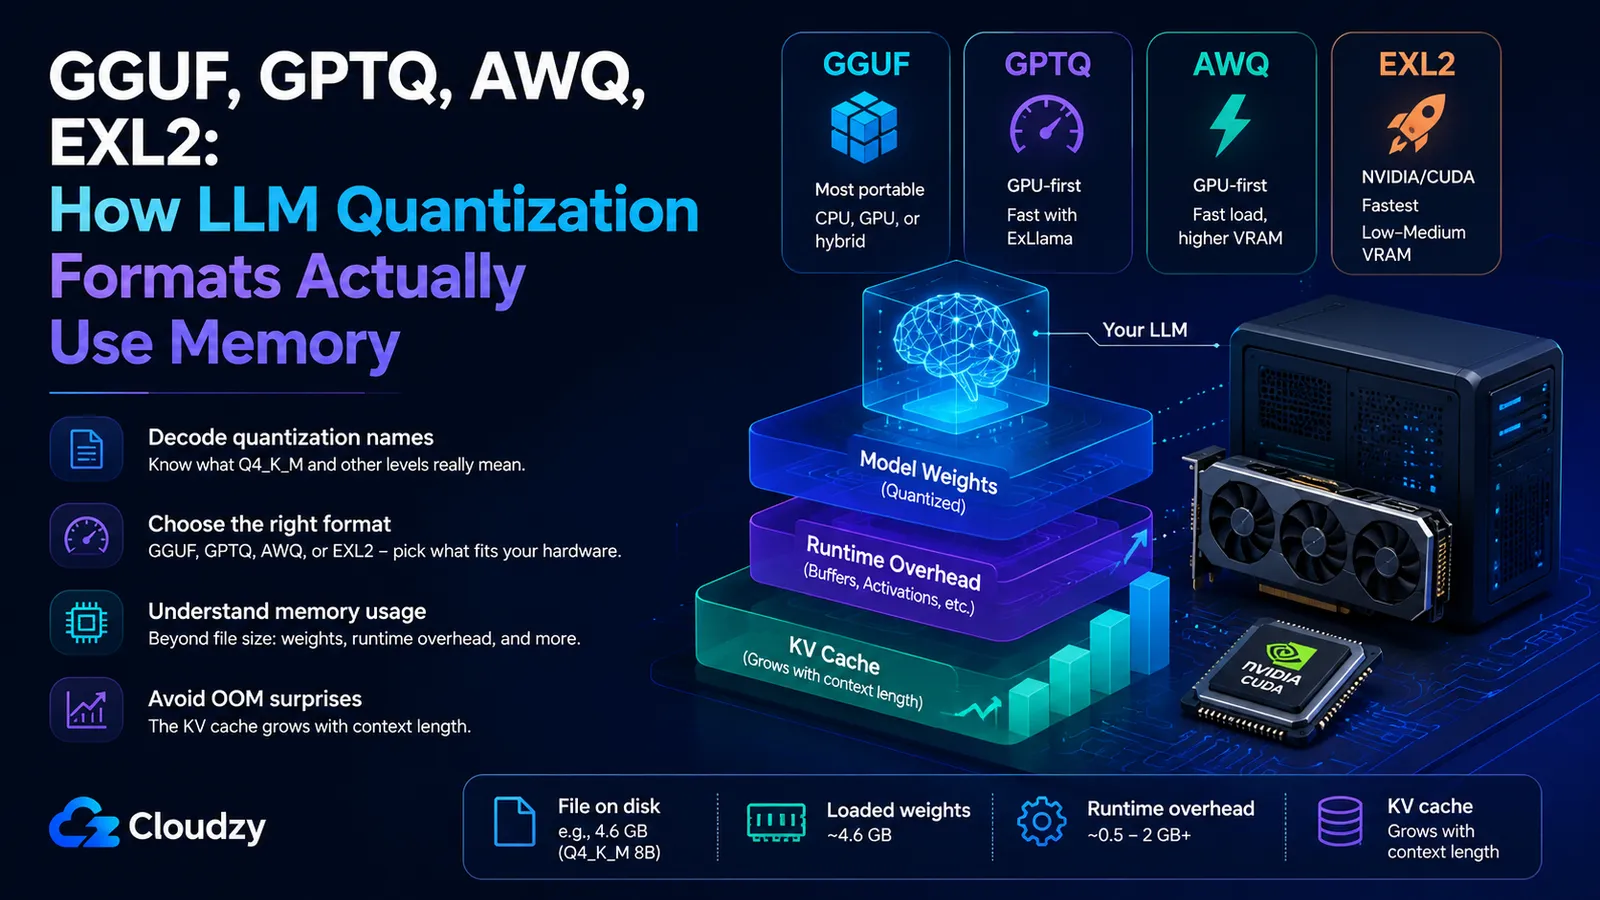
เปรียบเทียบการใช้หน่วยความจำของ GGUF, GPTQ, AWQ และ EXL2 ตั้งแต่ขนาดไฟล์ Q4_K_M ไปจนถึงการเติบโตของ KV cache และโอเวอร์เฮดของรันไทม์
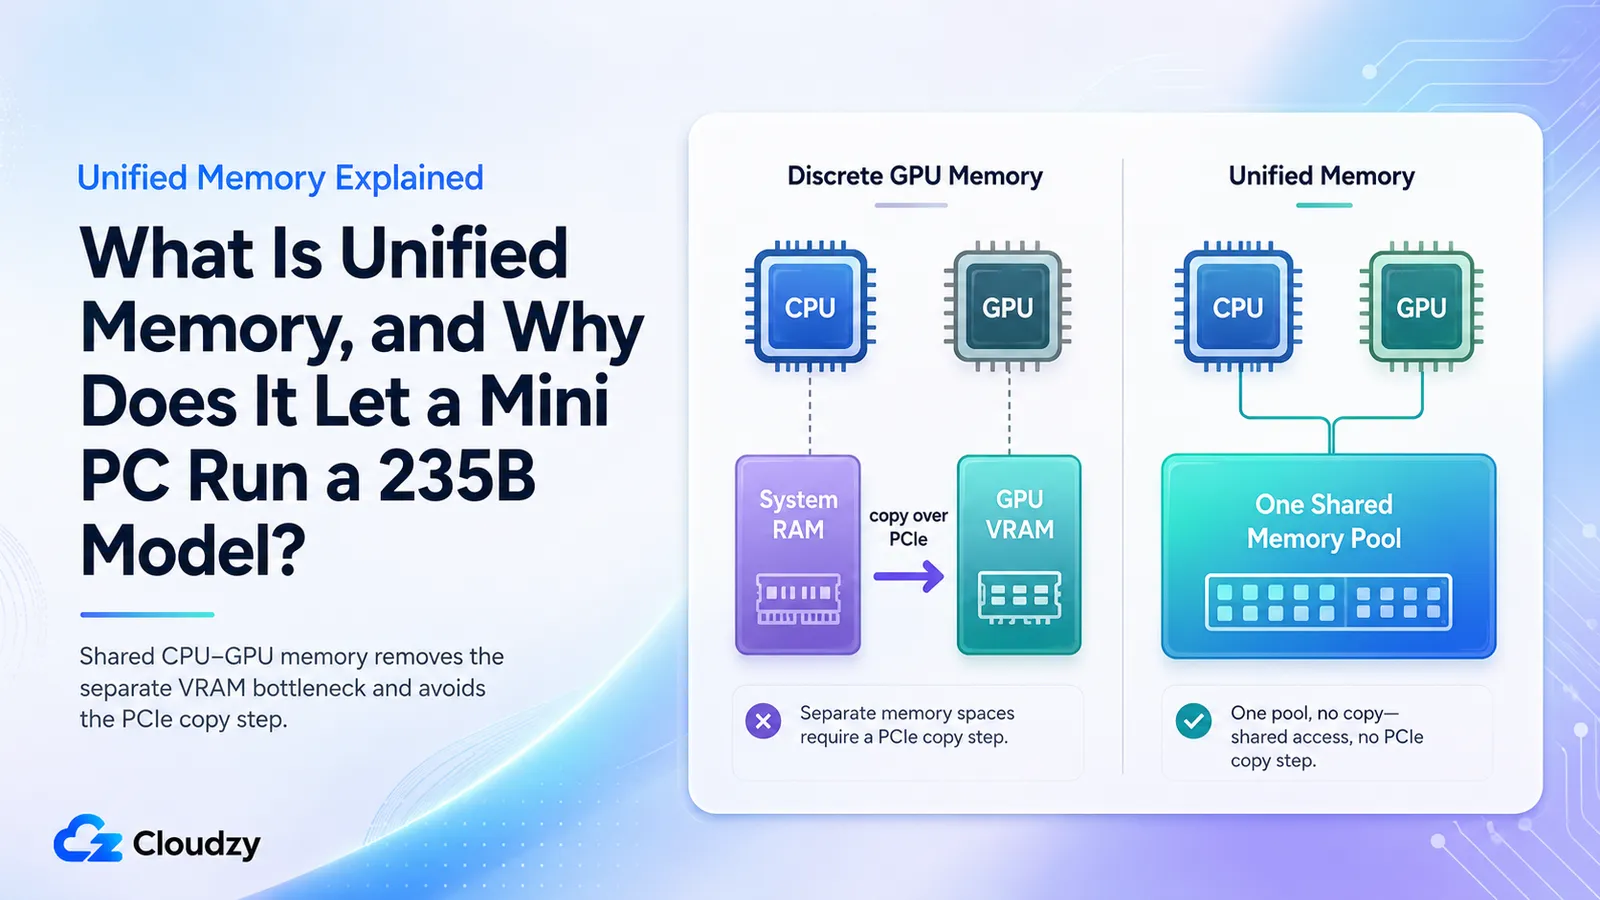
หน่วยความจำรวมทำให้พีซี AI ขนาดกะทัดรัดโหลดโมเดลระดับ 235B ที่ GPU 24-32GB เพียงตัวเดียวไม่สามารถรองรับได้ มันคืออะไร ทำไมถึงใช้ได้ผล และทำไมใหญ่กว่าไม่ได้แปลว่าเร็วกว่า